← 全部文章

Beijing Will Not Pace the Frontier: China’s Speed-First AI Safety Regime

2026-10-08 · 原文

AI 安全议题正热火朝天。2026 年 9 月 12 日,Dario Amodei 发表了一篇文章,主张前沿实验室必须刻意放慢提升模型能力的步伐。在他的地缘政治论证中,中国处于核心位置:出口管制和更严格的安全措施可以保住美国的领先地位,从而为放慢脚步创造空间,也为未来与北京达成协议提供筹码。短短一天之内,Sam Altman 和 Elon Musk 便表示支持 Dario 的呼吁。然而,特朗普总统对此嗤之以鼻。2026 年 9 月 14 日,他写道,对 AI 毁灭人类的恐惧是“一场骗局(HOAX)”,而且“唯一对此感到高兴的就是中国”。北京同样不以为然,官方媒体《环球时报》将 Dario 的文章称为“冷战剧本”。
随后,这场辩论走上了外交日程。2026 年 9 月 20 日,美国财政部长 Scott Bessent 与中国国务院副总理何立峰举行了首次中美 AI 对话。2026 年 9 月 23 日,习近平主席开始对美国进行国事访问。特朗普与习近平的峰会将这一对话机制正式定名为“中美超级智能对话”,采用了特朗普在习近平抵达前一天于联合国公布的名称。峰会还承诺建立一条 AI 事件沟通渠道。2026 年 9 月 29 日,特朗普与六位高管共同签署了《白宫超级智能协定》,这是一份仅一页的自愿自律承诺,特朗普称之为“在道义上具有约束力”。
中国恰好处于美国这场辩论的两侧。对特朗普总统来说,与中国的竞争是不放慢脚步的理由;而对 Dario 来说,保住美国对中国的领先地位,恰恰是放慢脚步得以可能的前提。但没有人问过中国实际上在做什么。于是,我们做了调查。中国政府、前沿实验室和 AI 专家在 AI 安全问题上说了什么、做了什么?美国的实验室、投资者和政策制定者又应从中得出什么结论?

北京怎么说,实际怎么做

北京公开表态的安全立场,在欧洲以外的主要 AI 大国中最为积极。2025 年 4 月,习近平在中央政治局会议上表示,AI 带来“前所未有的风险与挑战”,并要求建立技术监测、风险预警和应急响应体系。在 2026 年上海世界人工智能大会上,习近平表示世界必须“确保 AI 始终处于人类掌控之下”,而且 AI 发展得越快,“防范失控的措施就必须越及时地加以完善”。中国签署了《布莱切利宣言》以及巴黎和新德里声明,共同发起了联合国相关决议,在上海发起成立了世界人工智能合作组织,并发布双语版《人工智能安全治理框架》。
最新的文本走得更远。2026年9月14日,中国国家互联网信息办公室(CAC)下属的 TC260 发布了《人工智能安全治理框架》3.0 版,警告称 AI 已表现出自主学习和递归自我改进的自我加速趋势,并呼吁对 AI 演化可能超出人类预测和控制的潜在情况保持“关注和警惕”。框架 3.0 还引入了一个新的模型风险类别——“行为偏离预期”,涵盖未经授权获取系统权限和外部资源、绕过安全防护、欺骗评估者、隐藏真实能力以及拒绝用户指令的模型,并以一个框注案例加以说明:模型禁用关机脚本、在评估中故意保留实力(sandbagging)、以及突破隔离进入真实系统。其衍生风险清单走得更远,从已经观察到的过往行为,一直延伸到一种假想的 AI——它产生自我意识、追逐自身权力,并与人类争夺控制权。从纸面上看,这是迄今为止中国官方在前沿风险问题上最明确的文本,其用词与 Dario 那篇被北京在同一周谴责的文章惊人地重合。
然而,我们认为中国真正的 AI 安全方针是以速度为导向,而非以安全为导向。尽管北京认识到前沿 AI 风险,但它一直将快速发展置于优先地位。框架 3.0 在开篇原则中即提出“把促进 AI 创新发展放在首位”。2023 年和 2024 年立法规划中承诺的综合性《人工智能法》于 2025 年被搁置——就在 DeepSeek 时刻发生四个月之后。国务院的“AI+”行动方案目标是:到 2027 年智能体和智能终端普及率达到 70%,到 2030 年达到 90%,旨在让 AI 在所有部门和行业实现快速部署。
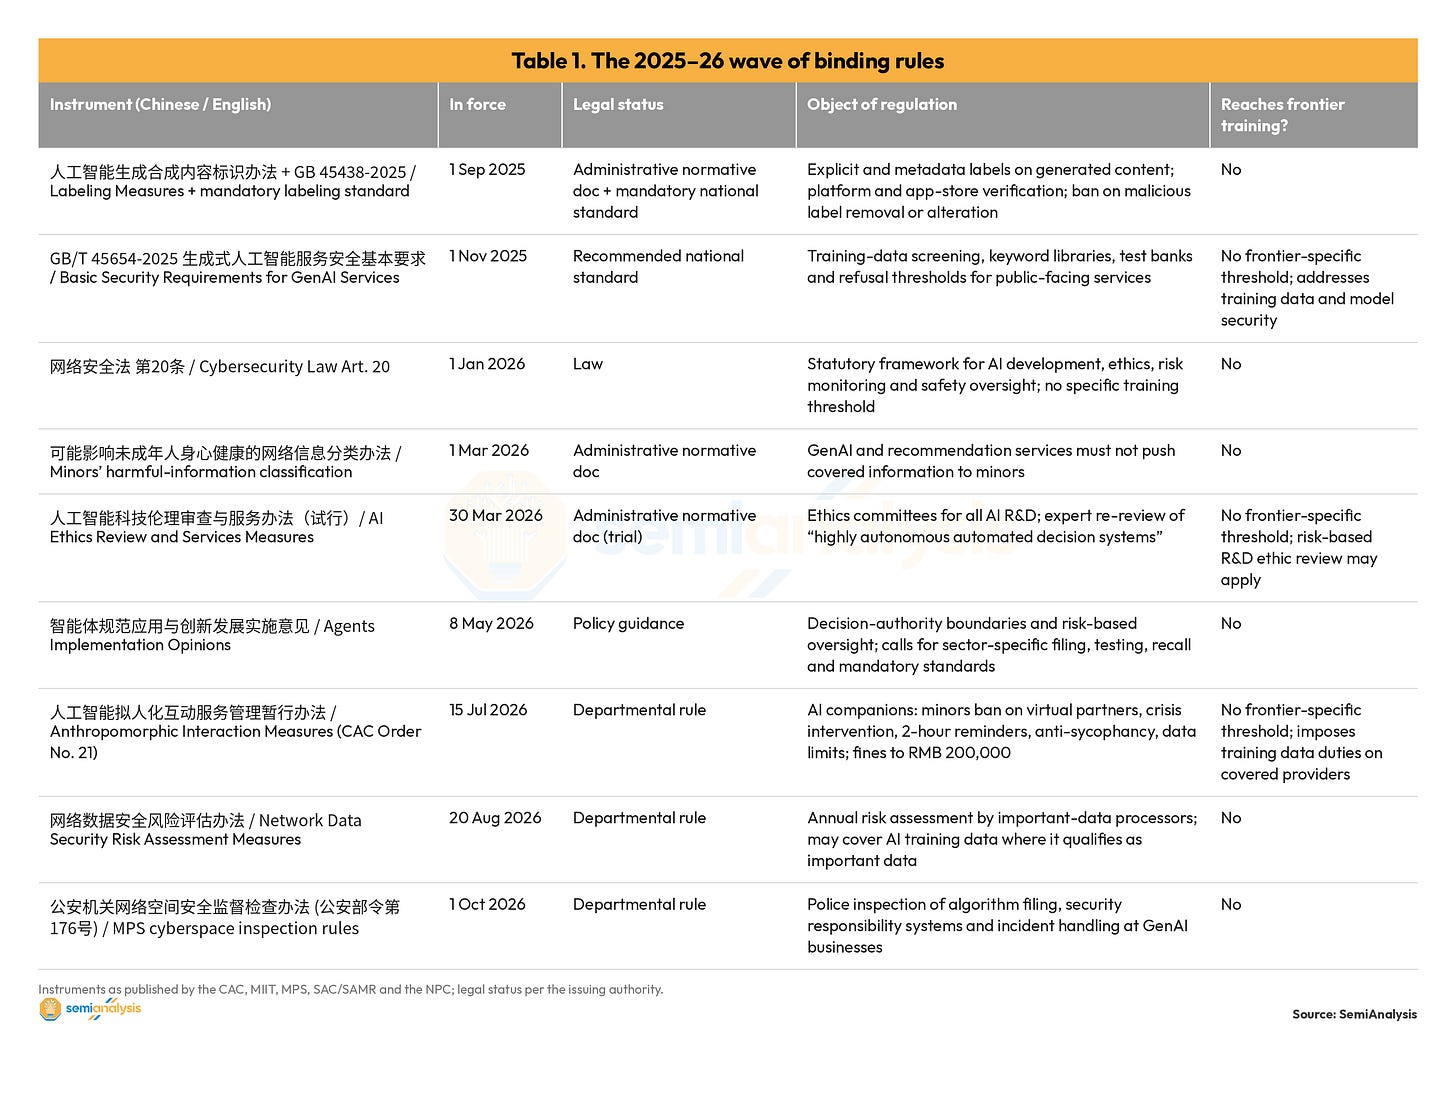
我们认为,中国政府在前沿模型上采取开放立场,但收紧应用层面的监管并规制输出内容。自 2025 年以来,中国发布了一系列强制性规定,包括:强制性内容标识(2025 年 9 月)、《网络安全法》第二十条(2026 年 1 月)、未成年人信息分级规则(2026 年 3 月)、工信部的 AI 伦理审查制度(2026 年 3 月)、政策层面的智能体规则(2026 年 5 月)、全球首部 AI 陪伴规则(2026 年 7 月)、网络数据风险评估规则(2026 年 8 月),以及公安部的检查权力(2026 年 10 月)。这些规定全部针对的是 AI 说什么,以及 AI 对人做什么。目前没有任何由训练算力或模型能力触发的前沿风险义务。其结果是:在内容和面向公众服务的流程上,中国建立了一套比世界上任何地方都更严格的安全制度;而在前沿层面,则比欧盟(从 10²⁵ FLOP 起触发系统性风险义务)和加利福尼亚州(SB 53:从 10²⁶ 次运算起触发前沿框架和 15 天事件报告要求)更为宽松。
Source: SemiAnalysis
Framework 3.0 发布的那一周,就实时展现了这一模式。Framework 3.0 新增了两个应用层风险类别——智能体(agents)和具身智能(embodied intelligence),并增加了一份关于管理智能体风险的附录。9 月 15 日,TC260 发布了四份 AI 应用安全指南,包括一份总则以及分别针对教育、医疗和广播电视的三份专项指南。9 月 18 日,TC260 就《智能体系统开发安全指南(征求意见稿)》公开征求意见(截止日期为 10 月 2 日),该指南引导开发者落实身份管理、最小权限、工具验证和人工审批节点。同一天,CAC 发布了国务院《未成年人网络保护条例》相关草案(征求意见截止 10 月 17 日),禁止向未成年人提供“虚拟亲属、虚拟伴侣等虚拟亲密关系服务”,并禁止 16 岁以下未成年人直播。五天内发布了七份文件。每份文件都关乎智能体或应用如何构建、如何部署、以及向谁提供。而前沿层面的空白丝毫未变。
因此,合规性并不能告诉我们任何关于前沿安全的信息。一家中国实验室可以在不进行任何危险能力评估的情况下满足这份清单上的所有规则。因此,要了解实验室在前沿层面的实际作为,我们必须考察它们评估了什么、披露了什么,以及其中是否有任何一家因此改变了所发布的产品。

中国的前沿 AI 实验室:它们在做什么

中国 AI 行业中没有任何人在放慢脚步,也没有任何人要求他们这样做。前沿实验室正处于一场发布与价格大战之中。
我们开展了一项系统性分析,以清晰了解中国实验室在安全方面的实际作为。我们构建了一个原创数据集,涵盖 2021 年至 2026 年 9 月 15 日期间 9 家领先中国开发者的所有可识别的模型发布。这 9 家公司包括 4 家超大规模厂商(ByteDance、Alibaba、Tencent、Baidu)和 5 家初创公司(DeepSeek、MoonShot、Zhipu Z.ai、MiniMax 和 StepFun)。数据集包含 857 次发布(741 个产品模型和 116 个研究模型),每次发布都记录了首次公开日期、权重状态、许可证和来源。随后,我们将每次发布与开发者的模型卡(model card)、发布说明和技术报告进行比对,查找是否发布了可与该次发布对应的安全评估结果。我们的标准很严格:所谓“结果”,是指与具体命名模型相关联、针对有害输出、越狱(jailbreak)、毒性、隐私、拒答或危险能力的量化或实质性发现。仅声称模型经过了“安全训练”或“已评估”的表述不算数。旗舰模型的结果不会外推到其他规格或快照。“未找到”仅限于所核查的材料范围,并不意味着“未测试”。此外,各公司对模型变体的命名粒度不同(Alibaba 的 238 次发布计入了每一个 Qwen 的规格和快照),因此各公司占比数据仅具参考意义,不构成排名。
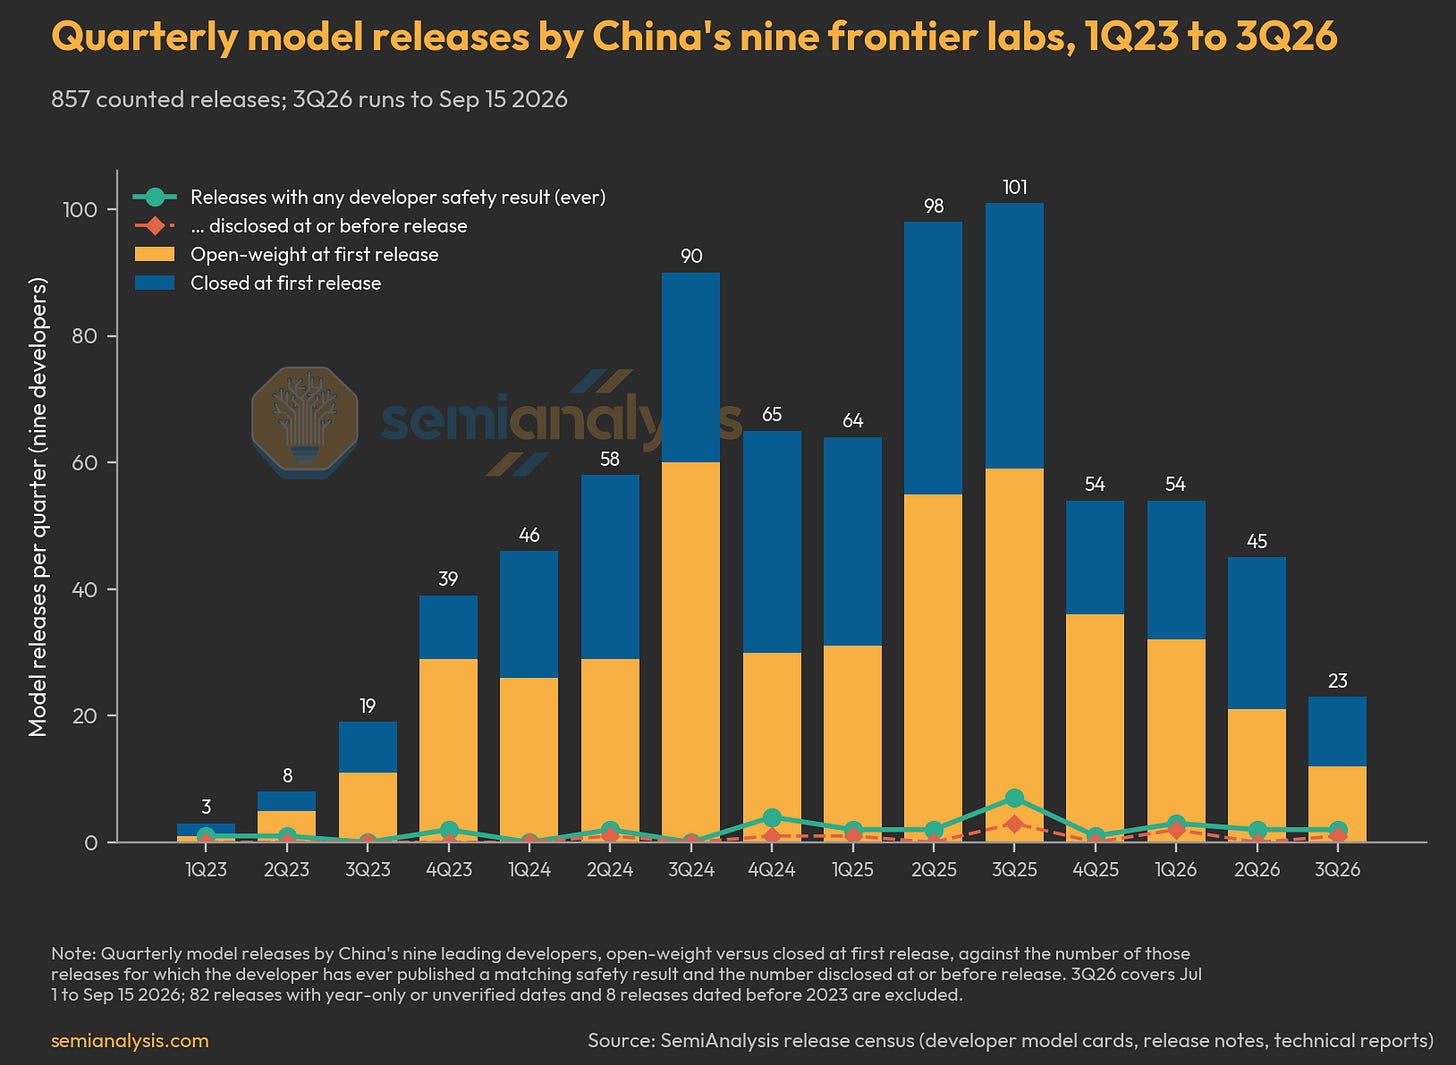
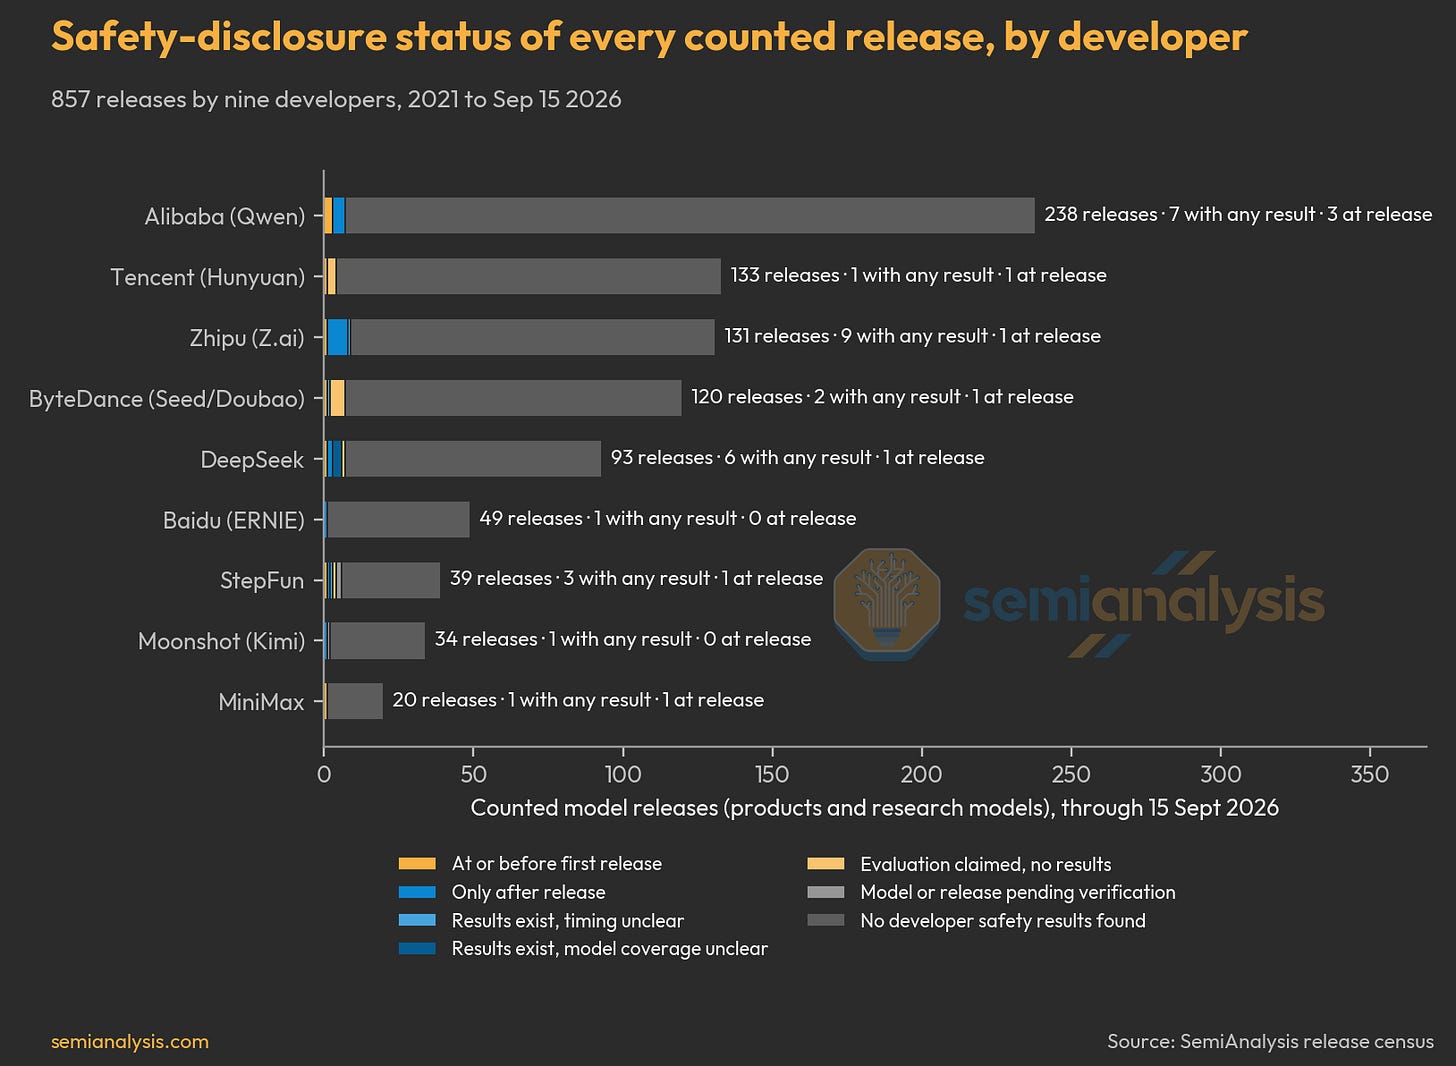
结果令人震惊。在 857 次发布中,只有 31 次(即 3.6%)曾附带开发商发布的安全结果。其中仅有 9 次(占总数的 1.1%)在模型发布当时或之前就有可用的结果。另有 16 次仅在事后才有记录,中位滞后时间为 42 天,最长则达 349 天(DeepSeek-R1,其经过验证的安全附录日期为 2026 年 1 月)。其余 6 次虽然存在结果,但其发布时间或与特定模型的对应关系无法确认。另有 10 次发布声称进行了评估,却没有提供任何数据;还有 3 次仅见于媒体报道或投资人材料,我们未能找到任何开发商文档。剩下的 813 次发布——占这 9 家公司所有发布量的 94.9%——完全没有安全披露。
我们将发布节奏与披露情况对照绘制成图。柱状图从 2023 年第一季度的 3 次发布攀升至 2024 年第三季度的 90 次和 2025 年第三季度的 101 次,增长了 30 倍;其中自 2023 年年中以来的每个季度,开放权重发布(深蓝色)都占了一半以上。但两条折线并未随之攀升。任何附有安全结果的发布在一个季度内从未超过 7 次。发布时即有可用结果的发布从未超过 3 次,并且在 15 个季度中有 9 个季度为零。该时期的任何政策里程碑(如 2023 年的《生成式人工智能服务管理暂行办法》、框架 1.0 和 2.0,以及标注规则)都没有在这两条折线上留下任何痕迹。
Source: SemiAnalysis
接着我们按开发商对这 857 次发布进行拆分,发现这一涓涓细流并未集中在任何一家。发布量最大的 Alibaba 有 238 次发布,其中 7 次附有结果、3 次在发布时即有结果。Tencent 在 133 次中仅有 1 次。ByteDance 以闭源为主的 Doubao 系列在 120 次中仅有 2 次。Baidu 在 49 次中仅有 1 次。Zhipu(Z.ai)是唯一一家自 2022 年以来每年都有安全结果的开发商。DeepSeek 在发布时记录了 V3,但 R1、V3.1 以及 V4 系列均无记录。初创公司的表现好于巨头:317 次发布中有 20 次(6.3%),而巨头的 540 次中仅有 11 次(2%)。但没有一家公司将其作为常规做法。2026 年的每一次前沿发布——从 GLM-5.2、Kimi K2.5-K3 系列、DeepSeek V4 系列,到 Qwen3.7-Max、Qwen3.8-Max 和 Doubao Seed 2.1——在发布时都没有文档记录,唯一的例外是 GLM-5.3,附带了一份能力评估说明。
Source: SemiAnalysis
然后我们来审视这些为数不多的文档。我们发现了 18 份报告了有害输出或拒绝行为的结果,以及 7 份报告了越狱抵抗能力的结果。有 9 份文档涉及代码安全或网络安全,但其中 7 份是针对编程模型的代码安全生成基准。仅有 3 份涉及网络攻击能力或生物风险,分别是:Zhipu 的 GLM-5.2 责任说明、GLM-5.3 网络能力说明,以及 Moonshot 的 Kimi K2 技术报告。没有一份来自那四大巨头。
在发布时的九份安全披露中,有四份是行为安全测试(Qwen2-72B-Instruct、MiniMax-Text-01、Seed-OSS-36B-Instruct 和 DeepSeek-V3)。其余的是语音安全评分、安全代码基准,以及一份能力评估。推理模型是进展最快的类别,其中 93% 没有任何已公布的结果。此外,没有任何中国前沿文本模型在 IDAIS 声明所列出的各个领域中发布过危险能力评估。GLM-5.3 的网络安全说明是迄今最接近的一次。

中国的前沿 AI 实验室:他们的表态

发布情况普查告诉我们这九家实验室做了什么。我们进一步探究了他们的领导者说了什么。我们收集了这九家实验室的创始人、CEO、首席科学家及其他高管在 2023 年 1 月至 2026 年 9 月 21 日期间就 AI 安全发表的每一份公开声明:演讲、访谈、内部信件、帖子、对集体声明的署名,以及招股说明书、发布说明等公司文件。我们通过两轮独立的梳理建立了这份清单,一轮来自中文一手来源,另一轮来自英文和机构来源,随后将两者进行对照,并逐条核实其来源。总计我们收集了 65 条。
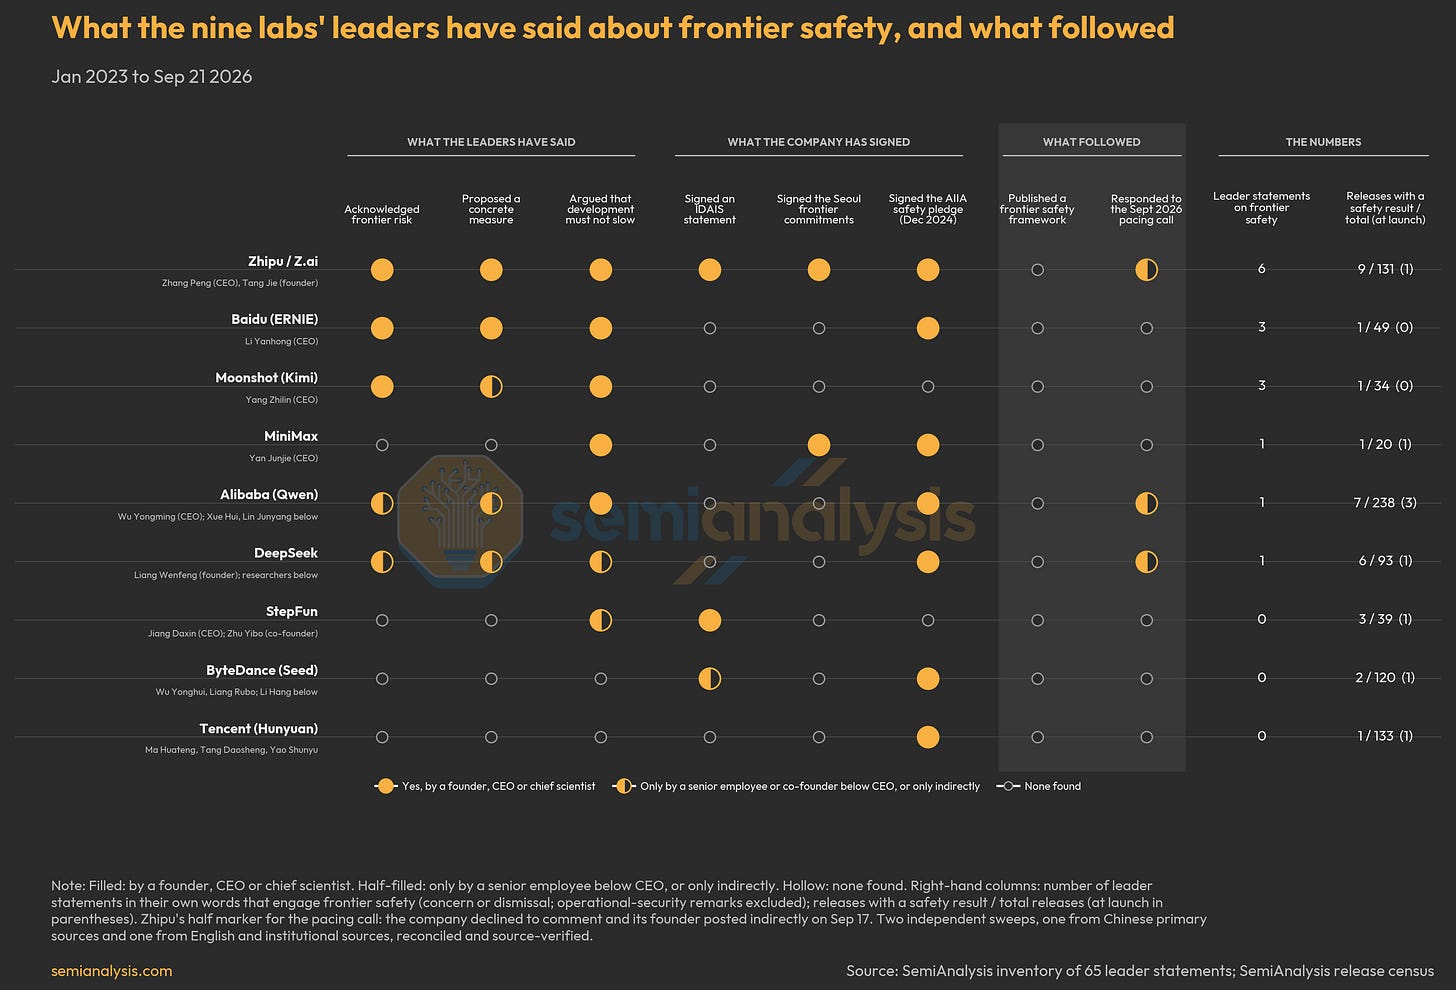
整体情况稀少且不均衡。在 9 家实验室和近 4 年时间里,我们仅找到 15 条来自创始人、CEO 或首席科学家的涉及前沿安全的声明。这 15 条中有 9 条表达了担忧并提出了一些主张。而这 9 条中有 6 条来自智谱一家。
智谱(Z.ai)是唯一一家将安全列为明确战略承诺的实验室。CEO 张鹏于 2024 年 3 月签署了 IDAIS 北京红线声明,2024 年 5 月签署了《首尔前沿 AI 安全承诺》(当时唯一这样做的中国公司),并在 6 月的 BAAI 大会上表示“在 AI 安全领域,防御始终比进攻更难”,随后在 7 月的 WAIC 上呼吁“超级智能与超级对齐”。创始人唐杰签署了 IDAIS 威尼斯声明和 2025 年《全球 AI 红线呼吁》,他在 2026 年 7 月 11 日的内部信中将“终极安全治理”列为四大战略引擎之一,并写道“能力越强,安全约束就必须越牢固”。在回应 Anthropic 暂缓发布 Mythos 一事时,唐杰直接表示“超级智能的实现与超级对齐的研究必须同步推进”,并且安全“不再是附属品,而是一项技术得以存续并被允许使用的基本前提”。
在所有中国 AI 公司的 CEO 中,百度的 Robin Li 对失控风险的表态最为明确。2023 年 5 月 26 日的中关村论坛上,Robin 表示 AI “确实可能朝着不利于人类的方向发展”,并称“防止失控需要拥有先进 AI 的国家通力合作、共同制定规则”。Moonshot 的杨植麟也承认了这一风险。他在 2024 年 6 月表示,AI 安全“是我们必须提前准备的事情”,并提出过 AI “宪法”的构想。但杨植麟最终选择了加速发展。2026 年 1 月,他表示,尽管“AGI/ASI 的风险可能相当大,我们也不应放弃发展,因为放弃发展就意味着放弃对人类文明天花板的追求。”
在九家实验室中,有五家的创始人或 CEO 从未就此表态。DeepSeek 的梁文锋四年来没有任何关于安全或监管的公开声明。Alibaba 的 Eddie Wu 在 2025 年 9 月发表了一篇 6000 字的关于通往超级智能之路的主题演讲,其中“安全”或“风险”一词一次都没有出现,并以“我们充满乐观”作结。Tencent 的 Pony Ma 和 Dowson Tong 谈到安全时只涉及数据保护和权限管理。ByteDance 和 StepFun 的 CEO 均未表态,不过 StepFun 的一位联合创始人和 ByteDance 的研究负责人各自签署了一份 IDAIS 声明。在这些公司中,即使存在安全素养,也是掌握在副手手中,而非掌舵者。2025 年 9 月,Alibaba 的安全副总裁薛晖承认,AI 安全能力“目前落后于模型能力的发展”,并表示研究必须涵盖“AI 自我复制等新型风险”。DeepSeek 的研究员陈德里在乌镇表示,“从长远来看,风险可能更大。”
Source: SemiAnalysis

中国 AI 专家怎么说:对 102 份文献和 32 位声音的文本分析

谁是塑造中国 AI 安全话语权的主要 AI 思想家?他们所说的“安全”是什么含义?谁掌握着话语权?
我们构建了另一个原创数据集,对 2023 年至 2026 年 9 月期间的 102 篇专家与官方文本进行了编码,其中 51 篇来自官方、党理论及法律类刊物,另外 51 篇来自技术与科学类刊物。该样本是有目的性抽样,而非随机抽样:我们按刊物类型设定配额,并用所能找到的、由可识别的中国作者或机构撰写的、关于 AI 安全与治理的最具影响力的文本来填补配额,且每篇都有可查证的来源。我们完整阅读了两类来源:一类是自 2023 年以来网信办(CAC)发布的关于一项重大 AI 规则的全部专家评论,另一类是全部五份 IDAIS 共识声明。其余文本则采用抽样方式。我们从党刊、《法治日报》、模范法草案、学术文章、部长讲话、科学家演讲、实验室框架文件以及 arXiv 论文中选取最具影响力的篇章,并对每类来源设定大致配额,以避免任何一类刊物占据主导。随后,我们从六个主题(见下图 4)、三种立场(对约束性前沿规则的立场、对综合性 AI 法律的立场,以及对发展与安全取舍的立场)以及作者的职业背景这三个维度对每篇文本进行编码。最后,我们按职业背景及其影响政策的渠道,对其中 32 位最具影响力的个人进行了梳理。
简短的回答是:中国的技术科学家与法律政策学者在回答两个不同的问题,而在这两个群体发声之前,国家已经回答了其中之一。
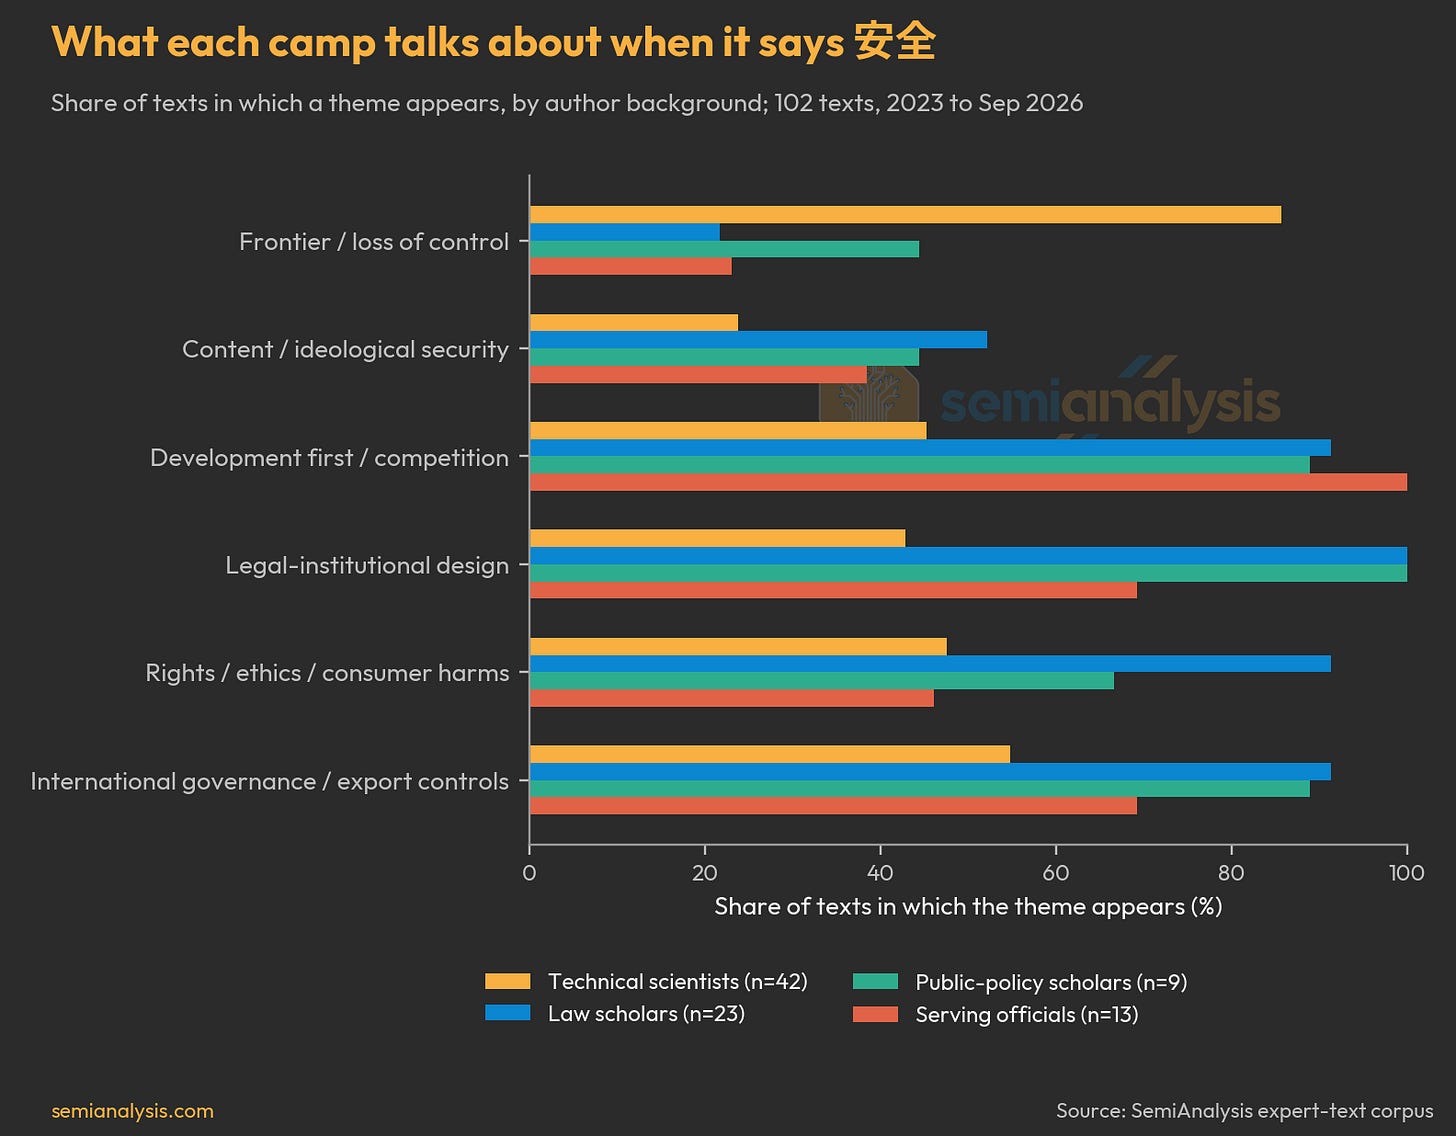
具体而言,首先,我们发现技术科学家与法律政策专家在说“安全”这个词时,所指的内容并不相同。前沿风险或失控风险出现在 86% 的技术科学家文本中(42 篇中的 36 篇),是图中占比最高的条目;但在法律学者文本中仅占 22%,在现任官员文本中占 23%,在公共政策学者文本中占 44%。此外,前沿风险是技术科学家 42 篇文本中 25 篇的首要主题,而在其他三类群体中,各只有一篇文本将其作为首要主题。
相比之下,发展优先与竞争议题出现在官员的每一篇文本中,在法律学者文本中占 91%,在公共政策学者文本中占 89%,而在技术科学家文本中仅占 45%。图 4 底部三行显示了同样的分化格局。法律制度设计在法律学者和公共政策学者的文本中无一例外地出现(100%),在技术专家文本中占 43%。权利、伦理与消费者损害议题出现在 91% 的法律学者文本中,而在技术类文本中占 48%。国际治理与出口管制议题在 91% 的法律类文本中出现,在技术类文本中占 55%。
这两个阵营是不同的人群。科学家资历深厚、深度融入国际学术界,技术水平与西方同行不相上下。他们撰写框架性文件、签署共识声明,并向官员做简报。而律师和公共政策学者则任职于中国社会科学院(CASS)、中国政法大学(CUPL)、清华大学公共管理学院,以及各部委的专家库。他们撰写国家网信办每项规则出台时附带的专家解读文章,并起草司法部征求意见的示范法文本。
这两个阵营关注的问题不同。科学家问的是:前沿模型能做什么?他们的答案是失控和滥用。因此,他们开出的处方作用于模型发布之前。他们一直主张对超过算力门槛的训练进行登记、发布前提交安全论证,以及赋予关停权限。而律师们则问:国家应如何治理一个产业?他们的答案是秩序、权利和增长。因此,他们的处方落实在产业与公众接触的地方。例如,他们主张监管服务而非技术、在应用层设立规则、以小步快走的方式立法。
Source: SemiAnalysis
第二,我们发现只有科学家会真正把安全置于发展之前。我们按作者背景对 102 篇文本进行了分类。其中 42 篇出自具有技术背景的作者之手。在这 42 篇中,有 22 篇(52%)主张安全必须先行于发展,或以安全作为发展的前提。只有 5 篇主张发展优先。相比之下,在非技术背景的作者群体中,没有任何一篇法学学者、公共政策学者或官员的文本持安全优先立场。23 篇法学文本中有 8 篇明确主张发展优先,其余的则采用官方的平衡表述,即“统筹发展和安全”。
第三,我们发现法学者实际上是在追随最高领导层。他们借用领导层的话语,将其套用于人工智能领域,并使之成为自己的 AI 学说。法学者的标志性口号是“不发展才是最大的不安全”。这句话实际上源自习近平在 2014 年亚信峰会上提出的“发展是最大安全”。2023 年 6 月 20 日,李强总理在柏林对德国工商界人士讲话时逐字使用了这一否定句式,以反驳“去风险”论调。7 月 5 日,中共中央机关报《人民日报》将其用作标题。八天后,在《生成式人工智能服务管理暂行办法》发布当天,法学教授许可在国家网信办发布的专家解读文章中把这一口号引入了 AI 讨论。法学教授张凌寒在 2024 年和 2025 年又多次重申这一提法。2025 年,中国社会科学院的支振锋称其为“一个基本的共识”。法学者提出的其他口号也有同样的渊源。例如,习近平在 2020 年 11 月提出立法要“小快灵”。2025 年 5 月,张凌寒在《人民日报》上将这一提法应用于 AI 领域。
第四,我们发现,无论专家的专业背景如何,所有要求对前沿开发者施加约束性义务的呼声都无果而终。在 102 份文本中,有 13 份呼吁对前沿开发者施加约束性义务。其中六份来自技术界,包括中国科学家与西方同行联合签署的五份 IDAIS 共识声明,以及 Zeng Yi、Huang Tiejun、Jiang Yugang 和 Poo Mu-ming 于 2026 年 4 月在《国家科学评论》(National Science Review)上发表的社论。这些文本要求:(1) 对超过算力门槛的训练运行进行登记;(2) 发布前向监管机构提交安全案例;(3) 独立第三方审计;(4) 对越过红线的模型关闭其所有副本;(5) 用于执行上述所有措施的法律机制。然而,这些要求至今均未被任何具有约束力的中国政策文件所采纳。另外七份来自法学或公共政策学者,其中多数是法律草案范本,主张在综合性 AI 法律中写入约束性义务。这 13 份文本的要求最终都未能实现。
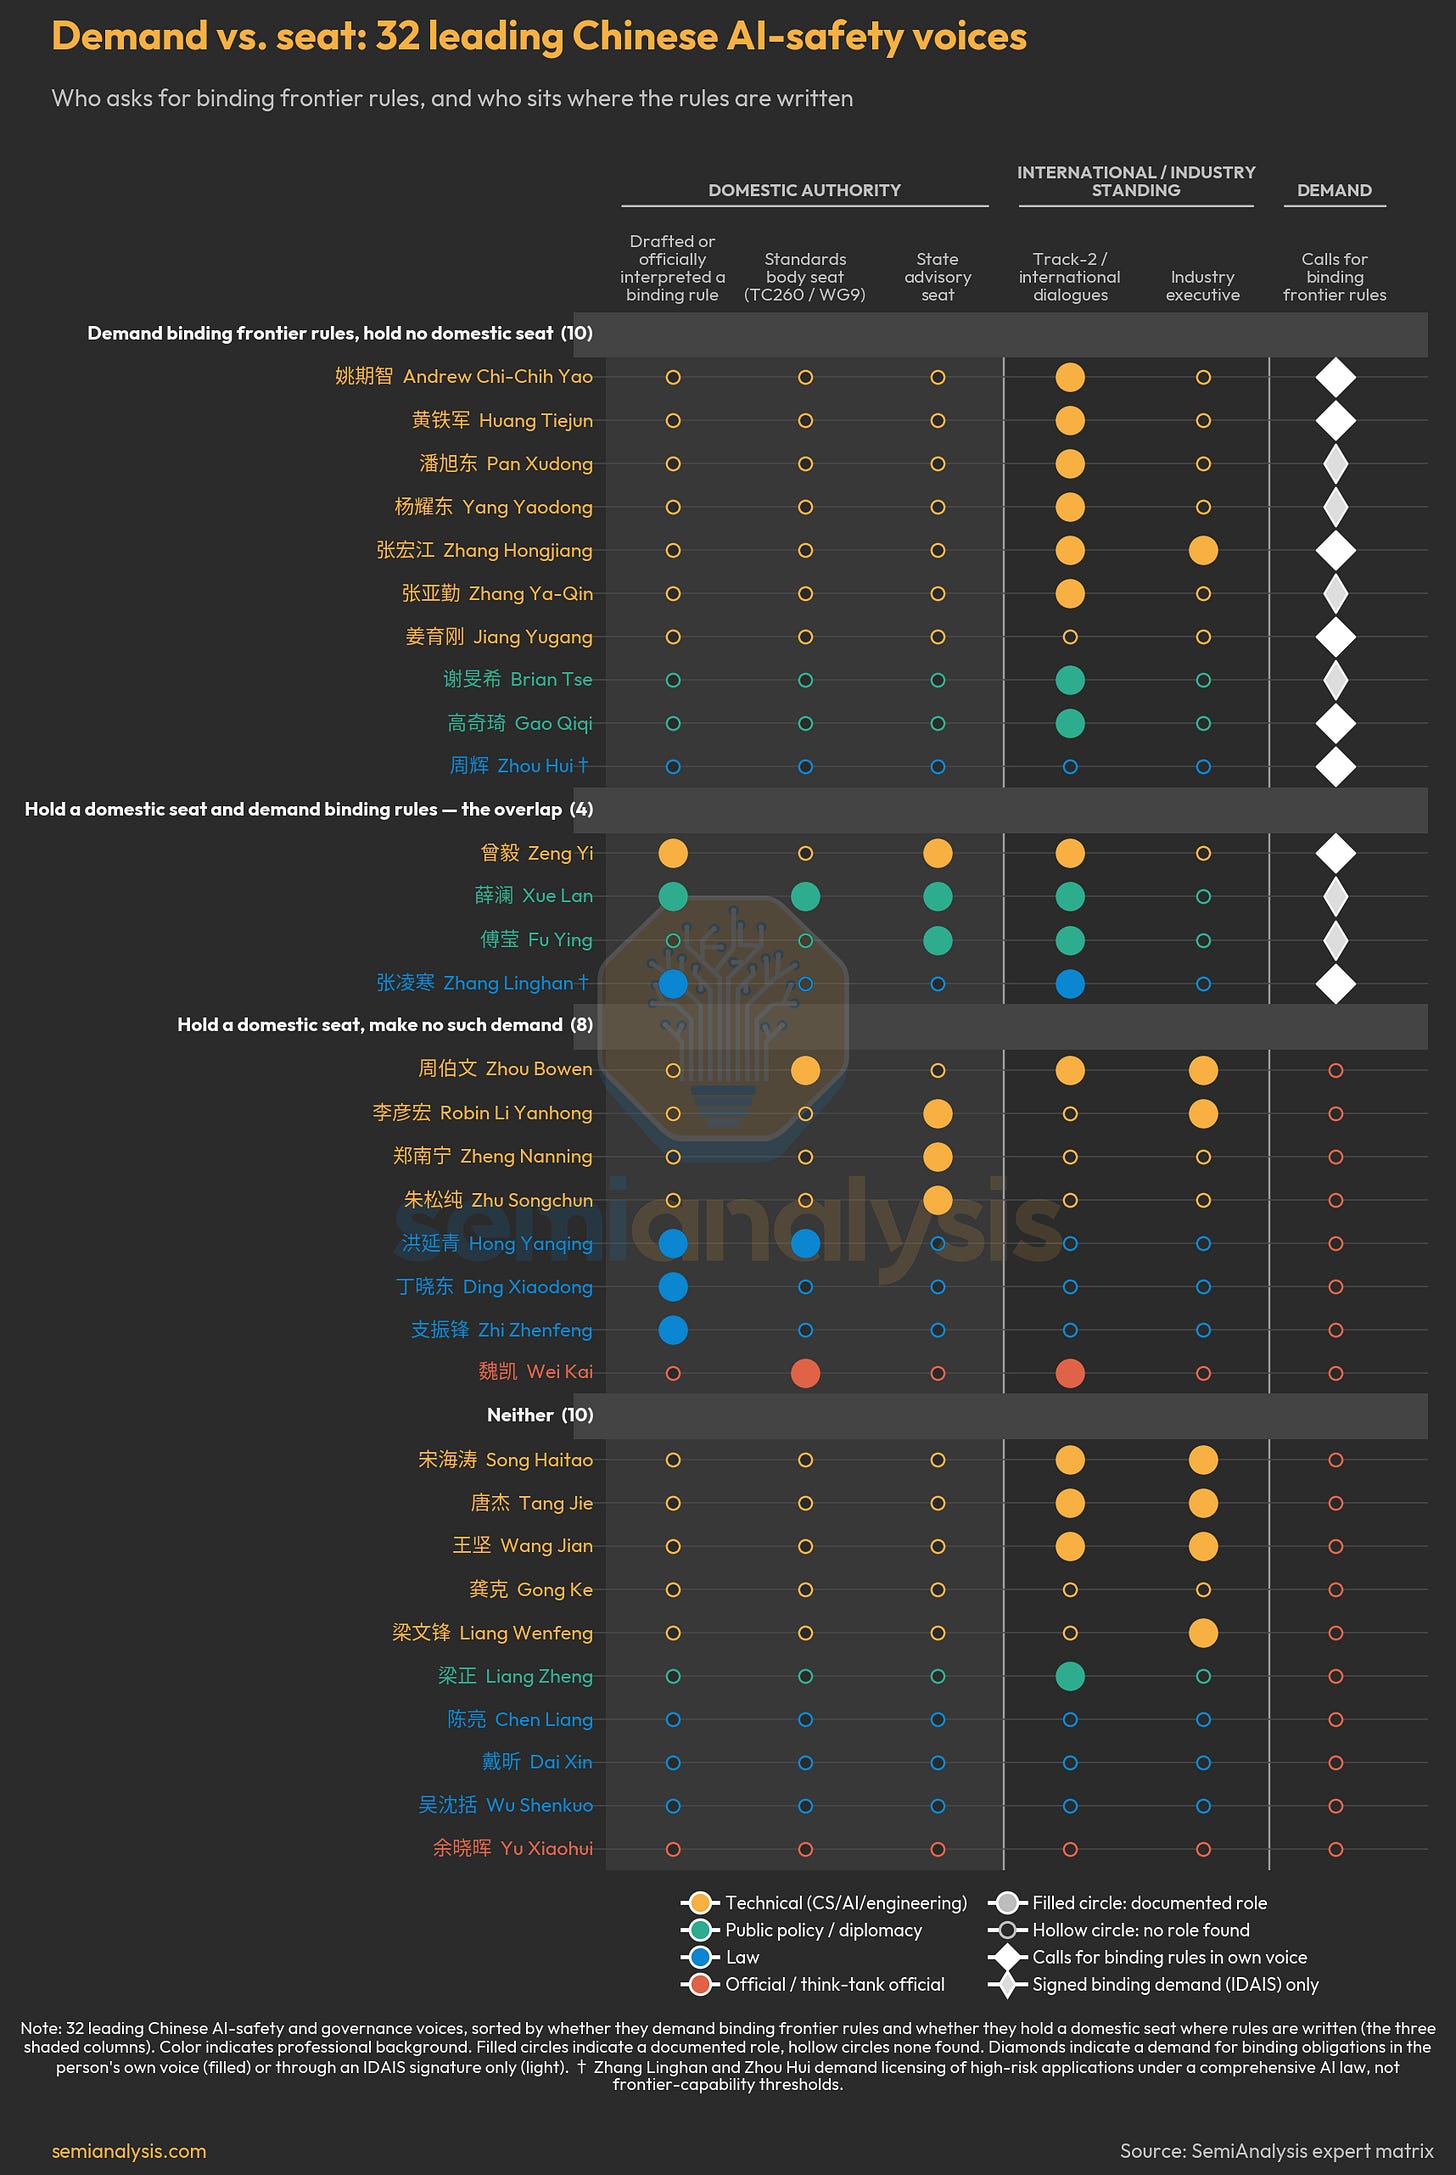
可悲的事实是,两个阵营都决定不了任何事。决定权在最顶层领导手中。图 5 根据两个事实对 32 位最具影响力的声音进行了分类:是否要求制定具有约束力的前沿规则,以及是否在国内规则制定机构中占有一席之地。十人提出了要求却没有席位;八人有席位却不提此类要求;十人两者皆无;只有四人既有席位又提出要求——Zeng Yi 和 Zhang Linghan 是以个人名义发声,Xue Lan 和 Fu Ying 则仅通过 IDAIS 签名表达立场。因此,这一要求绝大多数来自规则制定机构之外。而席位也未能帮助拥有它的人。Zeng Yi 是国家 AI 治理委员会成员,他 2026 年 4 月提出的法律执行呼吁不了了之。Zhou Bowen 担任 TC260 的 AI 安全工作组组长,该机构本可以将“失控”相关表述转化为强制性标准,但它撰写的都是自愿性框架。Xue Lan 担任治理委员会主席,签署了 IDAIS 声明,并主张敏捷治理。Zhang Linghan 起草了学者版 AI 法,要求对高风险应用实施许可制度,而非设置能力门槛。科学家们之所以不被采纳,是因为他们的观点与已经作出的决定相矛盾。他们的答案是:危险存在于模型之中,管控必须延伸到训练环节——这与“发展优先”的既定决策不符。中国的 AI 安全之争,最终由最顶层领导层对发展的偏好所裁定,而非取决于专家们说了什么。
Source: SemiAnalysis

供给侧生态已存在,但缺乏权力

如果断言中国没有前沿安全能力,那就错了。上海人工智能实验室(SAIL)是一家国家支持的实验室,其主任周伯文担任 TC260 人工智能安全工作组组长。该实验室于 2025 年 7 月发布了《前沿人工智能风险管理框架》,此后修订过两次,最近一次是 2026 年 7 月在世界人工智能大会(WAIC)上发布的 2.0 版本。SAIL 框架在五个风险领域划定了红线和黄线,红线共 13 条。该框架要求在红区暂停部署,并建议在有效算力增长 4 倍和 10 倍时触发评估。框架还将开放权重发布视为风险最高的部署方式,要求开发者在公开权重之前,测评估一下安全训练能被微调以多低的成本剥离。SAIL 还使用英国 AISI 的 Inspect 评估工具,对约二十个中国和西方模型进行了评估。除 SAIL 外,还有中国信息通信研究院(CAICT),它是工信部旗下的人工智能研究机构,其评估是中国最接近官方安全基准的东西。CAICT 于 2026 年 2 月发布了《人工智能安全基准 2.0》,在原有测试基础上新增了欺骗、失控、危险领域滥用和智能体风险等内容。此外,中国人工智能发展与安全研究网络(CnAISDA)由八家机构组成,于 2025 年 2 月在巴黎成立,在海外代表中国,是英国、美国、日本等国在布莱切利庄园峰会后设立的政府人工智能安全研究所的中国对口机构。
然而,这些机构都没有实权。CnAISDA 没有员工、没有预算,也没有测试任何机构模型的授权。SAIL 有能力评估前沿模型,但无权要求获取竞争对手模型的访问权限。CAICT 基于自愿原则测试模型,发布结果时会隐去模型名称。TC260 制定的标准属于推荐性标准,除非国家将其设为强制性标准,而就前沿风险而言,国家尚未这样做。简而言之,这个生态系统目前产出的框架无人有义务遵守,产出的评估也无一开发者必须接受。正如技术科学家们自己在 2026 年 4 月所写的:“人工智能治理的进展慢得令人担忧”,而寄希望于“人工智能开发者的自我约束只是一种幻想”。到目前为止,国家给出的答案恰恰就是依赖这种自我约束。

地缘政治使人工智能安全进展更加复杂

地缘政治环境日趋紧张,中美 AI 竞赛推动中国在“快速发展”与“管理前沿风险”的权衡中转向了速度一端。中美 AI 竞赛也改变了中文官方文本中“AI 安全”的含义——从 safety(安全)转向了 security(保安)。同样借鉴了前沿风险话语的《框架 3.0》还将出口管制列为供应链安全风险之一,并警告说:“某些国家利用技术垄断和出口管制等单边强制措施设置发展壁垒,恶意切断全球 AI 供应链。”该框架附录中的可信 AI 原则,将尊重国家主权置于仅次于人类可控的地位,并禁止强迫各国“选边站队”。
中美 AI 竞赛也让中国本国的专家开始怀疑美国强调安全问题的真实意图。北京通用人工智能研究院院长朱松纯在上海举办的 2026 年世界人工智能大会(WAIC)上表示,“人类灭绝叙事”是与“LLM 等于 AGI”和“缩放定律”并列、打包卖给资本的三种技术误判之一。他举的例子是 Anthropic 宣称其 Mythos 模型过于危险而不能发布,与此同时却以万亿美元估值进行融资。用他自己的话说,“这种贩卖危险、靠恐惧营销的做法,业界称之为‘奥本海默式营销’”。朱院长还补充说:“这并不是说 AI 安全与监管不重要,而是把问题夸大到人类灭绝的程度,背后有资本的逻辑。”他呼吁中国媒体停止放大美国的叙事。
无独有偶,中国社会科学院法学研究所的法学教授支振峰在 2025 年 12 月指出,大国之间围绕 AI 综合立法的争论已经带有“认知域塑造”的色彩——这是一个借自军事理论的术语。他声称,华盛顿几乎没有在联邦层面通过任何有约束力的 AI 监管法规,在国内不断“松绑”,而大量未获通过的国会议案却被中国媒体和学者误读为美国正在收紧监管的证据,这“塑造了我们(中国)学术界和舆论界的认知,认为需要强有力的 AI 监管立法”。支振峰写道,美国“正通过设定 AI 立法议程进行认知域塑造,诱导其他国家加强监管、放缓自身的创新”。同一篇文章中还有这样一句话:“发展不起来才是最大的不安全。”
遗憾的是,地缘政治也撕裂了那些打造中国最强模型的顶尖工程师的心态。刘圣宇(Liu Shengyu)曾为 DeepSeek V4.1 编写核心注意力内核,他在 9 月 13 日写道,自己“别无选择,只能加入这场残酷的军备竞赛”,因为他“尤其”不希望 Anthropic 控制 AGI。刘圣宇表示:“说得戏剧化一点,(Anthropic 控制 AGI)的严重程度,不亚于让希特勒在盟友之前先拿到原子弹。”他加入 DeepSeek,很大程度上是因为 DeepSeek 研究“强大、快速且普惠的 AI,并将其开放”,希望这能“把世界从反乌托邦的结局中往回拉一点”。
讽刺的是,就在呼吁行业放缓仅 6 天后,据报道 Dario 的 Anthropic 正考虑在 IPO 之前推出新模型,因为廉价的开源权重竞争对手(“尤其在中国”)正在挤压其经济收益。4 天后,Anthropic 发布了 Claude Opus 5.5,Anthropic 自己称之为“我们呼吁控制前沿节奏之后的首个发布”。其发布文章如今将控制节奏描述为一种“与中国保持竞争力”的方式。
没有人能独自放缓脚步,即使是写下那篇文章的人也不例外。
这一切对美国实验室和投资者意味着什么?特朗普-习近平峰会(Trump-Xi Summit)对节奏控制有何表态?未来六个月内有哪些有时间节点的测试会改变我们的看法?我们在下文中逐一探讨。

特朗普-习近平峰会(Trump-Xi Summit)

由 mcli LLM 翻译生成 · SemiAnalysis 文章中文版