← 全部文章
Anthropic Subscriptions Offer 5x+ More Value Than OpenAI
2026-10-05 · 原文
订阅套餐仍然是消费者和小型企业为 AI 付费的主要方式。正如我们六月份所解释的,这些套餐获得了大量补贴,但作为强大的客户获取和营销工具,它们在经济上仍然说得通。例如,OpenAI 慷慨的额度重置所带来的口碑效应,在一定程度上促成了 Codex 近期的使用激增,也迫使 Anthropic 多次撤回计划中的订阅限制收紧措施,以免在公众舆论中陷入被动。
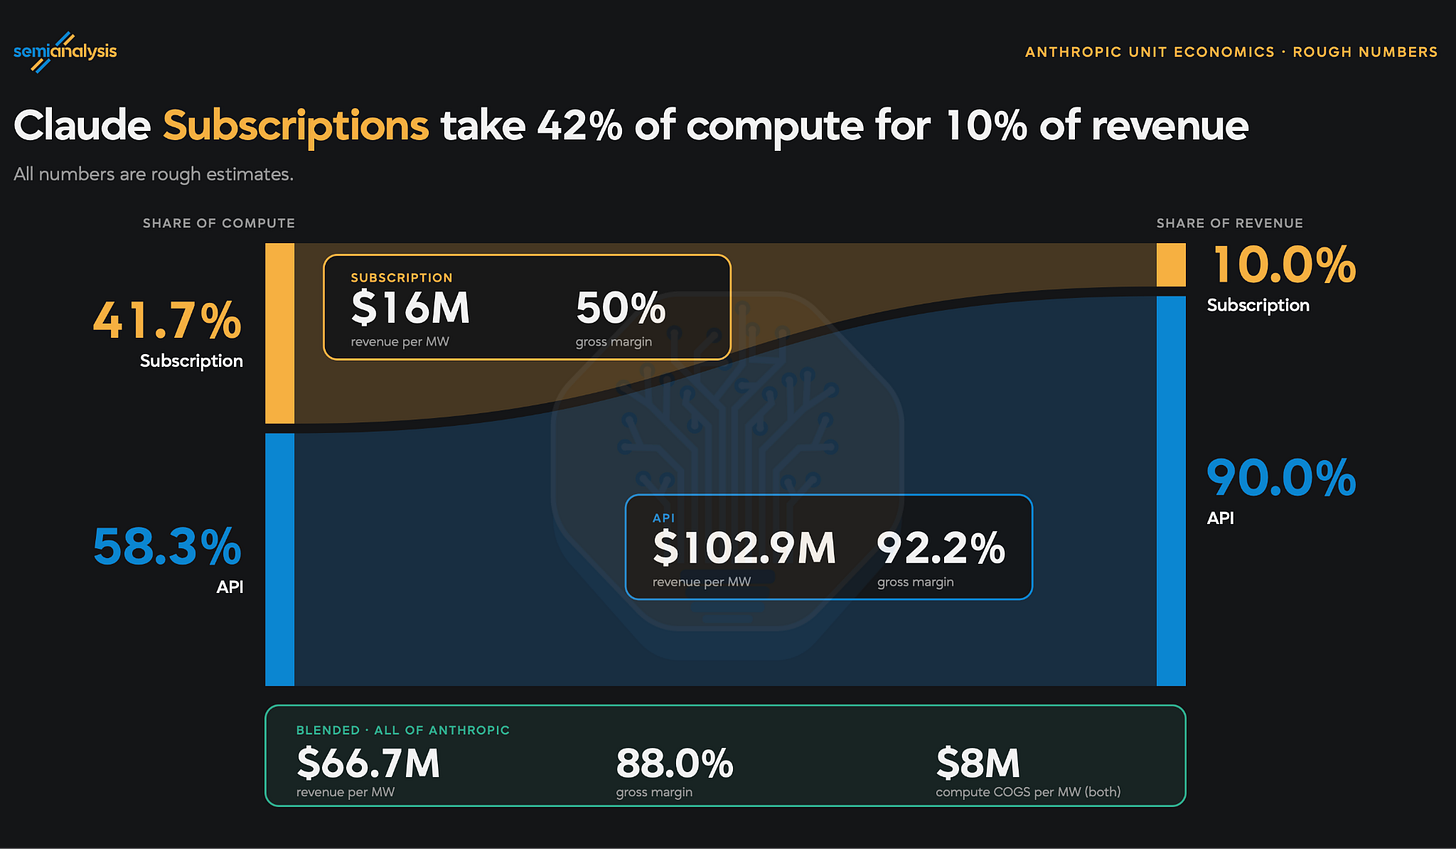
此外,由于订阅套餐的补贴力度极大,尽管它们只占总收入的一小部分,却可能对利润率和每 MW 收入产生重大影响。不妨看看 Anthropic 的以下粗略数字。
Source: SemiAnalysis Tokenomics Model
订阅收入仅占整体收入的 10%,却可能占用超过 40% 的推理算力,并使每 MW 的综合收入降低约 $36M。订阅对 OpenAI 更为重要,因为订阅在其总收入中占比更大。具体数字请参阅我们的 Tokenomics Model。
换句话说,如果你想准确地为 AI 实验室的财务建模,就需要理解它们的订阅限制。
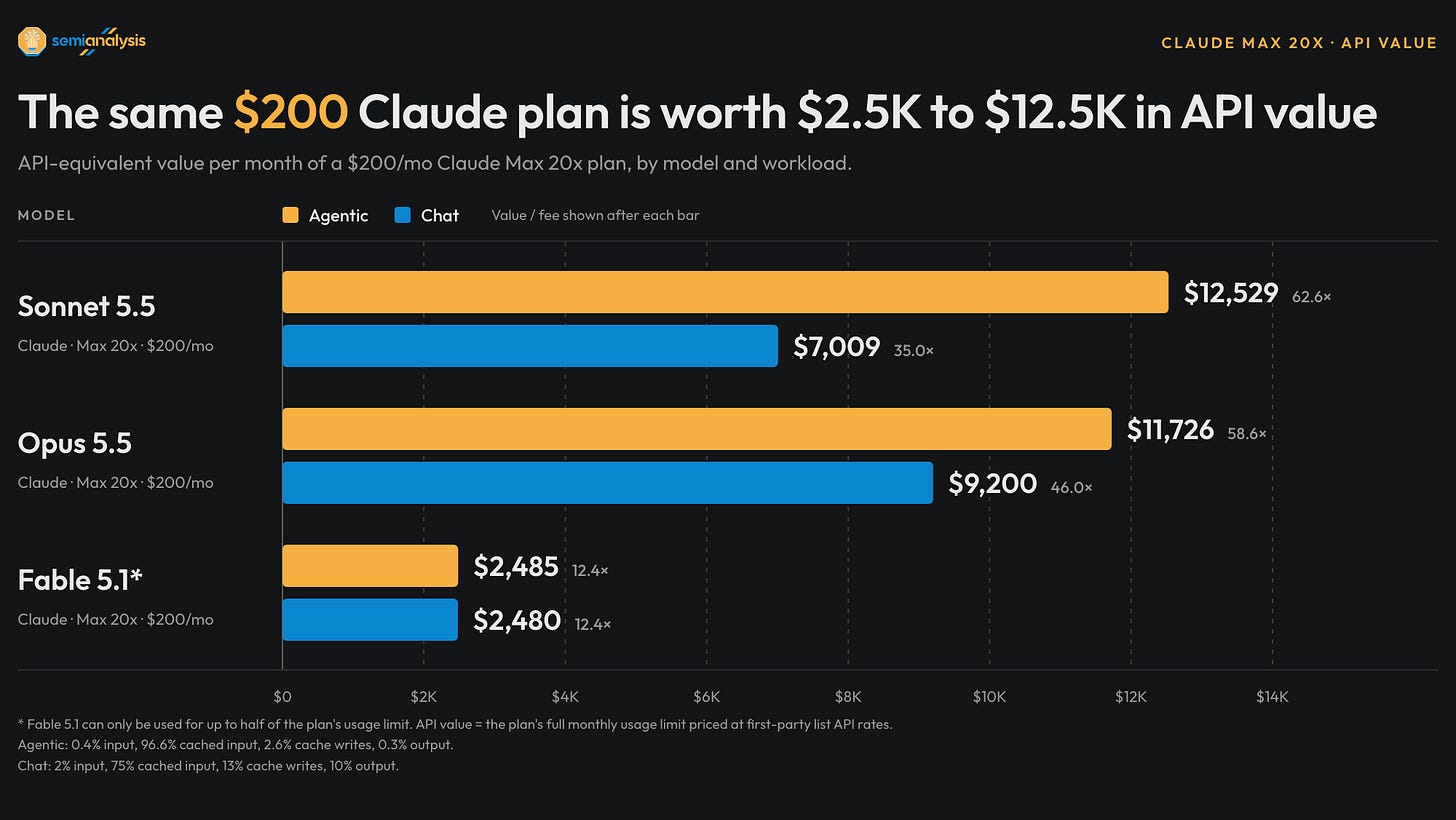
那么,限制究竟是如何运作的?理解订阅的正确方式是:你每月的付费为你换取一定数量的「积分」。每种(模型,token 类型)组合消耗的积分各不相同。由于积分消耗比例可能与 API 定价比例差异巨大,同一个套餐的「价值」会随着你使用的模型和工作负载而变化。换言之,孤立地说某个套餐价值 X 美元是没有意义的——你必须考虑完整的(套餐,模型,工作负载)三元组。
下图展示了同样的 $200/月 Claude 套餐,其 API 等效价值如何随模型和工作负载而变化。
Source: SemiAnalysis Tokenomics Model
单看某一时刻的静态快照也是不够的。各实验室经常通过促销活动和新模型发布公开调整限制。它们还可以随时通过调整积分消耗来悄悄变更限制。理想情况下,你应该每天重新核算每种(套餐,模型,token 类型)的成本,以便实时发现任何变化。
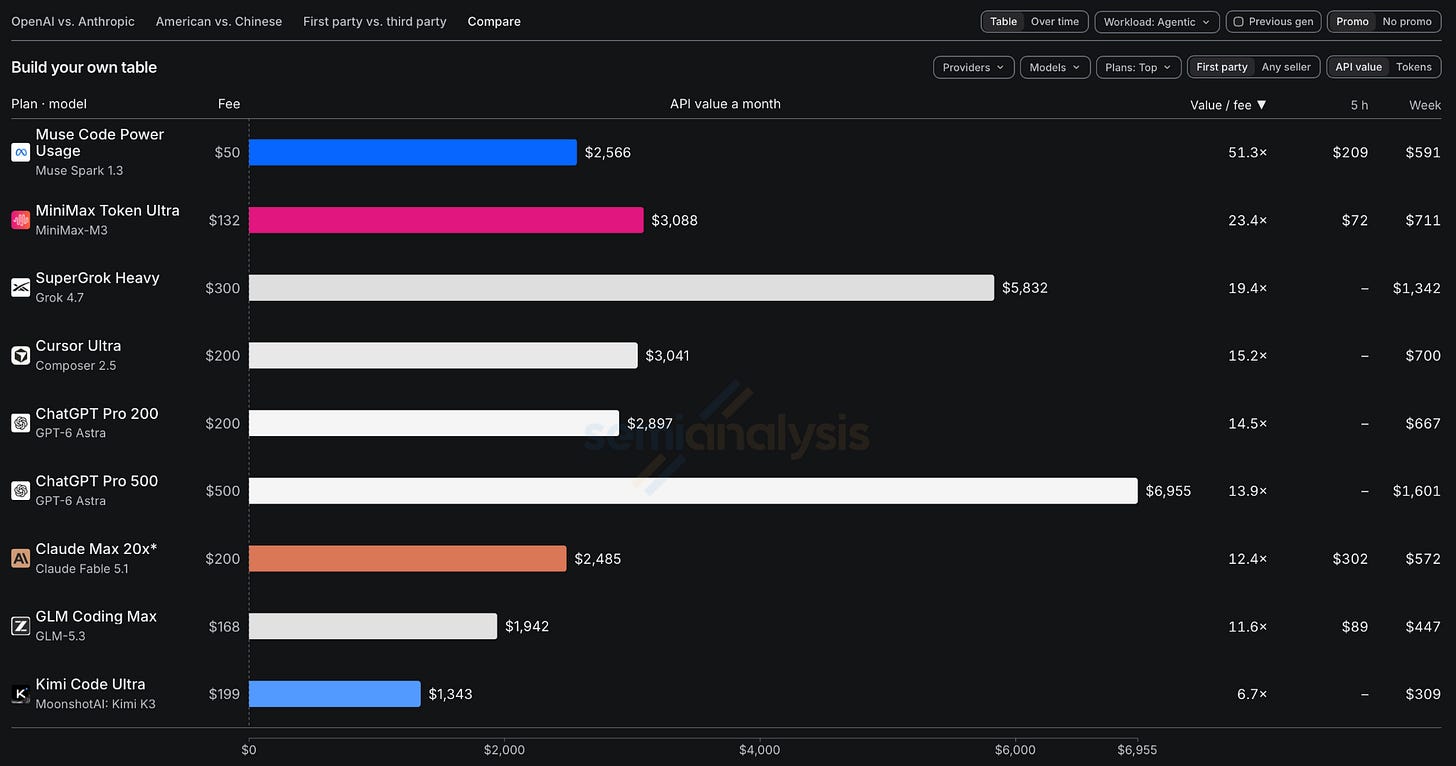
这正是 SemiAnalysis 所做的工作。我们推出了全新的订阅仪表盘,仅供 Tokenomics Model 订阅者使用。除了 OpenAI 和 Anthropic 的全部订阅套餐之外,我们还追踪 Meta、SpaceXAI、Cursor、Cognition、Z.ai、MiniMax 和 Moonshot。
A screenshot of our dashboard showing a small subset of the available data. Source: SemiAnalysis Tokenomics Model
新的提供商、套餐和模型一经发布就会被纳入其中。本文其余部分将概述各家目前的限制情况。除另有说明外,下文中的所有 token 数量和美元金额均基于 agentic(智能体)使用场景。
方法论
Token 通常按 MTok(百万 token)计价,涵盖以下几种类型:
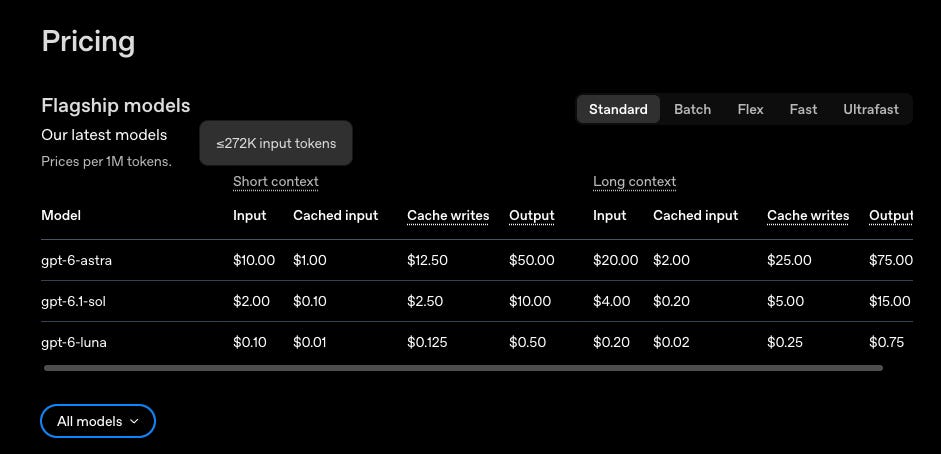
输入(Input):添加到 LLM 上下文窗口中未被缓存的新 token 缓存写入(Cache write):被缓存以用于多轮对话的输入 token。通常比普通输入 token 略贵。 缓存读取(Cache read):对话中前几轮已经缓存的 token。与未缓存的 token 相比通常极其便宜。 输出(Output):由模型生成的 token。这是最昂贵的 token 类型。 此外,一些模型对超出特定上下文窗口的 token 收取更高费用。这些模型通常会在达到那个昂贵的上下文窗口之前进行压缩(compact),因此我们也把测量控制在低于该窗口的范围内。
Source: OpenAI
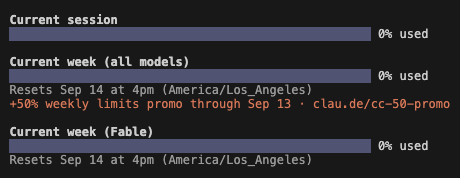
订阅方案并不提供这种细粒度的定价。它们只在 5 小时和 7 天的时间窗口内提供一个简单的 0 到 100% 的用量表,有时还会为 Fable 之类的模型提供单独的用量表。不同订阅档位的区别则只通过相对于同一提供商其他方案的用量倍数来体现。例如 OpenAI 过去曾在 20 美元的 Plus 方案中宣传「扩展的 Codex 用量」,在 100 美元的 Pro 方案中宣传「比 Plus 多 5 倍的用量」,在 200 美元的 Pro 方案中宣传「20 倍用量」——直到他们把 200 美元方案的用量砍半,并从定价页面上删除了所有相对用量信息。
Screenshot of Claude Code meters. Source: Claude Code CLI
实验设置
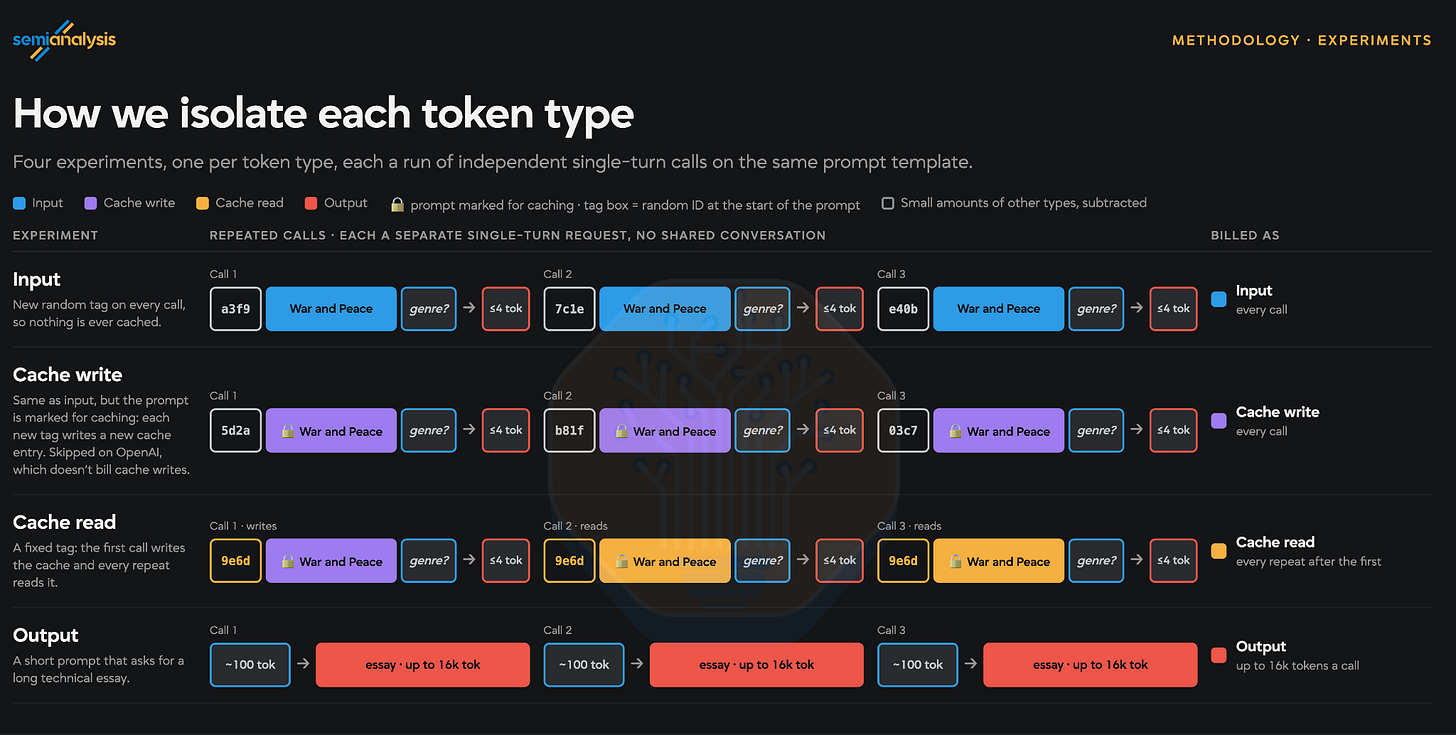
我们通过运行实验来计算每个(方案、模型、token 类型)三元组的订阅费率。每次实验只隔离一种 token 类型,观察模型提供商的用量表移动了多少。一个实验是使用特定提示词进行的若干次重复调用,该提示词会最大化一种 token 类型,同时尽量减少其他所有类型。
Source: SemiAnalysis Tokenomics Model
输入、缓存写入和缓存读取共用同一个提示词模板。我们使用了《战争与和平》的一部分文本,因为如果给定大段无意义字符,一些模型会拒绝响应。在输入 token 实验中,我们每次调用都使用一个随机标签,以确保不会有任何内容被缓存。缓存写入实验的运行方式相同,但提示词被标记为可缓存,因此每个新标签都会强制产生一条新的缓存条目。缓存读取实验使用固定的标签,因此第一次调用写入缓存,之后的每次重复调用都读取该缓存。
在输出 token 实验中,我们使用一篇技术文章来强制产生长输出,因为模型会拒绝「把 SemiAnalysis 重复 100,000 次」这类机械性的提示词。
计算结果
对于每次调用,我们记录两件事:提供商计费了每种类型多少个 token,以及用量表的读数。要把这些数据转换成价格需要三个步骤。
1. 测量每种 token 类型的费率
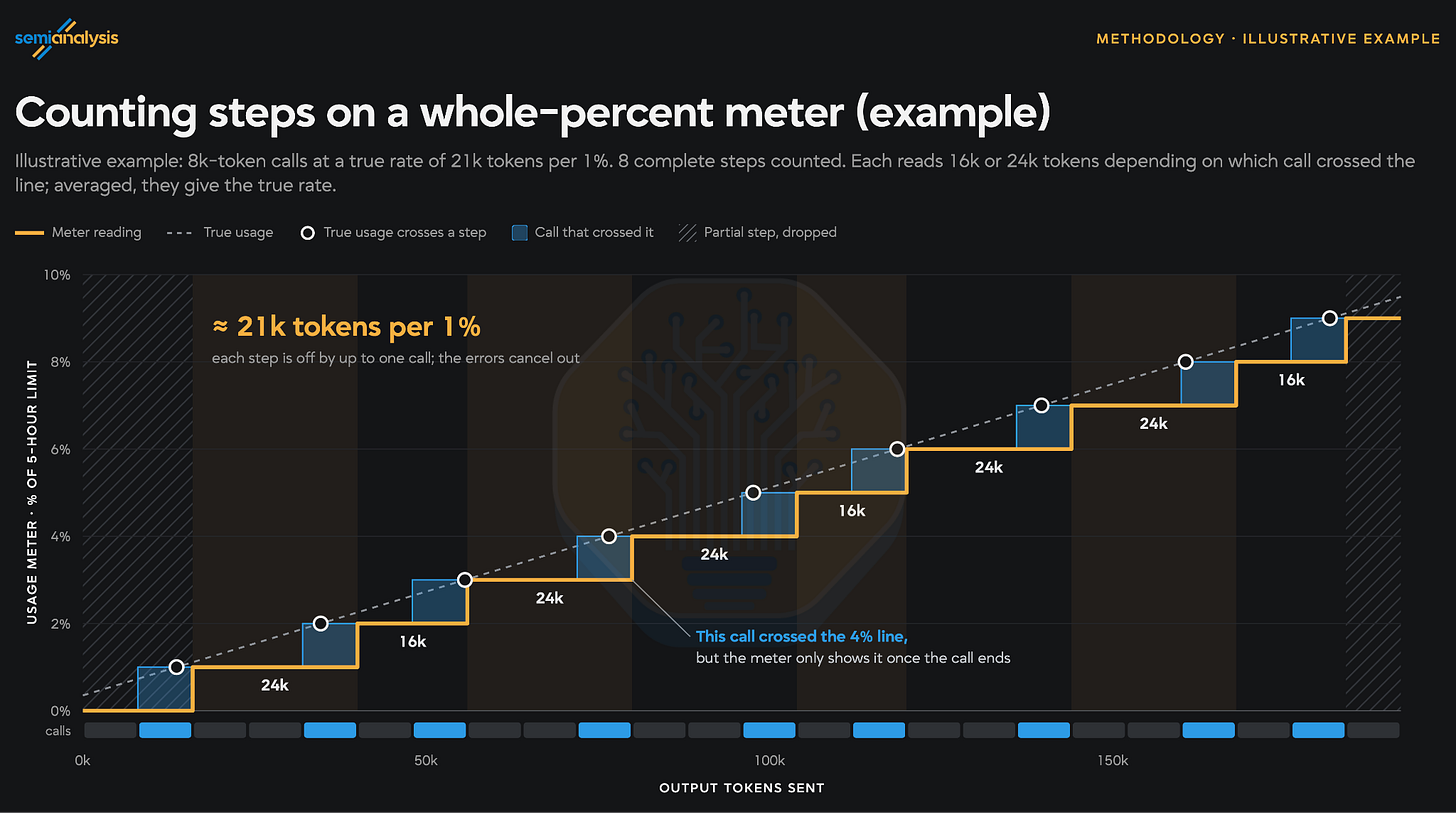
提供商通常用量表以固定增量来报告用量,可能是一整个百分点、一个积分(credit)、一美分等。单个请求往往根本不会让用量表移动,因此无法直接测量单个请求的成本。
相反,我们以「步」为单位来度量。当请求运行时,我们会持续累计已使用的 token 总数。每当计数器上升时,我们就记录下这个总数。计数器两次变动之间所使用的 token 构成一个「步」,也就是计数器移动一个单位所消耗的量。
我们会舍弃两个不完整的步。当一个运行开始时,计数器已经在通往下一次变动的路上了,因此第一次变动之前的 token 不足一整步,若计入会使速率显得偏高。而最后一次变动之后的 token 永远凑不满一整步,所以这部分也要舍弃。
为了得到速率,我们把完整步中计数器移动的总量相加,再除以这些步中消耗的 token 数。不同提供商对输入、输出和缓存 token 的计费方式不同,因此我们为每种类型分别计算速率。
Source: SemiAnalysis Tokenomics Model
注意事项:
由于每个请求只能看到一次计数器,单个步的误差最多为一个请求。这些误差不会随着连续步数的增加而累积,因此我们追踪的是一个区间而非单个数值,且统计的步数越多,区间就越窄。我们会持续累加步数,直到区间收窄到 ±5% 以内,然后报告覆盖所有这些步的速率。 没有任何请求只包含单一类型的 token。例如,某些套餐要求每个请求都附带一组指令。我们会使用其他类型 token 测得的单价,把这部分额外的量扣除。 在某些套餐中,读取缓存的成本几乎为零,甚至可能根本不会让计数器移动。如果在消耗 500M 缓存读取 token 之后计数器仍未移动,我们就认定缓存读取是免费的。 2. 将速率换算为每个窗口和每月的 token 数
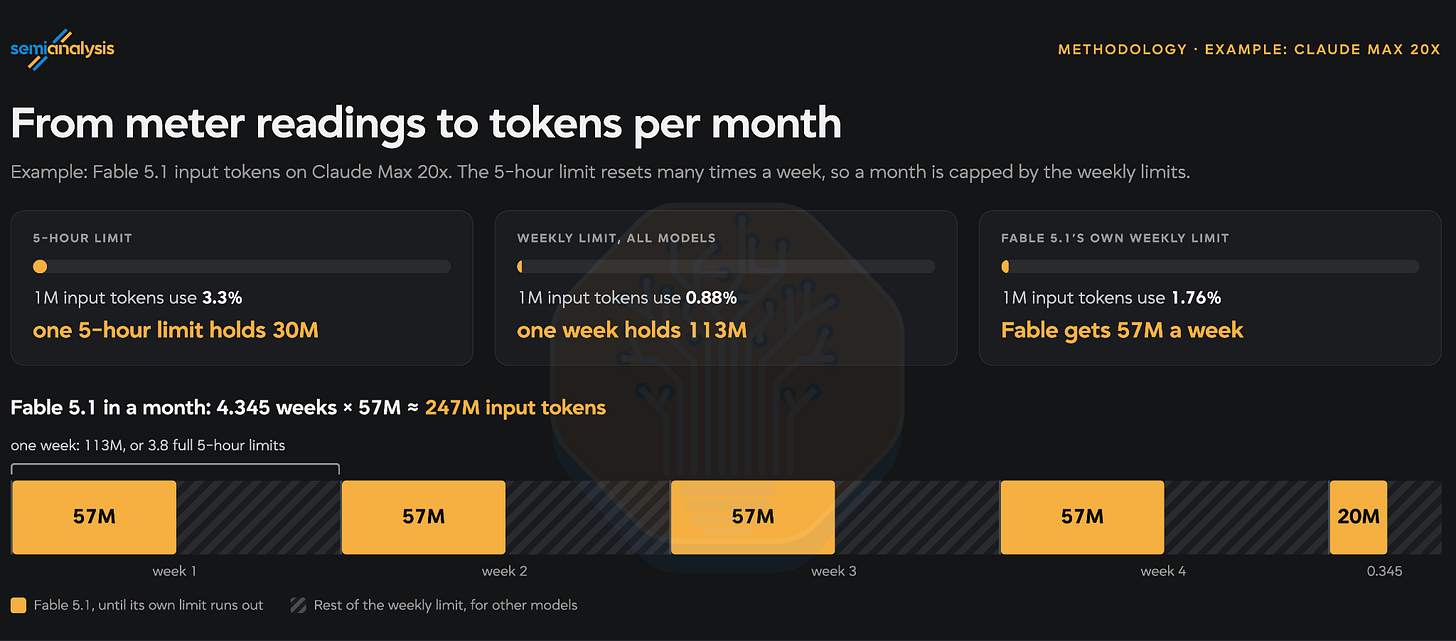
我们会读取套餐在每个请求之后显示的所有计数器。这可能是一个 5 小时限额、一个周限额,而对于像 Fable 这样的模型,还有其自身的周限额。这样一来,每种 token 类型在每个计数器上都会得到一个价格,即一百万 token 消耗该限额的多少。根据每个价格,我们可以推算出能容纳多少 token,例如:如果一百万 token 消耗某限额的 5%,那么整个限额可容纳两千万 token。
Source: SemiAnalysis Tokenomics Model
5 小时限额在一周内会重置多次,因此一个月的上限由周限额决定。
3. 定价
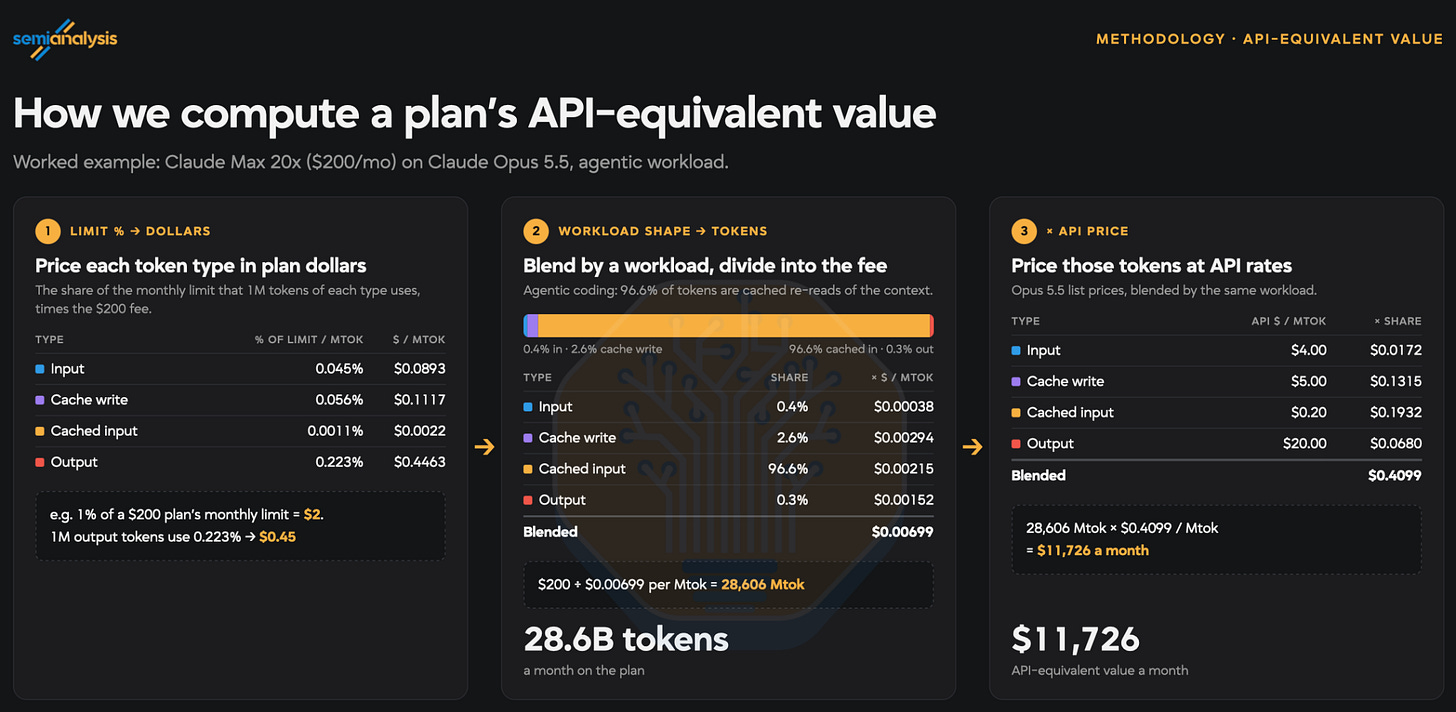
最后,我们通过将每种类型的一百万 token 所消耗的限额百分比换算成美元金额,来计算 API 等效价值。例如,如果你消耗了某个 200 美元套餐月限额的 1%,那就是 2 美元。
接下来,我们假设一种负载形态,并根据这一比例计算每个套餐总共能提供多少 token。对于 agentic 负载,我们采用《Tokenomics Model》中报告的我们自己在 9 月份的使用比例。
最后,我们乘以 API 价格下的每 MTok 混合单价,得到 API 等效价值。
Source: SemiAnalysis Tokenomics Model
捕捉提供商的 A/B 测试
在完善我们的方法论时,我们遇到了一个非常令人困惑的情况:针对某家提供商测试的 3 个相同订阅中,有 1 个的限额比另外 2 个低了约 20%。这个不走运的账号恰好也明显更老旧,我们一度担心该提供商采用了某种糟糕的设置,会根据账号的注册时长来调整订阅限额。
幸运的是,在联系该提供商后,我们确认情况并非如此。我们那个不走运的账号是他们正在进行的一项“规模极小”的限额 A/B 测试的一部分。此外,他们还特意强调,他们“并没有一刀切地全面降低限额”,而是在测试“如何更好地平衡用户触达限额的时机”。
这个结论之所以有趣,有两个原因:
它证明了提供商可以随时悄悄地更改订阅限额 我们的方法足够灵敏,能够检测到这些细微的变化! OpenAI 对比 Anthropic
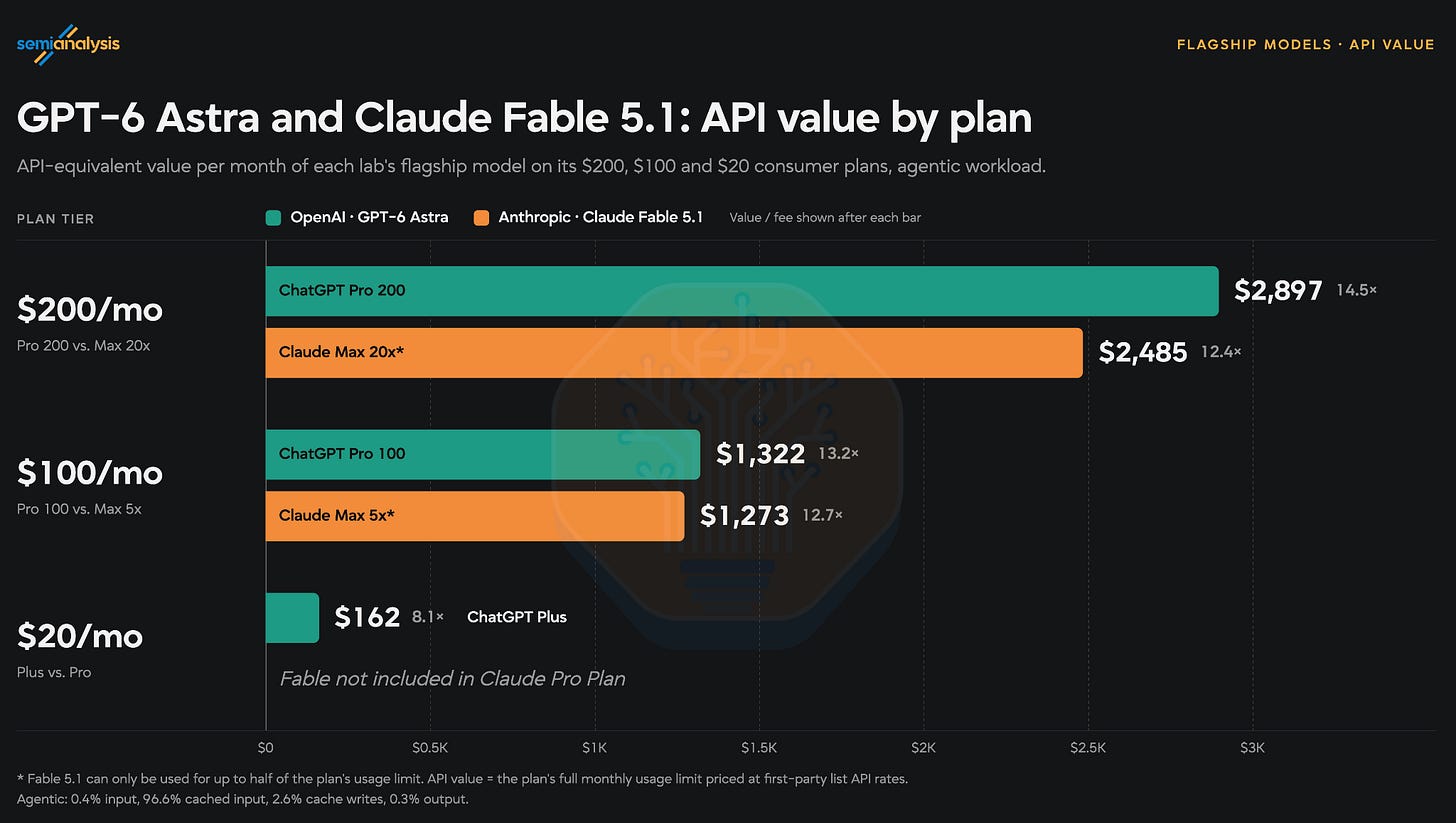
AI 订阅领域最大的问题是 Anthropic 的限额与 OpenAI 相比如何。请注意,OpenAI 上周刚对其订阅做出了重大调整:将 200 美元档位的 API 等效价值砍半,并推出了新的 500 美元档位。以下数字描述的是 OAI 与 ANT 的当前状态。之后,我们将深入分析 OpenAI 的近期调整。
Source: SemiAnalysis Tokenomics Model
总体而言,GPT-6 Astra 与 Fable 5.1 的限额相当接近,但请记住,Fable 只能使用你限额的 50%。换句话说,你的 200 美元 ANT 计划在消耗完价值 2,485 美元的 Fable 5.1 之后,仍会剩下 50% 的额度;而等价的 OAI 计划在用掉 2,897 美元的 Astra 之后就会完全耗尽。
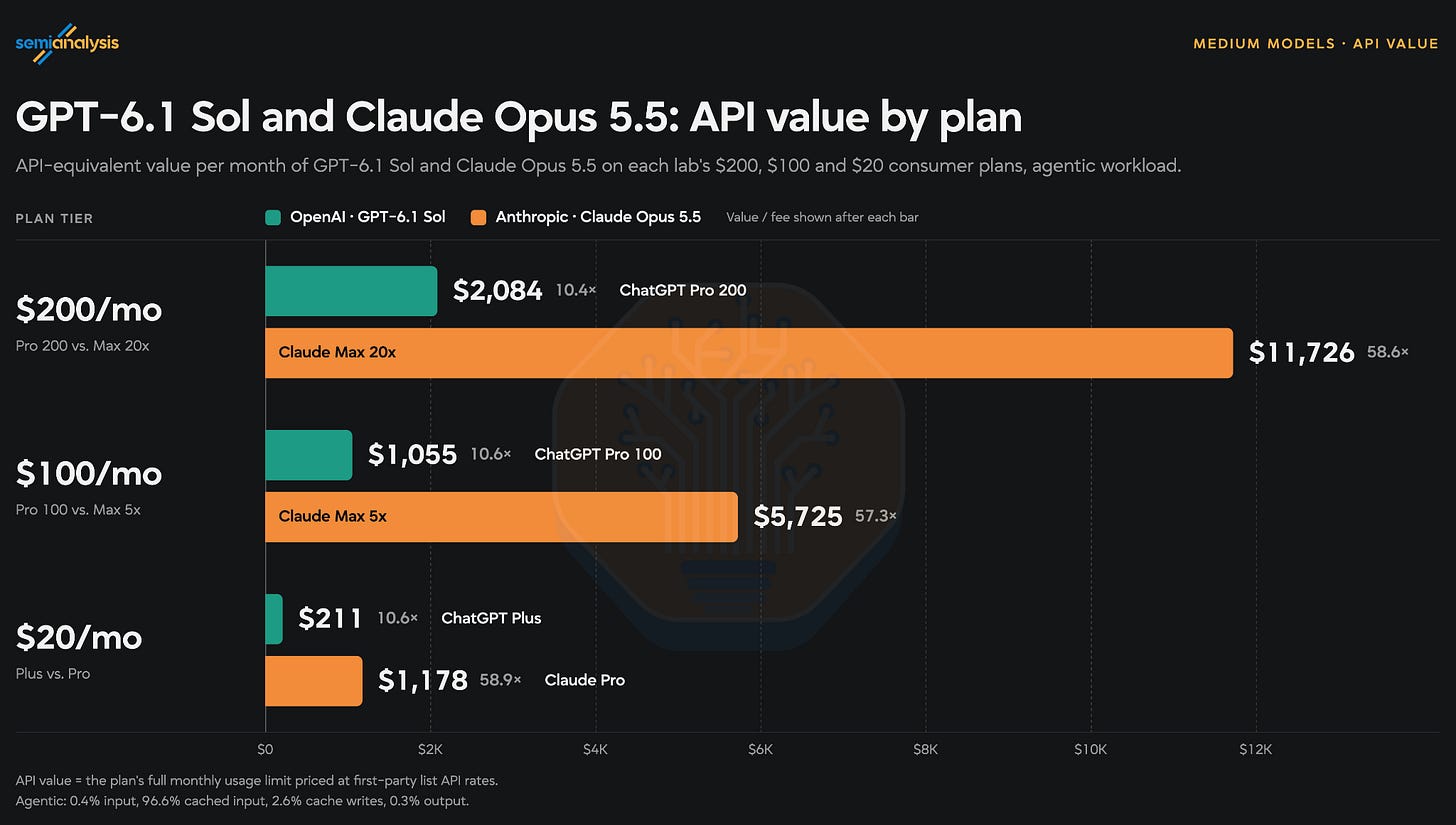
当我们比较 Opus 5.5 与 GPT 6.1 Sol 时,这额外的 50% 就开始变得非常重要了。
Source: SemiAnalysis Tokenomics Model
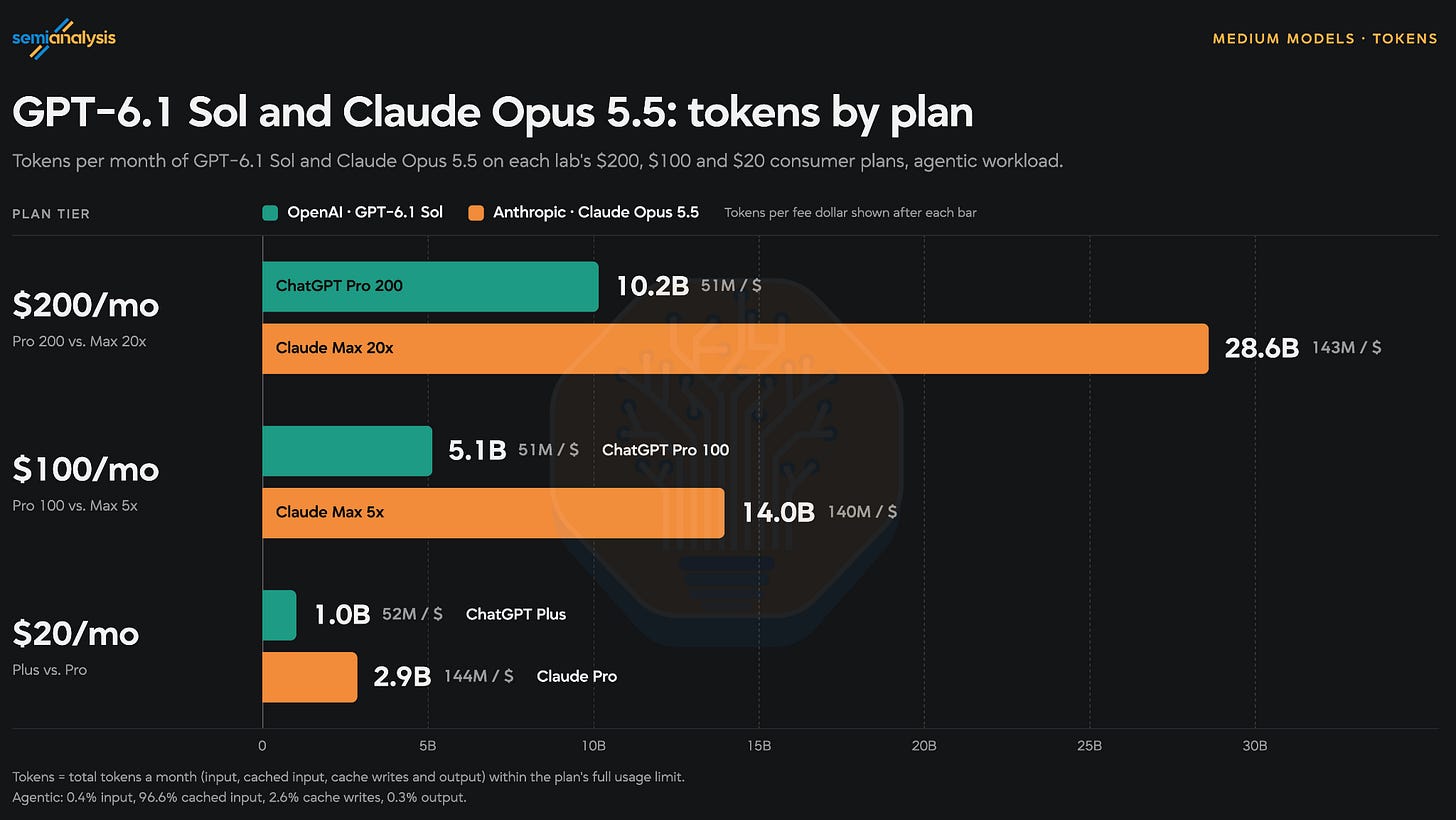
在这个中端模型层级——两家公司都将其宣传为大多数用户的日常主力模型——Anthropic 的性价比压倒性地更高,在各档位上都提供了约 5 倍的 API 等效价值。你可能会认为这对 OAI 不公平,因为 6.1 Sol 的单 token 价格比 Opus 5.5 便宜得多,但即便改用 token 数量来比较,差距依然巨大。
Source: SemiAnalysis Tokenomics Model
总体来看,我们认为 API 等效价值是衡量订阅计划“价值”的最佳单一指标,但某些情况下,原始 token 数量可能更为合适。例如,如果某个模型按 API 价格计算的性价比特别差(或特别好),那么 API 等效价值当然就会产生误导。
Token 效率也是一个极为相关的因素,但遗憾的是,业内缺乏这方面的可靠数据。很多人喜欢引用 Artificial Analysis 的这张图表,但我们认为 AA Intelligence Index 中的基准任务完全不能代表人们用 LLM 处理真实工作的场景。
OpenAI 新推出的 500 美元计划与大规模限额削减
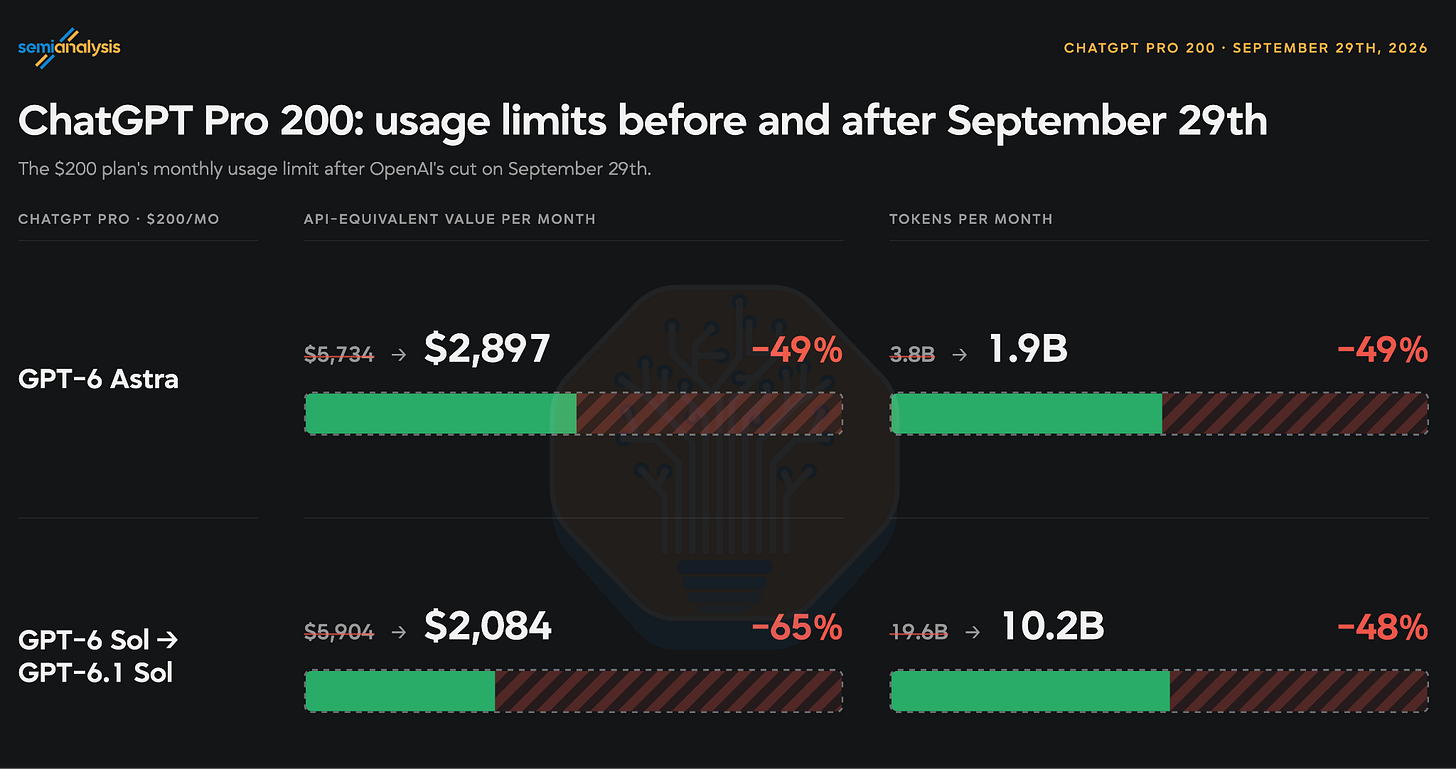
我们的追踪证实了 Tibo 宣布的 OpenAI 200 美元套餐价值缩减 50%。降价前购买的 200 美元套餐将保留旧的更高限额直到 10 月 29 日,但新购买的套餐会立即适用更低的限额。
Source: SemiAnalysis Tokenomics Model
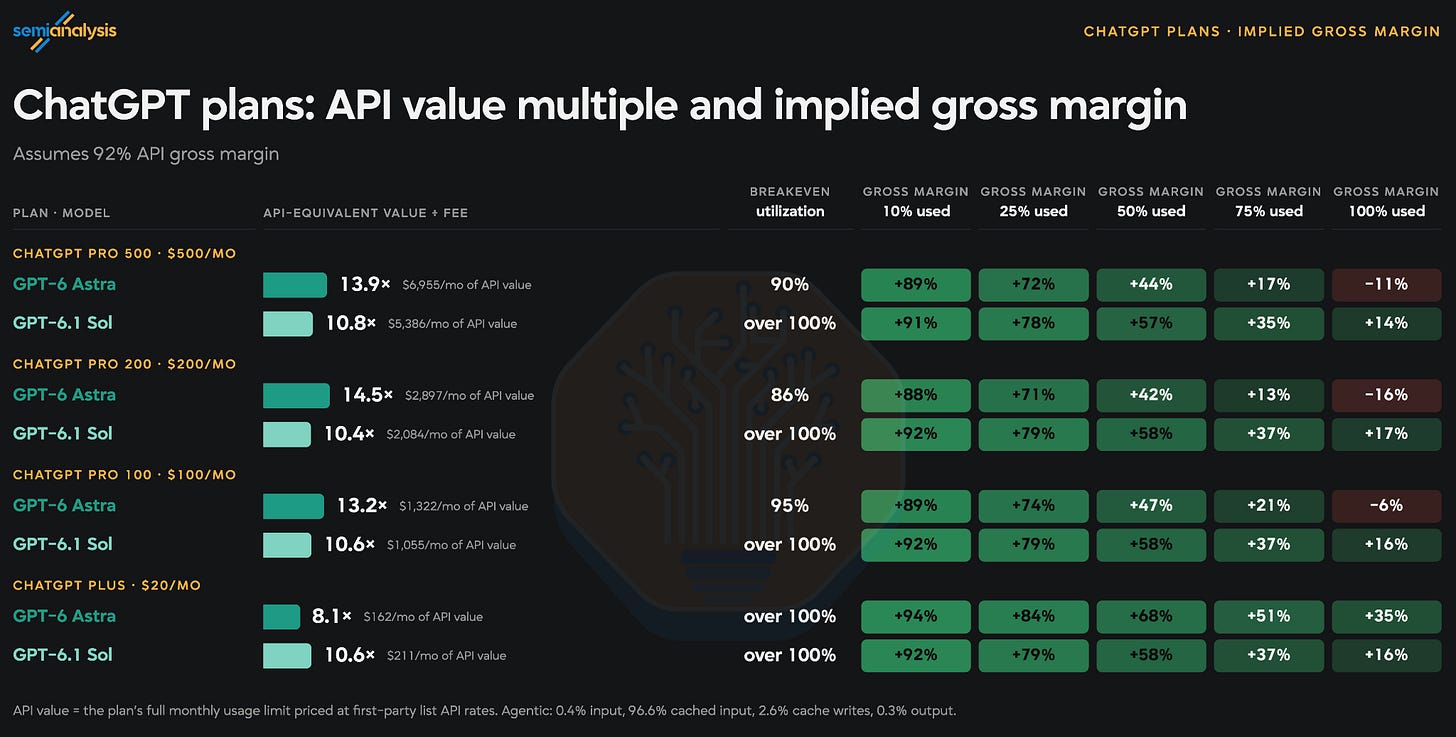
可以看到,OpenAI 精确地将每个模型档位的 token 数量砍半。这导致 Sol 级模型的 API 等效价值下降超过 50%,因为 OpenAI 同时还削减了 6.1 Sol 的缓存输入 token 价格。
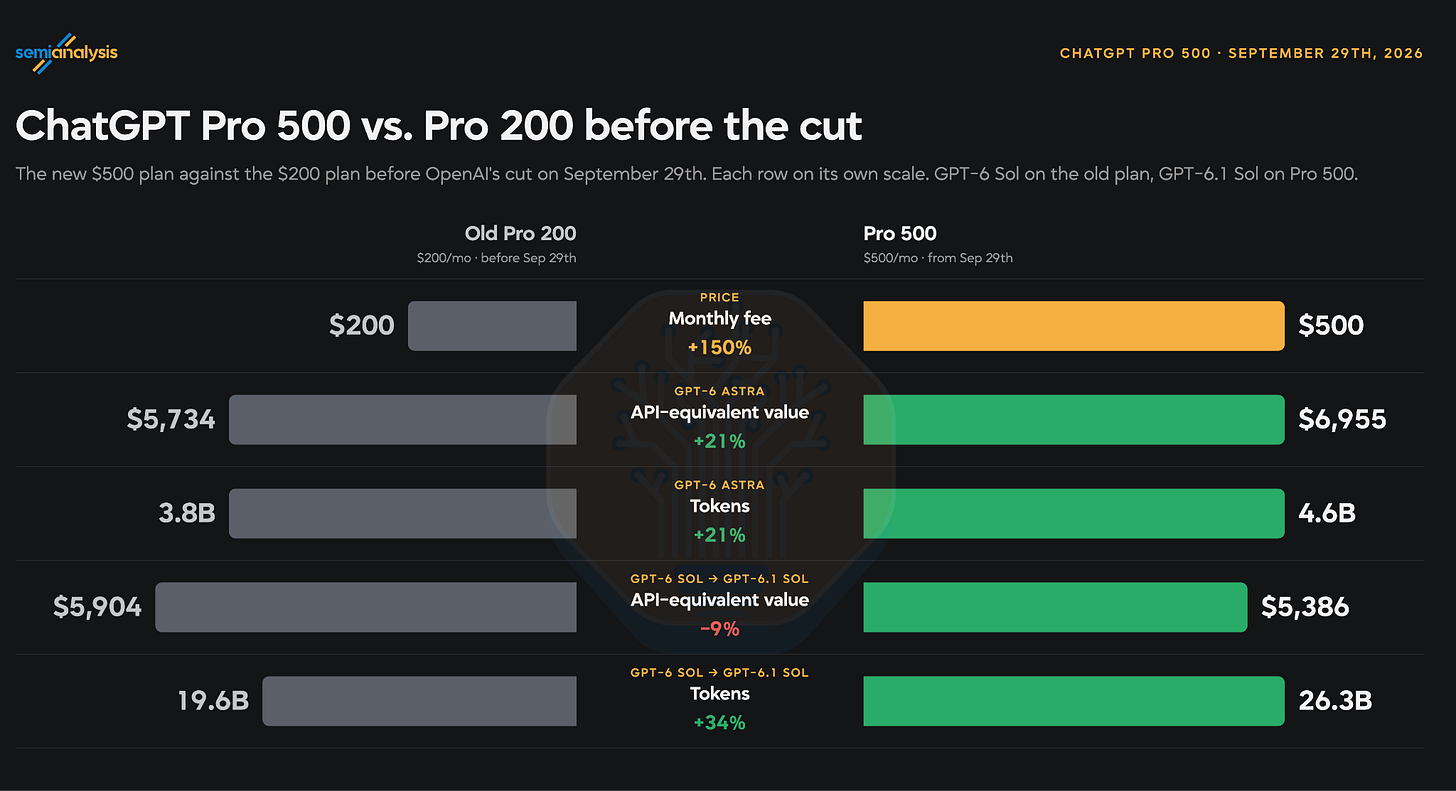
新的 500 美元套餐相比旧的 200 美元套餐,只多提供 21% 的 Astra 额度。有趣的是,由于上述 6.1 Sol 的降价,Sol 级模型的 API 等效价值反而下降了。
Source: SemiAnalysis Tokenomics Model
当然,300 TPS Ultrafast 才是 500 美元套餐真正的主角,我们目前正在测试其极限。结果一旦出来就会发布给 Tokenomics Model 订阅用户。我们也在积极测试在 Devin 等第三方应用上使用 ChatGPT 订阅时的限额表现。
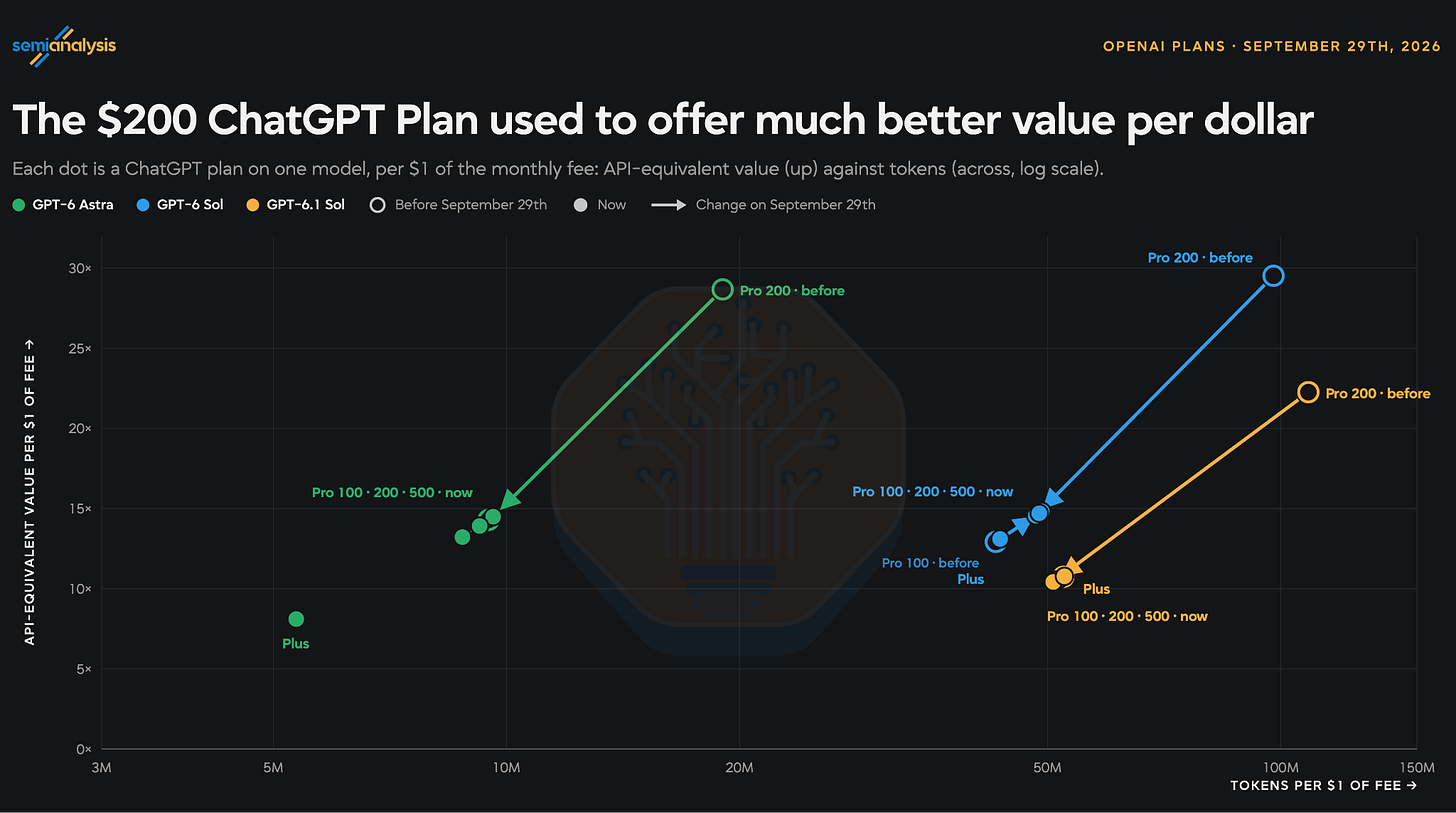
此外,200 美元/月的套餐过去获得的补贴也远高于 OpenAI 的其他订阅。如果我们将每个(套餐,模型)组合标准化为 API 等效价值和每美元 token 数,可以看到 Pro 100 在 Astra 上提供的每美元价值约为 Plus 的 2 倍,而 Pro 200 在所有模型上又比 Pro 100 高出约 2 倍。
Source: SemiAnalysis Tokenomics Model
经过上周的削减后,Pro 100、200 和 500 在每个模型上提供的每美元 token 数都相同。Plus 在 Sol 上也与之相当,但在 Astra 上的性价比相对更差。
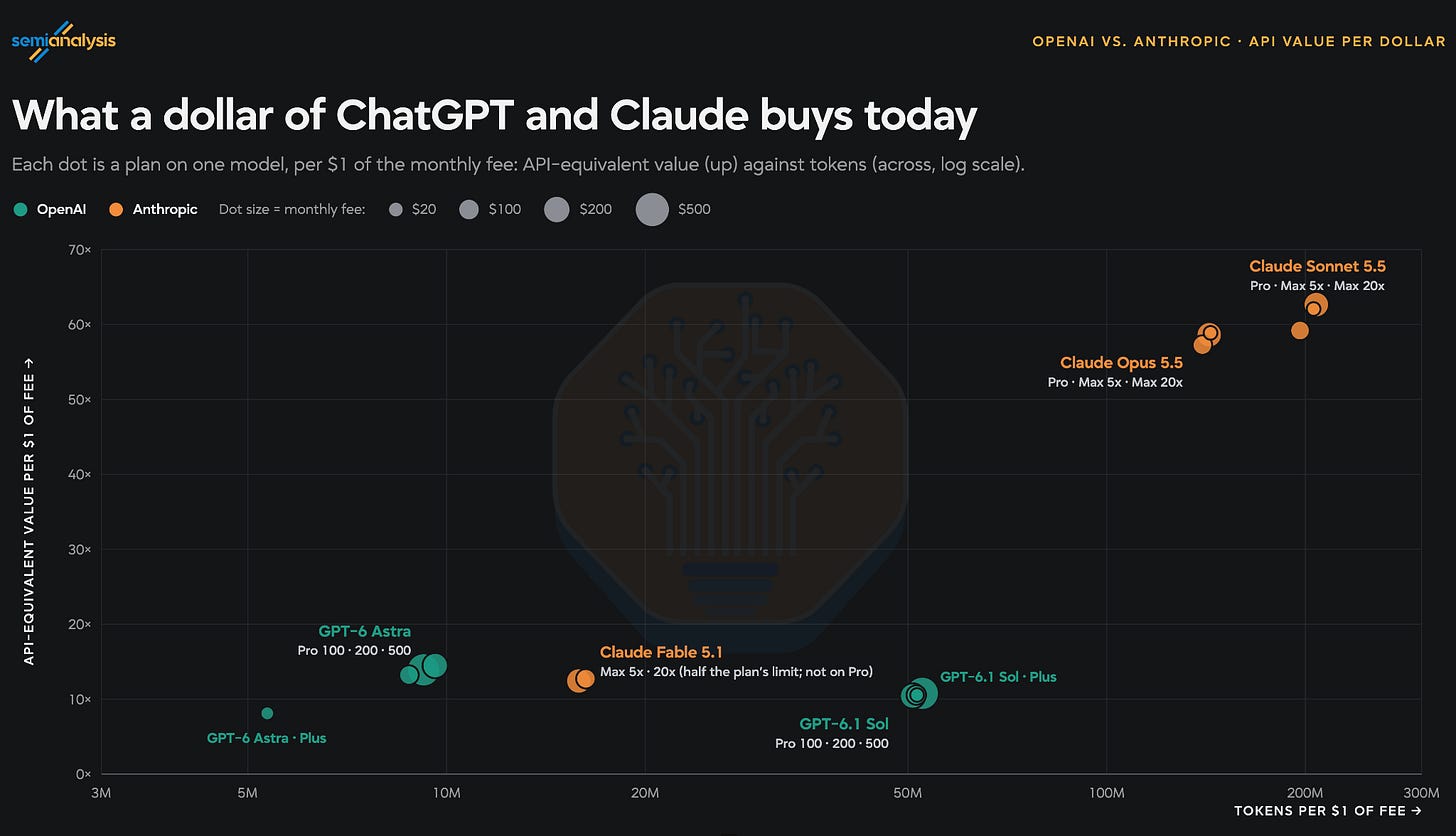
另一方面,Anthropic 早已在其所有订阅档位上提供相同的每美元价值,目前完全碾压 OpenAI。
Source: SemiAnalysis Tokenomics Model
OpenAI 过去曾因其相对 Anthropic 更慷慨的订阅限额而受到独立开发者的称赞,但如今这已不再是事实。任何 Claude 订阅上的 Opus 5.5 都能提供远超 OpenAI 任何套餐的价值。
OpenAI 唯一能拿出的反驳理由是,其 Pro 套餐都没有 5 小时限制,因此更容易消耗掉月度总限额的更高比例。然而,我们认为这并不能抵消 Claude 套餐上 Opus 5.5 提供的约 4 倍更高的 API 等效价值。
实验室会根据 API 价格变化调整订阅限额吗?
我们最近看到 Anthropic 和 OpenAI 模型出现了多次大幅降价。
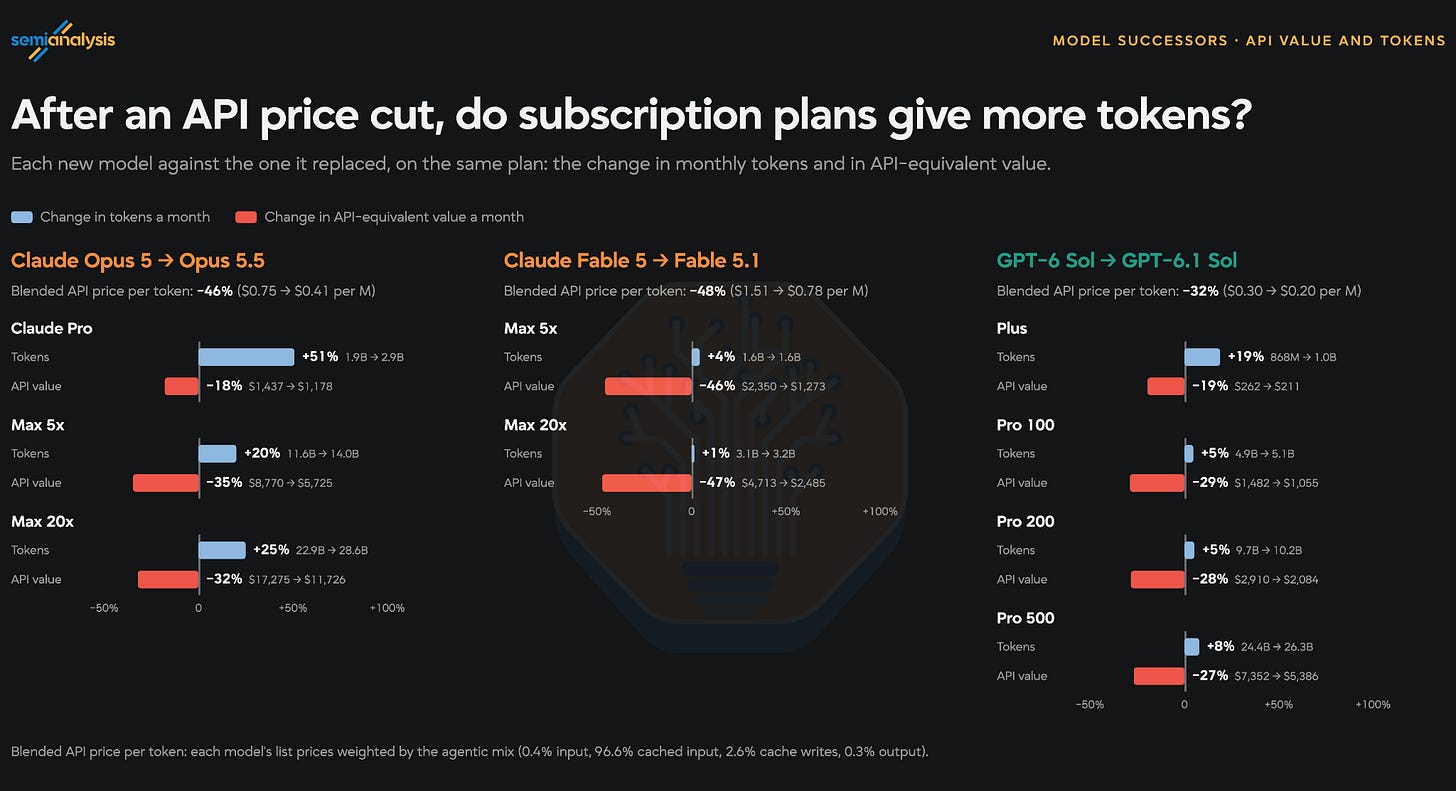
Fable 5.1 相比 Fable 5 将缓存读取价格降低了 75% Opus 5.5 相比 Opus 5 将输入和输出 token 价格降低了 20%,缓存读取降低了 60%。 GPT 6.1 Sol 相比 GPT 6 Sol 将缓存读取价格降低了 50%。此前 GPT 6 Sol 已比 5.6 Sol 便宜 60-67%。 一个重要问题是,实验室是否会在这些降价之后调整 token 限额,从而使订阅的 API 等效价值保持不变。
我们之前已经证明,OpenAI 在发布 6.1 Sol 时并未调整 200 美元/月套餐的 Sol token 限额,这导致 API 等效价值下降了约 30%。
Anthropic 在发布 5.1 时也完全没有提高 Fable 的 token 限额,但在 5.5 降价的同时确实上调了 Opus 的 token 限额。
Source: SemiAnalysis Tokenomics Model
然而,Max 套餐约 20% 的 token 增量以及 Pro 套餐约 50% 的增量,并不足以完全抵消 API 降价的影响。
提升订阅业务利润率的两种不同路径
正如本文开头所解释的,订阅业务的毛利率远低于 API 业务,并且显著降低了 OpenAI 和 Anthropic 每兆瓦(MW)的收入。两家公司都清楚地意识到了这一点,但在减少对订阅用户的补贴上,它们选择了两种截然不同的策略。
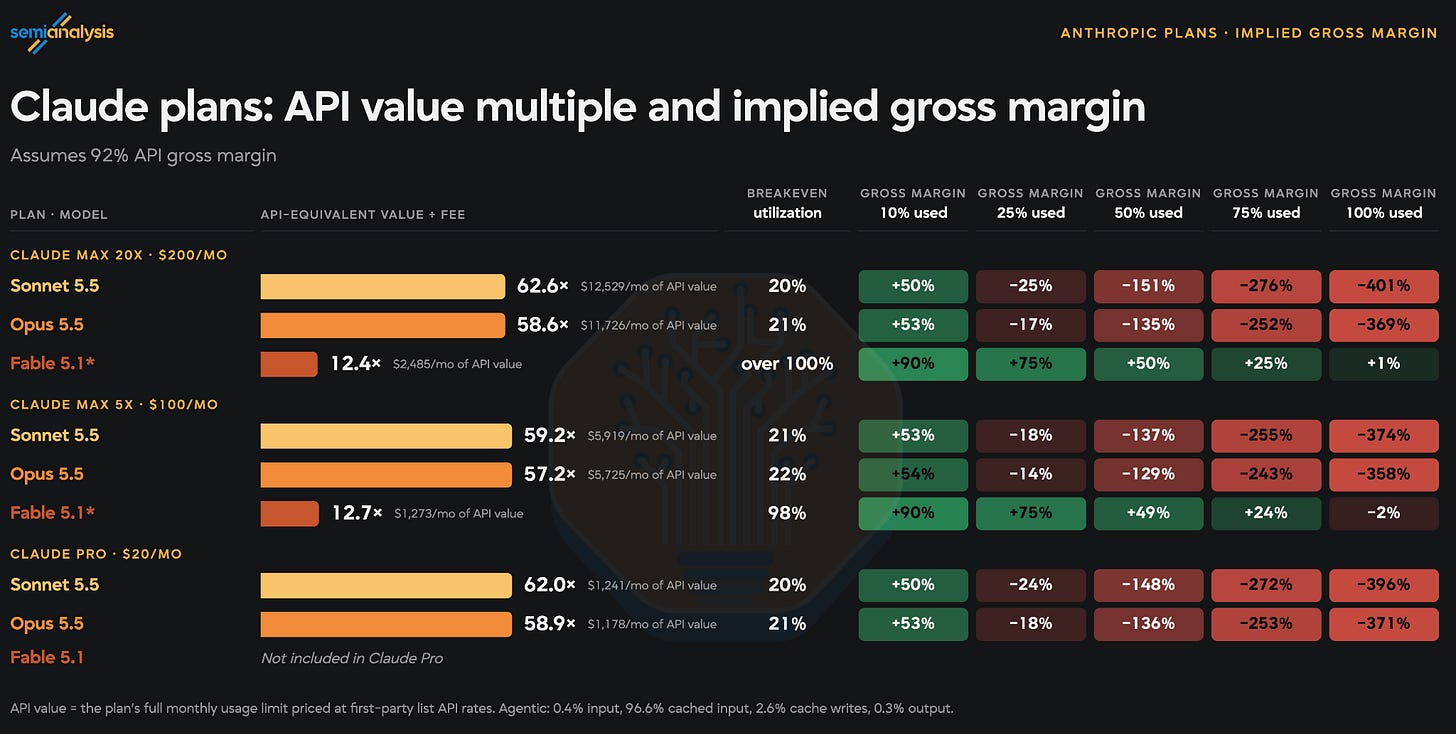
对于同一档位的套餐,Anthropic 降低了高端模型的 API 等效价值。从 Sonnet 5.5 到 Opus 5.5,降幅还比较小,但在 Fable 5.1 上就变得非常明显。
Source: SemiAnalysis Tokenomics Model
在以更高标价发布更强大模型的同时降低其 API 等效价值,是停止补贴订阅业务的一种更为隐蔽的方式。假设利用率为 100%、API 毛利率为 92%,那么将 Opus 5.5 与 Fable 5.1 的用量用到上限,对应的毛利率分别为 -369% 和 1%。如果采用更符合实际的 20% 平均利用率,则毛利率分别升至 6% 和 80%。
换句话说,如果所有人都只使用 Fable,Anthropic 的订阅套餐很可能已经能实现软件级别的利润率。随着 Anthropic 找到让模型变小的方法,Opus 级模型的推理成本会持续下降;而 Fable 之上的新模型层级,其订阅限额会更低(前提是这些模型还能被纳入订阅套餐)。
另一方面,OpenAI 则选择了“核弹级”方案——直接全面下调至 Fable 级别的限额。
Source: SemiAnalysis Tokenomics Model
这种做法的弊端本应是引发公众强烈反弹,但 OpenAI 却不知为何基本完全避开了这一点。这可能是因为 DevDay 上大量正面宣传淹没了前一天传出的负面消息,加上让现有套餐再享受一个月的过渡期,两者共同起了作用。
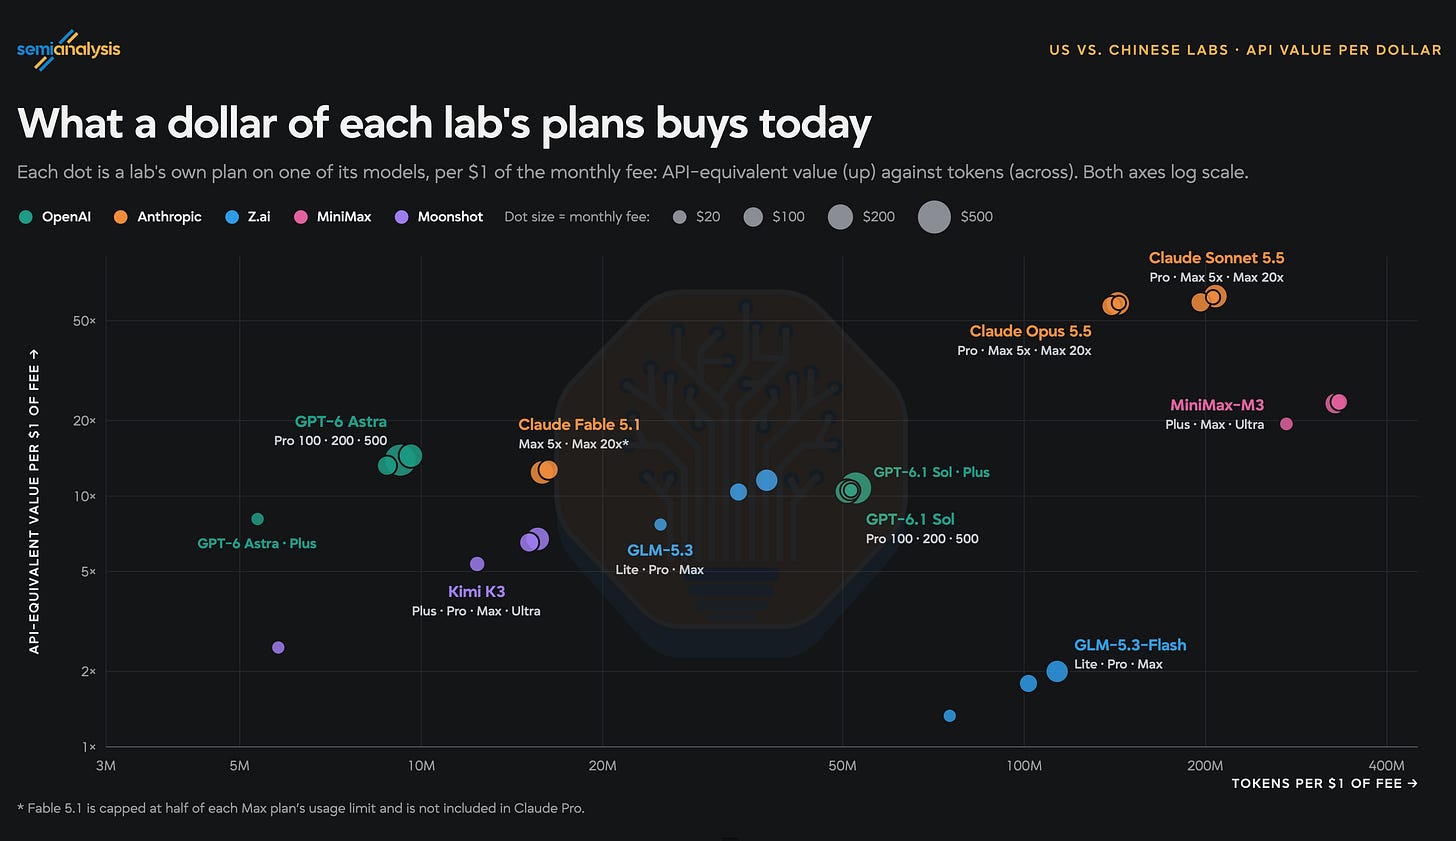
中国厂商的订阅套餐依然很划算
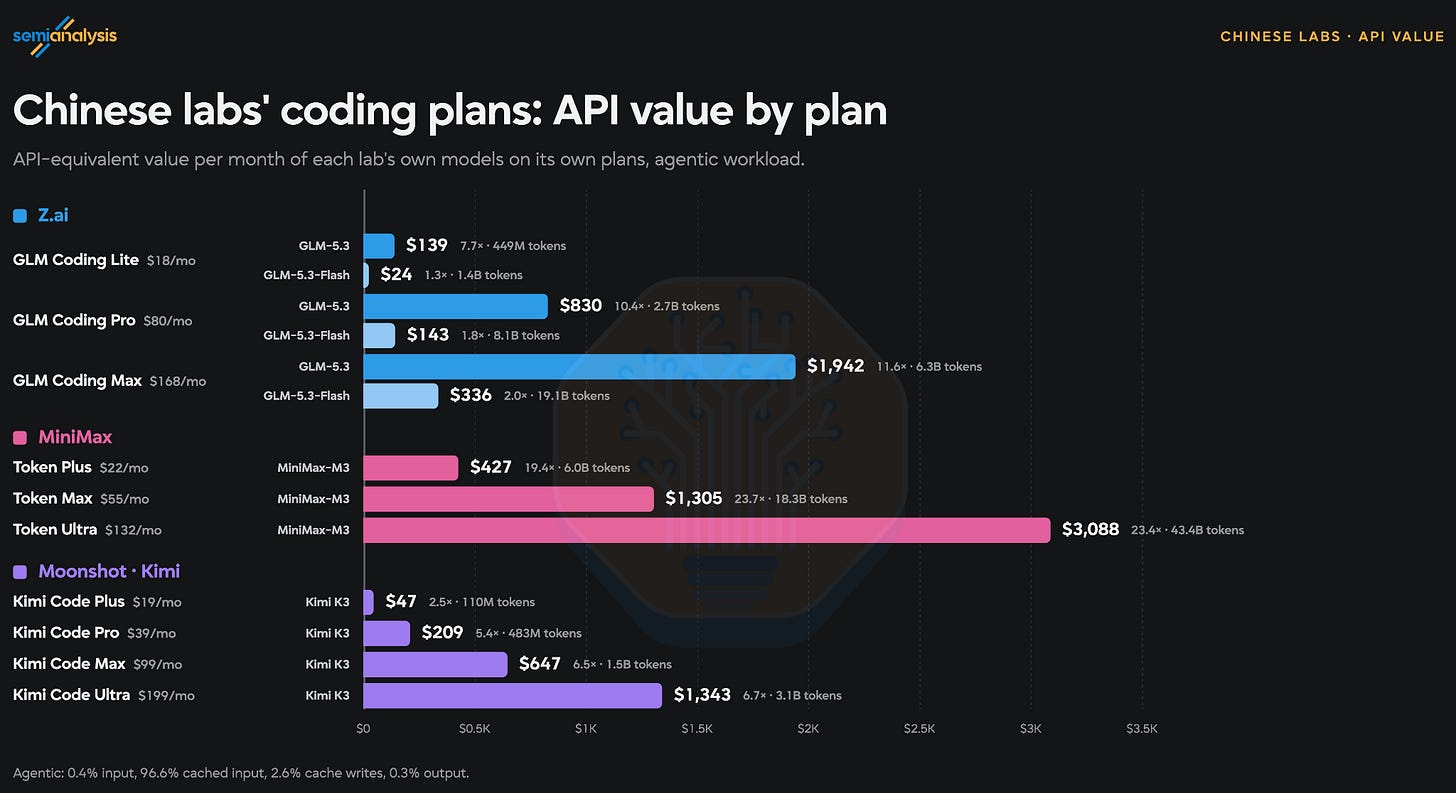
尽管算力资源匮乏,中国各家实验室仍然提供带补贴的订阅套餐,但不同模型之间的补贴力度差异极大。
Source: SemiAnalysis Tokenomics Model
以下是在按每美元归一化之后,它们与 OpenAI 和 Anthropic 的对比情况。
Source: SemiAnalysis Tokenomics Model
在中国厂商那里,购买的订阅套餐档位越高,每美元获得的价值就越多。平均来看,每美元的 API 等效价值略低于 OpenAI 提供的约 12 倍水平。
第三方套餐不如第一方划算
我们要考虑的最后一项对比是:OpenAI 和 Anthropic 的模型在自家第一方套餐上,与 Cursor、Cognition(Devin)等第三方套壳服务上的表现对比。