← 全部文章
Inside GLM-5.3: How Sparse Attention Affects DRAM Memory TAM
2026-09-28 · 原文
稀疏注意力如何影响 DRAM/NAND 内存
稀疏注意力如何影响内存(包括 HBM 和 NAND)的 TAM(总可用市场)?稀疏注意力会选出与当前计算最相关的 top-k 个 token 进行注意力计算,从而降低核心的缩放点积注意力(SDPA)操作过程中的内存消耗和带宽需求。然而,这种效率提升在实践中并不能直接转化为整体内存的节省。具体来说,top-k 选择操作通常要求完整上下文保存在 HBM 中,因此稀疏注意力并不能消除内存容量瓶颈。
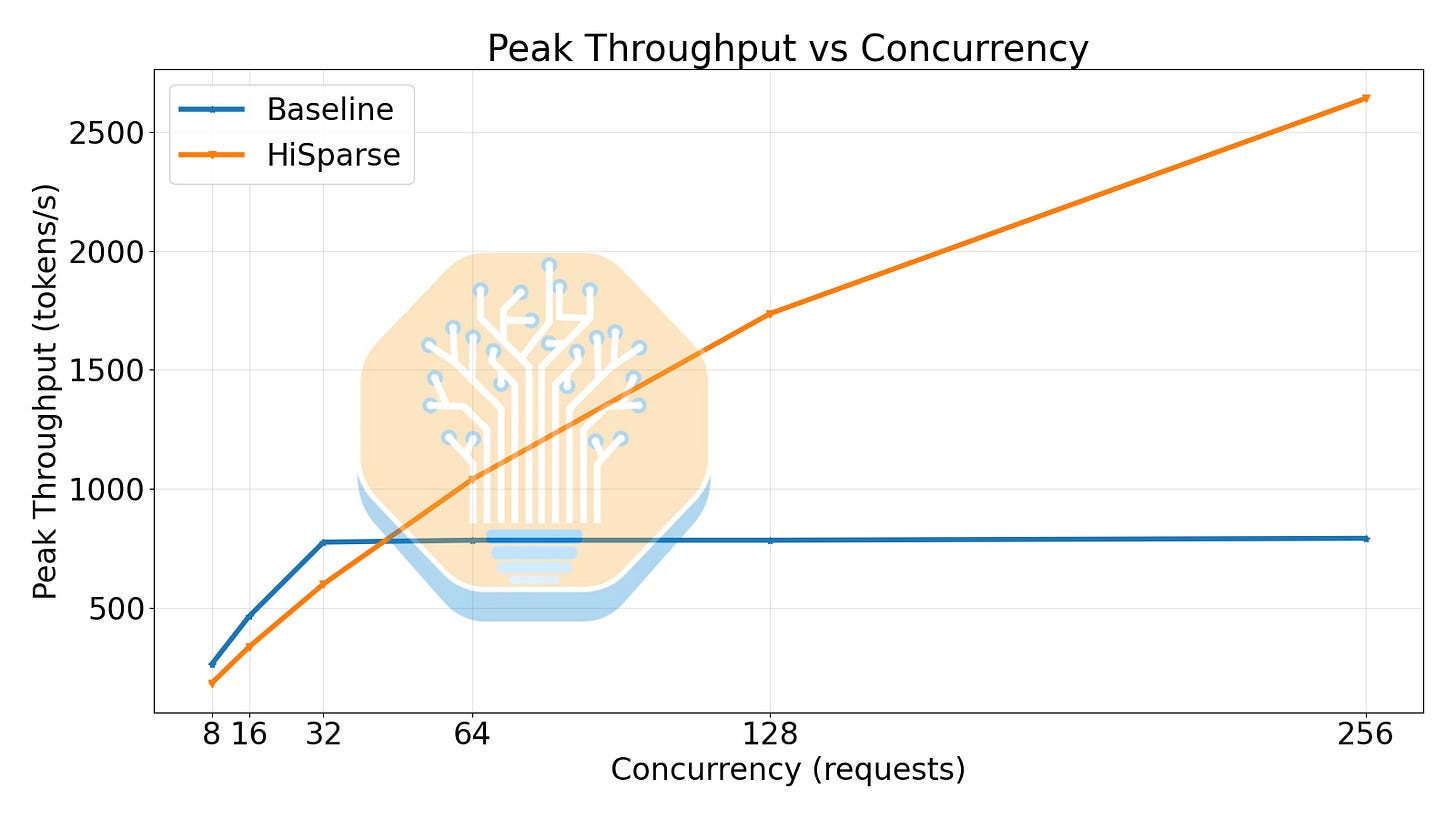
Sparse attention throughput is bottlenecked by memory capacity. Source: HiSparse
为了克服这一限制,SGLang 团队设计了 HiSparse,一种分层内存系统,可以主动将 KV cache 条目从设备端 HBM 卸载到主机端 DRAM。HiSparse 的行为类似于 LRU(最近最少使用)缓存:当 top-k 选择发生缓存未命中时,它将 token 从 DRAM 加载到 HBM;同时按照 LRU 淘汰策略将 token 从 HBM 卸载到 DRAM。为了降低缓存未命中延迟,HiSparse 将第 N 层的 KV cache 加载与第 N-1 层的执行重叠起来(逐层重叠),这一机制来自 HiSparse 的前身工作 HiCache。
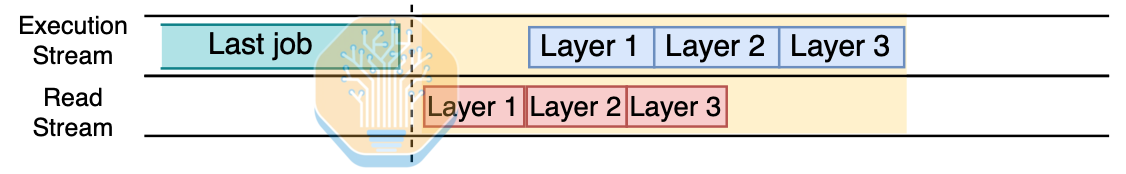
Layer-wise overlapping. Source: CachedAttention
借助 HiSparse,SGLang 在高并发和长上下文场景下大幅提升了吞吐量,代价是 top-k 缓存未命中带来的 I/O 开销。
稀疏注意力降低了 SDPA 操作中 KV cache 的内存和带宽需求,但并未减少整体内存容量占用。此外,HiSparse 表明系统级优化能够克服稀疏注意力的内存容量限制,因此仅凭稀疏注意力的内存特征并不足以完整刻画系统 KV cache 的效率全貌。为了更全面地展示稀疏注意力模型的推理服务情况,下面我们介绍 Z.ai 的 GLM-5 系列模型的设计,以及它们在实际中的服务方式。
GLM5.3 Agentic 推理服务
在我们的实时基准排行榜 InferenceX 中,GB300 在 150 tokens 每秒的响应速度下,在我们的对比中实现了最低的建模服务成本。GB300 每 GPU 能处理更多 token,尽管其每小时成本更高,但在成本效率上仍领先于 GB200。GB300 的结果使用 Dynamo-TRT-LLM,而 GB200 的结果使用 Dynamo-SGLang。
我们使用 9 月 28 日的 AgentX 快照结果来帮助说明 GLM-5.3 的服务影响。我们使用 InferenceX 的超大规模数据中心基础设施自有与运营成本模型来估算成本。总 token 数包括输入和生成的输出,其中包括跨轮次复用的缓存输入历史。流式速度采用 p90 交互性指标衡量;首 token 时间(TTFT)单独评估。
在 150 tokens 每秒的速度下,GB200 每百万总 token 的成本约为 0.044 美元,而运行 ATOM 的 MI355X 为 0.049 美元。在相同的流式速度目标下,成本约低 12%。这些数值是根据实测曲线估算的,而不是在恰好 150 tokens 每秒下单独测试得出的。
在本次对比中,我们采用 InferenceX 对超大规模数据中心级别基础设施的持有和运营成本的估算值。总 token 数包含输入和生成的输出,其中包括从缓存中复用的输入历史。
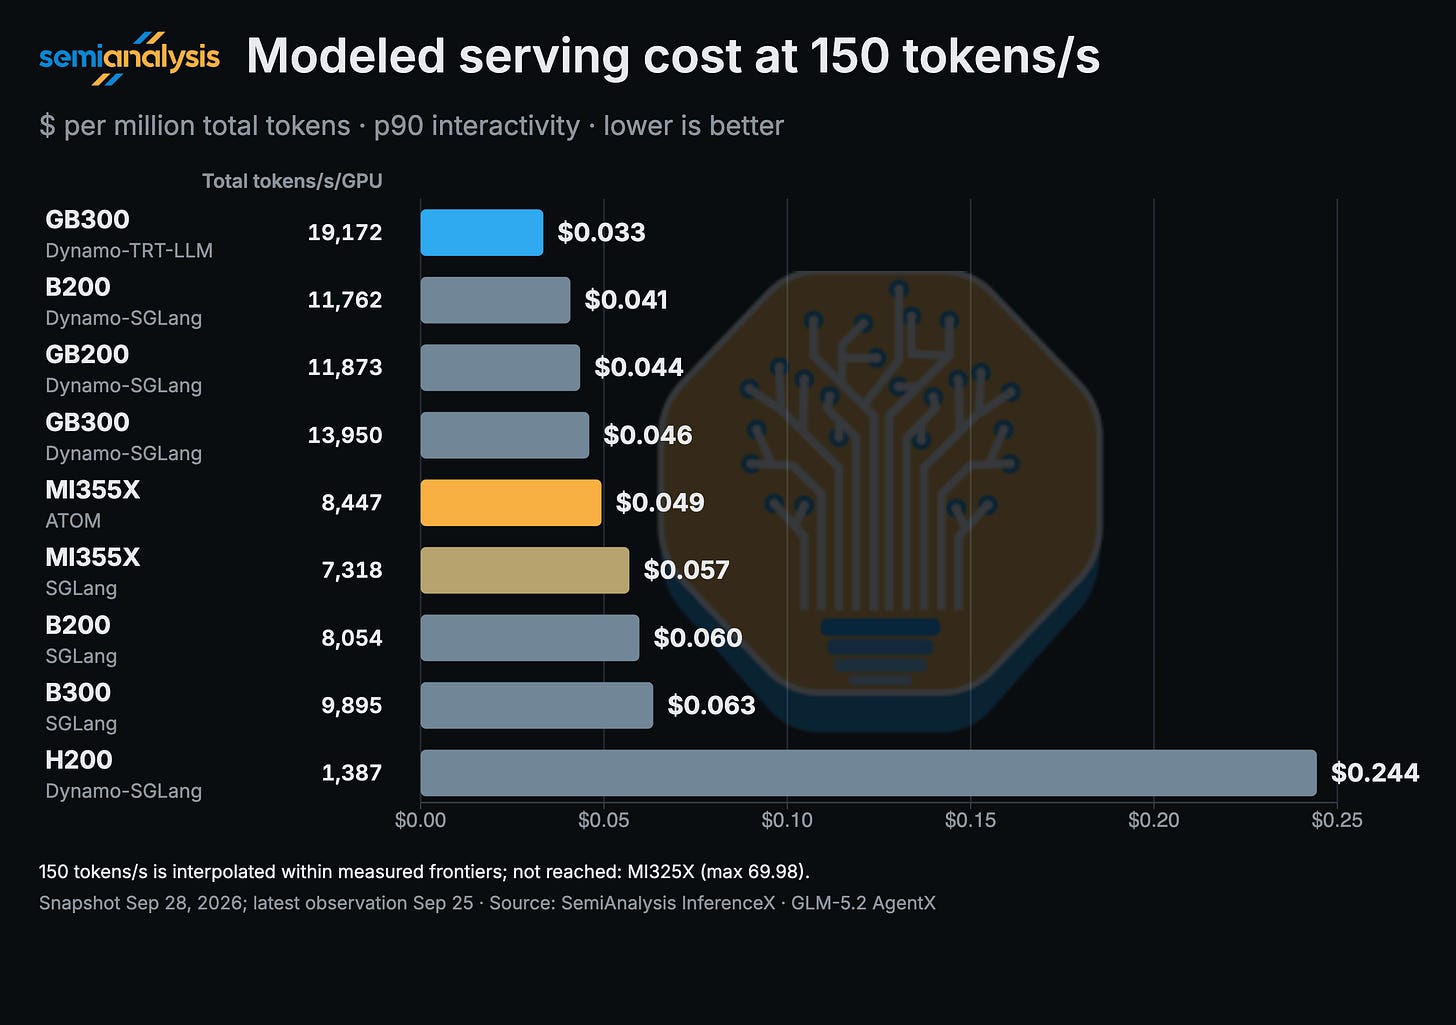
Source: InferenceX | SemiAnalysis
在 Dynamo-SGLang 的结果中,GB300 在此场景下每 GPU 每秒可处理约 13950 个总 token,相比 GB200 的 11873 个总 token 有 17.5% 的吞吐优势。但我们假设 GB300 的成本为每 GPU 小时 2.31 美元,而 GB200 为 1.86 美元。在该目标下,更高的每小时成本抵消并超过了 GB300 的吞吐优势。
与 AMD 相比,ATOM 在 100 token 每秒的速度下比 GB200 便宜约 13%。而在 125 token 每秒时 GB200 便宜约 5%,在 150 token 每秒时便宜 12%。在这三个目标速度下,两套系统都没有统一稳定的成本优势。
仅统计生成的输出时,在 150 token 每秒的响应速度下,GB200 每百万输出 token 的成本为 5.92 美元,比 MI355X ATOM 的 6.68 美元低约 11%。这一指标有助于分析智能体(agentic)工作负载下的成本,因为在这类负载中,智能体会反复复用较长的输入历史,同时生成的新文本相对较少。
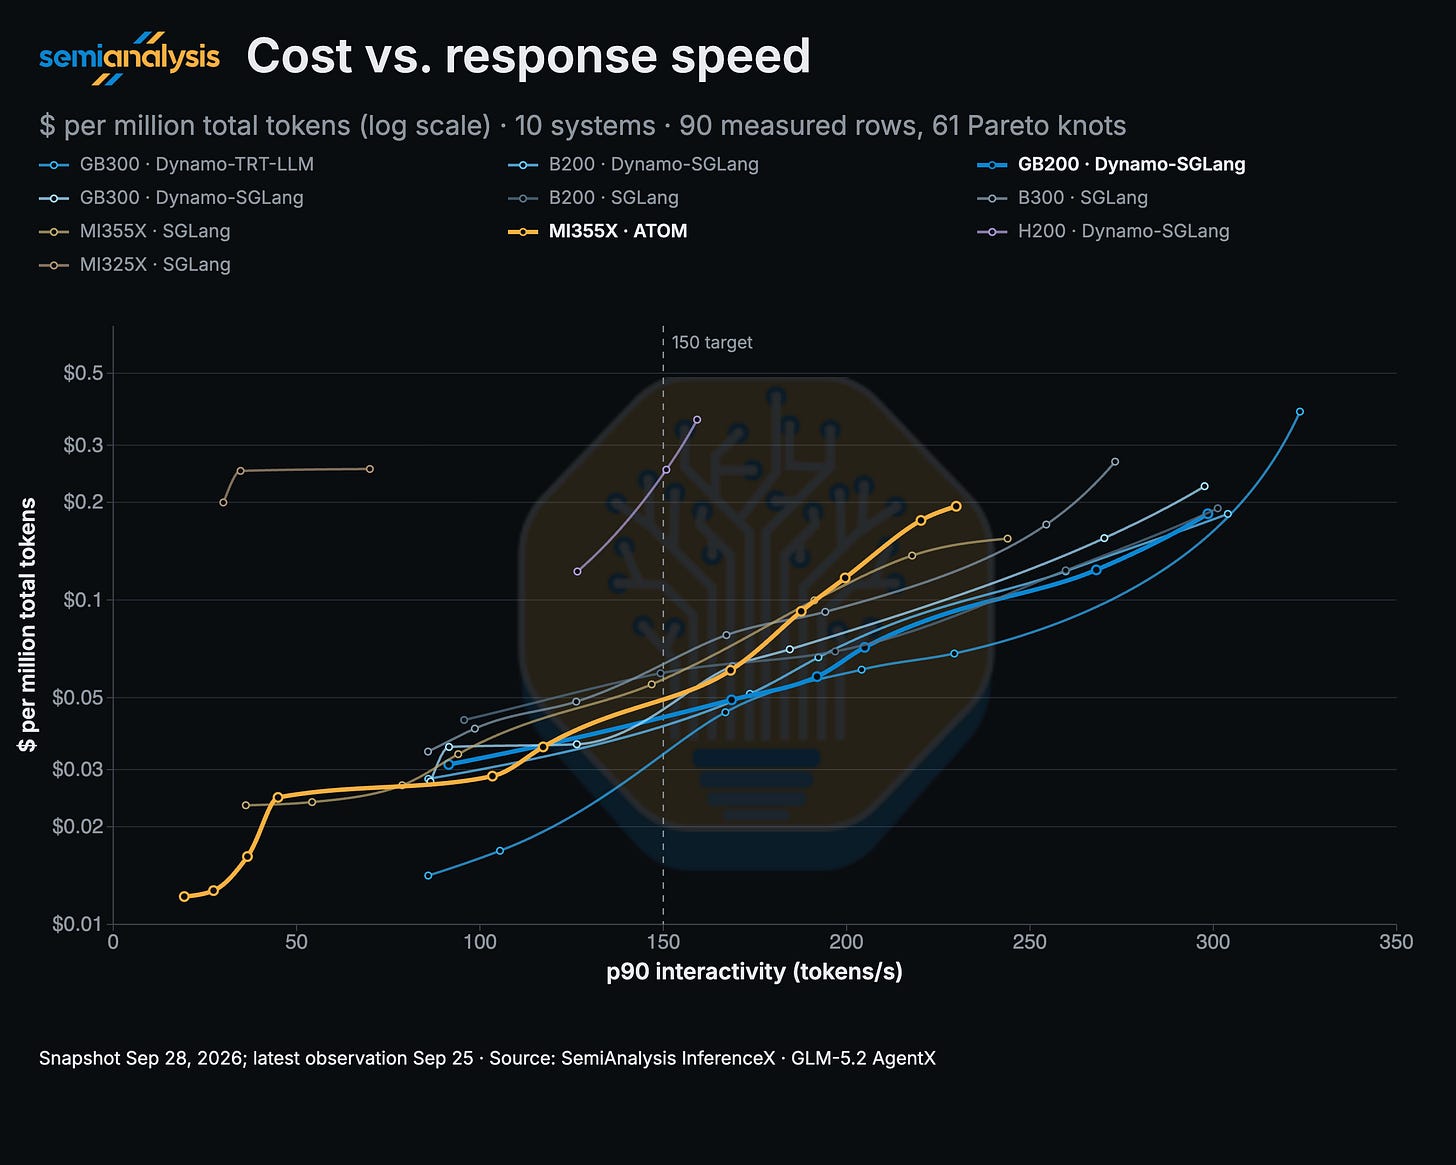
Source: InferenceX | SemiAnalysis
在 150 token 每秒目标两侧的 GB200 测量结果中,p90 TTFT(首 token 时间)约为 14–19 秒,而 MI355X ATOM 约为 1.1–1.2 秒。GB200 的一些最低成本运行会出现长得多的首 token 等待时间。
因此,我们进行第二次对比,只使用实际测试过且达到至少 150 token 每秒、同时 p90 TTFT 不超过两秒的配置。下图显示,带 ATOM 的 MI355X 每百万总 token 成本为 0.0607 美元,而带 Dynamo-SGLang 的 B200 为 0.0666 美元。在两秒首 token 限制下,ATOM 便宜约 9%。如果将限制放宽到十秒,带 Dynamo-TRT-LLM 的 GB300 就有资格参与比较,其成本为 0.0451 美元,比 ATOM 的 0.0607 美元低约 26%。
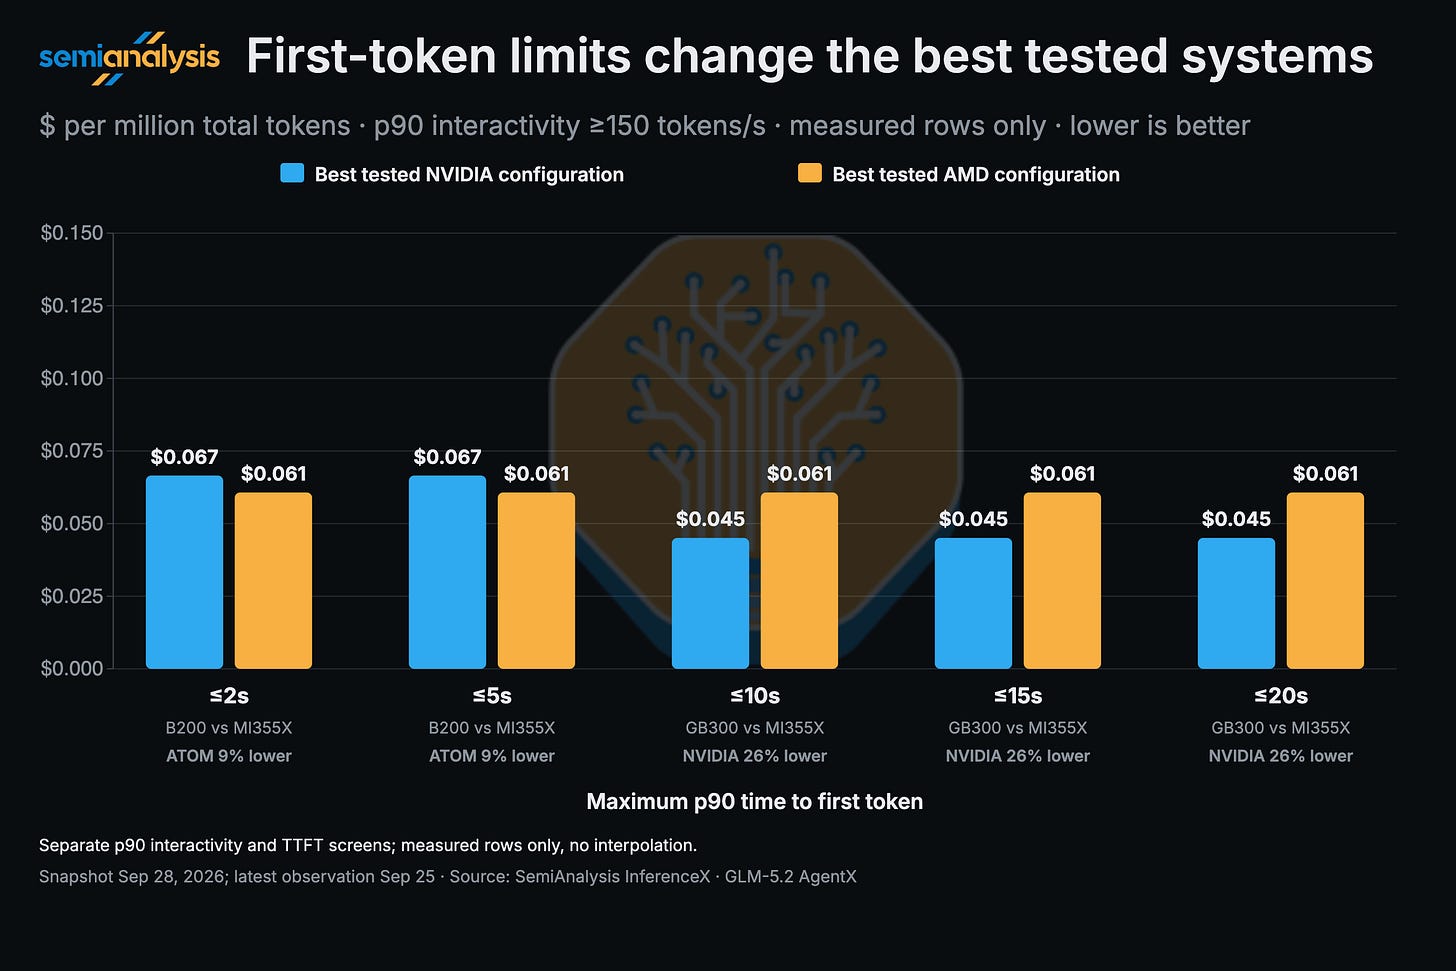
Source: InferenceX | SemiAnalysis
优化
在 GLM 的 5.2 / 5.3 模型中,其注意力架构降低了内存需求,而长时间运行的智能体仍需保留较早的对话历史。GLM 通过两种方式降低处理这些历史的开销:KV 压缩减少了每个 token 缓存的状态量,稀疏注意力则减少了每次注意力操作需要读取的状态量。然后由服务引擎决定缓存存储在哪里,以及如何高效地检索它。
这些 B200 结果展示了有多少复用可以发生在 GPU 显存之外。当并发数从 8 个请求增加到 16 个时,从 GPU 显存复用的 prompt token 占比从 90.3% 下降到 54.8%。其中大部分复用转移到了主机内存,其占比从 6.0% 上升到 40.3%。GPU 缓存的下降大部分被主机内存的复用所抵消,使整体缓存命中率在所有并发级别下都保持在 95% 以上。
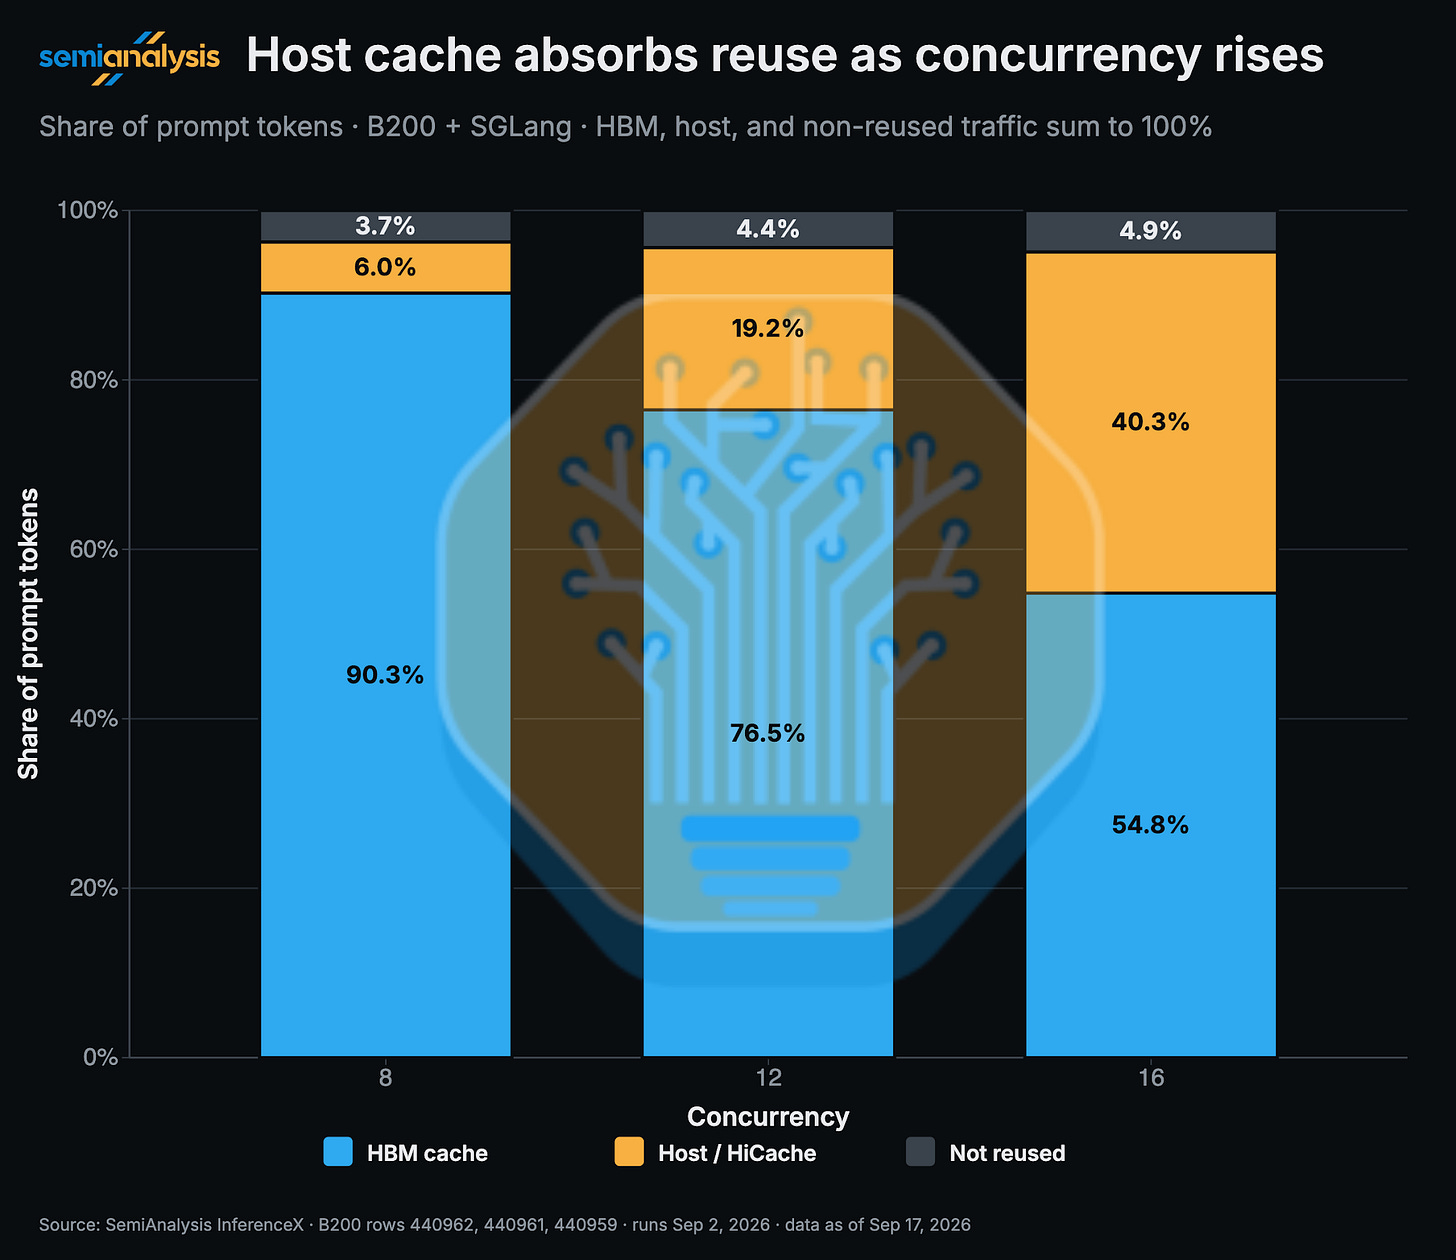
Source: SemiAnalysis InferenceX; InferenceX B200 rows 440962 , 440961 , and 440959 ; workflow run 33683520699
除缓存管理外,服务引擎执行 prefill 和解码方式的改变也会影响性能。两项关于 GLM-5.2 的独立研究说明了这一点:
- 在一项 NVFP4 研究中,vLLM 让首个解码步骤保持在一致的 CUDA graph 执行路径上,将平均 TPOT(每输出 token 耗时)从约 40 ms 降低到了 22 ms。
- 在另一个 8 卡 MI355X 长上下文工作负载上,ATOM 引擎将 prefill 按流水线阶段分块处理,使总吞吐量提升了 98%,并将 TTFT 中位数从 28.6 秒降至 8.7 秒。
TileRT
对于 TileRT 上的 GLM5.3,AMD MI355X 最先获得支持。TileRT 是一个低延迟 LLM 推理引擎,它将解码编译为单个持久化 kernel,从而减少启动开销,并让计算、内存访问与通信相互重叠执行。
它优先追求更快的单用户 token 生成速度,而非最大的批量吞吐量,而 prefill 则由 vLLM 处理。
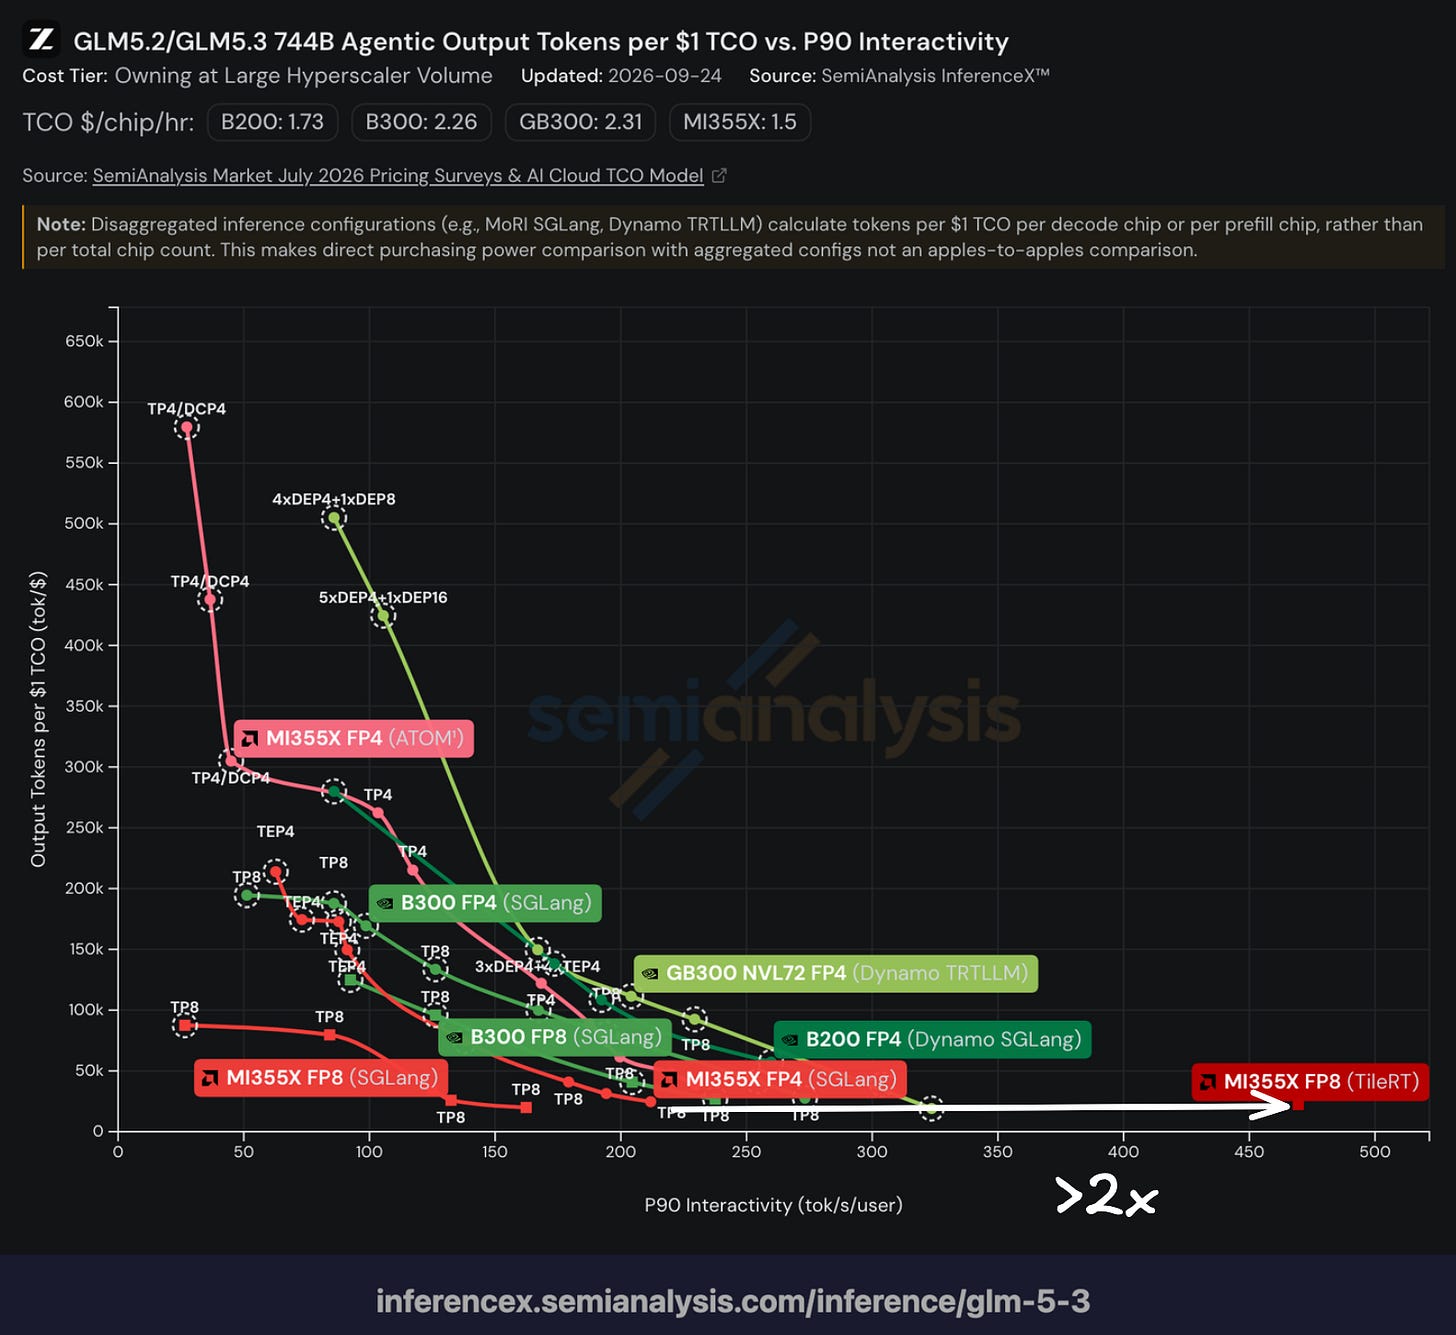
在 AgentX 上,FP8 的 TileRT MI355X 实现的 P90 交互性是最佳 FP4 MI335X 配置的 2 倍。与 GB300 NVL72 相比,它带来了 40% 的交互性提升。这些服务指标过去通常需要专用硬件才能达到。
不过,TTFT 仍然不够理想,还有进一步发展的空间,例如优化 KV 传输、支持 FP4 以及更大的 batch size。
DeepSeek Sparse Attention
GLM-5(以及 GLM-5.x 系列模型)是一个总参数量 744B、激活参数量 40B 的混合专家(MoE)模型。对每个 token 而言,它有 1 个共享专家,并从 256 个专家中路由到 8 个,稀疏度为 32。它采用了 DeepSeek Sparse Attention,本节将对此进行讨论。
DeepSeek Sparse Attention(DSA)由 DeepSeek V3.2 引入,包含两个组件:一个用于选取 top K token 的 lightning indexer,以及一个稀疏的 Multi-Latent Attention(MLA)。
Lightning Indexer
lightning indexer 在功能上类似于一个轻量级的注意力机制。Queries 和 keys 会被投影到较低维度,其中 indexer 的 queries 是多头(multi-headed)的,而 indexer 的 keys 是单头(single-headed)的。由于选取 top K token 只需要 query 和 key 之间的关系分数(logits),indexer 不需要 value embedding,也不需要对 logits 做 softmax 归一化。相反,它计算 query 与 key 的点积,再经过一个 ReLU 非线性变换。然后,indexer 将所有 query 头上的 logits 加权求和,得到每个 token 的 indexer 分数,我们用它来选取 top K token。这意味着尽管 indexer 有多个头,token 的选取是在多个注意力头之间共享的。在选取 top K token 时,对于关注 token 数少于 K 的 queries,我们会保留为 dense attention;否则则选取 top K。
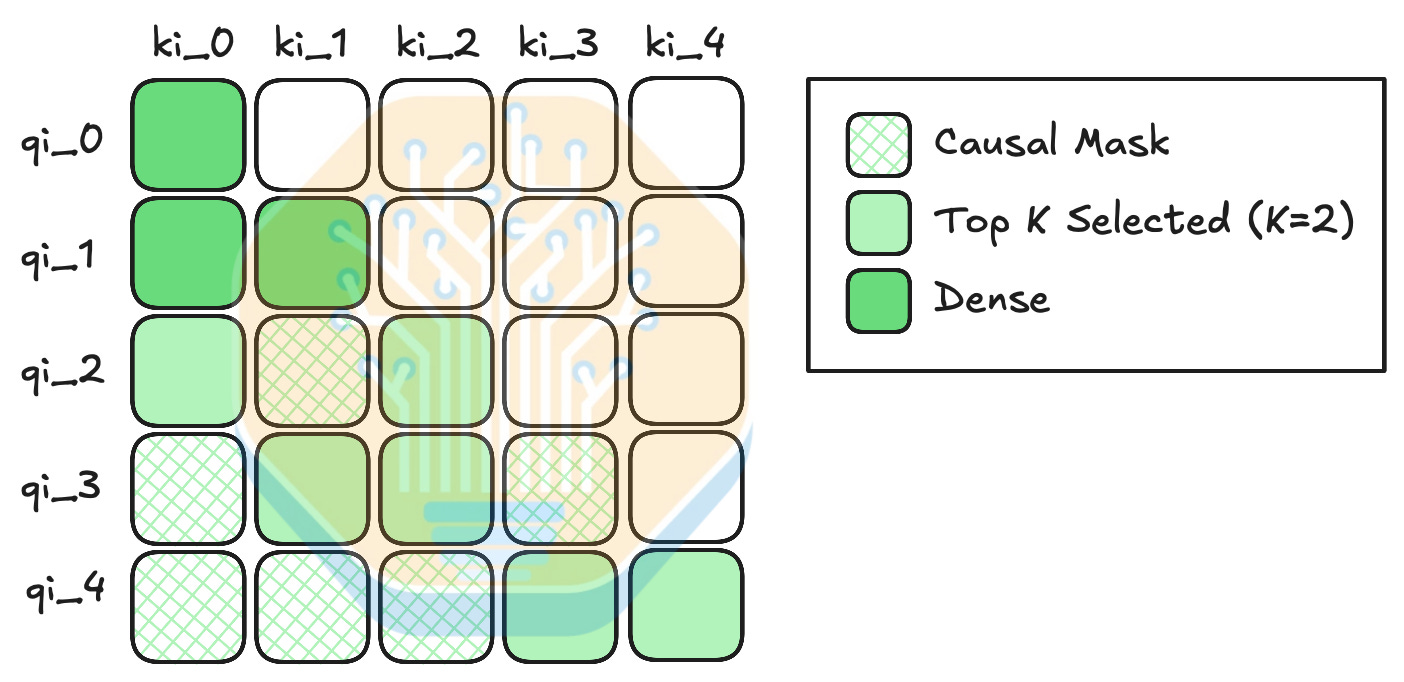
Conceptual example of the lightning indexer. Source: SemiAnalysis
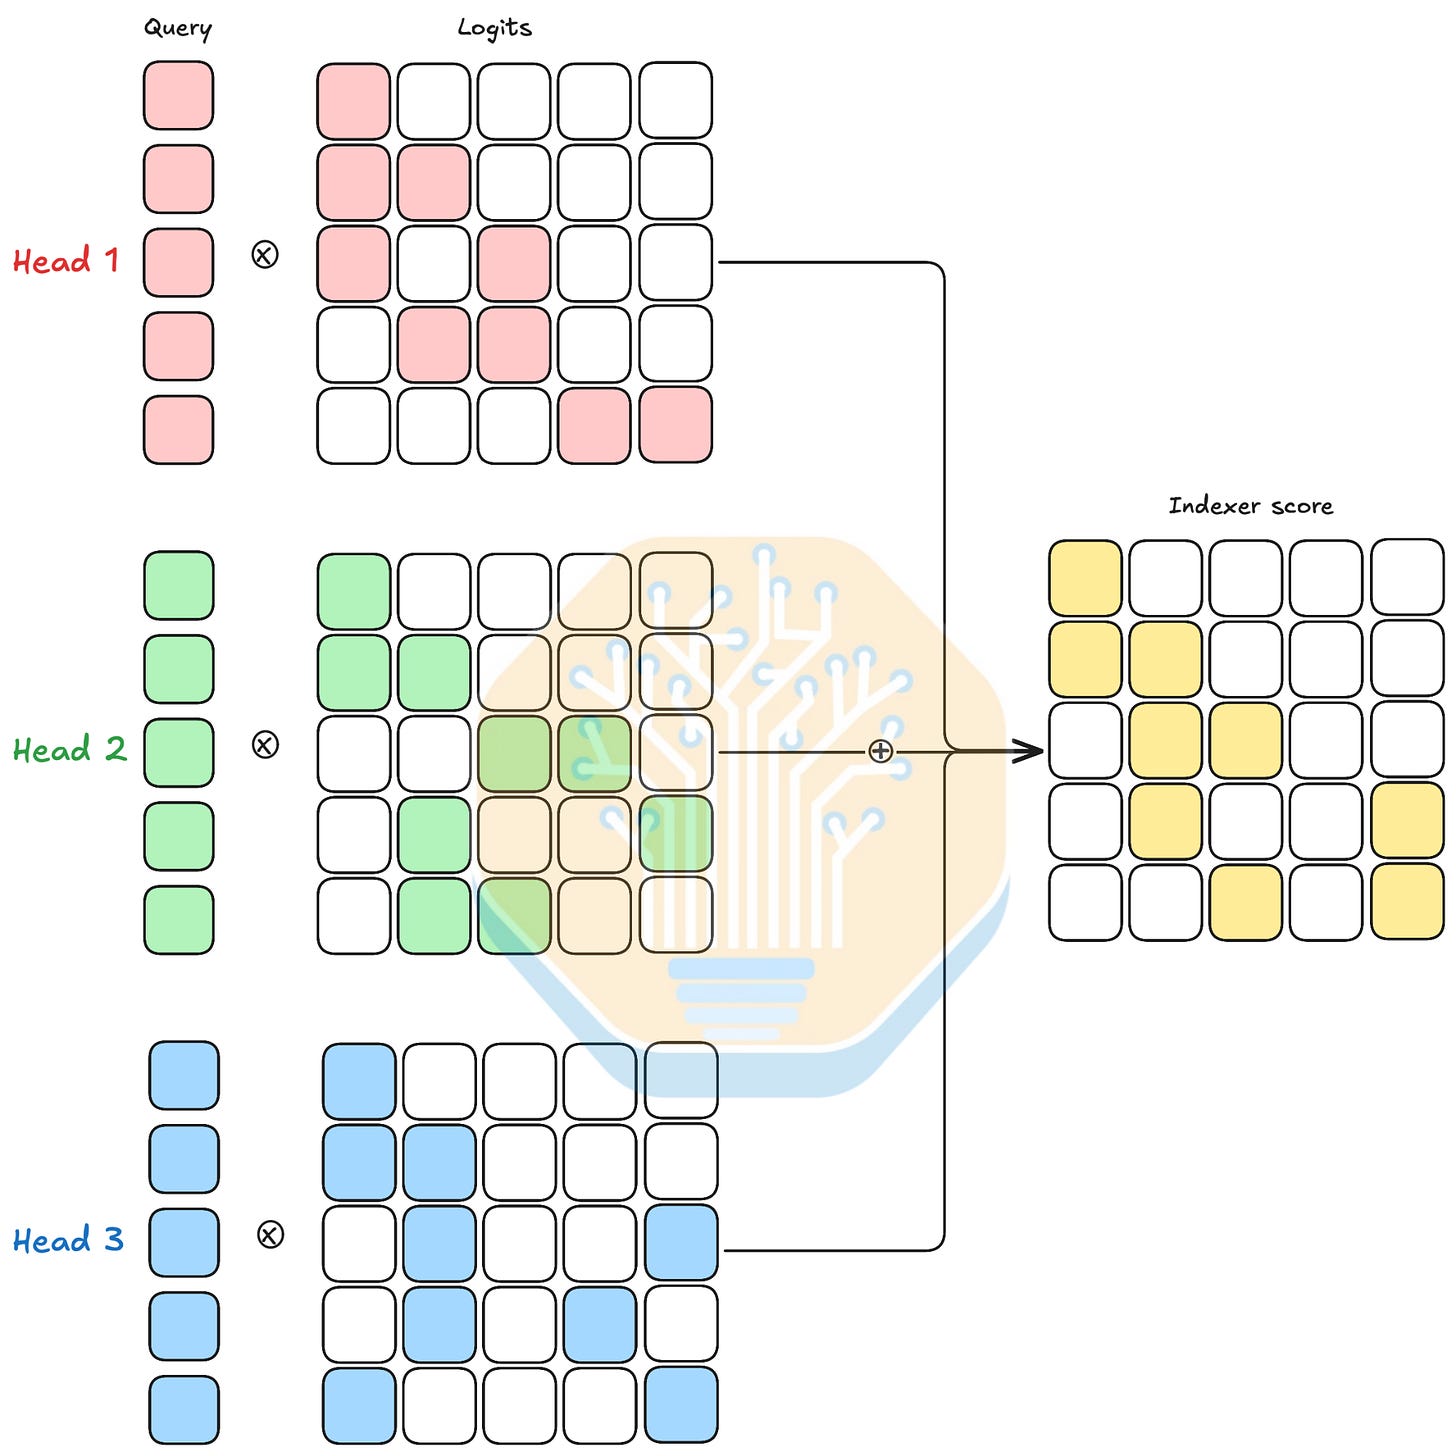
Indexer score is a weighted sum of all indexer query heads. Source: SemiAnalysis
Sparse MLA
正如我们在 Kimi K3 文章中所解释的,MLA 有两种运行模式:Multi-Head Attention(MHA,多头注意力)模式和 Multi-Query Attention(MQA,多查询注意力)模式。两者各有取舍:MHA 模式的 FLOPs 更低,但内存开销高 42 倍;MQA 模式内存开销更低,但 FLOPs 最多高出 3.4 倍。DSA 采用 MQA 模式,因为稀疏注意力只关注较少的 token,可以抵消更高的 FLOP 开销。但在实际中存在一个序列长度阈值,低于该阈值时 MHA 模式其实比 MQA 模式更高效。直观上讲,在序列长度较短时,内存加载时间不再是主导因素,而 MHA 模式因 FLOPs 更低可能更有优势。vLLM 实现了这个特性,为数据并行配置了 2K 到约 5K 的 MHA 模式,为张量并行配置了 2K 到约 77K 的 MHA 模式。2K 的下限是因为 top K 为 2048,而且如上所述,低于 2K 的注意力是稠密的。
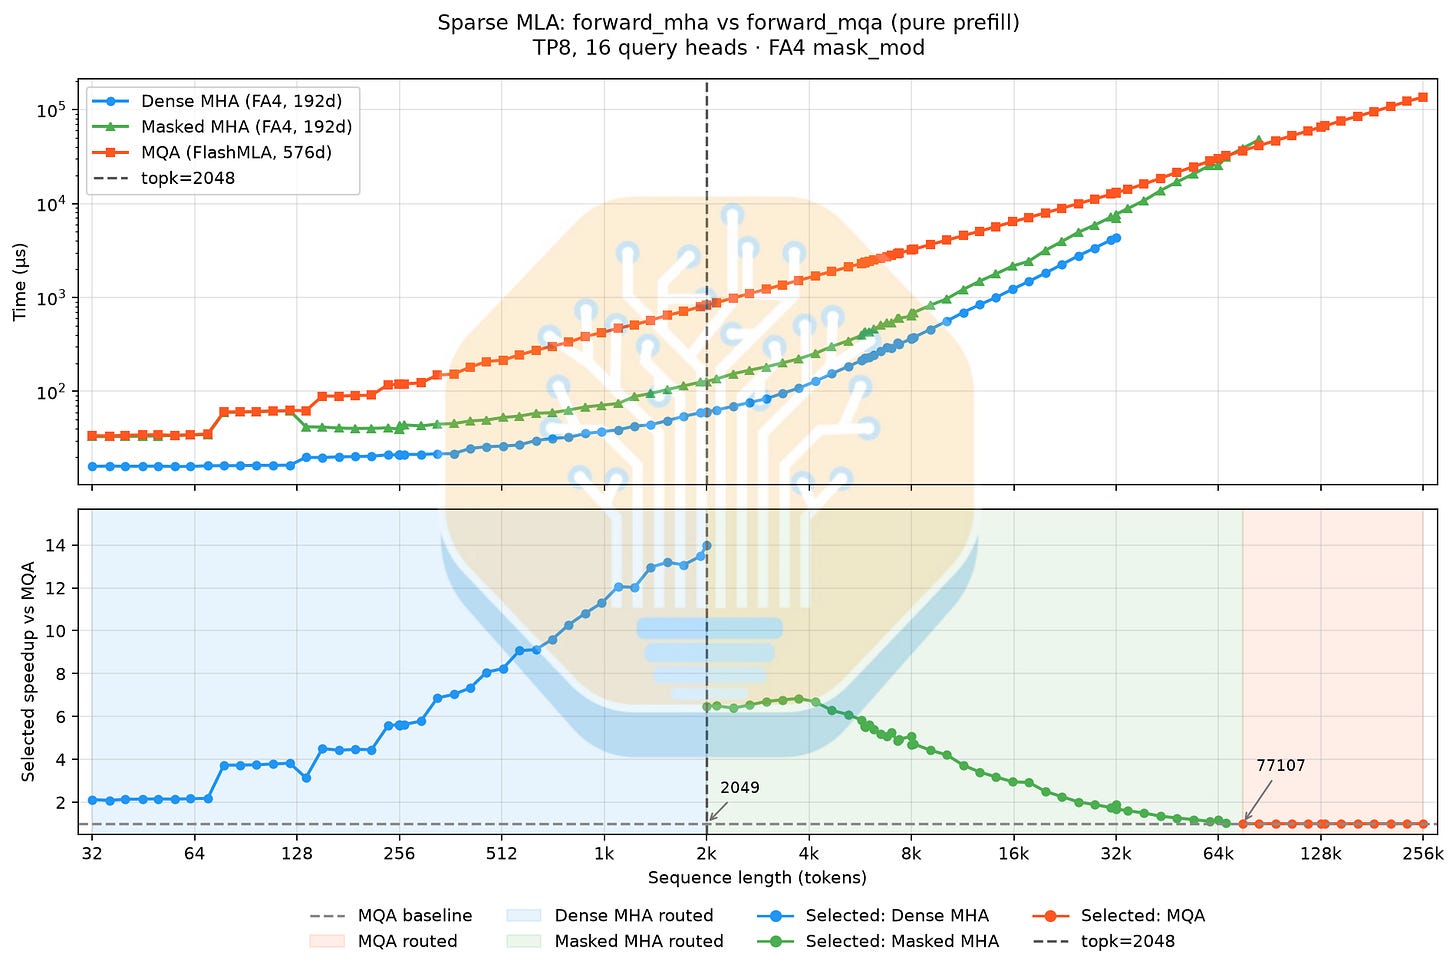
MHA (green) can be faster than MQA (red). Source: vLLM PR #48770
MLA 的改动
对比 GLM-5 和 DeepSeek V3.2 的 MLA 维度配置,我们可以看到最显著的差异在于 query 头的数量以及 query key 头维度。
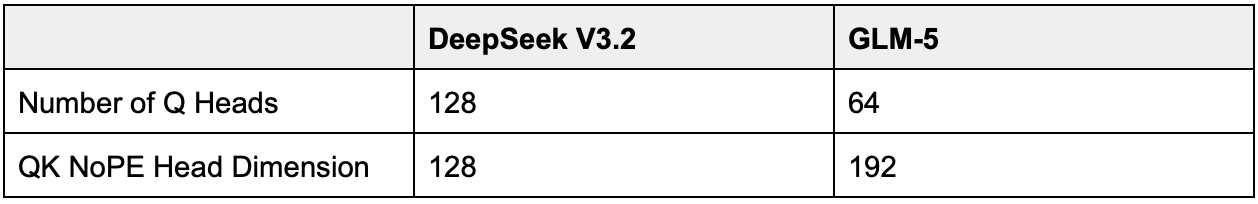
GLM-5 技术报告提到,DeepSeek 是根据 H800 的 roofline(屋顶线)来选择 query 头数量的。这可能指的是:在解码阶段,MLA 的 SDPA 算术强度大致处于 H800 的拐点(ridge point)。推导如下。假设
- L:序列长度
- d:头维度
- r:RoPE 维度
- H:头的数量
- b:每个参数的字节数
在 MQA 模式下,FLOPs 为
加载的内存为
因此算术强度为
如果代入 DeepSeek V3.2 的配置(d = 512,r = 64,b = 2),我们得到
H800 的实际算术强度为 258.2 FLOP/B(根据 DeepSeek 的数据,实际峰值为 865 TFLOP/s,带宽为 3.35 TB/s),代入公式可得 H ≈ 128。
GLM-5 的 H = 64,query 头数量只有一半,这意味着 GLM-5 可能是为不同的硬件设计的。如果代入 GLM-5 的配置(d = 512,r = 64,b = 2,H = 64),我们得到的算术强度为 120.8 FLOP/B。因此,我们猜测 GLM-5 是针对 Moore Threads MTT S4000 优化的,后者约为 128 FLOP/B。Moore Threads 与 Z.ai 的合作(例如对 GLM-5.3-Flash 的 day 0 支持)印证了我们的推测。
另外,GLM-5 将 QK NoPE 维度从 128 提升到了 192,消融实验表明该配置在 iso-FLOP 和 iso-parameter 约束下表现更优。这将 SDPA 头维度从 192 提升到了 256,考虑到头数量的减少,FLOP 仍降低了 33%。
IndexShare
随着上下文增长,索引器的延迟开销变得不可忽视。为了降低这一开销,Z.ai 在 GLM-5.2 中提出了 IndexShare(又称 IndexCache),即每 4 个 DSA 层共享一个索引器。
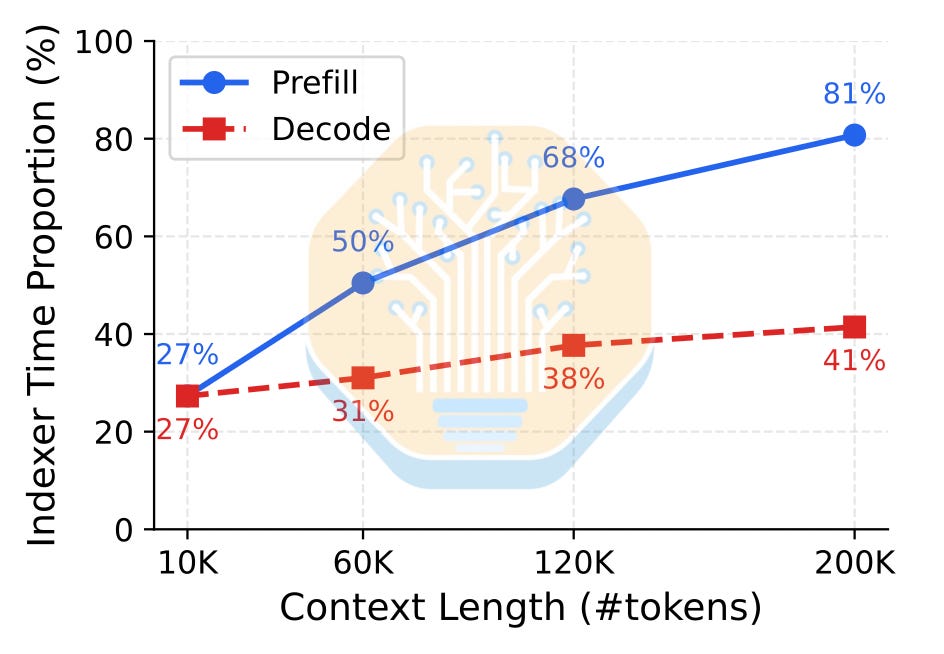
Latency cost at different context lengths for a 30B DSA model. Source: IndexCache
IndexShare 为训练和推理带来了额外的复杂性。标准的 DSA 训练包含两个阶段:一是稠密热身(dense warm-up)阶段,此时除 indexer 之外的所有模型权重都被冻结,注意力计算采用稠密方式;二是稀疏适配(sparse adaptation)阶段,此时使用稀疏注意力对完整模型进行训练。
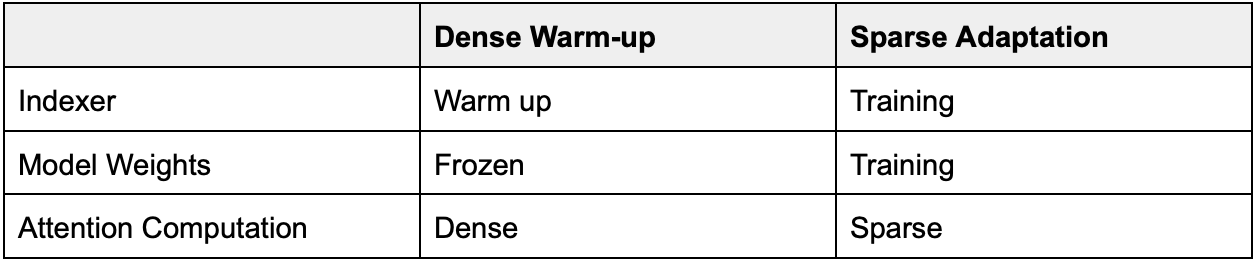
在训练目标方面,indexer 的训练目标是与注意力头分数之和对齐,采用 KL 散度作为目标函数。IndexShare 将训练目标调整为:让 indexer 的 logit 分布与共享层上注意力分数的平均分布对齐。
在推理方面,indexer 通常会像注意力缓存 KV 一样缓存 key。由于多个层共享同一个 indexer,我们还需要在完整层缓存 top K 索引,以便在共享层复用 top K 的选择信息。
这一设计将 indexer 缓存减少了 75%,将 indexer 的 FLOPs 减少了 75%,并在不同的上下文长度和 prefill/decode 阶段下将吞吐量提升了 1.5 倍到 1.8 倍。
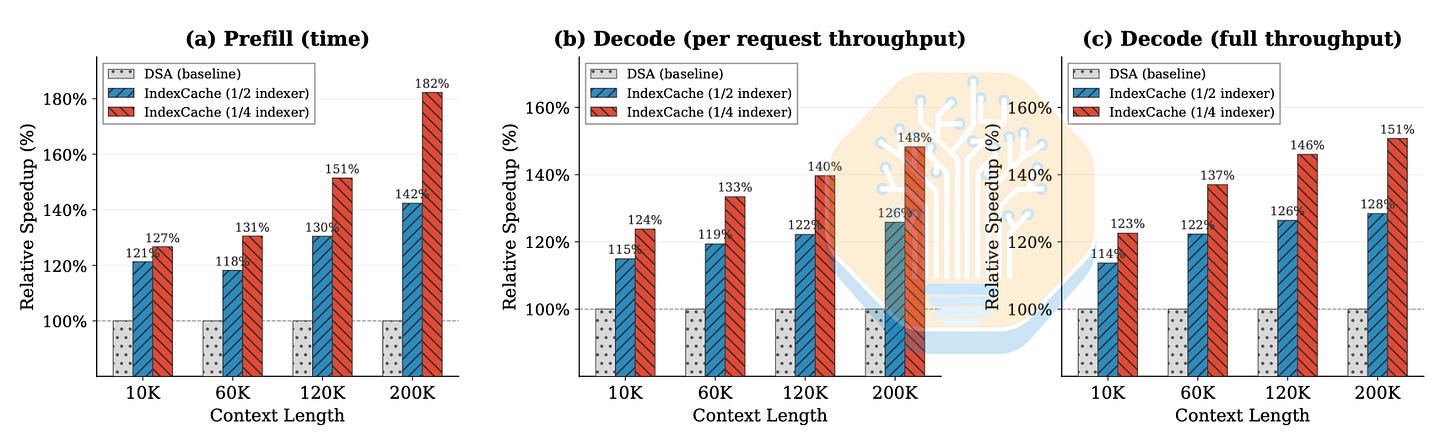
Baseline vs. GLM-5.2 configuration (red) for a 30B DSA model. Source: IndexCache
后训练(Post-Training)设计
流程
在预训练和中期训练之后,GLM-5 的后训练流程从监督微调(SFT)开始,接着进行三个 RL 训练阶段(推理 RL、智能体 RL 和通用 RL),最后以 on-policy 跨阶段蒸馏收尾,即将推理 RL 和通用 RL 蒸馏回 SFT 检查点。
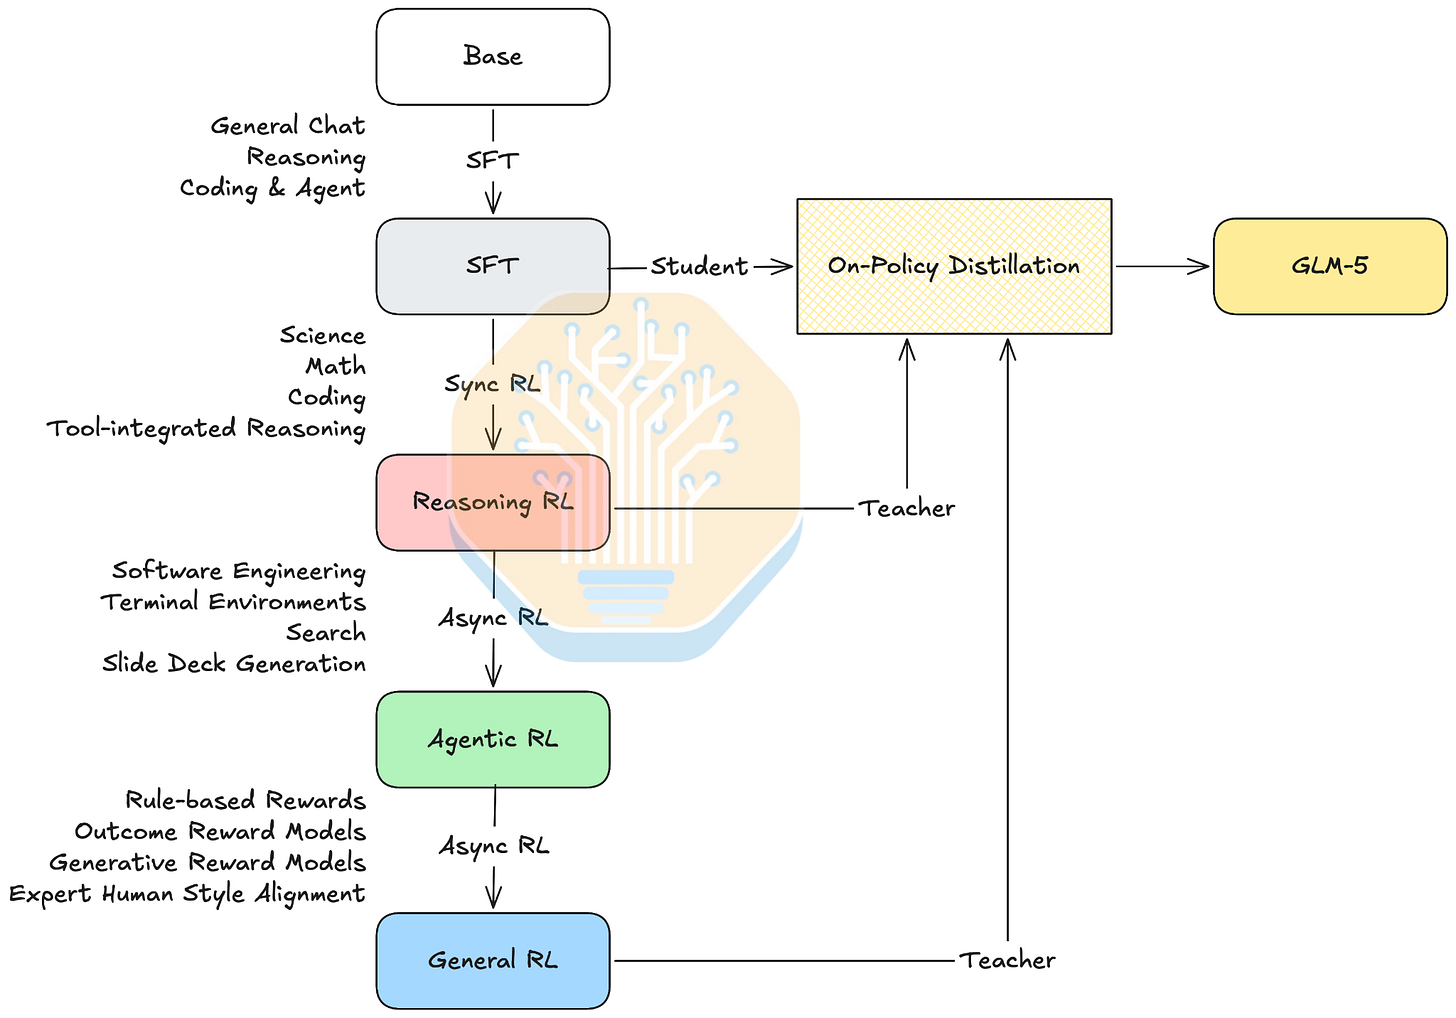
GLM-5 post-training pipeline. Source: SemiAnalysis
这里我们强调两个细节。第一,技术报告指出推理 RL 模型完全采用 on-policy 方式训练,这意味着它是同步训练的。同步 RL 训练的系统效率较低,但 RL 训练稳定性更高。第二,on-policy 跨阶段蒸馏类似于多教师 on-policy 蒸馏(MOPD),即学生模型在多个教师模型上进行 on-policy 蒸馏的同时接受 RL 训练。不过,MOPD 的目标是将多个专家教师模型合并为一个模型,而 GLM-5 在这里似乎更侧重于在模型学习新能力时恢复旧能力的损失。基于这一假设,我们并不清楚为什么 Z.ai 只使用推理 RL 和通用 RL 检查点作为教师,而不是使用全部三个 RL 检查点。
根据发布的博客文章,GLM-5.2 可能已将 on-policy 跨阶段蒸馏替换为标准的 MOPD 流程,Z.ai 将其命名为 parallel OPD training。Z.ai 大力宣传了其规模和训练效率:他们仅用约两天的训练,就将十多个专家模型合并为一个最终模型。
RL 训练算法
Z.ai 在同步和异步 RL 阶段采用了不同的 RL 算法。这里我们比较 RL 目标函数的主要差异。
在同步 RL 阶段,Z.ai 采用基于组相对策略优化(GRPO)的 RL 算法,并进行了现代化的改进,包括:
- 移除 KL 正则化项,以提升系统效率并允许更激进的梯度更新
- IcePop:基于训练-推理不匹配比率进行 token 级别的掩码处理
- Clip-Higher:为重要性采样比率设置更高的最大阈值,以鼓励探索
相比之下,Z.ai 在异步 RL 阶段采用了一种类 REINFORCE 的 RL 算法,并加入了直接双侧重要性采样(Direct Double-Sided Importance Sampling,DIS)以及一种类似 IcePop 的裁剪机制。下面我们对两个 RL 阶段的 token 级别目标函数进行对比:
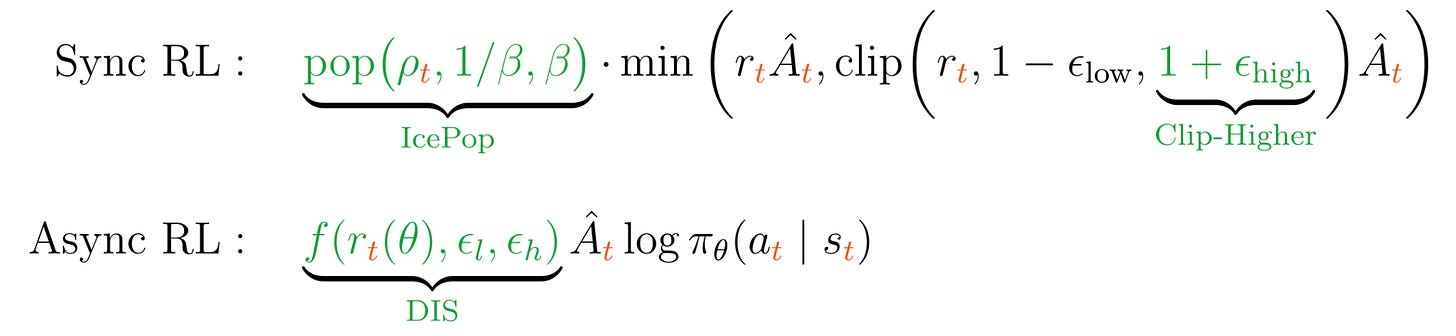
Token-level objective for the two RL stages. Source: SemiAnalysis
重要性采样(IS)比率会比较每个采样动作在当前策略和行为策略下的概率,并据此对每个动作在训练目标中的贡献进行缩放。在同步 RL 阶段,行为策略采用上一次迭代的训练器策略;而在异步 RL 阶段,则使用推理策略。在异步训练场景下,策略在 rollout 过程中会更新多次,因此理论上需要中间的每一个 checkpoint 版本来计算 IS 比率。但由于内存和延迟开销过高,这并不可行。因此,Z.ai 出于效率和简洁性的考虑选择使用推理策略,代价是面临数值稳定性方面的挑战。
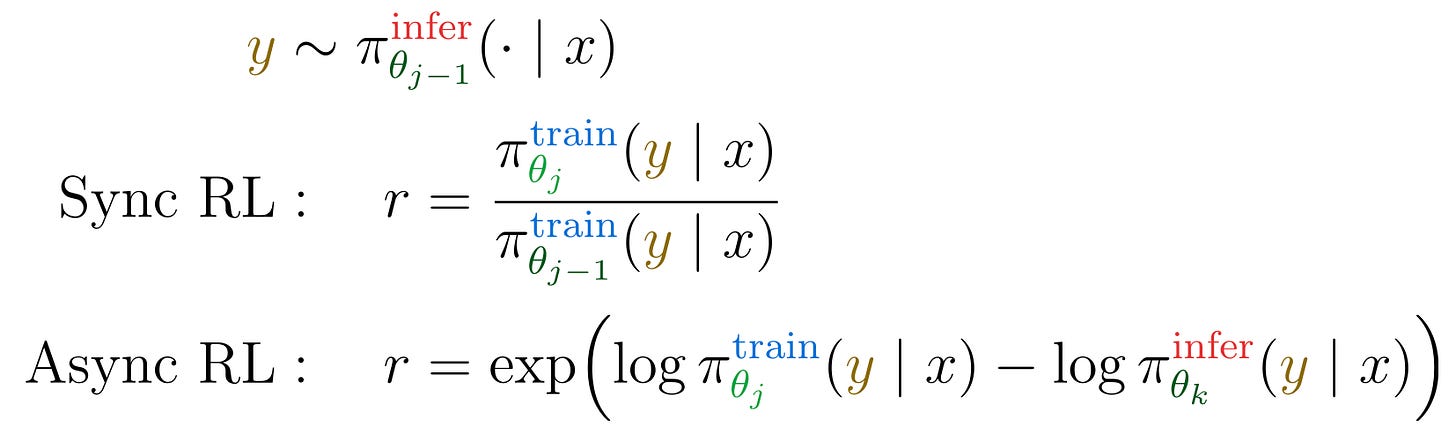
IS ratio for the two RL stages. Source: SemiAnalysis
最后,我们重点介绍 RL 训练中优势函数计算、交叉蒸馏以及长程 RL 训练的主要差异。RL 训练采用 GRPO 标准的组归一化优势,交叉蒸馏则使用反向 KL 散度。
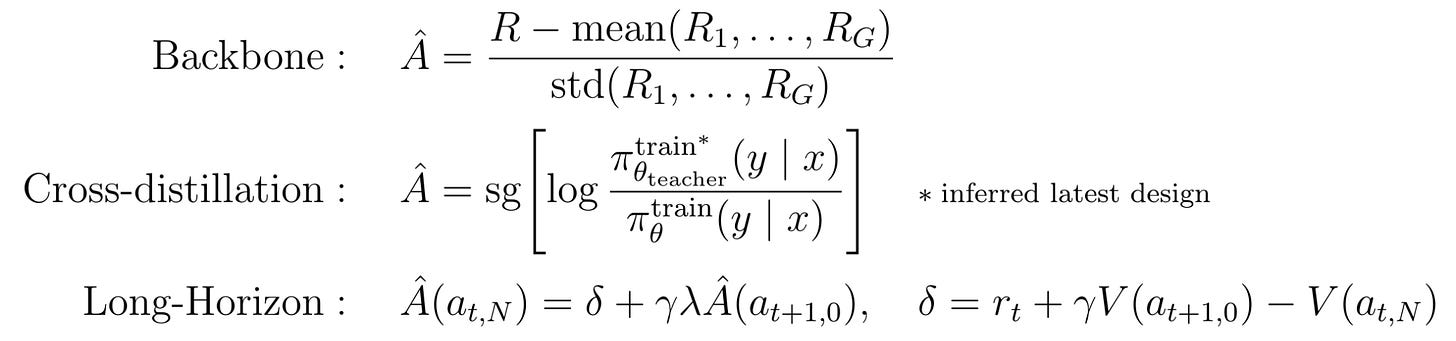
Advantage calculation comparison. Source: SemiAnalysis
单次 Rollout 异步优化
长程任务会产生极长的轨迹。在 GRPO 的框架下,轨迹长度的高方差会带来不稳定的训练信号,并可能使训练偏向更长的轨迹。更糟糕的是,由于 RL rollout 的工作负载对端到端延迟很敏感,长程任务中掉队者(straggler)rollout 的尾延迟问题会进一步恶化。为缓解这一问题,Z.ai 在 GLM-5.2 的长程 RL 训练中引入了单次 Rollout 异步优化(Single-rollout Asynchronous Optimization,SAO)。SAO 受 Proximal Policy Optimization(PPO)启发,用一种改进的广义优势估计(Generalized Advantage Estimation,GAE)替代了组归一化优势。GAE 只需要单次 rollout 即可计算优势,这省去了每个 prompt 进行多次 rollout 的必要,弥补了 GRPO 的短板。
Generator node asking trainer node to wait for rollout completion. Source: SAO
GAE 的计算依赖价值模型估计出的价值(用 RL 的术语来说,即当前状态的期望回报)。具体而言,价值模型以 rollout 作为输入,为每个 token 产生一个价值估计。SAO 通过在优化过程中剔除观测 token(即工具调用结果),将 GAE 适配到智能体 RL 训练中。此前在 GLM-5 中,只需跳过这些 token 即可;而在 SAO 中,我们修改了优势估计公式来绕过观测 token。关于 Bellman 目标的更多直观解释和消融实验,请读者参阅 SAO 论文及其附录 A.1。
在 SAO 中,价值模型是与策略模型 concurrently 训练的独立 LLM。这意味着训练早期阶段容易受到优势(advantage)计算高方差的影响,原因在于价值模型较弱。为了解决这个问题,SAO 提出了多种价值模型训练技术:
- Two Time-scale Update Rule(双时间尺度更新规则):价值模型的更新频率是策略模型的两倍。也就是说,在每次策略训练步骤中,每个数据批次会被训练两次
- Attention Parameter Freezing(注意力参数冻结):冻结价值模型的全部注意力层,以提升训练稳定性
- Scaling Pre-training(扩展预训练):扩大价值模型的预训练语料规模来初始化价值模型,使其在训练早期就能稳健地估计价值。遗憾的是,Z.ai 并未披露预训练语料的规模信息
Source: SemiAnalysis
SAO 用价值模型取代了分组采样(group-wise sampling),代价是带来计算开销和内存占用翻倍,从而缓解了 GRPO 的延迟问题。
后训练基础设施
Z.ai 在所有 GLM-5 模型中均采用 slime 作为后训练基础设施,这是目前最好的开源 RL 训练框架之一。我们建议读者前往 slime 的 GitHub 仓库了解其设计与功能的更多细节,这里我们重点介绍其中两个特性。
RL rollout 的性能特征高度依赖具体任务,每个任务都有不同的工具和奖励函数。为了保证系统效率,Z.ai 设计了一种基于服务器的多任务 rollout 编排器。每个任务作为一个独立的微服务服务器,控制 rollout 和奖励逻辑。编排器负责平衡整体性能,控制每个任务的 rollout 比例和生成速度。集中式设计还支持跨任务的动态比例调整、细粒度的进度监控等诸多能力。Z.ai 声称,在训练 GLM-5 时,该编排器可支持 1000 个并发 rollout。
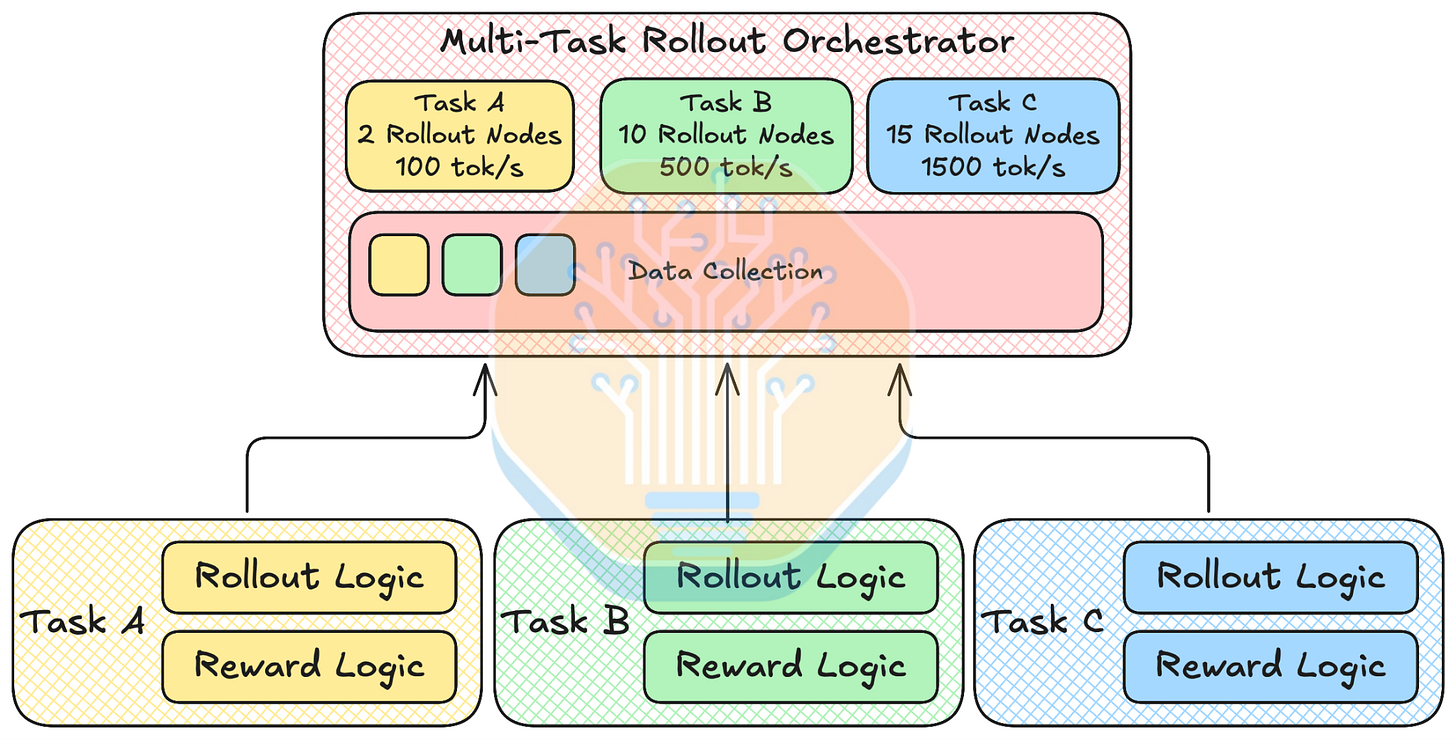
Architecture diagram of the multi-task rollout orchestrator. Source: SemiAnalysis
在 GLM-5.3 的发布公告中,Z.ai 声称除了主机内存外,还使用本地存储作为缓存层,从而支持动态教师模型切换以及 MOPD 的预取。slime PR#1538 通过引入 TensorBackuper 类实现了教师模型切换,该类将教师权重以固定(pinned)在 CPU 内存中的 PyTorch tensor 形式存储。当某个 rollout 被路由到某个教师模型时,TensorBackuper 对象会将该教师模型复制回 GPU 内存以执行前向传播(实现见此处)。不过这属于基于 CPU 的权重交换,我们尚未看到基于存储的实现。
在我们的付费章节中,我们呈现了对 GLM-5.3 网络安全能力的分析。