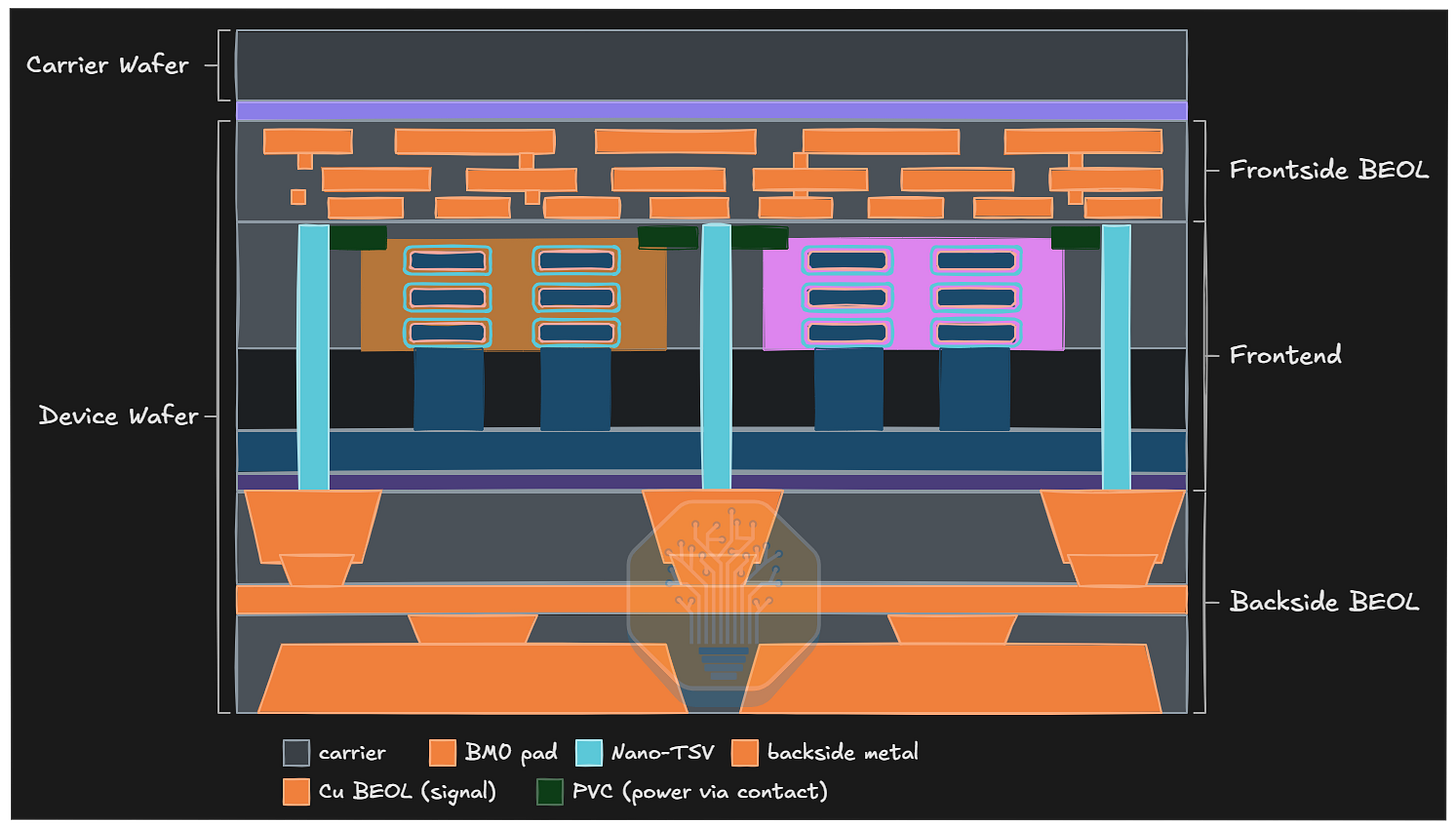
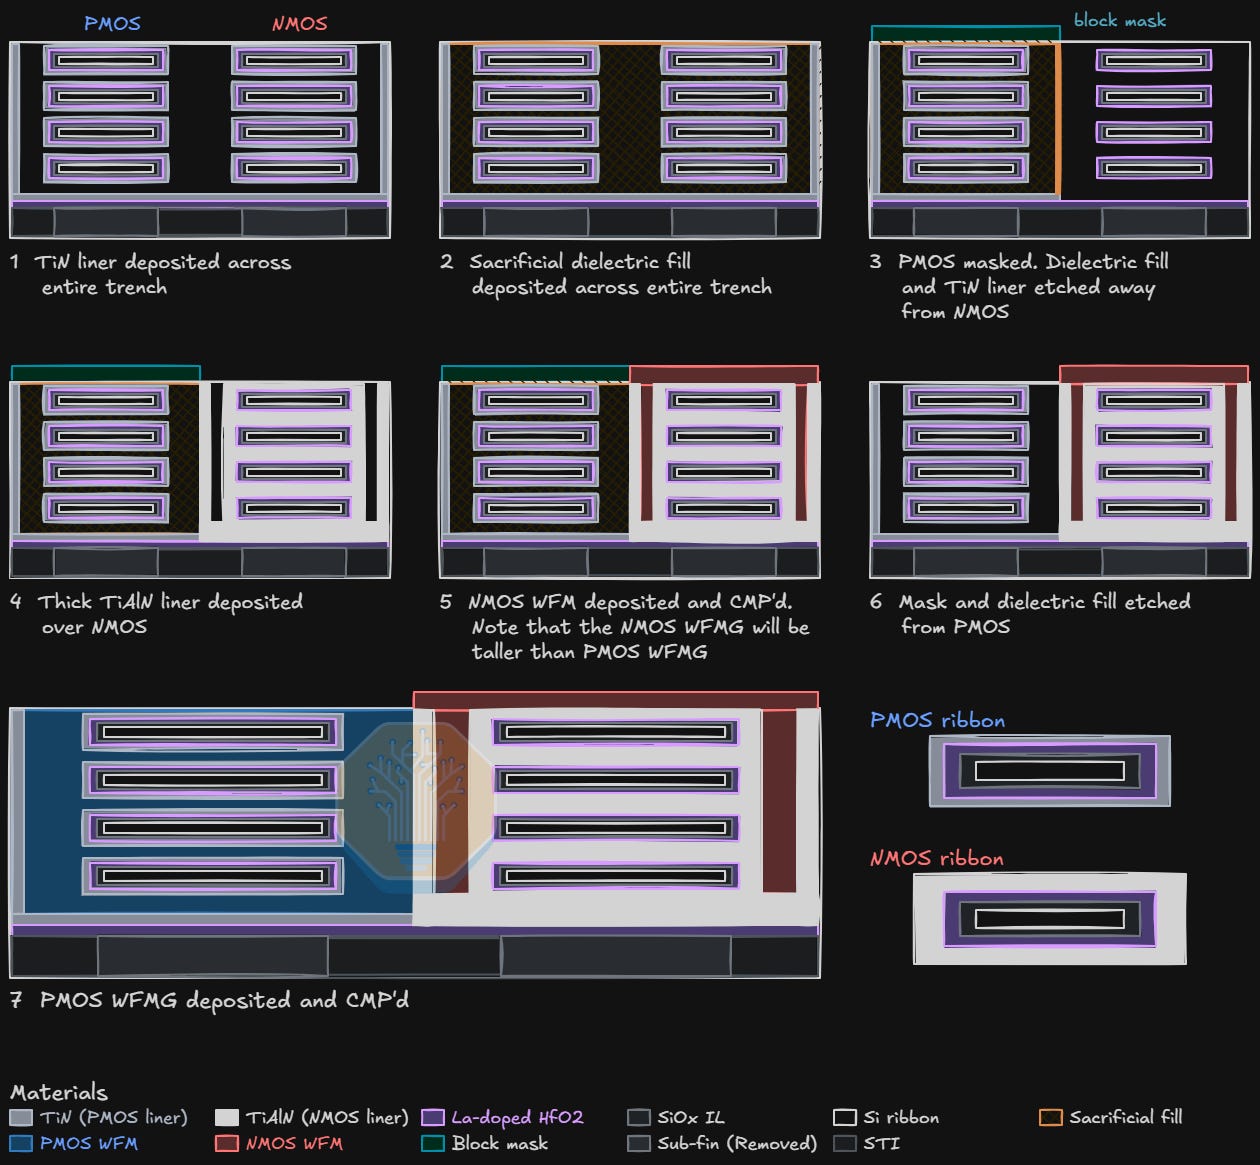
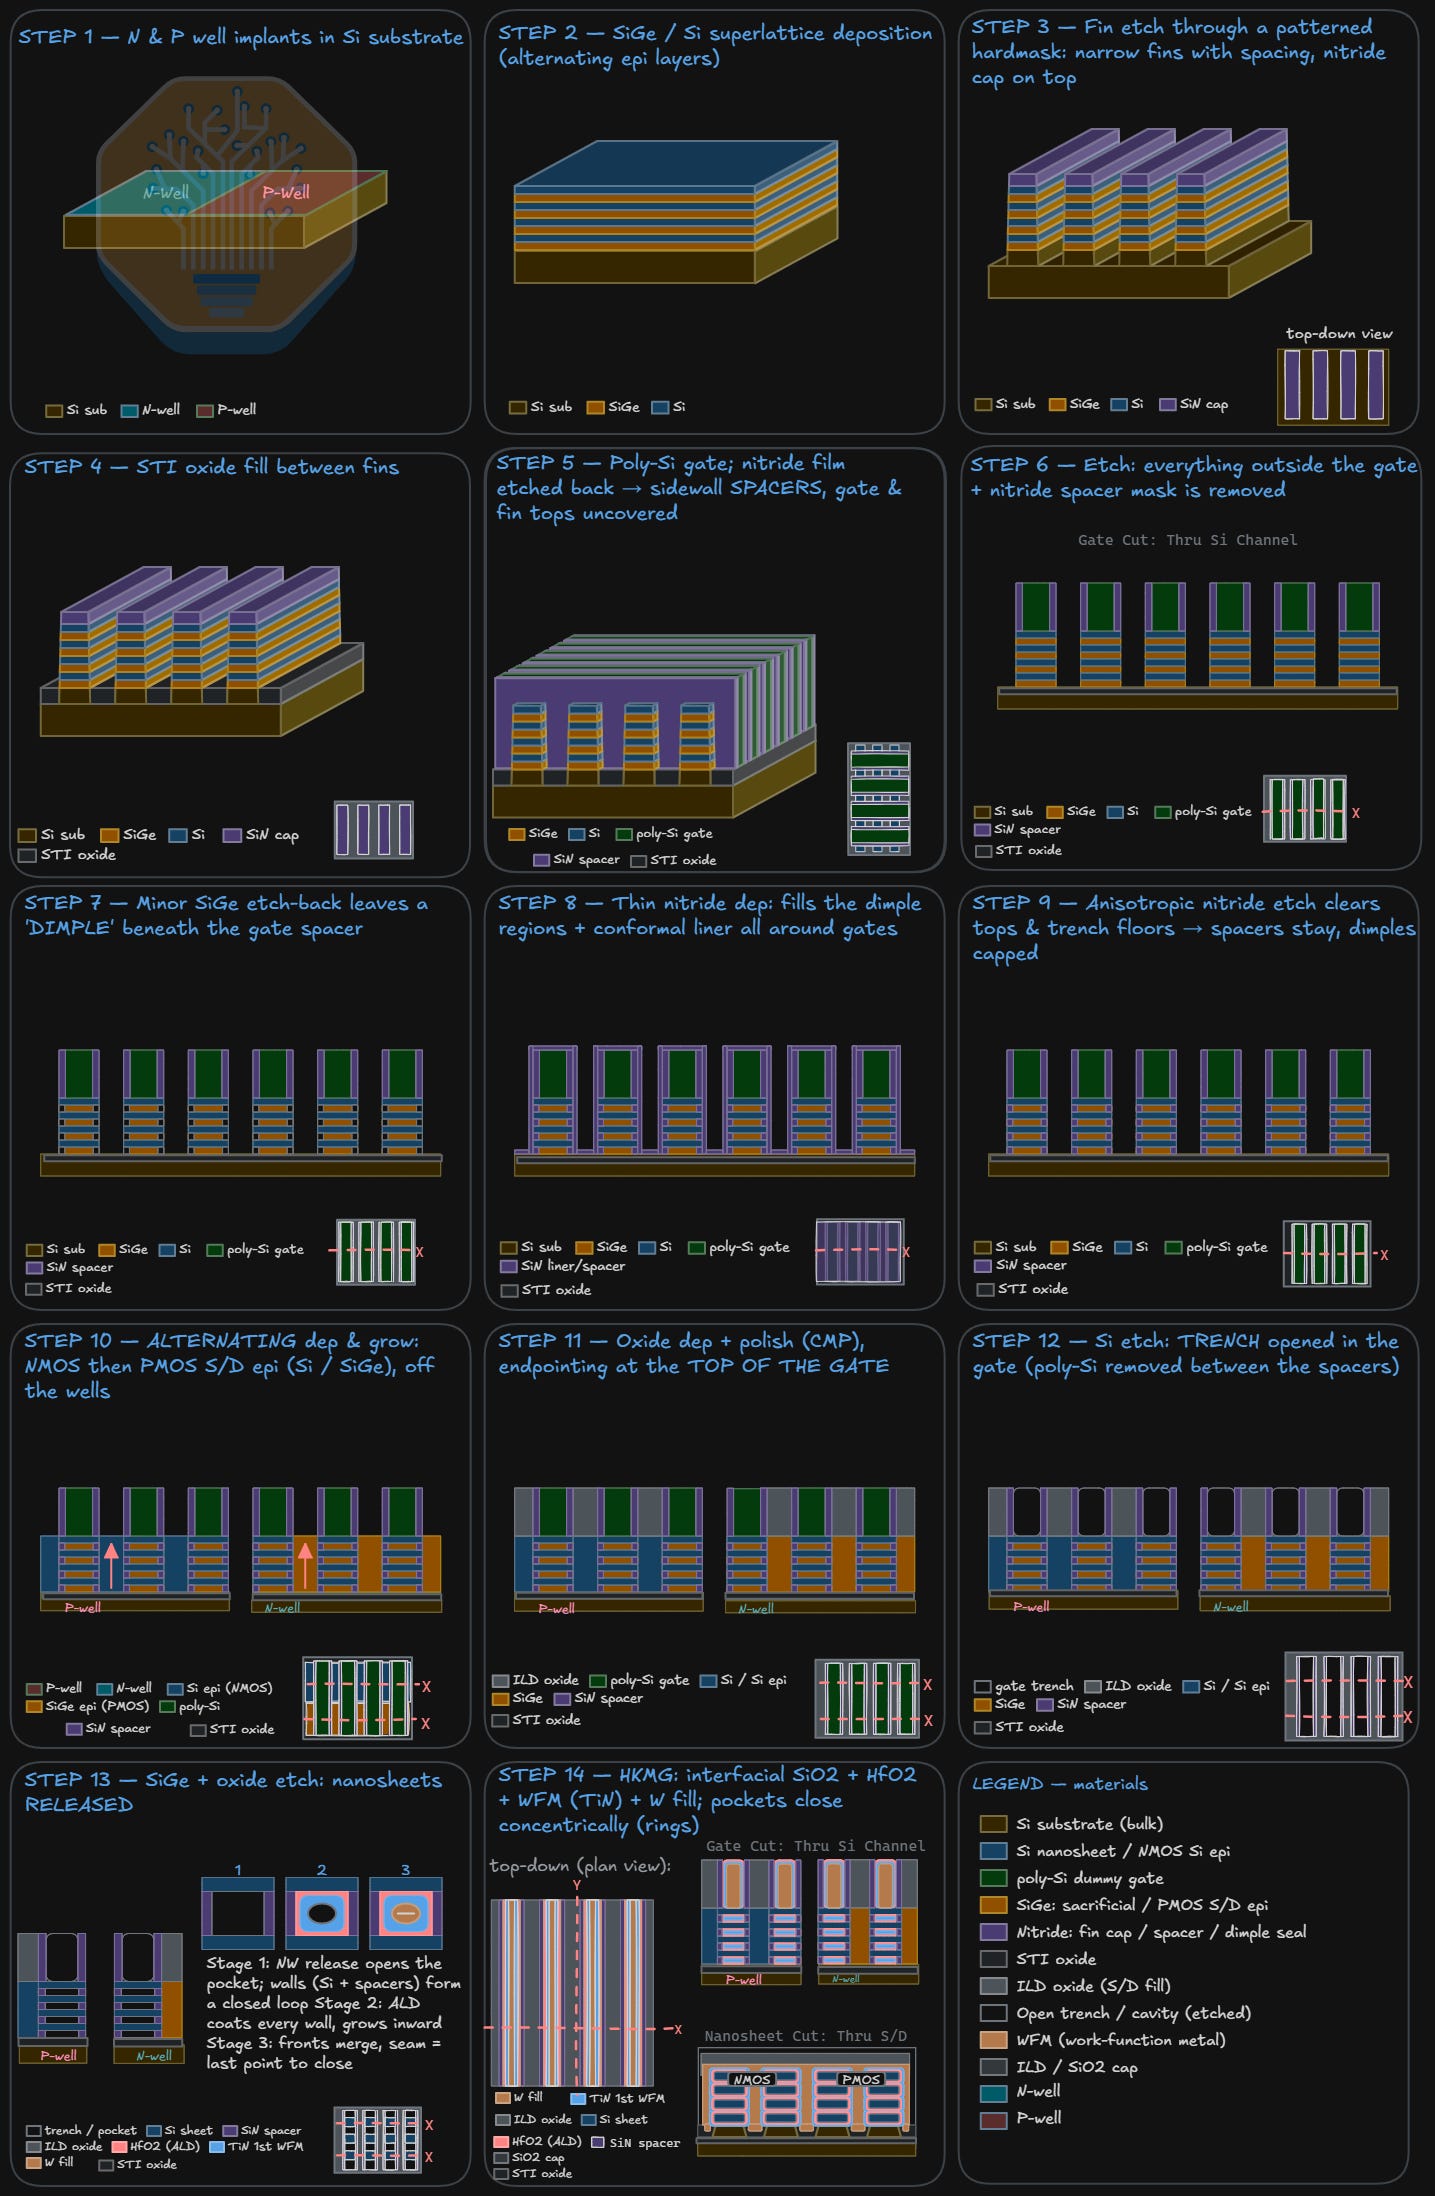
Schematic orientation of the retained carrier, devices and frontside/backside interconnects. Layer counts are illustrative; not to scale. Source: SemiAnalysis
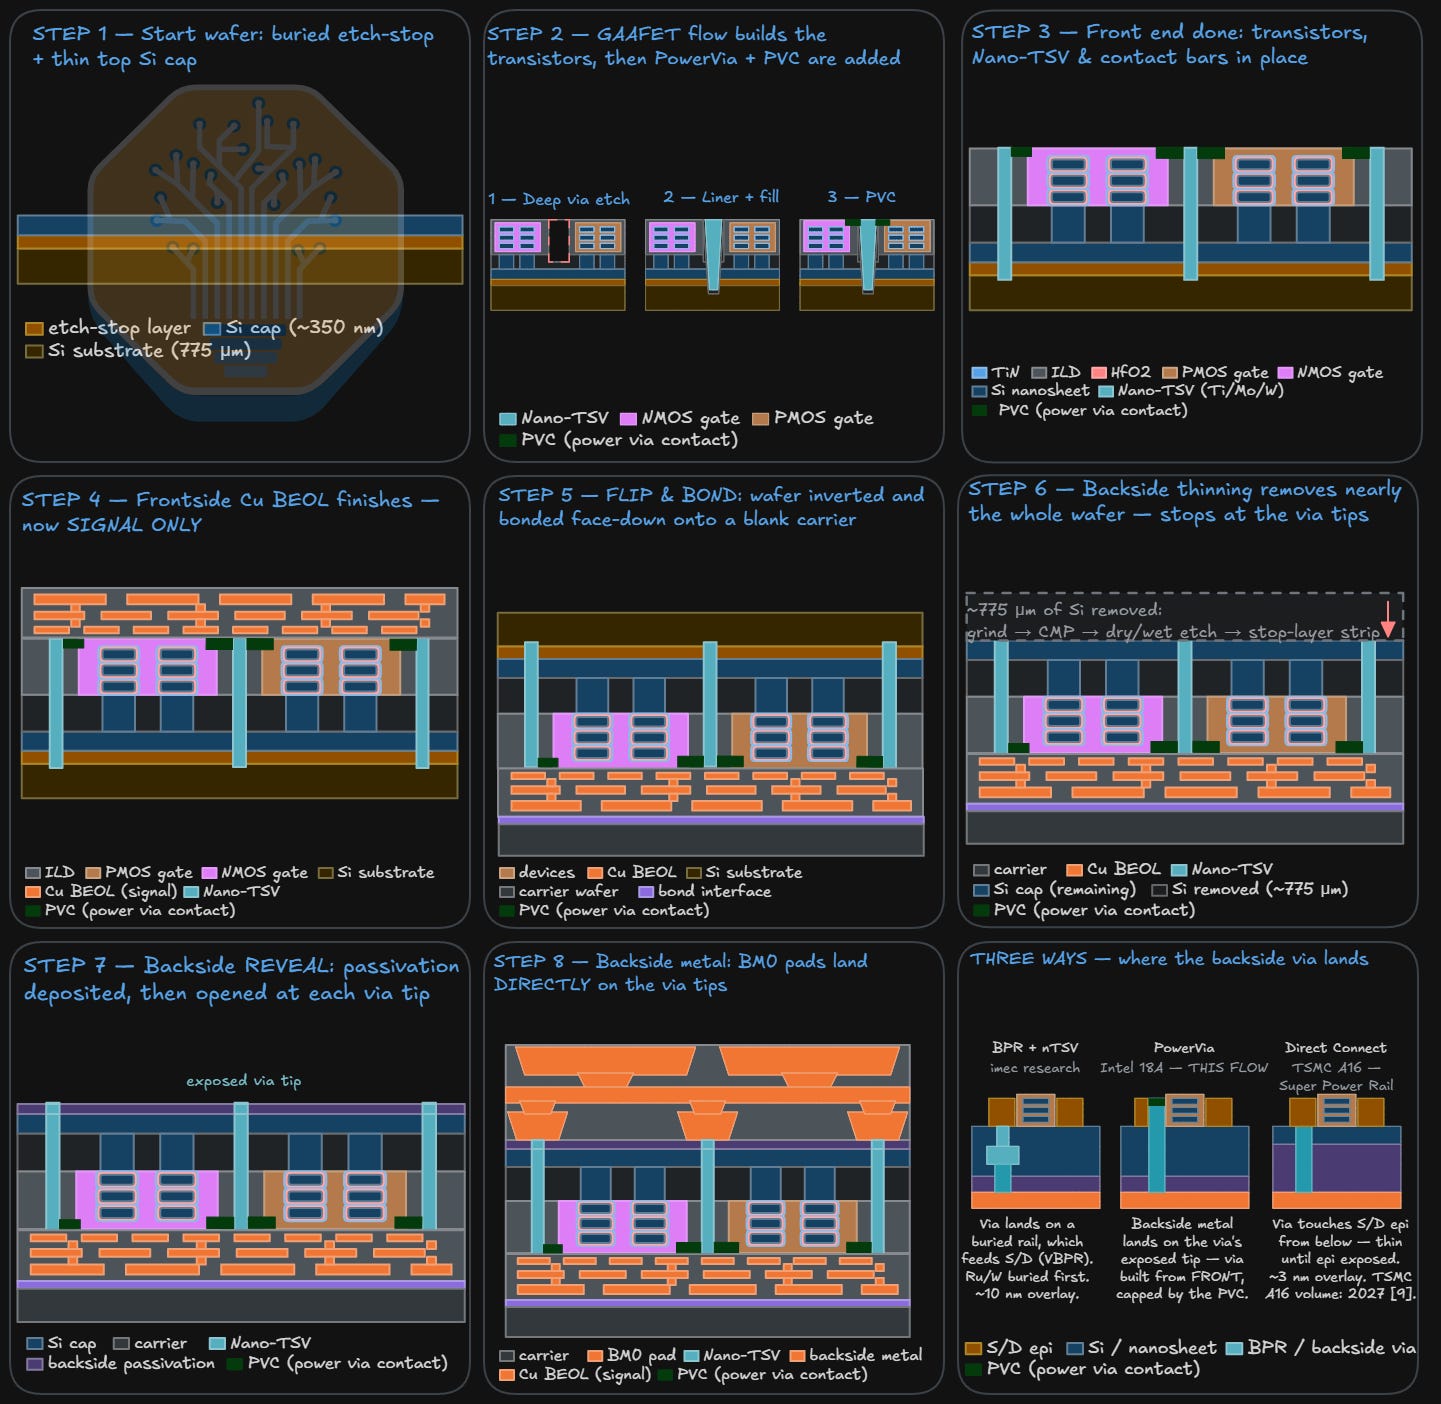
Generalized PowerVia process sequence and comparison of buried power rails, PowerVia and direct backside contact schemes. Integration details and layer counts are illustrative; the schematic is not to scale. Source: SemiAnalysis
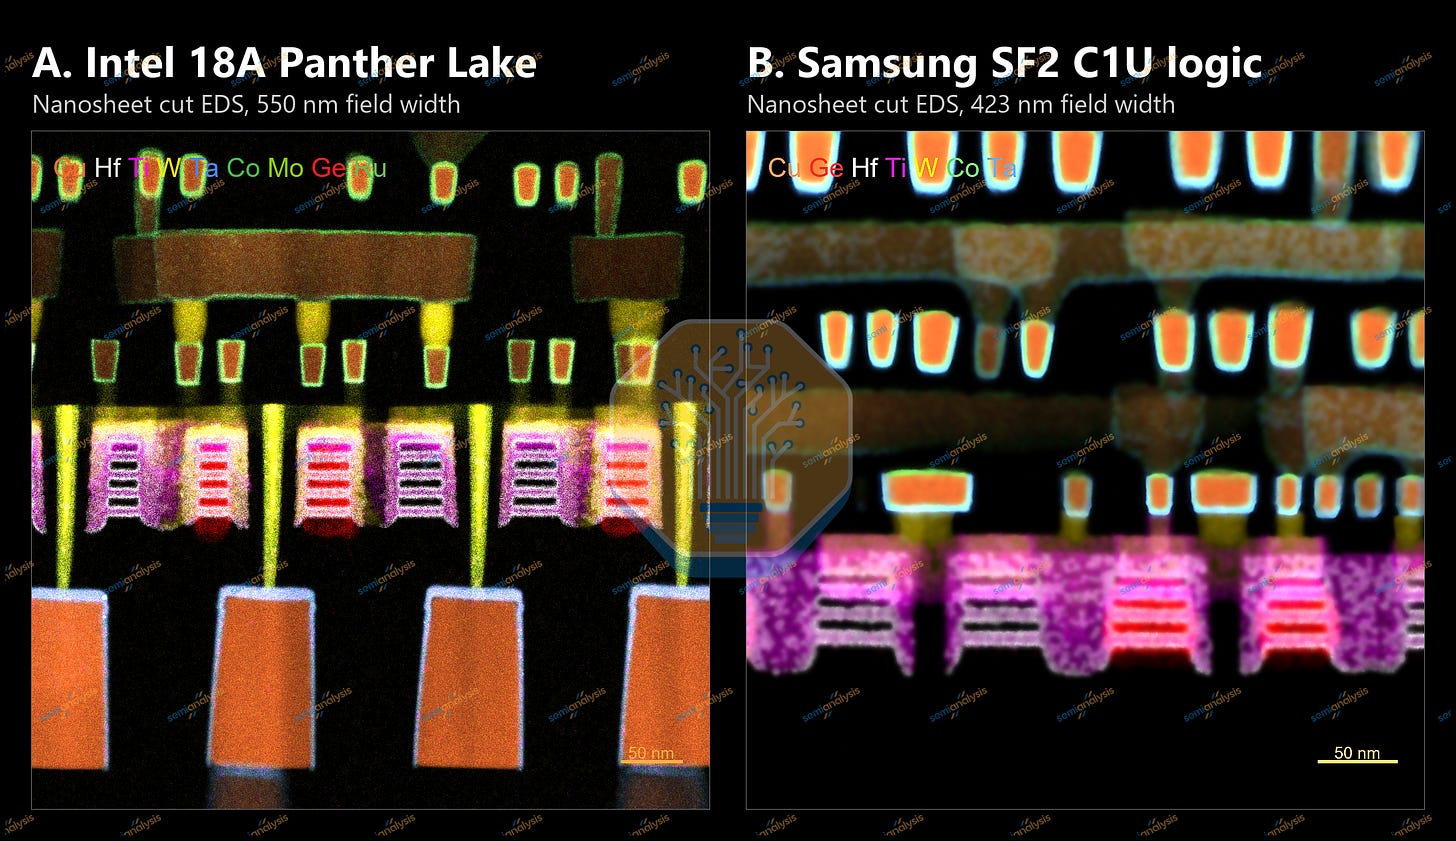
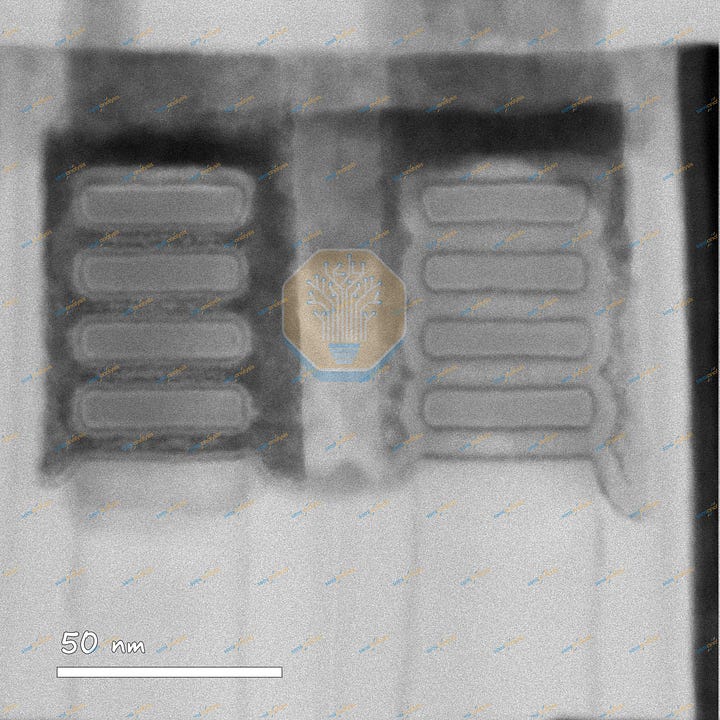
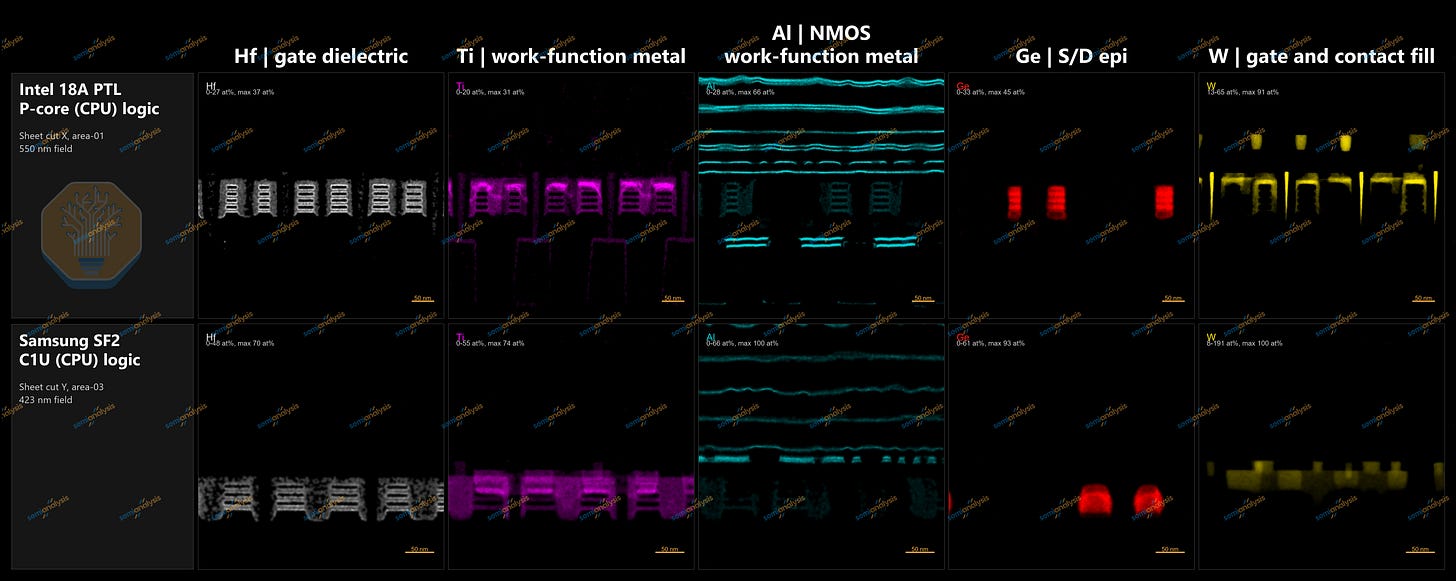
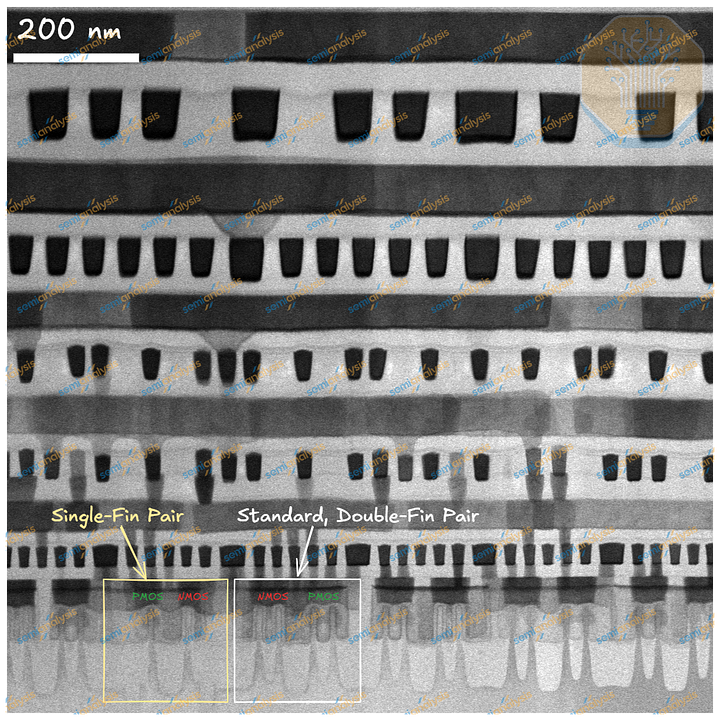
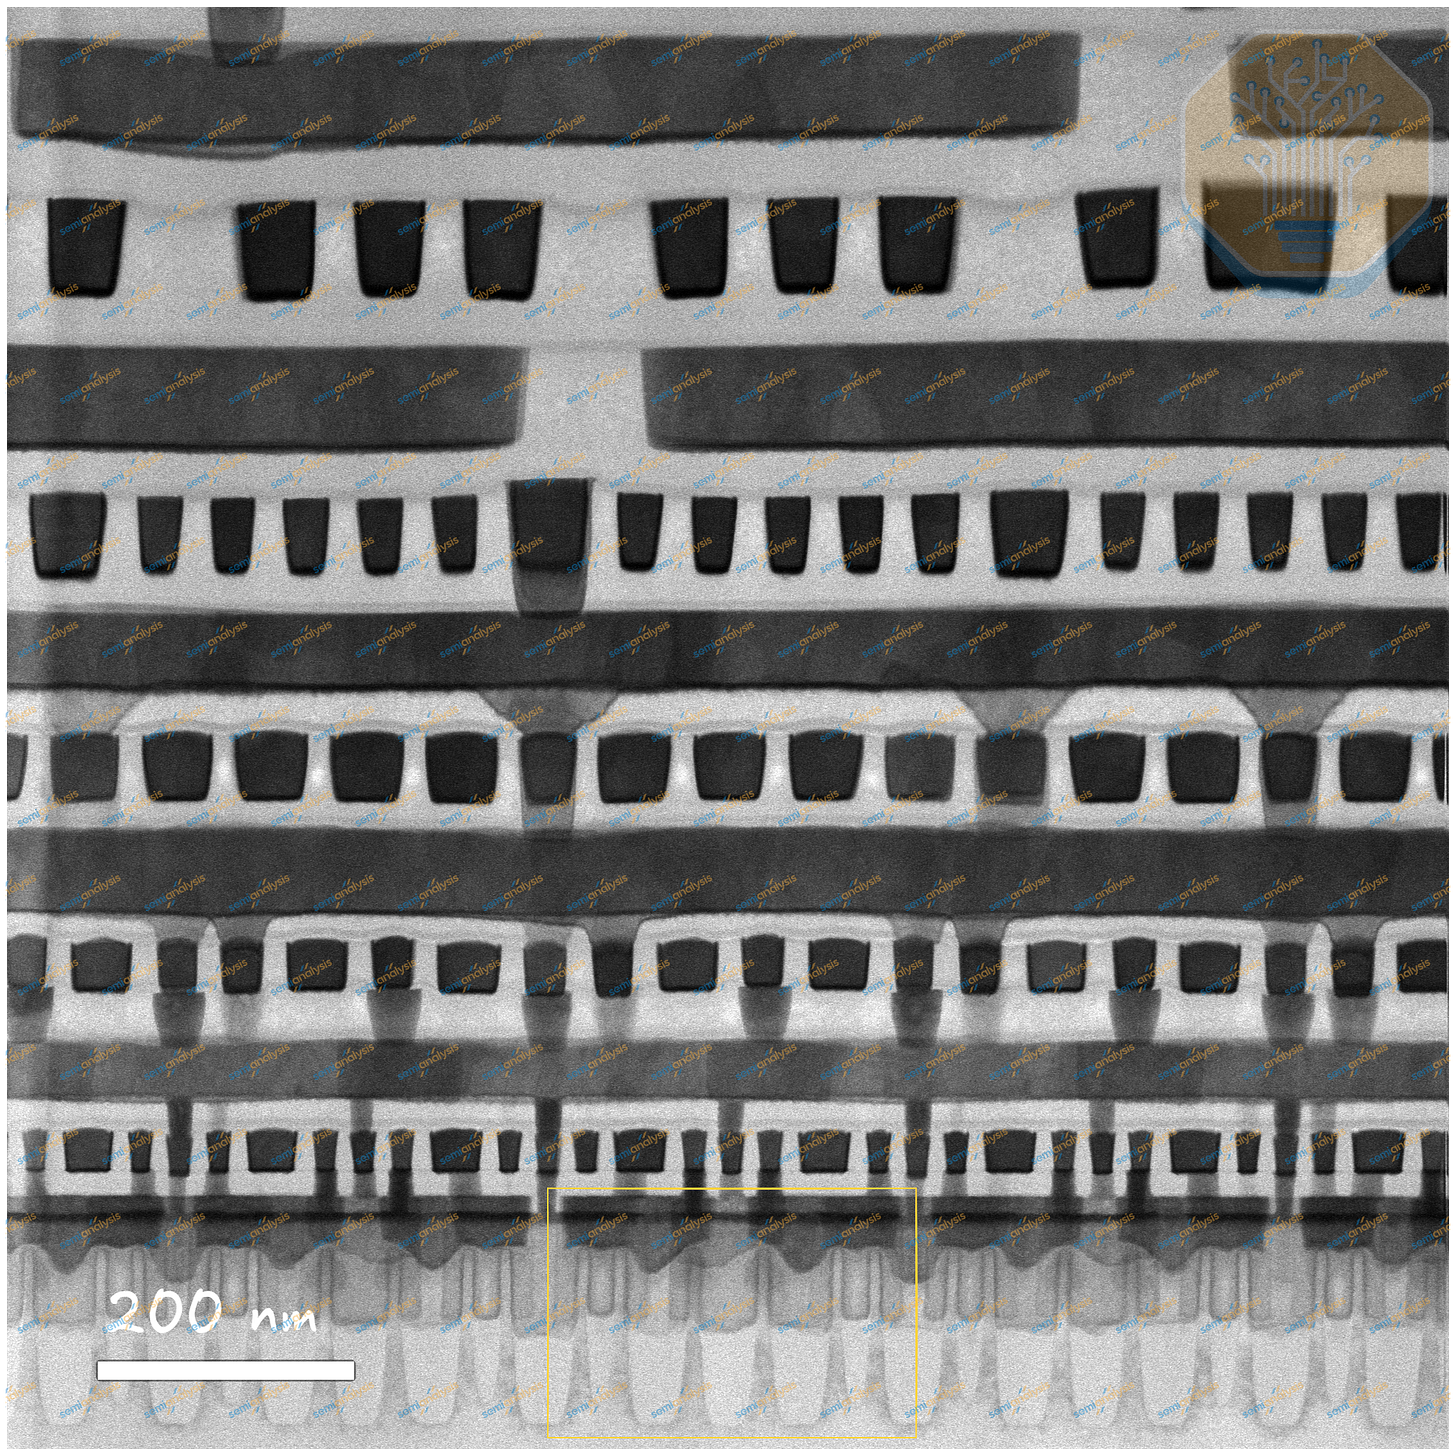
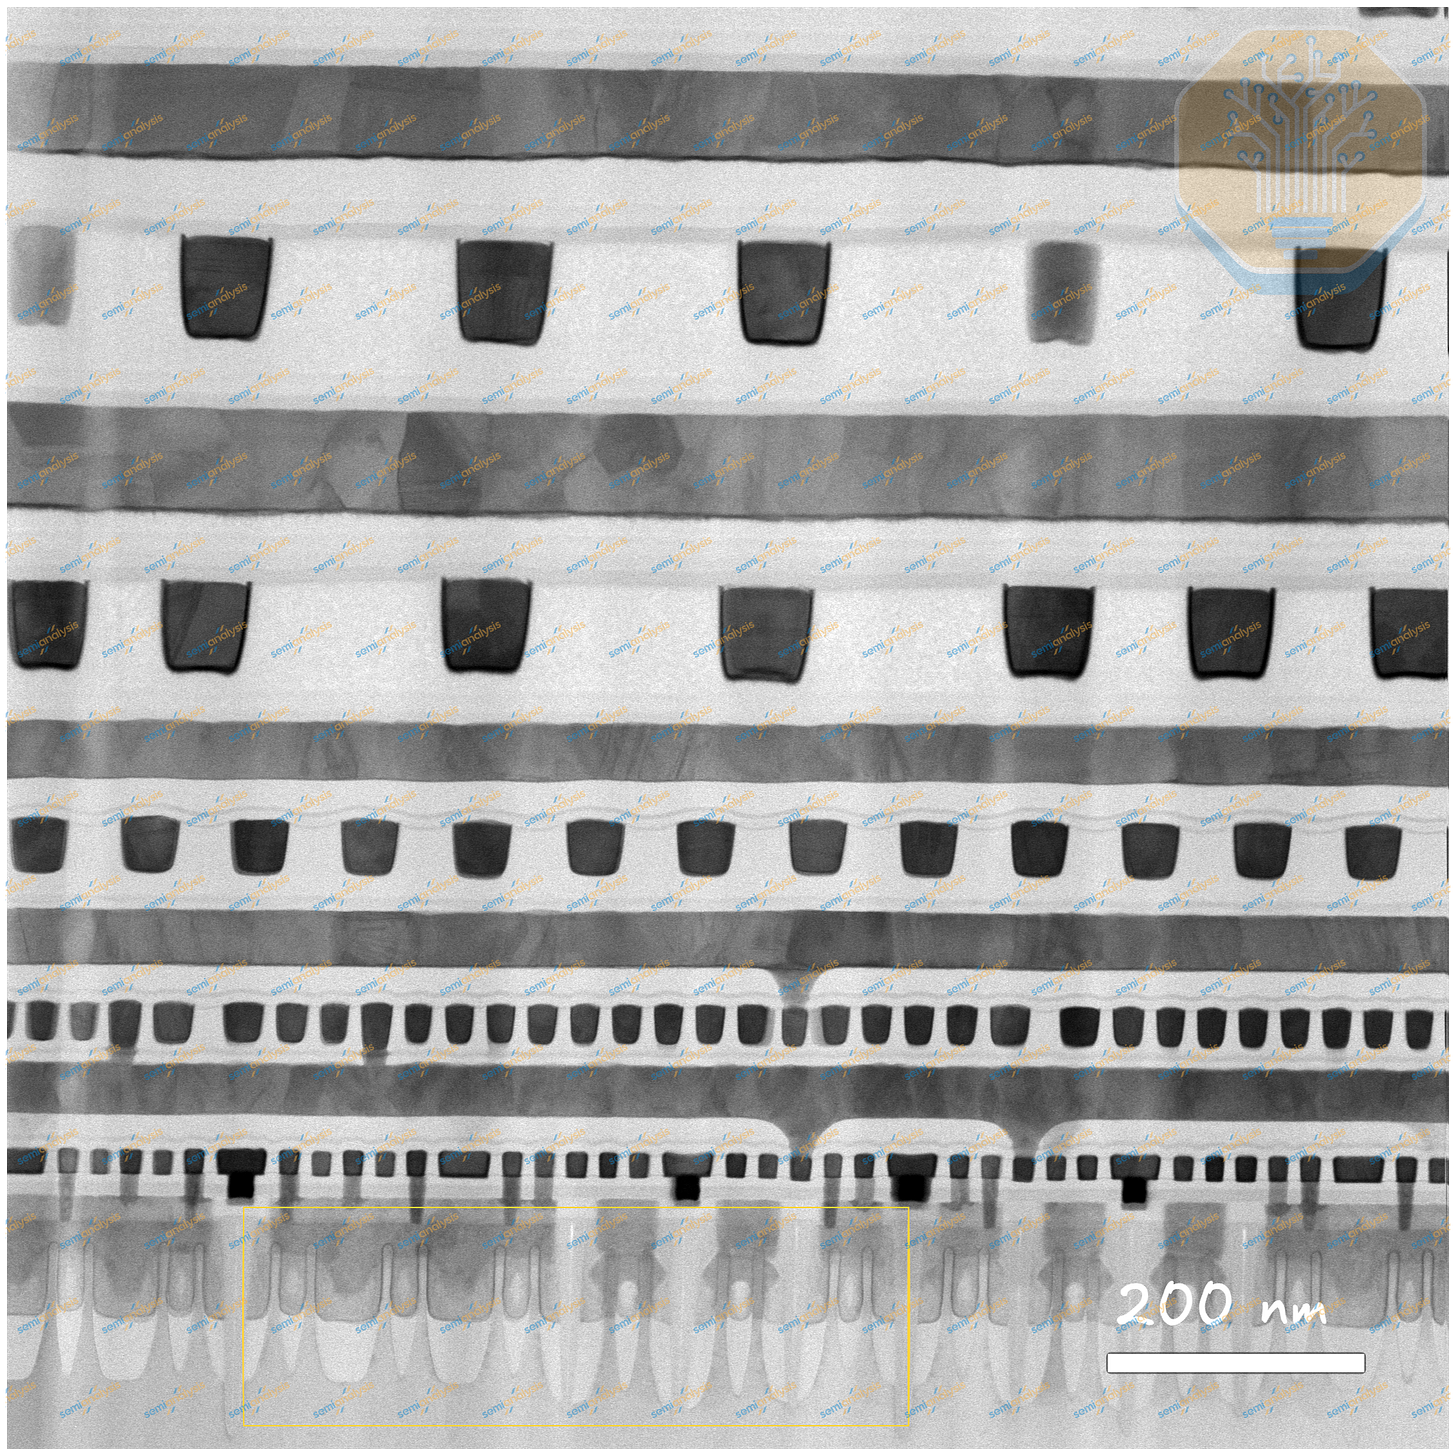
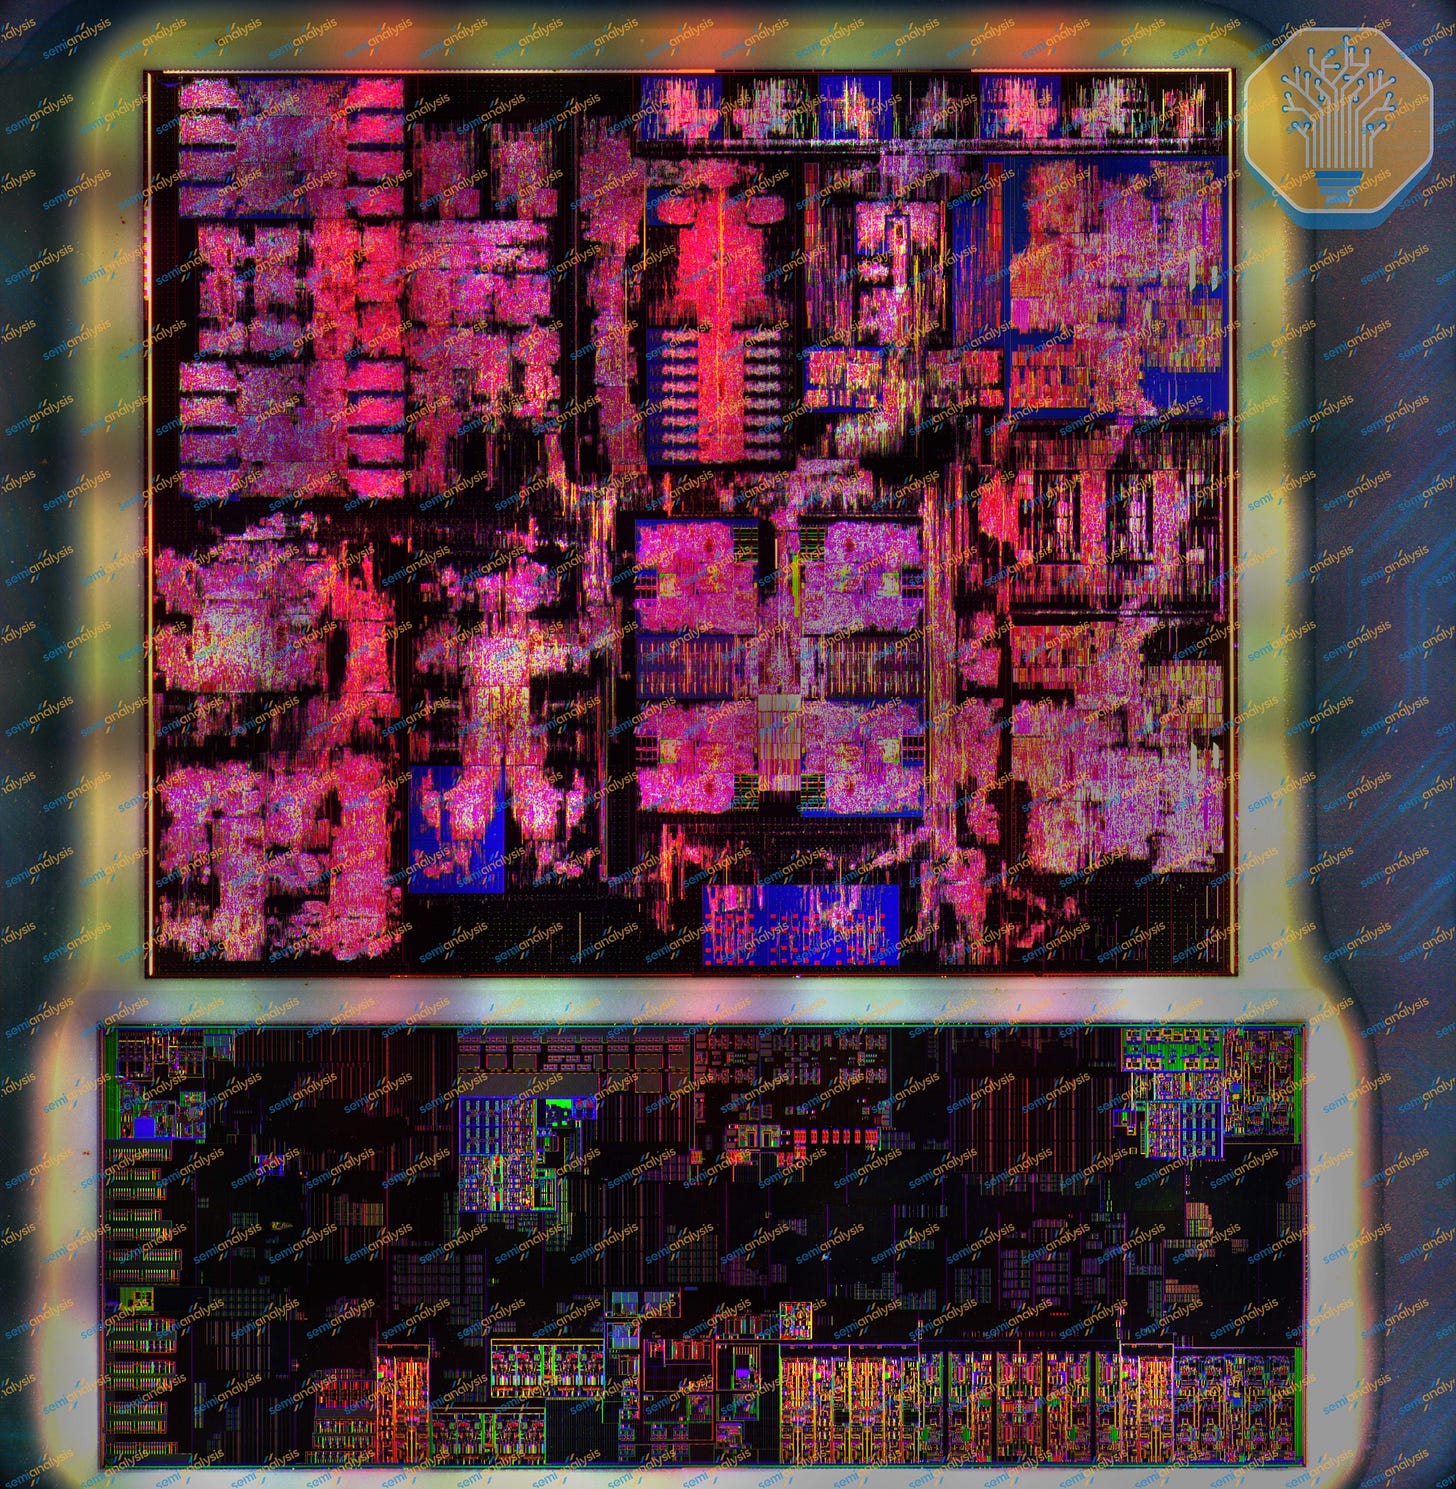
Intel 18A Panther Lake P-core logic (left) and Samsung SF2 Exynos 2600 C1-Ultra logic (right). HFW 550 nm (Intel) and 423 nm (Samsung). Source: SemiAnalysis
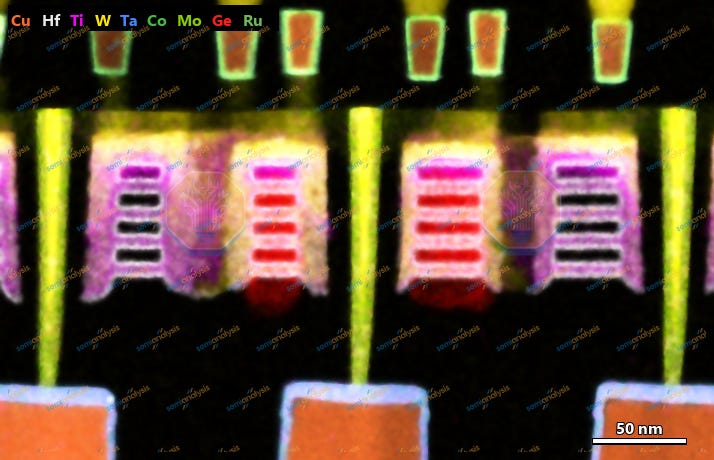
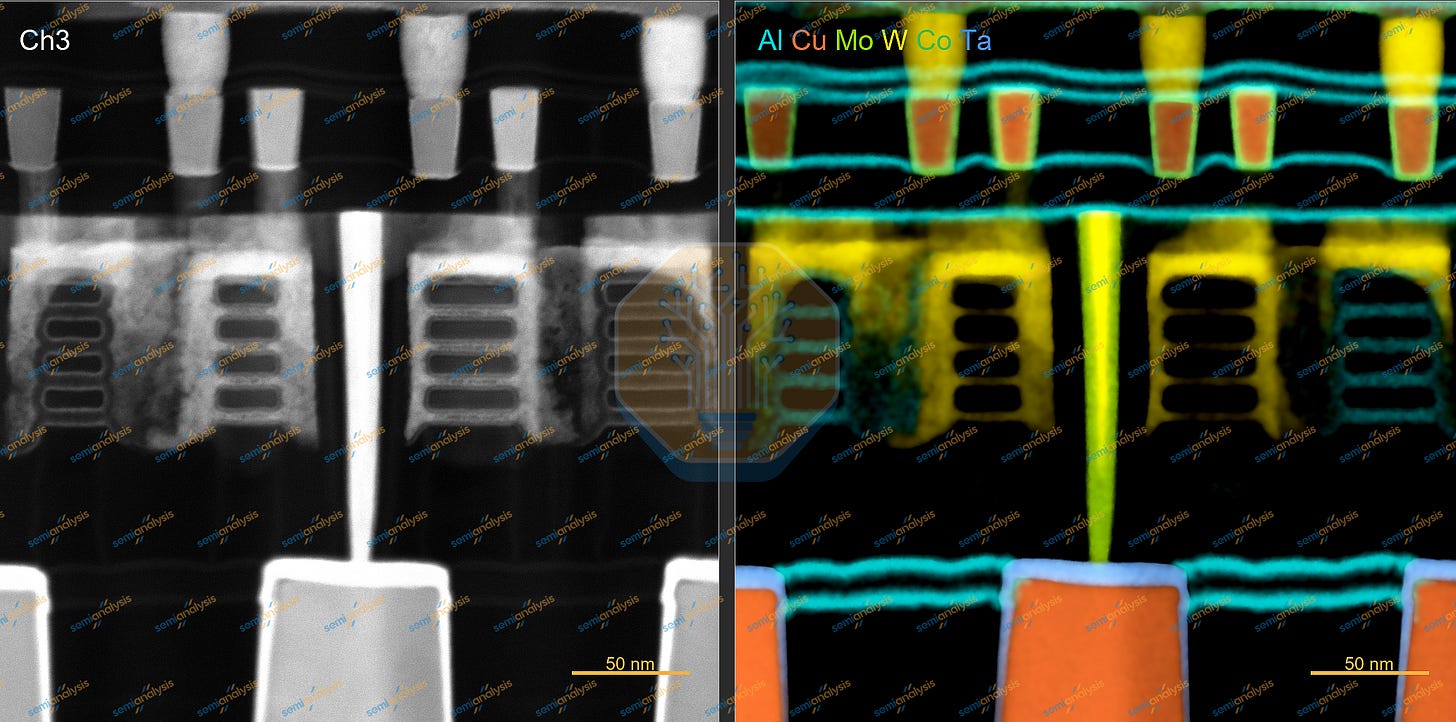
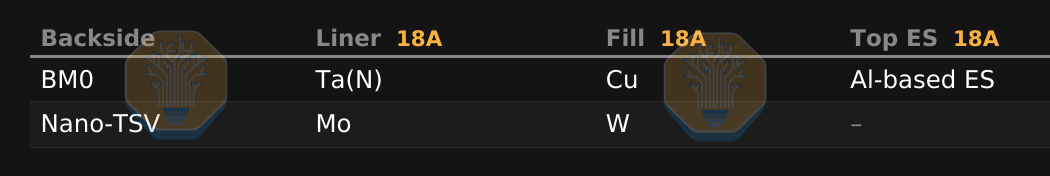
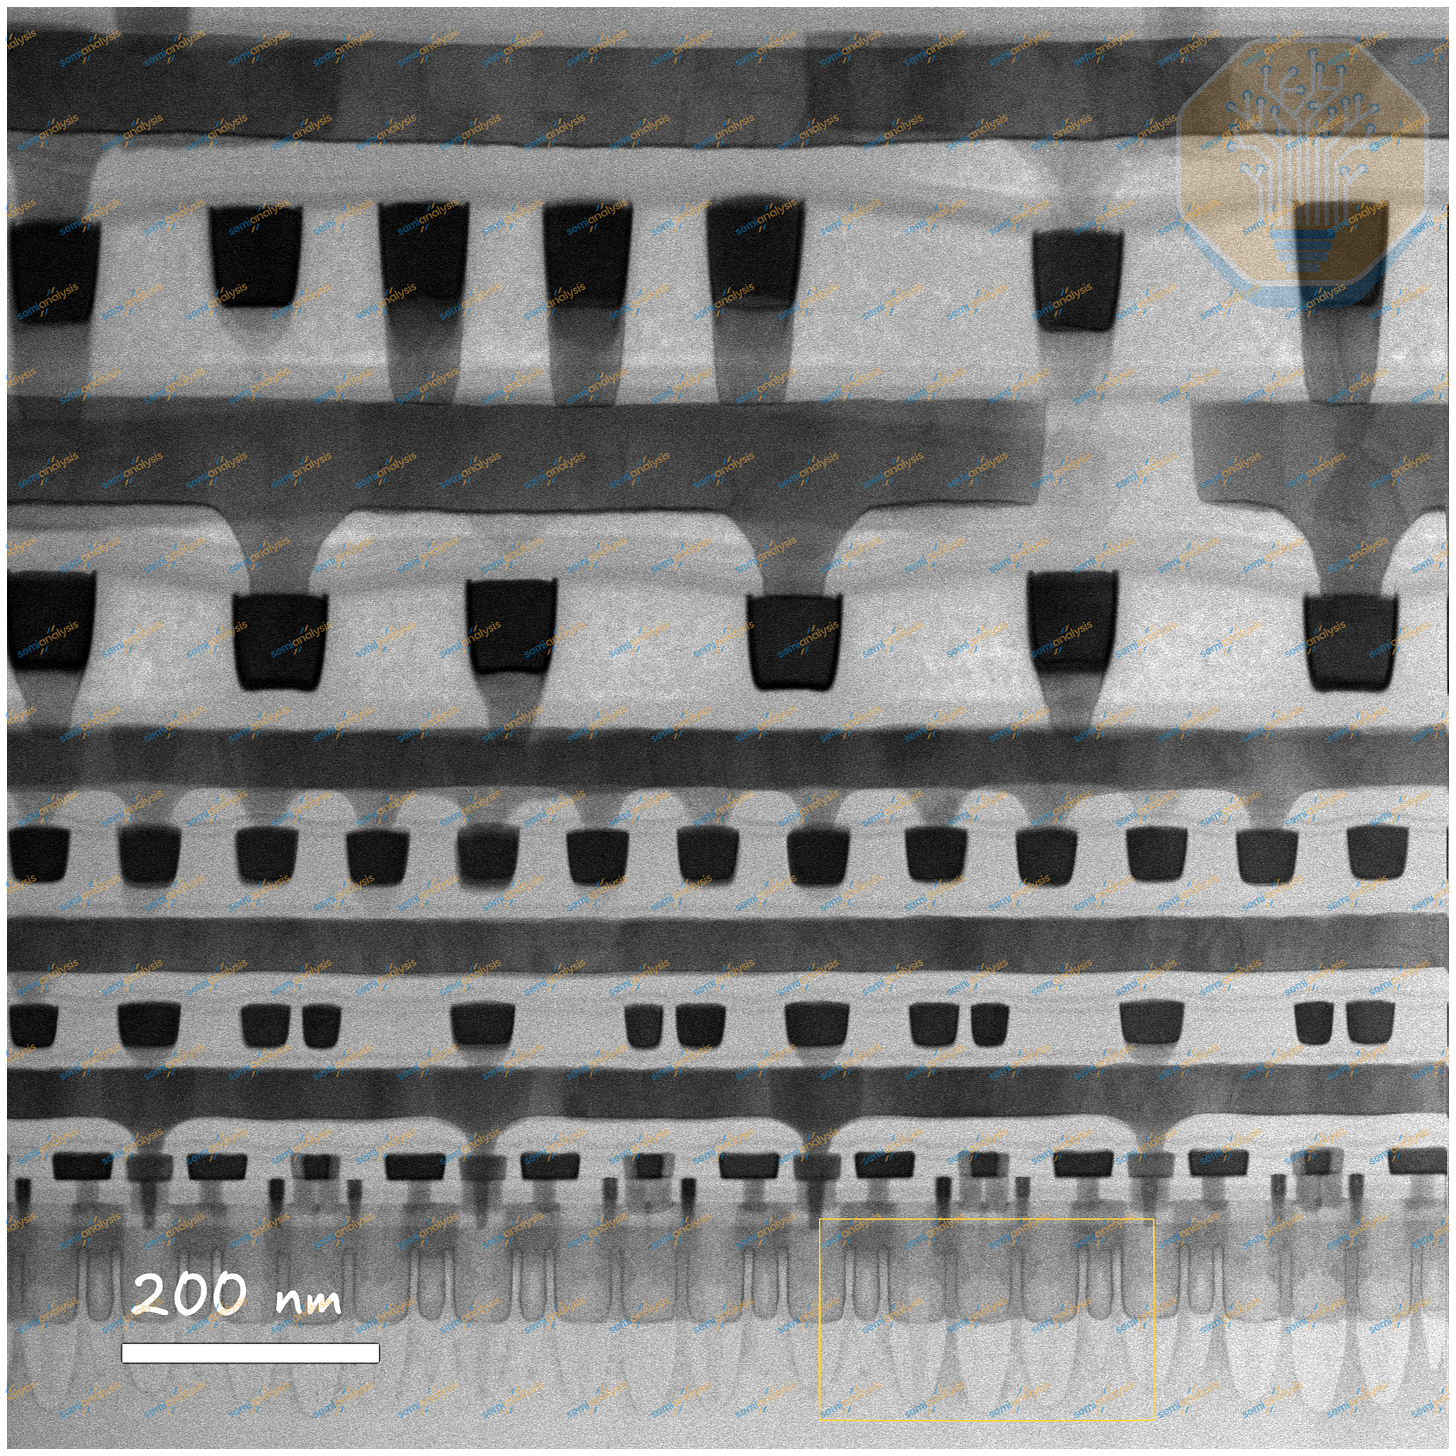
PowerVia 的供电路径从背面 Cu 电源轨出发,经过 Mo 衬垫的 W nano-TSV,到达局部晶体管接触孔。在这张截面图中,锥形连接从接触孔层到 BM0 大约跨越 150 nm。Ta 衬垫用于约束 Cu 并增强与周围叠层的附着力;AlOₓ 刻蚀停止层则控制电源轨上方下一次介质刻蚀。纳米片下方的介质层将器件与背面布线在电气上隔开,并去除沟道下方的导电硅体。[6]
Intel 18A Mo-lined W nano-TSV and Cu BM0 rail. Source: SemiAnalysis
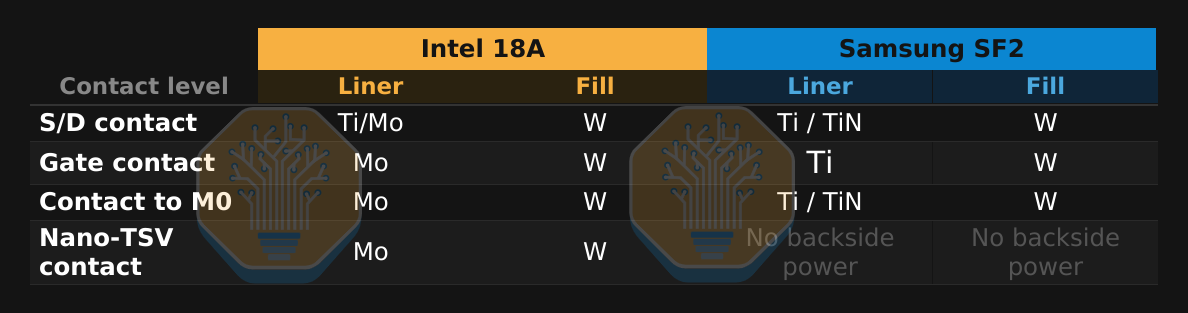
从器件到 M0,连接路径依次经过基于 Ti 的源漏(S/D)界面、钨接触孔填充、钼衬层的钨通孔,以及铜 M0 导线。钼为钨提供了导电的成核层和黏附层,取代了传统钨集成中电阻较高的 TiN 衬层。这增加了互连结构内的有效导电体积,同时保留了钨填充及其成熟的抛光、清洗和刻蚀工艺。Intel 的钼/钨专利描述了这种集成上的权衡取舍。纳米级硅通孔(nano-TSV)在背面供电路径中同样采用了钼衬层的钨结构。[12]
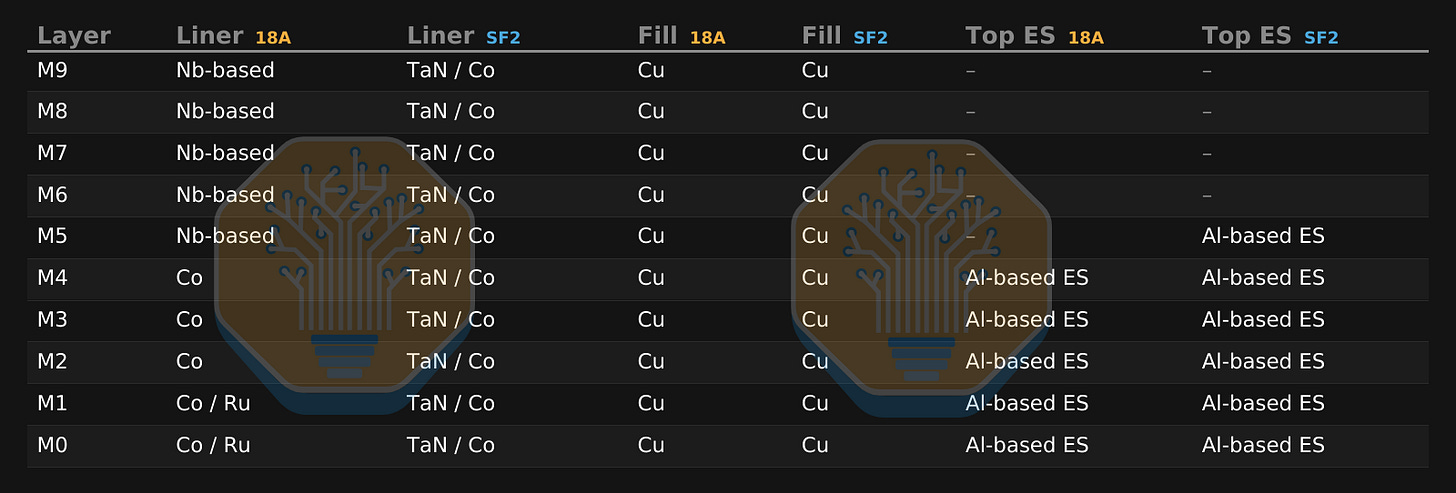
Intel 18A and Samsung SF2 contact and via materials. Source: SemiAnalysis
从 TiN 改用钼是一个渐进式的改变。虽然完全采用钴或钼填充也能减少极小结构中衬层占用的体积,但这需要新的集成方案,会增加复杂性和风险。由于电阻较低,铜在较宽的导线中仍然具有吸引力。随着导线和通孔尺寸不断缩小,扩散阻挡层在其横截面上占据的比例越来越大。[12], [12], [14]
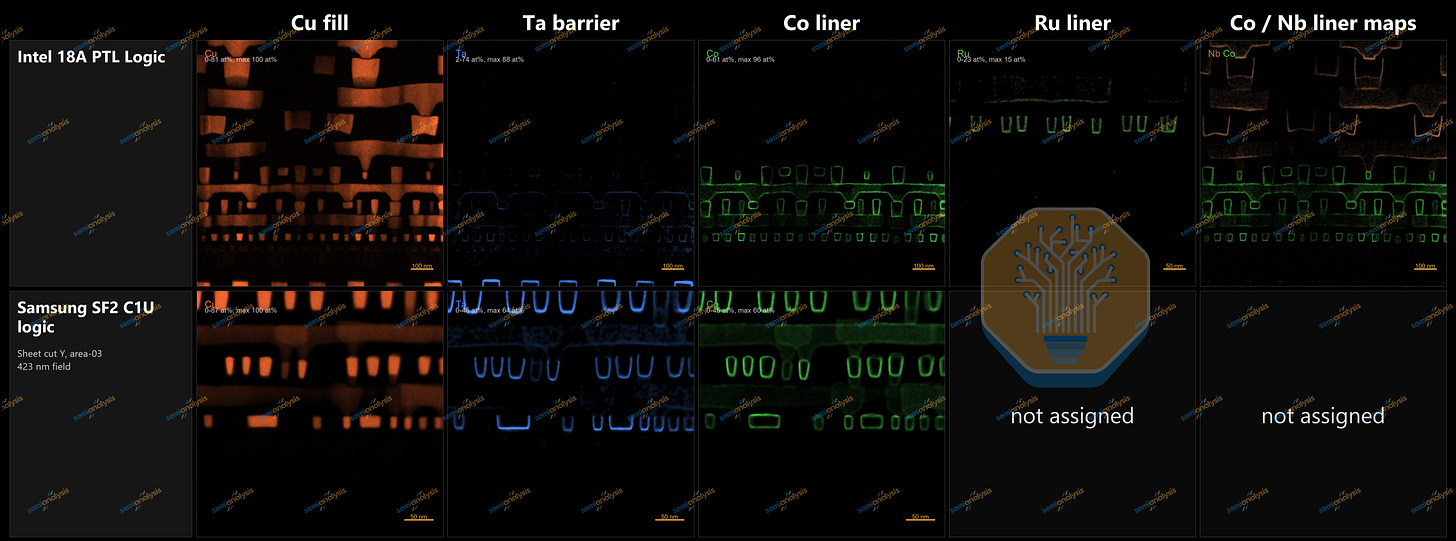
Intel 18A Panther Lake P-core logic (top) and Samsung SF2 C1U logic (bottom), interconnect EDS maps. Cu, Ta, Co, Ru, and combined Co/Nb maps, left to right. Source: SemiAnalysis
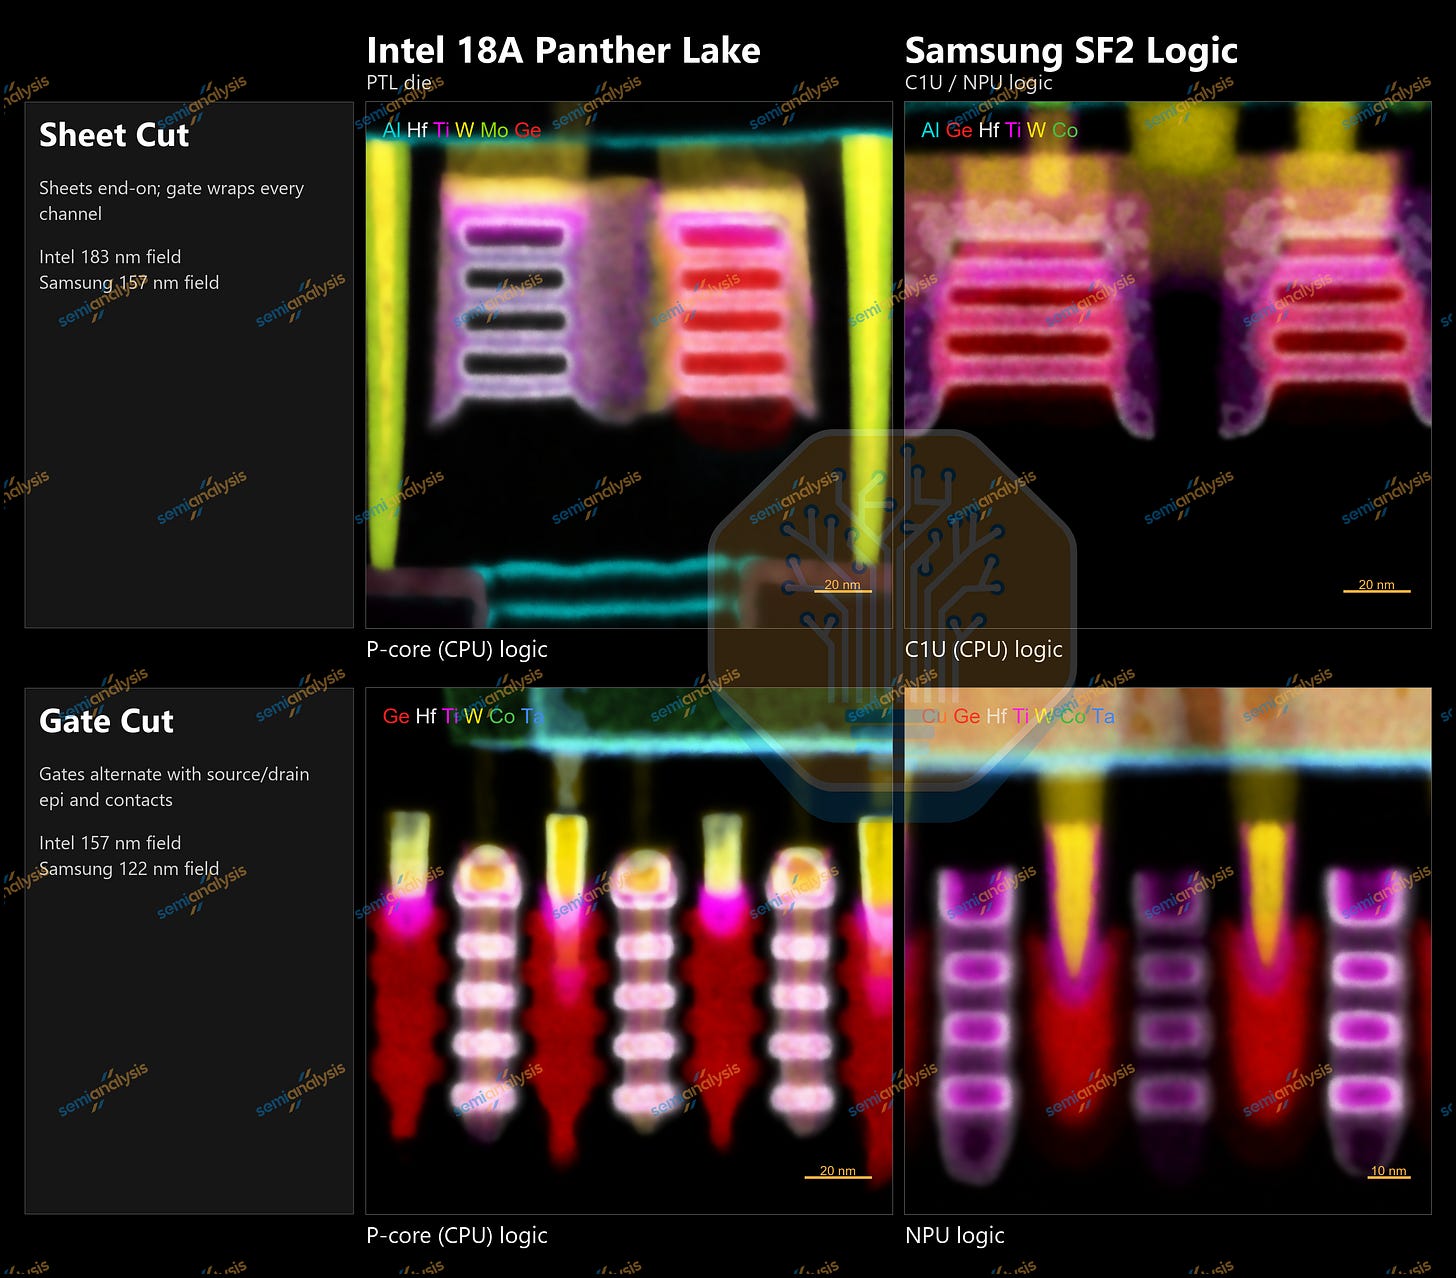
Top: sheet cuts, Intel P-core logic and the Samsung logic field labelled CU. Bottom: gate cuts, Intel P-core logic and Samsung NPU logic. Cut directions are matched; cell functions and drive targets differ. Scale bars per panel. Source: SemiAnalysis
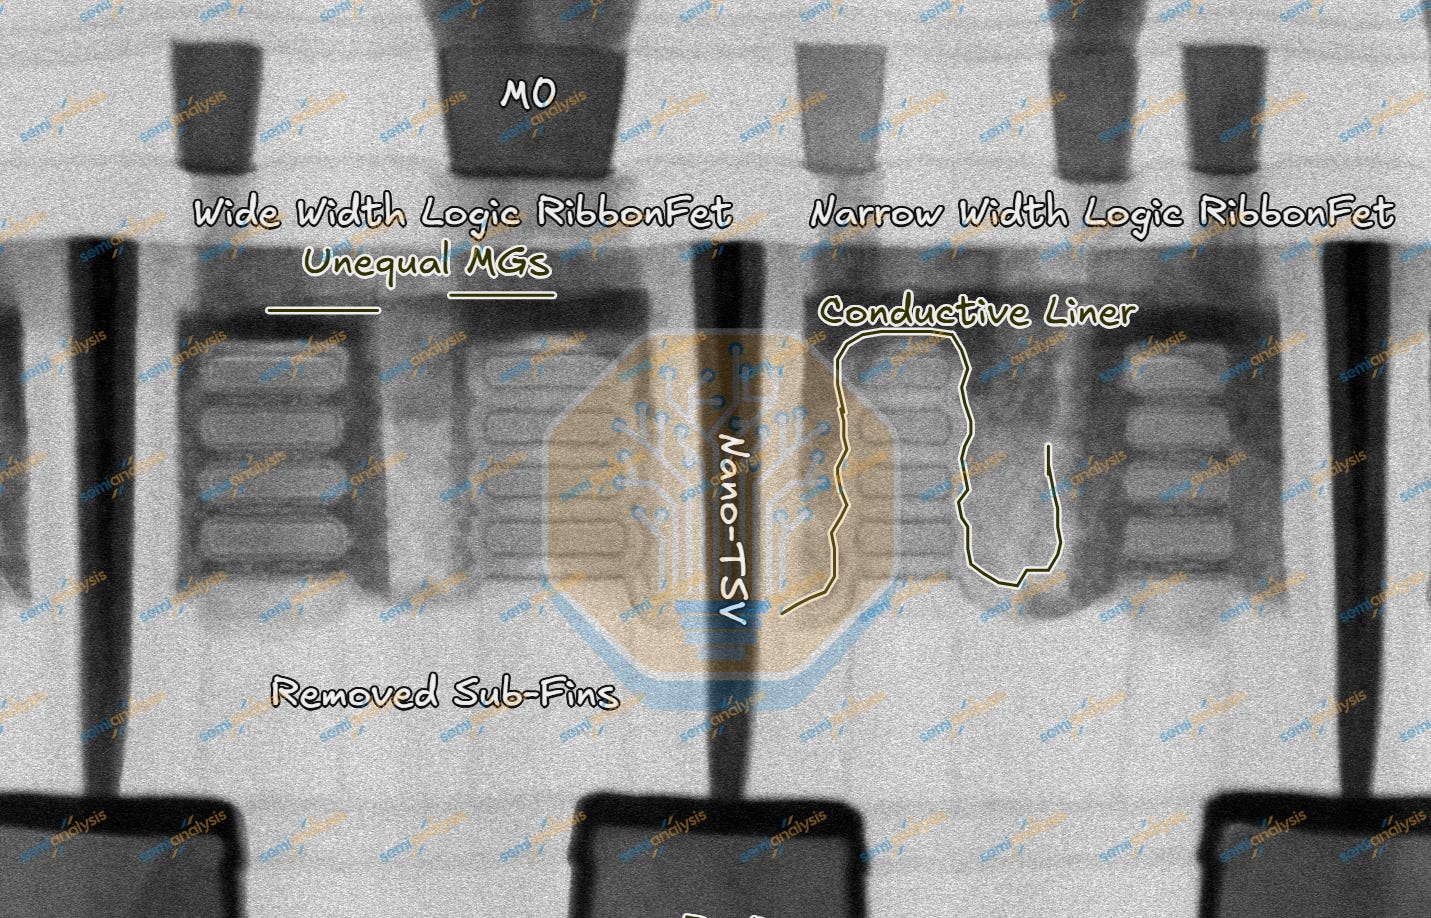
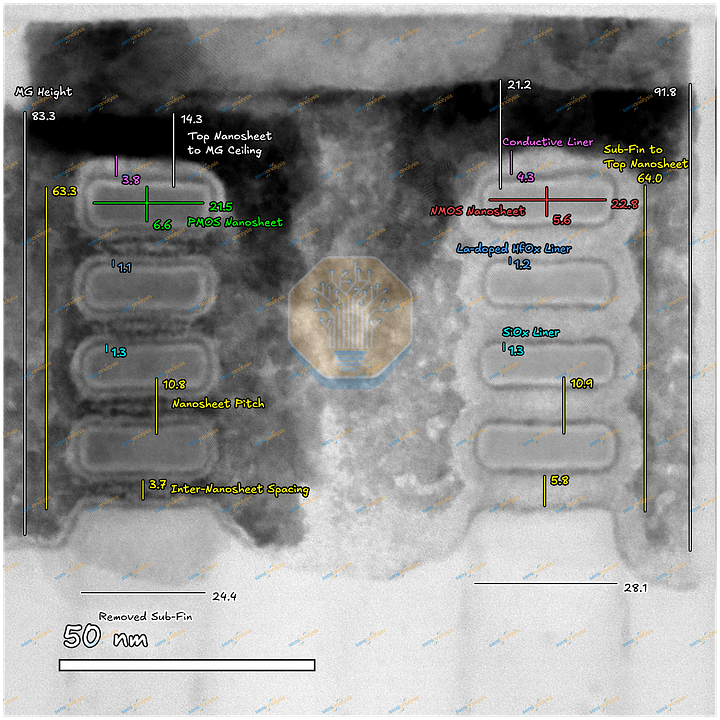
Intel 在接触孔下方保留了抬升的源/漏外延层,而 Samsung 则将 W 深深凹入外延层中,形成 V 形的 Ti 衬里界面。更深的接触孔增加了金属与半导体的接触面积,并缩短了从下层纳米片流出的电流路径,从而降低了接触电阻和扩展电阻。但这也移除了部分外延材料,并使接触孔刻蚀更靠近沟道末端。保留更多外延材料则可维持可用于应变转移的材料,尤其是从 SiGe 向 PMOS 的应变转移。这些几何结构在接触孔可达性、应力工程和刻蚀余量之间实现了平衡。[22], [23]
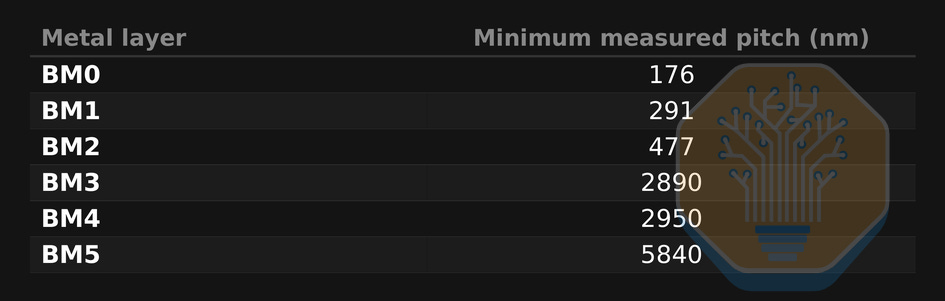
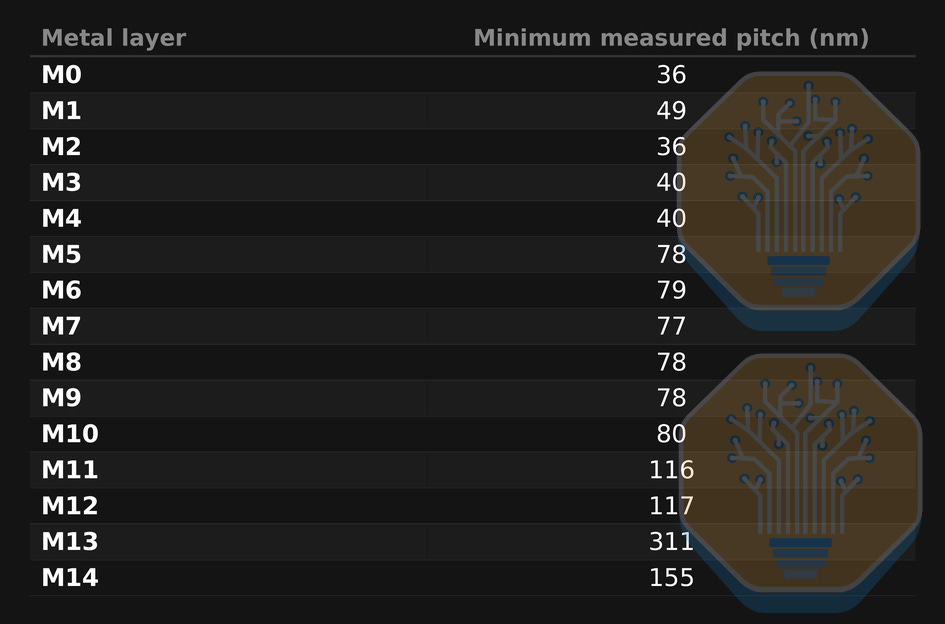
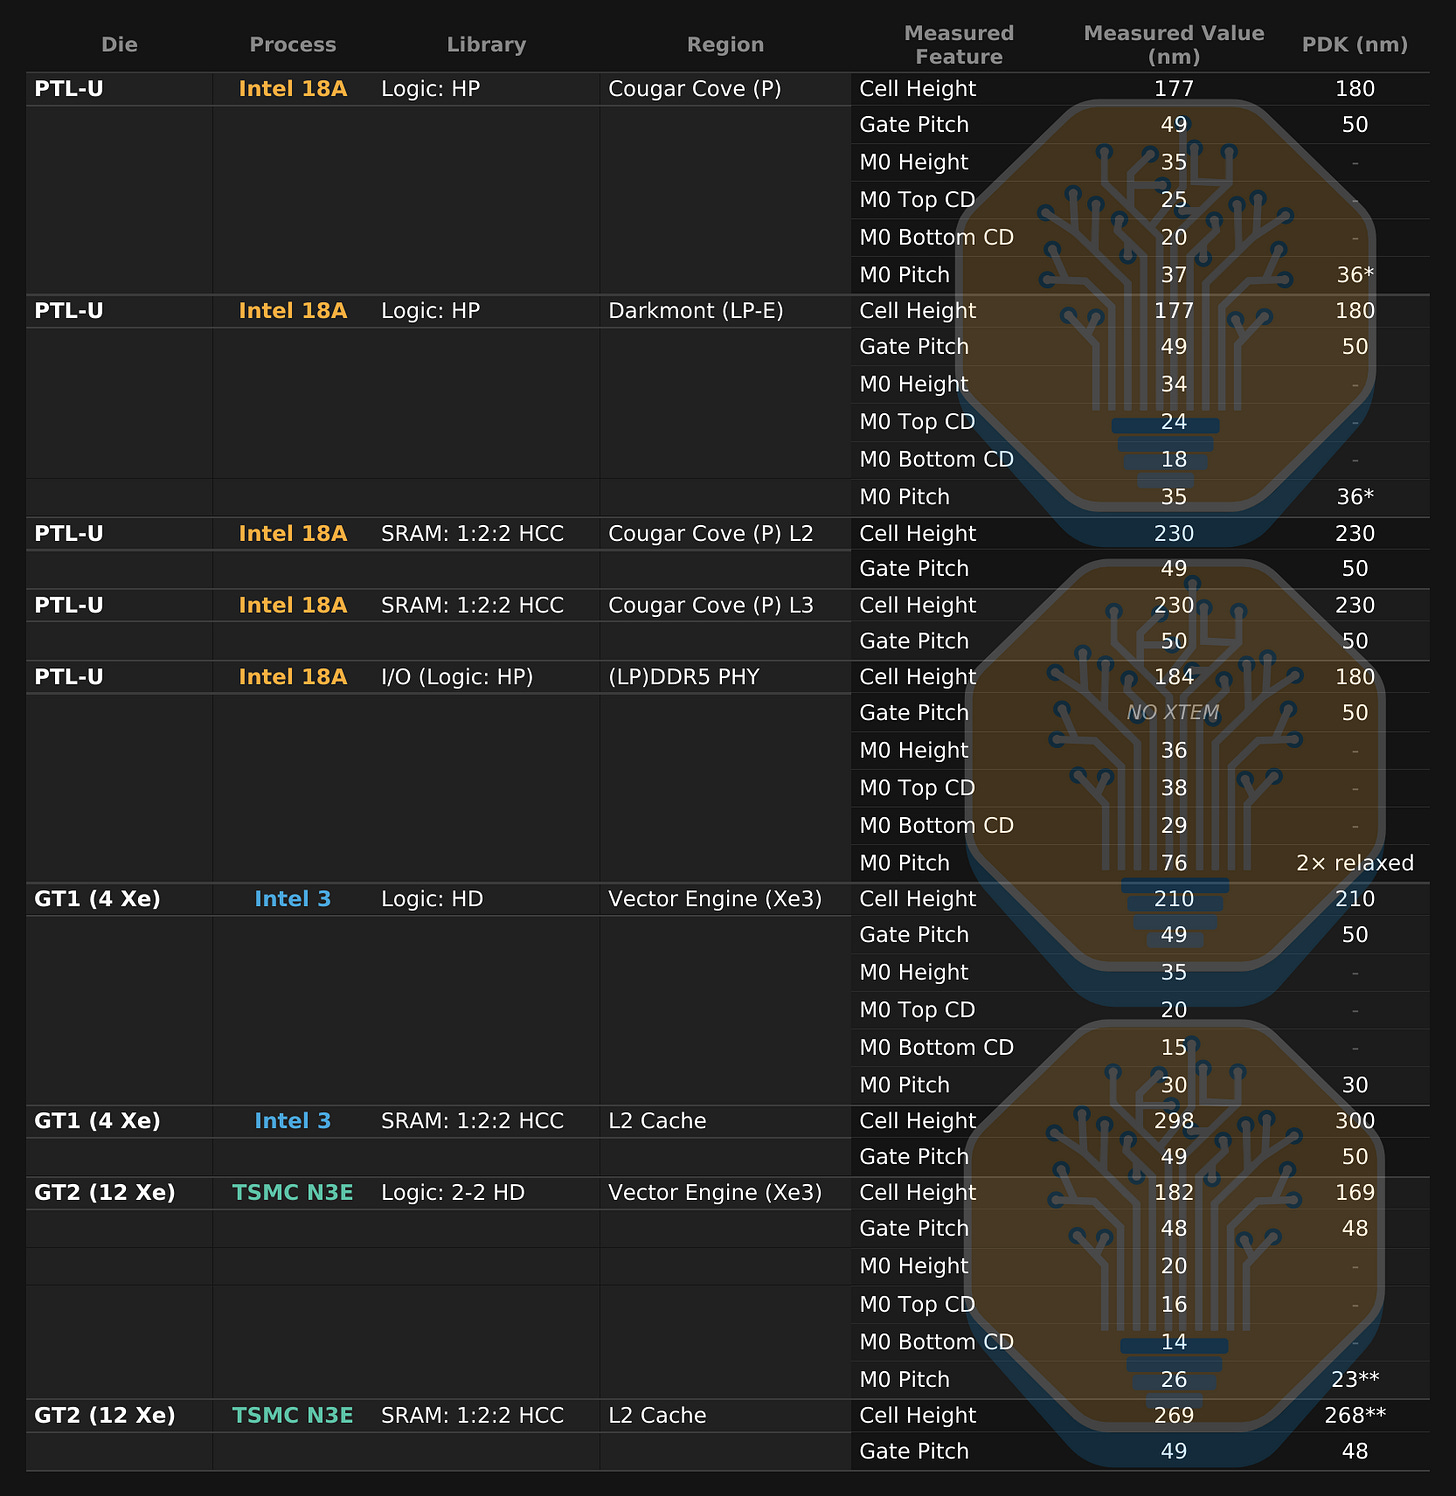
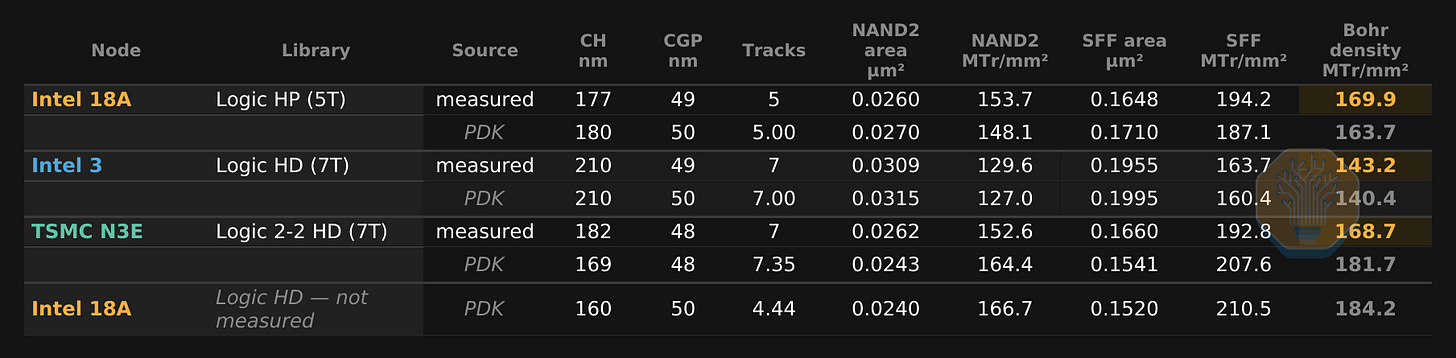
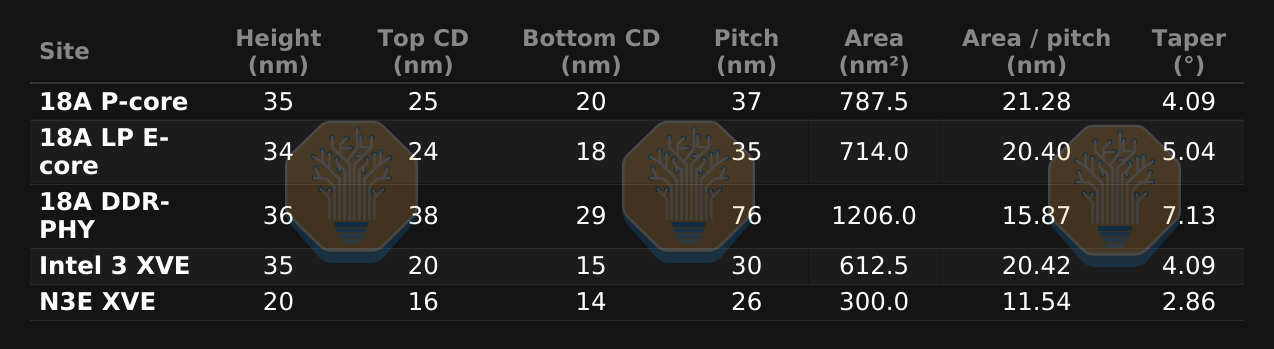
Measured library dimensions. *Intel 18A PDK provides M0 pitch of 32 nm, but Panther Lake HP libraries shipped at 36 nm, **3rd party discolsures. Source: SemiAnalysis
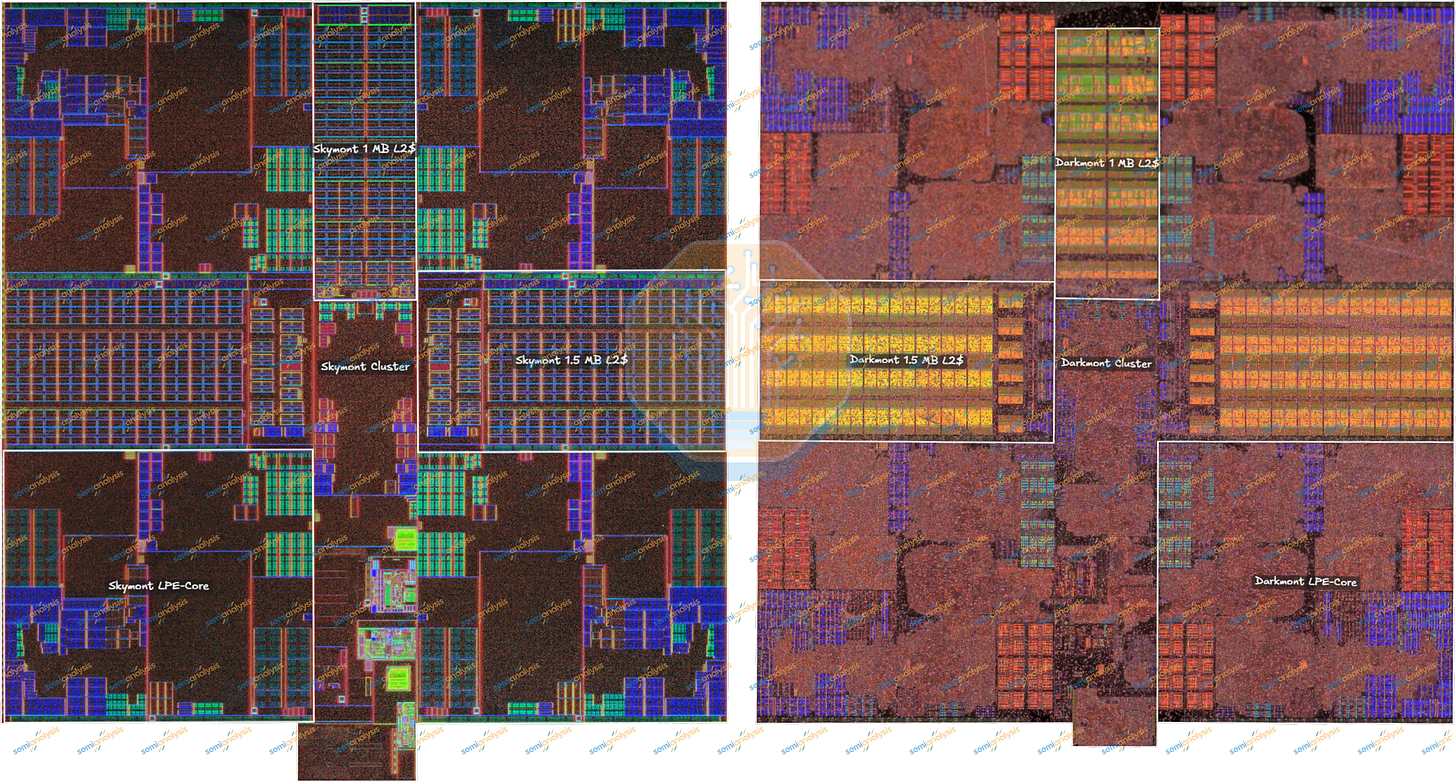
Lunar Lake Skymont (left) and Darkmont (right) LP E-core clusters. Source: SemiAnalysis
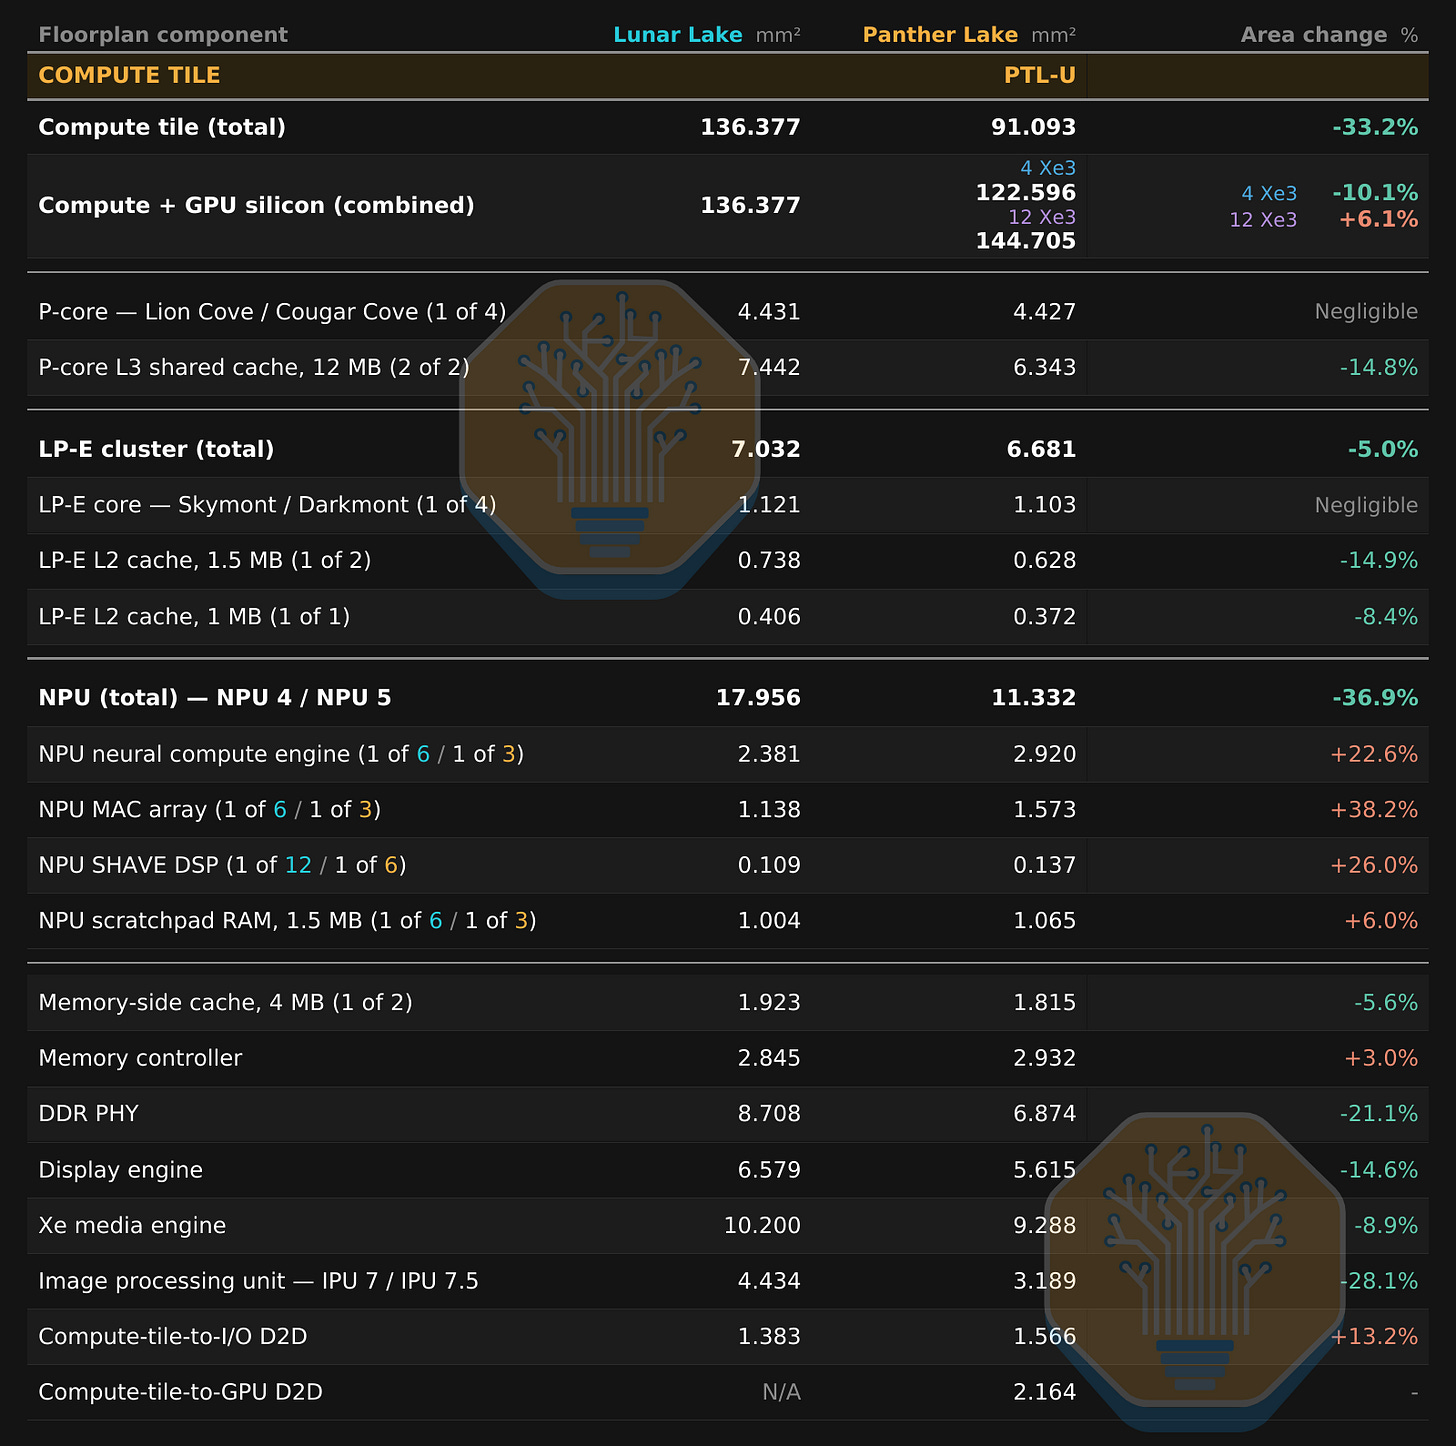
Darkmont 的四核 LP E 核集群比 Lunar Lake 上 Skymont 的版本小 5.0%,其中大部分缩减来自其 L2 区域。1 MiB 区域缩小了 8.4%,1.5 MiB 区域缩小了 14.9%。标签阵列(tag array)也少了一个可见行。标签用于标识数据阵列中存放了哪些内存地址,因此重新排列标签会改变缓存的布局和布线,而无需减少数据容量。[2]
LP E 核共享一个 L2。这样可以汇聚容量,并避免重复整套缓存机制,但四个内核会争用其 bank 和带宽。独立的集群还能让轻量级任务远离性能集群及其 L3,使那个更大的域得以休眠。[1], [2]
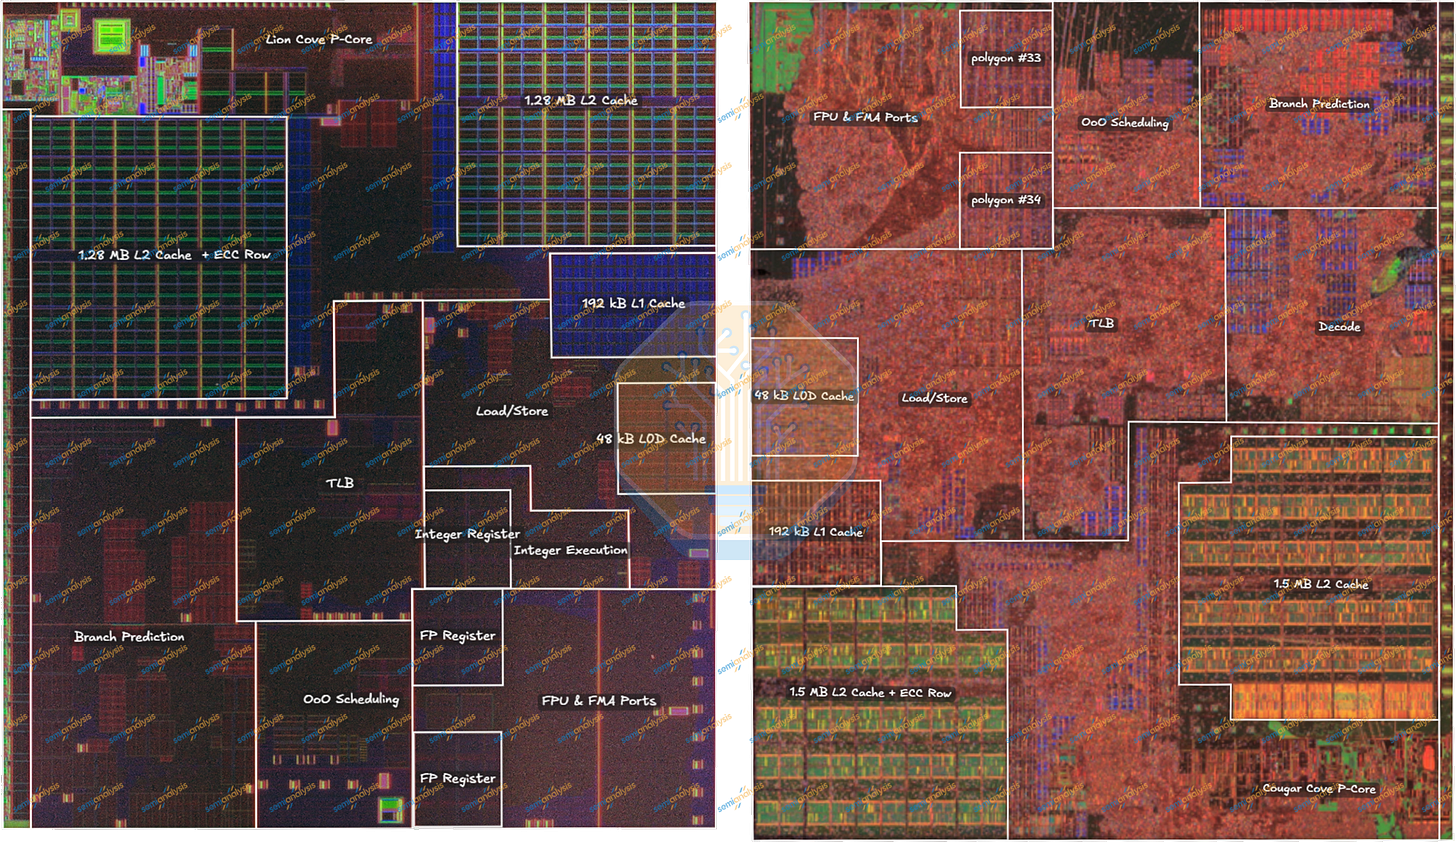
缓存面积不仅包括存储单元。标签标识每一行,解码器选择行,灵敏放大器读取微小的位线信号,导线则连接到各个 bank。将阵列拆分为更小的区段可以缩短字线和位线,提升访问速度,但会重复外围电路。因此,Panther Lake 更小的缓存区域反映的是完整的存储器实现,包括每个区域中用于存储的比例。[34]
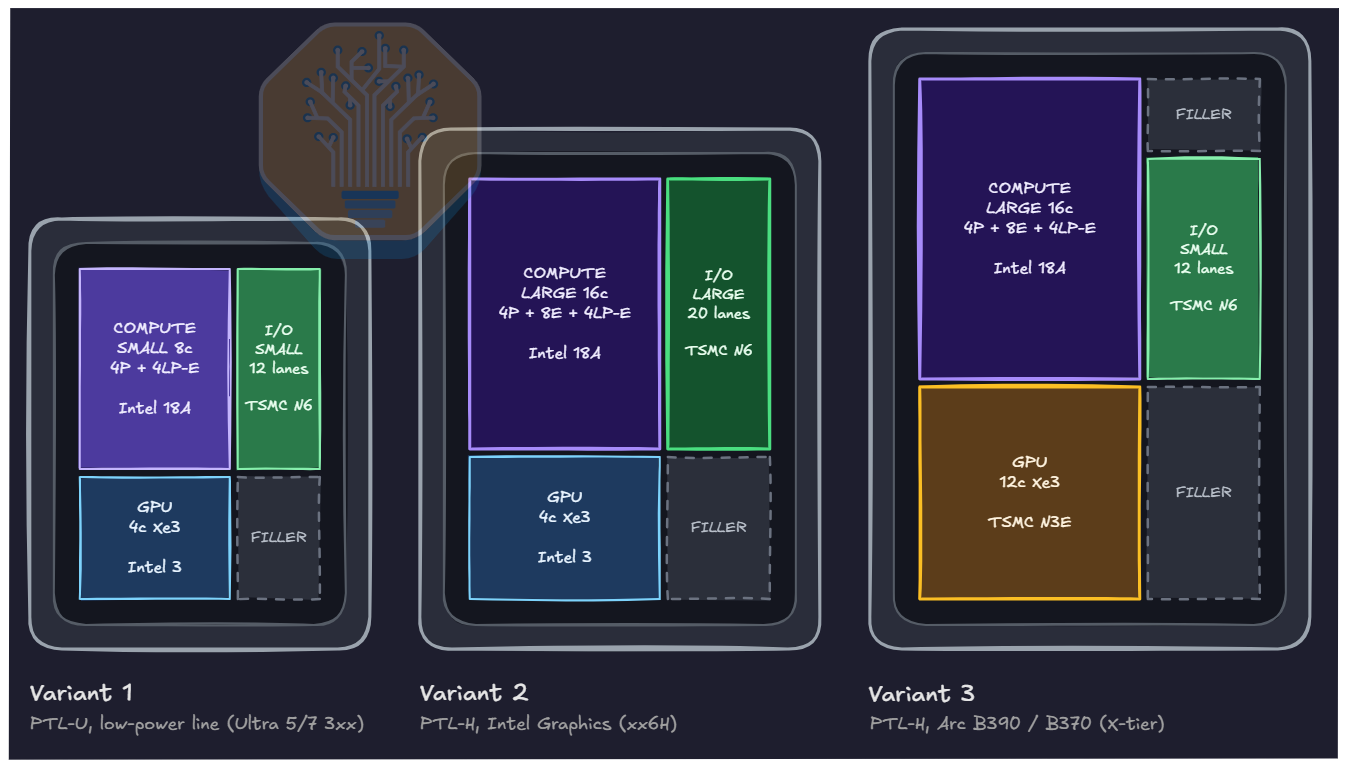
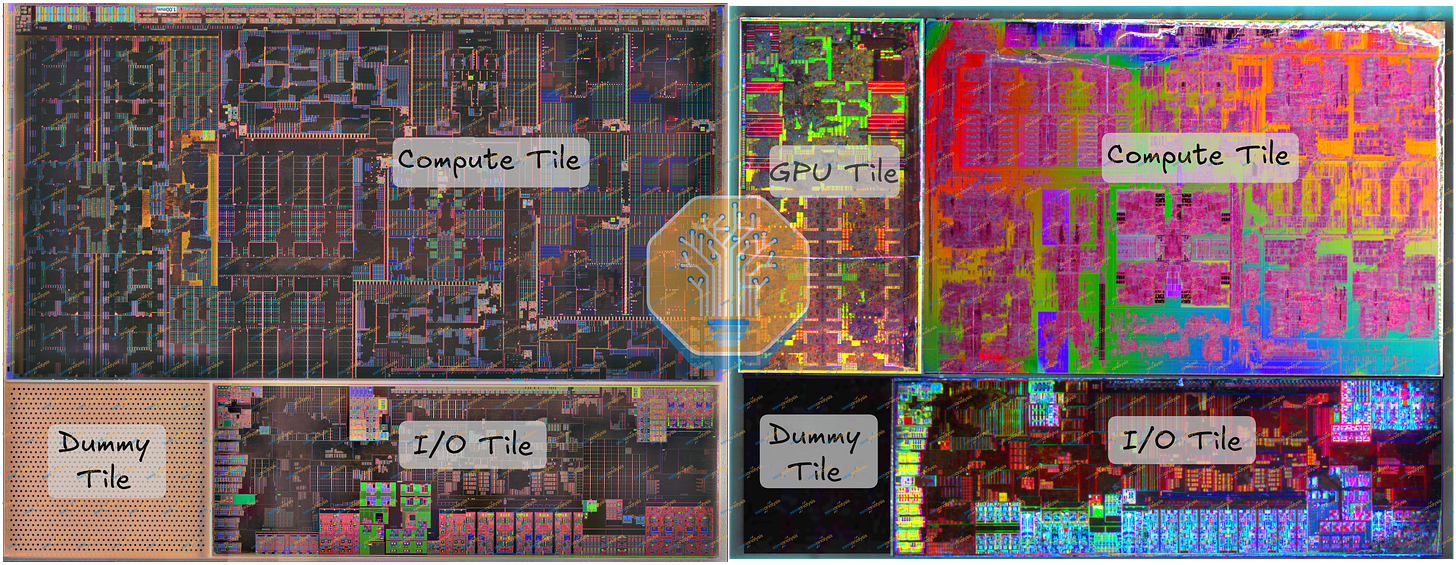
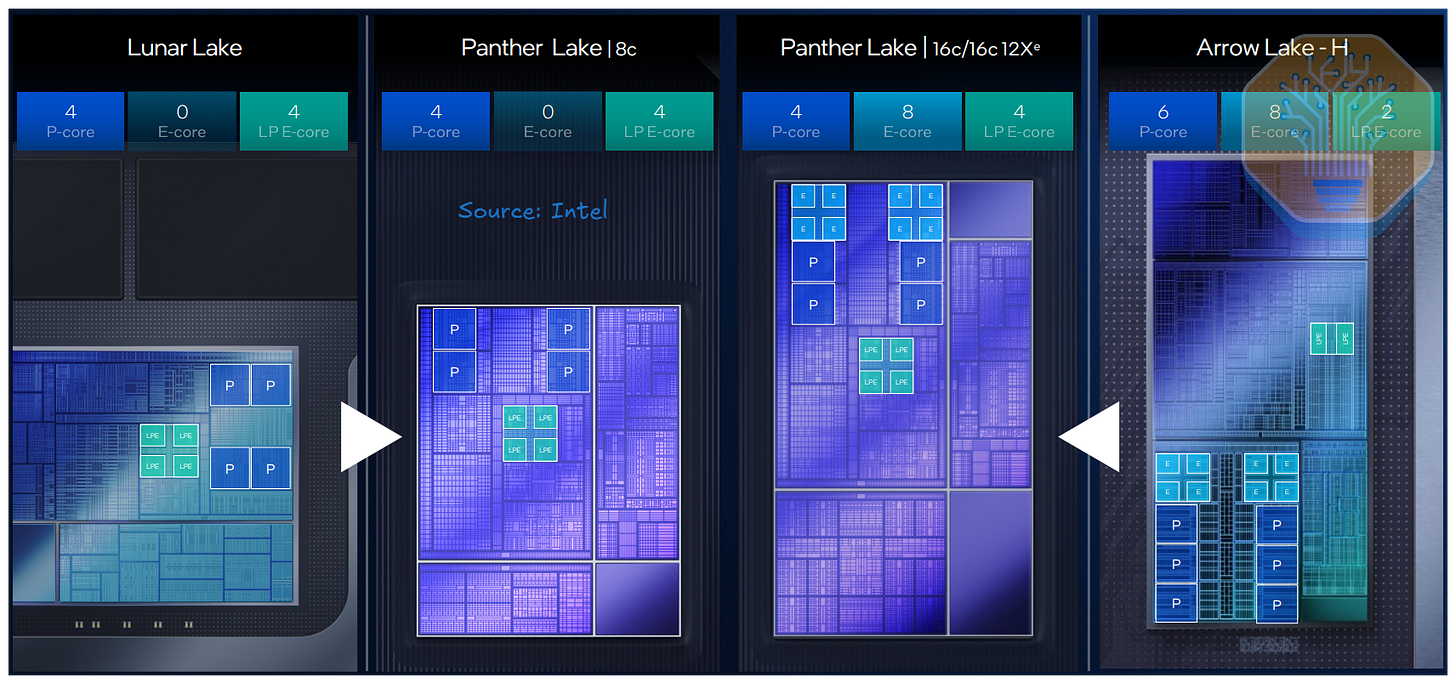
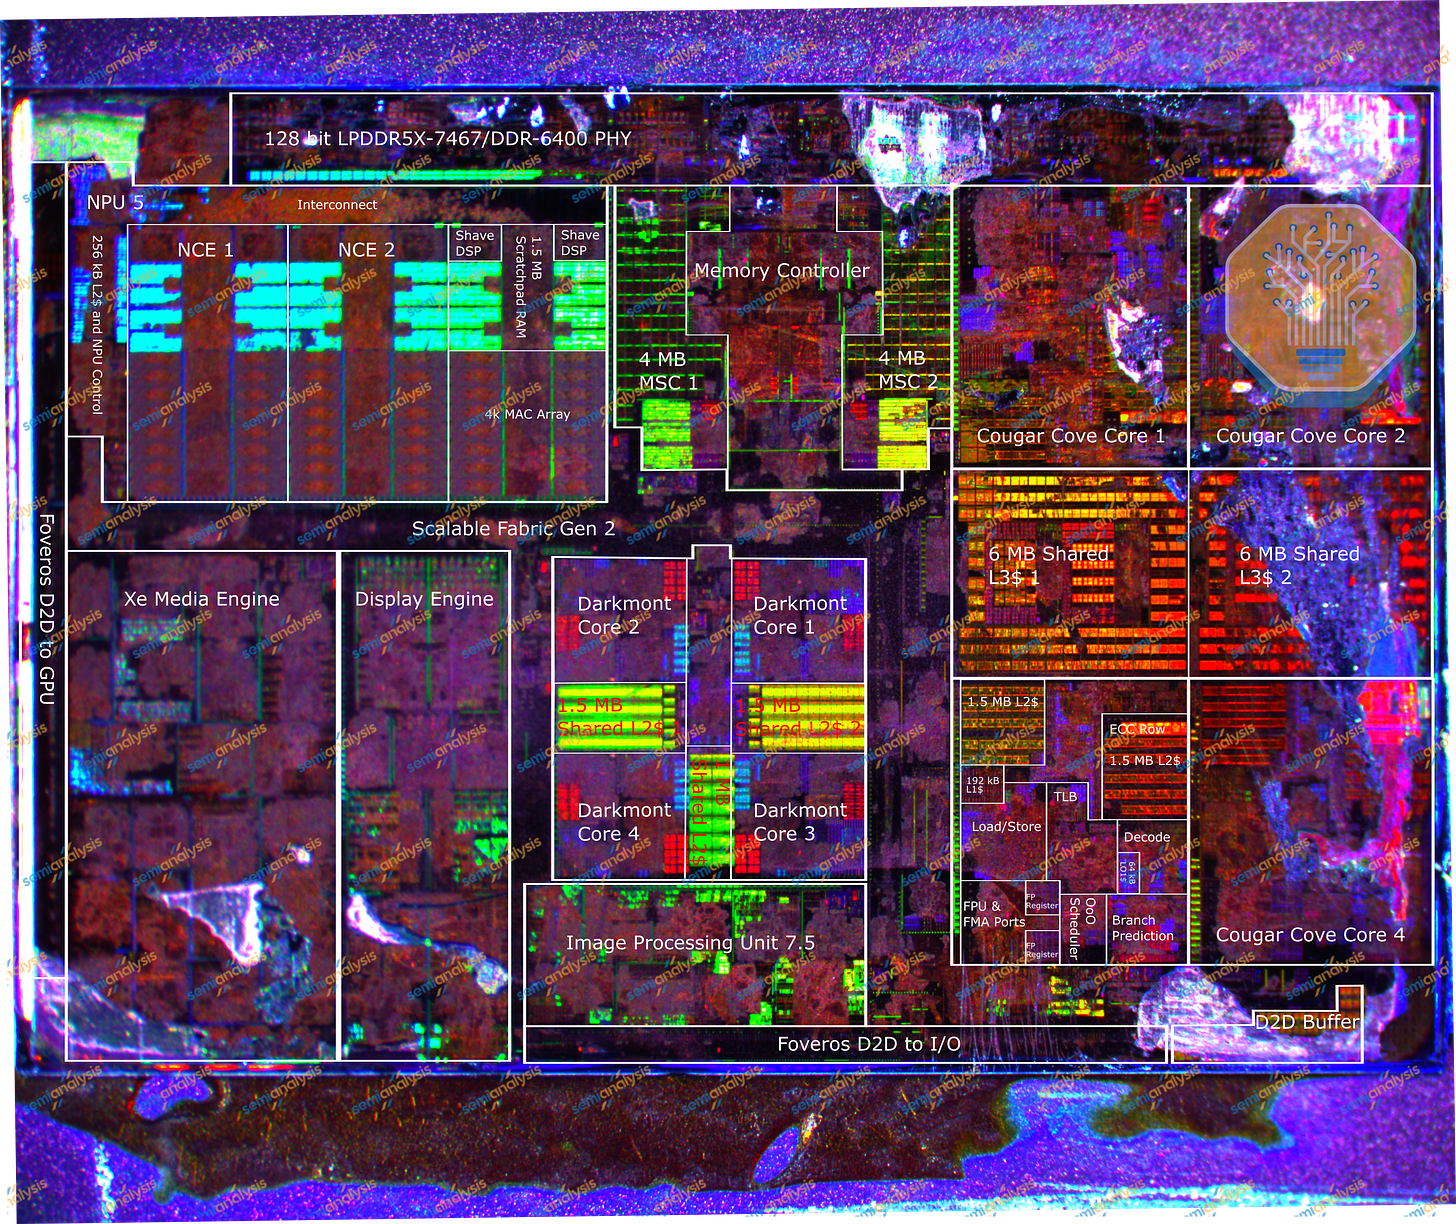
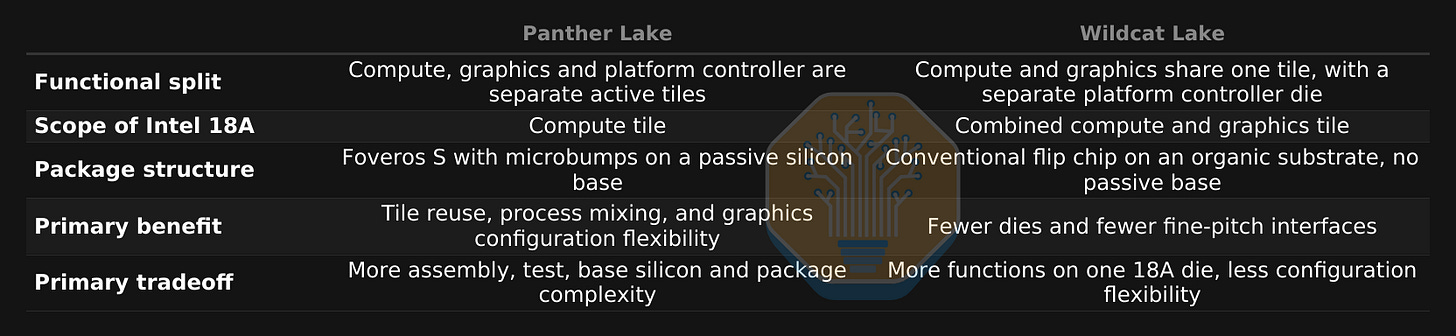
与 Meteor Lake 和 Arrow Lake 不同,Panther Lake 没有独立的 SoC 裸片。NPU、LP E 核、内存控制器、PHY、媒体和显示引擎现在都共享计算裸片。这去除了一个有源裸片,并使 CPU 的内存流量保持在同一裸片上。代价是将 PHY 和 I/O 相关电路迁移到了 18A 工艺上:驱动器、接收器和模拟电路仍必须满足外部电压、负载和信号完整性要求,因此它们的面积不会像高密度数字逻辑那样缩小。[1], [2]
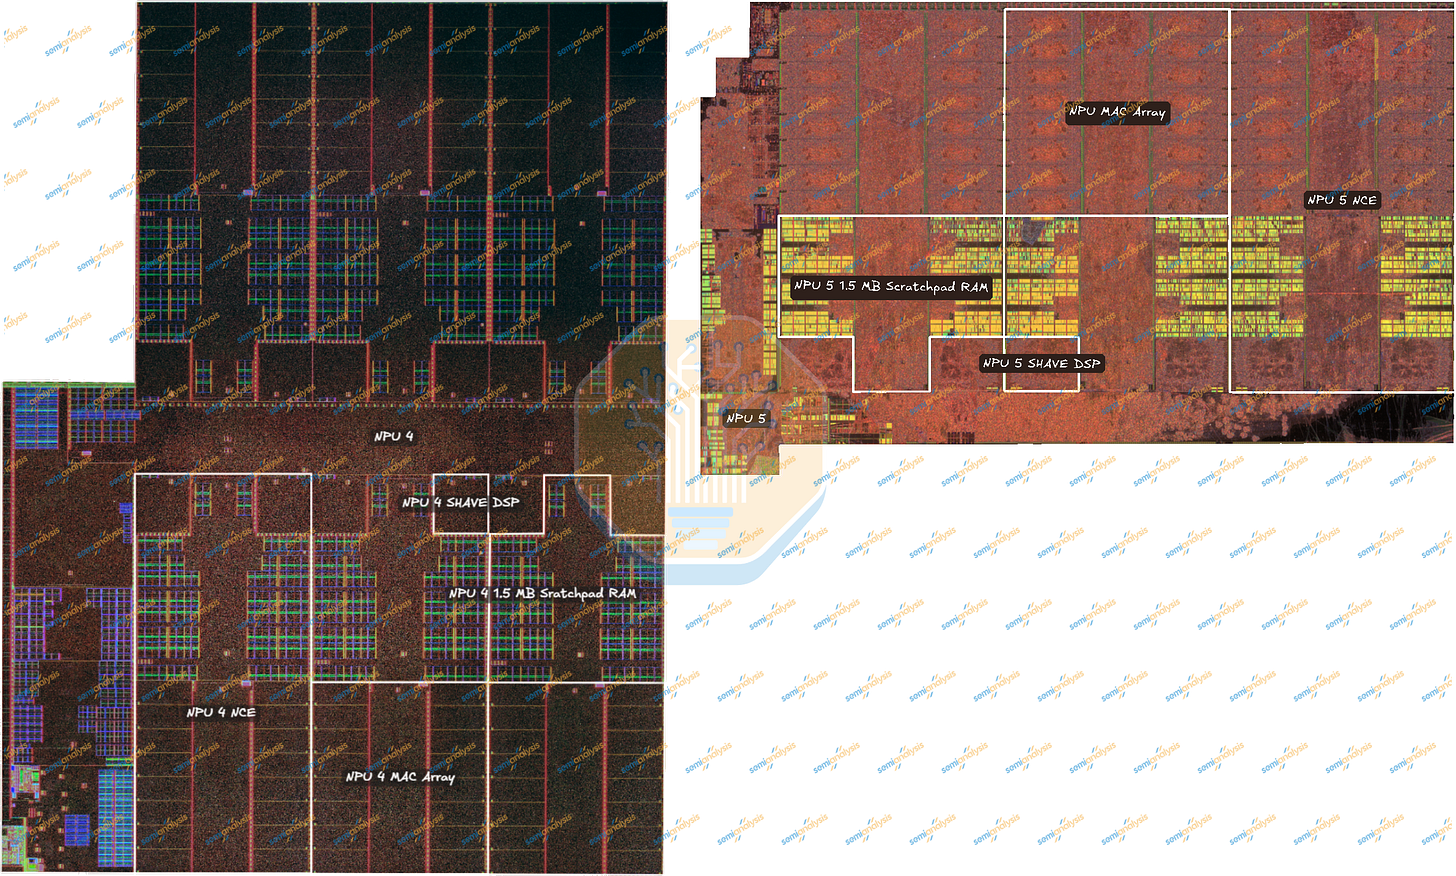
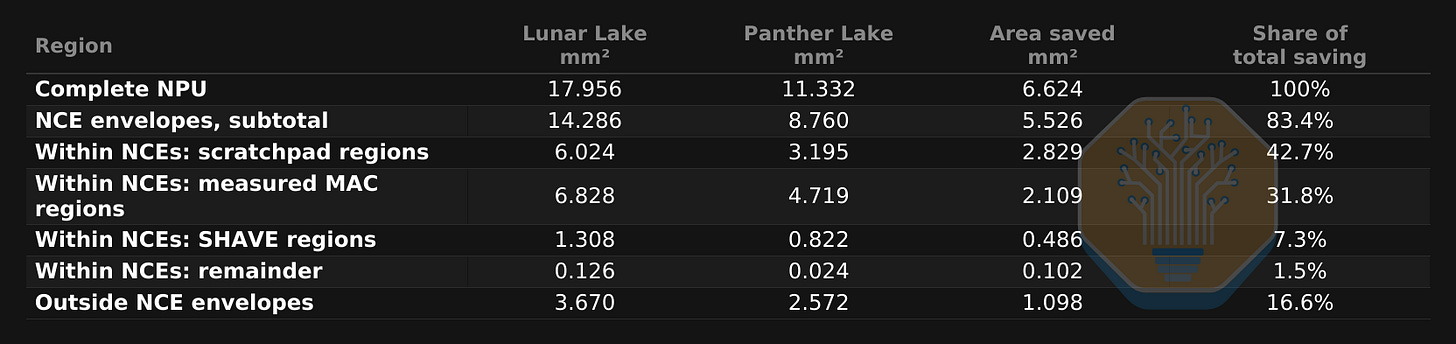
缩小幅度最大的是 NPU,其面积减少了 36.9%。NPU 5 将相同的 INT8 MAC 总数整合到数量减半的神经计算引擎中。三个 NCE 中的每一个都拥有更大的 MAC 阵列,使得单个 NCE 的整体面积比 NPU 4 的一个引擎大 22.6%。这种整合还将暂存存储器(scratchpad)和 SHAVE DSP 的数量从 12 个减半到 6 个。MAC 阵列负责矩阵乘法和卷积运算,而 SHAVE 则执行向量运算以及不太适合阵列结构的自定义运算。[1], [2], [35]
Lunar Lake NPU 4 (left) vs Panther Lake NPU 5 (right). Source: SemiAnalysis
成对的版图(floorplan)标出了每个 NCE 的整体轮廓及其 scratchpad、MAC 和 SHAVE 区域。在下方的面积统计中,每个测量得到的 MAC 多边形在每个 NCE 中只计算一次。
NPU area savings from the measured floorplan regions. Child regions are included in the NCE subtotal. Source: SemiAnalysis
scratchpad 在 MAC 阵列附近存储权重、激活值和中间结果,使其可以反复使用而无需再次从 DRAM 读取。将其数量减半带来了最大的实测面积节省,但在 MAC 总数不变的情况下,本地存储空间也随之减少。无法在本地容纳的网络层需要更小的工作分块(tile),或者需要更多中间数据的搬运。这样做的收益取决于能否在管理更紧张存储预算的同时,让扩大的阵列保持忙碌。[36]
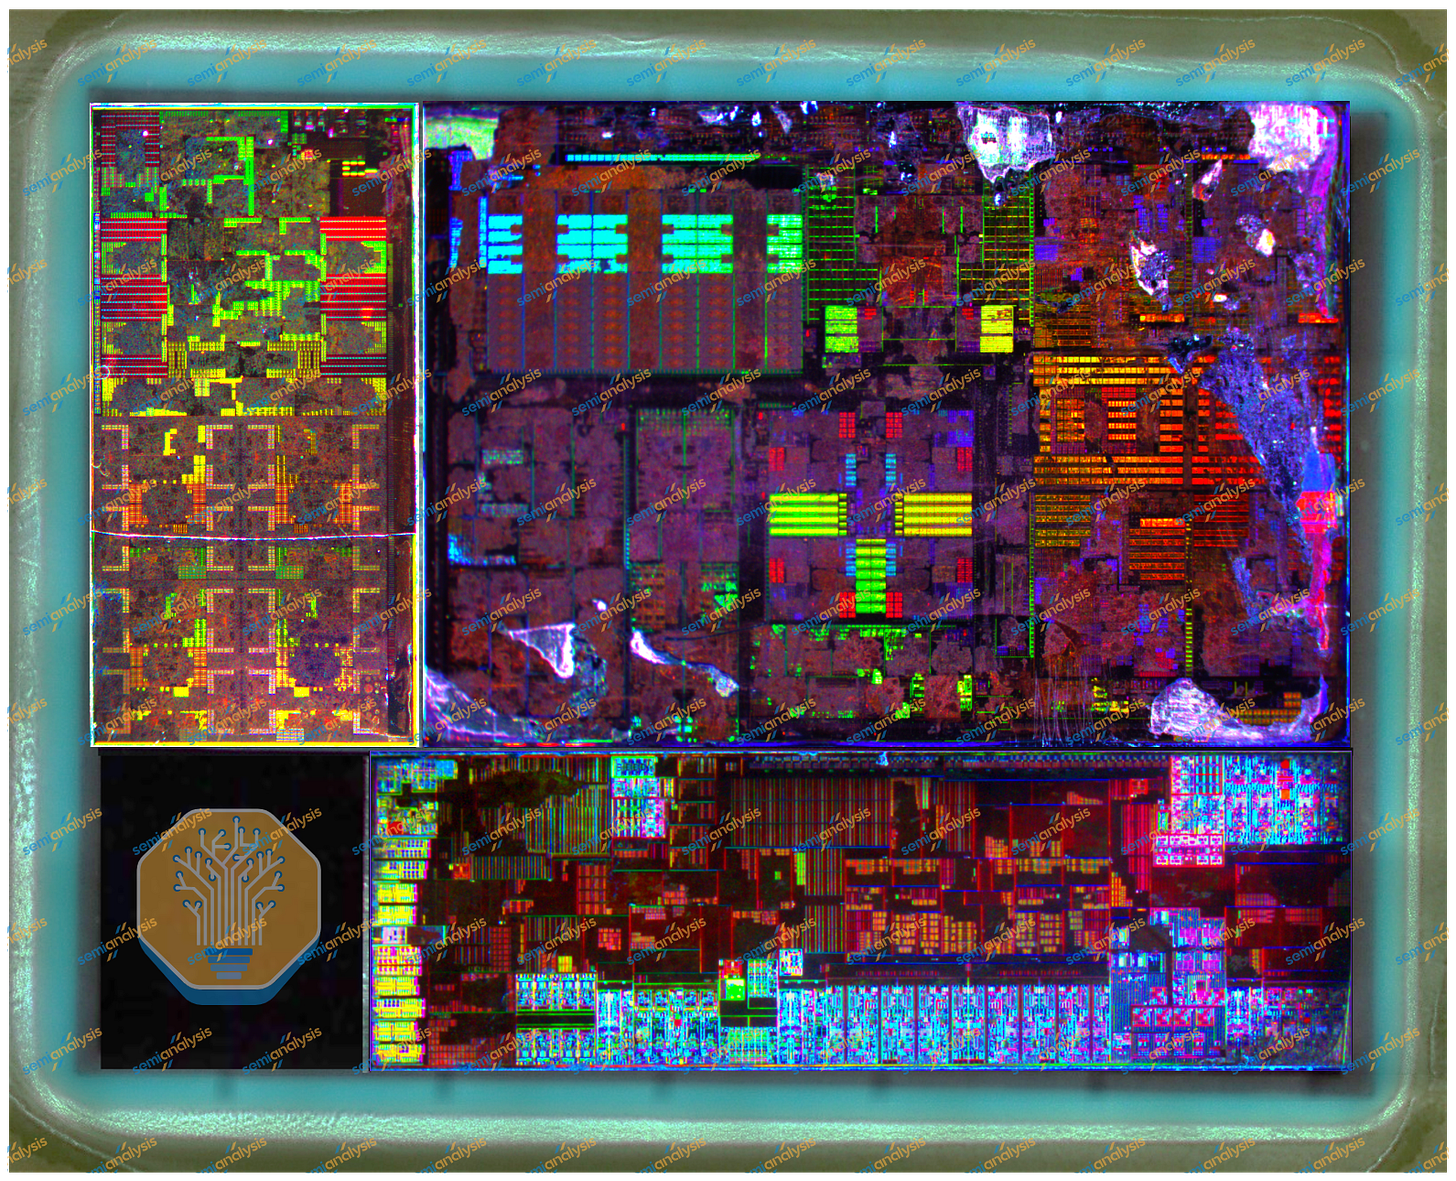
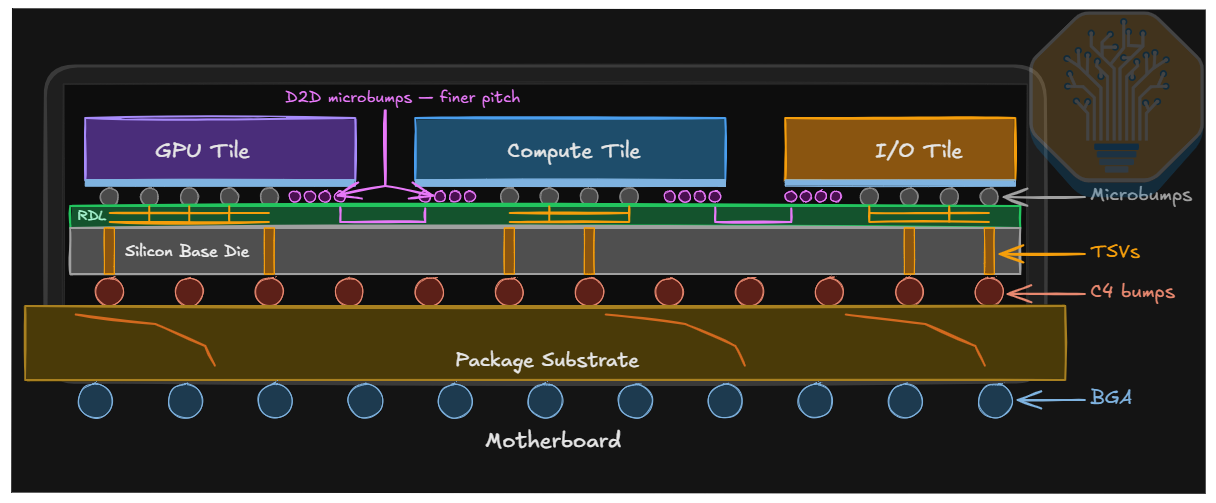
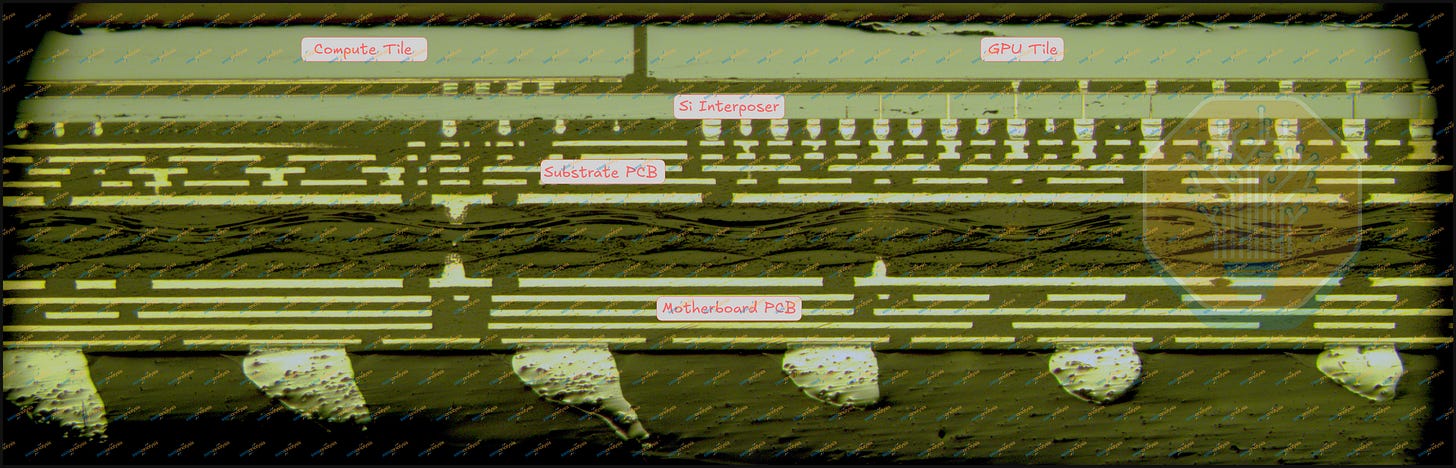
Panther Lake package cross section through the compute and graphics tiles. Source: SemiAnalysis
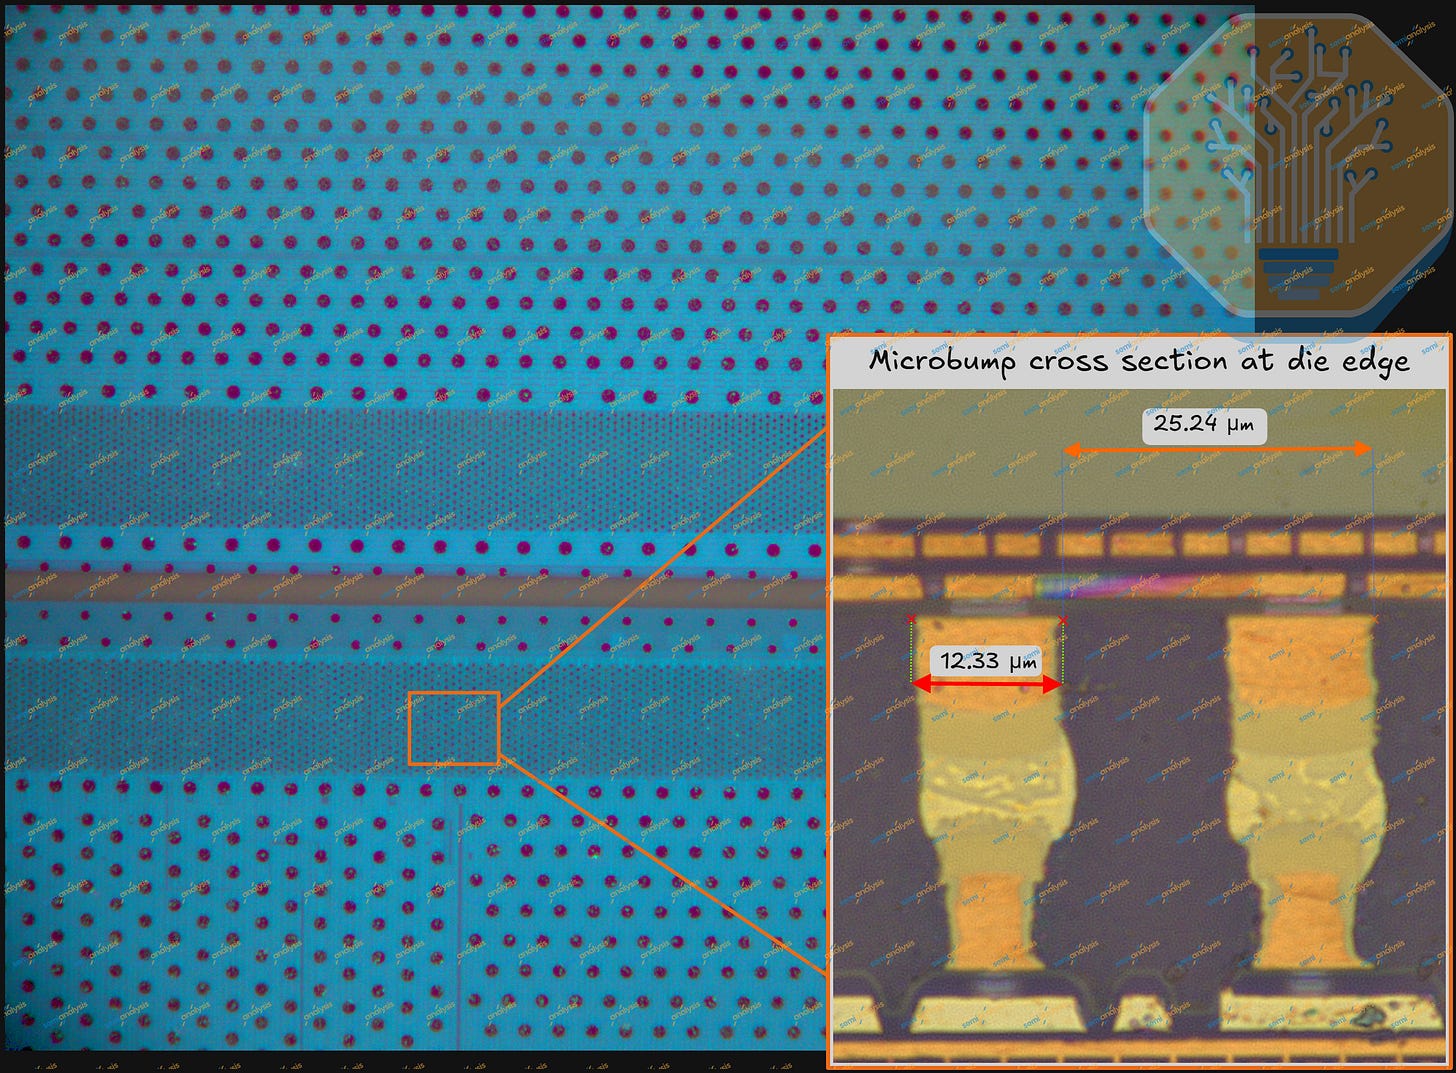
Panther Lake top-down image showing where the cross-section was taken. Source: SemiAnalysis
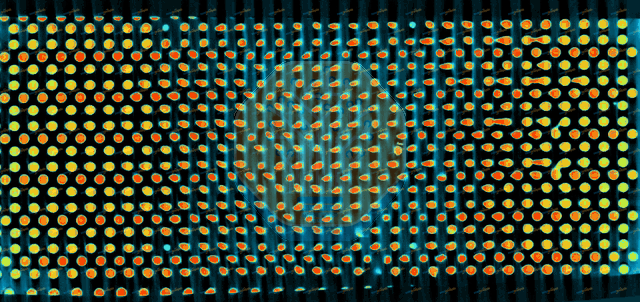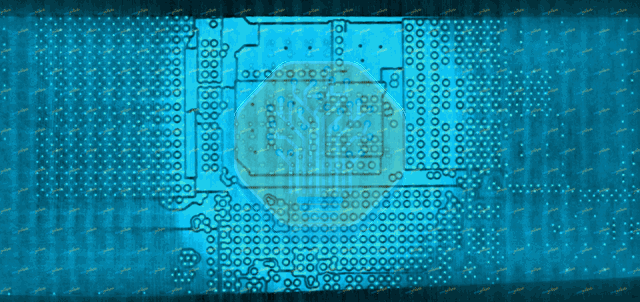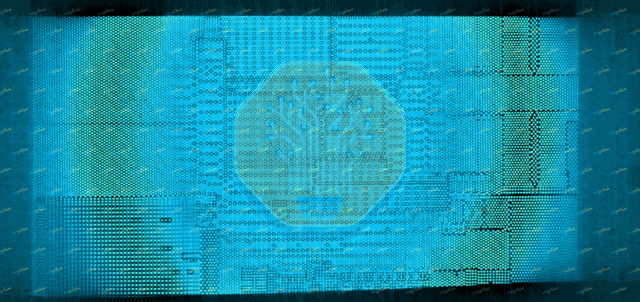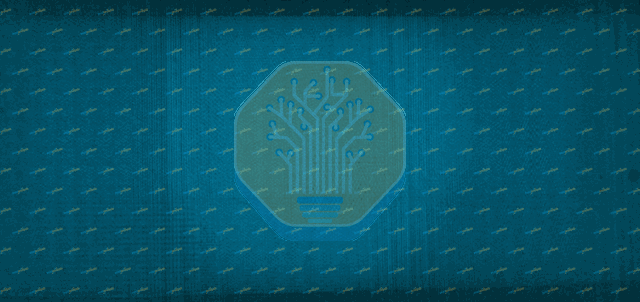
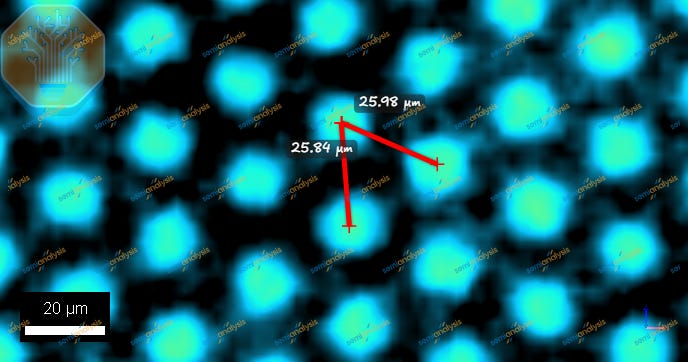
这些局部间距比 Intel 公布的 Foveros-S 标称值更精细。X 射线影像进一步证实相邻凸点间距更小,且每个 tile 上所有 die 间区域的情况都一致。付费墙后还有更多 X 射线分析内容。
GPU D2D region with annotated local neighbor separations. Source: SemiAnalysis
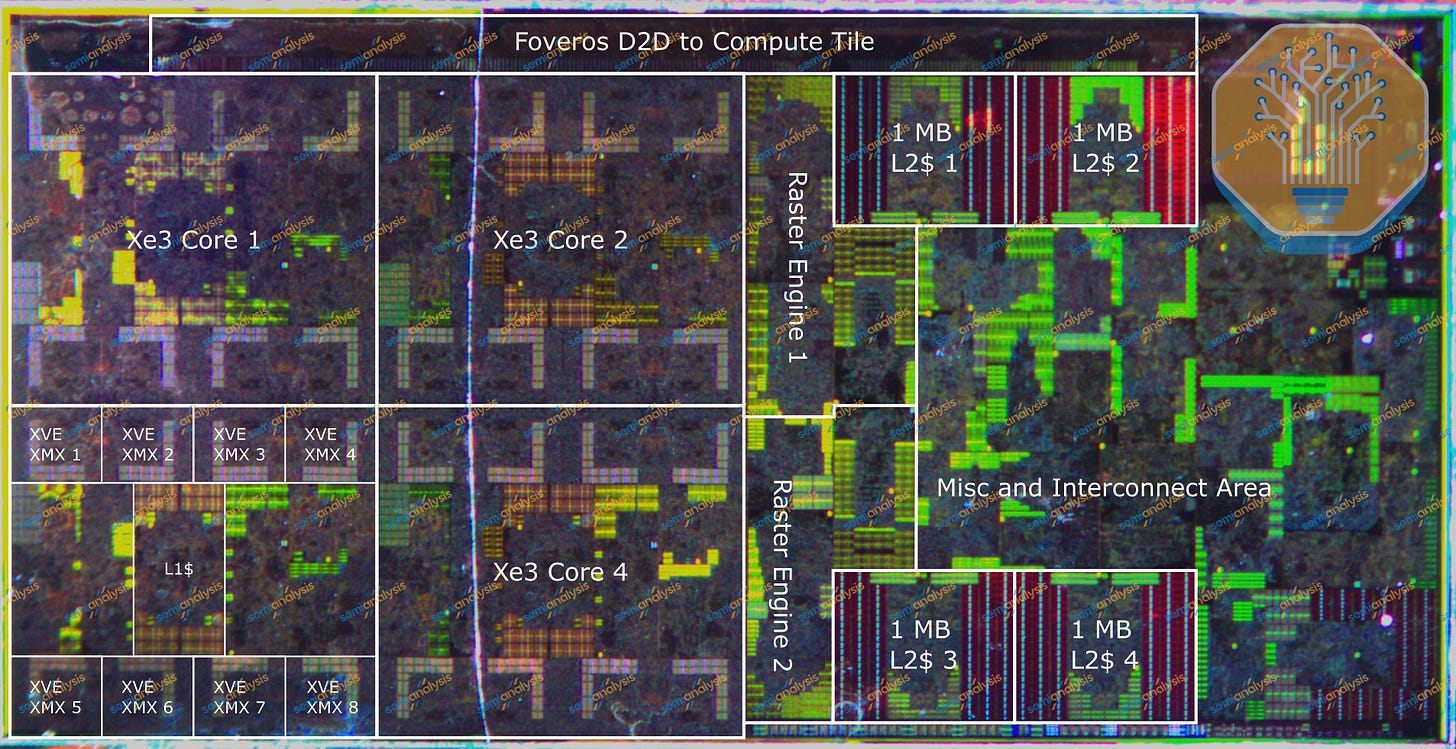
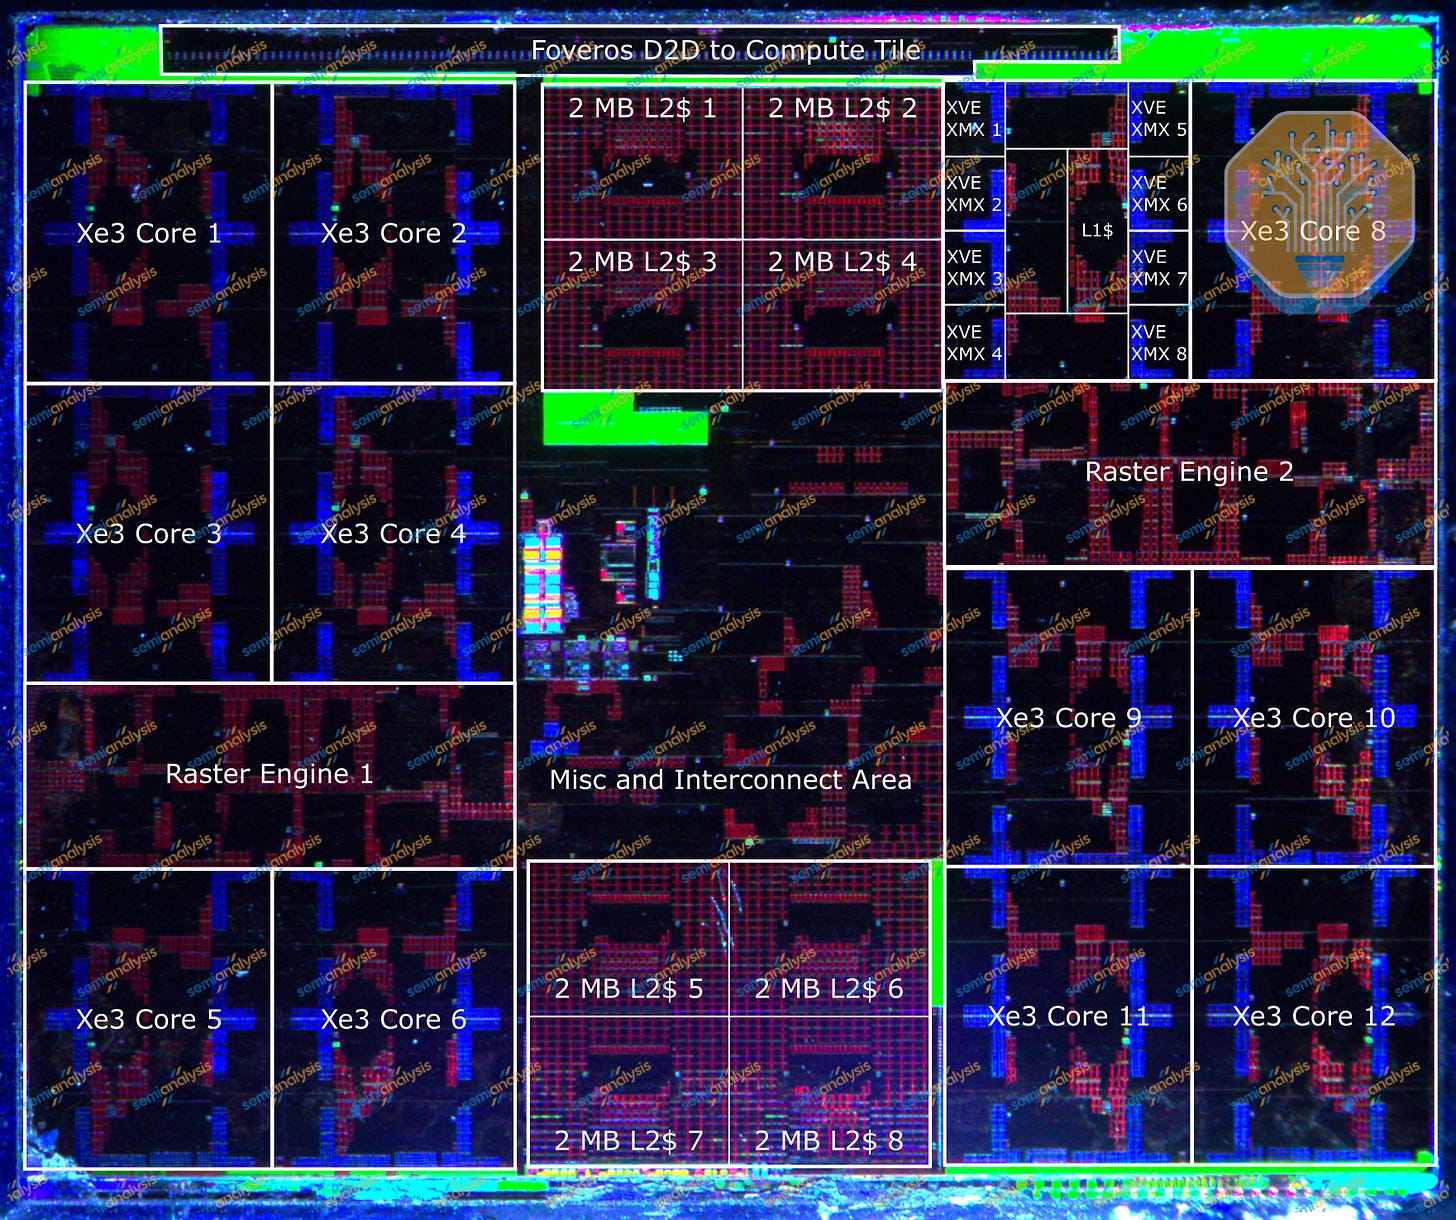
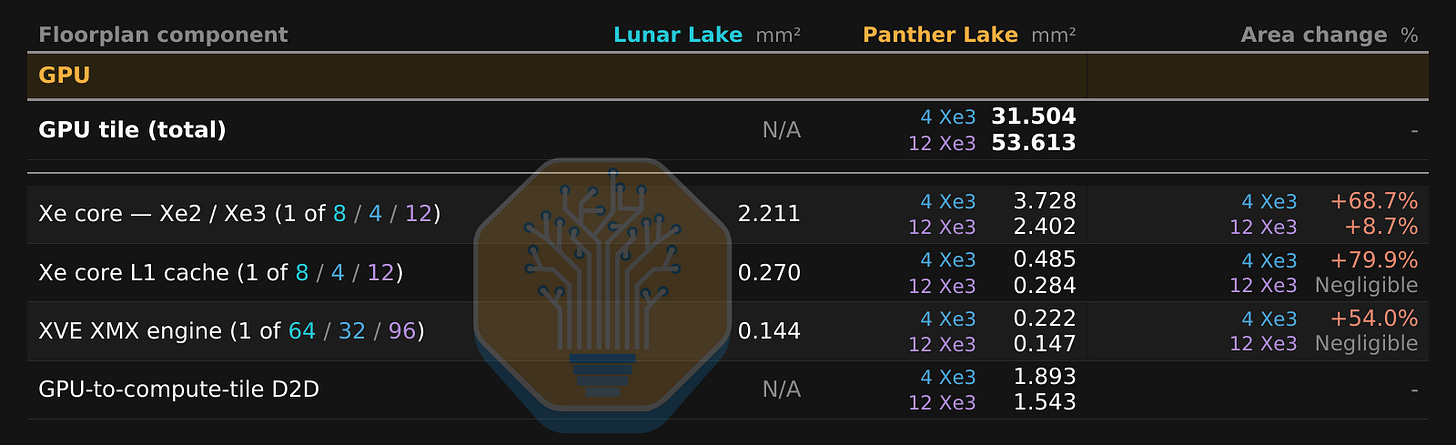
将内存控制器放在 CPU 旁边,消除了 Meteor Lake 和 Arrow Lake 中 CPU 内存请求所需的 D2D(die 间)传输。这避免了额外的发送器、接收器和链路传输环节,节省了接口能耗和延迟。Panther Lake 的独立 GPU 仍需跨越 D2D 链路才能访问 DRAM,因此其更大的本地缓存也有助于减少封装内流量。[1], [40]
[3] N. Horiguchi 和 E. Beyne, “Backside power delivery: How to power chips from the backside,” imec Reading Room, 2022年11月25日。访问日期:2026年9月14日。[在线]。 Available: https://www.imec-int.com/en/articles/how-power-chips-backside
[4] W. Hafez 等, “Intel PowerVia technology: Backside power delivery for high density and high-performance computing,” 载于 Proc. IEEE Symp. VLSI Technol. Circuits, 日本京都, 2023年6月, 第 1–2 页, doi: 10.23919/vlsitechnologyandcir57934.2023.10185208。
[5] K. Fischer 等,“Intel 18A platform technology featuring RibbonFET (GAA) and PowerVia for advanced high-performance computing”,发表于《Proc. Symp. VLSI Technol. Circuits》,日本京都,2025 年 6 月,第 1–3 页,DOI: 10.23919/vlsitechnologyandcir65189.2025.11075006。
[7] S. W. King,“Dielectric barrier, etch stop, and metal capping materials for state of the art and beyond metal interconnects”,《ECS J. Solid State Sci. Technol.》,第 4 卷,第 1 期,第 N3029–N3047 页,2015 年,DOI: 10.1149/2.0051501jss。
[8] A. V. Mule'、D. J. Towner、D. Seghete、C. R. Ryder 和 A. A. Gonzalez,“Multi-layer etch stop layers for advanced integrated circuit structure fabrication”,美国专利申请 20220102343 A1,2022 年 3 月 31 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/US20220102343A1/en
[9] C.-C. Wang 和 J. H. Wang,“Interconnect structure with dielectric cap layer and etch stop layer stack”,美国专利申请 20230253247 A1,2023 年 8 月 10 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/US20230253247A1/en
[10] Y. J. Wu、K.-F. Cheng、C.-C. Lee、H.-K. Chang 和 H.-Y. Huang,“Etch stop layer for interconnect structures”,美国专利申请 20240332070 A1,2024 年 10 月 3 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/US20240332070A1/en
[11] M. G. Rainville、N. Shankar、K. S. Reddy 和 D. M. Hausmann,“Deposition of aluminum oxide etch stop layers”,美国专利申请 20180197770 A1,2018 年 7 月 12 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.justia.com/patent/20180197770
[12] J. S. Leib 等,“Conductive lines having molybdenum liner and tungsten fill for advanced integrated circuit structure fabrication”,美国专利申请 20240429126 A1,2024 年 12 月 26 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.justia.com/patent/20240429126
[13] M. Naik,“Cobalt enables power and performance scaling at single-digit logic nodes”,Applied Materials,2018 年 12 月 17 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.appliedmaterials.com/us/en/blog/blog-posts/cobalt-enables-power-and-performance-scaling-at-single-digit-logic-nodes.html
[14] Lam Research,“Breaking through AI's invisible barrier with molybdenum”,Lam Research Newsroom,2025 年 5 月 6 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://newsroom.lamresearch.com/molybdenum-metallization-ai-revolution
[15] P. Yashar、G. Malyavanatham 和 H. Vijwani,“Integrated circuit interconnect structures with niobium barrier materials”,美国专利申请 20240112951 A1,2024 年 4 月 4 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/US20240112951A1/en
[18] C. W. Yeung 等,“堆叠纳米片的沟道几何影响与窄片效应”,载于 Proc. IEEE Int. Electron Devices Meeting (IEDM),2018 年 12 月,第 28.6.1–28.6.4 页,doi: 10.1109/iedm.2018.8614608。
[19] S. Mochizuki 等,“在环栅纳米片技术中评估 (110) 与 (001) 沟道取向,以改善 nFET/pFET 器件性能的折中”,载于 Proc. Int. Electron Devices Meeting (IEDM),2023 年 12 月,第 1–4 页,doi: 10.1109/iedm45741.2023.10413854。
[20] D. G. Ouellette 等,“具有氮化钼金属栅极及含偶极层栅介质层的环栅集成电路结构的制备方法”,美国专利 12 051 698 B2,2024 年 7 月 30 日。访问日期:2026 年 9 月 14 日。[在线]。可用:https://patents.google.com/patent/US12051698B2/en
[22] A. Reznicek、X. Miao、C. Lee 和 J. Zhang,“用于纳米片源漏外延的环包接触”,美国专利 11 302 813 B2,2022 年 4 月 12 日。访问日期:2026 年 9 月 14 日。[在线]。可用:https://patents.google.com/patent/US11302813B2/en
[23] J. A. Kittl、J. G. Hong、D. R. Palle 和 M. S. Rodder,“在纳米级场效应晶体管器件上实现可变应变的方法”,美国专利 9 978 833 B2,2018 年 5 月 22 日。访问日期:2026 年 9 月 14 日。[在线]。可用:https://patents.google.com/patent/US9978833B2/en
[24] S. Gandikota 等,“用于下一代 NMOS 器件应用的降低金属栅电阻的方法”,国际专利申请 WO 2024/137272 A1,2024 年 6 月 27 日。访问日期:2026 年 9 月 14 日。[在线]。可用:https://patents.google.com/patent/WO2024137272A1/en
[25] J. Zhang 等,“全底部介质隔离,助力面向低功耗与高性能应用的堆叠纳米片晶体管”,载于 Proc. IEEE Int. Electron Devices Meeting (IEDM),2019 年 12 月,第 11.6.1–11.6.4 页,doi: 10.1109/iedm19573.2019.8993490。
[26] C. Yoo、J. Chang、Y. Seon、H. Kim 和 J. Jeon,“考虑底部隔离与封装方案的多纳米片 FET 自热效应分析”,IEEE Trans. Electron Devices,第 69 卷,第 3 期,第 1524–1531 页,2022 年 3 月,doi: 10.1109/ted.2022.3141327。
[27] S. S. Pradhan、D. B. Bergstrom、J.-S. Chun 和 J. Chiu,“用于非平面晶体管的钨栅极”,欧洲专利申请 EP 3 506 367 A1,2019 年 7 月 3 日。访问日期:2026 年 9 月 14 日。[在线]。可访问:https://patents.google.com/patent/EP3506367A1/en
[28] L. Schloss 和 X. Ba,“低氟含量的钨薄膜”,美国专利 9 754 824 B2,2017 年 9 月 5 日。访问日期:2026 年 9 月 14 日。[在线]。可访问:https://patents.google.com/patent/US9754824B2/en
[32] D. Chandra、E. Potladhurthi、D. R. S. Reddy 和 K. S. Rengarajan,“可调负位线写辅助与增强衰减电路”,美国专利申请 20160203857 A1,2016 年 7 月 14 日。访问日期:2026 年 9 月 14 日。[在线]。可访问:https://patents.google.com/patent/US20160203857A1/en
[33] Synopsys,“基于固件训练在高速 DDR IP 中的优势”,Synopsys IP Technical Bulletin。访问日期:2026 年 9 月 14 日。[在线]。可访问:https://www.synopsys.com/articles/firmware-based-training-ddr-ip.html
[34] N. Muralimanohar、R. Balasubramonian 和 N. P. Jouppi,“CACTI 6.0:一款用于理解大型缓存的工具”,Hewlett-Packard Laboratories,2009 年。访问日期:2026 年 9 月 14 日。[在线]。可访问:https://users.cs.utah.edu/~rajeev/cacti6/cacti6-tr.pdf
[35] Intel,“Intel Tech Tour 2024 Lunar Lake AI 硬件加速器”,文档编号 824436,2024 年。访问日期:2026 年 9 月 14 日。[在线]。可访问:https://cdrdv2-public.intel.com/824436/2024_Intel_Tech%20Tour%20TW_Lunar%20Lake%20AI%20Hardware%20Accelerators.pdf