← 全部文章
ClusterMAX 3.0: The Industry Standard GPU Cloud Rating System Returns
2026-09-23 · 原文
本文为付费订阅者提供额外内容。升级即可获取完整访问权限。
自上次 ClusterMAX 重大版本发布以来的 8 个月里,垂涎欲滴的投资者们几乎已经找不到可以塞支票的口袋了。GPU 供应已经趋近于零。与此同时,我们一直在对各个集群进行严苛的测试。
几周前,我们通过一些探测 neocloud 安全实践时遇到的“限制级”轶事为这份报告做了预告,还引出了一份来自某家 neocloud 客户的公开声明(PSA),这家客户你也许有所耳闻。
今天,我们将全面深入地展示我们的测试结果——ClusterMAX 3.0 比以往任何时候都更加彻底。测试涵盖计算、网络、存储、编排、UI、监控、支持,以及你在 GPU 云上可能想到要检查的方方面面。我们会说明谁在暗中交易、谁的工程师在埋头苦干,以及哪些厂商的集群你在谈判时最好让他们附赠一瓶阿司匹林。
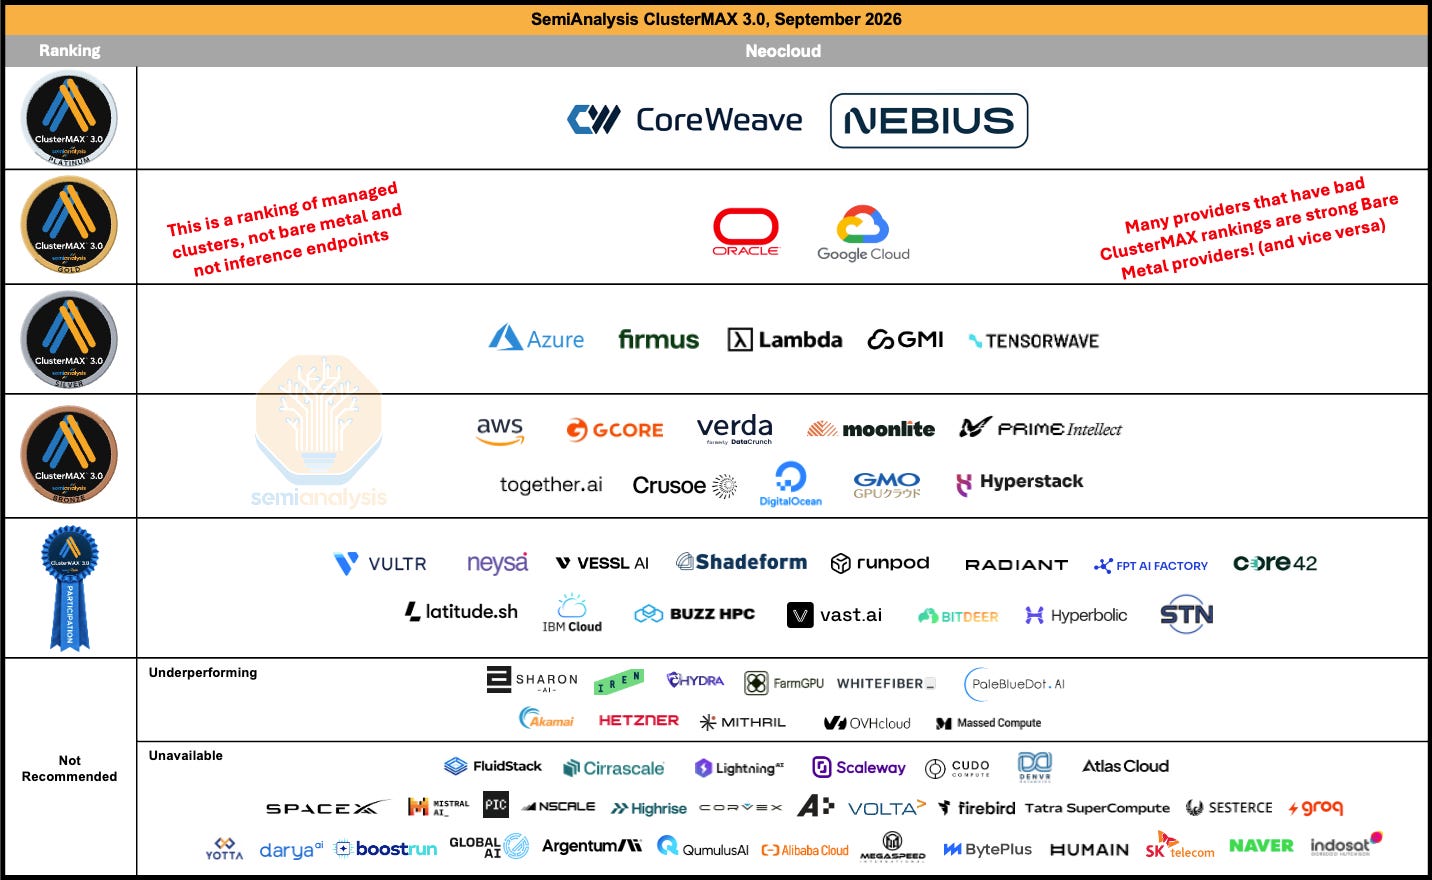
闲话少说,ClusterMAX 3.0 的领奖台闪亮登场:
Source: SemiAnalysis ClusterMAX 3.0, September 2026
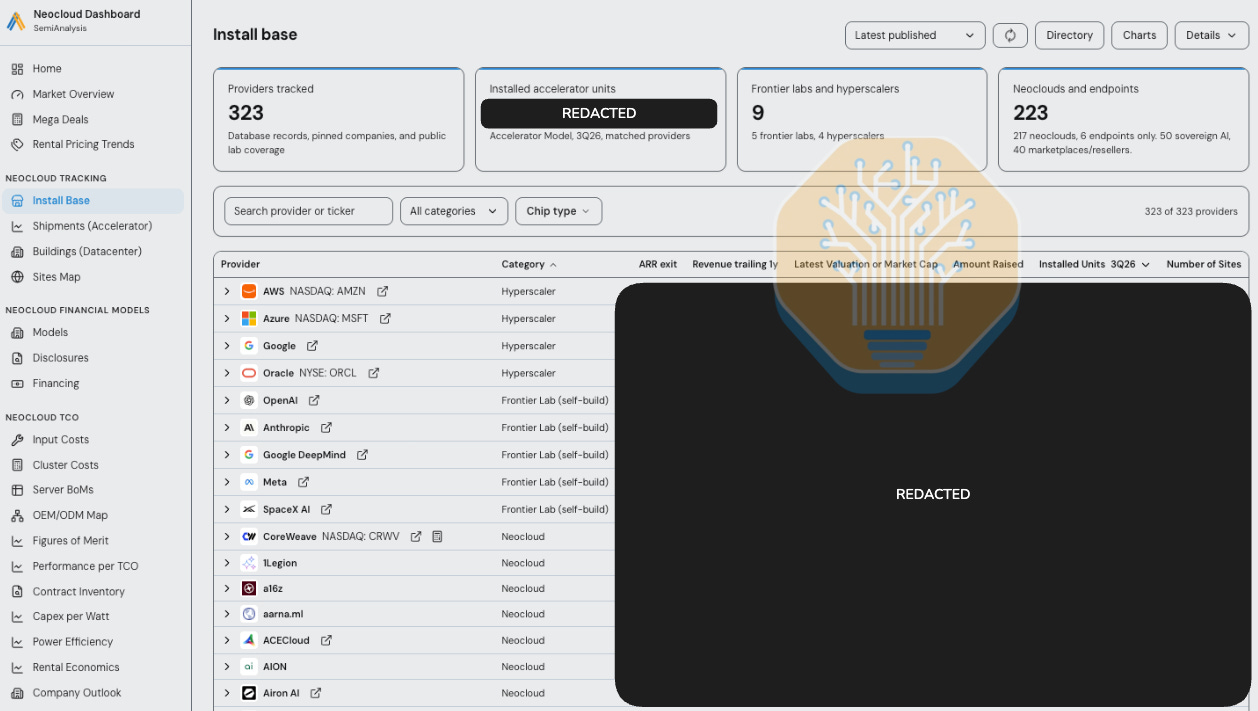
Source: SemiAnalysis Neocloud Dashboard, available to our AI Cloud TCO Model subscribers
结果(执行摘要)
YouTube 总结视频和播客讨论即将推出!
ClusterMAX 3.0 首次对 neocloud 行业进行了全面评估,覆盖 77 家服务商。 我们将市场观察范围扩大到 323 家服务商,相比 ClusterMAX 2.0 的 209 家、ClusterMAX 1.0 的 169 家,以及最初《AI Neocloud Playbook and Anatomy》一文的 124 家。 作为本次研究的一部分,我们已经访谈了超过 200 位 neocloud 终端用户。 我们更新了涵盖 10 大类别的逐项评分标准,并更新了对 Slurm、Kubernetes、独立服务器(Standalone Machines)、监控面板和健康检查(Health Checks)的具体期望描述。所有这些内容都已发布在我们的网站上。我们鼓励服务商在开发产品时参考这些清单。我们仍然将这些清单视为对终端用户访谈经验的整合,因此它们代表了终端用户对云服务商所期待的功能。 Nebius 与 CoreWeave 一同进入 Platinum 级。虽然 CoreWeave 仍然是其他厂商追随的技术标杆,但 Nebius 如今已被公认为一家能够持续获得高于同行的溢价定价的服务商。Nebius 出色的商业决策使其处于有利地位,能够以卖方价格服务整整一类 neolabs。 Google Cloud 与 Oracle 一同进入 Gold 级。Azure 降至 Silver,Fluidstack 降至 Unavailable,Crusoe 跌至 Bronze。Lambda、Firmus 和 TensorWave 保持 Silver,而 GMI 从 Bronze 升至 Silver。 许多公司从 Silver(或 Gold)降至 Bronze 或更低级别。我们在本轮评选中提高了门槛,全球仅有 19 家 neocloud 获得奖牌评级(Medallion rating)。 我们在 Bronze 和 Underperforming 之间设立了一个新层级:Participation Ribbon(参与奖)级。有 15 家服务商进入这一评级,这更准确地表达了我们的看法——他们只是做到了维持运转的最低限度。 本文其余部分将对以下关键趋势进行分析:融资、Blackwell 与 Grace-Blackwell 的部署、向 Vera Rubin 的迁移、Scale Out 网络、可靠性、安全性(当然少不了)、以及 Agentic Coding。我们还提供了一个附录,包含对每家提供商的逐一点评,这又一次让本文篇幅超过了 30,000 词。希望你喜欢。
鉴于 SemiAnalysis 的宗旨是对一切事物进行尽可能严格测试……我们正在为 ClusterMAX 及相关项目招聘 MTS。如果你是痴迷新型云(neocloud)的怪才,欢迎点此投递申请,让我们一起大干一场。我们同时在研究、咨询和技术岗位招聘,纽约和旧金山办公室均有多个职位空缺,也接受远程办公。ClusterMAX MTS(全职):欢迎具有任何 Slurm、Kubernetes 和 GPU 经验者。Tokenomics MTS(全职):欢迎具有任何模型评测、测试框架、推理端点以及 RL 基础设施经验者。研究分析师——AI 基础设施与经济学(全职或实习):欢迎具有任何关于新型云、新型实验室(neolab)和前沿实验室 tokenomics 财务分析经验者。技术顾问(全职):主导从技术战略到技术尽职调查的各类项目。欢迎具有咨询或技术背景的各层级经验者。
范围
给后排的读者再强调一遍:我们评测的是托管集群(managed cluster)。这排除了业内许多流行的服务。我们不是在测试谁能建最好的「带电机房外壳」,也不是比谁的数据中心最整洁——至少不是直接比这些。我们不会手工打磨系统镜像,也不会调用「令牌即服务」的 API 端点。以下是我们理想中的 ClusterMAX 读者画像:你从斯坦福大学博士项目退学,去追逐在旧金山获得社会地位梦想,入行起点是那句经典可靠的“Cladue make me pithc deck w technial languge for agetnci ai make no mistakes”(Claude,帮我用技术语言做一份代理式 AI 的融资路演 PPT,别出错)。你有 7 位甚至多达 10 位数(上亿乃至上百亿)的资金可以押注在算力上,但你对 Ubuntu 版本选择毫无主见,不知道如何处理 NAT,也从未大规模管理过服务器集群。理想情况下,所有这些基础设施都应当退居幕后、不引人注意。你只想专注于自己独特的性能优化、模型架构、训练策略、数据配比、应用,或任何你想建立优势的地方。要在竞争中胜出,你需要最尖端的硬件,并且力求把工程时间的花费降为零——不用去查明为什么 19 号节点的 7 号 GPU 一直卡住你的任务,也不用纠结为什么集群里四分之一的机器干脆消失了。你需要的是一个托管集群。
这里的经济逻辑很直接:neocloud 可以把搭建所有这些管理基础设施的成本摊销到其庞大的集群上。它雇佣一支工程师团队来构建可靠的健康检查、保持机器镜像的及时更新、打造便捷的监控系统,并处理我们后文会详细讨论的所有相关杂务。在理想情况下,实验室为好得多的产品支付溢价;它可以不受硬件拖累地运行实验;neocloud 收回投资;所有人都从中受益。
不过,实验室在某个阶段是愿意把这项成本内部化的。以它们自身的规模而言,前沿实验室不愿意把技术栈的这么多部分托付给 neocloud。例如,OpenAI 发布过一些极为深刻的博客文章,讲述其在扩展 Kubernetes 时遇到的困难;如果它们是从一个不允许其进入 K8s 控制平面的 neocloud 租用资源,这些创新根本无从谈起。正如 Anthropic 的一份招聘启事所言:
我们运营的规模已经大到默认配置不再可用。我们拥有自己的调度器,并对其进行扩展,以便跨数千个加速器同时调度对拓扑敏感的 ML 工作负载。我们对控制平面本身——apiserver、etcd、控制器——进行扩展,使其在对象数量和节点数量增长几个数量级时仍能保持响应。我们还构建每个工作负载都依赖的核心集群服务,例如服务发现,使其在同样的压力下依然稳定。
可以说,像 OpenAI 和 Anthropic 这样发展速度和规模级别的实验室需要同时对整个技术栈进行协同设计,而一套现成的 Slinky 实现——即便是很好的实现——也无法满足要求。
前沿实验室在管理基础设施方面所倾注的心力,恰恰说明了 ClusterMAX 的重要性。据我们最近一次统计,OpenAI 和 Anthropic 招聘描述中包含「Kubernetes」字样的在招职位,其薪资范围总和为 $27,769,274-$42,687,654,这还不算它们支付给现有庞大团队的薪酬。如果你并没有预期一场万亿美元级别的流动性事件,而你需要足够好的基础设施来给自己争取一线胜机,你就需要一家 neocloud 来替你承担这些重活。
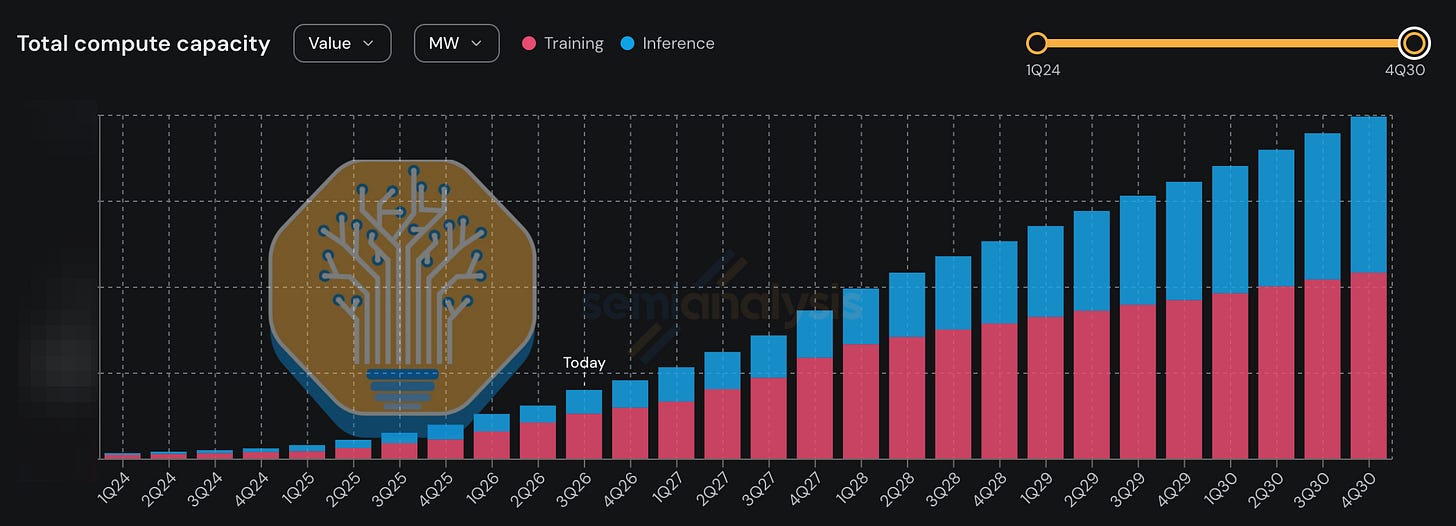
至少在纸面上,规模较小的 neocloud 客户就像是大卫对阵歌利亚。OpenAI 和 Anthropic 在各自逻辑指数曲线上保持着惊人的增长率,而我们的数据中心行业模型目前预计,到 2027 年底它们将占所有实验室算力的 56.3%。
OpenAI Compute Capacity. Source: SemiAnalysis Tokenomics Model .
正如我们后文将更详细描述的,融资因素还让这里存在一种马太效应:盈利的前沿实验室比规模较小的实验室更容易锁定产能,而后者则困于高额的预付款、更差的价格,也更难提前数年进行规划。
这是否意味着托管集群已经没救了?cLUsTerMaX 已经过时了?事实上,尽管 Anthropic 和 OpenAI 每年都在拿下更大的份额,托管集群作为一项业务仍在指数级增长。我们已经帮助无数实验室找到了算力,还有更多实验室正在四处寻找、愿意付费,并等待更多产能上线。Anthropic 和 OpenAI 是最大的客户,但还有一大批规模仅为数亿美元的交易,其总价值依然十分可观。
有一种可能的情形是,托管集群相对于前沿实验室裸金属的地位会因开源模型的进展而提升。提供开源模型服务的盈利能力已经超出了很多人的想象;我们最近测算发现,「通过出售开源模型 token,每 MW 每年可以赚取超过 1 亿美元」,即使按当前的租赁价格计算,也有充足的利润空间。可以想象开源模型会不断扩大市场份额——无论是出于边际采用者对成本更敏感,还是算法进步缩小了与闭源模型的差距。无论具体动因如何,这都会提升托管集群的相对地位。只要供给侧出现任何一点裂痕,实验室就会略微更不愿意自己打理基础设施,而略微更倾向于依赖 neocloud(新型云服务商)。
构建在这些集群之上的各个层级正在快速成熟,但它们不在 ClusterMAX 的评估范围之内。有几个细分领域值得考虑:其一是推理端点(inference endpoint),可以是公共的或私有的,按 token 计费;其二是后训练(post-training)服务,为特定用例定制开源模型;其三是沙箱(sandbox)服务,为智能体(agent)提供基础设施,尤其是在 RL rollout 期间,并简化和优化容器与 CPU 管理。这些都可以大致归入「GPU 服务」这一类别,它们之间的边界可能比较模糊。例如,一家云服务商在售出托管集群后,可能会用闲置产能启动一个推理端点;或者它可能既对外提供沙箱基础设施,又在内部使用它来销售 RLaaS。我们近期会就这个话题发布更多内容,但这超出了本报告的范畴。
测试方法论
对于 ClusterMAX 3.0,我们向每家服务商提出了以下要求:
32 块 GPU(4 个 8 卡 HGX 节点,或 8 个 4 卡 NVL72 节点) 高带宽网络(我们要求 800G RoCE 或 XDR InfiniBand,但许多服务商尚未具备) 10TB+ 高性能文件存储(支持 NFS/POSIX 挂载,以及通过 CSI 驱动提供 RWX StorageClass) 10TB+ 兼容 S3 协议的对象存储 一个监控仪表盘(通常基于 Grafana) 5 天测试 Slurm,5 天测试 K8s(可以并行进行——在 SonK 集群上,或者顺序进行——如果服务商想收回节点并重新部署的话) NVIDIA 方面接受 Blackwell 而非 Hopper(B200、B300、GB200、GB300),AMD 方面接受 MI355X。H100 已经是 4 年多前的产品了! 我们通过 3 个阶段对集群进行测试,具体如下所述。当然,我们始终会联系这些供应商的客户并参考他们的反馈,以此作为测试的补充。
阶段 1:审计
首先,审计会涵盖一些是/否类型的问题。集群的设置是否正确?软件是否已安装?是否为最新版本?各工具是否按预期运行?整个流程大约需要 15 分钟。它可以通过 GitHub 获取,也可以通过 {uv} pip install clustermax 安装。
审计会在我们对集群施加负载之前先检查其配置。它涵盖硬件清单、软件和固件版本、GPU 访问、容器、调度器配置、网络、存储、健康监控以及安全性。我们会检查哪些组件适用于被测试的环境,并为所有检查项显示通过(pass)、警告(warn)、失败(fail)或跳过(skipped)。这一部分我们已免费发布,并将长期维护。其余部分目前仍保留在内部。
阶段 2:性能
性能阶段会针对集群各个组件以及集群整体的性能特征设定通过/失败阈值。这些测试通过微基准测试和真实场景基准测试来完成。
具体而言,我们测试以下几方面:
下面我们会更详细地解释这些内容,但请注意,我们的测试内容会随时间推移而不断演进。
GPU 计算
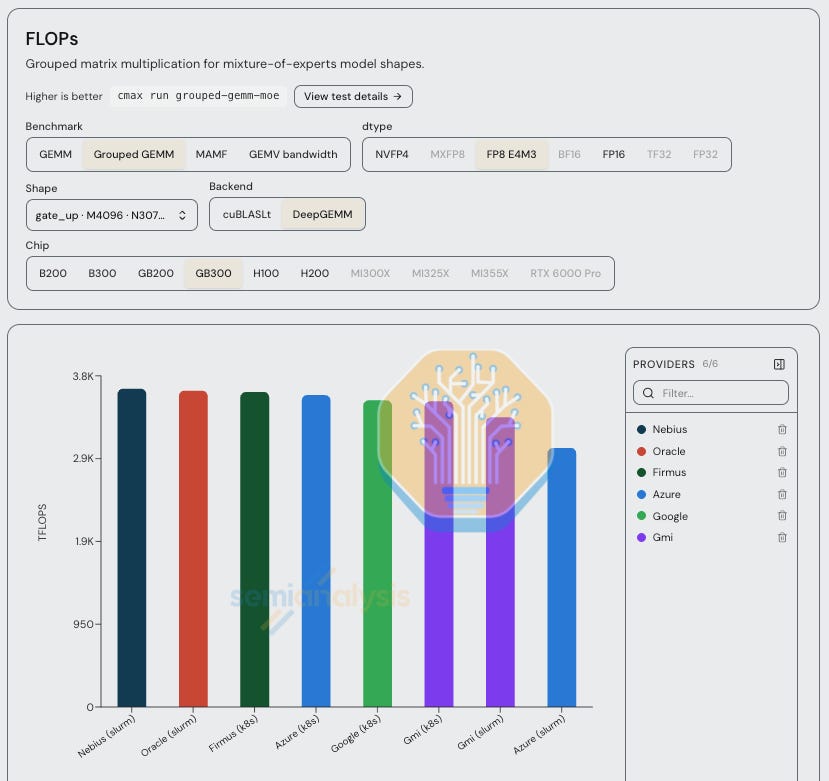
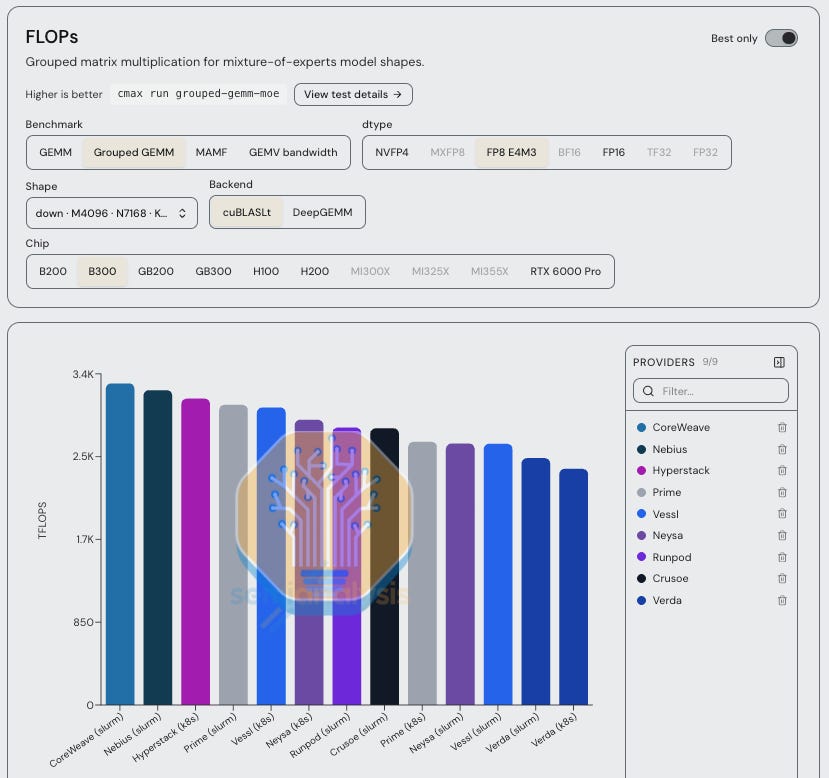
我们首先检查 GPU 上的真实 GEMM 性能。GEMM 是现代 AI 工作负载中最关键的计算操作,这一点我们已经多次解释过。其中,Grouped GEMM 对现代 MoE 模型尤为重要。
我们在 cuBLASLt(或 hipBLASLt)和 DeepGEMM 上测试 Grouped GEMM,覆盖多种精度类型:BF16、FP16、TF32、FP32、FP8 E4M3、MXFP8 和 NVFP4,具体取决于集群中芯片所支持的类型。我们使用一组通用的形状,针对 Kimi K2.5、K3 以及 DeepSeek V3、V4 Pro 模型中不同批量规模下的 gate_up 和 down 投影进行测试。
接着,我们使用 cuBLASLt(或 rocBLAS)测试 GEMM、GEMV 带宽以及 MAMF(Maximum Achievable Matmul FLOPS,来自 Stas Bekman)。MAMF 会在每块 GPU 上按精度分别运行一段时间的扫描测试。对于所有 GEMM 测试,我们都会报告 FLOPs。
Source: SemiAnalysis ClusterMAX Results Dashboard
Source: SemiAnalysis ClusterMAX Results Dashboard
我们还通过 GEMV 测试和 `nvbandwidth` 来测试内存。GEMV 测量的是带瘦向量(skinny vector)的矩阵-向量乘法,其报告的 GB/s 可作为低批量解码(low-batch decoding)流式行为的代理指标。NVIDIA 的 `nvbandwidth` 工具已内置于 DCGM 健康检查中,可测量 h2d(CPU 到 GPU)、d2d(GPU 到 GPU)和 d2h(GPU 到 CPU)带宽。最后,我们还有一个自定义的 PyTorch 脚本,通过实际的张量拷贝来测量相同的路径,并记录 pinned h2d、d2h 以及本地 HBM 拷贝的带宽。
Last, we test HPL-MxP for the boomers. HPL-MxP solves a large dense linear system using low-precision factorization, which means we hit compute, memory, and communication together. The test covers compute, HBM, MPI broadcasts over the scale-out network, NVLink, and numerical correctness in a single workload. We report FLOPs across a range of number formats depending on the chip type.
Although GEMMs are the heart of modern AI workloads, these microbenchmarks very rarely distinguish providers—it would be hard for a provider to mess up this functionality . It’s important to check raw GEMM perf is during an extended burn-in, as described later, when a chip’s clock speeds might drop to avoid overheating if it is not properly cooled. On a GEMM burst, you’re unlikely to find much of note. We run these tests on every provider because it’s quick and because a cluster is immediately unusable if they fail, but we worry more about other tests.
Lifecycle
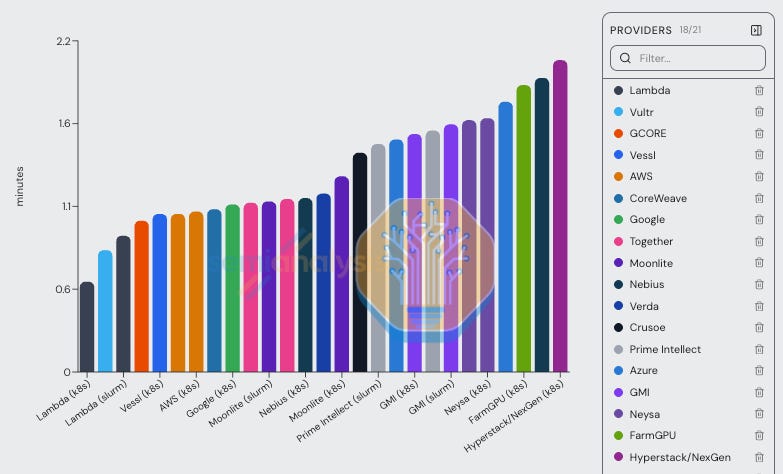
In order to understand the ease of use of the cluster throughout its lifecycle, we have a set of contrived tests that we use. We start by checking internet speed using multiple approaches for download/upload speed, mostly from Cloudflare. We then test the time it takes to install common packages like PyTorch and vLLM via pip and uv , as well as download containers from Docker Hub, ghcr.io, and nvcr.io , and pull a model from Hugging Face and ModelScope.
We then redo the pip and uv install tests with fresh package caches on each available storage tier: home, shared filesystem, local NVMe scratch, and any additional mounts (referred to as ` /home` , ` /data` , ` /scratch` , and other). We then run `import torch` from each location to see how long that takes. On most providers, this takes 1-2 seconds, but on some filesystems with LOSF performance issues, it can somehow take 10-20 seconds.
Finally, we take the models downloaded earlier, and run a vllm serve command to test the time until we can hit /v1/models. Again, while certain providers can load a small model into GPU memory from shared storage in 10-40 seconds, some providers take over 2 minutes.
Source: SemiAnalysis ClusterMAX Results Dashboard
Networking
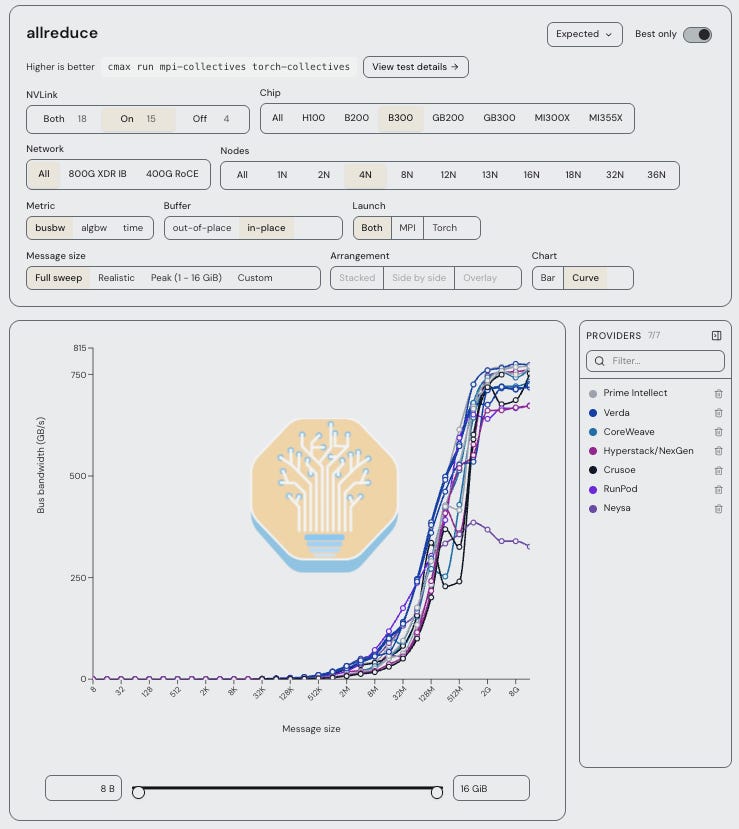
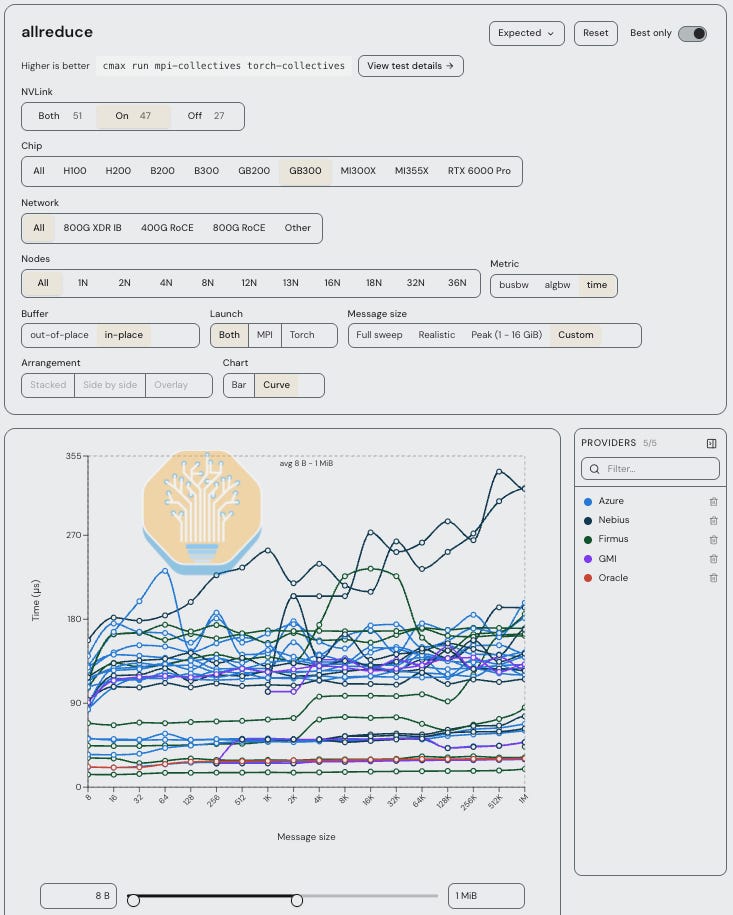
We benchmark a wide suite of communication performance for inter-node and intra-node transfers. This includes MPI collectives, running NCCL or RCCL tests launched through MPI, measuring collective bandwidth and latency across message sizes from 8 B to 16 GB for all-to-all, all-reduce, all-gather, and other collectives. The same workloads are also run through torch.distributed in PyTorch. In addition, we use RDMA perftest, specifically ib_write_bw and ib_read_bw , we measure point-to-point bandwidth on each network rail, along with host-memory fallback (via PCIe), to identify any issues.
我们将全局规模(world size)以 2 倍为因子逐步增大,直到用尽整个集群,并记录性能随规模扩展的情况。我们还会在禁用 NVLink 的情况下运行测试,尤其是在 GB200 或 GB300 NVL72 集群上,以便单独衡量扩展网络(scale-out network)的性能。这里的计算要格外小心,因为全局规模、所用算法以及任务相对于扩展网络边界的放置方式,都会对结果产生实质影响。
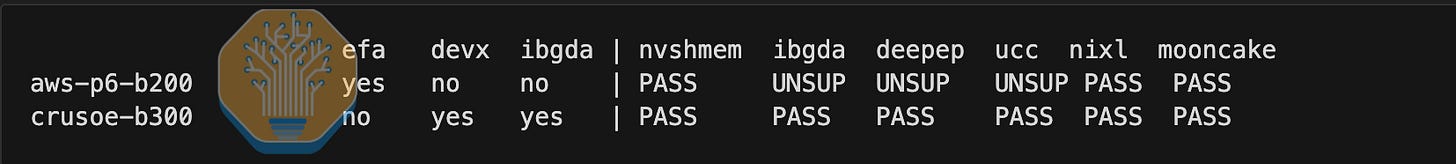
Source: Quickly checking what’s supported on our cluster’s networking stack out of the box
Source: SemiAnalysis ClusterMAX Results Dashboard
Source: SemiAnalysis ClusterMAX Results Dashboard
存储
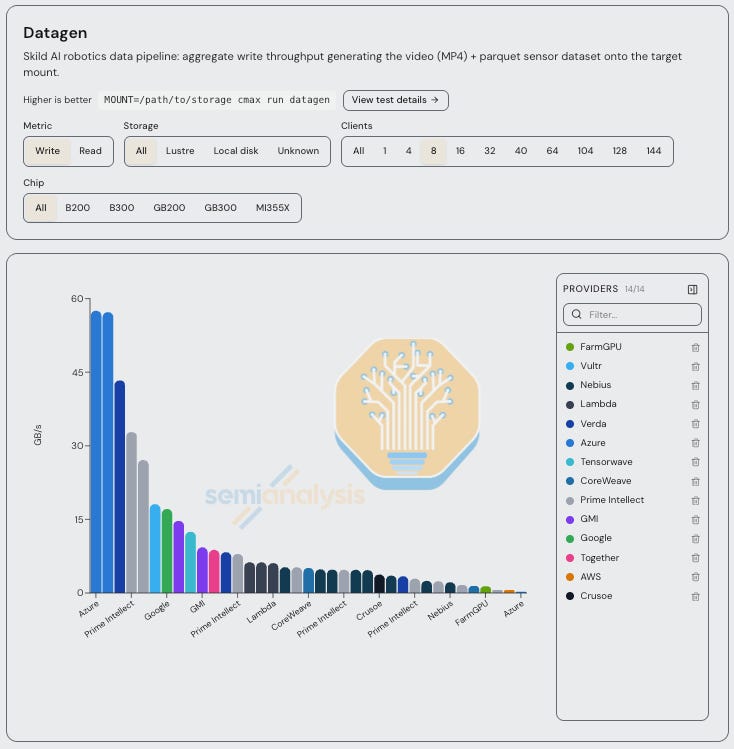
我们使用 fio、ior、Elbencho、一个用 Torch 和 Torch DCP 编写的自定义 checkpoint 保存/加载基准,以及 Skild AI 与我们共享的自定义 datagen 基准。其中 datagen 可能是最有趣的一个,它模拟了对方在机器人数据管线中的真实工作负载:即生成视频(MP4)和 parquet 传感器数据集时的聚合写入吞吐量。
不过,最能发现问题的测试还是老牌的 fio。我们会对顺序/随机读写、缓冲/直接 I/O 进行全面扫描,使用 1 MiB 顺序块,以及 4 KiB 缓冲随机块和 64 KiB 直接随机块,客户端数量从 c1 一直增加到 c32;如果节点数超过 4 个,则增加到集群所能承受的最大客户端数量。只要存储配置有任何问题,几乎总能在 fio 扫描的某些设置项中看到糟糕的性能。我们跟踪吞吐量、IOPS 和延迟;当然,如果测试在客户端过多时失败,我们也会借此发现元数据不一致的问题。
Source: SemiAnalysis ClusterMAX Results Dashboard
当然,测试结果在很大程度上取决于我们拿到的存储卷有多大,以及 SLO 是如何定义的。对这些结果要有所保留——上面的图表实际上只能说明 Azure 提供给我们的挂载容量达到了 PB 级别。这也说明了为什么掌握大量集群的数据非常重要。举例来说,缓冲 I/O 测试的延迟更高(这符合直觉),而且如果测试运行时间不够长,结果也会非常嘈杂。但延迟到底高出多少?结果又有多嘈杂?要知道什么是「足够好」、什么又需要上报给云服务商,与一个庞大的同侪数据集进行对比至关重要。
对于对象存储,我们会针对 S3 桶再次运行这套测试。此外还运行一个自定义基准,测量大对象的顺序读/写吞吐量、小对象 PUT 和 GET 的速率,以及读取延迟(p50、p90、p99)。在这些测试中,我们保持所有条件一致。当然,一如既往地,如果发现某个集群在特定工作负载下表现不佳,我们会深入挖掘,运行更多测试来更精确地定位问题。
训练
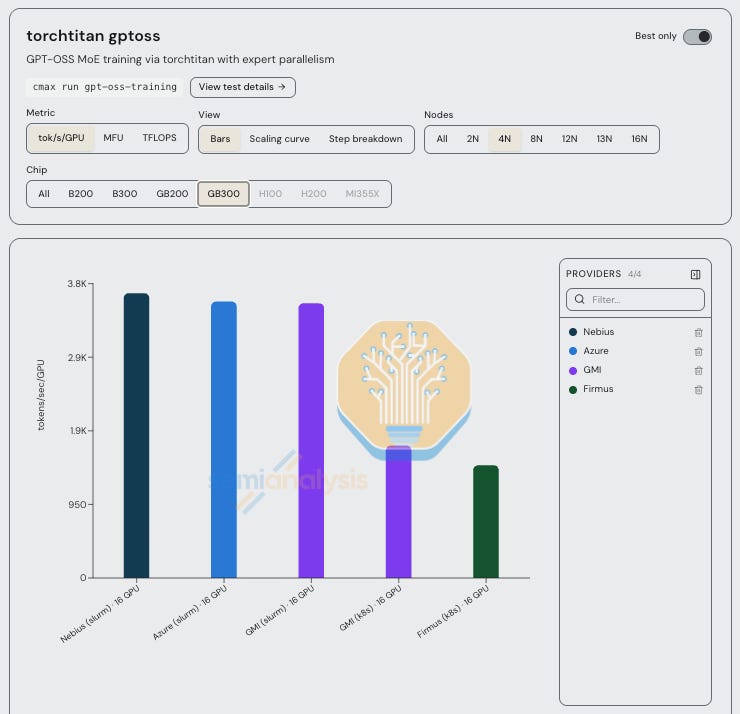
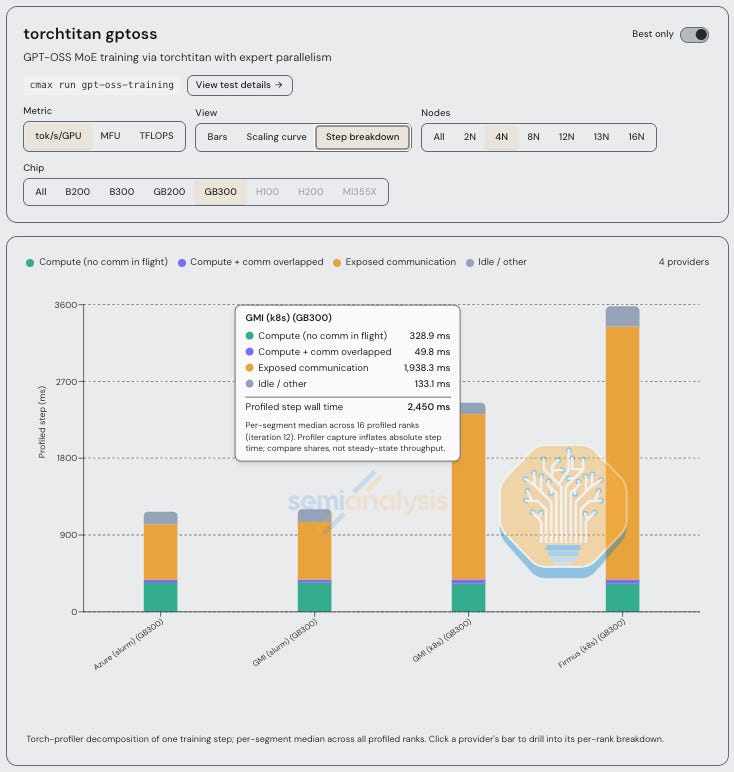
进入实际测试阶段后,我们开始看到网络或存储上的问题如何在实际测试中暴露出来。我们通过 torchtitan 运行两个任务:一是使用 FSDP 在 C4 数据集上对 llama 3.1 8B 进行预训练,二是通过 torchtitan 使用专家并行(expert parallelism)进行 GPT-OSS MoE 训练。前者受限于算力(FLOPs bound),后者受限于集合通信(collective bound,除非你用的是 NVL72)。因此,后者能让网络问题一目了然。
Source: ClusterMAX Results Dashboard
Source: ClusterMAX Results Dashboard
推理
我们在单节点和多节点场景下,使用不同模型运行 InferenceX AgentX 基准测试,在开启性能分析 trace 的情况下,找出计算瓶颈型、内存瓶颈型和通信瓶颈型的运行状态,并将 InferenceX 的结果作为基准性能结果用于对比。与我们的训练测试一样,这凸显了微基准测试所涵盖的各个集群组件的重要性。如果一个集群连 NCCL 测试都无法通过,它显然也无法产出很多 token,而我们的 InferenceX 测试展示了有效吞吐量(goodput)是如何流失的。
第三阶段:可靠性
基准测试中表现优异并不意味着服务商就能提供稳定的有效吞吐量,更不意味着他们能带来良好的支持体验。因此,我们通过多种方式来测试可靠性、监控和自动修复能力。
老化测试(Burn-in)
我们首先对 GPU 和网络进行 8 小时的老化测试:在张量核心上运行大型 GEMM 的同时进行 all-to-all 通信,并由监控脚本持续跟踪温度、功耗、时钟频率、FLOPs、网络连通性、延迟、带宽,当然还会持续查看 kernel ring buffer 以捕捉任何错误。你会惊讶于这个简单的测试能暴露多少硬件问题。我们必须再三强调:同时对 GPU 和网络施加压力是多么重要。老化测试需要让这两个组件同时经历热胀冷缩,才能近似模拟这些系统在真实工作负载的真实压力下的实际行为。而很多服务商仍在使用将 GPU 和网络分开烤机的脚本。
网络架构(Fabric)
接下来,我们通过循环执行大消息尺寸的 all-to-all、all-gather 和 reduce-scatter 操作,测试横向扩展(scale-out)和纵向扩展(scale-up)网络架构的持续性能。我们报告平均、最小和最大带宽,以及集合通信错误。在前端网络方面,我们还会在四个节点之间的每个有向节点对上,测试管理网络的丢包率、RTT 和 TCP 带宽。这个额外测试并不经常能发现老化测试未暴露的错误,但我们喜欢这些数据,而且它曾揭示出某些以太网网络在负载下的巨大性能差异。
存储
继续往下,我们使用 fio(如前文所述)测试文件系统的耐久性:在每个客户端数量下,先运行 7.5 分钟的顺序混合读写,再运行 7.5 分钟的随机混合读写。我们逐步增加分配中的客户端数量,并报告随时间变化的带宽、IOPS、尾延迟以及性能衰减。有趣的是,我们发现一些服务商在负载下的带宽相比初始基准测试衰减了将近 40%。
当对象存储可用时,我们还会运行 15 分钟的 PUT、GET、LIST 和 DELETE 混合工作负载,测量吞吐量衰减、p99 GET 首字节时间(time-to-first-byte)的漂移、限流(throttling)以及错误。在这些测试中,我们观察到过大约 10% 的差异。
编排
在 Kubernetes 上,我们通过反复创建/删除 GPU Pod 并检查 API 中的 GPU 分配情况来测试“节点变动(churn)”。我们同时报告调度延迟和启动延迟,并在 kubectl delete po 卡住时报告失败。我们还会增加仅 CPU 的沙箱 Pod 批量,测量有多少 Pod 能达到 Ready 状态、耗时多久,以及其余 Pod 保持 Pending 状态的原因。
最后,我们测试 PVC 生命周期:反复启动一个挂载卷的 Pod,写入文件并执行 fsync,然后将其删除。每轮测试之间我们等待清理完成,并使用一轮预热来把初始镜像拉取从正式测量中排除。
破坏性测试
最后,我们来到有趣的部分:故意搞破坏。
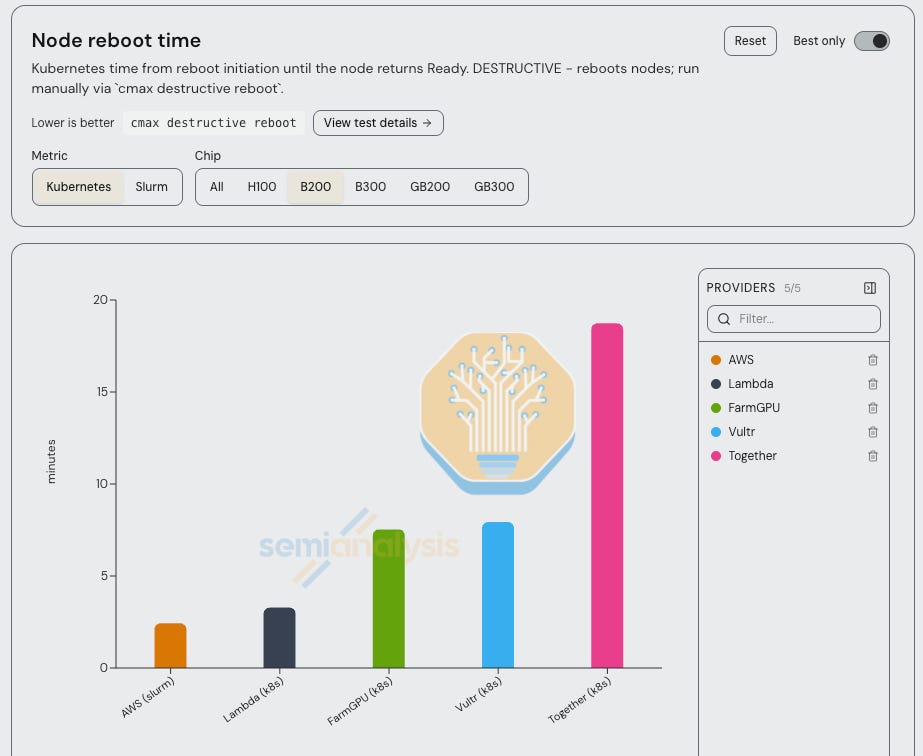
首先,我们重启集群中的所有节点。你也许希望这不是一个破坏性测试,但它确实是。在 Kubernetes 上,我们会先对节点执行 cordon 和 drain,然后发出重启指令,要求 boot ID 发生变化,再等待节点重新加入集群。当我们能在该节点上的一个新建 Pod 中运行 nvidia-smi 时,计时结束。在 Slurm 中,我们只需获取一个分配或通过 SSH 执行 sudo reboot。Slurm-on-Kubernetes 略有不同,因此我们尝试从 Kubernetes 层操作来正确测试它。我们的脚本会对整个过程计时。
在故障注入方面,我们首先使用 DCGM 注入方法。如果它不能正常工作,我们会随后向内核日志写入一条合成的 NVIDIA XID 或 SXID 消息,观察服务商现有的健康检查和调度器如何响应。我们不会干预他们的健康检测代理和自动排空(drain)机制,因此能否检测到错误并采取行动取决于他们自己的工具。大多数健康检查设置为从内核环形缓冲区读取,但有些不是,所以我们会与服务商沟通,确保我们的触发方式有效,并且我们有权限拉取日志。作为最后的可靠手段,我们会重置 GPU 的上游 PCIe 桥,这会产生一个真实的 XID 79 错误。
在所有这些场景中,我们都会测量故障检测耗时、节点停留在 DRAIN 状态的时长,以及节点重新加入集群后运行基本命令所需的时间。在 AMD 系统上,我们注入 UMC RAS 错误,并以相同方式跟踪所有指标。
这是我们最关键的测试。凡是听到大量客户抱怨可靠性的服务商,通常都没有完善的健康检查、监控面板和自动修复机制。正如我们在文章《GPU 集群的真实成本究竟几何?》中详细讨论的那样,可靠性是全球许多最大客户眼中最重要的第一标准。
Source: ClusterMAX Results Dashboard
值得注意的是,我们的实测只是整体评分的一部分。有很多东西无法通过实测来验证,需要借助其他研究方法来深入了解,包括:大规模性能、长期可靠性、支持体验、定价、GPU 的可用性和交付周期。
即将到来:Agentic 工作负载与 RL
我们还有两个测试套件,将在后续工作中详细讨论。
CPU 计算
对于现代智能体(agentic)工作负载而言,CPU 是一个关键的性能考量因素,我们此前已经讨论过这一点。我们开发了一个全面的基准测试,通过常见的 Linux 工具使用以及更多微基准测试,将这类智能体工作负载下的 CPU 性能推向极限,这就是我们即将推出的项目 SandboX。
SandboX 运行一系列具有代表性的 CPU 密集型工作负载,涵盖代码执行场景,包括环形交换(ring-shuffle)生产者-消费者队列、Redpanda(测量本地 Kafka 兼容代理及其吞吐量),以及一个动态负载基准测试。
我们还对 Kubernetes 集群的沙箱生命周期进行基准测试,以深入了解如何将用于强化学习(RL)的沙箱与 GPU 集群中剩余的 CPU/内存资源进行混合部署。我们报告冷启动延迟、调度吞吐量、每节点密度、容量以及基线数据。
强化学习
一次强化学习(RL)运行包含众多协同组件:负责展开轨迹的生成器、在沙箱中执行动作的环境,以及接收轨迹数据、更新策略并将更新后的权重推送回推理引擎的训练器。扩展 RL 意味着需要在多方面取得平衡:最大化训练器、推理引擎、环境沙箱执行的利用率,以及轨迹传输、权重同步等环节。任何一个环节出现瓶颈,都可能拖累整个 RL 技术栈。
我们还看到「后训练即服务」(Post-Training-as-a-Service,即 RLaaS)的兴起:客户自带环境,或由前向部署工程师(forward-deployed engineers)为其构建环境,托管训练服务商则搭建基础设施,对开放权重的模型进行后训练。其卖点是在保护客户 IP 的同时实现定制化——这显然已经成了 Satya 的口号。
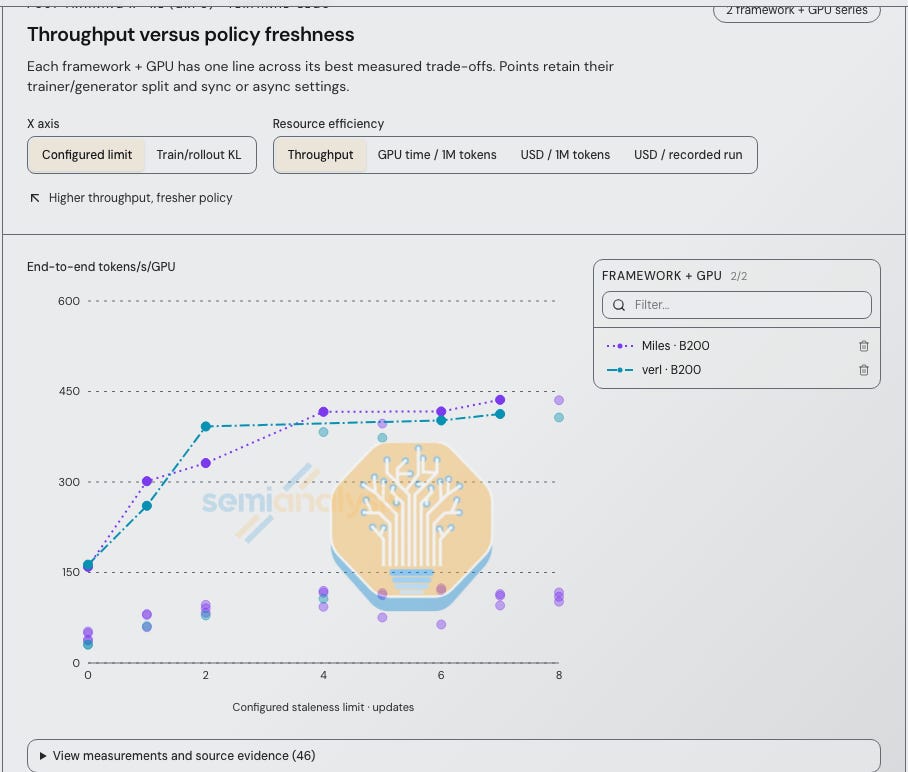
在我们即将推出的 PostTrainingX 基准测试中,我们会扫描训练器与推理 GPU 的分配比例、批次大小(batch size)、轨迹展开并发度以及策略过期(policy-staleness)限制,以研究这些因素对性能和训练稳定性的影响。
我们通过每块推理 GPU 的每秒输入/输出 token 数、轨迹展开延迟、KV cache 占用率和前缀缓存命中率来跟踪生成器性能;通过权重同步延迟、传输带宽和网络遥测数据来评估通信效率;并通过训练吞吐量、优化器步进时间、MFU、训练/展开 KL 散度、观测到的策略过期程度、截断比例(clipping fraction)、梯度范数和被拒绝的轨迹数据来衡量训练器的性能与稳定性。
对于环境,我们测量环境搭建时间、工具执行时间、超时次数和基础设施故障。GPU 利用率、内存使用和功耗提供系统层面的上下文信息,而归档的轨迹数据、日志和精确的环境定义则确保结果可复现。
PostTrainingX 的目标是对每一家服务商进行基准测试。这包括 Applied Compute、Azure Foundry、Fireworks、Thinky、Baseten、Trajectory、Engram、AI21 平台等托管训练平台,以及 Miles、slime、prime-rl 和 verl 等开源框架。最终结果应能为客户提供数据,帮助他们决定是把自己的后训练技术栈跑在开源框架上,还是交给托管的 RL 服务商。
我们已经开始在开源框架上运行测试,包括 Miles、prime-rl 和 verl,下一步将扩展到托管服务商。敬请期待……
行业趋势
融资
过去几个月里,新云领域最热门的话题就是融资。每个人都想“跟着钱走”,而这正是我们在 AI 计算、资本与市场模型中所做的事情。我们在最近一篇文章中推出了该模型,拆解了 NVIDIA 的“兜底宇宙”是如何运作的。下面我们将讨论几个其他热点话题。
债务与债务获取渠道
如今,新云厂商已经意识到,一份信用可靠的客户合同可以帮助它们以低于自身信用评级所能支持的利率获得债务。这意味着,没有确定客户(或“投资级承购方”)的服务商可能需要成本更高的债务或类股权资本来购买 GPU,从而启动或扩大业务。与此同时,贷款方也需要证据证明服务商能够按时交付集群,并履行客户合同中的 SLA。能否成功举债,既取决于租赁终止条款,也取决于可用于偿债的现金以及合同总价值(TCV)。这促使多家保险提供商带着参数化保险产品进入市场,保护新云厂商及其贷款方免受合同终止的影响。这类产品通常提供一个月的过渡期,以便在合同终止后寻找新的承购方。我们非常认可这种结构,并认为它是贷款方为此类交易降低风险的可靠方法。
交易对手风险与 NVIDIA 的“资产负债表即服务”
在一个大型新云项目中,GPU 贷款方和数据中心贷款方可能面对同一项目中的不同交易对手。例如,在 Anthropic 的 TPU 新云结构中,Broadcom 为设备融资提供支持,而 Google 为数据中心租金提供支持。由于供应链中的多笔贷款可能依赖于同一家 AI 实验室,即使每笔贷款的名义借款人是不同的新云厂商或数据中心,也会产生系统性的关联风险。正如我们刚刚讨论的,建设延期可能触发合同取消并损害现金流。
于是 Nvidia 的兜底机制登场了。Nvidia 通过收入下限、出租方担保以及计划转让给第三方的租约来支撑 GPU 需求,因此它们能够帮助 neocloud(新型云服务商)和 AI 实验室在没有超大规模云厂商参与的情况下获得投资级融资。Nvidia 在初始销售时赚取 GPU 利润,但现在还可以获得超出其“AICP 下限”那部分收入的分成。因此,它们的财务支持会推动自身硬件的需求。资产负债表就是护城河。
折旧时间表
自从我们去年 11 月在文章中抨击 Dr. Burry 之后,这个话题的热度已经消退了一些。也许是因为大家都在签 6 年期合同,又或者是那些价格就是不肯降的 4 年旧 H100!谁知道呢。
无论如何,我们在建模折旧时会把设备采购日期与投入使用日期区分开。6 年折旧假设需要针对具体提供商的证据支持,而在 NVIDIA 的 AICP 项目中,6 年收入下限实际上并不能确立 GPU 的使用寿命。我们的折旧敏感性测试会显著改变模型中的利润率,但 IRR 才是贷款方的首要考量,所以我们不会在这里分享这些结果。当然,财务分析也无法确定未来买家愿意为 GPU 支付的真实价格。这取决于供需动态,以及那个终极问题:残值。由于贷款方无法将贷款偿还计划与我们对设备计提折旧所用的会计假设分开设定,我们仍然身处这样一个世界:今天没有人愿意承担为 4 年、5 年或 6 年旧的 GB300 评估残值的风险。
Blackwell 与 Grace Blackwell
现在让我们回到本文其余部分的技术内容。精彩的部分来了。
正如我们在 ClusterMAX 2.0 中详细讨论过的那样,运营 8 卡 H100 HGX 服务器与运营 GB300 NVL72 机架级系统之间的差异是巨大的。那些 3-4 年前靠安装 H100 起家的服务商,如今正在应对以下挑战:
基于 ARM 的 Grace CPU(而非 x86 架构的 Intel 或 AMD) 采用 sm100/sm103 架构的 Blackwell GPU(需 CUDA 13.0 及以上版本) 强制性的直接液冷(DLC) 高压供电(每机架 130kW 以上,通过三相 408 或 480V 供电) 横向扩展网络:采用 800G CX-8 网卡,以及 51.2T 或 102.4T 交换机(800GbE RoCE Spectrum-X)或 115.2T 交换机(800Gb XDR InfiniBand) 纵向扩展网络:机架级、72 卡互联的 NVLink 交换机与背板 用于前端(或前端/存储融合)网络的 BF-3 或 BF-4 DPU 配备 shuffle 板卡/shuffle 线缆的多平面网络 所有这些变化都会对供应软件、监控系统、技术员培训、设施级的电气、散热和机械系统、OEM 支持合同与关系等等产生影响。
供应商在 Hopper 一代取得成功,并不意味着它在 Blackwell 一代也能成功。
在我们的评分中,我们格外看重那些向我们交付了 Grace Blackwell 的供应商。坦率地说,在交付配置、监控以及可靠性/热备件方面遇到困难时,我们也会给它们更多的宽容。
这意味着,如果客户租用的是仅通过 RoCE 或 InfiniBand 连接的标准 HGX 节点,我们期望看到具备热备件可用性的自动修复能力:端到端替换时间不超过一小时,故障检测时间在 2 分钟左右。但对于 NVL72 系统而言,在另一种规模的横向扩展(scale-up)网络架构上热插拔一个托盘就没有意义了。
因此,在我们的测试中,只要健康检查能在 2 分钟或更短时间内发现不健康的节点,并阻止工作负载被调度到该节点上,它就算完成任务了。如上所述,我们为许多实验室和云服务商提供 GB300 NVL72 SLA 方面的建议,而最常见的模式可以称为「NVL64+」。也就是说,SLA 应用于每个节点,但如果一个机架中的 18 个节点在同一时间有 3 个或以上发生故障,整个机架就被视为宕机。原因很简单,就是 2 的幂:很多任务能被 64 整除,运行在 64 个 GPU 上;而占满 72 个 GPU 的最大配置是 world_size=8 * num_jobs=9。
迈向 Vera Rubin
有趣的是,从 Grace Blackwell 迁移到 Vera Rubin 所需的改动,比从 Hopper 迁移到 Blackwell 少得多。供应商仍然管理着基于 Arm 的 CPU、液冷机架级架构、72 路 NVLink 横向扩展(scale-up)网络、多平面横向扩展(scale-out)网络,以及一些 Bluefield DPU。而在 GB200 刚问世时,这一切都是全新的东西!
主要变化在于横向扩展(scale-out)网络上从 800G CX-8 网卡升级到 1.6T CX-9 网卡,以及每个机架的功耗从约 130kW 提升到约 200kW,还包括 800V 直流供电选项。
早期需求比 Blackwell 过渡期更为强劲——部分原因在于,把 GB 的软件移植到 VR,比从 Hopper 移植到 GB 更容易。我们从许多供应商那里了解到,它们的 VR 交付进度有望早于预期。产品点亮(bring up)过程出乎意料地顺利,物理设计似乎也更加成熟。
横向扩展(Scale Out)网络
横向扩展网络是供应商仍然可以自主决定的最后一个重大设计选择。Nvidia 和 OEM/ODM 厂商锁定了 NVL72 机架的大部分设计。在机架之外,供应商可以选择拓扑结构、布线方案,以及 Kubernetes 或 Slurm 如何将网络结构交给某个任务使用。我们在每一层都发现了问题。
先从物理层说起,800G CX-8 网卡是多平面的:每块网卡把带宽拆分到多个独立的交换矩阵上,这些矩阵称为平面。每个 GPU 的总带宽仍保持 800G。平面越多,每台交换机就能获得更多有效端口,每块网卡也有更多通往上行链路的路径,而这需要经过一次重排。每条网卡通道都必须连接到正确的平面上,因此重排方案有两种:重排盒把光纤映射放在配线模块中,而重排线缆则把映射直接构建在线缆组件里。两者都可行,但在可靠性(设备需要维护的频率)和可维护性(维修或更换设备的难易程度)方面各有取舍。
Oracle 是这种物理设计的先驱,这一点在你拿到 GB300 节点时就能体现出来。我们收到的每个 4x GPU 托盘都有 16 个物理 200G 端口,也就是每个 GPU 对应 4 个平面。Linux 暴露出 4 个可用的 800G RDMA VF(rdma_vf_rail0 到 rdma_vf_rail3),每个 GPU 一个,各自位于独立的 VRF 中。聚合的 PF 无法使用,没有可用的 GID,因此我们只能依赖他们的 SPCX NCCL 插件:每个连接使用 16 个队列对,并在各平面之间采用自适应路由。
为什么要这么做?答案是规模。Oracle 在这个物理设计之上构建了 Acceleron。他们的 MRC 拓扑论文展示了每块网卡如何拆分成 8x100G,从而把一台 51.2T 交换机变成 512 个端口,并在仅有 2 层、最多 3 跳交换的前提下,支持 131,072 个 GPU 的全带宽互联。OpenAI 于 2026 年 5 月通过 OCP 发布了 MRC,而 Oracle 已在 Stargate Abilene 上投入运行。在软件层,MRC 可以把单个连接分散到多条路径和多个平面上,允许数据乱序到达,通过选择性确认来恢复丢包,并利用 SRv6 源路由绕开故障或拥塞的链路。这个逻辑层在任何规模下都可能变得复杂,作业层面的问题往往就出在这里。
要正确分配和使用 RDMA 设备,Kubernetes 必须把正确的设备和接口交给每个 pod。换句话说,NVIDIA NetworkOperator 有多种配置和使用方式。一旦配错,对所有人来说都是件麻烦事。
我们的脚本可以识别以下几种 NetworkOperator 部署模式(资源名称取自我们检查过的集群中的示例):
rdma_shared_device:配合资源背书 NAD 的 rdma/rdma_shared_device_*,或主机网络回退方案 sriov_host_device:配合 HostDeviceNetwork NAD 的 nvidia.com/hostdev 或 nvidia.com/rdma_host_dev,用于直接设备访问和 GPUDirect RDMA sriov_legacy:通过绑定 NAD 的 nvidia.com/<resource> 获取 VF,并配合 SriovNetwork NAD,必要时还需 RDMA CNI sriov_ib:配合 SriovIBNetwork NAD 的 InfiniBand VF(如 nvidia.com/mlnxics)。分区 fabric 还需要正确的 PKey 和 UFM 配置。 ovs_offload:配合 OVSNetwork NAD 的 nvidia.com/switchdev,用于硬件卸载的 Open vSwitch。 rdma_ib / rdma_roce:rdma/ib、rdma/roce 或 nvidia.com/rdma_*,每条 rail 一个 NAD,或采用主机网络回退方案。 特定供应商方案:AWS EFA(vpc.amazonaws.com/efa 和 libfabric)、DOKS(配合 roce-net-fabricN@fabricN 的 rdma/fabricN)以及 GKE DRANET(DRA claim 模板和 pod resourceClaims)。 设备配置以及其上的 NCCL 插件会显著影响作业性能。在 Google 的 GB300 上,内置的 NCCL 库选择了一个不可路由的链路本地 GID,导致我们测试时作业挂起。设置 NCCL_IB_GID_INDEX=3 解决了这个问题。Google 的 gIB 插件在 16 节点、16 GiB 的 all-to-all 测试中达到了 99.5 GB/s,而其他供应商只有 95.3 GB/s,也就是说达到了满性能。
话虽如此,多节点 NVLink 本身是另一个问题。NVIDIA DRA 驱动中的 ComputeDomain CRD 为每个作业提供独立的 IMEX 守护进程和 channel claim,与 RDMA 无关。Google、GMI 和 Firmus 的 Kubernetes 环境使用了 ComputeDomain,但 RDMA 路径各不相同:Google 用 DRANET,GMI 用共享设备加主机网络,Firmus 用每条 rail 一个 VF。与此同时,Oracle、Azure Slurm、GMI Slurm、Firmus Slurm 和 Nebius Soperator 直接从主机提供 IMEX,没有租户 claim。Azure AKS 运行多节点 NVLink 时没有租户可见的 ComputeDomain,尽管存在 GPU DRA ResourceSlices,而且 channel 来源和租户隔离边界都没有文档说明。
每个 ComputeDomain 必须位于单个 NVLink 域内,因为跨域需要 RDMA。换句话说,这就是在分层式纵向扩展 NVLink + 横向扩展 RDMA 网络上进行的拓扑感知组网。当我们在不考虑 ComputeDomain 的情况下错误地启动作业时,只要调度跨越了机架,作业就会卡死在 clique 建立阶段。至于 EFA 不支持 DeepEP 和 MoonEP 的问题,我们会在后文附录的 AWS 供应商评测中再详细吐槽。
可靠性、健康检查、自动修复和 SLA
大约在我们开始为《GPU 集群的真实成本究竟是多少?》进行调研的时候,我们开始向测试的每个集群注入故障。各供应商之间的差异很大。处理故障需要两件事:
识别故障的发生 妥善修复故障 要识别故障,我们建议使用监控仪表盘。一个好的仪表盘应当展示出故障组件、受影响的作业、调度器当前状态,以及每项检查的上次运行时间。一个过期未更新的绿色结果并不能证明系统健康。当然,监控仪表盘依赖于遥测数据,因此你必须正确(且安全地)配置好 DCGM。
要修复故障,我们期望自动修复机制:重启节点,以及用热备节点替换故障节点。自动修复无法覆盖所有情况。有些故障需要人工介入、RMA 退换等操作,这类工作必须由提供商直接与客户沟通。我们在相关文章中以有效吞吐量(goodput)的形式详细讨论过其确切成本。
NVIDIA 最近开源了 NVSentinel,一个面向 Kubernetes 的故障检测与修复系统。它读取 DCGM、syslog 和云维护事件,然后可以对节点执行 cordon(隔离)和 drain(排空)、重置 GPU 或重启节点。默认安装仅开启监控功能。软件本身反而是简单的部分。关键在于从每个 XID 到提供商所采取措施的映射。一个受控的 XID 94 只需要重启应用程序;而一个未受控的 XID 95 则需要 GPU 恢复。显然,如果你对每个 XID 都不加区分地重启每个节点,就会杀死健康的工作负载;反之,如果在出现严重 XID 后仍让 GPU 可被调度,则可能导致工作负载崩溃。
这也是许多客户只想要裸金属的原因。他们只是希望提供商把支持工单关闭掉。而关闭支持工单说起来容易做起来难。一个工单可能来自 100 多种 XID 中的任何一种,每种 XID 的含义和解决方案都不同。标准操作流程(SOP)涵盖的工作五花八门:从更换硬盘或电源,到清理线缆、重新插拔内存、GPU 或网卡,一直到对单个组件甚至整个服务器托盘(tray)进行 RMA 退换。
自动修复有很多不同的选择,正确方案取决于具体系统。此外,GB 和 HGX 的修复方式是两个不同的问题。在 HGX 上,你可以换入一台带 8 个 GPU 的热备节点。而在 NVL72 上,你无法向 NVLink 域中热插入另外 8 个 GPU。一个托盘(tray)故障会导致 4 个 GPU 下线,可选方案只有降级运行整个机架,或者更换整个机架。好消息是 GB300 的故障率往往低于 GB200。无论如何,真正重要的是从错误到数据中心实际操作之间的完整流程。
有些提供商告诉我们,他们会先等待一段时间再采取行动,好让客户有时间把自己的东西从节点上转移出去。这只是自欺欺人(cope)。我们模拟的是硬故障:节点已经死了,上面没有任何东西可以转移。(这里有一条普遍规律:如果一家提供商说他们选择不做某件事是为了“给客户保留选择权”,那多半是自我安慰,而且提供商迟早也会意识到这一点。)
这正是自建自营数据中心与租用托管机房(colo)的区别所在。自己运营设施的提供商可以掌控现场的技术人员、备件和标准操作流程(SOP)。而采用托管模式的提供商则只能依赖房东的远程协助服务及其时间安排。这两种模式都会影响容量恢复的速度,而这正是 SLA 必须衡量的内容。
在 SLA 方面,我们针对三个层级的提供商制定了一套标准化 SLA。
这些文档中包含以下内容:
在两种场景下对“节点”“机架”“集群”和“站点”的技术定义(HGX 8 卡系统,即 H100 或 B300;以及 MGX 4 卡系统,即 GB200 或 VR NVL72) 针对所有系统的“停机(downtime)”技术定义 三个层级对应的 SLA(“铜级”“银级”和“金级”,并附带相应的阈值以及与停机挂钩的服务抵扣赔偿) 关于停机计量和服务抵扣提供的双向承诺 建议排除在停机计量之外的情况,例如软件升级、安全补丁和物理维护 建议的每月评审节奏,用于评估提供商对 SLA 的履行情况 当停机低于建议阈值时,买方享有的合同终止权 验收测试的定义,包括应在 GPU 计算、网络、存储和软件层面执行哪些类型的测试,以验证集群正常运行并可通过验收,同时建议联系 SemiAnalysis 进行 ClusterMAX 技术评估 当提供商未能按约定日期完成验收时,买方享有的合同终止权 “不可抗力(force majeure)”条款的定义 ……以及更多内容 我们鼓励计算买家(Neolabs)、云提供商(Neocloud)、债务/融资合作伙伴以及保险提供商以这些条款作为合同基础,并在验收测试和每月 SLA 绩效评审中纳入 SemiAnalysis 技术评估。我们使用自研的 cmax 工具和一套全面的专有流程来执行该技术评估。
如需更多信息,请联系 clustermax@semianalysis.com。
安全
自我们发布《大多数 Neocloud 的安全做得很糟(Most Neoclouds Suck at Security)》一文以来,各方的反响令我们备受鼓舞。我们的朋友们已开始在自己的集群上运行我们的 CLI 工具,以找出需要替换的陈旧过时软件包。总体而言,业界以应有的严肃态度对待这一问题的动力也在不断增强。
尽管如此,我们认为这个问题值得更深入的审视。在关于 AI 是否会毁灭全人类的讨论已达到白热化之际,几乎没有针对其具体如何摆脱控制并造成伤害的分析。OpenAI 和 Anthropic 正花费巨资开展 gain-of-function(功能增强)研究,其中一些基础设施已被曝出存在严重疑点,但有一点基本没有受到评论关注:GPU 集群——承载这些模型的物理宿主——往往完全不具备你所期望的那种免疫体系。
无论你对 AI 能力持何种看法,良好安全实践的重要性都不容动摇。即便这些集群没有因为 AI 工具而变得更容易被攻击,事实依然是:我们正在投入数十亿美元建设本应更加安全却并不达标的基础设施。可以想象出许多令人不快的场景,其中所需的不过是一个会 Vim、深谙操作系统原理的人。翻一翻 Hugging Face 的报告,数一数那些让火势蔓延的平凡网络安全失误有多少个吧。
还值得强调的是,这在某种程度上是一种结构性风险。当前行业正艰难应对严苛监管和毫无辨别力的社会反弹这两重 hazard,此时最不该发生的就是 LLM 工厂遭入侵登上头条。这在网络安全层面成立——每一个被攻陷的节点都会增加攻击者可探索的邻居数量;在寻常的社会政治层面同样成立——无论好坏,批评者都会对 neocloud 行业一竿子打翻一船人。
做一个好邻居,别被黑。
Agentic Coding(智能体编程)
Agentic coding 已经给托管式 GPU 集群带来了利润压力,因为使用 AI 工具的客户更愿意选择裸金属或轻托管集群。我们在测试中时常看到这方面的证据。比如我们需要添加 Linux 用户,但集群上没有现成脚本,这时 Codex /goal make useradd script and add my whole team 就省去了大量跑腿工作。尤其是在文档匮乏的集群上,智能体能帮我们把各种可能的配置逐一试遍,让工作不再卡壳。与之对应的 Slack 对话通常是这样:
「嘿各位,XYZ 到底该怎么用?」
「算了,Codex 告诉我是 ABC。」
「对,没错。我们会把这个写进文档。」
智能体在具有明确成功标准和充足上下文的环境中对我们帮助最大;否则,它们处理 GPU 系统的方式就很天真。它们掌握相关知识,但这些知识相对于貌似合理却错误的做法而言,权重并不高。比如 Claude 有一个习惯:不用作业数组,而是用循环把 Slurm 控制器压垮。我们的一个智能体觉得 NVLink 网络配置太麻烦,就改用 InfiniBand 启动作业并宣布大功告成;另一个智能体犯了类似的错误,在 NVMe 而不是 NFS 上运行存储测试;还有一个在试图把 GPU 作业调度到 CPU 节点上之后,反过来指责供应商性能太差。我们通常让智能体整夜运行,指令要么是 `/goal 修复集群的这一部分,让测试能跑起来`,要么是 `/goal 用真实的工作负载尝试搞垮集群的这一部分`。总体而言,这让我们成倍提升了产出,但有时验证结果所花的时间比自己动手还长。如果你清楚如何搭建集群,智能体会让你如虎添翼,你甚至可以考虑接受一个比原本更差的供应商。如果你不知道自己在做什么,你的 AGI 顾问会兴高采烈地建议你搬起石头砸自己的脚。在这个半透明化的行业里,智能体放大的是技能差距,而不是抹平它。
一个有启发性的例子是 CoreWeave 的系统上线流程,它本来就是业内最严格的之一。现在,在严苛的传统流程之外,他们还让 LLM 在整个集群上运行统计分析,寻找能更早标记故障、改进流程的模式。CoreWeave 还有一个 NodeBot,它在其自动化告警之上提供轻量级推理,总结现状并建议下一步操作,从而简化环内人类的诊断工作。举个例子,团队描述过这样一个事件:导热界面材料泵出(pump-out)告警本应将该节点移出集群以便调查,但同时发生的 PMU 挂起告警却要求重启节点,而不是对其进行分诊处理。尽管存在这种冲突,NodeBot 仍识别出了正确的操作。CoreWeave 拥有大规模运行 GPU 的经验,掌握着无数训练数据中没有的经验法则,并且有专家持续闭环以改进这些模型的使用;即使 OpenAI 真用 AI 生成的内核造出了一款强劲的芯片,我们也不认为 CoreWeave 会在短期内被那些靠 vibecoded 数据中心自动化的新兴 neocloud 所威胁。
尽管说实话,业内每个人至少都在某些工作流中使用 AI,但我们看到的唯一 AI 优先(AI-first)产品是 AWS 提供的一个不错的 MCP 服务器。除此之外,所有文档名义上都是为人类编写的。供应商为了照顾 AI 智能体,能做的最好的事情就是提供详尽的文档——理想情况下,其详尽程度应远超人类所能通读的范围——并在集群上留下黄金配置方案(golden recipes),作为爬坡优化的起点。除了尚未实现 AI 优先的传统流程之外,还有许多系统因为不是为智能体构建的而明显更差。例如,虽然让 AI 管理作业可能有利于集群利用率,但它并不尊重那些为辅助研究而建立的旧式系统。CoreWeave 和 Nebius 在 Slurm 层面有许多优化——带有 RBAC 的真实作业记账系统、对用户和组强制执行的优先级、精心管理的分区、作业数组、日志和指标——当所有操作都由智能体执行时,这些都被浪费了。CoreWeave 还告诉我们,当远程操控的 Claude 粗暴地编排集群时,他们曾见过头节点内存耗尽的情况。观察供应商如何改进其对 AI 智能体的支持能力,将会是一件有趣的事。
展望未来
正如本文通篇所述,我们一直以来都在进行集群测试。但市场显然已经朝着两个截然相反的方向发展。
首先,最大的那些实验室正在以数百兆瓦(MW)级别的规模采购裸金属服务器,并拥有内部人才来管理自己的训练集群、编排软件、监控和可靠性保障。本质上,他们的新型云(neocloud)供应商(在他们不自建的情况下使用时)就是负责关闭工单的数据中心技术人员。这是一项复杂的业务,不能想当然:NVIDIA GPU 有 172 种已记录的独特故障方式(XID)。而且其中许多故障模式可能相互重叠,从而产生极其庞大的故障场景面,需要结合简单的故障排查逻辑、人类经验,以及日益重要的 AI 智能体研究,才能从这些故障中恢复。
与此同时,许多初创公司正在筹集数千万甚至数亿美元,并将这笔钱几乎全部花在算力上。但由于这项研究很大程度上由 RL 驱动,即通过在真实生产轨迹上对长程智能体进行持续学习,因此对离线的、吞吐量优化的推理以及在线的、延迟敏感的推理的需求都非常强烈。与此同时,越来越多的客户在寻找为工作流购买普通开源 token 的最简单方式。
这引出了我们即将推出的下一篇文章,我们将描述推理端点的剖析(Anatomy of an Inference Endpoint),并逐步将推理端点测试纳入未来版本的 ClusterMAX。我们相信,所有新型云供应商今后都需要开展端点业务。
我们还会对推理之外的 RL 基础设施进行评估,包括沙箱、托管训练、评测(evals)等。我们看到每天都有大量新提供商进入(和退出)这个市场。现在正处于 AI 发展的激动人心的时代,而 neocloud(新型云)正处于这一切的中心。
如果你已经读到了文章的这里,还想进一步了解我们对每家提供商的实际使用体验,不妨考虑加入 SemiAnalysis 工作!
我们正在研究、咨询和技术团队等多个方向积极招聘。我们在纽约和旧金山办公室都有多个职位空缺,也接受远程办公。ClusterMAX 工程师:具备 Slurm、Kubernetes 和 GPU 相关经验者均可申请,不限经验水平(全职)。Tokenomics 工程师:具备模型评测、测试框架(harness)、推理端点和 RL 基础设施相关经验者均可申请,不限经验水平(全职)。研究分析师——AI 基础设施与经济学:负责跟踪 neocloud、neolab 以及前沿实验室(frontier labs)的 token 经济学财务状况,不限经验水平(全职或实习)。技术顾问:主导从技术战略到技术尽职调查的各类项目,具备咨询或技术背景者均可申请,不限经验水平(全职)。
感谢阅读,期待在未来版本的 ClusterMAX 中与你再次相见。
附录:提供商评测
白金级
CoreWeave
CoreWeave 依然是业内最敏锐、最稳健、最积极主动的 neocloud。
我们的 CoreWeave 集群在所有关键类别上都堪称典范。健康检查运行正常,可靠性极为出色,几乎所有测试开箱即用即可达到预期数值。CoreWeave 与 Nebius 一起,充当着业内其他厂商的衡量标杆——这不只是抽象意义上的“优秀表现者”,更是字面意义上的:我们会将其集群与评分较低的集群进行对比,以此精确描述其他厂商的不足之处。当其他 neocloud 还需要反复催促才肯更新陈旧的 GPU 驱动时,CoreWeave 不仅把基本功做得到位,还搭建了庞大且独立的软件栈,以求在性能和可靠性上实现进一步的提升。
ClusterMAX 2.0 报告曾详细介绍了 CoreWeave 的设计决策,包括其裸金属配置、Slurm 分支版本、DPU 的使用以及健康检查。自那以后,CoreWeave 的技术极客们又增加了一项智能功能,名为「GPU 掉队者检测」(GPU straggler detection),并已集成到他们业界领先的仪表板中。客户无需自己去翻查日志,也不必在整个集群上做二分查找来定位出问题的 rank,CoreWeave 会对 NCCL 遥测数据应用自研算法,并根据检测结果推荐修复策略。CoreWeave 团队告诉我们,他们几乎每天都会在与客户的通话中使用这项功能。各种软故障不会写入 XID,也不会留下任何明显的痕迹,但作业会因为等待掉队者而浪费大量 GPU 时。
比发现坏 GPU 更好的做法,是从一开始就不把任务调度到它们上面。CoreWeave 还有一套系统,确保每个节点在承接客户工作负载之前都通过严格的高标准检验。当某个节点在 CKS 中处于空闲状态时,CoreWeave 会在每小时的 20-30 分钟内运行老化测试(burn-in),验证纵向扩展和横向扩展的 fabric 是否健康、GEMM 性能是否达标、D2H 和 H2D 带宽是否够高等。这些测试会被客户工作负载抢占,对运维人员完全透明,同时有助于确保故障由测试而不是生产工作负载来发现。CoreWeave 当然不是唯一一家提供主动健康检查的提供商,但他们的做法格外稳健。
这种严谨态度也贯穿于 CoreWeave 的设备上架(bring-up)流程。CoreWeave 每周要部署约 10,000 块 GPU,他们自信掌握着关于判定一个 Blackwell 机柜是否健康的数据,比任何人都多。在 CoreWeave 看来,Nvidia 的诊断工具(diags)能够捕获很多故障,但他们独有的深度数据集让他们得以推出一套自定义的补充测试套件,其中包括针对 NVLink 的测试。这一流程的核心是 Fleet LifeCycle Controller(FLCC),它“将节点部署、测试和监控自动化”,并掌控从上电到交付使用的整个流程。值得注意的是,正如其他大规模运营集群的厂商可以证实的那样,存在一大类冷门故障模式,Nvidia 的文档对此覆盖不足。CoreWeave 对这些故障进行统计,以便更好地预测未来可能出现的问题,并将应对模式固化到 FLCC 中。这也是我们把大规模运营经验作为我们评级中关键标准的原因之一。一个新手与 CoreWeave 这样拥有严格操作手册、自动化流程和老化测试(burn-in)的提供商之间,存在巨大差距。正如上文“Agentic Coding”一节所述,CoreWeave 在该系统之上运用 LLM,以挖掘人类工程师难以察觉的洞察。CoreWeave 还会在交付前与制造商合作。参与程度因 OEM 或 ODM 以及生产阶段而异,但总体目标是在供应链中逆流而上,尽早发现问题:能在上架阶段发现的,绝不要留到生产环境;能在 L11 诊断阶段发现的,绝不要放过到离开工厂之后。
凭借在 Blackwell NVL72 上架与验证方面的经验,以及与 Nvidia 和 Dell 的紧密关系,CoreWeave 成为首家宣布其 VR200 NVL72 系统通过 L11 诊断的提供商。CoreWeave 将 VR 称为“我们贡献自有 IP 的一代”。随着计算对物理设施的要求不断提高,CoreWeave 认为:“建筑的运行方式如今已成为计算机运行方式的一部分——二者不再是彼此独立的两样东西。”因此,CoreWeave 在最近的一篇博客文章中介绍了其自研的 Racky、Valvey 和 RLCC。其中特别值得关注的是 Valvey,这是一套可编程的逐机柜液冷阀门组件。它让 CoreWeave 能够对每个机柜的冷却回路实现精细控制,并且在发生泄漏或其他紧急情况时可以触发停机。尽管 CoreWeave 在自研硬件方面开始展现出超大规模厂商(hyperscaler)的思路,但它将自己的方法定位为“反超大规模”(anti-hyper):传统基础设施强调冗余性、以防止故障为目标,而 CoreWeave 则追求优雅地失败、快速地恢复,通过限制故障域来对不可避免的故障做出更敏捷的响应。
然而,在当前这场万亿美元规模的建设热潮中,CoreWeave 一方面在应对客户需求的大幅增长,另一方面也在应对资本成本的不断上升。当然,也有不少好消息值得提及。它与 Meta、Microsoft、OpenAI 和 NVIDIA 这些最大客户的关系看起来十分稳固,最近还与 Anthropic 达成了一项多年期协议。今年夏天,它高调宣布了与 HRT 和 Jane Street 的合作。它还在积极扩建 APAC 地区的产能,并表示“预计国际市场将成为增长的主要驱动力”。然而,它背负着 350 亿美元的债务,随着资本成本的上升,项目的启动周期也变得更长。因此,CoreWeave 已经将重心放在长期裸金属合同上——这类合同更容易获得拥有投资级评级的对手方的融资支持——而不是托管集群业务,后者虽然利润率更高,但市场对其融资意愿较低。此外,我们上一篇文章曾提到其近期一系列令人印象深刻的收购,但自那以后,它与 Core Scientific 的合并告吹,也没有再宣布任何其他收购。
在用户反馈方面,有些意见略显吹毛求疵:
我们希望他们的托管 SUNK auth RBAC 能按集群级别进行配置 我们希望在 UX 控制台中,启用本地 GPUDirect Storage 能做成一键按钮 新用户引导流程,以及 UX 控制台中填写 SSH 公钥的位置,让许多尝试过的用户感到非常困惑 CoreWeave 已开始从纯裸金属业务向多元化转型,首先推出了自助式 SUNK 集群,这使其在有空余产能时可以选择进入按需市场。值得注意的是,并非所有“裸金属”合同都是一样的。在 CoreWeave 的所有裸金属合同中,它们仍然负责管理横向扩展网络和前端网络、进行老化测试(burn-in)、处理维修/更换、监控以及其他常规的 day-two 运维工作。相比之下,其他一些自称是 neocloud 的服务商,实际上却被挡在自己的数据机房之外。我们将在接下来的文章中深入探讨这些细节,对比不同服务商提供的各种裸金属方案。
CoreWeave 还推出了一个托管推理平台,最近披露其 ARR 已达 1 亿美元。我们正在积极测试该平台,为一篇关于无服务器推理端点的 upcoming 文章做准备,但让我们失望的是,它不支持按 token 计费的公共端点。目前我们只能说,CoreWeave 在推理端点方面还有一些工作要补齐。
Nebius
在 ClusterMAX 2.0 中,Nebius 被评为全球第二好的 neocloud,但当时仍停留在 Gold 档。这一次,Nebius 毫无疑问已是行业领导者,在各个类别中都有强大的产品,并且拥有索取可观价格溢价的能力。Nebius 升入 Platinum 档。
Nebius 与 Nvidia 的关系依然紧密。Nvidia 在 3 月份向其投资了 20 亿美元,并于 7 月份披露持有其 9.3% 的股份。Nebius 是早在 2025 年 12 月就部署 HGX B300 的首家提供商,并且是最早进行 VR NVL72 部署调测的 neocloud 之一,预计将于今年年底或明年年初开始部署。
Nebius 在美国和欧洲的多个站点持续推进扩建,并于近期将 2027 年年底的已签约电力目标提高到 5 GW。在算力采购方方面,Nebius 已与超大规模云厂商 Meta 和 Microsoft 签署了大额协议,并与 Reflection AI 和 Palantir 签订了规模较小的合同。这使其成为少数几家拥有数百兆瓦级超大规模云厂商协议、同时仍经常参与争夺小得多的初创企业合同的 neocloud 之一。在短期集群市场上,Nebius 是所有 neocloud 中最活跃的,服务着许多满意的客户。当年 Nebius 因俄罗斯口音而让潜在客户望而却步的日子已经一去不复返。这一点在其算力资源的获取方式上也有所体现:与许多同行不同,Nebius 通过广泛的数据中心和软件合作伙伴网络,以机会主义的方式抢下了多个 5-20 MW 规模的站点。
至于集群本身——好的集群通常都是“无聊”的。在 Nebius 上,burn-in 测试运行无误;Slurm 具备拓扑感知能力;我们需要的软件包在集群上都有,而且版本普遍较新;WAN 网络状况良好;编排层也没有容易踩坑的地方。在技术上,Nebius 与其他所有提供商的一个不同之处在于,它自行构建并开源了其偏好的 SonK 版本 Soperator。(当然,CoreWeave 在内部自研了 SUNK,但并未开源。)本轮测试中,我们测试的一个 Gcore 集群使用了 Soperator,前几轮测试中的 Voltage Park 和 FPT 集群也是如此。Nebius 这样写道:“Soperator 真正的魔力在于我们使用 ‘jail’ Persistent Volume 的方式”。Nebius 在 `jail` 处提供一个 VirtioFS 卷,然后将其绑定挂载到 `/`,因此你无需操心把缓存指向正确的目录,在用 `salloc` 申请节点时也不必费心考虑如何携带自己的文件。在我们对其他提供商的评测中,你会看到一些在 SonK 上管理存储系统的棘手问题:Slurm 和 Kubernetes 对持久化的理念不同,而且当你实际上隔着好几层、站在一个临时性的 Kubernetes pod 之上时,要营造出裸金属的体验并不总是那么容易。Nebius 的方案让运维人员完全不用为此操心。
具体来说,Nebius 在每台 worker 节点上为我们提供了多种存储层级:`/jail` VirtioFS、`/home` NFS、`/mnt/data/` VirtioFS、`/mnt/local-nvme` ext4、`/mnt/memory` tmpfs,以及一流的 S3。对于 I/O 密集型任务,推荐使用 `/mnt/data`;而 `/home` 则足以存放共享代码和其他并发访问较低的数据。我们首次测试 `/mnt/data` 时,发现 4 KiB 顺序分配写入非常缓慢,而且当 128+ 个 rank 并发创建目录时,有时会因为元数据可见性不一致而返回 `EEXIST`,导致我们的任务被杀死。针对我们反馈的这些病态工作负载,Nebius 对该文件系统进行了重新调优,之后它表现得既稳定又快速。我们对它进行了各种压力测试,确认错误已经解决。就单客户端而言,它的性能超过了中位水平,我们还进一步验证了它可以扩展以处理跨两个机架的高强度工作负载。
Nebius 在健康检查方面投入了大量精力,在我们的测试中表现良好。在我们的一台 GB300 机架上注入合成错误后,Nebius 自动让该节点重新恢复服务。这个过程在速度上尚未优化,从头到尾耗时 8 小时 40 分钟,但检测是即时的,而且整个流程最终是有效的。此外,我们测试的其他 GB300 机架并不会自动重启并恢复故障节点,因此这一流程能够自动运行,算是 Nebius 的一个加分项。(正如我们在“Blackwell 和 Grace Blackwell”一节中所描述的,业界通常根本不会对 GB300 节点进行自动修复,因为并没有真正的方法将节点热插拔到 NVL72 机架中,而且故障排查通常比 HGX 服务器复杂得多。)Nebius 还为我们提供了一套优秀的仪表盘,可以查看集群健康状况等诸多信息。
这一切使得 Nebius 的每 MW 收入相比 CoreWeave 持续攀升(其市值也随之上涨)。由于按当前价格计算,他们还有大量容量可供出售,我们预计这一趋势将持续下去。据我们的经验,Nebius 在近期的谈判中态度非常激进,甚至有一次他们将一批容量直接以拍卖方式出售。总体而言,要求高价格以及高达 100% 的一年期承诺预付款,看起来是一门相当不错的生意,尤其是在当前 TCV 下,这些预付款足以覆盖服务器的全部资本支出。有没有人想要无限的项目 IRR?
在其最大的裸金属站点,Nebius 仍在面临建设和许可审批方面的延误,包括 Béthune 和 Vineland 在内——我们已为我们行业领先的 Datacenter Model 的客户对此进行了广泛报道。但随着越来越多各类型的芯片上线,Nebius 的过往业绩使其处于持续增长的强势地位。
总体而言,我们对 Nebius 一贯印象深刻。虽然我们仍然认为他们在许多技术层面、以及与 NVIDIA 和前沿实验室的关系上落后于 CoreWeave,但稳健的商业决策已使他们成为服务 neolab 的默认 neocloud。
金牌
Google Cloud
在 Google Brain 和 DeepMind 奇怪地从前沿撤出的同时,GCP 的交易动作却少有对手能及。值得关注的合作伙伴包括 100 亿美元的 Palo Alto Networks,以及与 Thinking Machines Lab 签署的“数十亿美元级协议”,同时还扩展了与 AI 安全组织 Anthropic 这一利润丰厚的合作关系。通过以 320 亿美元收购网络安全初创公司 Wiz、以 47.5 亿美元现金收购能源初创公司 Intersect,Google 在扩展技术能力方面十分激进。它还通过加大 TPU 销售而非仅通过 GCP 出租的方式,为自己开辟了新的收入来源——这一进展我们非常期待持续追踪。不过,其自有的 TPUaaS 仍在增长,这要归功于与 Blackstone 达成的 50 亿美元协议,目标是 500 MW 的容量。Google 手握数吉瓦的在途项目,我们期待继续追踪它与其他超大规模云厂商和实验室在电力资源和审批许可方面的持续竞争。
凭借横跨技术栈众多层的独特地位,Google 拥有的工程技术人才总量可能超过世界上任何一家公司,但其在支持创新方面的历史记录却明显不完美。在 ClusterMAX 1.0 中,我们指出了其平台的诸多问题,但我们当时就预测 GCP 会迅速达到金牌或铂金级别。虽然直到 ClusterMAX 3.0 这一预测才成真,但 Google 如今终于稳居最优秀的管理型集群提供商之列。
GCP 的 GPU 体验不如我们的铂金级提供商 CoreWeave 和 Nebius 那样精细。与更年轻、更专注的 neocloud 那些精简的 UI 相比,它的控制台感觉就像车管所一样官僚低效。访问需要使用 Google Cloud CLI,而它偶尔不听使唤,迫使我们有时改用 Google 控制台中基于浏览器的连接方式,而后者同样不太可靠。我们的 GB200 GKE 集群上还出现了一个小配置错误:默认 StorageClass 无法挂载到 `a4x-highgpu-4g` 节点上,我们不得不改用非默认的 StorageClass 来获得块存储。抛开这些吹毛求疵,GKE 的设置非常到位,我们很喜欢使用它。Google 的托管 Slurm 已正式全面可用(GA),并且相当扎实,预置了良好的默认配置和健康检查。我们此前在 ClusterMAX 2.0 中针对其托管 Slurm 服务所做的许多测试如今仍然有效,因为 GCP 产品管理部门的官僚们终于允许真正的客户使用该服务,而不是给它贴上“Beta”、“预发布”或“尚未 GA”之类的标签。(顺便说一句,我们将在 Google 之后讨论的许多 neocloud,其实应该考虑更频繁地使用这些标签——合适的平衡点在两者之间。)
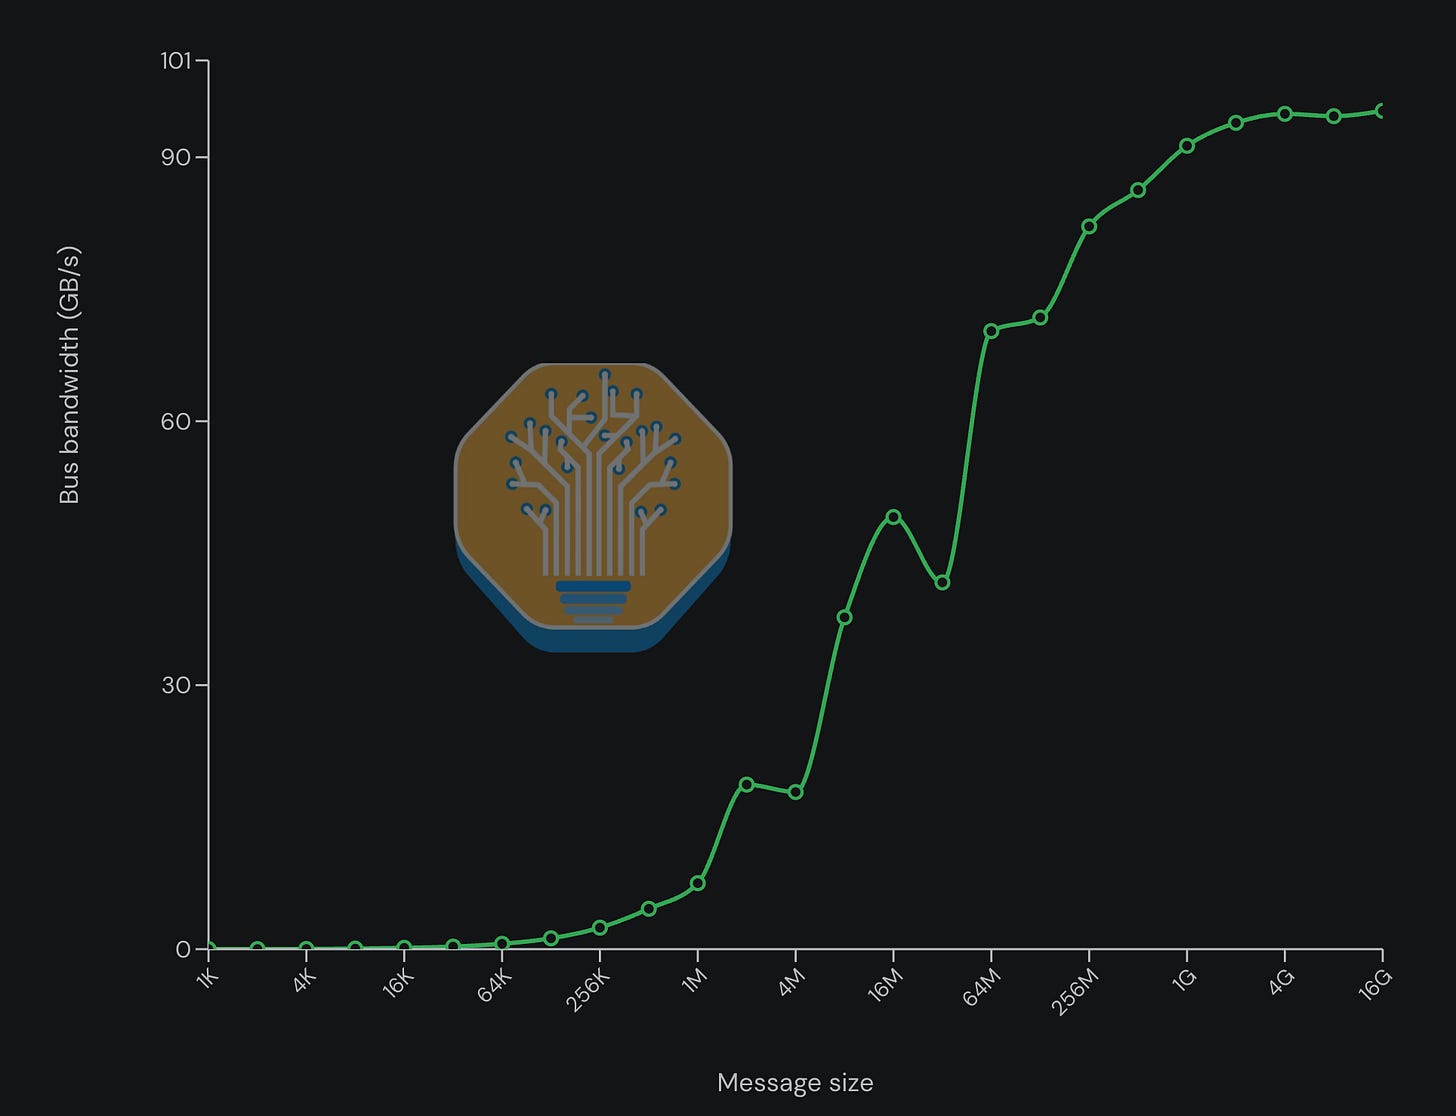
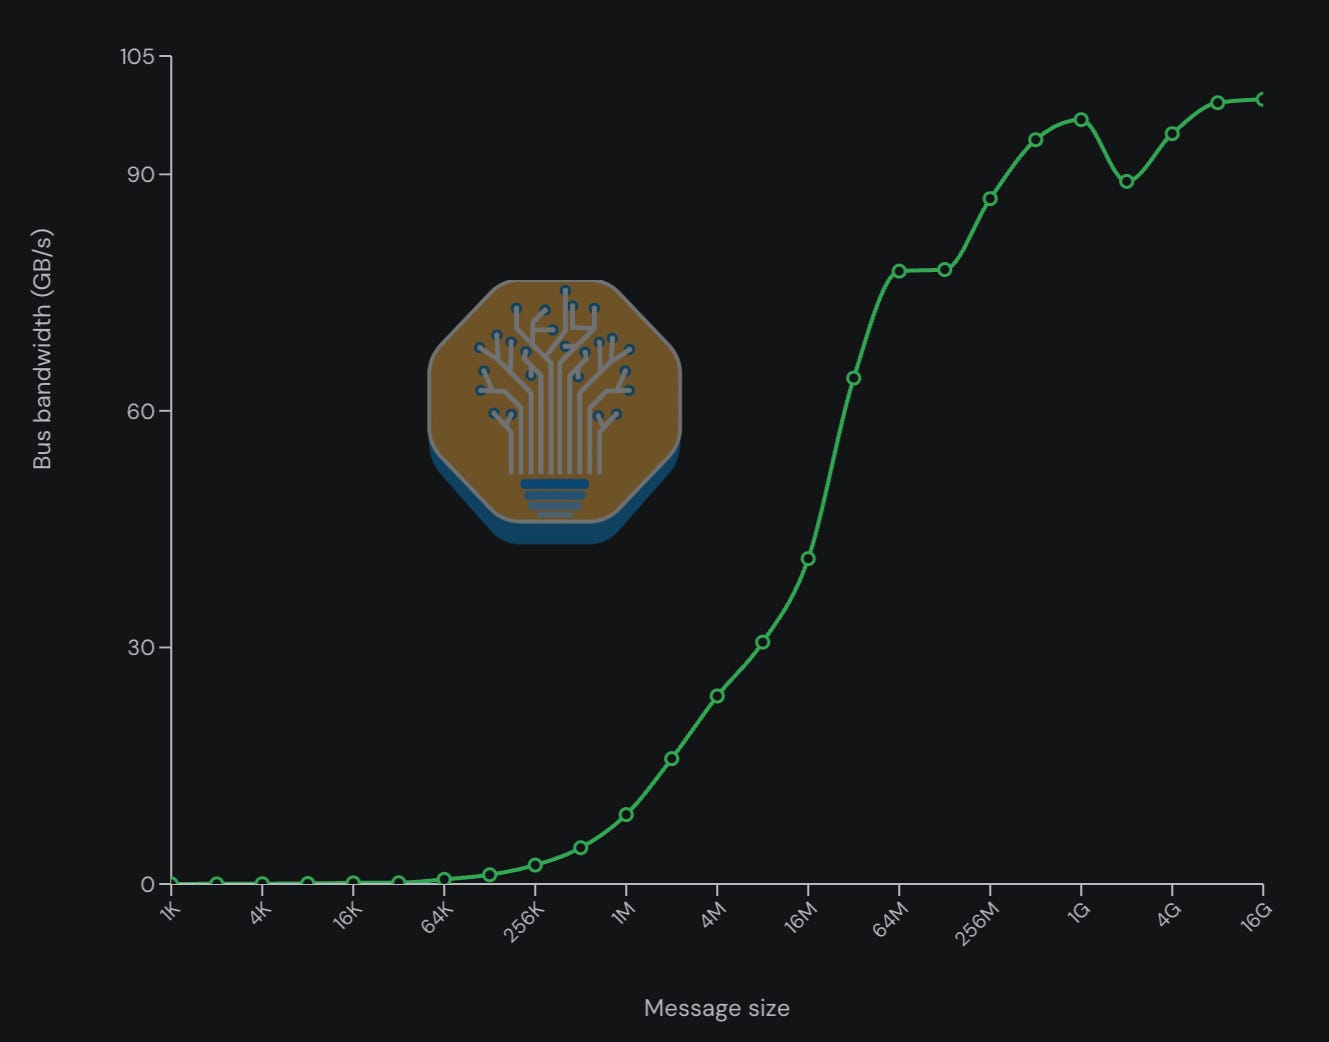
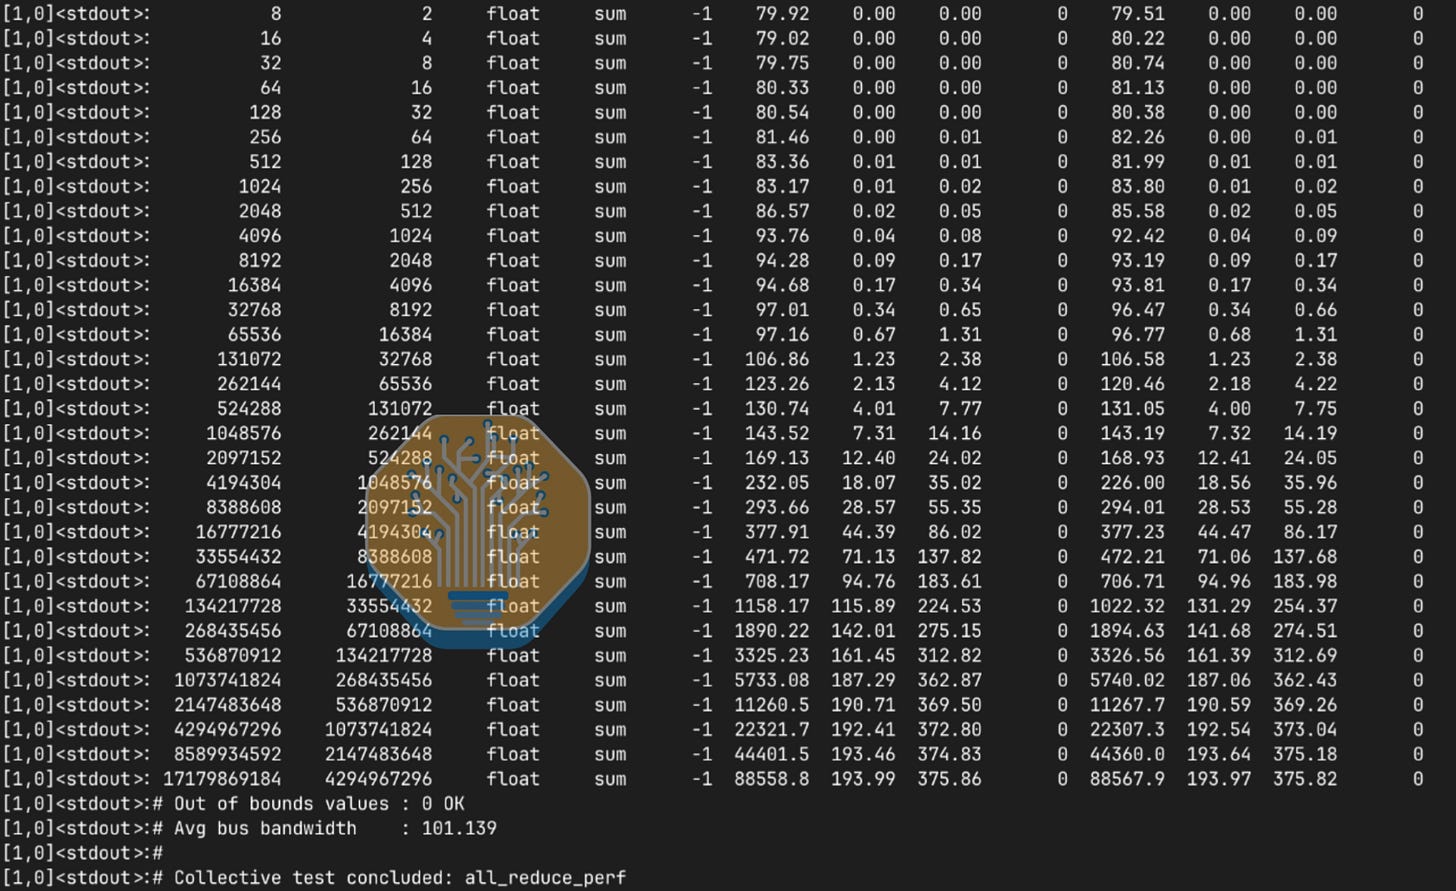
我们的 GCP 集群与其他测试集群之间最大的差异点在于网络。第一次 NCCL 测试挂起了,原因是自动 GID 选择选错了地址,但固定设置 `NCCL_IB_GID_INDEX=3` 后运行得以完成。即便如此,NCCL 测试结果仍不尽如人意:理想情况下,随着消息大小的单调递增,性能曲线应大致呈逻辑斯蒂(logistic)曲线形状,但我们实际得到的是如下锯齿状图形:
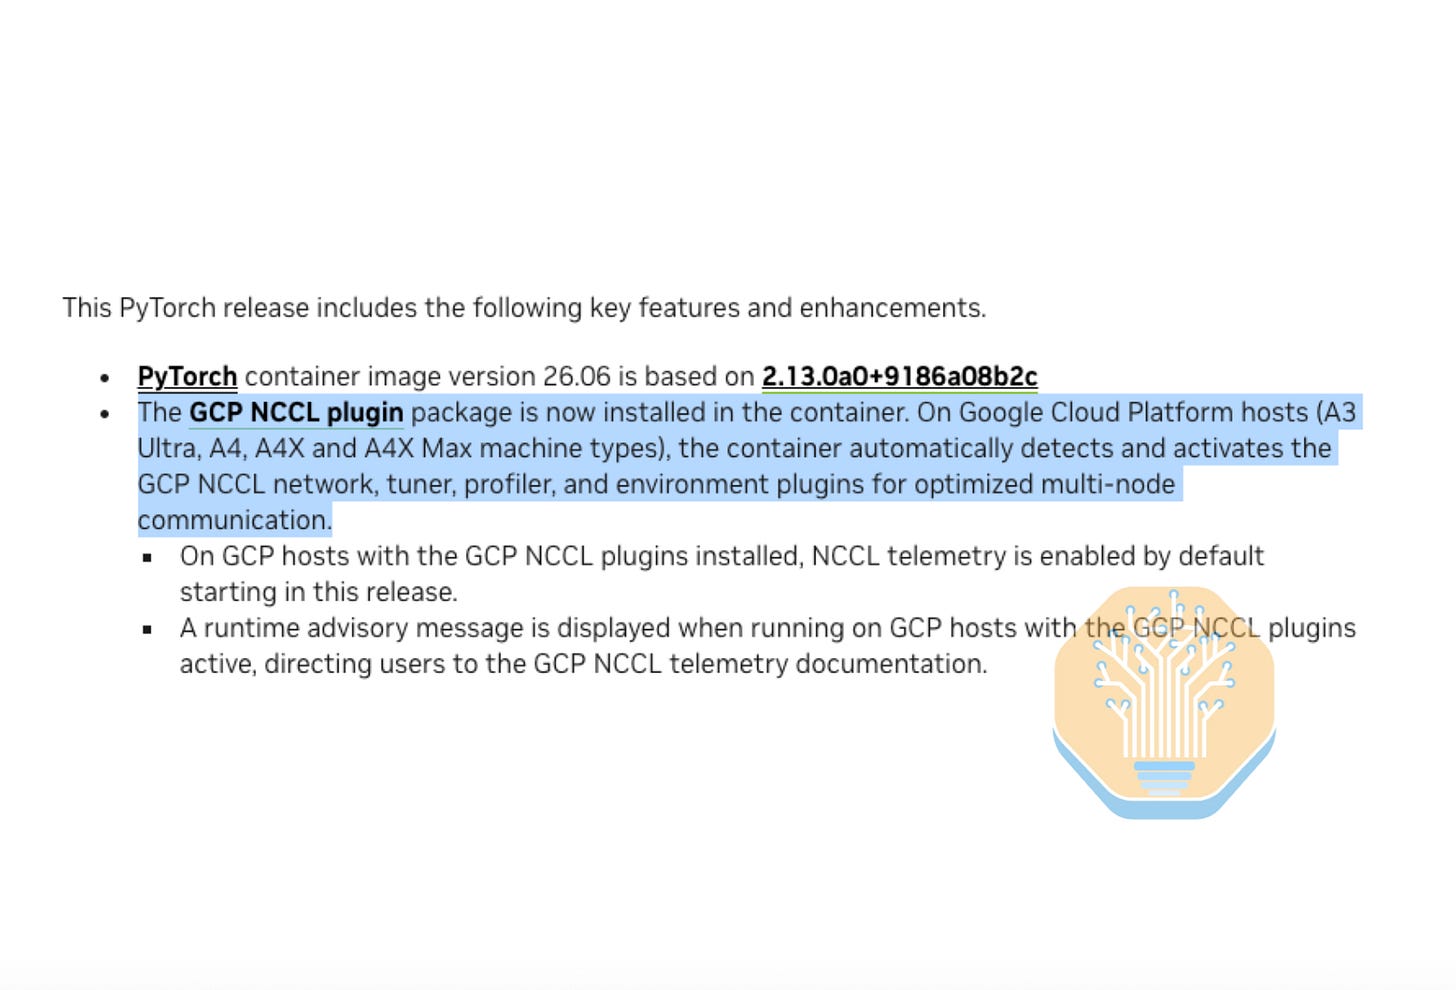
这 conceivable 地可能是 NCCL 本身的问题,而非 GCP 配置的问题。NCCL 的启发式策略并不总能针对消息大小和拓扑选出正确的协议与算法,通常需要一些手动调优。不过,此时我们已经收集了数 GB 的网络数据,知道性能理应更好。问题最终查明,仅仅是我们没有启用 gIB 插件。这是 Google 发布的一套 NCCL 插件,用于在 Google 的 RoCE 网络上提升性能。从 26.07 版本起,gIB 已内置到 NGC PyTorch 镜像中,因此 Google 的客户默认就能获得这套定制栈。安装 gIB 后,我们得到了更好的图表,16 节点 all-to-all 的峰值吞吐量提高了 4.4%。(注意,这些测试都在关闭多节点 NVLink 互联的情况下进行,以便单独测量横向扩展网络的性能,此处即 RoCE。)
虽然还不算完美,但看起来好多了,核心指标也很扎实。到这一步已经很清楚:网络互联(fabric)状态健康,配置也足够好。想要进一步压榨系统性能的工程师,可以以此作为一个可靠的基线起点。
这是 Nvidia 和 Google 做出的了不起的工作:为 Google 的 ConnectX-7/8 NCCL 插件实现了自动激活。以前,用户需要费心配置正确的库加载路径和环境变量,才能正确启用它并在 GCP 的 Nvidia GPU 机器上针对 ConnectX 网卡优化性能。我们在几个季度前给出了反馈,现在它已经完全自动化了!
Source: Nvidia
GKE 的健康检查表现良好。与其他有 NVL72 系统经验的云厂商一样,Google 的健康检查会进行干预,但将故障节点的恢复工作留给运维人员自行处理。具体来说,在我们注入 XID 之后,健康检查将节点标记为 `GPUUnhealthy=True` 和 `cloud.google.com/health-check-status=warning`,但节点仍保持可调度状态。这种配置使用起来很简单,也是 GCP 客户偏好的默认行为,同时还可以按用户的喜好进行配置,以响应不同严重程度的错误。
为了持续改进,GCP 可以借鉴 Nebius 和 CoreWeave 近期做出的那些提升使用体验的改动。它应该推出一个更好用、更易导航的控制台,简化 IAM 和 RBAC,并确保集群访问毫无障碍——无论是通过标准 SSH、`kubectl`,还是让其现有 CLI 变得坚不可摧。尤其是现在 gIB 已经内置在默认的 Nvidia 镜像中,我们希望 GCP 的运维人员能够轻松地从他们的 GCP 扩展集群中获得良好性能。他们还可以继续争取中型市场的 neolabs 客户,改善上手支持体验,并加强与 Nvidia 的合作关系。GCP 一直在把大量业务拱手让给规模更小、能力更弱的 neocloud,原因要么是 GCP 缺乏 GPU 算力,要么是它拒绝以某个价位服务这个市场。
我们期待在 GCP 的 VR NVL72 系统上市后对其进行测试,也期待 GCP 在易用性和性能方面的持续改进。
Oracle
正如我们在 ClusterMAX 2.0 中提到的,Oracle 在超大规模云厂商中的处境很独特:它的增长必须来自大额合同。与 AWS、Google 和 Azure 不同,Oracle 没有任何出售前沿模型 token 的协议;与 Meta 和 Google 不同,它也没有一个可以倚仗的非前沿实验室。相反,它不断签署涉及 OpenAI、Meta 和 Nvidia 的巨额交易,并报告在 6 月至 8 月间“交付了 850MW 的额外数据中心容量”,这个数字令人瞠目。我们预测,到 2027 年,它在超大规模云厂商中的相对增长率将是最高的,尽管基数最小。
我们测试了两个 Oracle 集群,下面将依次介绍。第一个是基于 Slurm 的 GB300 NVL72 集群,采用多平面网络。这是原生 Slurm,但由于客户需求,Oracle 已将 Slurm-on-OKE 列入路线图。分配到位后,我们尝试通过控制台熟悉环境,但事实证明,和所有超大规模云厂商的控制台一样,那里让人望而生畏。
重要的是,Oracle 的控制台不支持 RBAC——控制台上的任何内容都与 SSH 用户无关——因此我们所有的 SSH 密钥都必须在机器上管理。有一次,我们的实习生在向 `authorized_keys` 追加内容时忘记了 `-a` 参数,把我们之前所有的密钥都删掉了。这显然是典型的用户失误,但也恰恰说明了为什么我们更希望控制台上有一条加固过的路径。当一个小错误就可能把我们锁在集群之外时,我们宁愿不信任我们的实习生——尤其是那位,无意冒犯——让他们在命令行里输入那些“魔法咒语”。所幸 Oracle 的工程师立即发现了这个错误并帮我们修复了。
我们希望他们能修复这个问题,并添加企业级的 RBAC。
不出所料,Oracle 的集群从第一天起就表现良好。他们为我们提供了 InfiniBand 和 NCCL 测试脚本,这很有帮助,因为原版脚本无法正确使用全部 4 条链路(rail)。烤机测试毫无瑕疵,Oracle 托管的 Lustre 也展现出强劲的吞吐量。Oracle 的健康检查按预期工作:在我们的合成错误上成功将节点排空(drain),但把是否终止并更换 GB300 节点的决定权留给用户。Oracle 托管的 Prometheus 和 Grafana 表现不错,但并非完美。例如,它们尚未与面向终端用户的作业计费体验集成。不过好的一面是,健康指标现已集成到控制台中的 Cluster Manager,让人可以更轻松地一目了然地掌握关键状态。
接下来,我们用 MI355X 测试了 OKE。除了 TensorWave 之外,Oracle 是唯一一家让我们试驾 AMD GPU 的提供商。不过这段旅程颇为坎坷。
正如我们上次抱怨的那样,起初我们需要 SSH 登录到运维节点(operator node)来操控 Kubernetes。而这一次,团队迅速解决了我们的 Oracle CLI 问题,我们很快就能在本地下载凭证。不过,这个集群上更大的问题出在网卡(NIC)上。峰值性能接近线速,所以硬件本身没有我们能够检测出的问题。问题其实出在 ionic 驱动上。我们对全部八块网卡逐条链路进行 `ib_write`/`ib_read` 扫描测试时,每条链路都达到了 391 Gb/s,但测试一结束节点就卡死了:当 pod 被删除时,perftest 进程始终无法完成 `rdma_cm` 的拆卸(teardown),强制 `kill` 导致网卡的 destroy-CQ 命令超时,`ionic_0` 和 `ionic_4` 上的 RDMA 管理队列也随之失效。更糟的是,两个端口仍显示 400 Gb/s 的 `ACTIVE` 状态,节点也保持 `Ready`。被动检查没有检测 RDMA 控制路径,而主动检查已经八天没有运行过了。我们是在 RCRL 持续失败后通过 grep `dmesg` 才发现这个问题的。Oracle 在一个周末迅速诊断并重启了节点:他们自己的 `ibwrite` 健康检查几天前在同一集群上也以同样方式失败过。在一次通话中,我们解释了这种病态(pathological)工作负载,随后他们与 AMD 沟通,并向集群推送了不同的驱动和固件,问题就此解决。
另外,我们还有一块 GPU 间歇性地从 PCIe 总线上掉线,健康检查没有捕捉到,仪表盘上也没有正确显示。Oracle 迅速更换了节点,并针对我们对仪表盘的反馈作出了回应。
这次的事件喜忧参半,但 Oracle 的响应速度值得肯定。尤其令人不满的是,尽管这些驱动程序出了名地不稳定,却没有任何健康检查发出告警。不过,Oracle 与 AMD 的密切关系显然是一笔资产。他们能够直接与相关团队沟通、诊断问题,并迅速部署了补丁。在 Oracle 这种规模的组织中,这种级别的支持并非理所当然。有趣的是,Oracle 是唯一一家评级 Silver 或以上的厂商,也是仅有的两家评级 Bronze 或以上的厂商之一,其安装的库中没有任何可适用的 CVE。对我们而言,这更多是一种基本要求而非加分项,但它清楚地证明了他们的自动化系统在集群部署和升级方面确实有效。
如果我们是一家新兴实验室(neolab),那么经过这次测试,我们会对接入 Oracle 充满信心。然而,鉴于 Oracle 日益致力于为 OpenAI 等前沿实验室提供裸金属部署(如 Project Stargate),这一点已无关紧要。在那项业务中,成功与否更多取决于天然气管道建设能否获得政府批准,而不是 RCCL 测试的成绩。
尽管如此,自上次测试以来 Oracle 确实有所进步,整体体验非常好。我们期待今后继续关注他们的表现。
Silver(银级)
Lambda
Lambda 最近一次登上新闻,是因为参与了 Anthropic 350 亿美元的交易,将与 Hut8 和 Nvidia 一起在 Nueces County 提供 350 MW 的算力。在此之前,有传闻称他们正在为 2027 年 IPO 做准备,并且分别为其基础设施建设筹集了 10 亿美元、9.26 亿美元和 10 亿美元的债务资金。在如此快速的扩张之中,鉴于我们在 ClusterMAX 2.0 中将他们评为 Silver,我们这次很有兴趣对 Lambda 的集群进行评估。
接入流程从一份精美的演示文稿和 PDF 开始,其中说明了集群上的预期情况,访问权限也很快得到了解决。
我们在 ClusterMAX 2.0 中曾批评过 Lambda 的可靠性;而在本轮测试中,这恰恰是 Lambda 的重点改进方向之一。他们的被动健康检查覆盖了相关故障状态,并最终自动修复了我们在测试中模拟的三项错误。两个合成的 XID 在 15 分钟内被自动修复,并且有配套的仪表盘用于监控节点健康状况。我们通过触发 PCIe 二级总线复位(secondary bus reset)引发了一个真实的 XID 79,使节点进入 NotReady 状态,此时没有 GpuXid、没有 cordon,Kubernetes 层面也没有监控可见性,但该节点最终在 2 小时后重新加入了集群。我们在 Kubernetes 层进行的节点重启测试也顺利完成,没有出现任何问题。
编排层有了显著改进,不过仍存在一些问题。Slurm 配置中没有设置每个任务的 CPU 数量,因此 Slurm 按默认分配只给一个逻辑核心,除非启动时明确请求更多。Slurm 上没有启用免密 sudo,因为我们使用的是托管式 Slurm 而非非托管式 Slurm。Lambda 是我们遇到过的唯一一家做出这种区分的供应商,但显然他们的某些客户想要自己集群的 root 权限,而另一些客户不想要(?)。我们很享受在自己的集群上拥有 root 权限。
另一个缺失的功能是在没有分配资源的情况下通过 SSH 登录计算节点。这在调试时会带来麻烦:比如别人正在运行作业而你无法接入他们的分配,或者某个作业卡住了。这也是我们喜欢在集群上开启「yolo 模式」的又一个原因。
更重要的是,Slurm 上的软件已经过时,包括默认位置 /usr/bin/nvcc 中的 CUDA Toolkit 12.0(它太旧了,与 B300 的 SM100 架构不兼容),以及老旧得令人无法接受的驱动程序。好的一面是,Slurm 确实配置了拓扑设置,而且他们提供给我们的 NCCL 配置方案运行良好。测试期间我们没有遇到真正的错误,所有测试(包括压力测试和存储测试)都表现出良好的性能。
在如今算力预订排队数月的时代,我们对 Lambda「一键集群」(1-Click Clusters)的关注显得有些古雅。事实上,正如开篇所提到的,Lambda 越来越多地通过裸金属建设来驱动其营收,与管理集群业务渐行渐远。尽管如此,Lambda 的编排能力仍在持续进步,客户也很满意,这使他们在 ClusterMAX 3.0 中跻身前列。
Microsoft
使用 Azure 集群可能非常困难,原因在于 Microsoft 的官僚作风。他们的工程师已经尽了最大努力,但这并不是一个为灵活满足客户需求而设立的组织。在体验偏好方面,Microsoft 并没有把客户放在第一位。
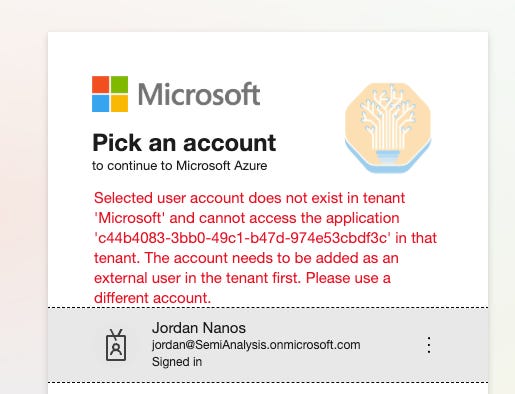
测试期间,我们不被允许拥有自己的 Azure 账户,只能使用某位 Azure 工程师名下的用户来操作集群,这使我们无法在控制台中四处查看,也无法体验真实的上手流程。我们的 GPU 本应部署在弗吉尼亚州,但由于某道晦涩的内部指令,我们被禁止在那里部署控制平面。于是,控制平面只能运行在得克萨斯州的圣安东尼奥。访问需要搭建 VPN,在来回折腾了一阵(真的花了 3 周)之后总算搞定。堡垒机上禁用了粘贴功能,所以为了运行测试,我们不得不手动输入 GitHub 和 HuggingFace 的令牌。没错,真的是一个字符一个字符地敲进去。不过我们第一次就敲对了,没什么大不了的 😮💨。
当一切终于跑起来之后,我们发现有一些软件包已经过时,而且 NCCL 的默认配置有问题,导致我们的首次运行无法完成。在 AKS 上,`managed-csi-premium-v2` `StorageClass` 无法挂载,而且在 Azure Files Premium 上以超过 4 个客户端运行 `fio` 时会收到 `EAGAIN` 错误。由于没有并行系统连接到我们的 Slurm 集群,我们其中一个从 NFS 加载 DeepSeek-V4 的测试超时了。
Source: a typical Azure experience
当我们开始进行老化测试(burn-in)时,Slurm 机柜中有 10 个节点出现了真实的硬件故障,导致我们的作业被终止。Microsoft 发现了这些错误,将其追溯到一个不健康的主机,并提交了 Guest Health Report 进行维修。一条 `scontrol` resume 命令让节点恢复了回来,此后我们的 Kubernetes 和 Slurm 机柜都顺利完成了老化测试,没有再出现任何错误。
在我们通过注入一个合成的 XID 来测试 Azure 的健康检查之后,CycleCloud 立即将该节点排空(drain)了,但它并没有恢复或替换这个节点。由于我们拥有整个 GB300 机柜,如上文「Blackwell and Grace Blackwell」一节所述,这样的表现已经可以接受。
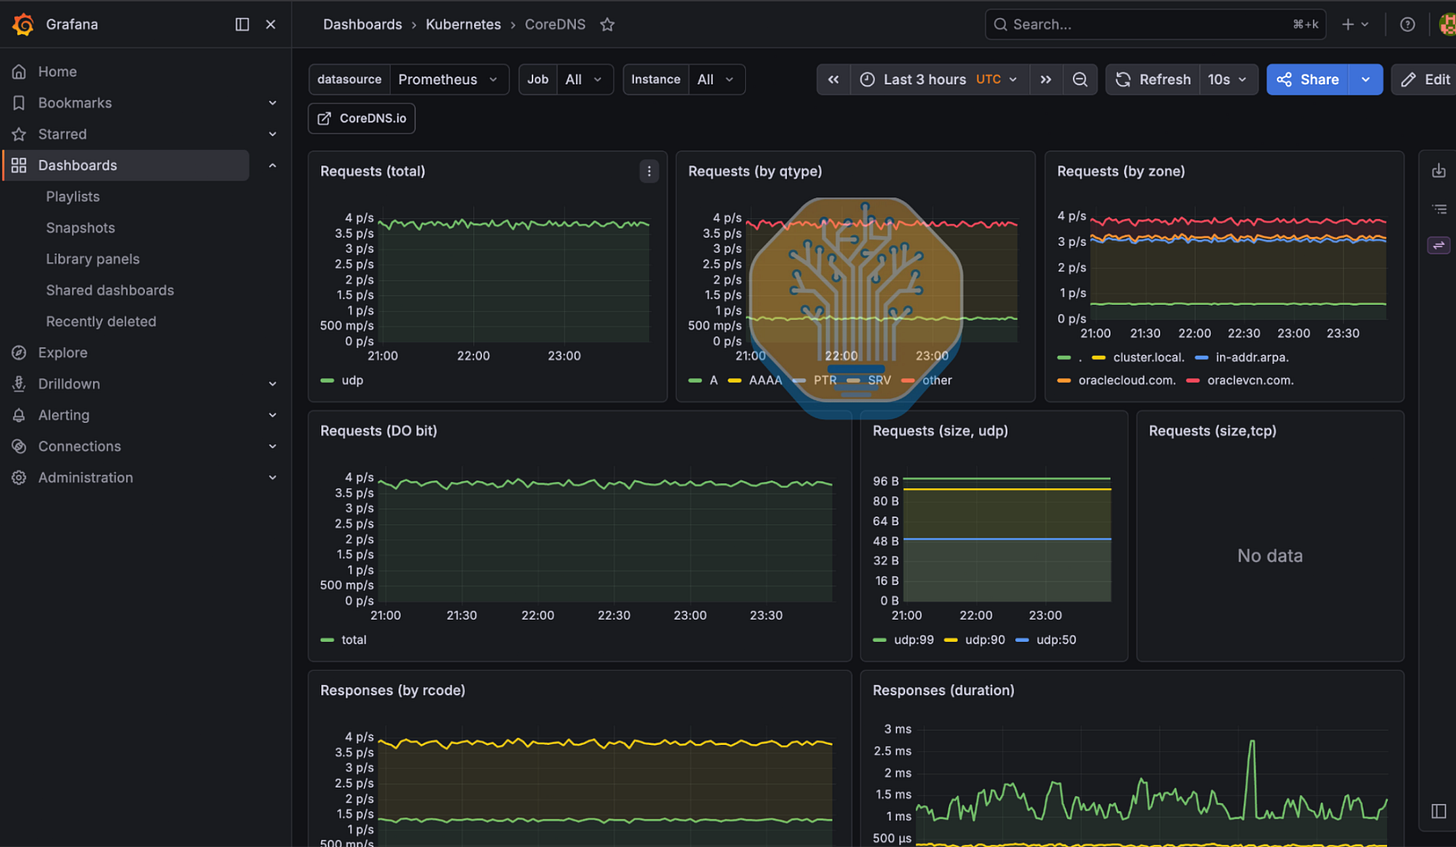
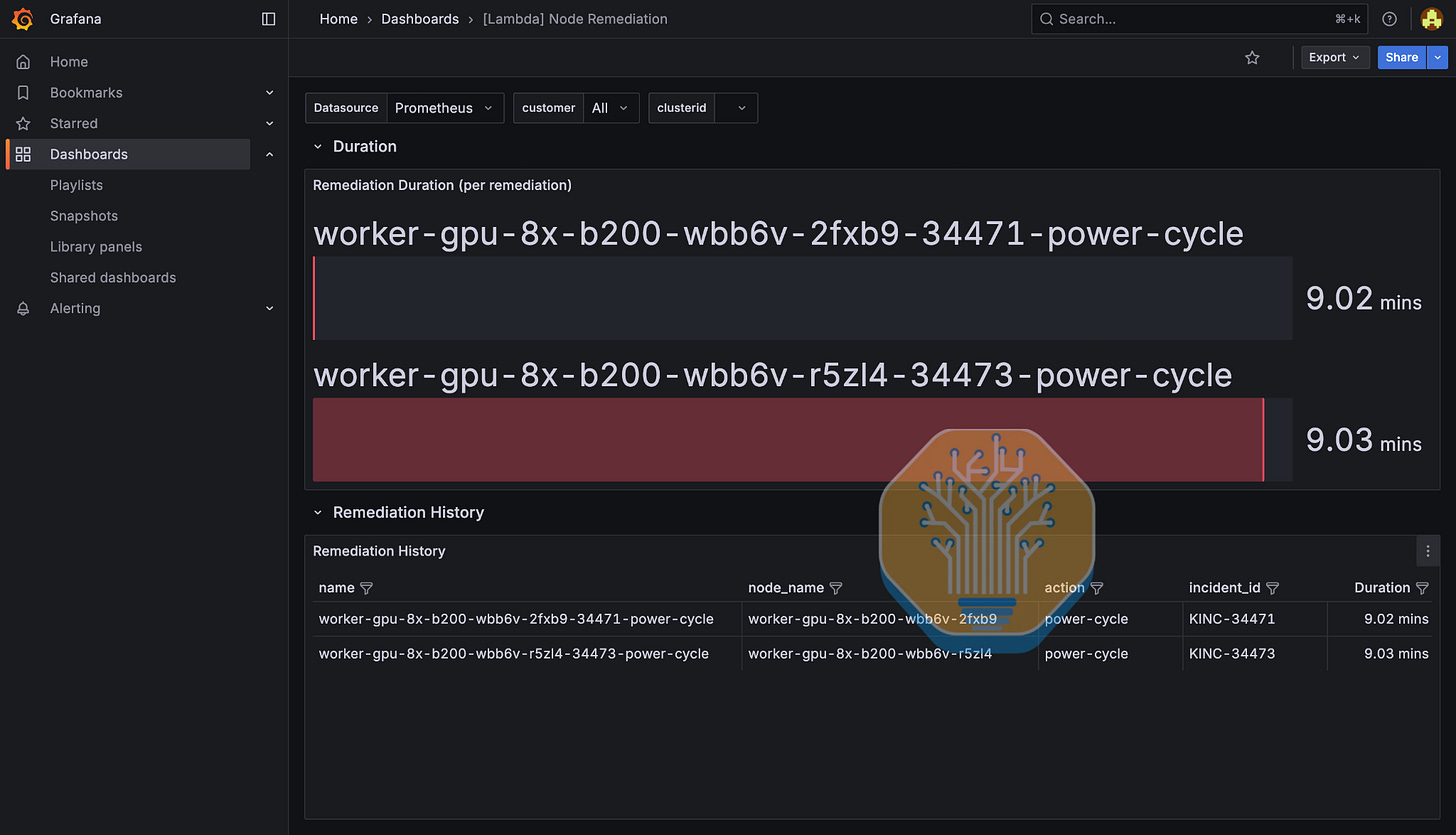
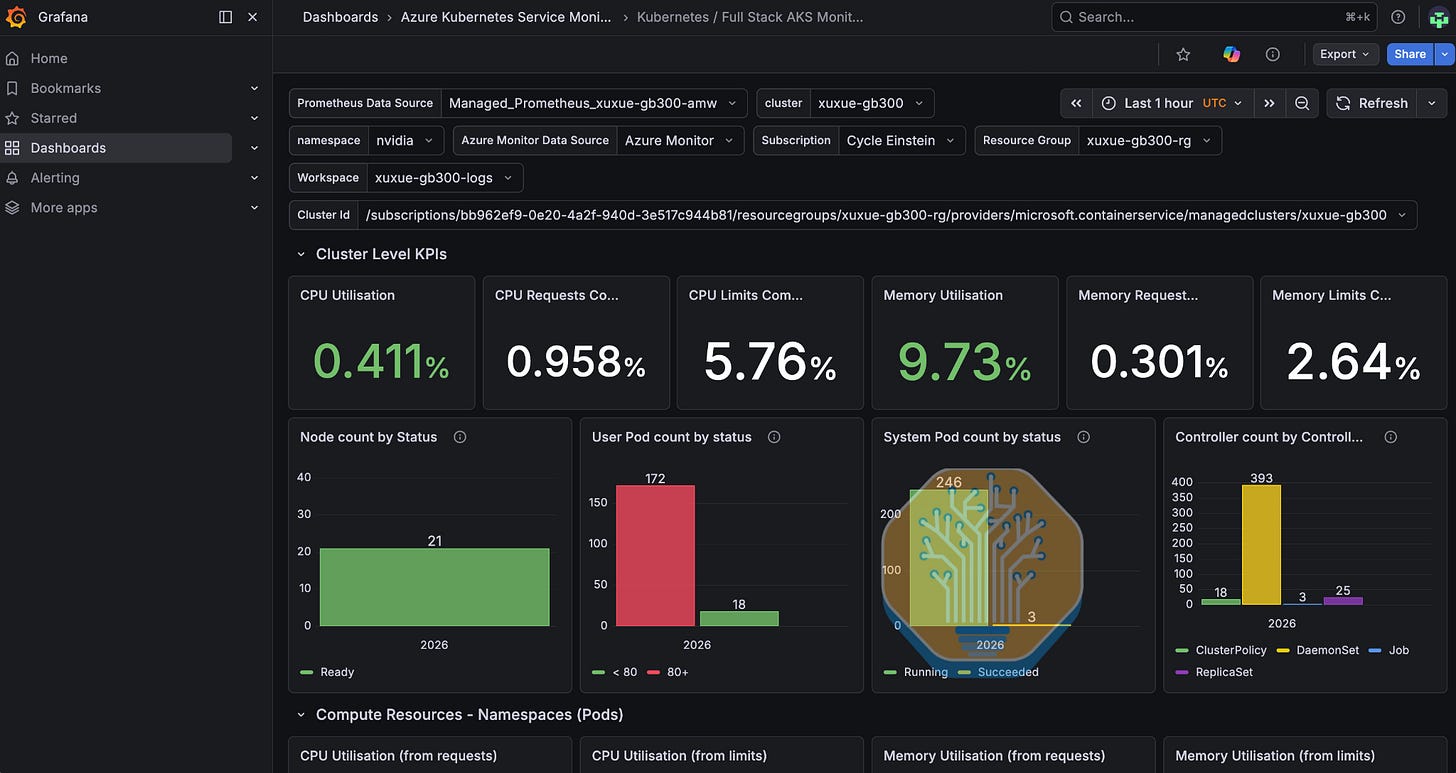
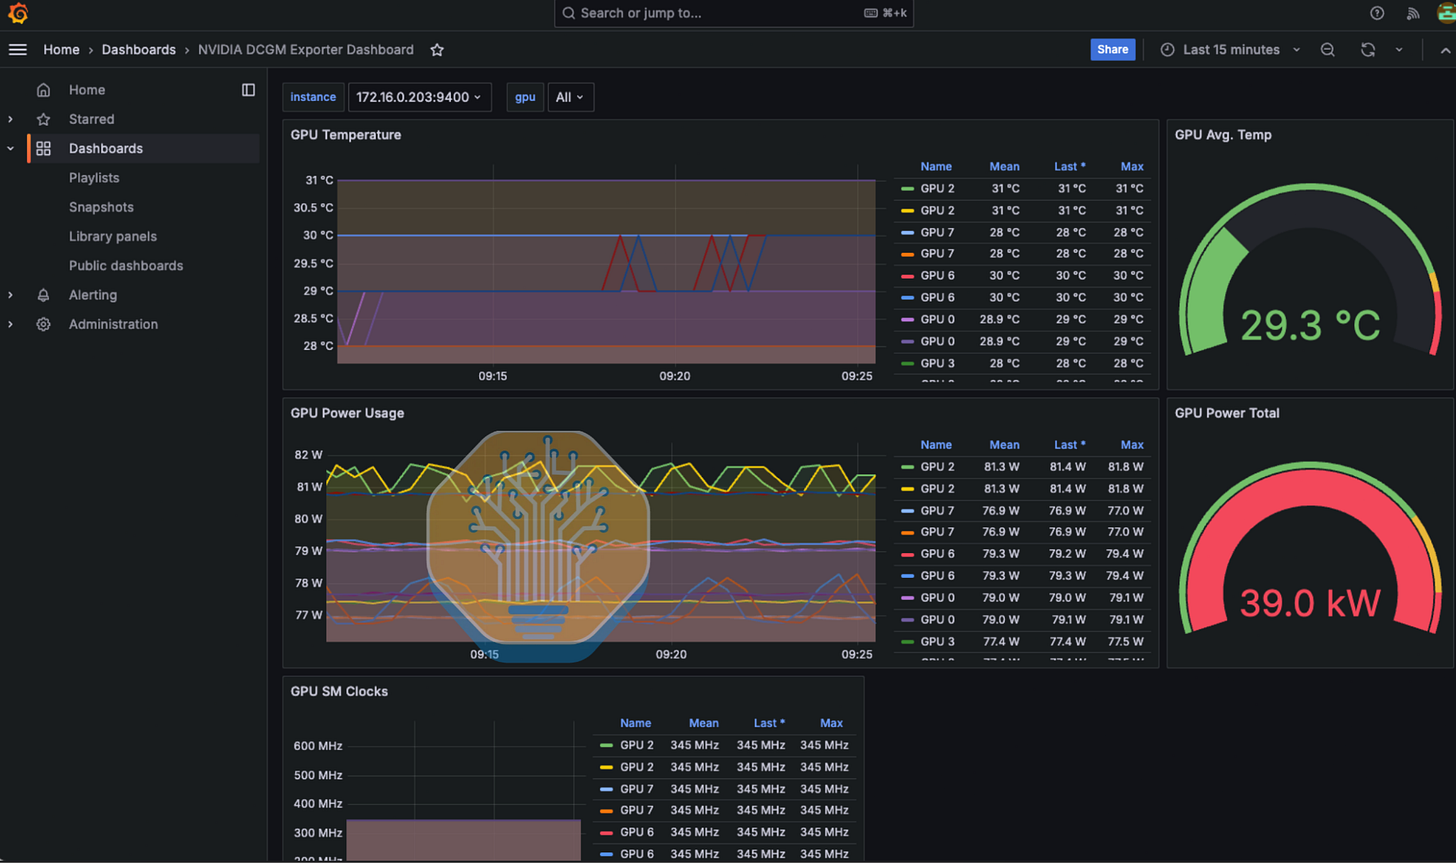
由于账户权限问题,我们默认无法查看自己的 Kubernetes 仪表盘。于是 Azure 的工程团队专门为我们搭建了一套自定义仪表盘,而且细节极其丰富——这是对官僚束缚的一次漂亮胜利。我们要在此特别感谢我们的朋友 Xu Xue,因为我们非常确定,他为了给我们搭建这套仪表盘远远超出了他的职责范围,但他自己绝不会承认。他精心制作的仪表盘已在此开源,对于任何想从零开始搭建 Grafana 仪表盘来监控 Nvidia GPU 集群的人来说,这都是一份极好的资源。
Satya 曾说过,「我们希望把 Azure 打造成对长尾工作负载极其出色的平台」,并且 Microsoft「不是那种只跟五个客户签五份裸金属服务合同的公司」。然而,你几乎找不到一家由 VC 支持的实验室在使用 Azure 进行训练和推理。「五个裸金属服务客户」其实是说多了。实际上只有两个:OpenAI 和 MAI。随着 Anthropic 开始多元化布局,很快就会变成三个。
Azure 最有趣的资产在于,它可以对外提供 OpenAI 的模型,并保留 100% 的收入。他们仍然拥有对 OpenAI 全部 IP 的完整访问权。与此同时,Azure 还可以单独炫耀它与 OpenAI 签订的大型裸金属协议,以及与 Anthropic 日益丰厚的关系。这是一个极其强势的处境。要不是那次「暂停」就好了。
由于 Azure 主要是在另一个层面上竞争——拥有超大规模的部署和数千亿美元的资本开支,它管理集群的能力只会让它更加灵活。与 Google 和 Oracle 一样,Azure 的现金流来自那些不需要别人帮忙搭建 `ComputeDomain` 的承购方。但从我们的测试质量来看,这三家依然可以与那些想要更高服务体验的实验室签下规模更小、利润率更高的合同。
不过,这种情况短期内似乎不太可能发生。即使 Azure 是唯一一家能让你在横向扩展网络中部署 Nvidia 参考架构的超大规模云厂商,其技术支持和控制台依然让人头疼。无论如何,我们很乐意验证这些超大规模厂商的应变能力是否足够敏捷。
Firmus
Firmus 是 Nvidia 最青睐的新锐厂商之一,也是我们在亚太地区的最爱。今年 8 月,Firmus 宣布完成一轮 20 亿美元的融资,投后估值为 105 亿美元,用于在澳大利亚、马来西亚和印度尼西亚扩张。而这距离上一轮 5.05 亿美元、估值 55 亿美元的融资仅过去 4 个月。今年 3 月,Firmus 还为其在墨尔本和塔斯马尼亚的 Project Southgate 建设项目筹集了 100 亿美元的债务融资。就在上周,该公司披露了总计 900 MW 的已签约容量,并宣布 OpenAI 成为其马来西亚扩张项目的锚定租户。总体来看,Firmus 目前已披露在部署中的 GPU 有 18,400 块 GB300,年底前还将在塔斯马尼亚再部署 36,800 块,此外还有多个 GW 级项目和数以万计的 VR 处于规划中。
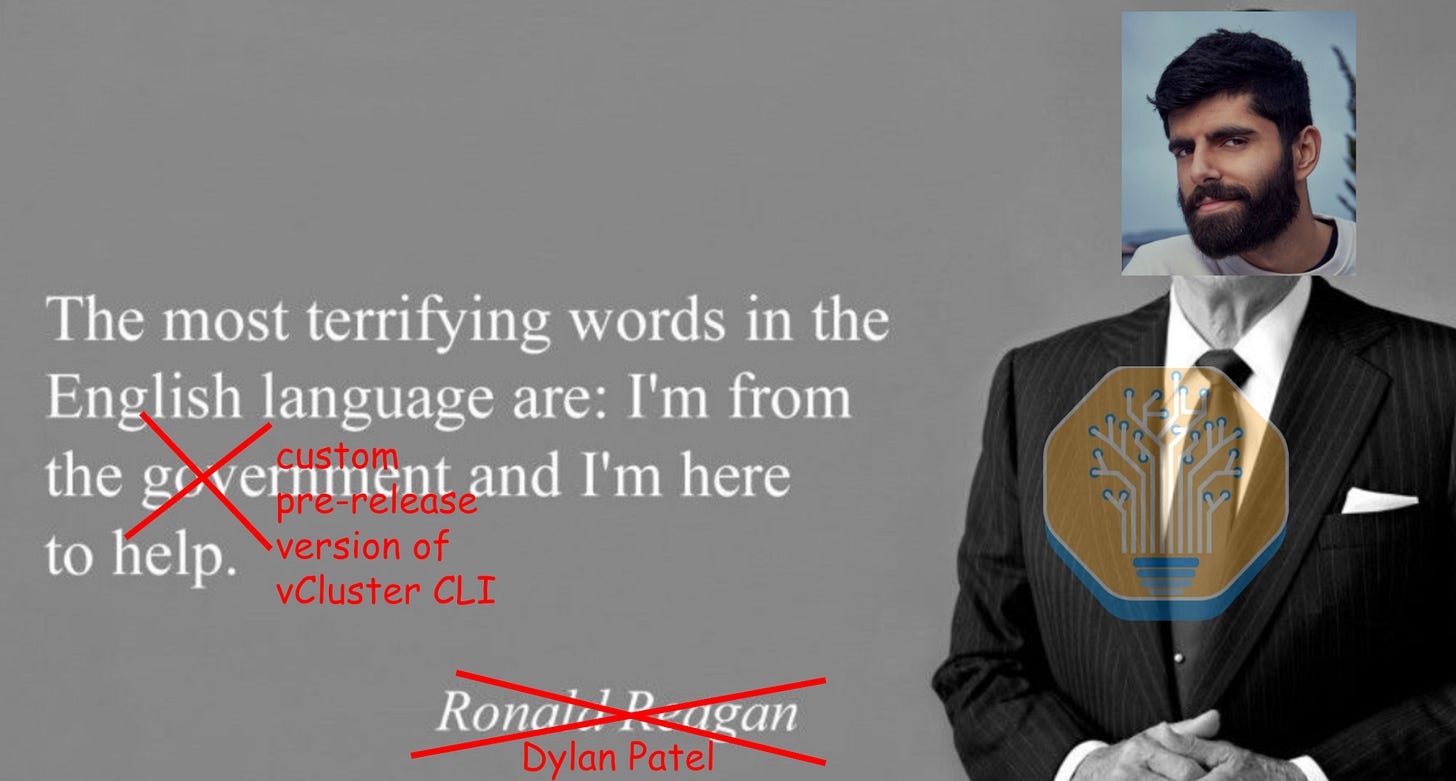
我们在测试 Firmus 的一个开发集群时,起飞过程有些颠簸,但着陆还算平稳。要访问我们的芯片,需要使用 Microsoft Entra 账号进行 Microsoft SSO 登录,然后下载并配置一个预发布版本的自定义 vCluster CLI。我们对新技术向来没有抵抗力,但在集群访问这件事上,我们更愿意直接用 SSH。经过几轮来回沟通,在 Firmus 团队的帮助下,我们终于成功登录了。
登上了集群,但离顺利开跑还有一段距离。Kubernetes 和 Slinky 上的默认配置都有很多不足之处。Slurm 登录节点上没有 `sudo`,没有 `vim` 或 `nano`,装了 HPC-X 但不在 `PATH` 里,也没有 NVCC。更重要的是,我们本应在一台机柜上获得 4 个 Slurm 节点、在另一台上获得 4 个 Kubernetes 节点,结果却是每台上各有 2 个。这本身未必是问题,但 Kubernetes 配置了 `nvidia.com/gpu.clique` 却没有任何组件消费它,而 Slurm 使用的是 `topology/flat`。这样一来,每个编排器可见的节点都跨越了多台机柜,而且没有任何机制能避免多节点任务不必要地跨越机柜边界。我们只能通过推断节点命名规则来确保测试被合理地放置。
除此之外,在测试期间,Kubernetes 控制面的 `etcd` 可见性多次出现闪烁,导致我们的作业被终止,Slurm 和 Kubernetes 两层均发生了重启。这个问题最终被归因于交换机固件升级中的一个故障,在最后 10 天里没有再复发。我们还曾在一次重启中因为 NIC 楔死(wedge)而丢失了一块网卡,而 Firmus 的健康检查没能发现这个问题,因为在我们测试的开发集群上这些健康检查并未启用。Firmus 是我们接触到的唯一一个将 GPU HBM 暴露为 NUMA 节点的 GB300 集群。这个配置很有意思,但我们将其标记为一项失败,因为如果你在主机内存上发生溢出,就会意外地把设备 HBM 也淹没。WAN 网络表现不稳定,而且往往相当差,到 NGC 只能维持 0.25 Gb/s 的速率。我们遇到的最后一个问题是:其中一个机架的 NVLink 互联网络性能出现了显著下降。这是因为 Firmus 曾在他们的开发集群上试验过的一个电源设置所致;修复该设置后,我们的性能数据回到了健康范围。
因此,到测试结束时,我们拥有了令人满意但配置尚不完善的 Slinky 和 Kubernetes 两层,我们知道如何使用它们,并且能够在整个测试套件中获得强劲的性能。我们理解托管集群目前并非 Firmus 的优先事项,但我们相信,对于他们的技术团队来说,这里有大量唾手可得的改进空间。随着 Firmus 不断将庞大的算力容量上线,我们期待看到他们继续让其 GPU 软件栈的用户过得更轻松。
TensorWave
TensorWave 是一家只提供 AMD 硬件的 neocloud(新型云服务商),我们通过 K8s 和 Slinky 测试了他们的 MI355X 方案。在上次的测评中,我们着重指出了 TensorWave 入驻流程的艰难:仅仅是为了登上集群就需要反复沟通,即便如此仍然会遇到许多磕磕绊绊。这次的改进非常显著。入驻过程很顺畅,直接发送给我们的 `kubeconfig` 完美可用,控制台让我们可以轻松添加具有 SSH 访问权限的团队成员,而且 TensorWave 的支持团队在整个测试过程中都非常尽责。
作为一家纯 AMD 云服务商,TensorWave 正在进行一场艰苦的战斗,需要应对 AMD 的软件栈。尽管 AMD 最近取得了显著进展,但仍然远远落后于 Nvidia。我们在 TensorWave 集群上进行 RCCL 微基准测试时亲眼见证了这一点:即使使用 TensorWave 提供的二进制文件和配置方案,all-gather 和 all-to-all 在 32 KiB 规模下仍然会挂起。其他集合通信操作在某些消息大小下表现出不均衡的扩展性和糟糕的吞吐量。[编者按:RCCL?不如叫 Rick L 算了!] 总体而言,可以说 AMD 的网络技术栈缺乏 Nvidia 工具链所拥有的社区支持。在硬件方面当然也是如此。比微基准测试更重要的是,我们在实践中看到,GB300 NVL72 系统在整个行业中需求最大:其性能如此出众,即使考虑到更高的价格,它们往往也能提供最佳的每美元性能。AMD 的机架级回应——MI455X Helios——仍在产能爬坡阶段,而且 TensorWave 肯定尚未提供该产品。因此,TensorWave 在排名中的位置不仅取决于其自身的内部改进,还取决于 AMD 在缩小与 Nvidia 差距方面的持续努力。
就其宣传的卖点而言,我们的 TensorWave 集群在各方面表现都不错。南北向带宽很强。存储性能非常出色,烤机测试顺利完成,没有出现任何问题。我们在 Kubernetes 层进行各种操作时,其可靠性良好,而且 Slinky 层易于使用。
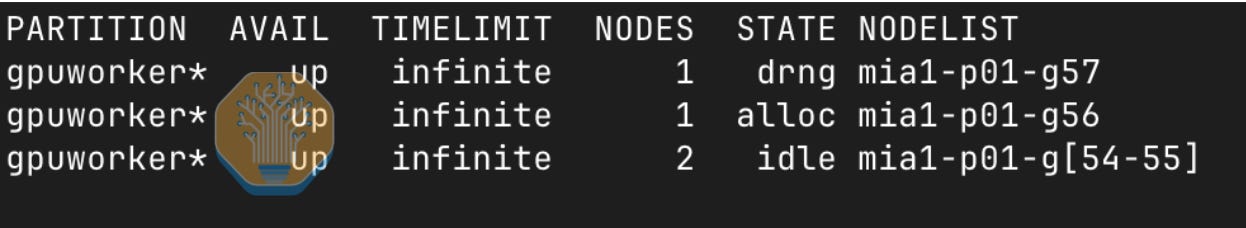
健康检查立即识别出了我们模拟的故障,将该节点置于 `drng` 状态。
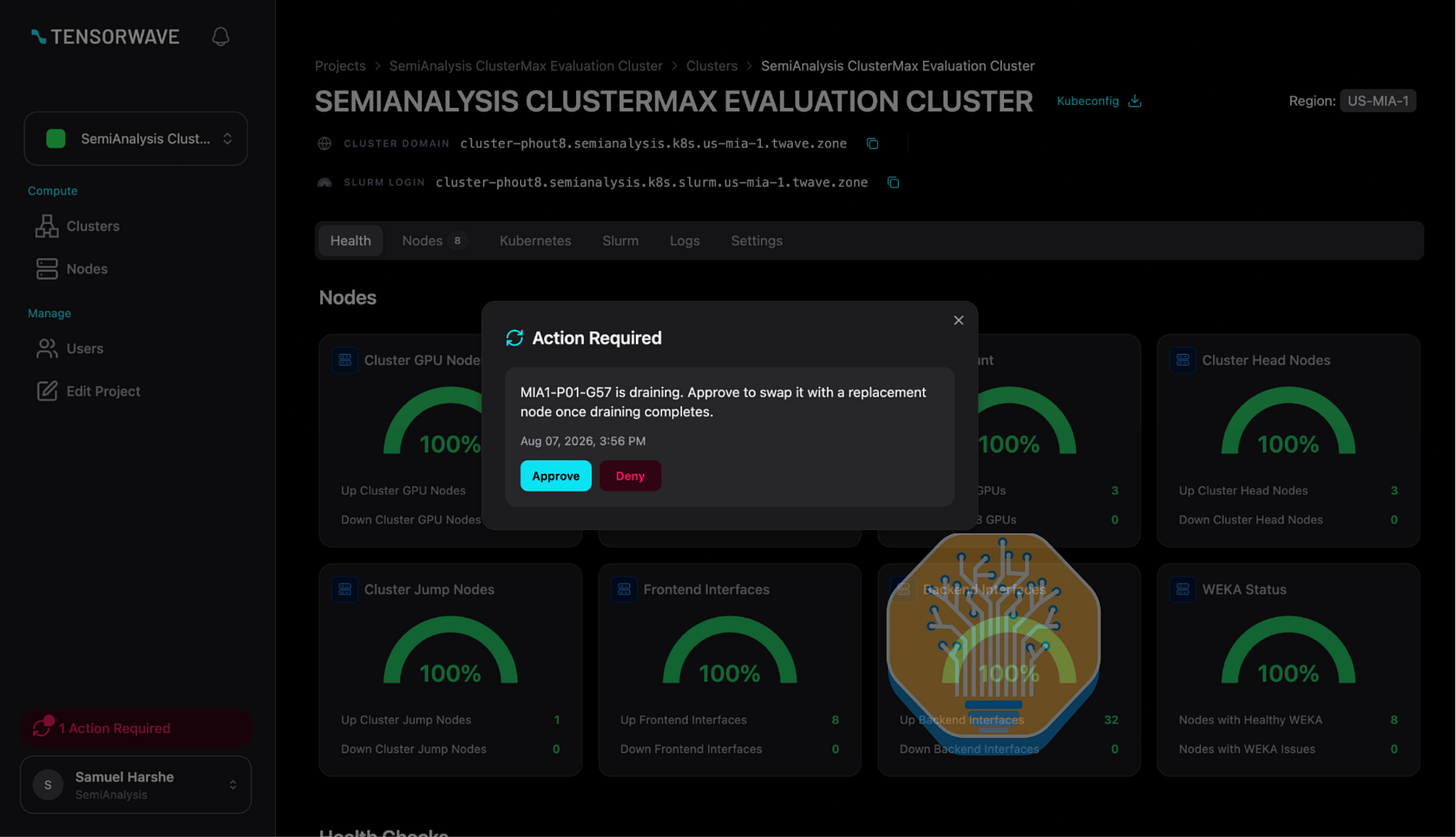
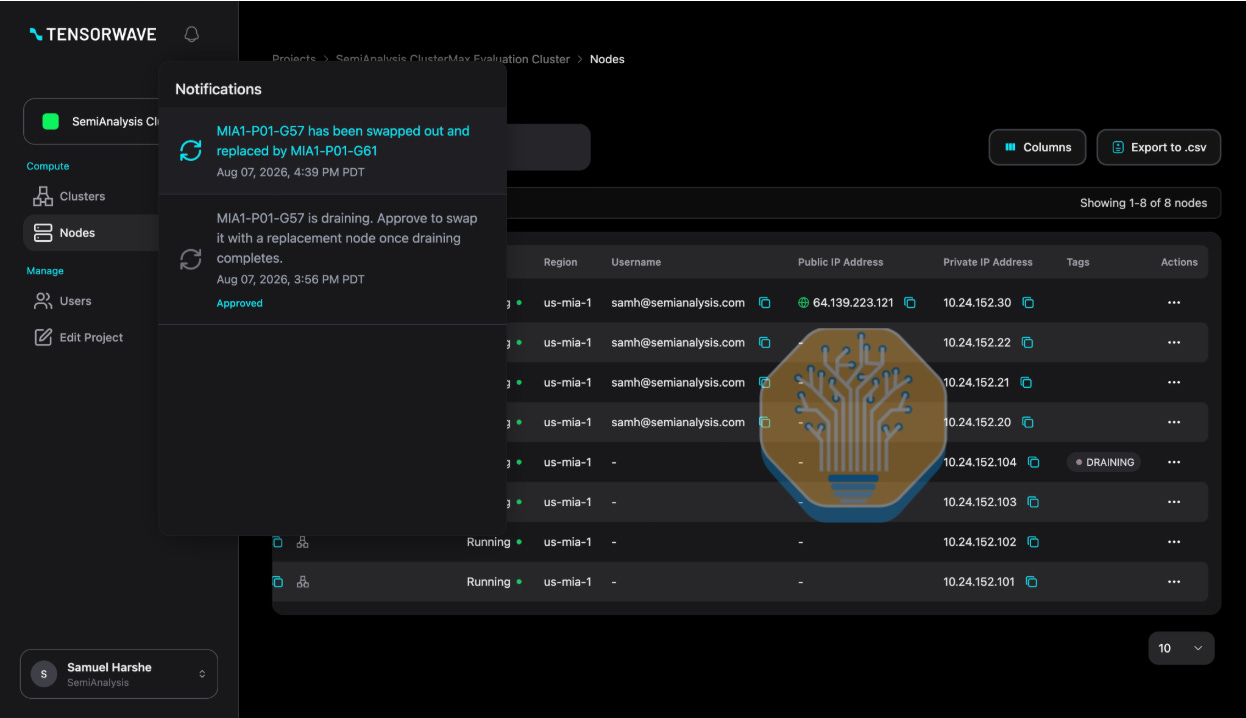
奇怪的是,仪表盘将该节点标记为“已分配”(Allocated),而不是单独归入一个独立类别。不过,没过多久,我们就看到了一个醒目的大按钮,点击即可批准用一个新节点替换我们那个“生病”的节点。
替换过程耗时约 43 分钟。我们希望自动修复默认执行——我们甚至不愿意去点击那个醒目的大按钮——但除此之外,我们认为 TensorWave 的监控和自动修复堪称典范。
总体而言,TensorWave 是领先的纯 AMD 新兴云服务商,在 AMD GPU 上提供与 Oracle 和 Microsoft 等超大规模云厂商相当(有时甚至更好)的体验。而且他们并没有止步于此。TensorWave 已与 Fermi 达成协议,在德克萨斯州锅柄地区获得 222 MW 的电力容量,并拥有最高扩展至 650 MW 的权利,前提是 Fermi 获得项目融资。凭借 6 月份 3.5 亿美元的 B 轮融资(投后估值达 15.5 亿美元),TensorWave 获得了强劲的顺风,目前还在与超大规模云厂商洽谈大额交易。随着 OpenAI 和 Anthropic 都宣布与 AMD 就 MI450 代产品建立战略合作伙伴关系,我们预计 TensorWave 将从中受益,纯 AMD 新兴云服务商或许能够跻身黄金梯队。我们期待在 TensorWave 的 MI455X Helios 上线后对其进行测试。
GMI
GMI 是一家总部位于 Mountain View、根源在中国台湾的新型云服务商(neocloud)。继去年 11 月宣布的 5 亿美元 Nvidia 订单和今年 3 月追加的 120 亿美元订单之后,他们还有数百个 GB300 机架正在交付中,并计划在未来支持 VR,在硬件方面始终走在前沿。最近,他们还通过与小型 neocloud 达成交易来扩大自己的集群规模,再将算力转售给已有的客户群体。这种模式不需要前期资本支出,因而能带来颇具吸引力的现金流。在 ClusterMAX 2.0 中,我们将其评为“顶级 Bronze 级 neocloud”,因此我们有兴趣测试其托管集群的进展。
入驻过程有些波折:从控制台下载的 Kubeconfig 是空的,我们上传的 SSH 密钥也一直没有同步到集群。经过与团队的多番沟通,我们最终成功进入。问题原来在于,出于测试目的,控制台对我们是只读的,因此我们无法验证其功能是否正常。上一轮测试中,我们完全没有获得自助控制台的访问权限,所以这一次算是有所进步。
与上次一样,算力符合规格,压力测试(burn-in)干净无异常,InfiniBand 网络结构也很稳固。自 ClusterMAX 2.0 以来,一个显著的改进是 GMI 的存储。GMI 提供了高性能的 RWX NFS 默认 StorageClass,该存储在 Slurm 层的 /home 目录下也可用。我们在试用 GMI 的 S3 时遇到了困难,最后发现是因为他们文档中有一个拼写错误。待 Brothers Karamazov Karasev 上了通话并修复之后,我们验证了对象存储的性能同样出色。集群配置方面最大的阻碍是:GMI 期望通过 ComputeDomain CRD 在 Kubernetes 集群上配置 IMEX domain。这本身完全可行——许多其他评价很高的提供商也是这么做的——但 GMI 的 Kueue 无法容忍(tolerate)该 claim,导致我们的任务一直处于 Suspended 状态。作为变通方案,我们只能在不包含名为 default 的 LocalQueue 的命名空间中提交任务。我们建议 GMI 在文档中说明 MNNVL 任务需要跳过队列管理,或者更好的做法是,让 GMI 配置其 Kueue 以容忍 DRA 资源 claim。
GMI 的仪表盘在上次测试时还不存在,这次则非常有用,其中包括来自 DCGM 的硬件信息以及 NVLink 和 InfiniBand 的监控数据。
由于缺少备用容量,我们无法完整体验 GMI 的健康检查流程,但能够测试的部分表现良好。节点在 Kubernetes 层被快速隔离(cordon),随后重启并自动解除隔离。在注入一个模拟错误后,Slurm 层也很快将一个节点置为 DRAIN 状态。GMI 在 Slack 中设置了告警,因此我们可以看到他们的系统检测到错误,并且可以在相应的讨论串中与支持团队商讨后续步骤,这非常方便。
我们在 GMI 的体验在所有关键方面都很扎实。随着他们的容量快速提升,我们期待继续对他们进行测试。
Bronze
Amazon Web Services (AWS)
上一次报告中,我们把 AWS 的体验总结为“令人头疼”。这一次,我们不得不拿出 Amazon Basic Care 布洛芬片(退烧止痛药,可缓解身体酸痛、头痛、关节炎疼痛等,棕色瓶装 200 粒),才勉强撑过整个测试过程。
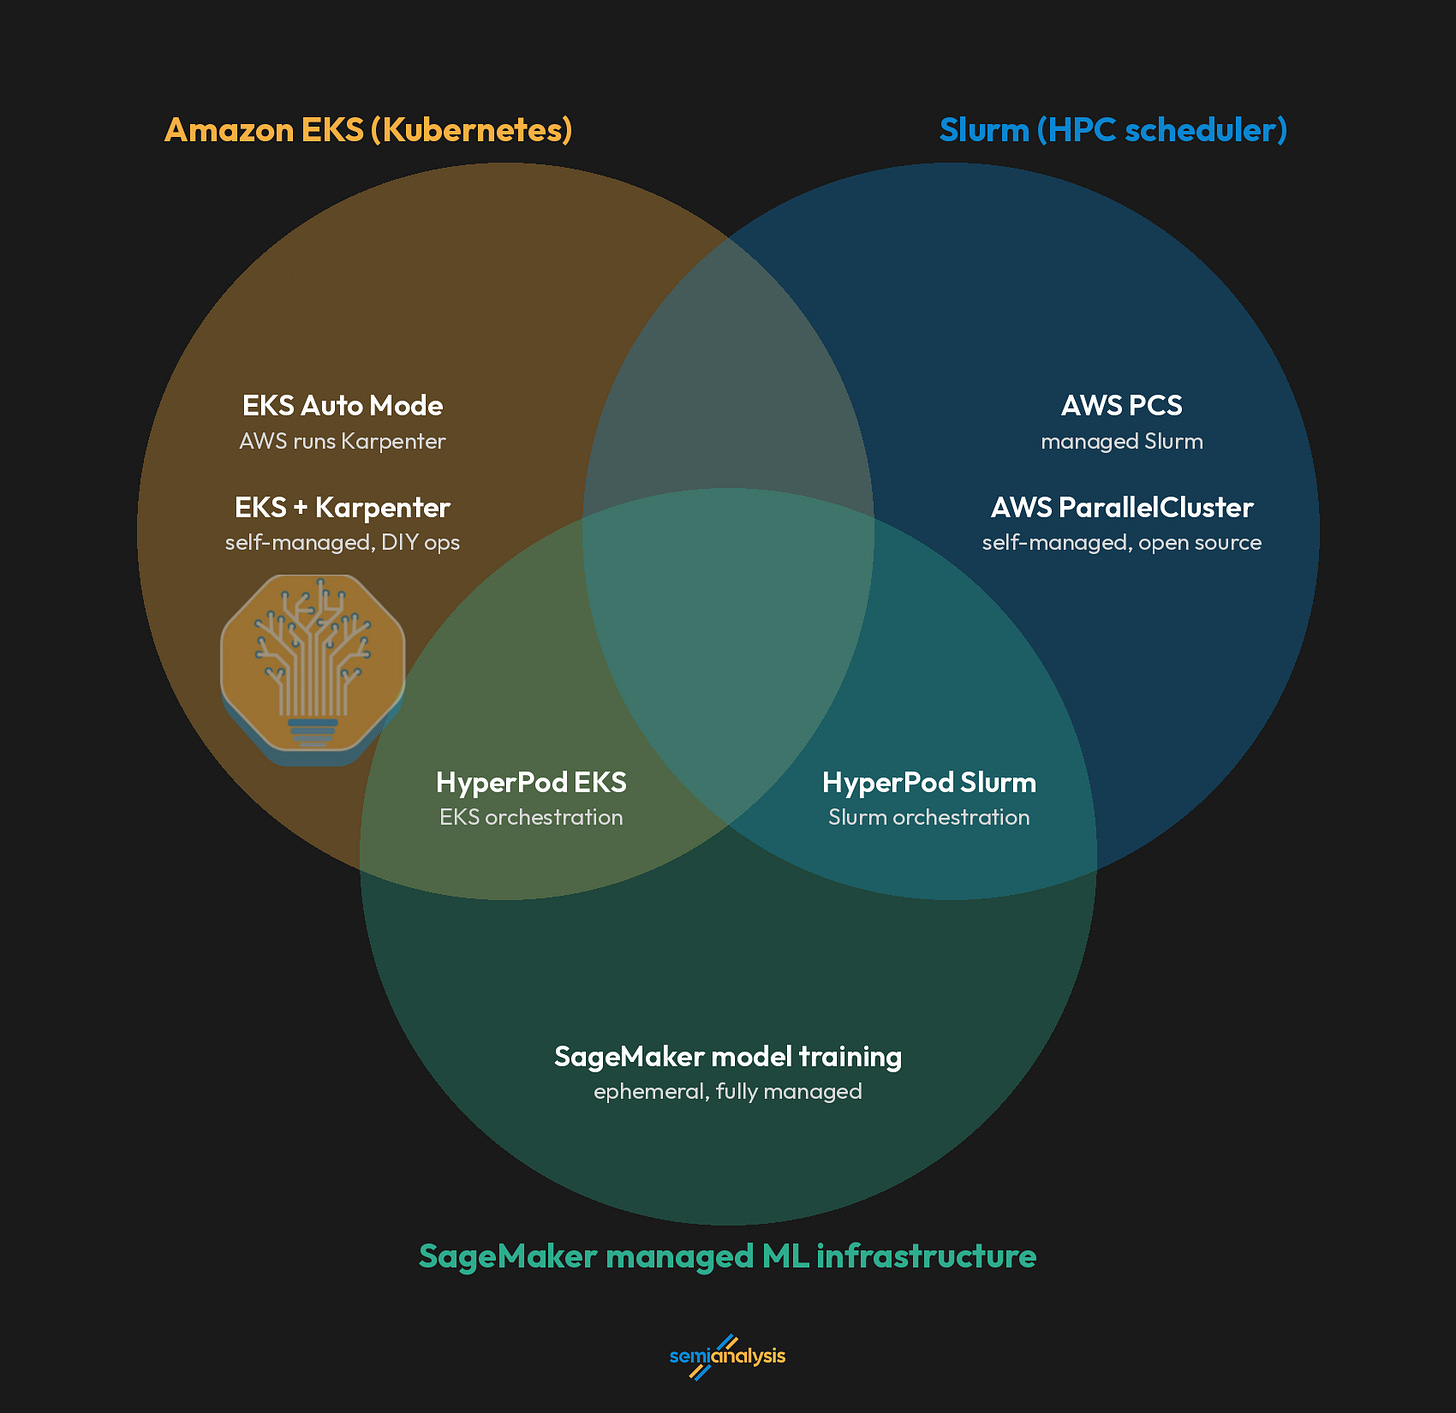
AWS 的难题在你登上集群之前就开始了——确切地说,甚至在你尝试开通集群之前就开始了:它始于你面对 AWS 那座琳琅满目的托管服务“动物园”之时。为了理清这一切,我们不得不画了一张韦恩图:
Source: Intern (I forget his name)
(读者须知:对 AWS GPU 产品细节不感兴趣的读者可以跳过本段。)SageMaker 是 AWS 的全托管平台,主打最低维护成本。如果你完全不想碰任何基础设施,它提供无服务器(serverless)的模型定制和数据科学环境,将底层计算抽象掉了。再往上一个层级是 SageMaker HyperPod 产品线,同时支持 Slurm 和 EKS。HyperPod 提供诸多便利,例如健康检查、自动修复、仪表盘,以及开箱即用的免 checkpoint 训练等工作负载级功能,适合那些希望保留 `ssh` 或 `kubectl` 访问权限的用户。如果你想把基础设施抽象掉,但希望自己掌控 ML 技术栈,可以走出 SageMaker 的保护伞,选择 EKS Auto Mode——它负责节点开通、自动扩缩容、操作系统补丁和节点修复。EKS Auto Mode 是构建在“托管 EC2 实例”之上的一层封装,但这些并非真正意义上的 EC2 实例:它们不会出现在 EC2 控制台里,也不具备普通 EC2 实例那样的可定制性。在 EKS Auto Mode 中,用户无法访问控制平面,而且出于安全原因,必须允许 AWS 每 21 天回收一次他们的 worker 节点。最后,如果需要更高的可定制性,还有 EKS + Karpenter 方案,允许用户使用开源工具 Karpenter 自行管理自动扩缩容。
尽管 Amazon 素有“客户至上(customer-obsessed)”的名声,但显然,这份长篇小说般的 GPU 菜单更像是“你的组织架构就是你的产品(you ship your org chart)”这句格言的写照,而非对真实需求分层的反映。而且,下完集群订单之后,官僚式的挫败感也远未结束。这是对整个组织的批评,而非针对某个具体团队——AWS 颇有几分三世纪罗马帝国的影子。为了在下一轮 ClusterMAX 测试中改善排名,我们建议 AWS 换一个帝国和/或时代作为参照。
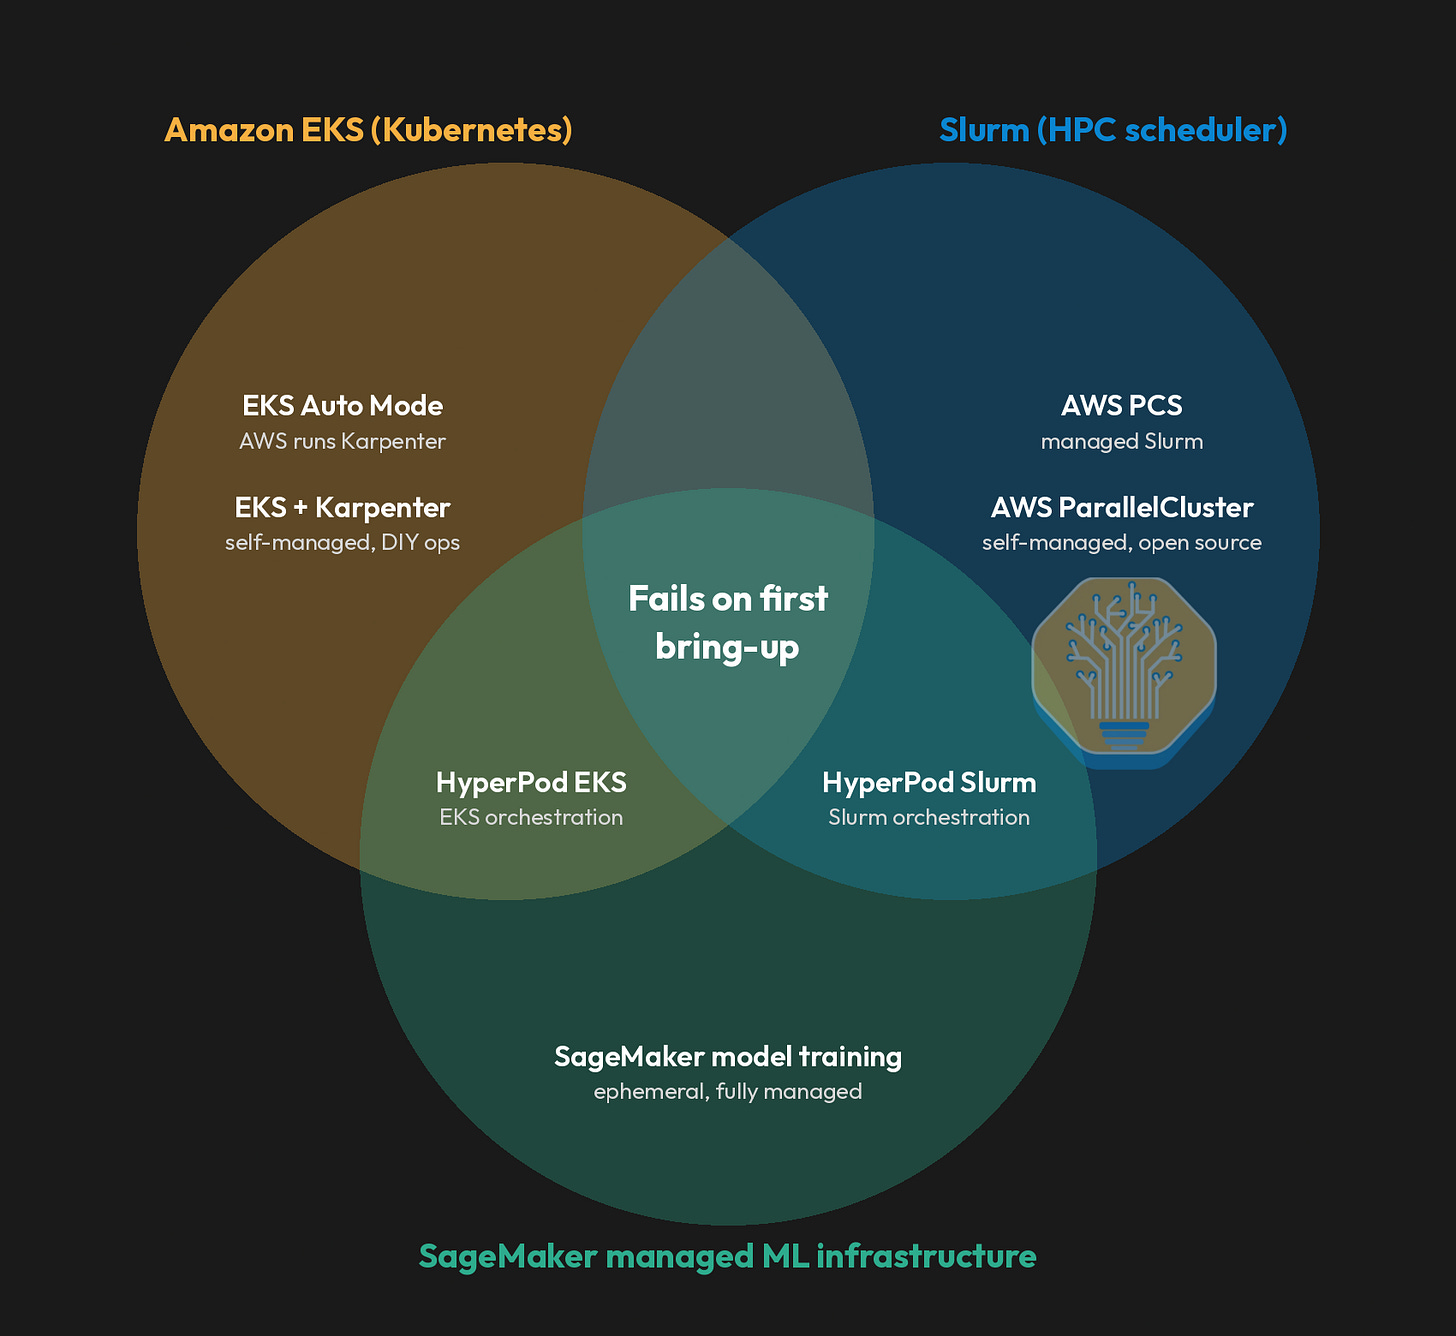
尽管如此,所有这些产品线都有一个共同点:第一次尝试开通时必定失败。于是,我们又画了一张说明情况的韦恩图:
Source: Ibid.
这终于把我们带到了 AWS 的运维体验上。我们在控制台开通的一个 SageMaker 集群因 IAM 权限不足而失败。一些 EKS 集群使用了 Terraform 来简化开通流程,但这条路径并未经过实战检验,而且要求你必须在正确(正在开发中的)仓库的正确分支的正确 commit 上、位于正确的子目录中,还要确切知道该调整哪些配置项,否则就会发出无效请求。有一个集群启动时没有 Lustre,而且无论我们与 AWS 工程师如何反复沟通,都无法挂载任何 Lustre 存储。出于测试目的,我们在一个新区域开通了一个新集群来收集文件系统性能数据,但如果这是一个真实运行中的实验室,这至少会造成临时性的瘫痪。与我们合作的 AWS 团队始终乐于提供帮助,但很明显,他们既没有权限去解决问题,甚至也缺乏对整个系统如何拼装在一起的全局了解,尤其是与我们对标评判的那些层级扁平、反应敏捷的新型云(neocloud)相比。说到底,开通一个 Slurm 集群本不应该需要六位工程师开多次电话会议。
一旦交付完成,就没有任何阻碍我们一开始就获得合理性能的因素了。驱动、固件和大多数工具都是最新的。不过,对于 AWS 这样一家声誉良好的供应商来说,这只是最基本的要求,而且在其他方面粗糙的细节并不少见。
我们所测试的 AWS 集群与其他 B200 集群之间有一个基本的区别:AWS 使用的是其专有的横向扩展网络架构 Elastic Fabric Adapter(EFA)。在我们的测试中,EFA 的峰值吞吐量表现强劲。在 B200 上通过 EFA 进行的四节点 32-GPU 全互联(all-to-all)NCCL 测试中,我们在 16 GiB 消息大小下测得 59.44 GB/s 的总线带宽(busbw)。考虑到需要跨节点传输的流量比例,这大约相当于横向扩展线速的 92%。在其他流量模式和启动机制的网络测试中,只要消息大小足够大,其吞吐量都位居最佳 B200 集群之列。然而,EFA 的延迟始终比调优良好的 InfiniBand 同类方案要差。例如,当消息大小缩小到 64 KiB 时,同样的四节点 32-GPU 全互联 NCCL 测试在 EFA 上耗时 85.26µs,而在 InfiniBand 集群上则不到 50µs。EFA 与 InfiniBand 之间这 30-40% 的差距在小消息测试(此类测试由延迟主导)中始终存在。这看似吹毛求疵,但横向扩展延迟对现代专家并行(expert-parallel)工作负载来说是关键指标,因为这类负载经常需要跨节点发送小的 token 向量。例如,这个 64 KiB NCCL 测试就类似于 Kimi K3 和 DeepSeek V4 这类模型中的专家路由步骤。我们的发现得到了 Perplexity 一篇关于优化 EFA 的优秀技术博客的印证,该博客报告了类似的结果:EFA 的峰值吞吐量令人满意,但在「MoE 分发(dispatch)与合并(combine)过程中交换的消息大小」上,要付出约 20µs 的延迟代价。(注意,Perplexity 的这篇文章是将 EFA 与 ConnectX-7 网卡比较,而我们测试的是 ConnectX-8,但两代产品的标称吞吐量相同。)当 Perplexity 那些顶尖的工程师都在撰写极其详尽的博客文章,讲解如何在你的自定义网络栈上「启用」基本功能时,这可不是什么好兆头。
All-reduce tests on EFA. Note that message size must double many times before time to completion changes much; this is because at small sizes, it is latency, rather than line rate, that defines performance. .
在上游的 vLLM 和 SGLang 中,EFA 用于专家并行推理仍然需要额外的设置。AWS 报告了成功的 vLLM 部署案例,但用户必须安装 EFA 用户态库,并在构建相关通信组件时启用 EFA 支持。根据工作负载的不同,这些组件可能包括 DeepEP、NIXL 或 Mooncake Store。AWS 的 DeepEP 分支通过 NCCL GIN 支持 EFA。DeepEP V2 使用 NCCL GIN,而其基于 NVSHMEM 的 V1 路径现在已被标记为遗留方案。上游集成和默认容器打包仍有待完善。NCCL EP 是另一条正在开发中的路线,其对应的 vLLM 集成仍处于草案 PR 阶段。总体而言,EFA 并非前沿通信库的优先事项,用户往往要等待数周甚至数月才能获得有限的支持。
AWS 是唯一一家在这方面与众不同的云厂商。我们测试的其他所有提供商都使用 InfiniBand 或 RoCE。当然,与 AWS 签有 GW(gigawatt)级协议的客户有足够的资源确保其 EFA 得到良好调优,但我们仍然认为,规模最大的提供商的横向扩展技术栈却独此一家如此麻烦,实在令人遗憾。
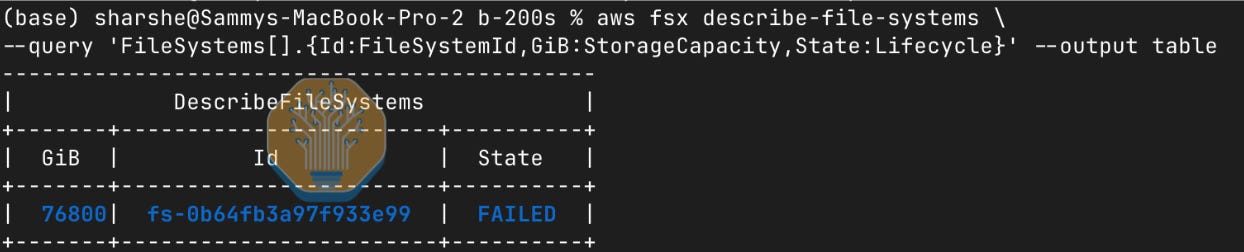
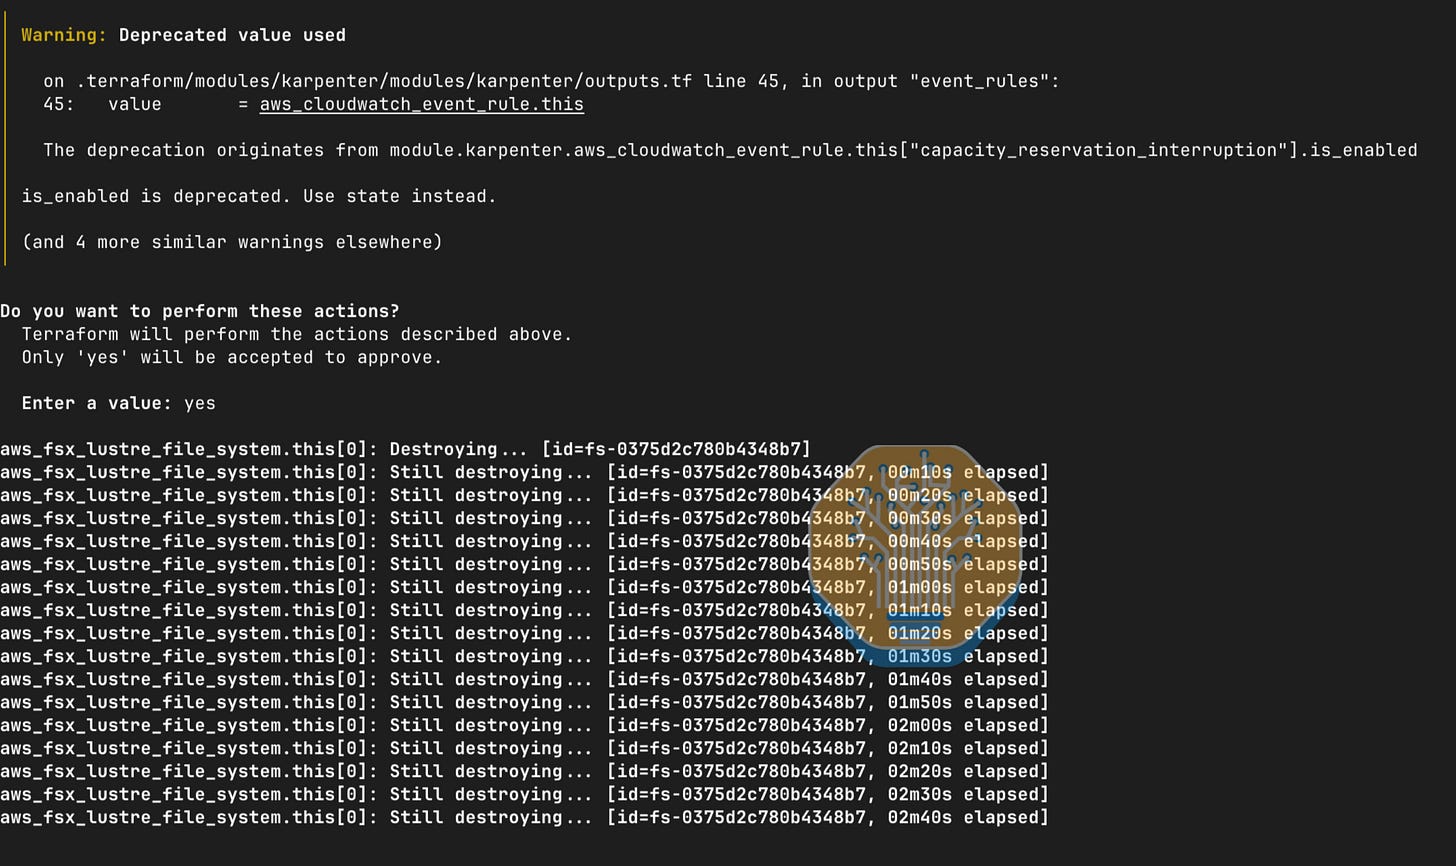
另一个方面,存储同样是一项经常不配合的基础集群服务。我们在 `ap-south-1a` 预配的 B200 集群上,所有存储请求都因一个含糊的 `Insufficient capacity` 错误而失败,而删除这些 `Failed` 状态的文件系统花了 5 小时 46 分 55 秒。
要测试 Lustre 的性能,还需要在另一个区域再建一个集群,这意味着又是一场漫长的启动过程——又是盯着终端屏幕度过的一个晚上,努力分辨 Terraform 到底有没有在推进。
Source: Provisioning purgatory.
通过 Terraform 在 AWS 上申请存储就像带一个蹒跚学步的孩子:你只能在一旁看着,祈祷它破坏完之后会开始创建。而且存储创建好之后,访问起来也未必顺利。在 Kubernetes 层面,有一个集群默认没有提供任何 StorageClass,而它唯一提供的 StorageClass 又因为驱动不对,让我们的 PVC 一直卡在 `Pending` 状态。我们只能自己定义一个使用正确 provisioner 的 StorageClass。
存储通电并接好之后,性能表现喜忧参半。所提供的 FSx 存储栈在普通缓冲 I/O 下表现明显不佳:在 fio 测试中,顺序读 p99 延迟达到了 9.2 秒,而关闭缓冲后同一指标仅为 312 毫秒。开启缓冲时延迟升高是正常现象,但这个差距已经到了病态的程度。
AWS 健康检查的表现同样是喜忧参半。我们的 EKS Auto Mode 集群捕获到了注入的 XID,将节点标记为 `AcceleratedHardwareReady=False`,并在注入后仅 24 分钟就给我们换上了一个全新的健康节点。与此同时,我们的 SageMaker HyperPod Slurm 集群也立即检测到了 XID,将节点置为 `DRAIN` 状态,并完成了大部分重新预配流程——却在最后一步栽了跟头:节点重新加入集群之前需要进行一次深度健康检查,而这个深度健康检查是作为 Slurm 作业提交的,只有等节点重新加入集群后才能被调度。于是运维人员必须手动执行 `scontrol ... State=RESUME` 命令,集群才恢复完全健康。根据我们的反馈,AWS 迅速修复了这个循环依赖问题,随后在单个 H100 节点上的复测无需人工干预即告成功。有进步。
我们 EKS Karpenter 集群的健康检查更是适得其反。`dcgm-server` DaemonSet 不能容忍 ` nvidia.com/gpu:NoSchedule ` 污点,因此它没有被调度到工作节点上,导致监控代理报出 `error connecting to nv-hostengine`,并将 `AcceleratedHardwareReady` 置为 `False`,原因为 `Reason=DCGMError`。随后 Karpenter 将该 `NodeClaim` 标记为待终止,而替换节点又因同样的原因被标记为不健康,系统就这样原地打转,直到我们手动修改 DaemonSet 使其容忍 GPU 污点。当健康检查发现 IMEX 守护进程未被调度时,又出现了另一次过敏反应。IMEX 负责跨节点配置 NVLink 网络,但我们使用的是通过 EFA 通信的普通 B200 节点,因此 IMEX 本来就无事可做:这个守护进程调度失败本应无关紧要。然而,监控日志却输出了自相矛盾的消息
在非 NVLink 多节点系统上忽略 IMEX 健康代码,code=122
将状态发送至 exporter,
Reason=NvidiaFabricError,
Severity=Fatal。如果我们没有手动设置 NodeRepair=false,阻止这种过度热情的垃圾回收机制阻碍我们的工作,这又会把一个健康的节点回收掉。最后,就在我们的测试即将结束时,Karpenter 在 EndDate 前 39 分钟拆除了我们的 B200 集群,强制驱逐了一个正在运行的 4 节点 MPIJob。我们在这里详述这些问题,是因为对于全球最大的云厂商来说,这些 bug 简单得令人难以置信。或许 AWS 生命周期中唯一轻松的部分就是 Karpenter 的扩容和缩容,几分钟内就能完成且毫无错误。但是,GPU 容量必须以大块方式提前很久锁定,因此 Karpenter 快速的自动伸缩其实是个毫无意义的功能。
尽管产品问题重重,但在我们与 AWS 的专家和工程师的交流中,他们聪明且反应迅速。他们热衷于展示自己的改进成果,主动征求对文档的反馈,及时纠正测试中的错误,甚至还构建了一个出色且颇具前瞻性的 MCP server,我们将其技能借鉴到了自己的代码库中。AWS 的问题出在其组织结构上。以 AWS 的资源体量来看,竟然有如此多的基本问题被漏掉,实在令人震惊。
今年 2 月,AWS 宣布将其与 OpenAI 的合作金额扩大 $100B;在 2Q26,其净销售额同比增长 37%;其 Trainium 业务的 ARR 已达 $25B,且同比增速保持在三位数;其对 Anthropic 的投资正以每年数百亿美元的幅度增值;Bedrock 则继续在坚实的收入上赚取坚实的利润。
托管集群并不是 AWS 的优先事项。
Gcore
Gcore 是一家卢森堡系的新型云服务商(neocloud),在一个被称为「欧洲」的模糊区域开展建设,其算力依赖于其他供应商。他们近期没有发布什么高调的公告,不过正在向其 Hopper 机型集群中增添 Blackwell。在 ClusterMAX 2.0 中,我们通过 Soperator 测试了他们的 Kubernetes 和 SonK 产品后,给 Gcore 打了 Silver 评级。这一次,我们只再次测试了 SonK。
我们对 Gcore 能力的了解受限于他们算力资源的不足:大多数供应商都至少为我们提供了 4 个 B300 节点、为期至少一周的使用权限,但 Gcore 资源非常紧张,只能拿出 3 个 H200。尽管如此,在这个集群上仍有很多让我们保持警惕的地方。
我们在 Soperator 层上的测试需要与 Gcore 团队进行多轮来回沟通才能修复一些粗糙的边角问题,但该团队始终表现出乐于助人的态度。当我们第一轮测试的大部分用例因一项错误配置而失败——该配置阻止了非 root 用户运行其工作负载——团队迅速做出响应,确认设置 `kernel.apparmor_restrict_unprivileged_userns=0` 可以解除我们的阻塞。当每个 Slurm worker 都报告 `RealMemory=2048 MiB`(显然是错误地继承了 CPU 配置)时,Gcore 团队再次快速响应,修正了这一糟糕的默认设置。这个问题甚至导致我们无法运行 `nvidia-smi`,我们很高兴看到它很快得到了修复。
在 Soperator 层上进行调试稍微有些困难,因为节点间 SSH 默认被禁用,但团队向我们指出了一个 `soperator-createuser` 便捷脚本,让操作变得更轻松。在我们测试期间,团队还排查了其仪表盘上的一个错误。
在 Kubernetes 层上,没有默认的 StorageClass,因此用户必须显式选择 NFS。Slurm 层上的存储配置正确,采用了 Soperator 易用的默认设置——在 `/` 挂载 NFS——营造出连接到所有节点的单一共享卷的假象。该存储在各类工作负载下表现良好。南北向网络没问题,东西向网络最终也达到了规格要求,但 RDMA 设备的命名不符合标准,且没有 `topology.conf`,因此配置需要额外的步骤。
我们注入的 XID 很快就被捕获并显示在 Grafana 中;有趣的是,该节点在 Slurm 层上进入了 `Down` 状态,但在 Kubernetes 层上却没有任何变化,尽管 XID 是通过 K8s 注入的。我们无法测试自动修复功能,因为 Gcore 没有备用算力。
Gcore 的细心周到以及经过一番调教后能把基本功能做好的 Soperator 产品给我们留下了深刻印象。我们期待测试 Gcore 的 B300/GB300 管理,包括其对 XDR ConnectX-8 网卡的处理,并见证其 Soperator 和 Kubernetes 产品的改进。
GMO
GMO 托管的 Slurm 集群在两个 B300 节点上展现出了强大的网络和存储性能。它的主要短板在于性能分析受限、企业级管控能力有限,以及缺乏自动修复功能。
Slurm 集群交付时已配置好头节点、分区和 topology.conf。驱动程序以及 CUDA/NCCL/HPC-X 模块均为最新版本,且各节点之间保持一致,Pyxis 也可用。集群上手过程很顺畅,不过控制台只有日文界面,我们只能手动 ctrl+c、ctrl+v 去翻译才能看懂。
Source: PoV you are a SemiAnalysis intern who dropped Japanese after two classes trying to locate a Grafana dashboard
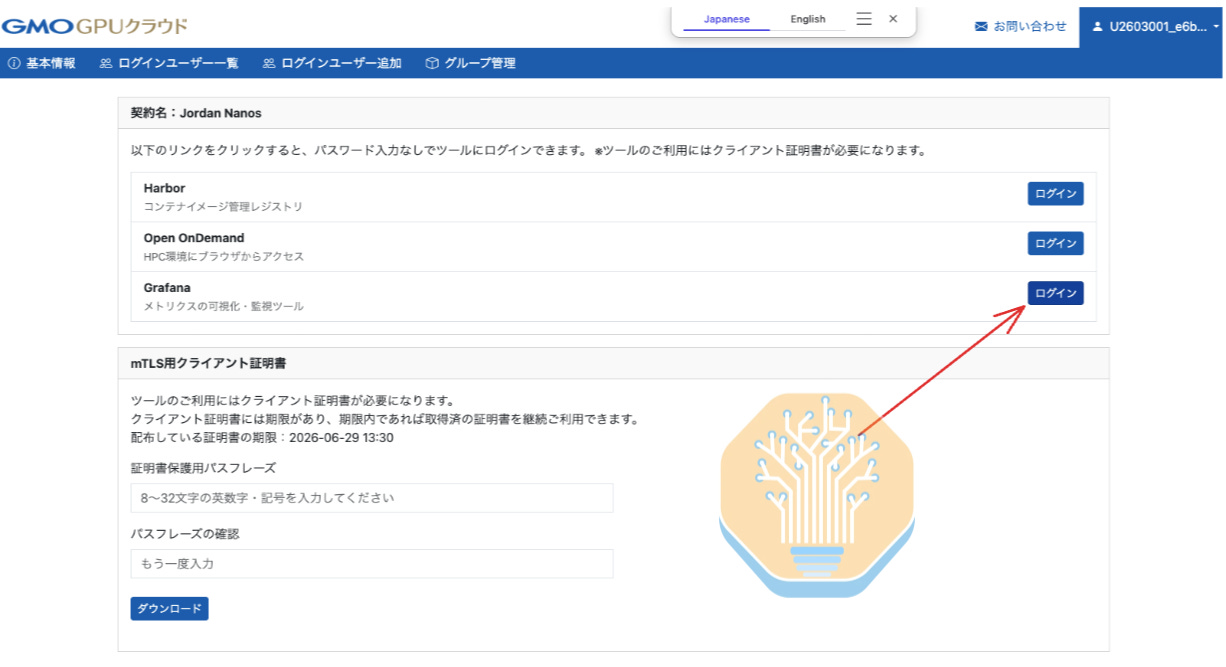
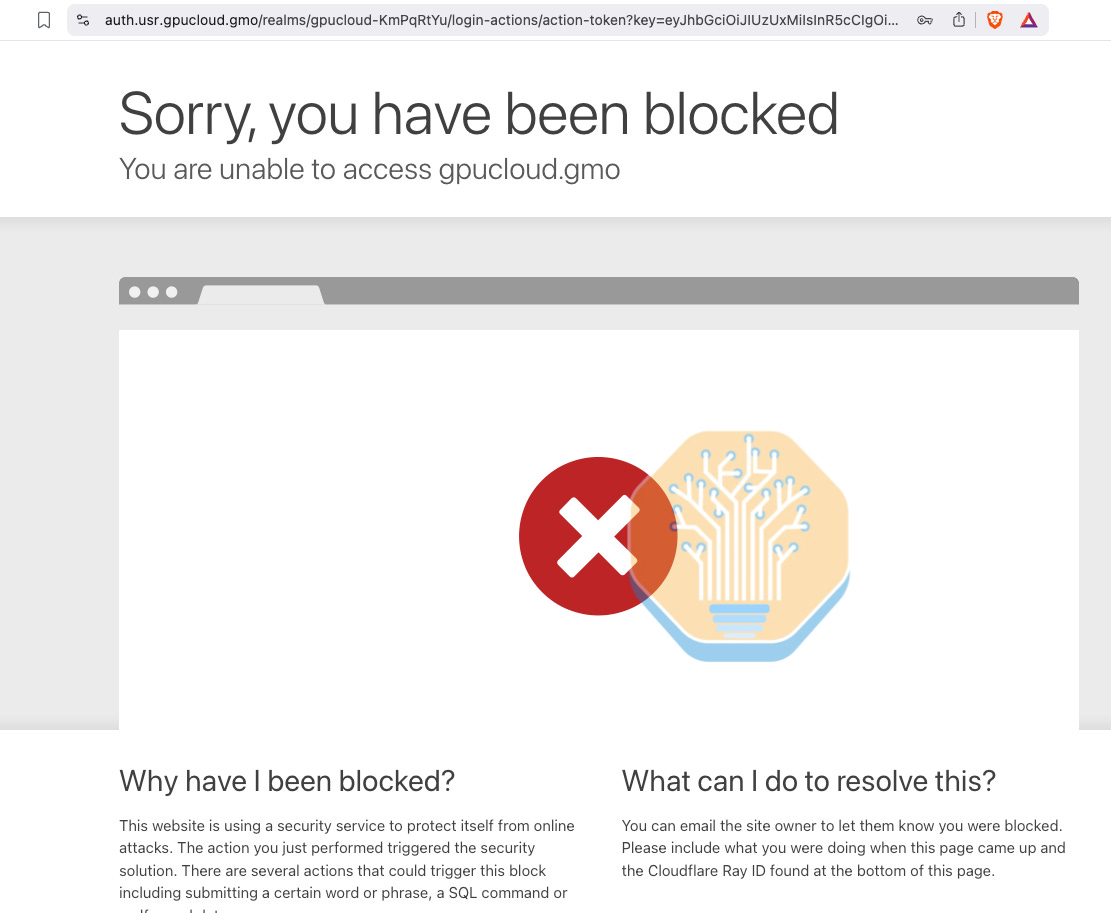
Grafana 的访问折腾了我们五天时间。起初我们漏看了 macOS 登录钥匙串的操作说明,之后又把证书密码输在了要求输入系统密码的地方。GMO 进行了排查并多次跟进。最终错误确实出在我们这边,但如果证书说明能写得更清楚一些,就能省下不少时间。或者说,干脆不要用不必要的自定义证书来访问网站。日本式的安全表演再次上演。
Source: Attempting to access our Grafana dashboard
每个节点配备的 16 条 400 Gb/s 网络通道(rail)带来了出色的 NCCL 测试结果,不过两节点规模所能提供的扩展性证据比我们通常要求的四节点最低标准要少。MPI 启动时需要显式设置 NCCL_IB_HCA,GMO 表示他们已在 nccl.conf 中提供该配置,但一开始对我们并没有生效。压力测试(burn-in)未发现任何网络错误、重传或 ECC 错误,温度和功耗均正常。
共享的 home/data/work 目录开箱即用。FIO 顺序读写、随机读以及 torch.save 的表现都很扎实,这得益于调优良好的 DDN Lustre 文件系统。然而,我们人为构造的测试(例如从共享存储上执行 `import torch` 和 vLLM Serve)表现很差;GMO 表示可以协助排查,但我们认为这是典型的 Lustre 元数据性能调优问题,就直接跳过了。与许多其他 Lustre 实现一样,GMO 的存储方案缺乏快照、自动备份和灾难恢复选项。
该集群还不提供 `sudo`,工作节点上没有 Docker,并且要求使用 snodes——这是他们自行开发的一个便捷脚本,用于展示集群的元数据信息,因为他们禁止用户在自己的集群上运行任何 scontrol 命令。安全表演再次上演。
最后,集群上 SSH 连接到工作节点也被阻止了。而且在 Slurm 作业内部,`RmProfilingAdminOnly=1` 阻止了 Nsight Compute 读取 GPU 计数器,perf 也无法满足我们的性能分析需求。我们认为,托管集群应该允许用户在选择 yolo 模式(放开限制模式)时对自身工作负载进行性能分析。我们有这方面的需求,但 GMO 无法提供。
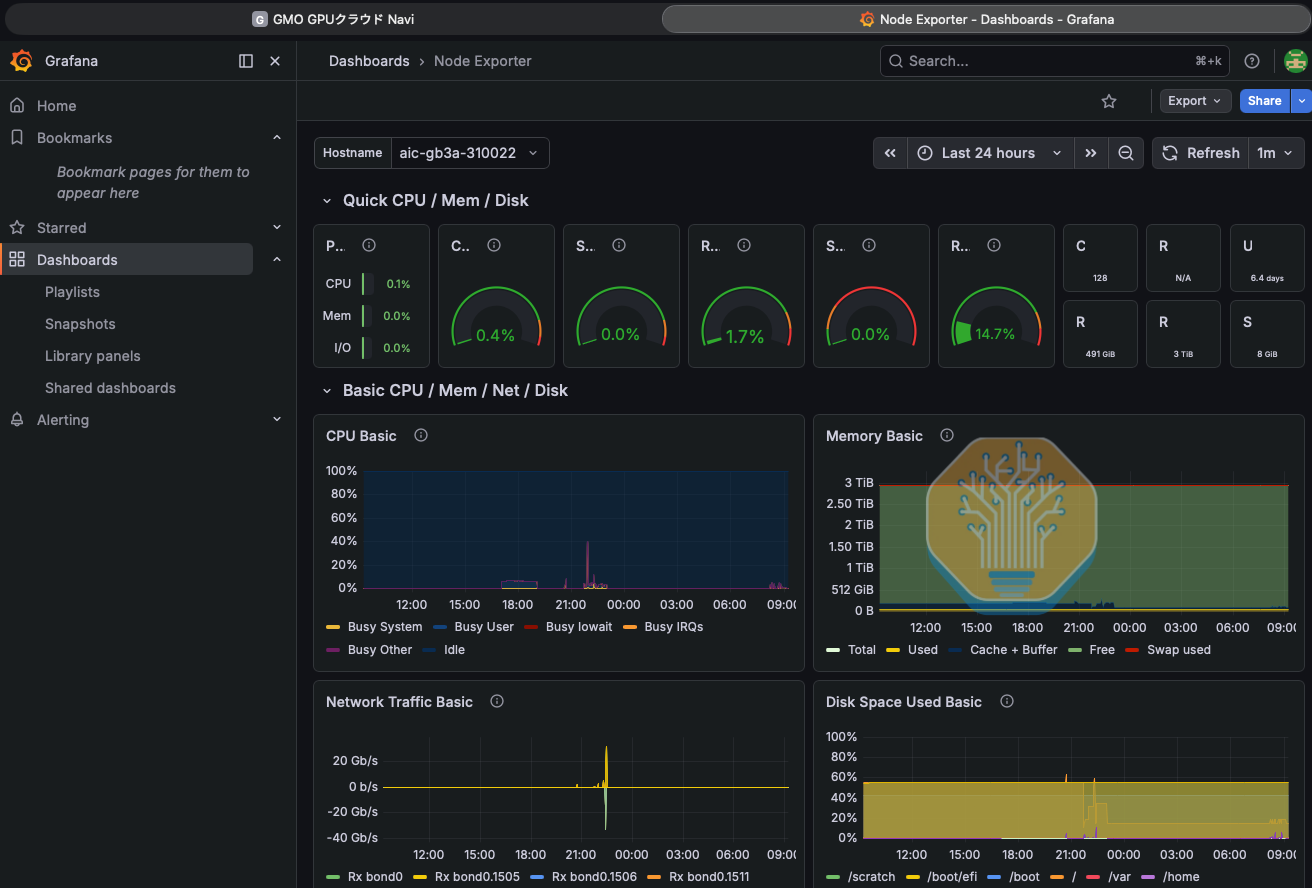
最后,Grafana 展示了有用的 DCGM 指标,但缺少我们用于性能和可靠性监控所依赖的 XID 检测、估算 TFLOPS、SM Active 和 SM Occupied 视图。Slurm 作业摘要视图也相当简陋。我们注入合成的 XID 79 日志后,没有观察到任何告警或节点摘除(node drain)。GMO 表示他们在 Slurm prolog 中运行 dcgmi health,并确认 XID 79 不在白名单中,同意在未来进行调查。测试的最后我们确认,GMO 没有任何自动修复(autoremediation)系统,或者至少我们无法验证其存在。
Source: Our Grafana Dashboard on GMO!
总体而言,GMO 缺乏 Kubernetes 和企业级功能(如 RBAC、SSO 以及客户可访问的审计日志),这使其归属于有效服务日本市场的小众本土厂商阵营。他们团队的支持体验是有帮助的,但遵循标准的日本工作时间。展望未来,我们预计 GMO 将继续在日本保持领先地位,但缺乏将业务扩展到本土以外所需的雄心。
Verda
总部位于赫尔辛基的 Verda(前身为 DataCrunch)今年 6 月披露其 ARR 达到 1 亿美元,总融资额为 2 亿美元。他们与 Nvidia 保持着密切关系,并继续积极寻求融资。在技术方面,自我们去年 11 月测试以来,他们已经实现了不少新功能,我们对其工程团队和产品路线图持乐观态度。
上一轮测试时,Verda 的 Slurm 还处于官方 beta 阶段,且不提供 Kubernetes。这一次,他们提供了托管 Kubernetes,并将 Slurm 服务迁移到 Slurm-on-Kubernetes 架构以简化部署。我们在 Slurm 和 K8s 两层分别测试了他们的集群;虽然仍有不少粗糙之处,但已代表重大进展,也为后续开发奠定了坚实的起点。我们还发现其安全性相当扎实。
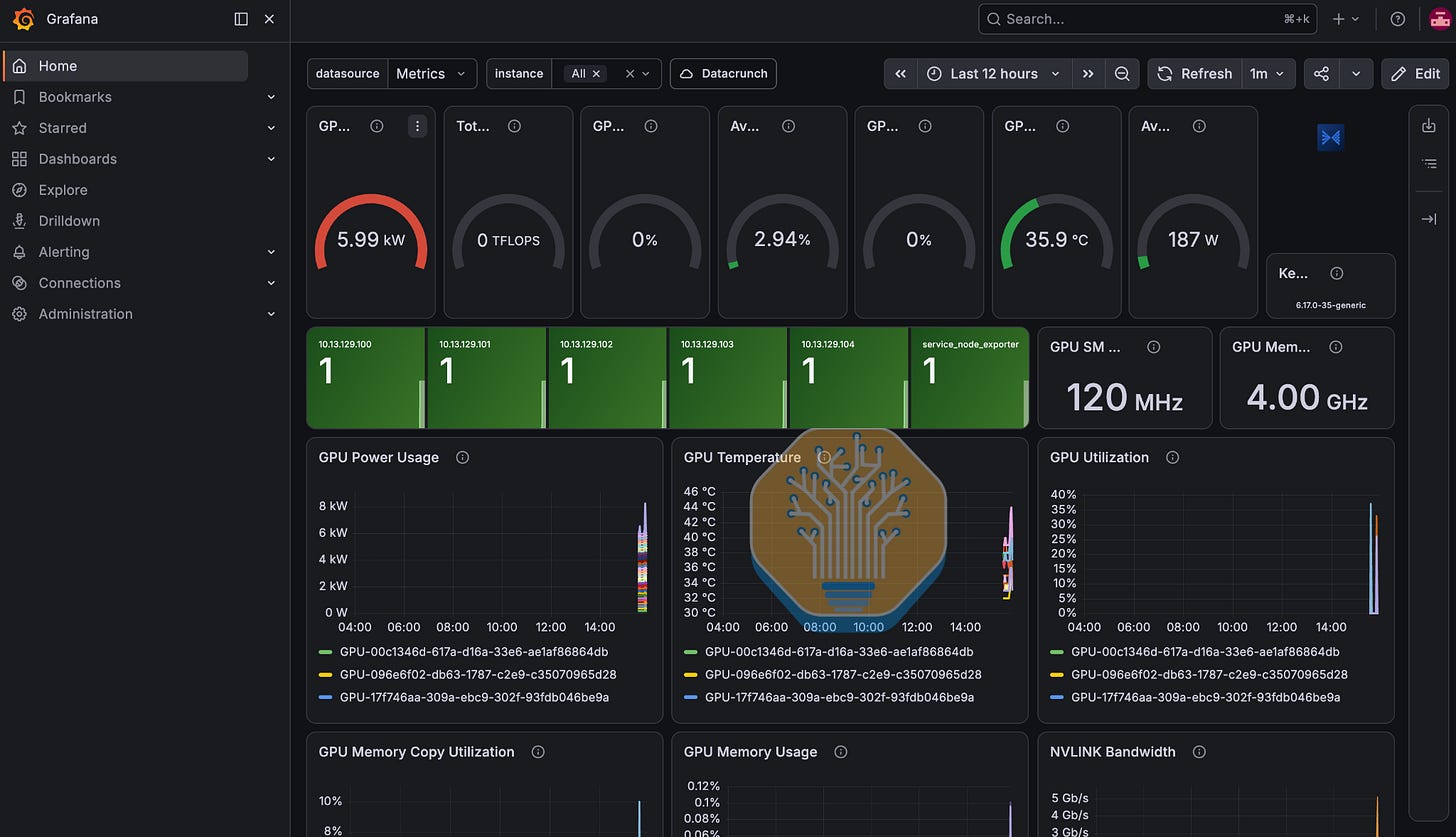
购买和上手流程很顺畅,集群在 30 分钟内无故障地完成了配置。Grafana 仪表盘开箱即用,我们通过 SSH 登录集群也没有遇到问题。
然而,一旦登上集群,就遇到了一些坎坷。我们的 Slurm 测试从一个有趣的“坑”开始:SSH 登录后,我们以为自己处于 Slinky 层,但实际上落在了外部 VM 上,其中的包装脚本通过 kubectl exec 进入 LoginSet 来执行 salloc、sinfo 等命令。其行为很不寻常——例如,所有 Slurm 命令都会把我们提升为 root,而且我们的 Python 环境也消失了——我们调试了一个晚上才弄明白:我们的 Slurm 访问其实是假象,需要使用另一个 SSH 命令才能真正进入 Slinky 层。
Verda 的工程师响应迅速,很快便与我们进行了支持通话,他们合理解释了这些便利功能背后的设计初衷,并为我们指明了官方支持的路径。虽然这个特定功能让我们头疼了一阵,但当工程师们想方设法让集群更易于使用时,这是一个积极的信号。
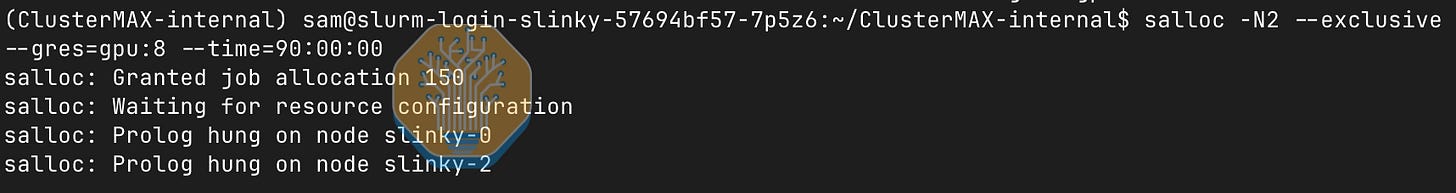
Slinky 层总体可用,但并不完美。Verda 运行的 NCCL-test prolog 超过了 Slurm 10 秒的 `MessageTimeout`,导致每次分配资源时都会触发一条令人担忧但无害的 `Prolog hung` 告警。更重要的是,Verda 不支持 Pyxis 和 Enroot,因此我们只能通过一个庞大的 `.sif` 文件来搭建环境。变通方案完成后,我们顺利完成了 8 小时的压力测试,并在微基准测试中取得了令人满意的数值。
与此同时,Kubernetes 层只能通过堡垒机进行操作,控制台没有提供下载 `kubeconfig` 的途径。要让 Verda 的产品与用户的标准工作流保持一致,这是一个相对简单的修复。
性能扫描中暴露出的最大短板在于共享文件系统。总体吞吐量数据非常出色,但跨节点文件锁似乎根本没有被强制执行。我们发现,跨节点使用 `flock()` 和 `fcntl()` 时,100 次独占锁测试全部出现违规,而同节点的对照组则拒绝了所有尝试。这强烈表明问题出在 `virtiofs` 未能正确公布其锁定行为。此外,我们还发现,多个客户端同时从 Hugging Face 下载数据时会出现数据损坏,以及在 Elbencho 使用 32 个客户端时出现 `ENOENT` 错误。这是一个容易解决的问题,而且至关重要——毕竟在运行 Slinky 时,可靠的共享文件系统是根本所在。
最后,Verda 的健康检查程序尚未完全配置到位。说它们是字面意义上的“健康检查”,是因为它们确实只评估节点是否健康,但没有任何机制来消费其输出——它们退出时返回 `1`,表示“没错,这个节点挂了”,然后就到此为止了。因此,如果用户不想让故障节点悄悄毁掉自己的工作流,就必须自带可靠性测试套件。当然,Verda 也尚未提供自动修复功能。
Verda 的沟通始终及时而清晰,其工程师似乎既有自主权、也有动力去改进产品。9 月 10 日,在我们的测试完成后,他们对 Instant Clusters 推送了一批看起来颇有意义的变更。我们期待他们继续打磨 Slinky 和 Kubernetes 产品、调优存储系统,并实现健壮的健康检查与自动修复功能。
Moonlite
Moonlite 是一家总部位于芝加哥的 neocloud(新型云服务商),本次 ClusterMAX 3.0 是其新入选。其创始团队来自 Crusoe。Moonlite 目前运营一支 Hopper 集群,并且最近交付了首批 B300 和 GB300,未来几个月还将继续扩大规模。根据 LinkedIn 的信息,Moonlite 是我们本轮合作的公司中员工数量最少的一家,且以工程为导向。
我们测试了 Moonlite 的 Kubernetes 和 Slinky。交付过程很顺畅,他们提供了一份不错的入门文档,其中定义了经过验证的配置方案,还有一个 Kubeconfig,为我们提供了所需的一切。默认情况下,所有人在 Slinky 上共享同一个 root 用户;当我们提出需要非 root 用户时,Moonlite 在半小时内就写好了一个 `moonlite-adduser` 便捷脚本,并在当天将其内置到 login-pod 镜像中。这体现了 Moonlite 对反馈的响应速度,但也暴露了他们的不成熟。我们很欣赏这种响应态度,但我们更希望有一套久经考验的系统(最好通过控制台)来处理这类基础需求。
在硬件方面,我们测试的所有内容都开箱即用、运行良好。NCCL 测试达到了 ConnectX-7 的规格,NFS 表现不错,计算基准测试结果扎实,烤机测试也顺利完成。不过需要再次指出:我们测试的是 H100,业界现在对它已经相当熟悉,因此比我们在其他供应商那里测试的 GB300 NVL72 更容易调好。尽管如此,我们对 Hopper 的性能仍然感到满意。
系统中有一个组件我们无法测试,那就是 NVMe——它确实存在,但无法访问。没有任何途径可以访问它:没有 local-path `StorageClass`,`hostPath` 不可用,而且 Slurm worker 是 Slinky pod,只有挂载 VAST 的 `/home`。在 Kubernetes 层面上,根本没有默认的 `StorageClass`,未指定 StorageClass 的 PVC 会一直卡在 `Pending` 状态。
我们通过一次 PCIe 二级总线复位测试了 Moonlite 的健康与监控系统,Moonlite 在 11 分钟内向我们发出告警。在征得我们同意后,他们将节点置为 cordon 状态、运行诊断,并在总共 57 分钟后将其归还到我们的集群中——其中还包含几分钟他们等待我们指示后续操作的时间。在实际服务客户时,他们会提前定义好策略,以便团队根据具体错误按照 runbook 执行。Moonlite 的典型 SLA 是 15 分钟内响应,因为他们的团队会通过 Slack 和 PagerDuty 接收告警。我们从他们的客户那里了解到,到目前为止他们也确实做到了这一点。
在我们看来,任何能在一小时内让集群恢复完整规模的自动修复流程都算足够好了。不过,虽然手动流程目前尚可,但在规模化运营时,我们希望看到这一过程实现自动化。我们还希望在出错时对集群有更高的可见性。在这次事件中,用户唯一能看到的变化是:该节点在 Kubernetes 层面虽然保持 `Ready` 状态,但在复位发生到 Moonlite 人工介入之间的这段时间里,对外报告的 GPU 数量从 8 个变成了 7 个。
Slinky 层在 worker 节点上缺少容器运行时,但其他方面还是完成了任务,登录 pod 上具备我们要求的大部分功能。Moonlite 的 Grafana 还不错,但在调度层缺乏细节,而且没有显示最关键的信息,即错误状态。
Moonlite 尝试做的事情,它都做得很好。我们期待随着其产品日趋成熟、在 GB300 上积累更多实战经验后,再次对它们进行测试。
Together
在 ClusterMAX 2.0 中,我们对 Together 的评价如下:
Together 是一家实力强劲的服务商,其集群方案对 Slurm 和 Kubernetes 都有完善支持,但由于可靠性问题未能进入金级。
本轮测试中,Together 的问题——主要(但不仅限于)涉及可靠性——导致我们将其降级为铜级。
我们有两个节点在计算测试期间发生故障:一个恢复了,另一个却在没有通知的情况下被送去 RMA,让我们一头雾水不知道它去了哪里。在测试后期,Together 的 Slurm `HealthCheckProgram` 试图在已经调度的节点上以 45 秒超时运行 `dcgmi diag -r 1`;诊断没有完成,超时被误判为失败,导致节点在运行过程中被下线。Together 根据我们的反馈很快修复了这个问题。另外,我们有一个节点无法访问 VAST,原因是其存储网卡的 `operstate` 为 `down`。Together 解释说,这是其新的轻量级 VM 技术栈中网卡初始化存在竞态条件所致。当时没有任何机制能捕获这个错误,需要人工干预来重新部署一个健康的节点,把我们的测试机群恢复到 4 台。我们固然喜欢“缩短集群部署时间”这个目标,但显然不希望它以牺牲可靠性为代价。
Together 的健康检查在某些情况下确实能正确运行,相比 ClusterMAX 2.0 已有进步。当我们在 Slurm 集群上触发 PCIe 二级总线复位(secondary-bus reset)时,节点在 67 秒内被下线,随后自动节点替换在 35 分 7 秒内完成,无需人工干预。一个模拟错误也在 Kubernetes 层正确地对节点执行了 cordon 操作,并且因为我们关闭了 `Auto Repair`,正确地没有触发自动修复。
Together 的 Kubernetes 层和 Slinky 层都可以使用,但存在不少问题。有意思的是,Together 建议不要使用 Slinky 集群的 Kubernetes 层:要把 Slinky 节点转换为 K8s,官方指示我们需要将节点拆除,然后按原生 Kubernetes 重新部署。因此,Slinky 方案应当按纯 Slurm 来评估。尽量简要地总结其痛点如下:OCI 镜像解压因 `/tmp` 的默认设置而失败,我们只能把解压重定向到 `/scratch`;即使解压失败,Slurm 仍以退出码 `0` 正常退出;NFS 拒绝任何包含 `:` 的文件名;租户没有读取 `dmesg` 的权限,导致无法检查 XID 事件;非登录节点的 worker shell 的 `PATH` 中既没有 `nvcc` 也没有 `mpirun`,因此普通批处理脚本的行为与交互式环境不一致,还缺少所需的工具。这些问题单看都不致命,但加上其他一些更小的错误,累计起来我们花了几天开发时间才能不受阻碍地运行自己的任务。奇怪的是,Together 的公网到大多数服务的吞吐量都很强劲,但连接 Canonical 的 Ubuntu 源却反复失败:要么无法建立连接,要么连接后停滞不前,要么传输速度低于 20 kB/s。这再次让我们在搭建集群的过程中陷入困境。
通过公网 IP 检查确认,这个不稳定的 B300 集群属于 `AS53735 IREN` 组织。这个位于 Prince George 的 N+0 数据中心,连同 Crusoe 那个被诅咒的 Reykjavik 站点,是业内出了名不可靠的两个数据中心之一。我们强烈怀疑这两个数据中心在启用时没有举行过 Land Acknowledgement(土地致谢)仪式。我们了解到多个对 Together 极为不满的客户,他们饱受链路抖动、供电问题、集群访问被切断、未经用户批准的随机升级出错且不回滚,以及持续整个周末的宕机之苦——这些故障最终都归咎于单一的 ISP(没错,这个站点只有一条 ISP 线路——加拿大北部没有冗余)。也许他们的其他站点更好,但位于 IREN Prince George 的这个 TogetherAI 站点实在是太糟糕了。
在经历了一段时间的互相推诿之后,事情已经很清楚:可靠性问题不能全部归咎于底层提供商。客户支持工程师们犯下的低级失误,已经在客户与提供商之间造成了信任缺失。
当然,托管集群并非 Together 的主业,也不是它的主要收入来源。今年 7 月,当他们宣布 8 亿美元 C 轮融资时,那篇文章充其量只是顺带提到了他们的托管集群业务,反而强调“Together AI 是一家以研究为驱动的公司”。他们在沙特那 250MW 算力的承购方目前尚未披露,但我们知道,Together 更倾向于按 token 计费,而不是按 GPU 小时计费。尽管如此,我们还是希望 Together 能把自身整顿好(Get It Together),解决其集群可靠性问题,让其 Slurm 和 Kubernetes 产品成为值得骄傲的东西。
Crusoe
ClusterMAX 2.0 中关于 Crusoe 的部分以谨慎的语气收尾:
Crusoe 面临被降级为 ClusterMAX Silver 的风险,因为他们的许多顶尖一线工程师相继离职,其云部门的文化开始变得像大厂。整个组织尤其是工程部门,中层管理者太多了。这导致了发布节奏极其缓慢,比如他们的 AutoClusters 功能,让我们对 Crusoe 公有云产品的未来感到担忧。Chase 如果不想失去他所有的 10x 工程师,并最终随之失去他们的 Neocloud 业务,就需要迅速做出调整。
在我们发表那段文字之后的八个多月里,Crusoe 也取得了不少成绩。其估值从约 100 亿美元增长到了 309 亿美元,宣布了在得州的 900MW 和 1.0GW 园区以及其他许多项目,并且在数据中心建设这片“狂野西部”中依然保持着创新者的姿态。他们拥有所有数据中心建设方中最大的真实项目储备。
在收购了一批来自 Atero 的实力超群的以色列工程师之后,他们的推理端点业务也备受赞誉。他们还与 Jane Street 等公司达成了很棒的合作。
业务繁多让他们忙得不可开交、生意也持续运转:他们的有些集群非常出色,但也有些相当糟糕。
然而,本轮 ClusterMAX 测试发现,Crusoe 的 neocloud 业务调整得还不够快。问题可以追溯到根本:可靠性和基础运维卫生。
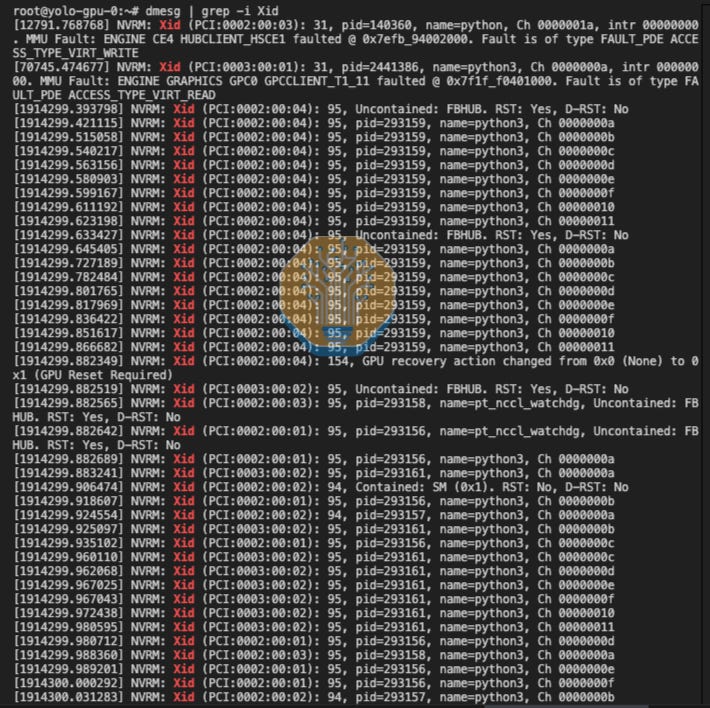
我们在评测标准和报告中都强调健康检查,但真正的硬件故障在测试中很少见,因为我们 ClusterMAX 拿到的分配规模太小、周期太短。Crusoe 打破了这一规律。今年 5 月,我们在一个用来测试 AutoClusters 的 H100 集群上,看到了数量惊人的 XID 错误——在五天时间里,这一个集群上出现的真实错误比其余所有测试加起来还要多。
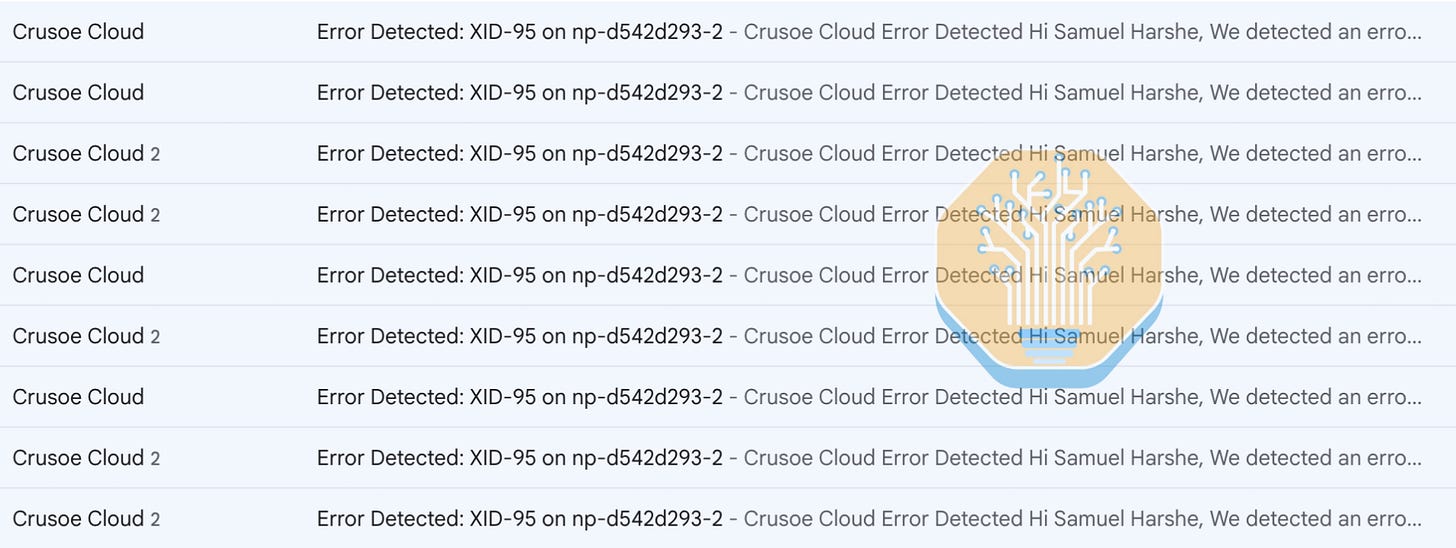
这一模式在整个测试过程中反复出现:某些方面表现极其糟糕的同时,另一些方面的服务却很成熟。这场 XID 风暴伴随着贴心的邮件——排版精美、语气礼貌地通知我们出现了这些错误。
除了要为本轮测试中的大多数硬件故障负责之外,Crusoe 还有一个“特点”:在我们测试的系统中,它的 Linux 内核版本最旧,GPU 驱动也最旧。Crusoe 后来已经弥补了这些缺陷,但在测试时,有若干软件版本远低于我们的最低要求:前文提到的 NVIDIA 驱动未能通过我们的 cmax audit security 检查,Docker、ConnectX 固件和 runc 也存在同样问题。这些问题反映出其安全姿态松懈、工程管理不善。
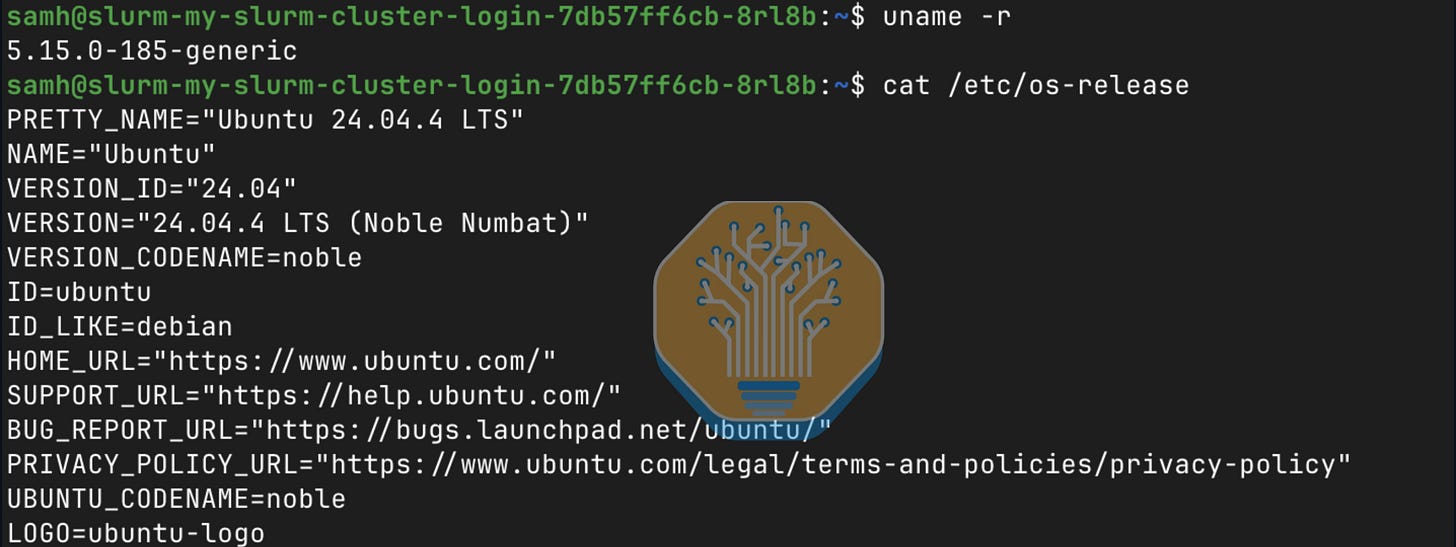
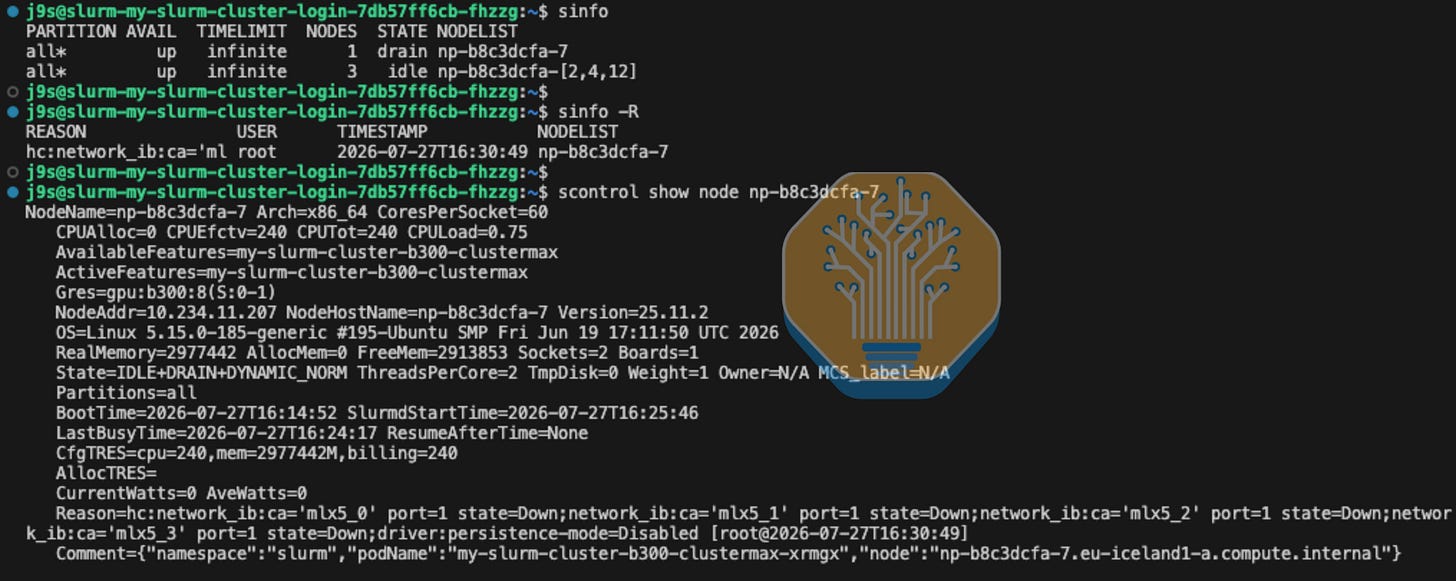
而且这些对软件版本的批评并非纸上谈兵。我们的 B300 集群运行的 Linux 内核版本为 5.15.0-185-generic,早于一个名为 “writeback: Avoid lockups when switching inodes”(回写:切换 inode 时避免锁死)的 Linux 补丁系列。我们遇到的内核问题的具体成因,在提交 e1b849c 的描述中有很好的说明,该提交在上游内核中修复了此问题:“可能存在多个 inode 切换工作项,试图将 inode 切换进出同一个 wb。当某个 cgroup 退出且其拥有大量(数千个)inode、需要全部切换时,这种情况尤其容易发生。此时多个 inode_switch_wbs_work_fn() 实例会在同一个 wb->list_lock 上空转,而只有一个能向前推进。这不仅浪费 CPU 周期,还会迅速导致 softlockup 报告,使系统不可用。
那么,什么情况下会有一个拥有数千个 inode 的 cgroup 退出?答案之一:当一个 Slurm 作业被拆除时。在我们的案例中,随着一个普通工作负载接近收尾,NUMA 节点上的每个 CPU 最终都卡在了争抢同一个 list_lock 上,导致处理器无法使用。碰巧位于这个被冻结的 NUMA 节点上的本地 NFS 客户端拿不到 CPU 时间,其存活探针超时,该节点随即被报告为不健康。Kubelet 尝试用 SIGTERM 和 StopContainer 操作来控制损害,但内核在“慢条斯理地洗衣服”——重新分配脏 inode——花了两个多小时才响应这些终止请求。最终结果又是一封来自 Crusoe 的 NotReady 邮件——而这封邮件的独特之处在于,其根源是一个老旧的 CPU 内核。
到我们测试结束时,这个内核不仅仅是老旧、性能差:它已被 CVE-2026-64378 正式标记为安全漏洞,该漏洞利用了有缺陷的回写行为,于 7 月 25 日发布,严重性评分为 7.8;7 月 27 日又针对这个内核发布了另一个 7.8 级别的漏洞。于是,我们将这个 Linux 内核加入了 Crusoe 暴露于 CVE 的软件清单。Crusoe 已告知我们,他们将升级到 Linux 6.x 大版本内核,这是一个必要的补丁。
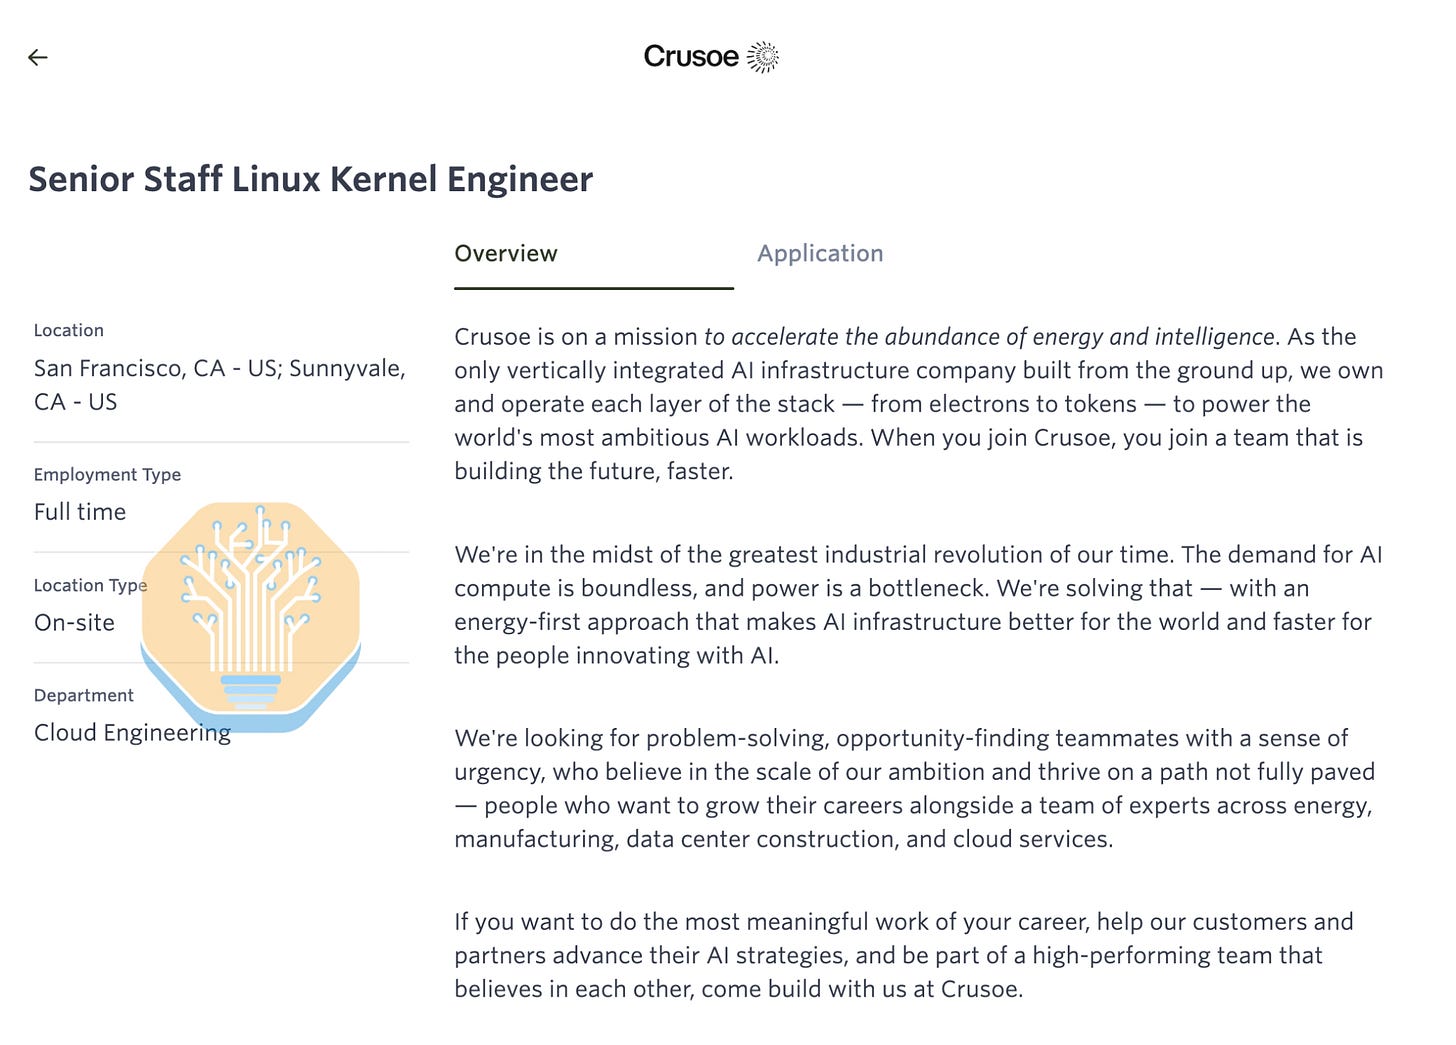
Source: A Crusoe job posting on August 13, 2026
当我们在 Crusoe 的 Kubernetes 层上注入 XID 错误时,该错误很快就被检测到,并触发了「节点替换(Node Replacement)」工作流。但由于一个漏过 Crusoe CI 检查的 Slurm 命名约定不匹配问题,节点无法进入 drain(排空)状态。健康监控系统空转了许久,不断捕获该错误,反复尝试将节点标记为不健康,却始终失败。不过,Crusoe 的工程团队诊断问题的速度快得令人印象深刻,几个小时内就推出了替换节点。然而,替换节点的存储 NIC 存在故障,导致它立刻进入了 drain 状态。即使在手动重置节点的 VM 之后,这个问题依然存在。Crusoe 的工程团队告知我们,AutoClusters 在后一种情况下未能自动修复是「一个已知的缺口」,他们将在「几周内推出针对此问题的自动修复操作」。对于一个如此基础的可靠性故障来说,这样的响应速度慢得出奇。
最后简单提一句:在我们测试过的集群中,这个集群的 WAN 属于最慢的一档,根据具体场景不同,速度在 0.47 Gbps 到 0.78 Gbps 之间。冰岛通往外界的海底光缆确实够细的。
所有这些问题加在一起,造就了一个出了名不稳定的集群。我们的前沿实验室(frontier labs)朋友也证实了这一点——他们抱怨的不仅是故障频发,还有 Crusoe 工程师对及时修复这些问题明显缺乏兴趣。需要说明的是,我们曾一度将 Crusoe 视为全球第二的新云(neocloud),也因此将其视为全球第二大 GPU 租用平台,并给出了相应推荐。唉,昔日强者竟沦落至此。
不过,虽然 Crusoe 的机器镜像早就该更新了,他们的工程师也拿不到 Claude Tags 或 Codex 的审批,但他们确实在内部 Slack 中设置了类似这样的自动化:
2025 年 11 月的 CVE 算「历史包袱」吗?
说正经的,这是一个优先级问题,是官僚主义失控的问题。我们不知道该如何看待上面那种资深 Linux 内核工程师的招聘启事。说直白点,我们只是希望大家把东西保持更新而已。你不需要雇一个 Linus 才能明白这为什么合理。所以,看到 Crusoe 展现实力、出高薪聘请优秀人才固然不错,但把 Crusoe 拖到今天这个局面的,从来就不是缺人、缺钱或缺技术能力。我们抱怨的都是最基础的问题,而不是 Slinky 配置、控制台或 CLI——毫无疑问,那些东西占用了多得多的工程时间,而且我们用起来也挺顺手的。
我们很乐意与 Crusoe 的工程团队合作,并且相信他们有充足的人才来提升自己的地位。坦白说,最近几个月,情况似乎正在重回正轨。工程师们全情投入,不断提交代码,并对即将发布的版本充满期待。对 Atero 的收购可谓价值连城,让 Crusoe 一跃成为推理端点质量方面许多买家的首选之一。我们乐见其成。
不过,在托管集群业务中,TCO 取决于有效吞吐量(goodput),而有效吞吐量取决于可靠性——而 Crusoe 的集群恰恰极不可靠。
本轮 Crusoe 在我们的 Bronze(铜级)类别中排名靠后。
Prime Intellect
Prime Intellect 于今年 7 月完成了 1.3 亿美元的 A 轮融资,估值为 10 亿美元,并披露了“涵盖计算、RL 与后训练、沙箱、推理、环境和评测的年化收入运行率达 1 亿美元”。
我们测试了 Slurm 和 Kubernetes B300 集群,总体上对 Prime Intellect 的两个编排层都比较满意,尽管各自都缺少一些我们希望有的软件包。庞大的 Slurm 控制平面表现出色且响应迅速,其机器不知为何配备了 2TB 内存,有充足的交换空间可供运行 salloc。
在快速修复了 NCCL bootstrap 接口的标准化问题后,我们的网络测试在 ConnectX-8 网卡上最多扩展到了 13 个节点,吞吐量表现出色。存储方面没有问题,Weka /data 卷在 4 个节点上表现非常出色,并且之后仍能稳定扩展。PrimeIntellect 的托管 Grafana 是我们遇到过的较为出色的之一。不过,我们所使用的集群当时仍在进行烧机测试(burn-in),因此我们不断看到各类错误。这倒是检验系统监控和健康检查的好机会!
首先,我们 Kubernetes 集群上的一个节点被标记为 NotReady,显然是由于现场技术人员在摆弄相邻服务器所致;该节点在 5 分钟内恢复了。随后,在一次 PyTorch 网络测试中,另一个 Kubernetes 节点停止上报 kubelet 状态,导致分布式作业无法完成;重启后该节点恢复,作业也得以完成。第二天,2 个 Slurm 节点宕机,一个出现 NVLink 问题,另一个在重启后卡住。经过干预,两台机器很快恢复,但后者很快又故技重施,意外重启了一次,导致一项存储测试失败。一项 MPI 测试在最后一个阶段中止,相应的 Slurm 作业一直停留在 COMPLETING 状态,因为在我们交还集群前的短暂时间里,所有 worker 节点都无法访问。
所有这些可靠性问题都可以归咎于一个事实:我们是在一个很短的时间窗口内进入这个集群的,而当时他们还在为一位付费客户进行烤机(burn-in)测试。这情有可原。但 Prime 手中没有足够的算力来保留热备节点(hot spares),这指向了一个更大的问题——日益增长的容量约束。Prime 是他人算力的转售商,依赖其底层提供商来保证客户获得高质量的体验。这带来了一些挑战,而这些挑战并非总能靠高质量的训练/RL 框架、仪表盘,以及一支精英工程师团队在 Slack 上的疯狂投入来掩盖。
话虽如此,Prime 的健康检查在整个过程中表现令人印象深刻,能够快速干预并限制每次错误造成的损害。我们认为系统的默认响应是合理的,甚至很喜欢那些 Slack 告警,团队也会及时跟进处理。鉴于 Prime 从多家提供商获取算力,其软件层的质量对于实验室(labs)而言非常重要,能让他们对所获得的服务感到放心。在我们测试过的平台中,Prime 似乎是最好的一家。
这给 Prime Intellect 留下了一项明确的任务,也是我们无法直接洞察的任务:提升可靠性,建立一个基础负载级别的算力容量池,并以真正的 neocloud(新型云)身份在排名中上升。我们对这个团队的技术能力毫不怀疑;他们在这个集群上正确地完成了很多困难的工作,而且他们是这份名单上唯一一家将真实的模型训练经验融入其软件和服务方式中的提供商。无论好坏,他们在其他方面的工作都比这里评估的托管算力主业要出色得多。
在这段时间里,我们预览了他们的托管训练产品,并留下了非常深刻的印象。RL 基础设施明显比简单的托管 Slurm 或 Kubernetes 集群更复杂,因为它建立在同样的基础之上,但额外有三个需要保持同步的组件:
训练 推理 沙箱/环境 即将推出的是,我们将通过一个暂定名为 PostTrainingX 的项目,对托管训练基础设施提供商和可按需雇用的 RLaaS 公司进行评估。如果我们现在就得给出这些排名的初步版本,Prime 将有望冲击铂金奖!敬请期待。
DigitalOcean
这是我们第一轮能够完整体验 DigitalOcean 开发者流程的测试。DigitalOcean 将自己定位为「首个为推理和智能体(agentic)时代端到端打造的云」,以此将自己与「专注于裸金属的 neo-cloud 和缺少云平台的推理套壳」区分开来。简而言之:DigitalOcean 销售的产品中包括托管集群。
DigitalOcean 的托管集群由 Kubernetes 编排,整体表现扎实,但略显不成熟。其入门文档要求我们自行安装 Multus,然后创建网络附件(network attachments)、安装 MPI Operator,再创建 MPIJob manifest。这些完全可以为客户预先配置好。配置完成后,我们的集群表现良好,达到了计算和 XDR 网络的所有标准基准,并顺利完成烤机测试,未出现任何问题。此外,集群开箱即用时不包含 RWX StorageClass,这又增加了一项基础配置步骤,而更优秀的 K8s 服务商会替你处理好这些。存储配置完成后的性能表现很有意思:在多个不同客户端数量下,顺序写入比顺序读取快约 6 倍,这与我们在大多数集群上观察到的情况正好相反。我们预计,经过重新调优后,DigitalOcean 的顺序读取性能可以得到显著提升。
当我们测试健康检查时,第一次注入 XID 未被察觉:监控系统没有检测到任何异常,节点仍处于可调度状态。我们向 DigitalOcean 团队报告后,他们迅速响应,找到了系统中的 bug,并请我们在本周晚些时候重新执行测试。第二次测试进行得很顺利,注入后 50 分钟我们就获得了一个新节点。
当一家 neocloud 宣称“端到端专为……推理而构建”时,就意味着它不提供 Slurm。DigitalOcean 团队热心地为我们提供了一份搭建 Slinky 的操作手册,基础部分没有问题,但要达到生产可用的水平还需要大量工作。没有 SSH 访问权限,而且如前所述,默认也没有任何 RWX 卷,这意味着没有地方存放 `/shared` 目录。任何计划在 DigitalOcean 上运行 Slurm 的人,都应该做好自行搭建编排系统的准备。
DigitalOcean 将在 2027 年全年新增 60 MW 的容量。除了托管 K8s 之外,它还提供一系列有趣的 GPU 服务,例如 Droplets 以及裸金属 Hopper 和 MI300X,不过这些不在 ClusterMAX 测试的范围之内。但据我们目前所知,它尚无部署 GB 系列或 VR 系列的计划。我们期待在下一次测试时,看到该团队持续改进其托管 Kubernetes 服务。
Hyperstack
Hyperstack 隶属于母公司 NexGen Cloud,是一家总部位于英国的 neocloud,其在美国、加拿大和挪威提供 Kubernetes 集群。该公司最近以 3.54 亿美元的估值融资 4500 万美元,计划推出众多面向“全周期开发”的 AI 新产品。在宣布获得 3400 万美元债务融资以建设 B200 集群的同时,它还披露了今年晚些时候部署 4500 块 B300 的计划,并将于 2027 年再新增 56 MW 的在线容量。
我们测试的这套托管 Kubernetes 集群相比 ClusterMAX 2.0 有了显著进步,也为其持续发展打下了坚实基础。计算和网络测试均符合规格,烤机测试也保持了良好的数据,没有出现硬错误。Kubernetes 节点重启后的恢复很迅速,PersistentVolume 的挂载和卸载也没有遇到任何问题。北向/南向(N/S)网络表现良好,存储性能也足够用,不过我们未能在时间安排内用上 Hyperstack 通常提供的 Weka 和 VAST。
我们注入的合成 XID 错误在不到一秒内就被检测到,并带有 `NvidiaFatalXid=True` 标志。这次测试有些波折,因为 Hyperstack 没有多余的容量,我们只能从自己的集群中取出一台节点来模拟备用节点。支持团队通知我们,他们在错误注入 12 分钟后检测到了该错误,备用节点在总共 52 分钟后重新加入了集群。有意思的是,此时那台“出问题”的节点仍未被隔离(cordon),直到 1 小时 30 分钟后才在 Kubernetes 层面完成隔离。这一切都是由 Hyperstack 的 SRE 团队在合成错误触发 Grafana 告警后进行人工干预驱动的。
总体而言,这次测试是成功的,我们感谢 Hyperstack 为顺利完成为此付出的努力。不过,正如该团队自己所知,所需的人工支持量让我们对其可复制性有所担忧。Hyperstack 提供 7×24 小时支持,目标是在单节点故障情况下 60 分钟内介入处理。但更好的情况是,不必依赖另一个工程团队按下正确的按钮,你的集群才能恢复到完全健康的状态。
测试期间唯一一个明确的错误是:`cilium-envoy` 和 `csi-hyperstack-node` 这两个 Pod 因 `Too many open files` 而陷入崩溃循环。这只是个小麻烦,并未影响我们的工作负载。
我们期待继续与 Hyperstack 合作,看着他们扩充团队、积累管理更大集群的经验,并持续对其基础设施进行自动化和加固。
参与奖
Vultr
Vultr 自称是“全球最大的私有云基础设施公司”,实际并非如此;还自称是“全球最大的私有超大规模云厂商”,即便前一项属实,这一项也算不上。尽管如此,他们在新兴云(neocloud)领域仍是一个不容忽视的参与者,拥有现代化的 GB300 和 MI355X,并声称在俄亥俄州建有一个 50 MW 的 AMD 站点。在 ClusterMAX 2.0 中,Vultr 交付的集群带有一些基础性错误。遗憾的是,近一年之后,情况依旧如此。
Vultr 为我们的测试构建的镜像中包含许多存在可用 CVE 的库,包括 CUDA、DCGM、Docker、runc 和 ConnectX 固件。我们的 Slinky 登录 pod 没有挂载 `/shared`,也缺少 Pyxis plugstack 配置,因此在 Vultr 支持团队于测试中期重新配置登录 pod(同时解决了这两个问题)之前,我们只能从 worker pod 进行编排。从 K8s 层面还能看到存储方面有另一个基本问题:默认存储配置与我们的裸金属集群不兼容。默认的 StorageClass `vultr-block-storage` 在创建和绑定时毫无报错,然后 pod 就永远卡在 `ContainerCreating` 状态。不过,随 worker 节点附带部署的 Lustre 存储层非常出色,在 32 个客户端上实现了 91.7 GB/s 的聚合读取速度。Grafana 虽已配置但只有部分正确,由于 `DCGM_FI_PROF_NVLINK_*` 字段未配置,NVLink 读数为 0。
众所周知,Vultr 的横向扩展网络在可靠性方面一直存在问题,这让合作伙伴不愿开启或扩大既有合作。我们建议 Vultr 继续提升其集群的稳健性,并努力打造各项相关工具和编排都经过合理配置且保持最新的黄金镜像。
Vessl
Vessl 是一家新兴的韩国 neocloud,它自视为“多云编排器”而非中介,通过长期采购裸金属,并在其上提供带有 SLA 的管理层。他们声称目前有 5,000 块 GPU 在运行中,并制定了到 2027 年底达到 100 MW 的宏伟目标。Vessl 早年的一份 BizOps 招聘启事写道,要具备“速度。我们必须快速行动、快速学习、不断迭代”,并要求“每周至少工作 60 小时”。
我们欣赏这份雄心;然而,我们在其 Kubernetes 和 Slinky 两种形态中抽样的 Vessl 集群尚不成熟,有很多需要改进的地方。我们的上手流程一开始就收到通知,需要固定(pin)三项设置才能让 RDMA 网络可用。有提示总比没有强,但我们更希望拿到一个开箱即用、性能良好的集群。
第三条提示是针对一个特别麻烦的配置:由于 Vessl 的 Kubernetes `LimitRange`,默认情况下每个容器一旦使用超过 2GB 的主机内存就会直接硬性失败。虽然在某些场景下防御性的默认值可能有其道理,但这是一个糟糕的设置。节点很少需要同时运行多个作业,因此容器理应可以使用主机的全部 DRAM——数百 GB——却因超过 2GB 就被 OOM 杀掉,这严重束缚了性能。我们建议 Vessl 放宽这一限制,使其与主机的物理容量相匹配,同时让失败过程更加优雅。
在管理方面,除了通过机器上的传统 Linux 工具外,Vessl 没有提供任何在 Slinky 层管理用户的方法。我们从控制台添加的 SSH 密钥没有出现在集群上,通过 Vessl CLI 添加的密钥同样也没有出现。后来我们了解到,这些工具与 Vessl 的 Blackwell 集群是相互独立的。因此,我们只能使用对方通过 Slack 私信发给我们的私钥和 `kubeconfig`。
该集群提供了一个还算方便(虽然有些奇怪)的 `add-user` 便捷脚本,用于创建新的 Linux 用户。
然而,它并没有提供 `pip`、`git` 甚至 `sudo` 等基本软件包。
因此,这个集群要达到可用状态还需要一番折腾。但我们的实习生作为 Linux 系统管理员的历练还没结束。Vessl 运行的 Slurm 登录节点使用的是临时性的 OverlayFS 根文件系统,因此对 `/etc/passwd` 和 `/usr/bin` 的运行时修改只存在于容器的可写层中,当 Kubernetes 回收该 Pod 时并不会被保留。这导致我们的用户在测试进行到一半时消失了。
另一个 Slinky 配置错误导致 Slurm 层在部分测试期间宕机。我们的工作负载写入了一个未清理的 overlay 层,在根卷中累积了 863 GiB 数据,导致 Kubernetes 将该节点标记为 `DiskPressure` 并将其重启。这不仅使本地 worker 宕机,还导致 Slurm 控制器守护进程一同崩溃,使整个 Slurm 层间歇性不可访问。我们推断 `slurmctld` 被调度到了一个同时运行 `slurmd` 的节点上。将 `slurmd-pyxis` Pod 与 `slurmctld` 共同调度通常是一种糟糕的做法,这个事例就充分说明了原因:数据平面不应被控制平面的管理职责所拖累,控制平面也不应处于数据平面的爆炸半径之内。Vessl 很快通过让 Enroot 写入更大的卷止住了血,但据我们所知,根本原因——worker 与控制器共同调度的问题——至今仍未解决。很明显,Vessl 缺乏大规模生产环境中运行 Slinky 的经验。
另一个独立错误导致 Kubernetes 访问时好时坏。我们 `kubeconfig` 中 `server` 字段里的 URL 并不总是解析到同一个 IP 地址:Vessl 错误地将私有的 `10.x` IP 与公网 IP 一起发布到了记录集中。有时我们的 `kubectl` 命令解析到正确的(公网)IP,可以正常访问;但有时会解析到错误的 IP,请求就会挂起,直到重试成功。我们建议 Vessl 从公共记录集中移除该 `10.x` IP。
我们在 Vessl 集群的 Kubernetes 层上设置的 `NetworkPolicy` 虽被接受但并未生效,因为所有租户 Pod 之间的 HTTP 请求都会被放行,完全无视已定义的规则。Vessl 没有配置健康检查程序,应当优先解决这个问题,并一并完善上述所有不起眼的“基础体验”功能。
Vessl 提供的硬件本身在整个测试过程中表现良好,包括在 InfiniBand 上进行的 NCCL 测试。鉴于其宣称即将上线如此庞大的集群规模,Vessl 有充分的动力去强化其服务,为用户提供更优质的服务,从而获得更高的定价能力。我们很有兴趣在下次测试时观察 Vessl 的进展。
Runpod
Runpod 是一家总部位于新泽西州 Moorestown 的 neocloud,其集群包括 RTX PRO 6000、H100、H200、B200 和 B300。今年 6 月,他们以 10 亿美元的估值融资 1 亿美元,并在 Twitter 上宣布其营收从 2 月到 6 月翻倍,达到 2.4 亿美元的年经常性收入(ARR)。
我们测试的集群位于西雅图,而且是如此之新,甚至还没有配置存储。我们的"Instant Cluster"确实几乎即时可用,启动时间不到 2 分钟。
Runpod 的用户模型很不寻常。在理想情况下,我们会通过带 RBAC 的 Web 控制台来管理权限:通过电子邮件添加团队成员、提升或降低权限、创建用户组,并放入 SSH 密钥以自动同步到集群。然而,Runpod 则是利用其快速供应的优势,建议按需创建 Instant Cluster。工程师们以单租户方式操作自己的集群,用完后将其归还到资源池。这意味着预算、监控等策略都在集群层面之上处理,而不是通过 Linux 用户管理或 Slurm 记账等传统工具。Runpod 的这一设计选择是可行的,但值得注意的是,我们最终并没有按照建议的方式使用集群,而是更倾向于退回到熟悉的模式:创建与我们 SSH 密钥绑定的 Linux 账户。
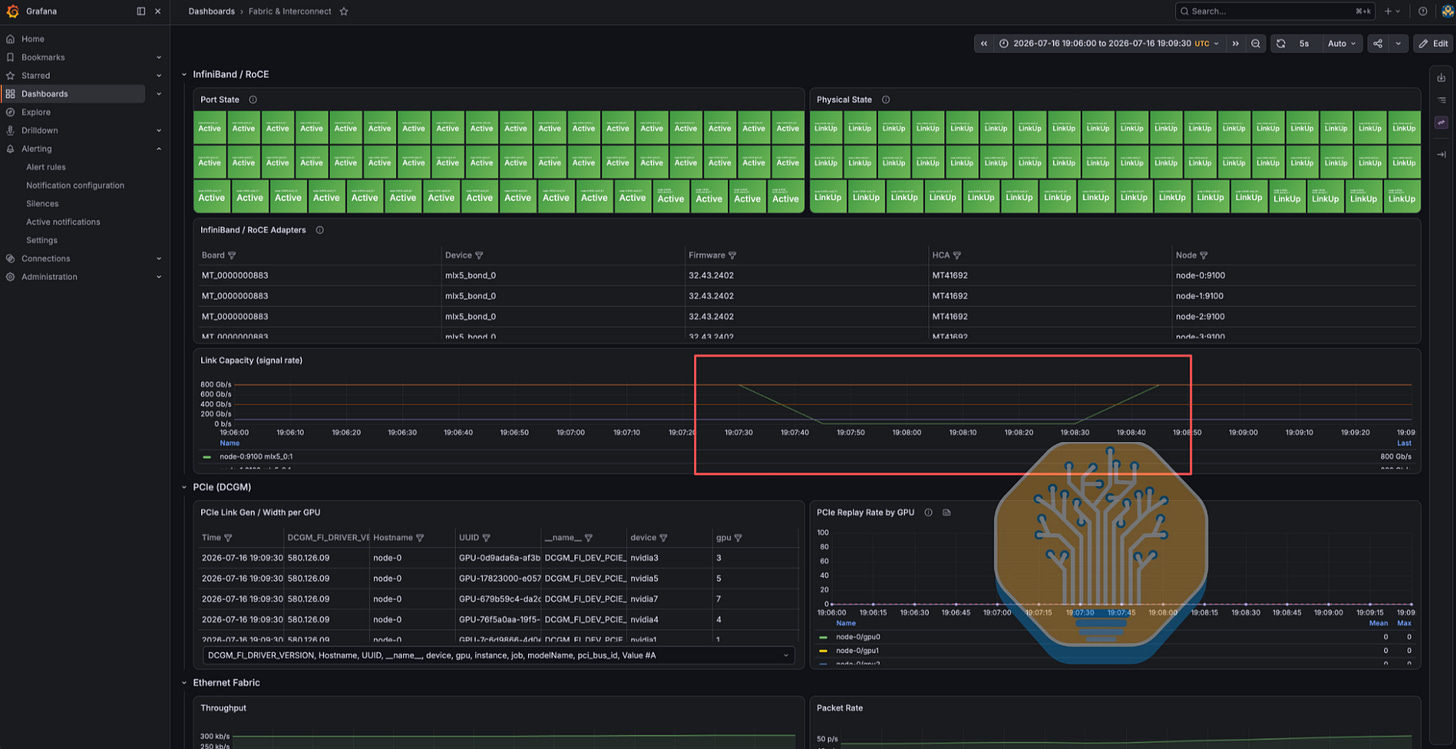
我们的第一次压力测试失败了,因为其中一个节点的两张网卡上的端口 1 链路中断,疑似是由 leaf 交换机的问题引起的。当时没有健康检查能捕获该错误,不过有一个 Grafana 仪表盘可以高亮显示该错误——前提是你知道去哪里看。在我们的反馈下,Runpod 团队迅速改进了仪表盘,让 InfiniBand 状态更容易被发现。
在第二次压力测试中,网络表现良好,测试顺利完成,没有出现任何错误。
这个集群非常新,当时还没有可供测试的共享文件系统。不过从软件层面来看,我们最初的审计发现了许多有待改进之处。出于安全原因,CUDA Toolkit、GPU 驱动和网卡固件均已过时;CUDA Toolkit 还存在另一个问题:12.8 版本不支持 SM103,即 B300 的 SM 架构。这导致我们的一些基准测试在第一次运行时就失败了。此外,集群还缺少大量预期中的工具:没有容器运行时,许多基础 HPC 软件包也不存在。Slurm 还偶尔会将等待中的作业标记为 `InvalidAccount`,即使已设置 `AccountingStorageEnforce=none` 和 `AllowAccounts=ALL`,作业仍然无法运行。解决办法是反复执行 `scontrol update JobId=<jobid> Account=me`,直到 Slurm 接受为止。
我们还遇到过一次节点被置为 drained 的情况:镜像解压占满了 50 GB 的 root overlay,而该空间与 `/var/spool/slurmd` 共享,导致 `slurmd` 无法写入。我们的租户没有执行 `scontrol update` 的凭证,因此测试只能继续在受限条件下进行。另外,Linux 拒绝了 `unshare -Ur`,我们只能改用 `udocker`。由于没有写入 `/dev/kmsg` 的权限,我们标准的 XID 注入路径被阻断;我们没有任何触发节点重启的机制;默认也没有启用免密 `sudo`。这里的问题很明确:在 Runpod 环境中,用户缺少许多完成工作所需的权限。
我们发现 Runpod 团队对反馈的接受度异常之高,并且乐于解释他们的决策。我们欣慰地看到,他们的招聘职位中大多数是正经的工程岗位,也希望他们能继续在易用性与开发者控制权之间寻求更好的平衡。
Bitdeer
Bitdeer 是自 ClusterMAX 2.1 起新加入 ClusterMAX 测试的厂商。又一家从加密货币挖矿转型 AI 的公司,据其最新公告,Bitdeer 已拥有高达 1.75GW 的总电力容量,令人印象深刻。不过这些电力大部分供给加密货币矿机:根据 SemiAnalysis 数据中心行业模型的估算,他们在线的 AI 算力只有几兆瓦。尽管如此,Bitdeer 正在大力转向利润率更高的 GPU 业务:未来几年已有数百兆瓦在规划之中,其项目所在地包括 Knoxville、Wenatchee、Fox Creek 和 Rockdale 的改造或新建站点,以及挪威和马来西亚。Bitdeer 希望业务既能横向扩张也能纵向延伸,因此并不满足于单纯的托管(colo)业务,其新兴服务涵盖从 token 即服务(token-as-a-service)、托管智能体到托管集群等各类业务。
Source: bitdeer.ai
当 Bitdeer 在其公共控制台上给我们提供额度时,我们花了大量时间试图弄清楚他们到底希望我们测试什么。健康检查没有配置,监控仪表盘无法使用,PyTorch 和 Docker 等许多基础库没有安装,网络设置为空,IMEX 未配置,控制台也不支持 RBAC 之类的基本便利功能。Bitdeer 的监控安装程序下载了错误 CPU 架构的二进制文件。SSH 最终能用了,但奇怪的是要求使用 RSA 密钥而非 ed25519。Kubernetes 查询反复断开连接。简而言之,这个集群的管理形同虚设。最多只能说它有 GPU 驱动、NCCL、CUDA 以及操作系统和内核,而且这些都足够新。
一旦我们有时间完成各项设置,性能还是不错的。GPU 在烤机测试中达到了预期数值,NVLink 也支持了预期的流量。
然而,该集群的广域网(WAN)性能异常糟糕,多次测试的平均速度只有约 0.1 GB/s。我们不清楚性能如此差的原因;毫无疑问,这将成为实际使用中的障碍。
最糟糕的是,获取支持极其痛苦。整个技术团队都位于亚洲(就我们而言是马来西亚或新加坡),这意味着我们在排查问题时要等待 8 到 12 小时的响应时间。除了这个最低层级之外,我们无法考虑将 Bitdeer 用于其他任何用途。
我们期待在未来的测试轮次中看到 Bitdeer 的改进,随着其托管云产品日趋成熟,并逐步实现健康检查和托管 Kubernetes 等功能。Bitdeer 会把时间和精力投向哪里,将是一个有意思的问题,因为其管理层已明确宣布 neocloud 业务并非其主要焦点:“履行托管租赁协议才是重中之重。”
Shadeform
Shadeform 仍以小团队专注于经纪业务以及小规模的市场转售单个 GPU 虚拟机。我们很喜欢他们的界面,也乐于与 Shadeform 团队合作,但如果没有更大的抱负,他们将一直停留在我们的最低层级。
Radiant
Radiant 是在 Brookfield 收购 Ori 之后成立的。Ori 是一家总部位于英国的 neocloud,我们在 ClusterMAX 2.1 中讨论过。遗憾的是,我们一直未能测试到一个可正常使用且安全的集群。尽管筹划了将近一年,投入了大量营销精力,还发布了提及数十亿美元和数吉瓦规模的公告,Radiant 迄今仍未部署任何 Blackwell GPU。
FPT
FPT 在我们测试期间出现了许多安全问题,我们在 ClusterMAX 2.1 中已有描述。我们尚未重新测试,也不了解其是否拥有任何 Blackwell 产能。
Core42
Core42 是这一类别中的一匹黑马。他们拥有一支实力雄厚的团队、充足的 GPU 配额、政治层面的支持,以及 Mubadala 这个取之不尽的资金来源。我们预计,随着他们进入美国市场,他们会将各方面整合到位,排名迅速攀升。
Latitude
Latitude 正努力维持其规模不大的云业务,最近被 Megaport 收购并借此实现上市。我们有机会测试了一些搭载 RTX Pro 6000 Blackwell 的服务器,但只要 Latitude 还缺少最新最强的 GPU,我们就预计他们会一直停留在这一类别。
IBM Cloud
自 ClusterMAX 2.0 中那次糟糕透顶的体验之后,我们一直没有机会重新测试 IBM Cloud。
BuzzHPC
Buzz 正在加拿大掀起波澜。他们搭上了 Carney 与 Trump 对决背景下兴起的主权 AI 浪潮,与 Bell 等合作伙伴一道,在萨斯喀彻温省拿下了 1.2GW 的规模和 500 亿美元的投资。这与他们在加拿大其他地区 300MW 以上的部署相得益彰。BuzzHPC 通过母公司 HIVE Digital Technologies Ltd.,成为 ClusterMAX 榜单上众多上市公司之一。遗憾的是,我们测试过的所有来自 Buzz 的 GPU,都部署在质量存疑的集群中,其软件供应商合作伙伴的选择也令人怀疑。自 ClusterMAX 2.0 以来我们尚未有机会重新测试,但希望这一情况能在不久的将来有所改变。
Neysa
印度新兴云厂商 Neysa 今年 2 月宣布获得 12 亿美元融资,其中包括 6 亿美元股权融资和 6 亿美元债务融资。本轮融资由 Blackstone 领投,投后估值达 14 亿美元。他们宣称“将在 2026 年 12 月至 2027 年 3 月期间分阶段部署 9,216 块风冷 NVIDIA B300”,同时还有同等数量的 AMD MI350X 在规划之中。增长势头令人瞩目,显然是印度在这一领域的领军者。
遗憾的是,本轮测试揭示出一个错误重重的集群。集群配置期间预装的许多软件包已过时数月甚至数年,存在多个可被利用的严重 CVE 漏洞。例如,CUDA Toolkit 12.0 发布于 2022 年 12 月,比 Neysa 公司本身还要“年长”,却不知为何被安装在我们集群的 /usr/bin/nvcc 路径下。
我们与 Neysa 团队的合作非常愉快,并鼓励他们在产能激增、开始服务海外大客户之际,继续改善安全态势、夯实基本功。目前 Neysa 的客户大多仍停留在 Hopper 一代,只有少量 B300 可用。在印度次大陆上,还没有 GB 系列(因此也没有直接液冷)实现量产落地。
Vast.ai
Vast.ai 是一个转售商/市场平台,在客户谈到按需租用各类零散 GPU 时经常被提及。它拥有业内顶尖的合作伙伴团队之一,善于在全球各地挖掘闲置算力。遗憾的是,其用户界面实在糟糕,非常难用。
Hyperbolic
上一轮评测之后,我们还没来得及重新测试 Hyperbolic,不过他们终于完成了基本的安全合规认证!Hyperbolic 由此进入榜单。
STN
STN 一直让人很困惑。它是最早部署 B300 的云计算厂商之一,也是极少数提供「私有云」选项的服务商之一。在这种模式下,客户自己负责采购集群,芯片保留在客户自己的资产负债表上,而 STN 负责集群的运维。我们听到多家客户表示他们很喜欢这种安排,比起那些漫天要价的新兴云厂商,更倾向于这种模式。
与 STN 团队的合作一直很愉快,但遗憾的是,最近三次与该团队合作时,我们都遇到了性能、可靠性或配置方面的问题。我们要求修复,对方也承诺会修复,结果问题没有解决,时间就已经耗尽了。
遗憾的是,在能够完整地以客户视角体验一次端到端的测试流程之前,我们只能将 STN 留在这个层级。
不推荐——表现不佳
根据实测结果,这些服务商只需解决一个或多个关键问题,就能迅速升入 Bronze(铜牌)层级。这些问题包括:仅提供较老的 GPU、缺少基本的安全认证(SOC 2、ISO 27001)、对关键服务器功能的错误配置(例如保留 PCIe ACS 开启,或未启用 GPUDirect RDMA),或者在集群创建或硬件停机期间仍收取 GPU 使用费用。
SharonAI
Sharon AI 是一家澳大利亚的新兴云厂商,宣称其项目储备(pipeline)达到 132MW,其中 116MW 已签约出租,而我们估计其当前实际规模约为 4 MW。他们没有 SOC 2 或 ISO 27001 认证。我们测试了 2 个裸金属 H200 节点以验证基本功能。我们期待在 Sharon AI 的产品成熟之后对其进行测试。
IREN
IREN 不断出现在我们与新兴云客户的交流中,而且通常不是出于什么好原因。他们在加拿大不列颠哥伦比亚省北部的 Prince George 和 Mackenzie 提供价格极低的 HGX B200 和 B300 GPU,我们也听说了那些故事:持续多日的断电、网络升级、存储故障、空气质量控制导致链路抖动、到处都是 XID 错误。用户评价它是业内最差的站点,位列第一。我们自己也是他们的用户之一,因为通过多家转售其算力的服务商,我们测试过 IREN 的 GPU。而我们听到的很多体验不佳的用户,并不是从 IREN 的转售商那里租用,而是直接租用 IREN 自家的服务。
话虽如此,他们在 Childress 和 Sweetwater 的新建站点看起来要好得多(也就是说,不再是 N+0 的电力、制冷和 ISP 配置了!)。我们在数据中心模型中已经详细介绍过这些站点,这里只需说明:尽管他们的云服务存在诸多技术缺陷,我们预计 NVIDIA 的 21 亿美元投资将帮助他们在这次建设中少一些偷工减料。
我们建议 IREN 停止在公开的营销和投资材料中假称自己提供托管集群和推理端点,转而专注于裸金属业务——市场对他们的这类服务有充足的需求。
Hydra Host
Hydra Host 于 2026 年 6 月完成了 1 亿美元的 A 轮融资,NVIDIA 是其投资方之一。该公司专注于撮合交易,而关于其托管集群的体验,我们只能参考此前的测试结果。在考虑给予更高评级之前,我们需要对一个真实的托管集群进行测试。
FarmGPU
我们在 FarmGPU 的测试中未能取得太多进展。其 Slurm 层无法正确通告(advertise)GPU 资源,而 Kubernetes 又没有为横向扩展网络暴露任何 RDMA 设备。
话虽如此,我们非常欣赏 FarmGPU 的开放开发文化,包括其出色的 Grafana 监控体验和详尽的部署说明。我们认为其技术团队值得信赖、合作扎实,尽管他们在尝试正确部署几个小型集群时已显得人手过于紧张。
WhiteFiber
WhiteFiber 于 2025 年 8 月在 IPO 初始交割中募得总额 1.594 亿美元。我们此前的测试发现其网络性能不错,但 Slurm/Kubernetes 集成无法使用,作业监控也很薄弱。较新的客户反馈表明情况有所改善,不过 Slurm 登录节点的临时文件系统仍然是个隐患。我们需要验证这些运维问题是否已得到解决。
PaleBlueDot
PaleBlueDot 于 2026 年 1 月完成了由 B Capital 领投的 1.5 亿美元 B 轮融资。我们此前发现其市场平台用于租用单个虚拟机非常便捷,但缺乏完整的托管集群体验。遗憾的是,他们已关闭了按需控制台,转而在专属数据中心内为少数大客户提供服务。
Akamai
过去一年,Akamai/Linode 没有太大变化,仍以单节点 GPU 为重点,不提供托管的 Slurm 或 Kubernetes。我们会继续关注,看这头沉睡的巨人在短期内是否会醒来。
Hetzner
Hetzner 的低价托管模式仍提供一些便宜的 PCIe GPU,具体是 RTX 4000 和 6000 Pro Blackwell Edition。我们期待看到他们能否借助其数据中心运营经验更进一步,推出更大的动作,真正服务于 AI 市场。
Mithril
Mithril(前身为 Foundry)于 2024 年宣布获得 8000 万美元融资,目标是“为 AI 重拾公有云的承诺”。如今,它已变成一个市场平台,封装了 3 个配备 H100 或 H200 的 Nebius 可用区,但只有 H200 有可选配横向扩展网络的选项。
Source: Mithril website
他们曾发布过一些关于 TPU 支持的公告,让我们相当期待,但这项合作似乎已被悄然取消。
OVHCloud
OVHcloud 在全球拥有庞大的基础设施,在全球众多数据中心开展运营,其中一些还与本榜单上的头部新型云厂商(neocloud)共享。但我们的顾虑依然存在:通用型 IaaS 并不是 AI 时代的增长引擎,毕竟各家公司在获取最新最强的算力上不惜一切代价。又一位沉睡的巨人。
Massed Compute
Massed Compute 上一次宣布的融资是 2025 年 8 月从 Digital Alpha 获得的最高 3 亿美元股权与收益分成融资。他们利用这笔资金推动了裸金属业务的稳健增长,但仅凭这一点在 ClusterMAX 评级体系中还不够,尤其他们的 AI 水军聊天机器人(slop cannon chatbot)仍然在被网络爬虫收录。
不推荐——无法评估
我们的「不推荐——无法评估」层级一如既往,但需要说明的是,该部分包含四类公司:
我们此前测试过、但现在声称零闲置容量和/或拒绝与我们合作测试的公司。包括 Fluidstack、Cirrascale、Lightning AI(近期与 Voltage Park 合并)、Scaleway、CUDO Compute、Denvr Dataworks 以及 Atlas Cloud。 尚未上线、尚未测试、但总体上让我们感到有兴趣的公司。不过我们认为其中一些不愿具名的公司在误导投资者(即撒谎)——在公开宣传材料中声称自己提供托管集群服务,实际上只做裸金属业务。包括 SpaceXAI、Mistral、Poolside Infrastructure Company、Nscale、Highrise、Corvex、Andromeda、Volta、Firebird、Tatra、Sesterce、Yotta、Boostrun、GlobalAI、Argentum 和 Qumulus。 规模庞大且重要,但由于地域或监管方面的顾虑,我们无法妥善测试的公司。包括 Alibaba Cloud(阿里云)、MegaSpeed、BytePlus、RunSun、SK Telecom、Naver Cloud 以及 Indosat/Zankore/Lintasarta。 规模太小、无关紧要的公司。这些公司仍会涵盖在我们的市场观点中,但不参与评级体系。 Fluidstack
就我们而言,Fluidstack(目前)已经退出了托管集群市场,因为他们的重心已从托管 Nvidia 集群转向了 10 万颗以上芯片规模的裸金属 TPU 部署。我们期待未来能再次与他们合作测试,无论届时他们提供的是什么芯片。
Cirrascale
遗憾的是,在收到一封要求修改我们上一篇文章中关于与 Cirrascale 合作体验描述的法律函件之后,我们一直未能与其建立起富有成效的合作关系。
Lightning(已与 Voltage Park 合并)
在 Lightning 与 Voltage Park 合并之后,这家合并后的公司不幸耗尽了 GPU,我们一直无法测试整合后的产品。尽管该公司持续宣称自己是全球已部署 GPU 数量第三大的新型云厂商,但实际上他们连前十都进不了。
Scaleway
最近我们听闻,Scaleway 已降低多个客户合作的优先级,并主动决定与 NVIDIA 断绝合作关系、转投 AMD,而且似乎并没有什么充分的理由。我们认为这很令人惋惜。
CUDO
CUDO 本周期未能提供有代表性的托管 Slurm 或 Kubernetes 环境,因为他们专注于其他业务重点(即管理一批裸金属数据中心的建设工作)。我们期待在环境可用时重新评估 CUDO。
Denvr Dataworks
尽管 Denvr 的领导层有所变动,社区中也偶尔出现一些活动,但我们在测试方面依然毫无进展,也没有看到业务上有任何有意义的增长,足以让他们摆脱创始人挖下的坑。
Atlas Cloud
我们最近一直无法从 Atlas 获取 GPU。尽管其加密货币母公司大肆宣传裸金属数据中心,他们的托管推理服务也零星出现在一些推理端点提供商名单上。
SpaceXAI
我们很喜欢 Colossus,迫不及待想测试 SpaceXAI 的 neocloud 服务!
Mistral
Mistral 刚完成了一笔 30 亿欧元的 Series D 融资,但尚未确认 TeamPCP 一名黑客的说法——该黑客声称将 Mistral 的全部代码库放到暗网上出售。不管怎样,我们对测试他们的 neocloud 服务感到非常兴奋。团队告诉我们,该平台在 8 月仍在搭建中并正在接入首批客户,因此我们非常期待未来与他们进行测试。在我们看来,如果那些在为自己模型搭建训练集群方面有经验的公司(见上文)决定转型,它们显然能够成为成功的 neocloud。
Poolside Infrastructure Company
在 Nvidia 以 60 亿美元完成 licensiquihire(许可证收购加人才吸纳)之后,这支优秀的团队被埋没在了 Nemotron 的官僚体系之中。而 Poolside 的遗产通过 Poolside Infrastructure Company 得以延续——该公司正在西德克萨斯州开发他们的 Project Horizon 园区。我们尚未测试过他们的任何产品,但凭借其经验和雄心,只要这个精简团队决定在 neocloud 业务上放手一搏,他们就能立即成为有力的竞争者。
Nscale
Nscale 在 3 月宣布了 20 亿美元的 Series C 融资,5 月宣布收购 AnyScale,几天前又刚刚提交 S1 文件,准备在纽交所上市。让我们难以置信的是,他们的业务规模如此庞大,却仍在公开宣传材料中声称提供托管集群和推理端点——而事实显然并非如此。不过,他们显然还会继续成功下去。他们掌握着大量土地和电力资源,具备一些建设和数据中心运营经验,而且大家确实都想要价格实惠的裸金属服务。
Highrise
Highrise 是 Hut 8 旗下的 AI Cloud 业务,经常出现在新闻中。我们希望能尽快测试他们的托管集群。
Corvex
Corvex 依旧对 ClusterMAX 躲躲闪闪,不过他们在 8 月宣布了一笔 3300 万美元的定向增发,用于扩充数据中心容量。他们选择的合并对象是 Evie 智能戒指的制造商 Movano,产品路线图可谓发生了巨变。私下里,他们声称拥有一些美国政府(USG)的保密客户。我们期待进行测试。
Andromeda
Andromeda 从其他供应商那里获取算力,并在其之上提供托管集群服务。我们多次讨论过测试事宜,也很乐意与他们的技术团队合作,但发现其商业方面有些不太光彩。经销商有一种扭曲的动机:向客户隐瞒底层供应商是谁,担心客户会绕过他们直接与供应商签约。不幸的是,这可能导致糟糕的传话游戏,最坏的情况下还会引发大量相互指责。具体来说,我们对不得绕过条款(non-circumvention)持保留意见,并希望 Andromeda 能建立一个持久的商业模式,让他们可以坦然地展示其优秀的技术团队以及团队能够创造的价值。我们期待尽快测试他们的 Blackwell 算力,无论它位于何处。
Volta
Volta 以 3 亿美元的创业资金启动,另有面向客户的 50 亿美元融资池。其首个宣布的大型合同使用的是 Bitdeer 位于挪威的站点。我们尚未测试其云软件和客户运营。
Firebird
Firebird 正在亚美尼亚建设 GPU 基础设施,Ameriabank 宣布为其提供 6000 万美元的建设融资,并计划向哈萨克斯坦扩张。最近,他们成为了一则关于 Nvidia 芯片获取与亚美尼亚-阿塞拜疆和平进程的报道的主角;联合创始人 Razmig Hovaghimian 回应称,该项目早在这些外交进展之前数年就已启动。GPU 外交。为亚美尼亚人民交付成果的压力来了!我们仍然需要看到其托管云的实际运行效果。
Tatra
Tatra 正在斯洛伐克开发 B300 和 GB300 算力,依托该国的核电和水电基础。我们收到了一些关于这对父子团队技术实力的好评反馈——他们勤劳肯干,是一个令人敬佩的家庭。不过目前,我们需要他们先完成第一批算力的全面部署,才能对其进行测试。
Sesterce
今年 8 月,我们通过 Sesterce 启动了一台按需 H100。控制台显示的 Ubuntu 选项已经过时,开通过程耗时不短,最终我们得到了一台可用的机器。然后我们发现底层是 Shadeform。中介之上再加中介。我们很想知道在客户能运行工作负载之前,究竟有多少家公司需要从中抽成!话虽如此,Sesterce 正在洽谈一些大型裸金属 Blackwell 集群,并对接大型承购方。我们想要测试这些集群。
Groq
Groq 曾立志挑战 Nvidia,但在一场“许可+收购式招聘”(licensiquihire)把 Jonathan Ross 和大部分工程团队带走之后,剩下的公司已经转型……去租 Nvidia GPU 了!想再融 3.5 亿美元来实现梦想,成为一家新型云(neocloud)就是当前的选择(8 月宣布)。我们期待有一天能测试的不只是端点。Jensen 拿到了芯片团队,还多了一个客户。这笔买卖不亏。
Yotta
Yotta 在一场入门演示后交给了我们一个四节点的 H100 Kubernetes 集群,而那场演示的主要内容就是参观一下登录界面。要提交工单,我们先被从 Shakti Cloud 引导到 One Yotta,然后又被引回 Shakti 域名下。遗憾的是,这么多门户网站并不能帮集群保持在线——我们开始测试不到一天,就遇到了一次真实的故障(Xid 94)。我们的测试仍在进行中,性能表现扎实(虽然远超我们的截止日期),但从客户反馈和我们自身的体验来看,目前的信号已经相当明确。他们需要拿出 Blackwell GPU 和更好的可靠性,才能跟上业内其他厂商的步伐。
Darya
Darya 正把 GPU 云基础设施带到塔吉克斯坦,紧邻阿富汗边境,这无疑扩大了我们需要测试的地域版图。其 H200 集群于 2025 年 6 月上线,随后又与 Yotta 签署协议,在 Darvoz 建设一座由水电供电的 AI 数据中心。这很有意思,但鉴于我们在 Yotta 门户之间来回折腾的经历,我们特别好奇这套运营模式中到底有哪些部分能顺利落地到塔吉克斯坦。我们还没有获得 Darya 集群的访问权限,不过我们很乐意实地参观。
Source: Darya’s Datacenter on Google Maps
Boostrun
Boostrun 有相当不错裸金属硬件,但他们花钱跳过了部分 Kubernetes 工程:据 vCluster 称,该公司在不到 45 天内就推出了托管 Kubernetes,而且没有新招任何平台工程师。他们采用了租户隔离的控制平面、专用私有节点,并用 Netris 做网络配置。这个思路很务实。我们更愿意看到一家小型供应商直接使用成熟的软件,而不是花一年时间重新摸索 Kubernetes。在与客户的讨论中,我们仍在考虑为完全托管的训练体验增加另一个运营商。我们曾通过另一家转售其容量的供应商间接测试过 Boostrun 的集群,但还在等待直接与其支持团队接触的机会。我们想看看在真正的合作中,Boostrun 自己能承担多少“第二天”(day two)运维工作,然后再决定是否将其列入榜单。
Global AI
Global AI 对“主权云”这个说法的理解非常字面化:按数据中心机房(data hall)出售专属的、单租户的、物理隔离的集群(至少他们是这么说的)。客户可以决定 Global AI 何时访问自己的系统,对于裸金属来说这是一个不错的方案。不过,在宣传托管集群选项时,我们想看到更多东西。光是评估裸金属,我们就想了解诸如配置和补丁是如何处理的、监控栈有多全面、可靠性和健康检查如何运作,以及现场团队关闭工单的速度和准确度如何。我们目前还没有看到这种程度的细节。
Argentum
Argentum 的网站上写着“现有 200,000+ GPU 可用”。在读到文章这一节之前,你听说过 Argentum 吗?
QumulusAI
QumulusAI 找到了另一种 GPU 债务来源:通过 USD.AI 获得 5 亿美元的追索权贷款,以 GPU 仓单代币(GPU Warehouse Receipt Tokens)作为稳定币借贷的抵押品,可为已批准的部署提供最高 70% 的融资。GPU Warehouse Receipt Tokens 是它的真实名称。公告中描述的是一项授信额度,所以我们没有把 5 亿美元计入已安装硬件。在客户访谈中,Qumulus 被提及为一家算力供应商,若要做托管训练,可能还需要在其之上再叠加一个运营商。我们还需要审查它自己的软件和支持能力,但初步的客户反馈出人意料地不错。
Alibaba Cloud
与典型的新云初创公司相比,阿里展示的软件要多得多。一个例子是它的 ACK Slurm operator:其中的 SlurmCopilot 组件负责协调 Slurm 与 Kubernetes 之间的资源分配,使空闲资源不会滞留在某一个调度器中。这种编排层的基础设施正是我们喜欢深入研究的,而很显然,这家公司还没有做好被深究的准备。我们有账号,也被列入了几个模型端点的白名单,还与销售团队直接沟通过,但至今仍未获得任何现代 GPU 或这套 ACK 软件用于测试。
Megaspeed
他们在马来西亚和印尼的站点有大量硬件可供调查,但还没有拿到登录权限。
BytePlus
BytePlus 的 GPU 服务宣传了多轨道网络上的交换机亲和性放置、对其 vePFS 并行文件系统的直接 RDMA 访问,以及与我们最爱的模型的集成:Seedance 2.5。我们尚未完成对其集群的评估,但显然有值得密切关注的东西。滴答,滴答。
Humain
Humain 给自己揽了不少活。除了沙特的 GPU 建设之外,Tareq Amin 宣布了约 6 GW 的数据中心规划,以及 Humain One——一个可用于任何计算机的实时语音界面。我们很乐意先从一个登录账号和一个能正常运行的集群开始,但至今没有得到团队的任何回应,这让我们很好奇:他们在 Groq 系统旁边还藏着什么秘密。
SK Telecom
SK Telecom 为韩国主权基础大模型项目运行着超过 1,000 块 B200。正如我们在近期一篇文章中所报道的,政府还从 SK Telecom 和 Naver 合计租用了约 3,000 块 H100 等效算力,用于竞赛的第一轮。SK Telecom 已宣布建设规模更大的 2 GW NVIDIA DSX AI 工厂,预计将部署搭载 SK Hynix HBM4 的 Vera Rubin 系统,这属于 SK Group 规划的 5 GW 一期建设的一部分。我们曾通过 Vessl 测试过 SK Telecom 的 GPU,表现相当不错,但没有与 SK 直接合作过。要把他们视为一个重要的市场参与者,我们还需要看到他们在国际市场上有更多动作,但他们的技术基础显然是扎实的。
Naver
Naver 与 SK Telecom 一样,具备很高的可信度。它已经在运营超大规模云服务商级别的数据中心,其 7 月与 NVIDIA 和 Brookfield 共同宣布的计划,要求将 GAK Sejong AI 工厂从最初 55 MW 的建设规模扩展到 2028 年的 200 MW。我们关注的是,这些运营经验中有多少能够服务于外部客户,而不是仅限于 Naver 的内部研究团队。这方面的体验我们尚未测试过。
Indosat(Zankore)
Zankore 已宣布,约 200 MW 的 GB300 NVL72 算力一期工程将于 2027 年上半年交付。即使他们在部署 Blackwell 方面稍有延迟,但他们仍在朝着长期 1 GW 的目标稳步前进,主要服务于(传闻中的)来自中国大陆的算力采购方。而且他们已经获得了一笔 31 亿美元的贷款来推进这一计划!
ClusterMAX 的下一步