← 全部文章
Computation and Data Movement for Inference
2026-09-21 · 原文
混合专家(Mixture of Experts)如今已广泛应用于前沿模型,它不仅改变了推理服务的结构,也改变了有效推理的经济学。它的作用不只是增加参数量。它改变了每个 token 激活哪些张量、哪些数据必须保持紧密相邻、哪些传输需要强大的本地带宽、哪些可以容忍较弱的网络链路,以及内存搬运、存储和调度如何共同贡献有效吞吐量。
最好的切入点是从服务整体来看。推理运行在一个由编排层(如 NVIDIA Dynamo、Mooncake 或自定义调度器)协调的集群中。这些编排层与 vLLM 或 SQlang 等推理服务器紧密配合,而这些服务器本身也带有自己的编排功能。本文不会深入讨论如何使用这些编排软件,也不会讨论应该如何选择。本文的目标是提供一个概览,说明整个流程以及你可能使用的各种功能背后的原因。
用户(或其代理)以一个请求(查询)开始一段对话,对话可能在得到回答后继续发起更多请求。一次「请求-回答」构成一个「回合」(turn)。在现代 AI 系统中,用户通常在客户端应用(无论是图形界面还是命令行)中运行,AI 返回的部分回答会被该应用拦截并作为指令执行,比如编辑你的代码,或者针对一个人力资源问题搜索公司规章。
AI 系统也可以在其数据中心内自行完成其中一些操作,例如搜索网页。这些被拦截的工具操作的结果也会作为请求返回给 AI,从而产生更多回合。服务器会保留一个上下文(通常称为 KV cache 或简称缓存),它是整个会话的浓缩,使得来自用户或工具的每个新请求都能被正确解读,从而推动整体进展。当用户启动一个代理去执行长期任务时,每小时可能出现数千个回合。对话也可以暂停,数小时甚至数天后再恢复。
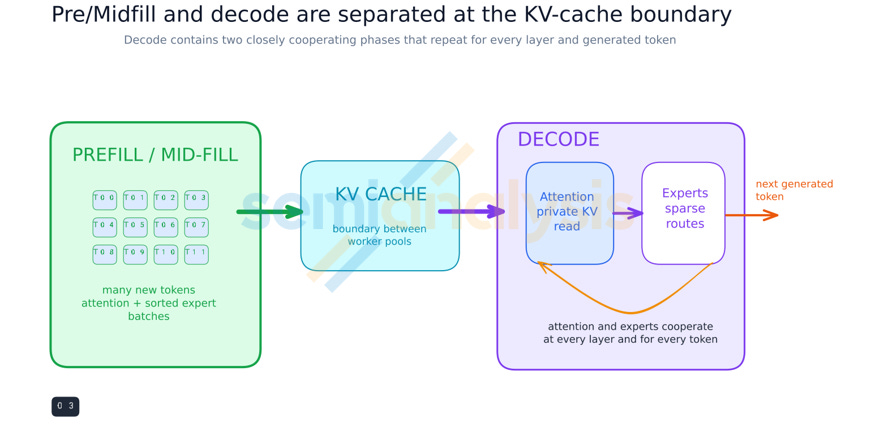
当请求到达推理服务器时,编排层会将其放入队列,随后它会连同系统提示词以及对话中先前回合的上下文一起,被送入输入填充(input-fill)worker。查询随后被转换为新上下文,追加到对话中。新的上下文状态接着被移动到解码(decode)worker。解码过程反复读取累积的状态,生成回答 token,而这些回答 token 也被追加到对话状态中。整个过程可能在工具、代理、用户和进一步的输入填充工作之间循环。运行在 GPU 上的模型 worker 只是这座「token 工厂」的一部分;存储、网络和编排将各个阶段连接起来。
在 worker 内部,从一开始就值得区分四种运行状态:
Prefill(预填充):将新 token 组成的初始块一起处理。 Midfill(中期填充):将一个续写请求追加到已有的缓存上下文中。 Decode attention(解码注意力):利用上下文来生成新 token 的基础表示。 Decode experts(解码专家):每个新的基础 token 由从一大组可选专家中选出的部分专家进行精炼。 这些模式对算力、内存和网络的需求各不相同。Prefill 和 midfill 密切相关,Prefill 可以看作是没有任何先前上下文的 Midfill。不过,Prefill 是一种常见的特例,对应于经典“聊天机器人”式的一次性查询使用场景,因此其优化方式可以与 Midfill 略有不同。Prefill 的算术强度(计算量与数据搬运量之比)很高,而且不需要等待上下文的定位和读取。Midfill 则从已有的 KV 缓存所保存的先前状态出发,追加一段新的请求输入序列。由于新 token 较少,而每个 token 需要搬运的已有数据较多,Midfill 的算术强度通常比 prefill 更温和。
Decode attention 和 decode expert 的工作通常算术强度较低,因为与先前上下文或专家权重相比,新 token 的数量很少,而在解码阶段,这些先前上下文和专家权重都是需要搬运的数据。同时,对于所有这些模式而言,注意力所用的张量和专家所用的张量与 token 的取值无关,因此让尽可能多的排队的 token(甚至包括来自其他用户的、恰好在同一时间运行且网络距离足够近以便共享的无关请求的 token)共享同一次张量读取,是很有收益的。如果把这四种模式当作同一种工作负载来处理,就会放弃 MoE 模型在差异化强度和差异化共享模式方面的大部分结构性优势。
在本文档中,我们将分别讨论这 4 个阶段,并且有时会假设它们是分离(disaggregated)部署的。聚合式(模型驻留在同一台服务器上,随着请求的推进在各阶段之间重新配置)和分离式(协调器可以在另一台已按合适方式配置的机器上找到空闲槽位)之间存在权衡。总体上,我们会以分离式的方式讨论各个阶段,并把聚合式视为一种特例,即前一阶段完成时,当前节点总是可用的。在更完整地介绍完需要完成的工作之后,文末将有一节专门讨论这些权衡。
Transformer 模型是由重复的层组深度堆叠而成的。一个层组可能只包含一种层,也可能包含一个全注意力层,并同时搭配若干线性层、局部层、选择性层或其他经过优化的注意力层(这就是混合层组)。在每一层内部,注意力、共享变换、路由、选中的专家以及重组会按顺序依次发生。这些步骤是预先确定的并不断重复,因此同一套硬件资源可以在不同时刻服务于流程的不同部分。
机器同样可以用简单重复的单元来描述。一个节点是一组加速器,通常是机架中的一个托盘,每个加速器将计算与本地高速内存配对。节点由 CPU 协调,并通过 NIC(网络接口控制器)连接到其他节点。节点堆叠构成机架。当处理超大张量时,一个机架可以作为一个扩展域,也可以作为若干个较小的扩展孤岛,或者作为一组流水线阶段。而数据中心网络的作用是将有界的 worker 连接到存储和编排服务,而不参与每一次内部张量运算。
本文遵循这一递进顺序展开。首先介绍全局服务和运行模式,然后将模型拆解为宽泛的层组切片,并将它们映射到加速器节点和机架上。在此基础上,进一步阐述流水线并行、张量并行和专家并行;KV 缓存内存带来的限制;批处理在 prefill、midfill 和 decode 阶段的不同价值;以及调度在多机架 token 工厂中的作用。
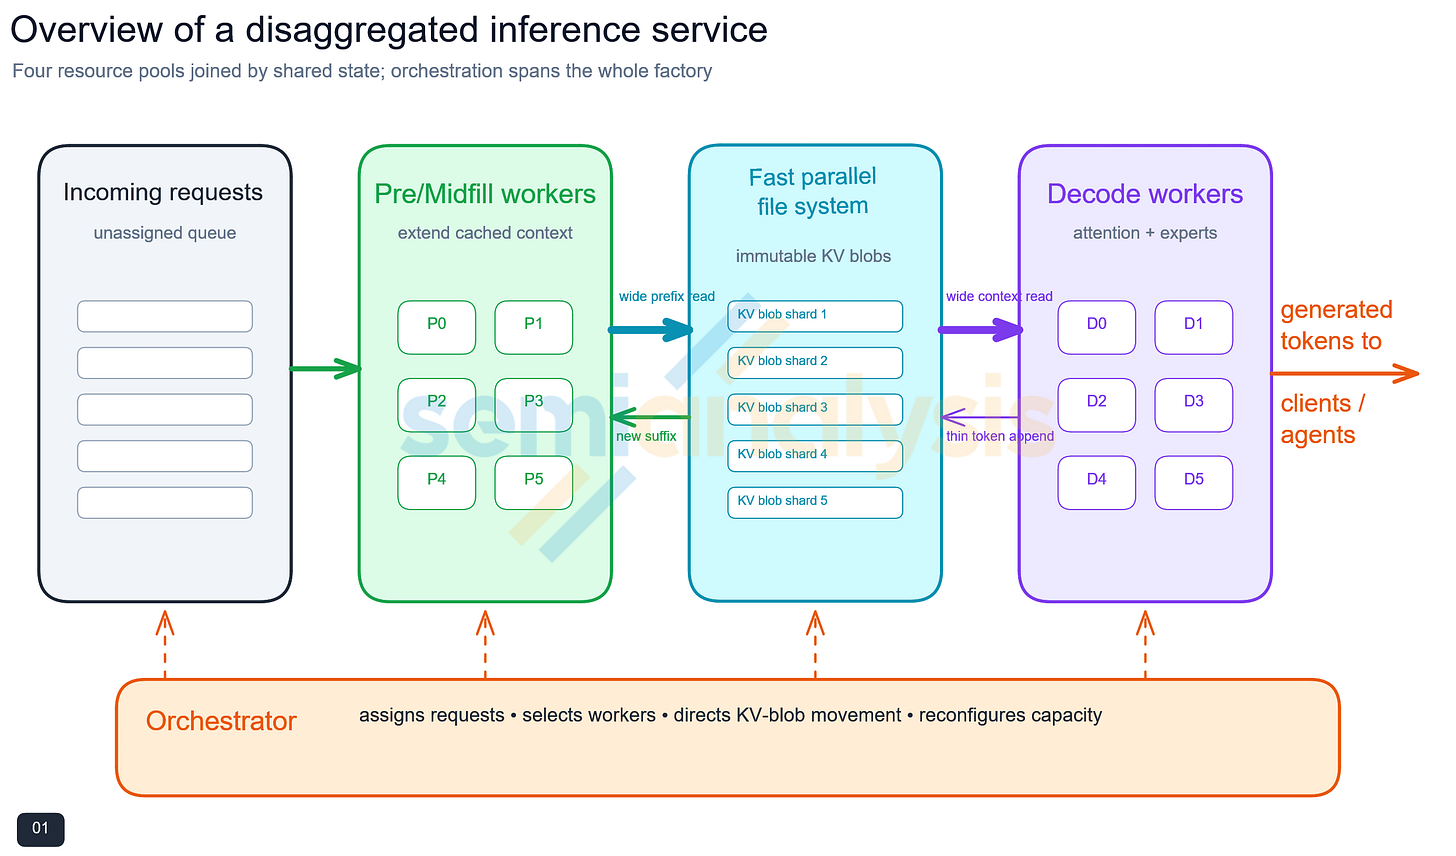
Figure 1. Overview of model stages in an inference service.
1. 编排通过队列将请求交付到 worker 池
推理服务是一个集群:空闲时,先前的请求和不可变状态会被存储起来;当新请求引入上下文,或先前的请求被重新唤醒以继续时,它们会被排入队列,交付给专门的 worker。进入队列的请求还不是 batch。每个请求携带提示 token、对可复用上下文的引用、服务目标,通常还有已有的对话或 agent 状态。编排器可以将其放入 prefill、midfill 或 decode batch,且请求可以随着完成情况独立地加入或离开该 batch,从而将这部分容量释放给新任务。当调度器知道哪些 worker 拥有与请求的上下文长度和服务目标相匹配的槽位时,持续批处理(continuous batching)的效果最佳。
Prefill worker 从一大块新 token 中创建上下文。其输出是每个模型层的新 KV 状态,独立于创建它的 worker 存储。KV 状态沿着模型层流动,某一轮中第 K 层的输出会成为下一轮中第 K 层的输入。在采用流水线方式的服务器中,这自然形成了输出与输入分别通过不同 NIC 的“洪流式”传输。
Midfill 工作节点(worker)负责扩展先前已处理的上下文。缓存的前缀可能包含系统提示、用户提示、记忆、较早的对话轮次、agent 步骤或检索到的文档。较大的根部分可能已经缓存,而增量输入可能远小于规模相当的未缓存请求:一个拥有 50 万上下文的请求可能只接收几百或几千个新 token。
Decode 工作节点(worker)消费已处理、已累积的上下文,并在每次传递中生成一个或几个 token(多 token 预测正变得相当普遍)。每个生成的 token 都会增加少量新状态。当用户、工具或 agent 随后贡献另一块输入时,相同的上下文可以再返回给某个 midfill 工作节点。使用工具的 agentic 工作会反复交替进行上下文扩展和生成,而不仅仅是一次 prefill 加一次 decode。
一个工作节点可以占用一个节点(node)、一个托盘(tray)或一个机架(rack)。服务通过运行许多有界(bounded)的工作节点,并在它们之间迁移请求和状态,从而实现大规模扩展。取决于精度和工作状态的要求,即使是数万亿参数的模型也可以放入现代机架级系统的总内存中。数据中心网络仍然不可或缺,因为工厂必须将众多这样的工作节点连接到共享存储,并持续使工作节点的配置与需求相匹配。KV 传输可能达到 GB 级别,但它们可以跨多条链路和多个目的地进行条带化(striping)或类似种子下载式(torrent)的并行分发;其传输时间仍可远低于一个长时间 decode 任务的持续时间。
这种分离对性能和运维都很有用。一旦已知缓存前缀大小、新 token 数量和工作节点配置,prefill 和 midfill 就是可预测的。而 decode 的完成时间是随机的,因为无法提前预测最终输出 token 何时到来。两个池之间共享内存和存储,使每个阶段都能按自己的节奏运行。本文后面的章节将讨论队列、就绪缓冲区(ready buffer)和工作节点重配置。目前需要强调的重点是:该服务是一个由可迁移状态连接起来的、循环运转的多个阶段。
AgentX 示例
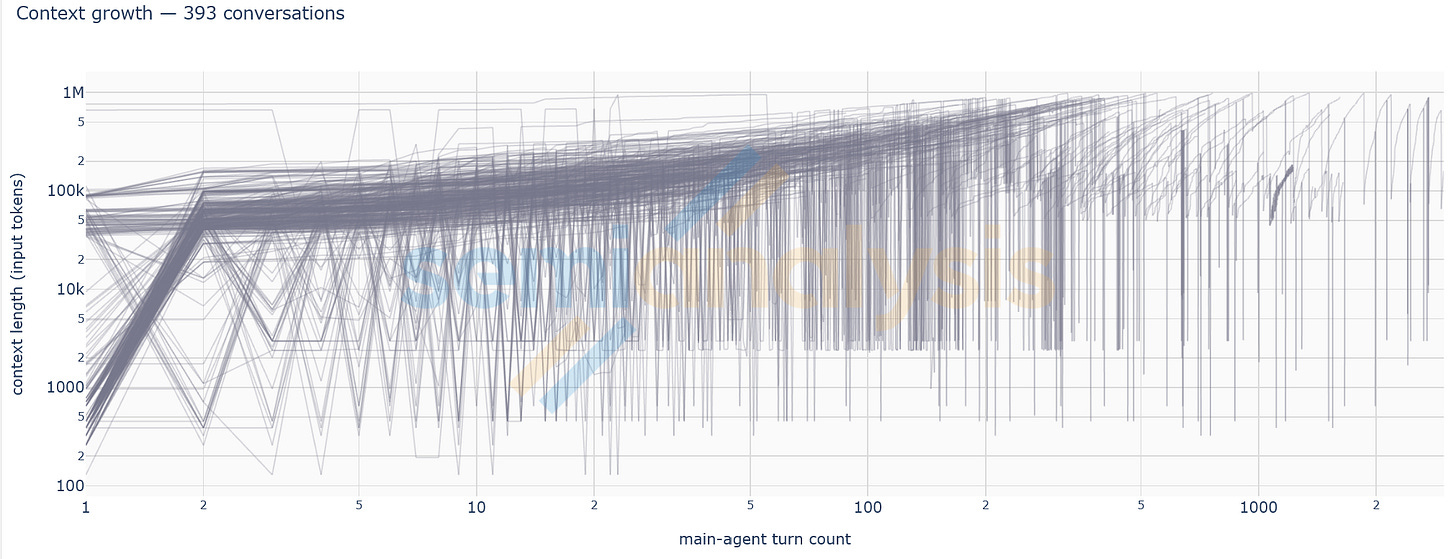
Figure 2. “CC Traces Weka” dataset contributed to AgentX, release 34. Source: SemiAnalysis AgentX.
这些内容通过 SemiAnalysis Conversation Explorer 进行观察。它表明,对话期间的上下文增长可能非常迅速,同时也会因压缩(compaction)以及其他在公开讨论中可能没有解释过的模型行为而产生剧烈波动。推理上下文的编排是 AI 公司的一项竞争优势。
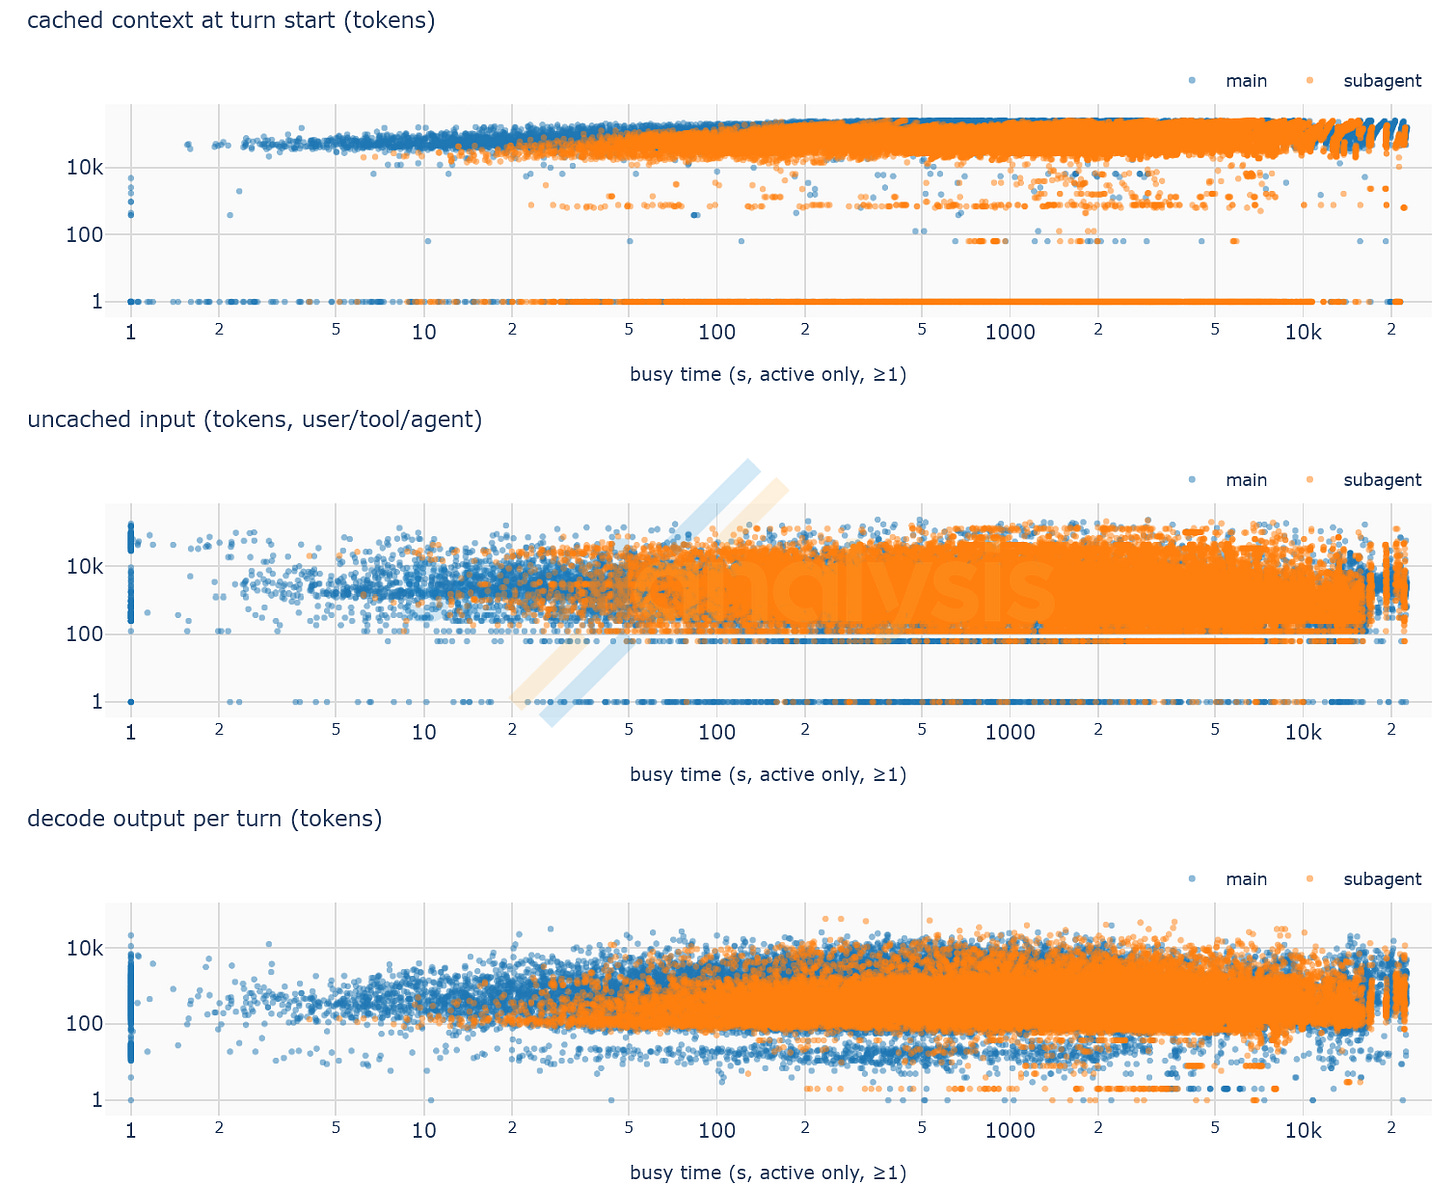
Figure 3. Cache, new input, and result lengths seen at each turn of the same conversations. Source: SemiAnalysis AgentX.
我们可以拿同一份数据集,提取每一轮中出现的缓存、新输入和结果长度数值。这张图展示了 Token Factory 需要服务于多么多样化的工作负载。原则上,这些轨迹中的每个点(以及来自其他工作负载数据集的更多点)所对应的请求都可能同时运行,并被分配到 AI 集群中的某个工作节点上。
本文旨在概览推理中使其成为可能的一些主要功能,
2. KV 状态以不可变 blob 的形式迁移
在数据中心规模下,可复用的上下文不再是一台机器上的文件,而是一个由不可变 blob 组成的共享对象存储。系统提示词、项目上下文、之前的用户对话轮次、工具输出以及生成的 token 可以分别存放在不同的 blob 中。新的操作读取所需的 blob 并追加新的 blob;已有的 blob 通常保持不变。这种只向前的结构与因果 transformer 本身是一致的。如果需要变更,可以通过回溯并创建新分支来处理,而不是重写公共路径。
这些 blob 的持久化数据源是一个快速、并行、可横向扩展的内存与存储池。它需要足够的聚合带宽和网络覆盖范围,这样 prefill、midfill 和 decode 工作节点就可以根据适配性和可用性来选择,而不是因为某台机器持有上下文的唯一副本。新近空闲的 blob 可以先移入共享的网络挂载 DRAM,包括节点 CPU 内存和专用内存设备。当这一层被填满时,分类器可以丢弃不太可能被复用的 blob,或者将存活时间较长的状态提升到 SSD。底层文本和引用通常比扩展后的 KV 表示小若干个数量级,因此如果分级策略决定复用空间并丢弃了扩展的嵌入状态,也可以从较小的文本重建 KV blob。AI 计算结果可能存在细微差异,因此虽然重建的状态可以预期是有效的上下文,但各家服务在丢弃与重建的随意程度上,以及在对重要不可变状态的保留程度上,可能会采取不同的策略。
如果想深入了解这些 blob 是如何管理的,推荐阅读 Unified Radix Cache: One Tree for Hybrid Model Prefix Caching - LMSYS Org。它不是最终结论,但写得很清晰,如果你想进一步探索,它会指引你找到其他资料。
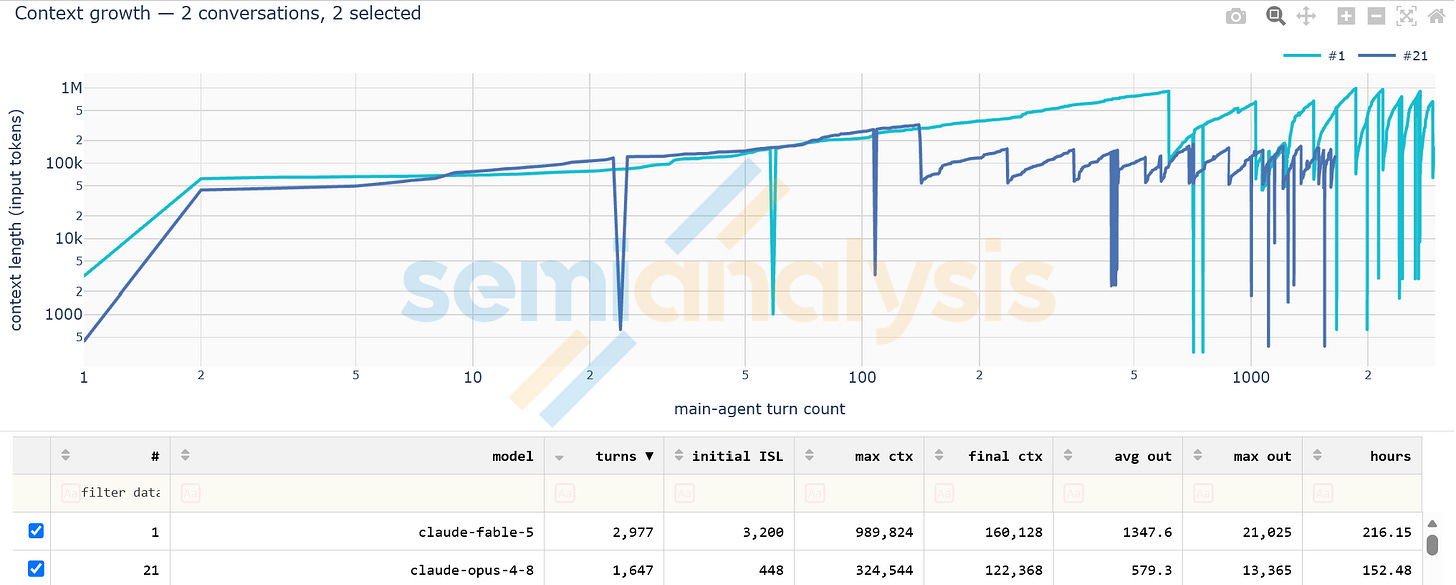
此外,对于长期运行的 agent,状态压缩也很频繁,它们会逐渐积累到最大上下文。因此一般来说,每次压缩之后会有许多旧 blob 被废弃,取而代之的是新的上下文。压缩前上下文占用的空间很可能被回收用于新的工作。
Figure 4. AgentX release 34, selected conversations. Source: SemiAnalysis AgentX.
你可以在这些对话的后半部分看到压缩的发生,此时上下文接近各模型的实际上下文限制(Opus 4.8 为 250k token,Fable 为 1MT)。两条曲线中还出现了看似短暂的“钟乳石”形状,这反映了 Anthropic 模型中的一些专有行为。
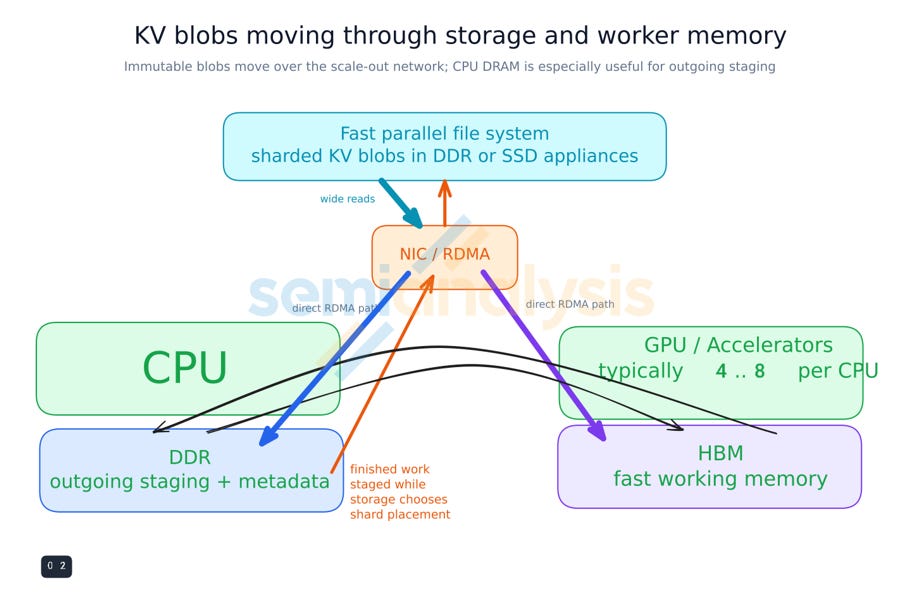
加速器的 HBM 是“热”工作层。它成本高昂且供应受限,不适合作为被动上下文存储的默认选择。活跃前缀和后缀应在即将使用时进入 HBM,并在 worker 用完之后尽快移出。CPU DRAM 是一个有用的暂存和组装层,尤其适用于输出状态:一个已完成的 worker 可以将新生成的数据块移入 CPU 内存,同时由存储系统决定其放置位置和冗余策略,之后 NIC 再将它们发送到共享池中。
对于输入数据,支持 RDMA 的系统可以让网络直接将数据放入加速器内存,从而避免经由 CPU DRAM 的完整拷贝。CPU 内存仍然可用于元数据、协调、部分组装、回退路径、副本以及输出暂存。当 worker 使用多个 GPU 时,输入上下文可以并行地直接分发到各自的目标内存中。
机架级热数据块缓存也很有用,可以通过内存/存储设备实现,也可以利用分配给分布式存储池的 CPU 内存。像系统提示词这类非常常见的对象就是天然的候选者。这些缓存应保持为共享的横向扩展资源,而不是将请求绑定到单一解码机器的私有状态。HBM 比 DDR 贵数倍,且供应更受限。HBM 的最佳用途是当前正在创造收益的活跃批次中的数据。
Figure 5. KV blobs moving through storage and worker memory.
数据输入通常大于输出。Midfill 通常读取一个大前缀并追加一个有意义但较小的后缀。Decode 则读取累积的上下文,且只追加一个或少量生成 token 的状态。读取是重复的,而写入通常只发生一次。系统设计应该通过每条数据路径的宽度直接体现这些差异。
3. Prefill、midfill 和 decode 形成了不同的运行模式
全局服务包含多种计算模式。它们之间的差异比“计算受限”和“内存受限”这类笼统标签更有价值,因为每种模式在重用机会上各不相同,在硬件上的自然映射方式也各不相同。
3.1 Prefill
经典 prefill 从几乎没有可重用 KV 状态开始,处理一大块新 token。这些 token 共享权重加载,高效地执行矩阵运算,并产生足够多的路由激活以形成有用的共享专家批次。注意力和稠密变换可以达到很高的算术强度,因此 prefill 通常主要受计算能力限制。较长的初始输入上下文会增加内存流量,但很少达到 100,000 个 token 的长度,而 midfill 通常会超过这个规模。
3.2 Midfill
Midfill 会将新 token 追加到一个长得多的已缓存前缀之后。新的计算块仍能为共享权重和专家复用提供成百上千个激活值,从而将算术强度提升到每字节数据数千次运算的水平。同时,注意力机制还必须读取一个庞大的既有 KV 状态,其规模可能达到数十 GB。因此它处于一种混合状态:算术复用程度高于 decode,但缓存状态的流量却远高于对相同数量新 token 执行的初始 prefill。
3.3 Decode 阶段的注意力
Decode 阶段每次查询只处理一个或少数几个输入 token,向前推进。每个查询都携带自己的 KV 状态,其长度与 midfill 所处理的相当。如果说 prefill 与 midfill 的区别在于缓存长度,那么 decode 与 midfill 的区别则在于输入序列长度。这一个到几个输入 token 使得算术强度保持在较低水平,这项工作显然由围绕 KV cache 的内存搬运所主导。
对于长上下文而言,注意力的读取量可能超过与模型权重相关的张量运算规模。因此,尽管大多数模型参数都位于专家(网络)中,注意力仍是现代 decode 阶段中规模最大的运算之一。Delta、top-k 或线性注意力算法层可以减轻这一负担,但周期性地使用一层全注意力仍然是一项重大的内存负载。由于每个查询都携带自己的上下文,批量处理查询并不会改变注意力的算术强度。
3.4 Decode 阶段的专家
专家并非 decode 阶段所特有。模型在哪里运行,专家就在哪里运行,而且除了单个 token 的嵌入之外,它们不需要任何其他上下文。查询的历史信息已被压缩进呈现给专家的激活值中。这使得各种设计能够跨所有可用 GPU 共享专家,从而降低每块 GPU 的内存占用,并提升内存带宽与内存容量之比(即内存强度比)。你可以将 GPU 读取其全部专家所需的时间间隔视为交互性的最佳情况(每个用户看到的 token 速率)。因此,如果内存带宽保持不变,而 GPU 负责的专家数量更少,交互性就可以更高。但问题在于,网络需求也会随之上升,而且路由到专家所需的 all-to-all 通信模式是一种非常难以处理的模式。
在注意力计算结束时(无论是 prefill、midfill 还是 decode 阶段),一个路由计算(一个作用于未精炼 token 的小型张量)会为每个新 token 选择少量专家。选择了相同专家的 token 可以共享一次张量权重的加载,即使它们来自不同的请求,只要它们能被及时汇集到一起,利用同一次权重加载即可。实际中,所有层加起来可能有 15,000 个专家,因此要利用这种巧合,就需要刻意的同步,比如等待一个批次中的所有查询都完成注意力计算后,再将它们切换到专家处理阶段。而这又可以进一步改进:让附近不同机器上的多个实例也同步到这个调度。如果你曾好奇 Nvidia 为什么要如此费力地将 72 个 GPU 紧密连接起来,这就是其中一个重要原因。在一个大型 token 工厂中,让这 72 台机器全部同步运行是可行的,这样某一层的专家就可以被拆分成多达 72 份。如果模型的一层有 256 个专家,那么每个 GPU 在每一层只需处理 3 或 4 个专家,从而可以极快地完整轮转所有专家。当然也需要大量的 all-to-all 流量。
如果你的所有专家都能放进 SRAM,就会发生一些有趣的事情。你需要数量庞大的加速器和一张怪兽级网络,把所有专家通过 all-to-all 方式汇聚回 GPU,但此时几乎没有必要再等待批次形成。每个专家只要有输入就可以立即运行。每字节加载的能耗比从 HBM 加载最多可好上 100 倍,因此单个 token 的运行效率,可能相当于过去大约 100 个排队 token 的水平。作为这种 DAF(disaggregated attention-FFN,即用专家充当 FFN)架构的回报,你可以让各个实例摆脱同步的约束。这一优势对 prefill 或 midfill 的帮助没那么大,因为它们天然拥有一批 token,可以在某一层上将其归类到共享队列中。但它仍然可以把所有专家权重从这些 GPU 上卸载下来,让它们能把本地内存优化用于其他用途,比如更长的上下文。网络仍是一个隐患:基于 SRAM 的加速器可以在不到一微秒内完成一次专家计算,但如今你可能正在用数百万个 token 的 all-to-all 流量,冲击一个连接着数百个节点的交换机。网络所消耗的资金和电力,可能会超过它所连接的专家本身。
Figure 6. Prefill and midfill are separated from the closely coupled decode loop at the KV-cache boundary.
推理 worker 可以通过在同一模型层上协调多个 attention 实例来改善共享效果。它们的路由激活随后从同一层的专家库中提取,从而减少每个目标需要加载的不同专家数量。在流水线式服务器中,这意味着用于专家并行的网络连接可以局限于机器的该流水级内部,永远不会出现需要另一层专家的路由。即便如此,每个解码请求在单次前向中通常只产生一个新 token,涉及 8 到 16 个路由专家,而一层可能包含数百个专家。在小批量下,共享仍然有限,内存带宽依然是 KV 扫描和活跃专家加载的主要瓶颈,每加载一字节权重所对应的计算量非常少。无论使用哪种类型的内存,专家内存都需要做到极低的每比特能耗。
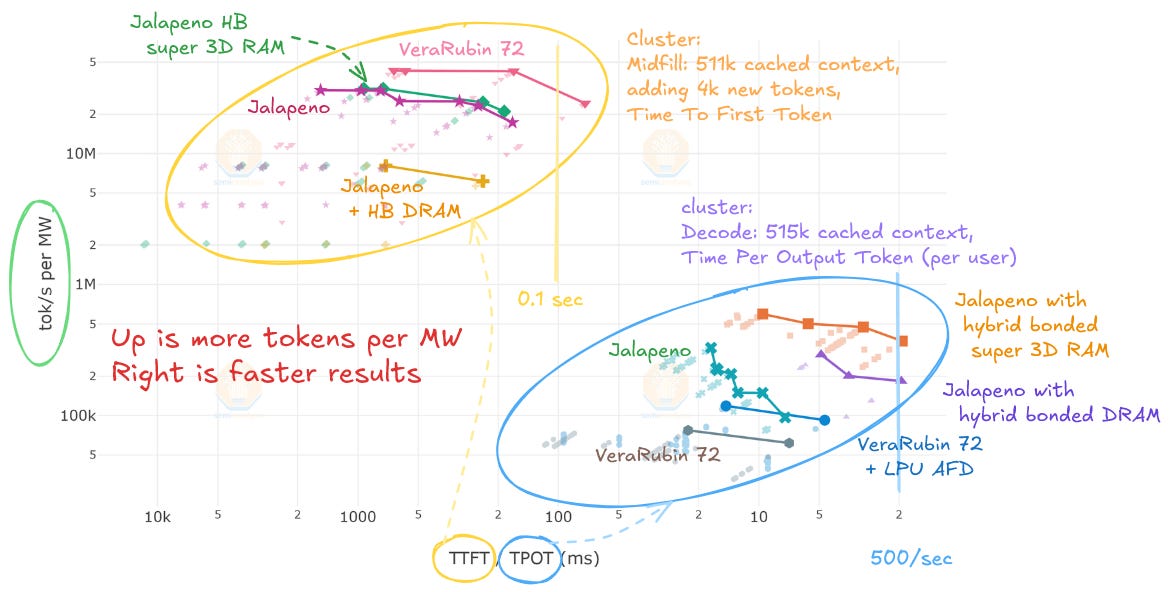
这些不同的运行模式解释了为什么 prefill、midfill 和 decode 可能偏好不同的 worker 配置;为什么 decode attention 和 decode 专家可能偏好节点内的不同部署位置;以及为什么批处理对每个阶段的帮助程度各不相同。随着现代 agent 工作负载的 prefill 快速扩展到 500k token 量级,内存数据搬运量变得非常庞大,尤其是在 token decode 阶段——模型正是在这个阶段生成有用的中间结果和最终结果。快速且大容量的 3D RAM 对效率将起到决定性作用。快速内存对 midfill 也很有用。然而,对于如今已司空见惯的超大上下文,容量必须达到一个最低水平。如果内存容量太小,网络开销和过多的芯片集群会浪费功耗,相比之下,未来的内存类型将利用 3D 容量扩展,同时不牺牲吞吐量。
Figure 7. Projected effect of faster memory (hybrid-bonded DRAM, super-fast 3D RAM)) on midfill and decode with 500k token context cache length. Source: SemiAnalysis model simulator with projected accelerator and GPU performance.
Vera Rubin 72 可以在算力密集的 midfill 层大展身手,但在切换到内存密集的 decode 时就没那么高效了,此时 Rubin 无法充分发挥其计算实力。在大上下文场景下,把 decode 工作和 midfill 保持在同一节点内非常关键,要避免把上下文通过网络传送到另一个节点。这就有利于选择一款兼顾超高中内存吞吐和真正高效计算能力的全能型芯片。
4. MoE prefill 层的数据流
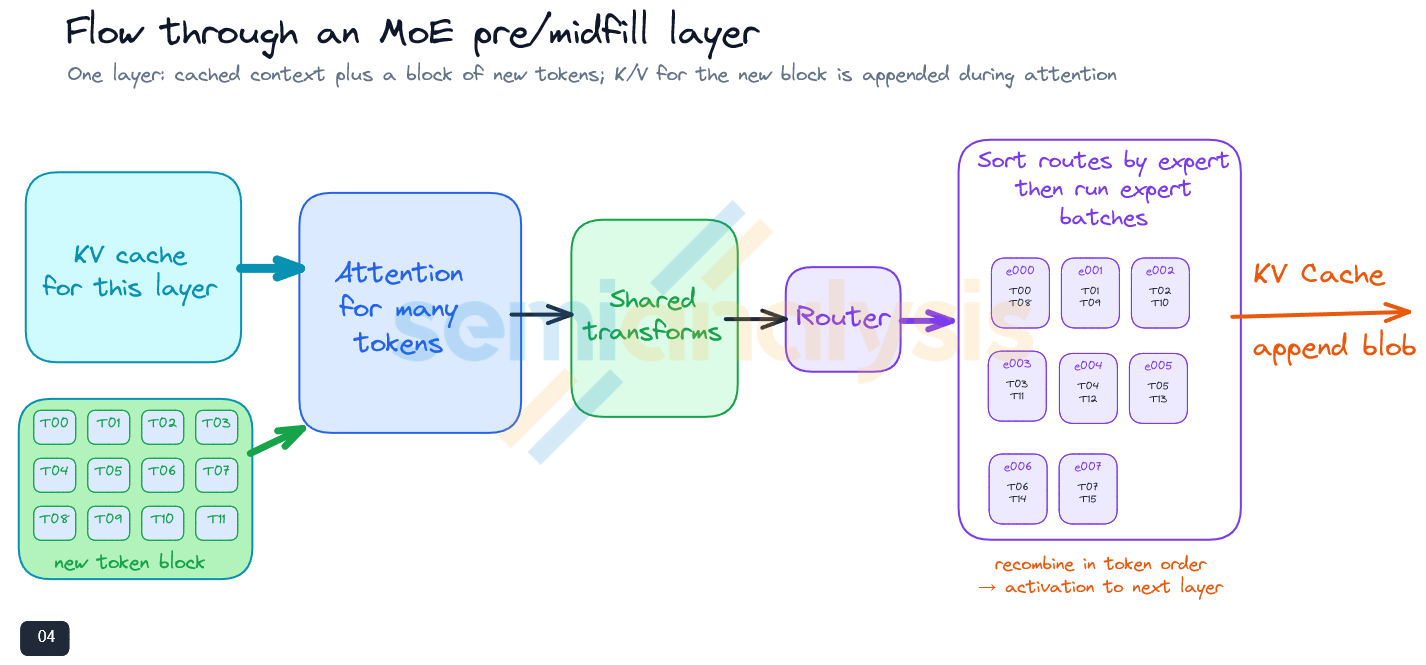
经典 prefill 以 attention 开始。一组新的 query token 会关注可复用的前缀(如系统提示词)以及新块中较早的位置。attention 操作为每个新 token 产生一个激活,随后由共享变换将这些激活准备好,送入路由专家阶段。
路由器会为每个 token 分配若干专家。如果模型选择了 8 个路由专家,那么每个输入 token 会在一个可能包含 256 个或更多专家的专家库中产生大约 8 条路由。按 token 顺序来看,这些记录是稀疏且交错分布的:相邻的 token 可能拥有完全不同的目的地。但在整个输入块范围内,每个专家都可以积累一份分配给它的 token 短列表。
工作节点按专家标识符对这些路由记录进行排序或排队。所有分配给专家 037 的激活值构成一个消息流;分配给 142 的构成另一个。这样一来,一次专家权重加载就能服务于该桶中的所有激活值。多个请求可以贡献到相同的桶中,运行同一层的多个独立 attention 实例也可以在专家目的地合并各自的路由工作。将 token 顺序转换为专家顺序是 MoE prefill 的核心效率来源之一。像 NVLink 这样的纵向扩展(scale-up)网络可以组织为内存映射连接,因此向特定专家发送请求可以映射为将消息推送到一个配置为硬件队列的特定内存映射位置。这种方式几乎没有启动和停止的开销。专家可以借助类似 RDMA CIQ 的机制进行监听,同样利用硬件加速来交付消息流,而无需复杂的协议启动与停止过程。消息中内联的简单头部标识了发送方和接收方。从专家返回解码工作节点的回流方向也可以建立类似的连接。
专家的输出被转换回 token 顺序,经过加权、合并后传递给下一层。与此同时,attention 会为新增的 token 创建新的 K 和 V 状态。在整个模型范围内,这些值构成一个不可变的 KV 后缀,用于解码下一个 token,并最终作为下一个 blob 存储到上下文中,供对话的下一轮使用。
因此,prefill 结合了两种形式的权重复用。Attention 和稠密变换在多个 token 之间复用权重,而路由专家则在各自桶中收集的 token 之间复用每个被选中的专家。随着激活流量、KV 流量和输出处理相比张量计算占用更多时间,收益最终会趋于平缓。批处理可能会延迟首 token 的生成时间,但一个包含数千个新 token 的单个请求本身就能提供可观的算术强度;prefill 并不总是需要每个批次中有大量请求才能高效运行。对于较小的批次,现代单插槽 GPU 即使在大型模型上执行 prefill 也可能只需一秒左右。
Figure 8. Flow through an MoE prefill layer.
5. MoE 解码层的处理流程
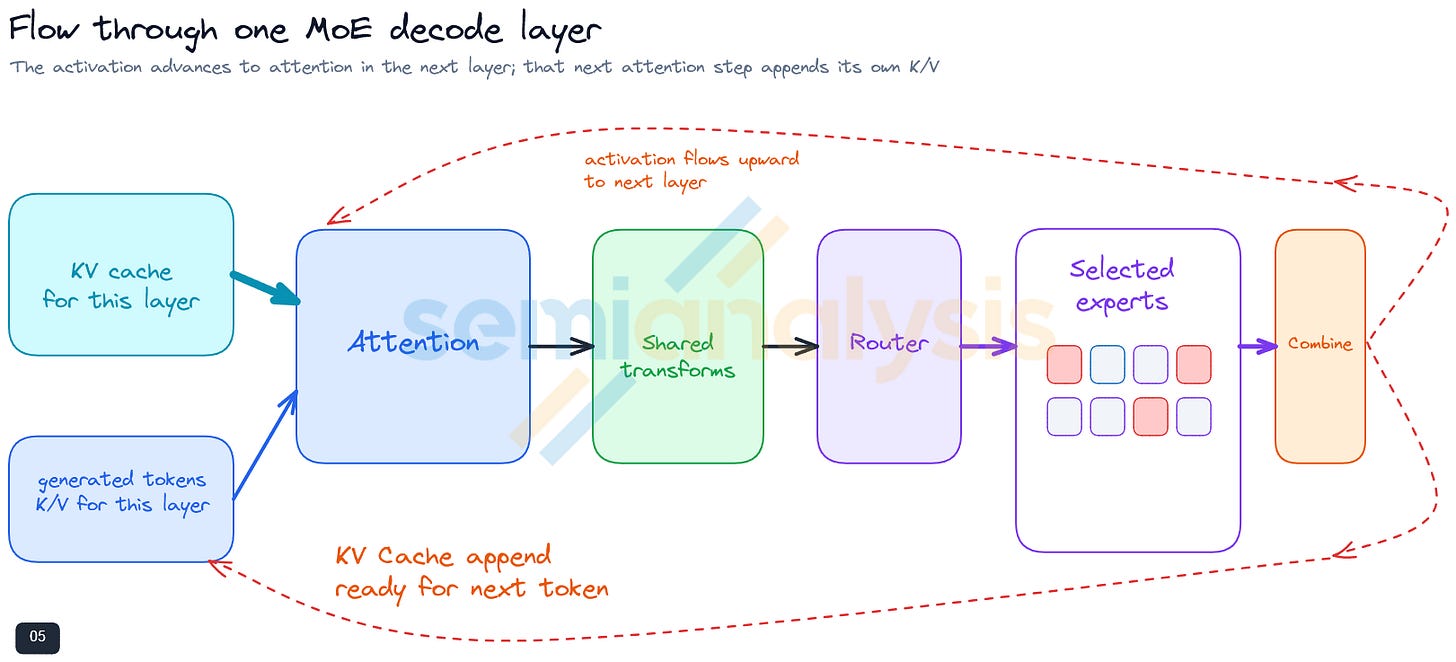
解码阶段每次前向传播的新增计算量要小得多。当前 token(或 MTP 多 token 预测中少量被推测出的 token)作为查询。注意力机制会读取之前的 KV 状态,同时读取新 token 的 KV 条目。新条目会被追加到结果中,并写入 KV 状态,供下一轮传播使用。
在智能体(agentic)场景中,读取已有 KV 状态的负担往往比该 token 所需的注意力权重和专家权重要重得多。新的查询及其本地投影权重相对紧凑。注意力计算可以按 KV 头、上下文区间、内存通道或加速器单元进行划分,各部分结果随后归约为单个 token 的激活值。这个激活值足够小,传输开销很低,尽管它会在下一阶段触发规模大得多的本地张量运算。
激活值随后经过共享变换和路由。路由器从可用专家库中选出少数几个专家,只有这些专家的张量会在当前 token 上激活。它们的输出经加权、组合、投影后继续向后传递。
在每一层,注意力机制会为新 token 创建并保存该层的 K/V 条目。激活值随后进入下一层的注意力计算,重复相同的流程。当最后一层生成下一个 token 时,每一层都已追加了其小幅的 K/V 更新。在这些 token 流式传输给客户端或智能体的同时,这些更新可以被组装成一段新的不可变 KV 后缀。
因此,这一流程既包含一个宽泛的操作,也包含一个稀疏的操作。注意力会广泛读取私有的查询状态,而专家只激活模型总容量中的一小部分。硬件映射应当同时支持这两者,而不是强迫整个层采用单一的并行策略。
Figure 9. Flow through one MoE decode layer.
6. Midfill 是一种独特的运行模式
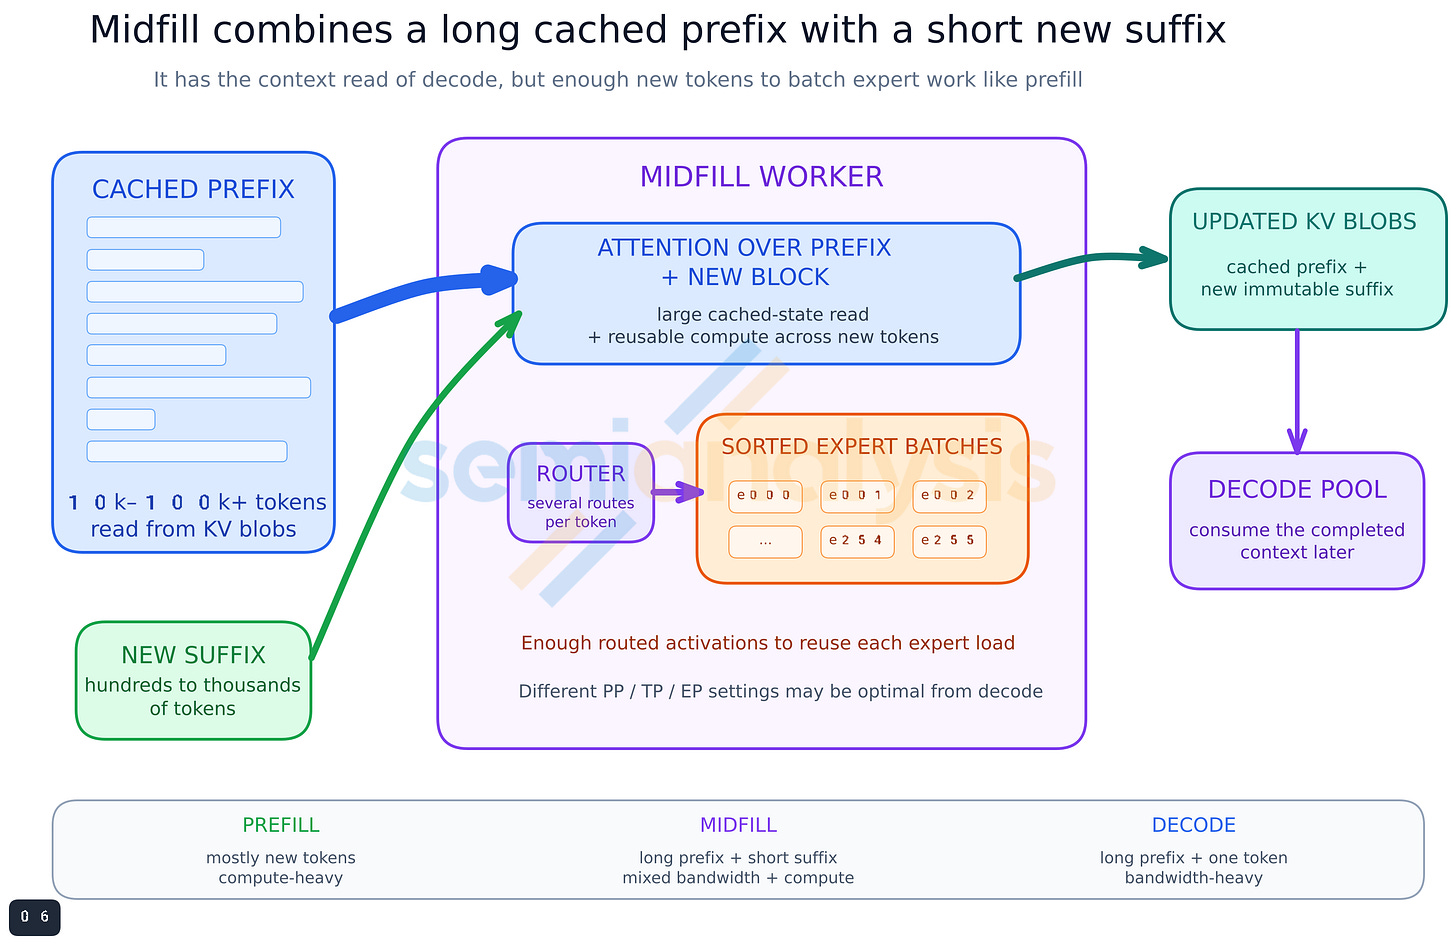
Midfill 将较长的缓存前缀与一段新 token 结合,为对话或智能体任务的下一轮做准备。跟踪数据显示,缓存输入的规模往往是增量查询的许多倍,尽管增量查询通常包含 50 到 5,000 个新的输入 token。缓存中的系统提示、对话根节点、记忆、先前的智能体步骤以及检索到的文档,可以很快将对话和智能体上下文推高到百万 token 的上限。AgentX 数据集显示,前沿专家模型为了保持在百万 token 上限之内,需要反复压缩上下文。
这使得 midfill 既不是小规模的 prefill,也不是大规模的 decode。与 decode 类似,它必须读取大量的私有 KV 缓存;与 prefill 类似,它要处理足够多的新 token,以便复用权重,并将路由后的激活值整理成有效的专家批次。其算术强度可以比单 token 解码高出数百倍,而其缓存状态的流量又可以比同等规模的初始 prefill 大上数十倍。
现代加速器通常能够利用数百个 token 组成的数据块中的算术复用机会,因此真正的权衡难点往往在于大规模的 KV 读取与路由专家流量突发之间。这种突发流量与解码流水线的平稳节奏并不匹配:一个 midfill 可能长时间占用某个流水段,远超相邻流水段中解码批次所需的时间,从而导致那些流水段利用不足。
理想的并行策略也可能有所不同。本文后面的示例发现,midfill 配置所使用的流水线、张量和专家并行设置与解码阶段并不相同。在正在运行的解码流水线中途重新配置 GPU,代价可能很高昂,甚至不切实际。因此,服务或许可以从一组专门针对 midfill 优化的节点中获益。这些节点的硬件可以与解码节点池完全相同,只是加载的模型阶段、并行策略和批处理策略有所区别。
Figure 10. Midfill combines the cached-state read of decode with enough new tokens to batch model and expert work.
7. 模型是一个由重复层组堆叠而成的高耸堆栈
模型的参数数量衡量的是其学习到的总状态量,但服务部署的效率取决于这些状态如何组织和调用。模型是由许多层堆叠而成的,而将层组织成重复的架构单元正变得日益重要。
在某些 MoE 模型中,一个层组就等于一层。而在另一些模型中,一个层组包含一个全注意力层,以及若干线性注意力、delta 注意力、top-k 或其他经过优化的注意力层。通常,开头的 1 到 3 层可能是稠密层,或采用其他设计以获得干净的初始状态。模型的其余部分通常会重复同一个循环出现的层组模式。
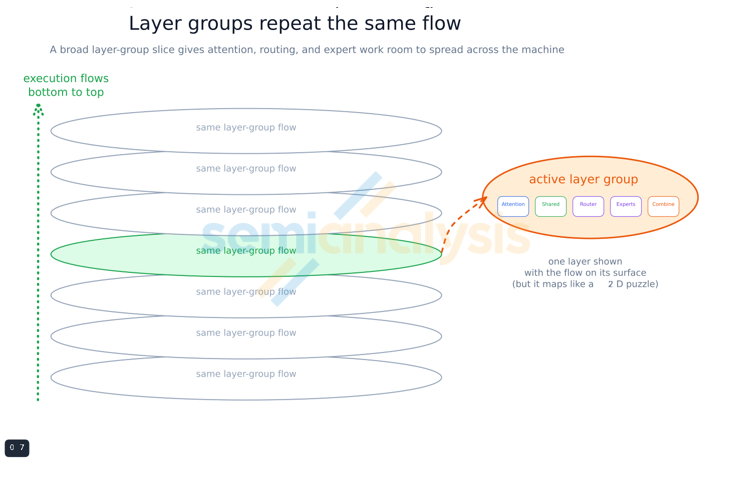
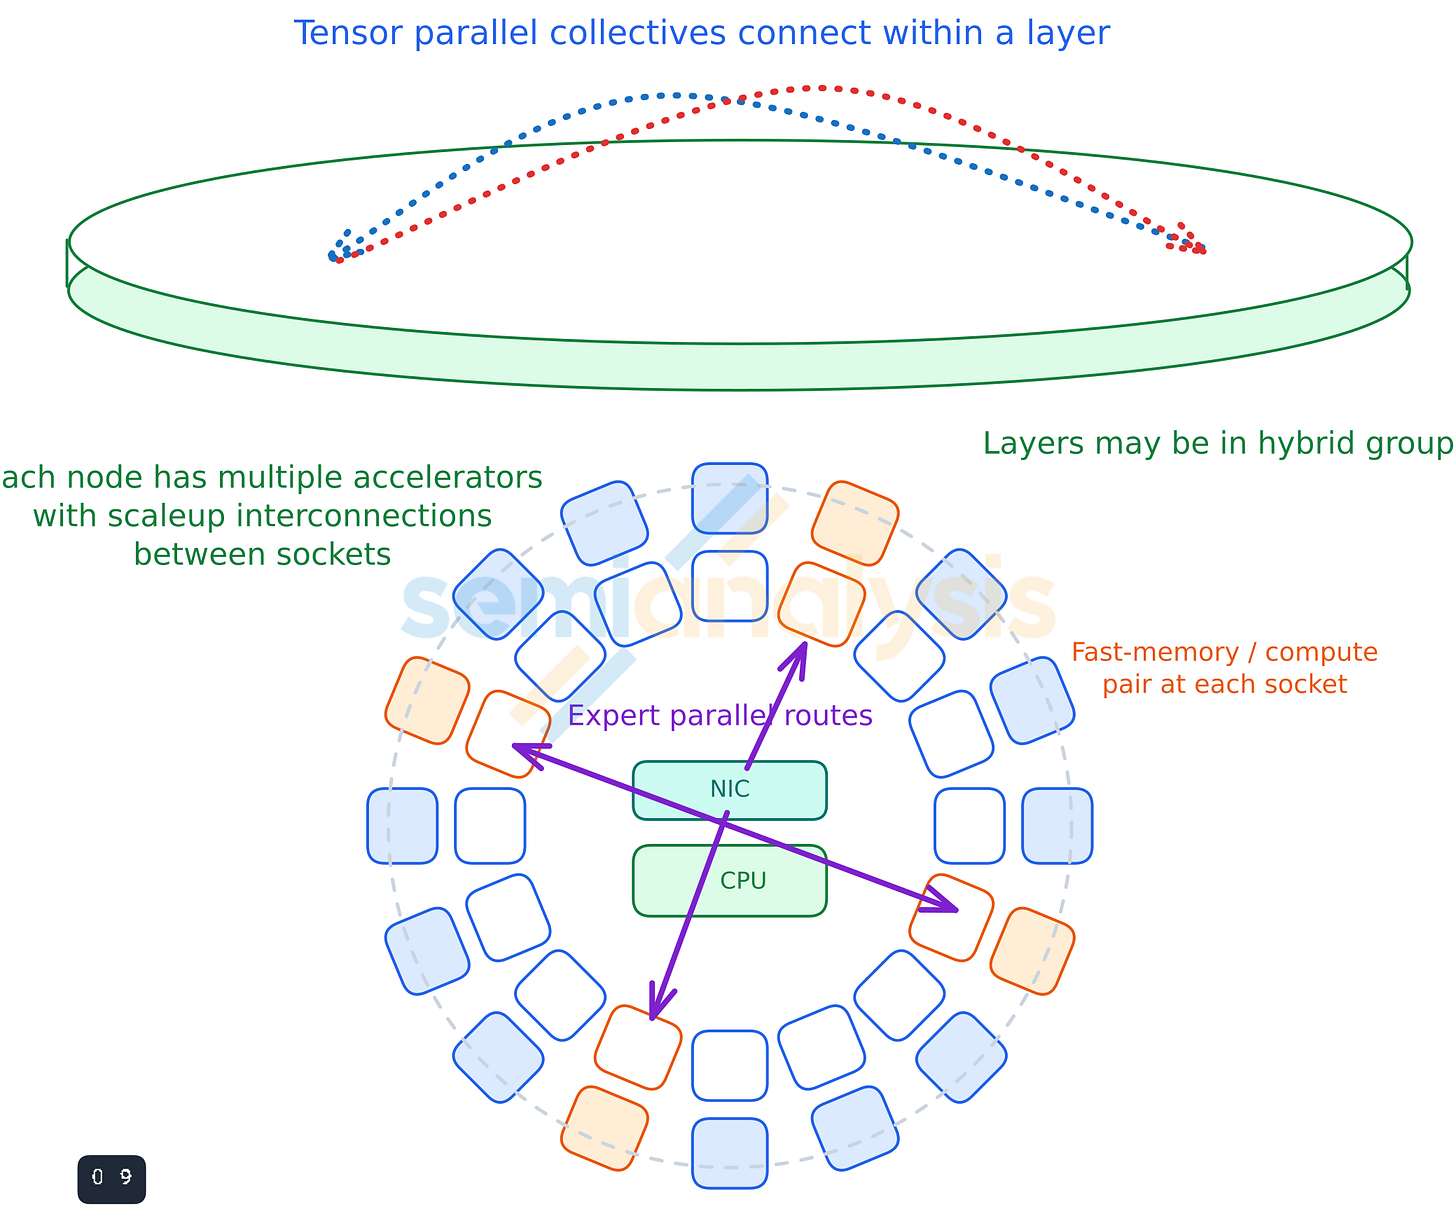
一张宽而薄的法式可丽饼是表示层组的一个直观形象。宽大的表面为注意力、共享变换、路由、专家容量和残差流提供了充足的空间;而较薄的厚度则表明这个层组只是整个高得多的重复模型中的一个切片。它也与加速器的物理形态相呼应:一层非常薄的有源逻辑摊开在宽阔的封装之上。这种可丽饼的比喻有助于将宽泛的算法数据流映射到宽阔的硬件表面。
重复的结构简化了功能规划。为某个层组创建的映射可以直接复用到下一个层组。对应的内存区域可以存放下一个层组的权重。同样的计算和通信方案可以反复执行。这种一致性不仅对运行时效率很重要,对编译器、内核和运维工具同样重要。
Figure 11. Layer groups repeat the same flow.
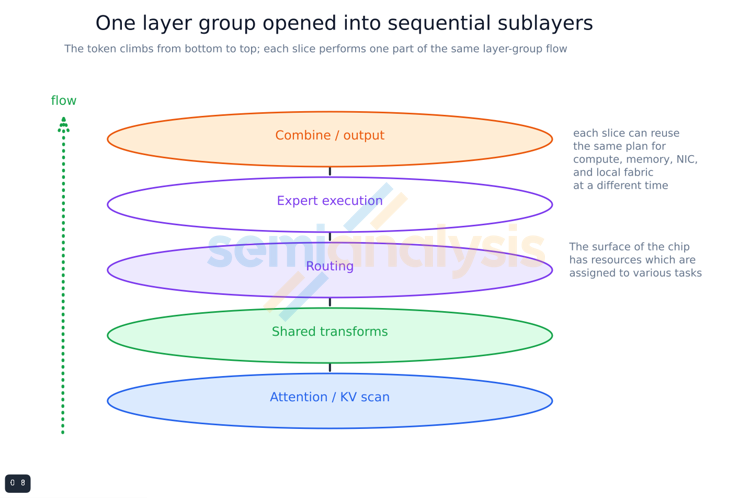
在解码过程中,对于某个特定 token 而言,同一时刻只有一个层处于活跃状态。在该层内部,多个操作按顺序依次执行。相邻的层可能会被预取,不同的流水段也可能同时处理不同的查询,但单个 token 的逻辑路径仍然按顺序逐层向上穿过整个堆栈。
Figure 12. One layer group opened into sequential sublayers.
8. 并行策略应当切分模型中狭窄的数据流
并行化并非一个单一的决策。流水线并行、张量并行和专家并行分别切分模型的不同维度,也应当用不同的通信模式来评判其优劣。
流水线并行沿袭层堆叠结构
层级结构天然适合流水线化。层与层之间传递的激活值很紧凑——通常是一个嵌入 token、一个小的多 token 预测块,或先前混合组结果的简要摘要——而层内部使用的权重和 KV 状态则大得多。因此,一个流水线阶段可以持有一个或多个完整的层组,并把相对较小的激活值传递给下一个阶段,而无需强大的网络支持。
流水线化能干净地划分模型权重,并让层内的热点通信保持在本地。它的主要缺点是多批次占用:一个满负荷运行的流水线中,每个阶段都持有不同的查询或批次。因此,每个阶段都要为所有活跃流保存其相应的 KV 状态份额,随着上下文增长,这种内存上的收益最终会停止提升。
张量并行适用于本质上宽泛的单个运算
注意力机制可能需要将权重和 KV 状态分布到多个加速器上。可以对 KV 头、上下文范围或其他某个线性维度进行划分,让每个加速器先处理自己的份额,然后对 token 结果做一次紧凑的归约。张量并行也可以服务于异常庞大的稠密变换。
TP 不应自动蔓延到层内的每一个张量。对一个宽泛注意力运算来说合理的集合通信,其开销可能超过一个小型专家张量本身的计算量。
专家并行沿袭相互独立的专家张量
MoE 的大部分参数内存可能都在专家中。专家本身不保留任何查询历史;上下文信息都包含在激活值中传递过来。因此,专家库可以广泛地分布在一组对等节点之间,并由多个工作实例共享。
专家并行可以铺得很宽,因为专家之间相互独立且数量众多。路由器将紧凑的激活值发送到选定的目的地,这些目的地再返回变换后的激活值。即使流水线阶段变小,专家并行的宽度依然可以保持很大,从而使交换基数和本地内存布局能够独立选择。
总体规则很直接:垂直的层序列使用流水线并行,大型不可分割的运算使用张量并行,无上下文依赖的路由专家库使用专家并行。当一个阶段的可用快速内存安全地超过其本地权重、活跃批次状态和工作缓冲区之和时,它就能舒适地容纳在一个纵向扩展域内:
M_{free,node}>\frac{W}{P}+M_{batch}+M_{working}
现代 GPU 节点往往能以数倍的幅度超过这一阈值。这样一来,苛刻的带宽、功耗和延迟需求就可以留在单个节点内部,而较轻量的流水线激活值和 KV 迁移则使用横向扩展链路。其余的快速内存很可能没有产生任何收益。闲置在内存中的数据是成本,被移动去处理的数据才是收益。
Figure 13. Pipeline, tensor, and expert parallelism follow different dimensions of a layer group.
9. 逻辑加速器节点
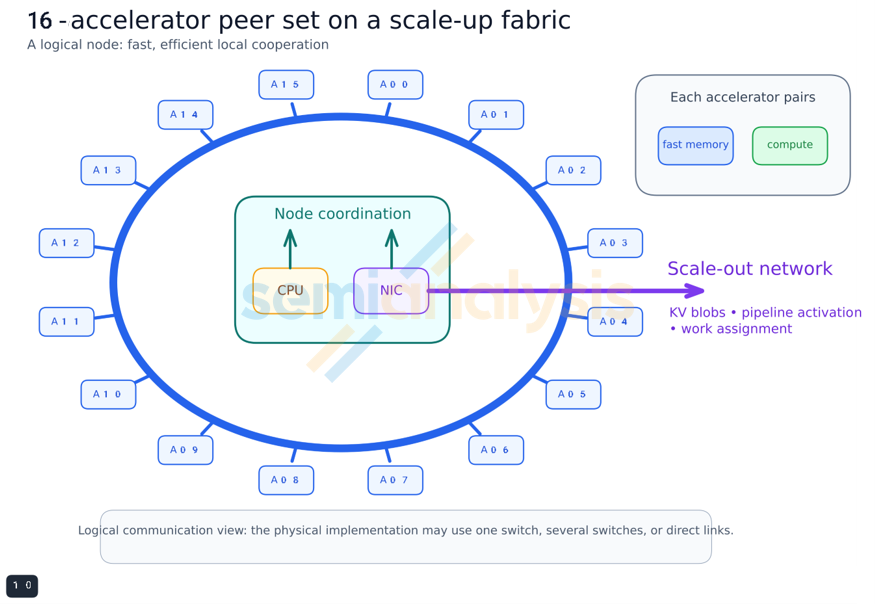
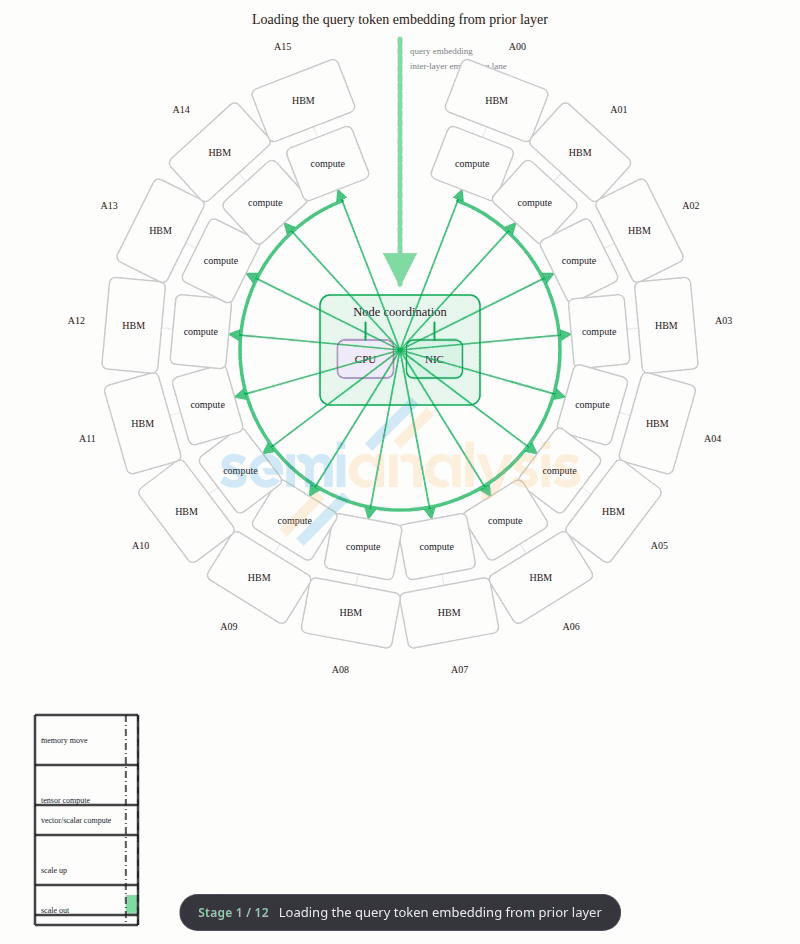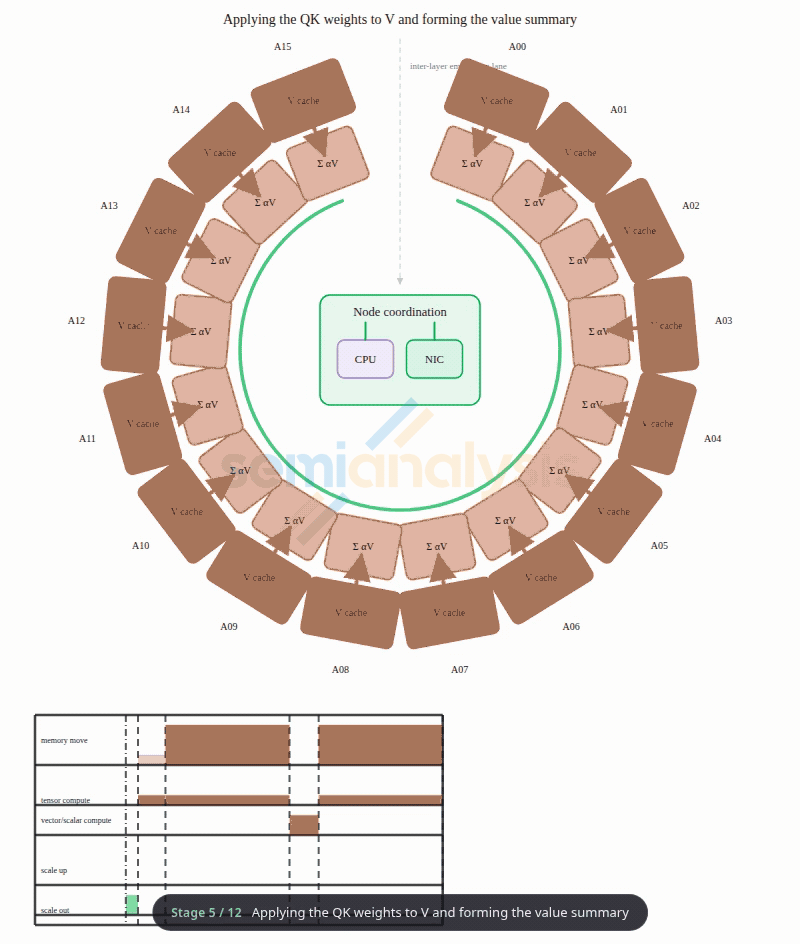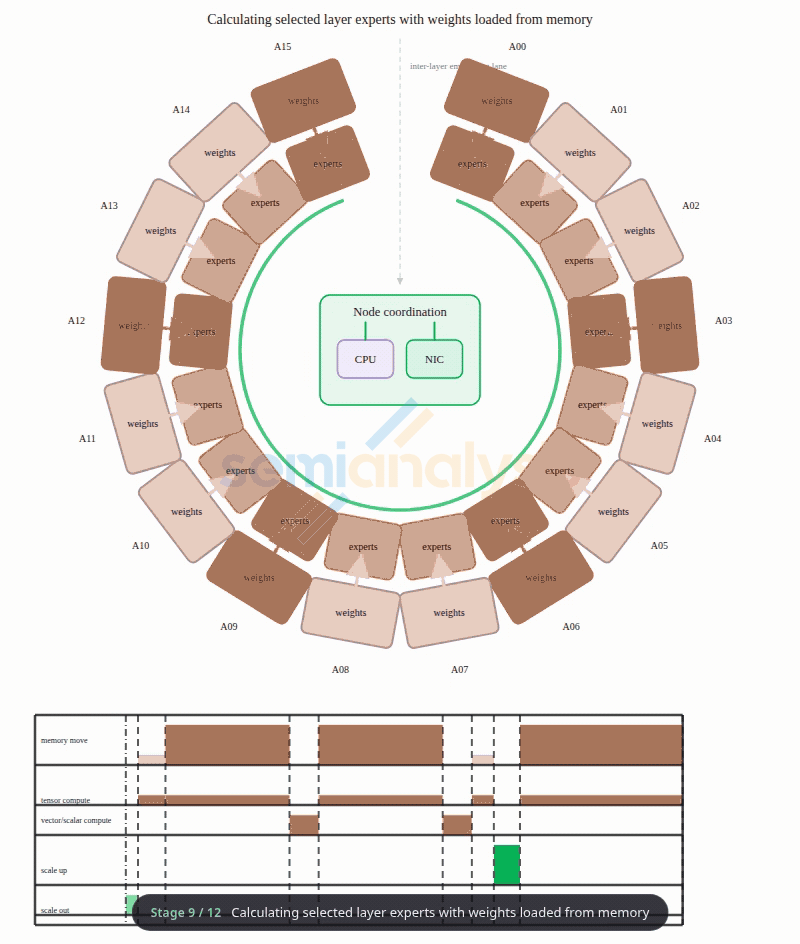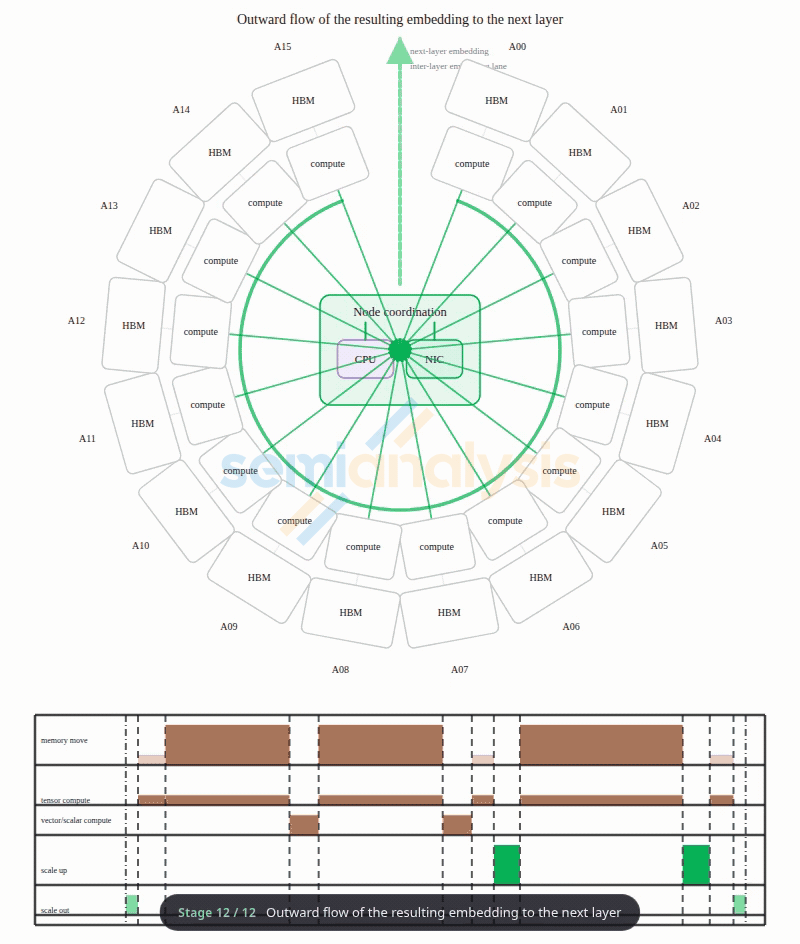
把一个逻辑节点理解为由对等单元组成的环,比将其理解为字面意义上的电路板布局更容易。这个环大约包含十六个加速器。每个加速器将一个计算区域与本地高速内存配对。这些单元通过强大的纵向扩展(scale-up)互连结构连接。CPU 负责协调工作负载和内存管理,而 NIC 则将节点连接到机架和数据中心资源。
环只是一种可视化方式,它把加速器展示为地位平等的对等单元。我并不是说节点内部网络应该是环形拓扑。它可以是中心辐射式(hub and spoke)、轨道式(rail)、全互联(all-to-all)、环面(torus)、超立方体(hypercube)……无论你偏好哪种都行,只要它能以低延迟和低单位比特能耗处理机架内最高的数据流量。为了简单起见,我就画成环。
这种表示方式避免过早绑定到封装布局、电路板走线或交换机实现上。实际的机器可能采用中央交换机、多个交换机、直连链路或分层互连结构。逻辑上的要求只是:一个有界的对等单元集合,具备可预测的快速本地通信。
加速器的设计可以多种多样。一种版本可能使用以 SRAM 为主的存内计算(processing-in-memory)单元。另一种可能使用混合键合的 DRAM,或在 BEOL 工艺中沉积在顶部的 IGZO 存储单元。还有一种可能使用混合键合的高带宽真三维(3D)内存。即便内存容量和带宽发生变化,这个逻辑模型依然适用。
节点是承载高频重复工作的天然场所。注意力分区之间交换紧凑的部分结果。路由后的专家激活值被送往本地目的地。专家输出返回以进行重组。共享状态和调度元数据则保留在 CPU 附近。NIC 负责在节点之外传递流水线激活值、KV blob 和工作分配。
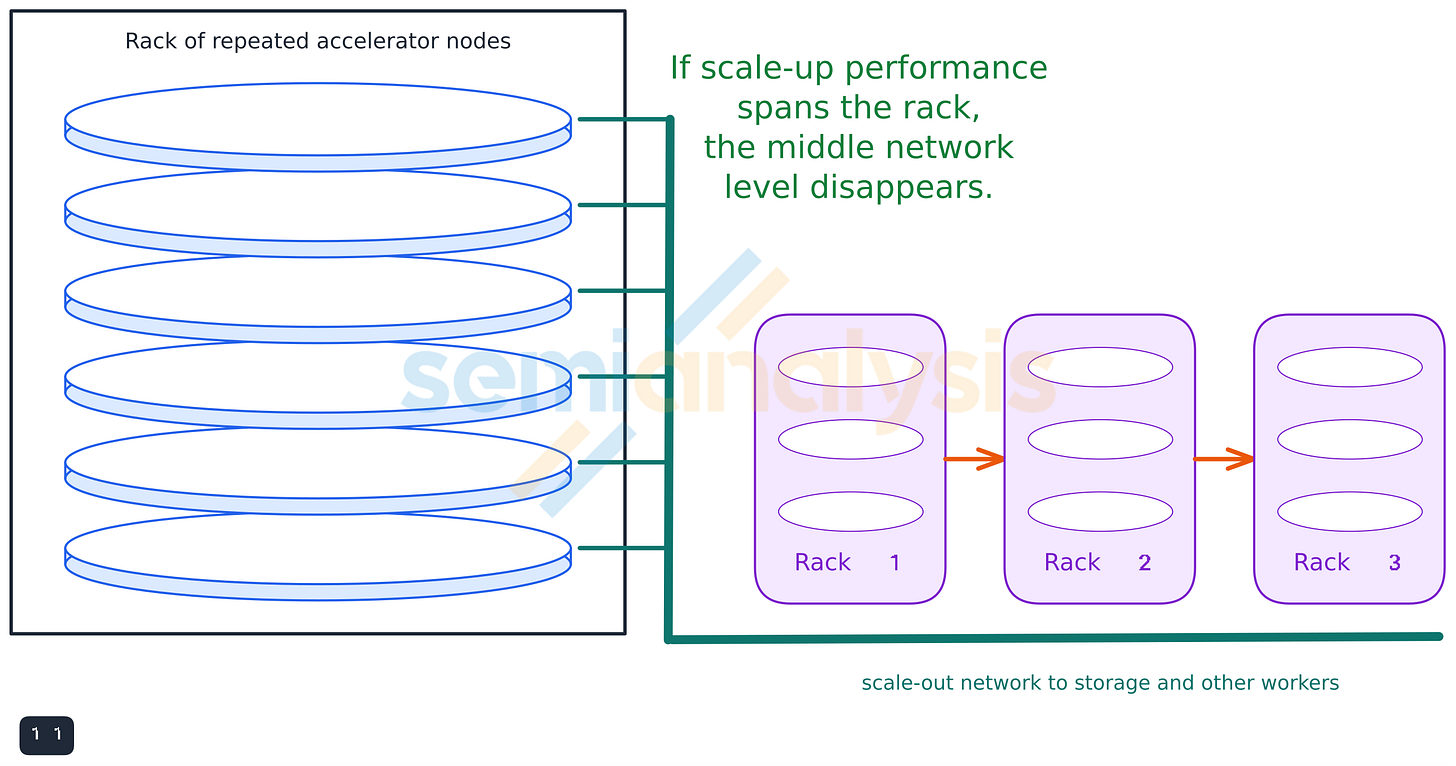
一个节点可能比机架小,就像我们看到的配备 8 个 GPU 的 SGX 节点;而一个纵向扩展系统也可能覆盖整个机架,就像 NVL72 那样。无论哪种情况,这个逻辑符号都依然有效。如果纵向扩展已经覆盖了整个机架,那么单独的机架主干层就会消失,下一个边界直接就是横向扩展(scale-out)网络。
Figure 14. A 16-accelerator peer set on a scale-up fabric.
10. 节点堆叠成机架
当把这个环倾斜成一块宽而薄的硬件“可丽饼”时,它的表达力更强。多个单元可以在机架中垂直堆叠,就像模型层组按模型深度堆叠一样。
这种重复出现的形态让模型与硬件之间的关系更容易看清。一个层组“可丽饼”可以放置到一块硬件“可丽饼”上。如果内存允许,多个层组可以占据一个节点。如果注意力或专家容量需要,一个层组也可以跨越多个紧密连接的节点。这种映射可以扩展或收缩,而无需改变基本的视觉语言。
一个机架可以采用多种方式组织:
一个覆盖整个机架的纵向扩展域; 多个由机架骨干连接的节点级岛屿; 流水线阶段分布在各个岛屿之间; 在每个阶段内部进行宽泛的专家放置; 或者混合使用阶段本地的纵向扩展链路和共享的横向扩展链路。 因此,机架骨干是一个可选的中间层级。有些系统将纵向扩展网络延伸到整个机架,无需单独的节点连接器。另一些系统则使用强大的本地节点网络,再配以独立的机柜顶部(top-of-rack)或共享轨道(shared-rail)网络。在机架之上,横向扩展网络负责连接存储、prefill 池、decode 池以及其他机架。
这种可重复的机架单元还有助于区分两种不同的扩展问题。模型可以容纳在一个有界的机架 worker 之内,而工厂则通过增加大量 worker 来扩展规模。前者是功能放置问题,后者是 worker 编排问题。
Figure 15. Accelerator nodes stacked into a rack.
11. 一个层级组随时间复用节点
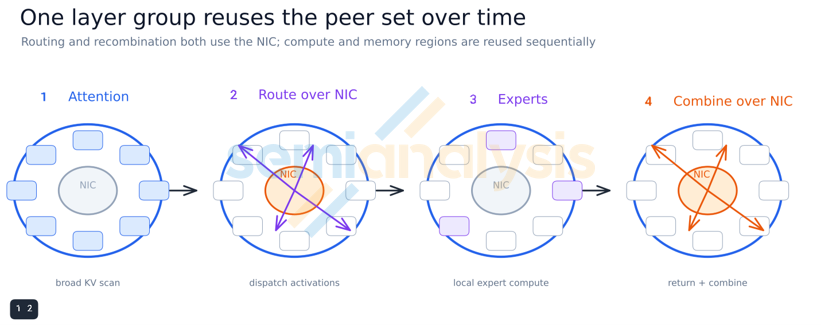
层级组并不要求算法中的每个操作都同时以峰值强度运行。这些操作构成一个不断重复的序列,在 decode 周期中让同一套硬件承担不同的工作。
注意力计算可能分布在环的大部分区域,占用大量内存通道和多个计算单元。query 和输出变换则以更紧凑的操作使用模型权重。共享的前馈计算可以使用一个密集区域。被选中的专家随后激活环上各处的本地内存-计算区域。重组阶段则返回一个紧凑的结果。
同一批物理加速器在每个步骤中可以扮演不同的角色。先前计算注意力的执行单元,之后可能执行一个或多个专家。先前用于流式读取 KV 状态的内存通道,之后可以载入专家权重。随着 token 的推进,缓冲区和本地链路也得到复用。
这种时分复用是高效设计的核心。静态示意图可能让机器看起来利用率不高,因为并非所有模块都在同一时刻活跃。但实际上,硬件是在为一个由不同操作组成的序列服务,而设计目标是让这个序列持续流转,尽量减少建立和同步的开销。
宽大的层级组可丽饼(crêpe)与加速器对等集合是互补的。可丽饼展示的是算法层面的流程;环形结构展示的是其下方可复用的物理资源。映射的过程,就是让流程中的每个阶段与环上一个合适的子集相互对齐。
Figure 16. One layer group reuses the peer set over time.
12. 把吞吐量边界放在流量最小的地方
一旦把模型和机器都画成相互连接的流,放置规则就变得清晰:频繁且对延迟敏感的通信应保留在最强健的本地网络之内,而较弱的链路只应承载紧凑的或可摊销的传输。
Figure 17. The general flow of operation of an MoE pipeline stage (animated).
注意力分区的部分结果可能需要在每层之间交换。专家路由会把激活值发送给被选中的专家,然后接收它们的输出。这类流量按字节数来看并不总是最大的,但它们出现频繁、具有突发性,而且对同步非常敏感。只要条件允许,就应把这类流量放在所选的 scale-up 域内。
层或层组之间传递的激活要小得多。因此,流水线边界可以跨越一条较弱的链路,而无需移动该层完整的内部工作集。KV blob 体积较大,但它们只在 worker 边界处移动,并且可以分摊到许多个生成的 token 上。它们的传输路径可以使用条带化或洪泛式的 scale-out 网络以及共享存储,而不必占用最内层的张量网络。
路由器到专家的边界通常是一条中等吞吐量的 all-to-all 通信,传递的是紧凑的激活值。其难点往往不在原始字节量,而在于端点数量、同步和路由效率。把它限制在节点或机架的 scale-up 域内,可以同时降低延迟和运维复杂度。
这种分层结构比构建一台所有链路强度完全相同的机器更容易、成本也更低。Scale-up 路径承载那些在每层内部交换 embedding 和部分结果的操作。Scale-out 链路则负责传输流水线激活、KV 移动、调度流量,以及有界 worker 之间的流量。
不同层级对延迟的要求也不同。层组之间的流水线传输,只要吞吐量足够,可能几乎察觉不到几微秒的延迟。相比之下,当一次专家加载和乘法运算只需几微秒时,每个路由跳步多出的 100 ns 就变得不可忽视。因此,最贴近的链路应当与加速器网络紧密集成,而不那么频繁的传输则可以容忍 scale-out 网络。
13. 尽可能按层组切分流水线
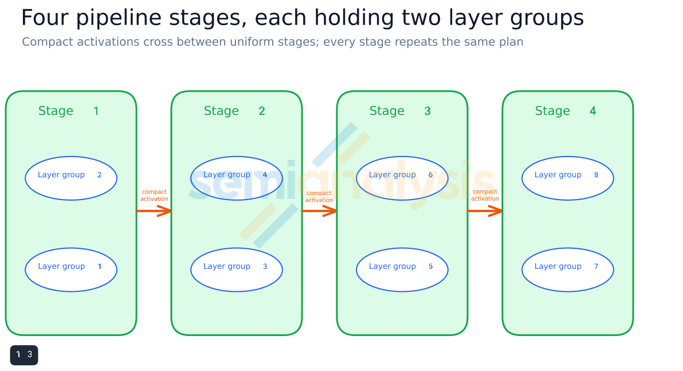
层组是流水线切分位置的首选。在经典的 MoE 模型中,每个层组重复同一种层。而在更新的结构中,一个层组可能包含一个全注意力层,后跟若干个优化注意力层或局部注意力层。
将层组保持在同一处可以保留其内部依赖关系,并让同一套部署和编译方案可以在各个阶段之间复用。统一的方案能降低工具链成本、简化部署。当每个阶段运行的都是相同的重复结构时,内核、内存布局、通信调度、监控和故障恢复都会变得更简单。
在层组中间切断流水线仍然可行,只是最终的部署会更复杂。如果这些层之间没有特殊的跨层依赖,那么紧凑激活边界依然是一条流量很小的链路,适合走网络传输。一个阶段可以包含若干个完整层组、一个层组,或者一个大层组的一部分,具体取决于内存和吞吐量需求。
指导原则并不是绝对禁止拆分组,而是优先选择规整的边界,并理解何时非均匀拆分是值得的。工具链和运维的简洁性,可能与微小的理论布局收益同样重要。
Figure 18. Four uniform pipeline stages.
14. 流水线深度止步于 KV 缓存的交叉点
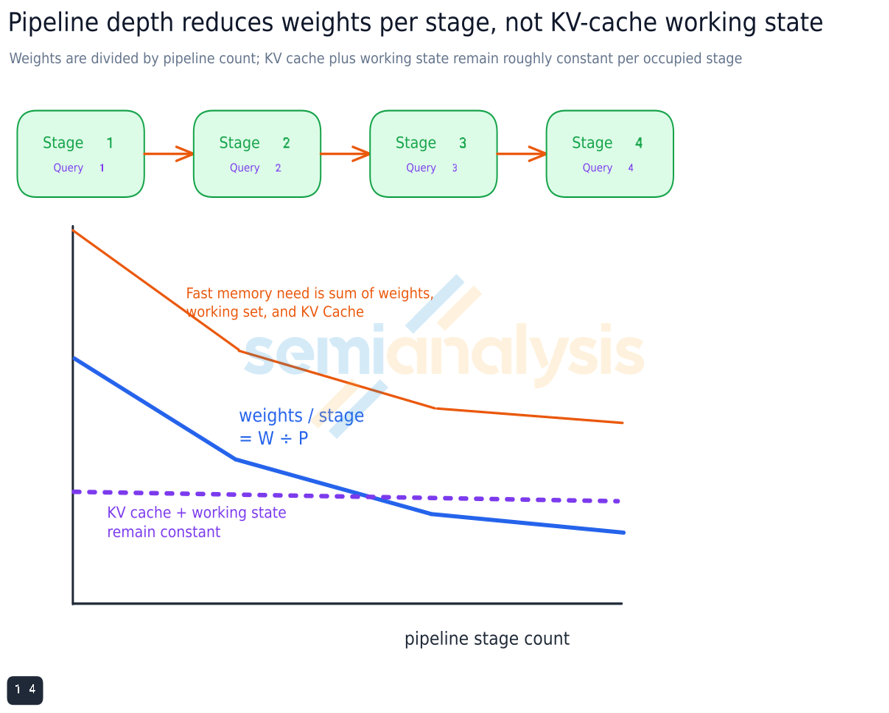
流水线并行可以干净地切分模型权重。如果模型的权重占用为 (W),并使用 (P) 个流水级,那么理想情况下每个流水级的权重占用约为 (W/P)。
KV 缓存的需求则表现得不同。一条完整的流水线在每个流水级上运行不同的查询或批次,从而保持满负荷。在一个八级流水线中,每个流水级拥有八条活跃流各自的逐层 KV 值的八分之一。每个流水级层数的减少,会被并发流的数量所抵消。因此,流水级在活跃 KV 需求上并不能像权重那样获得 (1/P) 的缩减。
一个实用的流水级内存估算公式是:
M_{stage} ≈ W/P + M_{KV,stage} + M_{working} + M_{slack}
一旦每个流水级的权重降至与 KV 缓存和工作状态内存相同的量级,更深的流水线在增加协调开销和延迟的同时,几乎不再带来额外的容量收益。
这一交叉点在很大程度上取决于模型设计。经典的全注意力方法,所有层合计每个 token 可能需要数百 KB 的 KV 状态。MLA 类设计通常在数十 KB 的量级,而近期以线性层、递归层或局部注意力为主的混合层组可以更低。对于某些新型混合架构,按每 token 约 25 kB 的工作平均值估算可能是合理的;而对于经过验证的压缩注意力设计,每 token 约 70 kB 是一个保守的参考值。
作为一个粗略的设计目标,取每 token 70 kB,并将总计两百万 token 的活跃上下文分配给一个流水级,这大约是 140 GB 的 KV 状态。双缓冲允许一个工作集在搬移的同时另一个继续运行,从而将 KV 预算提升到接近 280 GB。再加上模型权重、激活值、瞬态缓冲区、路由表、内存碎片和运行余量,一个大约 400–500 GB 本地高速内存的流水级目标,就成为 2027 年一个有用的基准。
其他设计可以通过流式处理、压缩、部分驻留或额外的存储层级来降低需求。这一估算并不是一个普适的硬性要求,而是一个实际的前沿系统在无需极端假设的情况下应当能够满足的标准。
只要多个加速器插槽共享同一 scale-up 互连网络,流水级就可以将这部分内存分布到这些插槽上。大型 MoE 中超过 95% 的权重内存位于路由专家中,而路由专家可以自然地在插槽之间划分。KV 状态可以按注意力头、上下文或注意力实例进行分区,并将由此产生的集合通信限定在同一本地互连网络内。
Figure 19. Fast-memory demand is stage weights, live KV state, working buffers, and margin.
15. Prefill 与 midfill 将稀疏路由转化为稠密的专家批次
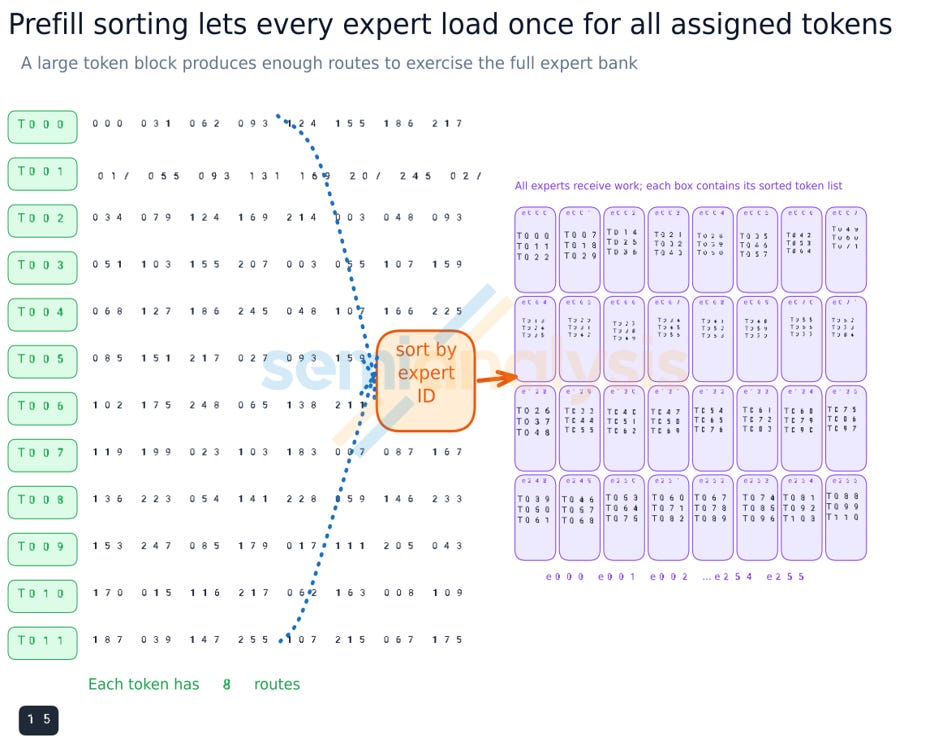
Prefill 和 midfill 具有很强的批处理机会,因为许多输入序列的 token 会在专家执行开始之前就完成注意力计算。路由器可以对所有 token 打分,为每个 token 输出多个目标专家,然后按专家对路由记录进行排序。
一个实际的输入块所包含的分配数量,足以让几乎每个专家都能分到工作。如果 128 个新 token 各自选择 8 个专家,路由器就会在一个包含 256 个专家的专家库中产生 1,024 个分配。对每个 token 来说路由仍然是稀疏的;排序只是改变了执行顺序,使得专家 e000 先处理全部分配给它的 token,然后是 e001,依此类推。每个专家只需加载一次,就能在其紧凑的 token 列表上反复复用,而不必按 token 顺序被反复加载。
对于一个拥有 (W) 个权重、每个被路由 token 的权重流量 (B_W)、激活流量 (B_A)、输出流量 (B_O) 以及 (n) 个被分配 token 的专家,其算术强度可以粗略表示为:
AI_{expert}\approx \frac{2nW}{B_{W}+nB_{A}+B_{O}}
当权重流量占主导时,增大 (n) 能迅速提升复用率。最终,激活、输出和路由流量会变得不可忽视,收益随之趋平。
排序并非没有代价。路由记录需要被构建、计数、重排、发送到各专家目的地,最后再恢复到 token 原有顺序。专家容量限制还可能导致溢出或重新路由。即便如此,prefill 和 midfill 一开始就有足够多的 token,这项优化通常是有意义的。
这是与 decode 的关键区别。专家本身是相同的;变化的是工作器在执行专家时可用的被路由激活数量。
Figure 20. Sorting lets each expert load once and process every token assigned to it.
16. Decode 从批处理中获益较少
Decode 的注意力几乎得不到直接的跨查询复用。每增加一个查询,就会多出一份 KV cache 和一次上下文扫描。共享的查询投影权重可以被复用,软件开销也可以被摊销,但占主导地位的长上下文读取仍然只为单个查询所私有。
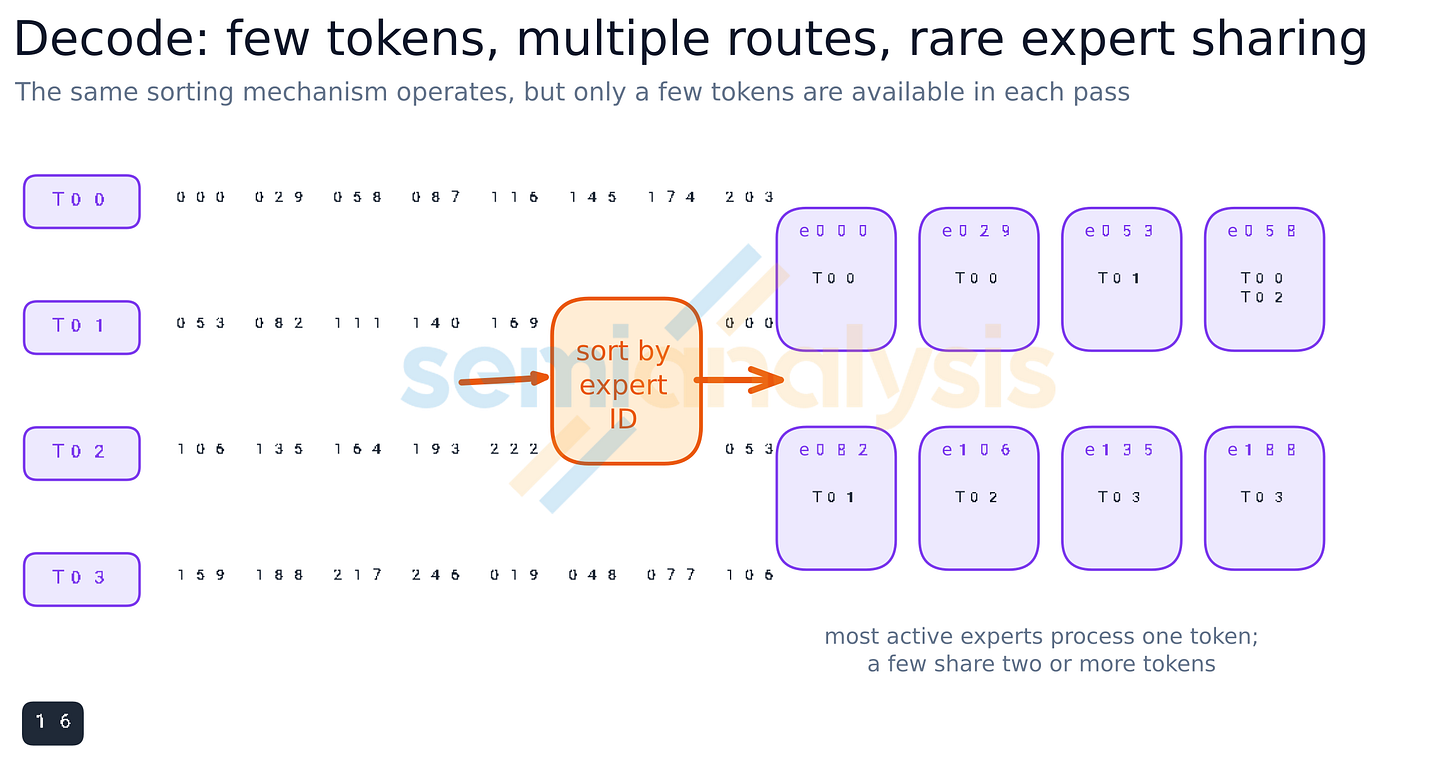
Decode 的专家具备潜在的共享能力,因为专家权重与上下文无关。实际的限制在于共享概率。一个模型在每一层可能包含数百个被路由的专家,整个模型中则可能有数千个层-专家组合。每个查询每轮只贡献一个新 token,并且只选择少数几个目的地。在小批量下,可用的被路由 token 很少,大多数活跃的专家只从单个 token 那里获得工作。虽然确实会发生一些共享,但它随每轮 token 数量的增加而逐渐增长。
共享变换提供了更常规的权重复用,但它们在 MoE 模型中只占较小的一部分。因此,扩大 decode 批量所带来的总吞吐量提升,相较于延迟和 KV 内存压力的增加,可能相当有限。
当上下文长度达到 100,000 个 token 或更多时,批大小为一并不是一个微不足道的工作负载。注意力扫描本身就会占用大量内存带宽。最优批大小未必是一——软件启动、内存分配、路由和硬件利用率仍然重要——但它可能更接近一或五,而不是面向吞吐量的服务所使用的大批量。
这在经济上很重要。交互式 token 可能比大批量延迟处理的 token 更有价值。为了获得微小的吞吐量提升而牺牲延迟,可能是一笔糟糕的交易。硬件和软件应当消除小型批量高效运行的障碍,而不是把大批量作为实现效率的前提。
Figure 21. Decode uses multiple routes but rarely shares experts at small batch sizes.
17. 调度让解耦架构发挥真正作用
在云规模下,解耦作为一个统计系统最为有效。一个大型资源池可以包含针对长 prefill、短 prefill、长上下文 decode、短上下文 decode 或其他有用类别配置的工作节点。编排器将每个任务分配给合适的可用工作节点,并通过共享存储移动所需的 KV blob。
一旦已知前缀长度、新 token 数量和工作节点配置,prefill 和 midfill 的工作就是可预测的。而 decode 是随机的,因为输出长度不确定。资源池之间的存储将可预测的生产与不规则的消费解耦开来。已完成的 prefill 和 midfill 工作的就绪缓冲区可以让 decode 工作节点持续有活可干,即使各个查询在不同时间完成。
调度器应当观察客户工作负载和时段模式,预判已知的流量增长,并在组合变化时重新配置工作节点。重新配置可能意味着加载不同的模型阶段、改变流水线的并行度、重新分配专家容量,或者在 prefill、midfill 和 decode 之间调整机架的用途。
规模很重要。在小型的固定基准测试中,一个输入填充阶段可能直接连接到一个 decode 阶段。某个阶段变慢可能会让另一个阶段的算力闲置。而在大型资源池中,工作节点独立地完成和启动任务,因此不会有工作节点被闲置。
因此,高交互性和高利用率并不天然对立。只要调度器拥有足够多的工作节点、足够的存储带宽、对工作的足够可见性,以及足够快的响应速度来实时适应变化,它就可以在保持批量较小的同时让机器保持忙碌。
图 1 中的服务概览给出了对应的系统图景:四个资源池,编排器横跨其下方。
18. 反馈可能将微小的不平衡放大为振荡
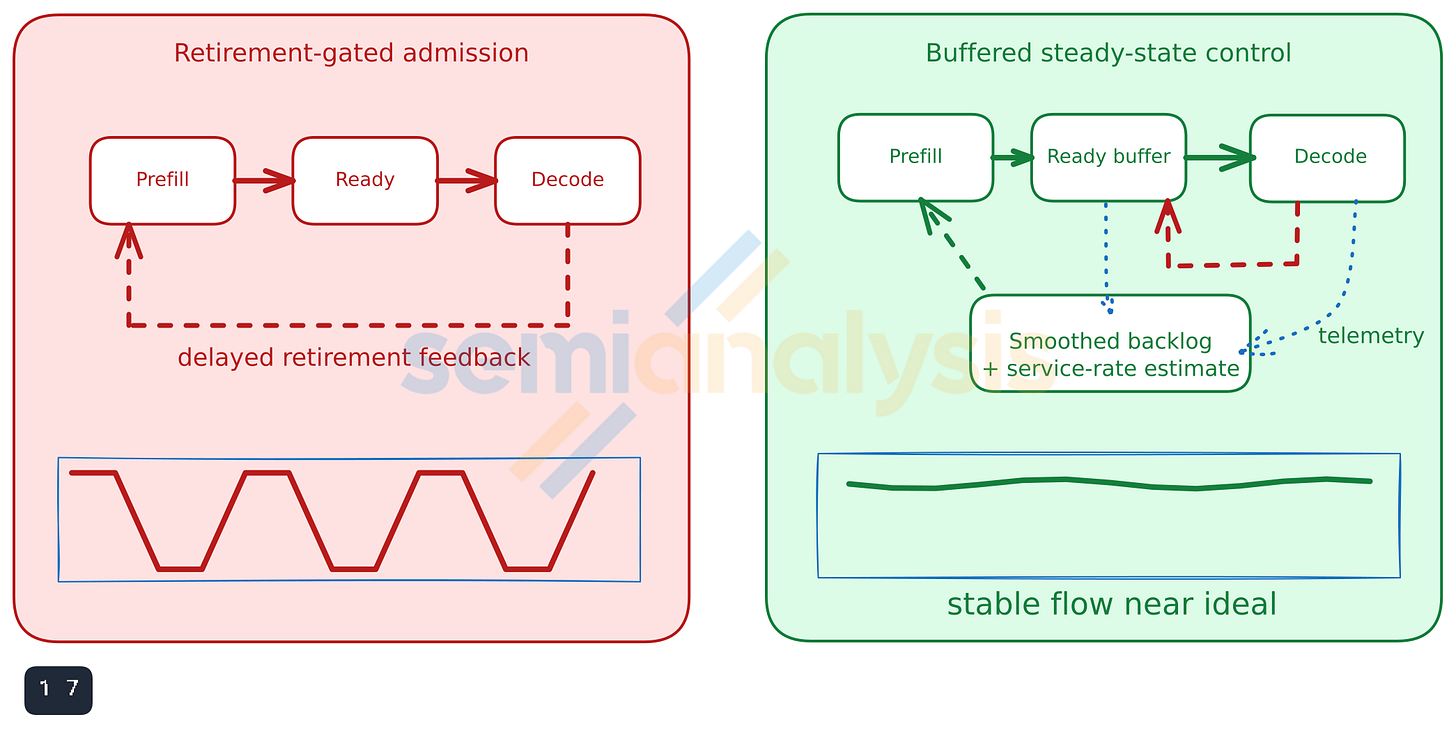
紧耦合系统会放大普通的波动。假设输入填充(input fill)的准入直接由解码查询的退出来控制。一个长时间运行的解码查询会延迟退出,输入填充的准入量随之下降。随后解码清空其就绪队列,出现供给不足。此时准入又激进地放开,产生一波突发的输入填充任务和新一轮的拥塞。
这是一个延迟反馈回路。控制信号在系统状态已经改变之后才到达。大批量恢复(batch recovery)会通过增加 KV 内存压力和响应延迟,使这个回路进一步恶化。于是工厂在满载和空载之间来回震荡,而不是运行在稳定的工作点附近。
没有任何单一调度策略能解决这个问题。几种常见的控制技术可以有所帮助:
在各阶段之间使用就绪工作缓冲区(ready-work buffer); 基于平滑后的积压量和预测的服务速率来调节准入,而不是基于单次请求的退出; 将快速的本地控制与较慢的容量控制分离; 对工作节点重配置应用滞回(hysteresis)机制; 为短小的交互式任务预留容量; 避免以超过系统可观测到其影响的速度去更改批量大小。 同样的原则可以推广到各个时间尺度。微秒级的工作节点调度、毫秒级的 token 流动、秒级的缓冲区、分钟级的工作节点重配置,以及小时级的需求规划,不应对同一个充满噪声的信号做出响应。
Figure 22. From retirement-gated oscillation to steady flow.
19. 聚合与分离的对比
既然我们已经详尽地描述了分离式推理(disaggregated inference),那么聚合式(aggregation)是否也有其道理?在某种程度上,是的。显然,由于对话可能会暂停几分钟甚至几小时,把整个会话绑定在一套系统上是不合理的。而那部分 HBM 在一轮结束后的几秒内就可以得到更好的利用,现代横向扩展(scaleout)网络可以在不到一秒内,把数 GB 的 KV cache 迁移到一个更便宜的并行存储系统位置,该存储系统可以对 DRAM 和 SSD 进行分层。
然而,在一轮对话进行期间,我们真的需要调度多个不同的地方来完成工作吗?维护太多不同设计的服务器成本高昂,既增加运营成本,也增加设计工作量。如果只有一种设计,并且以 midfill 为核心,会怎样?一个请求可以被调度到那个空闲的工作节点上,并在那里完成 prefill、midfill 和 decode。这种设计需要有足够的算力来完成 prefill 和 midfill,以及足够的内存带宽来完成 decode。根据模型当前所处的阶段,总会有一些算力或内存传输能力被闲置,但我们对 GPU 上偏低的 MFU 早已习以为常。我们试图通过巧妙的 kernel 来克服这一点,但实际上集群中一直存在功能闲置的情况。
复杂的编排调度必然会造成一些资源的闲置浪费。如果一轮对话完全在单个聚合式 worker 上运行,其中一部分浪费就可以避免。预填充/中间填充(pre/midfill)交接给解码(decode)时不会出现调度空档。宽并行专家集自然只需共享一份副本。上下文从填充阶段转移到解码阶段也没有网络开销。编排器仍然会考察请求的形态——缓存大小、输入序列长度、模型类型、客户交互级别——然后一次性决定由哪个可用 worker 负责该轮对话的所有阶段。之后便不再干预,直到停止词(stop token)输出,这一轮结果被交付给用户并缓存到高速并行文件系统。这个 worker 在处理一轮对话的所有阶段时,会使用与该请求形态相适应的算子和数据流。
聚合式 worker 有其吸引力和支持者。
在真实世界用途中,所有系统都会闲置加速器的部分能力。在解耦式(disaggregated)系统中,可以构建两种(或更多)类型的机器,把投资聚焦在真正会被用到的算力、内存和网络上,可以说这是对投资的最佳利用。填充(prefill)机器可以把投资放在算力上,而解码(decode)机器可以把投资放在内存上。如果 worker 是聚合式的,那么一台机器要贯穿所有阶段使用,因此它需要在最强算力和最强内存吞吐上都投入。可能还需要强大的网络。如果它不是全方位的佼佼者,就会被较弱的环节拖累,整体表现只能算是“平平”。所以,聚合有优势,但在交付全方位最佳性能这件事上,它也让你无处藏身。如果你能打造出那种全方位出色的神奇明星,那么把整轮对话聚合到一个 worker 上可能是最优选择。
20. 内存带宽和内存容量是不同的目标
人们讨论内存时,往往把它当作两个可以分别最大化的独立标量。但在实践中,容量和带宽之间存在相互制约,它们的经济价值必须放在一起考量。
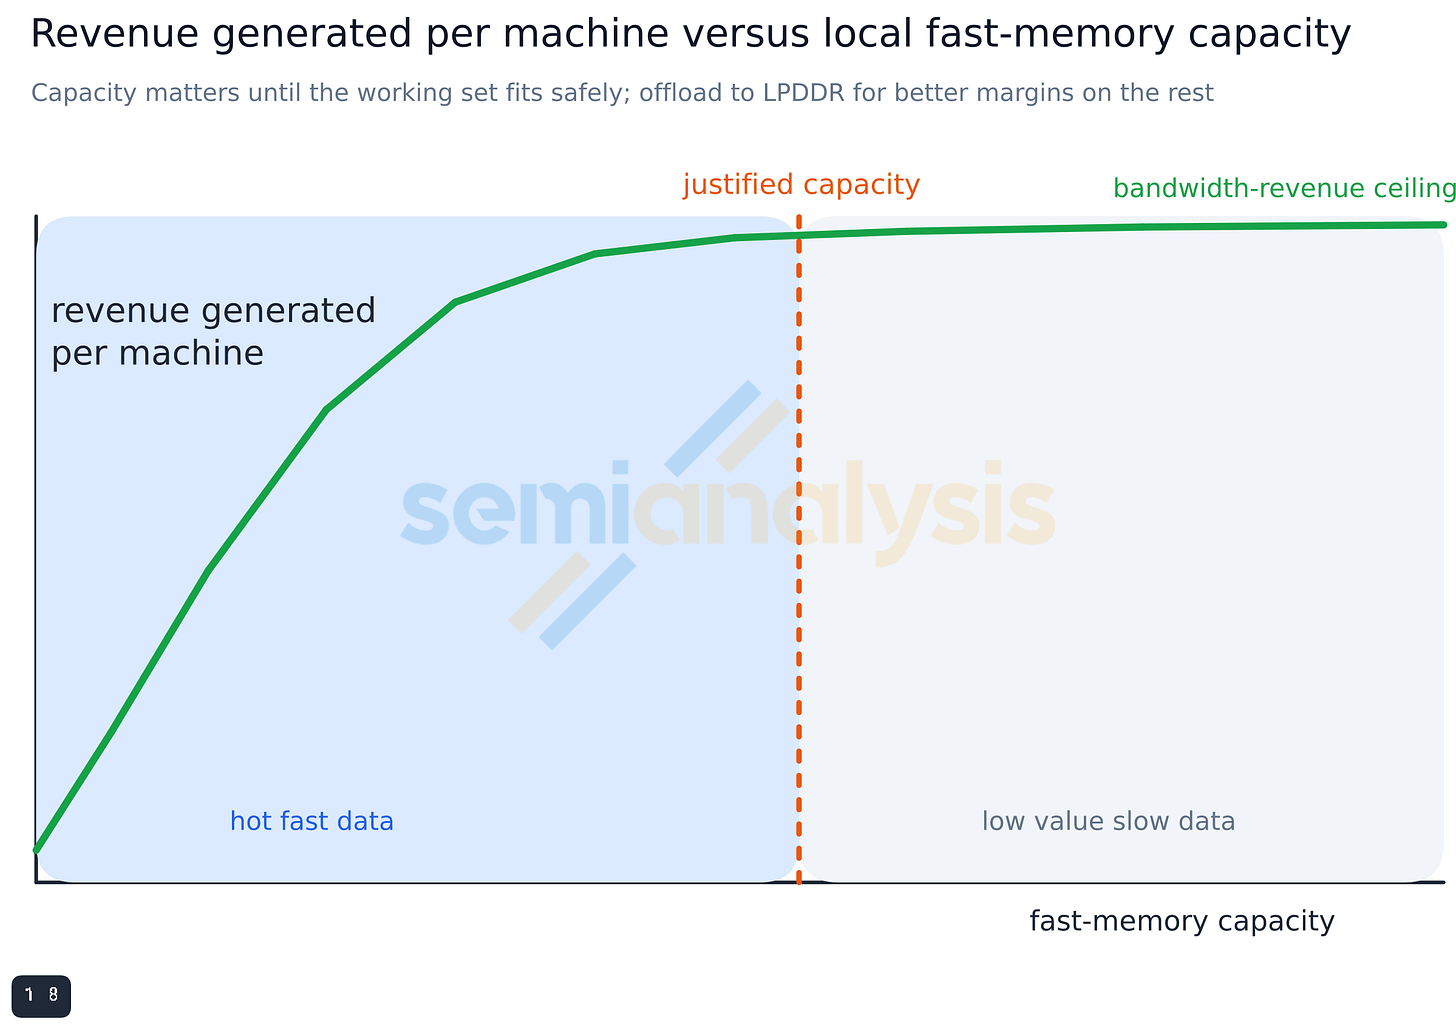
数据只有在流动时才能创造收入;闲置不动时只会产生成本。一个内存吞吐量非常高的加速器,其产 token 的速度是低带宽内存无法企及的,即使低带宽配置拥有更大的容量。容量的价值止于这样一个临界点:活跃权重、KV 状态、激活值和运行余量能够干净地容纳为止。超过这个点之后,额外的本地容量可能只增加成本,而不增加收入。
容量曲线并非垂直的悬崖。在有效上限之内,增加加速器既能带来更多内存,也能带来更多带宽。但当其他限制出现时,这些优势就会终止:最大横向扩展(scale-up)宽度、糟糕的模型切分方式、延迟的主导地位、额外的同步开销,或是网络争用。
安全容量的设计点必须高于这些限制。它要为真实的上下文分布、双缓冲、内存碎片、故障以及瞬时峰值预留裕量。收入-容量曲线在该点之前快速上升,随后平滑过渡,最终进入主要由带宽和算力决定的较平坦的上限区间。如果过剩容量变成沉没成本,运营方为了消化它而运行大批量、高吞吐但价值低劣的慢速批次,收入甚至可能下降。
加速器的 HBM 太过昂贵,不适合存放暂时无用的空闲数据。已完成的 KV blob 应先移入 CPU DRAM 作为输出暂存,再转入横向扩展存储。频繁复用的公共 blob 可以保留在共享 CPU 内存或近端缓存设备的副本中。只有活跃的工作集才配得上使用最昂贵的内存。
高容量的深层内存堆叠可能在功耗、信号质量、封装和频率方面带来额外成本。一个容量恰到好处而带宽出色的设计,在交互式推理中可能比那种在单个加速器上堆满闲置冗余容量的设计获得更高的利润率。
Figure 23. Revenue per machine versus local fast-memory capacity.
21. 一种实用的映射方法
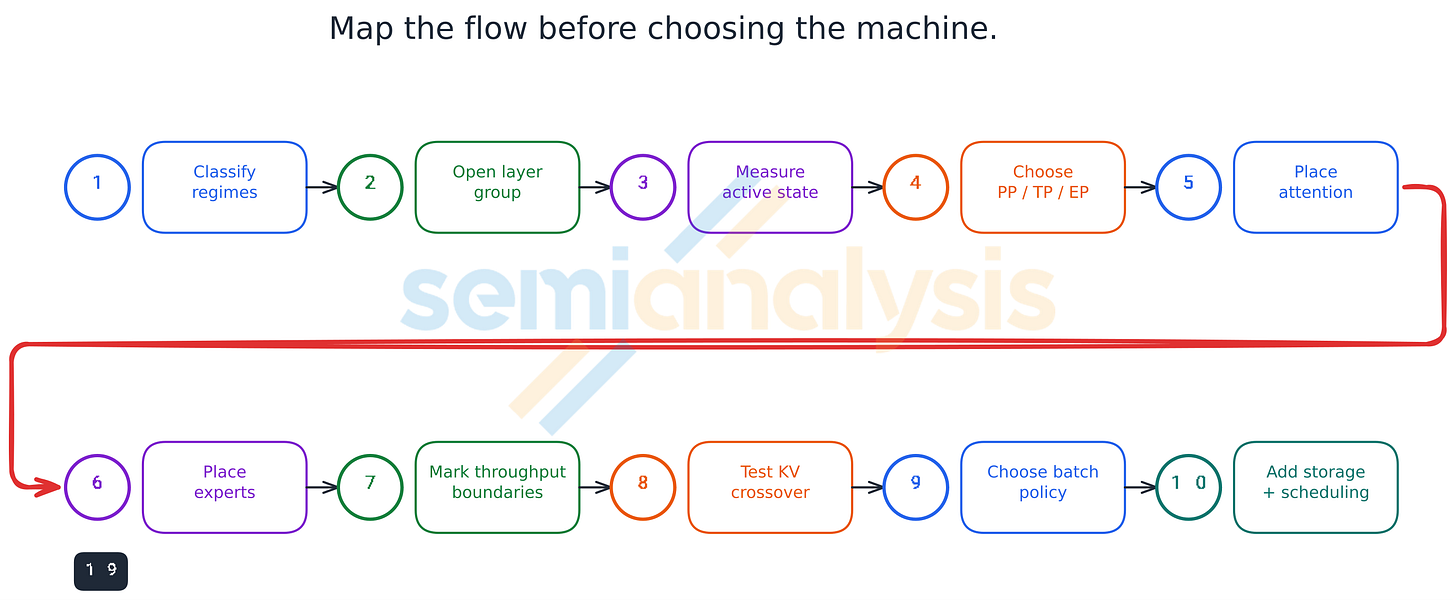
前面各节的内容可以浓缩为一套可复用的方法,用于将模型映射到机器上。
分离各个运行阶段。分别测量 prefill、midfill、decode attention 和 decode experts。每个阶段还可以按上下文长度或工作负载类别进一步细分,例如 agent、编码、媒体或内容创作。这些会成为预置的配置,供编排器在生产环境中组合使用。 描述重复出现的层组。识别完整与优化版 attention、共享变换、路由专家,以及任何跨层依赖。 测量活跃状态,而不只是总参数量。将阶段权重、活跃专家、实时激活、KV 状态和临时缓冲区分开计量。 为每种运算选择自然的并行维度。对层堆叠采用流水线并行,对宽泛且不可分割的工作采用张量并行,将相互独立的专家广泛分布。 优先映射最宽的运算。长上下文 attention 往往决定了内存条带化(striping)方式和参与 scale-up 的最小有效规模。 将专家权重放置在固定的本地目的地。让路由在已知的对等节点位置之间做选择,而不是为每个 token 触发一次全局事件。一个大模型可能包含约 15,000 个层-专家(layer-experts),每一个都可以结合同层其他专家的分布和预期的路由分布来放置。目标是让内存容量和带宽的使用保持均衡。 将反复出现的高吞吐协作留在最强的互连结构(fabric)中。让较窄的激活和摊销后的 KV 迁移跨越较弱的边界。除了吞吐量悬崖,还要注意延迟和功耗悬崖。 在达到 KV 内存交叉点时停止加深流水线。一旦模型和目标上下文以安全余量装下,更多流水线阶段带来的内存收益就微乎其微,反而会增加阶段切换延迟。 区别使用输入填充和解码。将 prefill 和 midfill 的路由整理进专家批次;保持小批量解码的交互性。 与 worker 一起设计存储和调度。KV 迁移、准入控制、就绪缓冲区以及 worker 重配置,决定了物理映射能否产生稳定的吞吐量。短批次和持续的批次更新,让编排器可以替换单个请求,而无需等待整个批次结束。 该方法并不选定某种万能拓扑,而是把各种权衡变得清晰可见。一个对等集合可以是一个封装(package)、一块板(board),也可以是一个机架级别的 scale-up 域。一个层组的"薄饼"(crêpe)可以映射到一个节点,也可以映射到多个节点。关键在于:通信层次结构要跟随模型的真实数据流。
Figure 24. A practical sequence for mapping the model onto a worker and then into a token factory.
22. 下一个视角:时间
到目前为止的图示描述的是结构和数据流。下一步是在其上叠加时间维度。
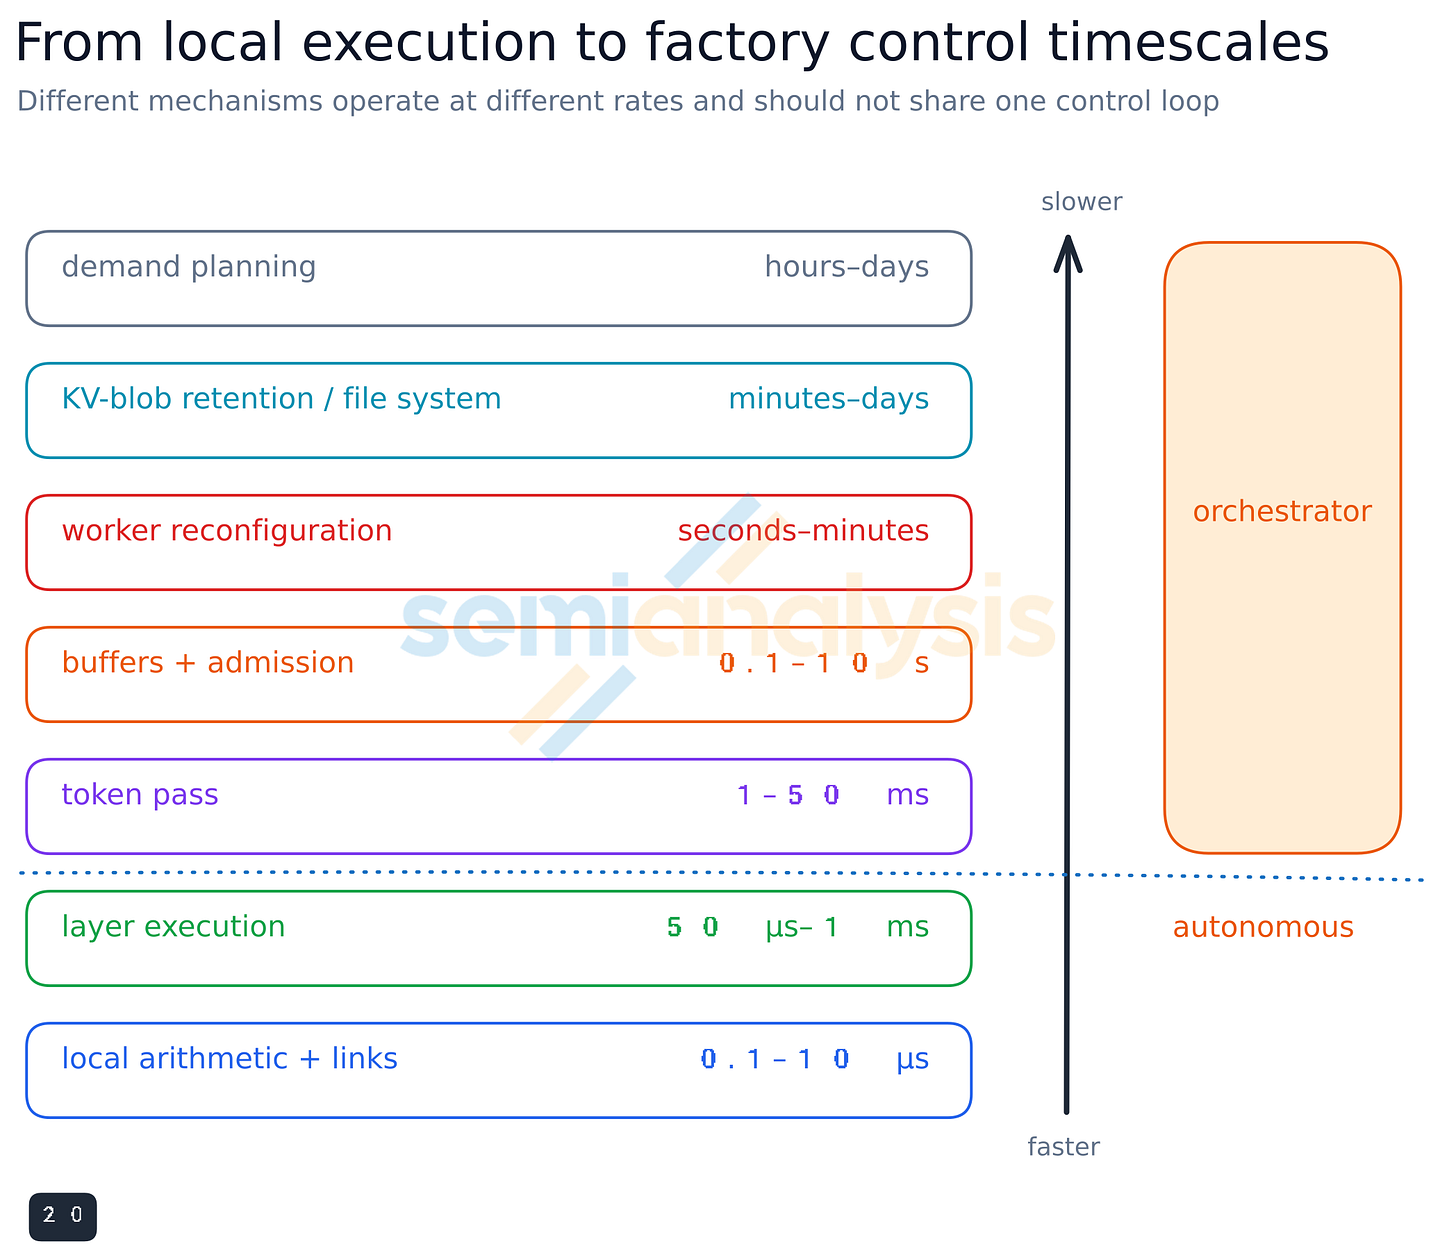
交互式解码有严格的端到端时间预算。执行一层通常需要在约 50 微秒到 1 毫秒内完成。对一个典型的 60 层模型来说,这相当于每秒约生成 15 到 300 个 token。每一层包含多个顺序执行的阶段,因此单个算术运算和交接的耗时在几十微秒、几微秒,有时甚至不到一微秒的量级。
在这个量级上,张量运算只是影响结果的一部分。内核启动、排队、同步、内存设置、路由、归约和链路延迟,相对于它们所支持的运算来说都必须保持足够小。如果一个专家乘法只需不到一微秒,而调度和数据搬运各要花几微秒,那么前者的价值就会被大幅稀释。
从时间的视角看,网络层级结构也变得更加清晰。一条高带宽路径如果建立延迟太大,仍然可能不适用。对于亚微秒级的交接,一个小的本地缓冲区可能比一个大的远程内存层更有价值。一个会引入毫秒级波动的调度器,可能会让 worker 内部精心设计的微秒级工程化为乌有。
这座工厂横跨多个控制时间尺度:
局部算术运算和链路交接:不到一微秒到几微秒; 层执行:约 50 微秒到 1 毫秒; token 生成:毫秒级; 就绪缓冲区和准入控制:约 0.1 到 10 秒; 由编排器进行的 worker 重新配置:数秒到数分钟; 快速并行文件系统中的 KV-blob 保留与生命周期:数分钟到数天; 客户需求规划:数小时到数天。 这些控制回路应该分别设计,再谨慎地衔接。快控制不应去追逐慢速的需求噪声,慢控制也不应对每一次瞬时的队列波动做出反应。
Figure 25. From local execution to factory-control timescales.
23. 实例分析:Kimi K3 在 Blackwell 系统上的预测性能
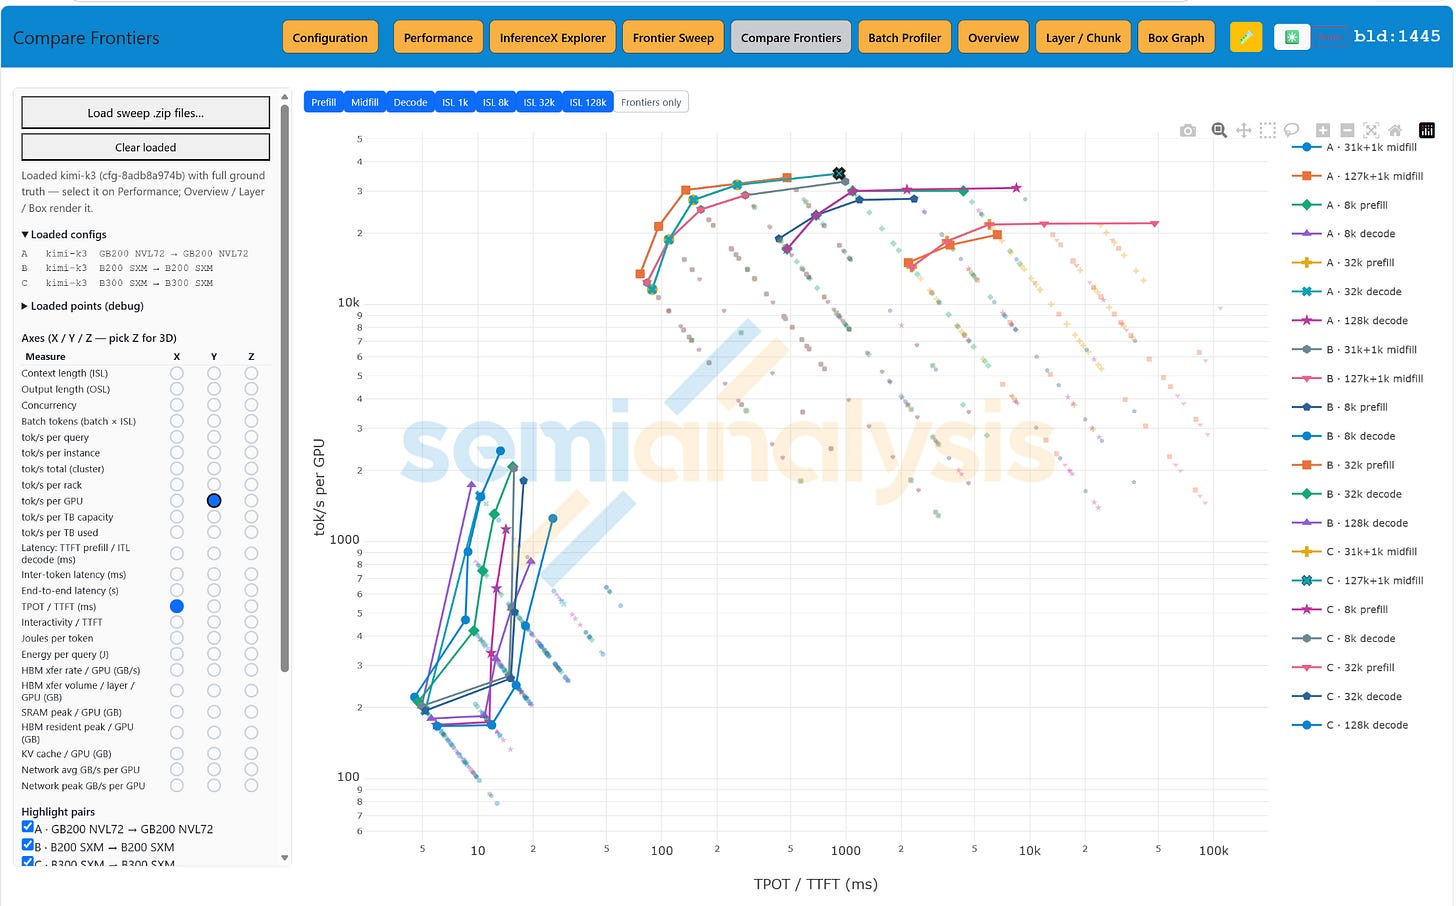
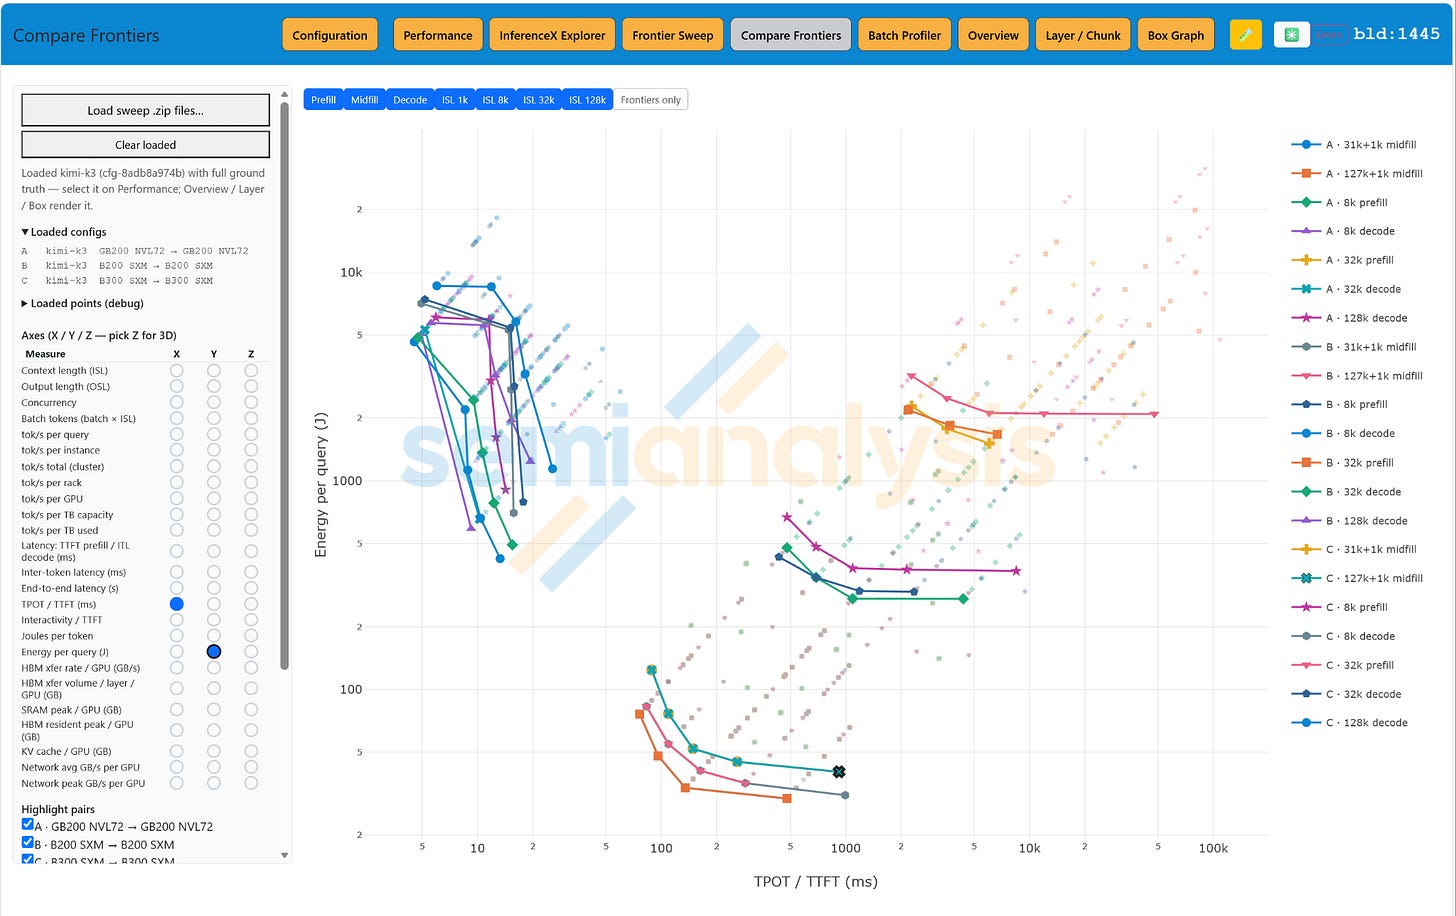
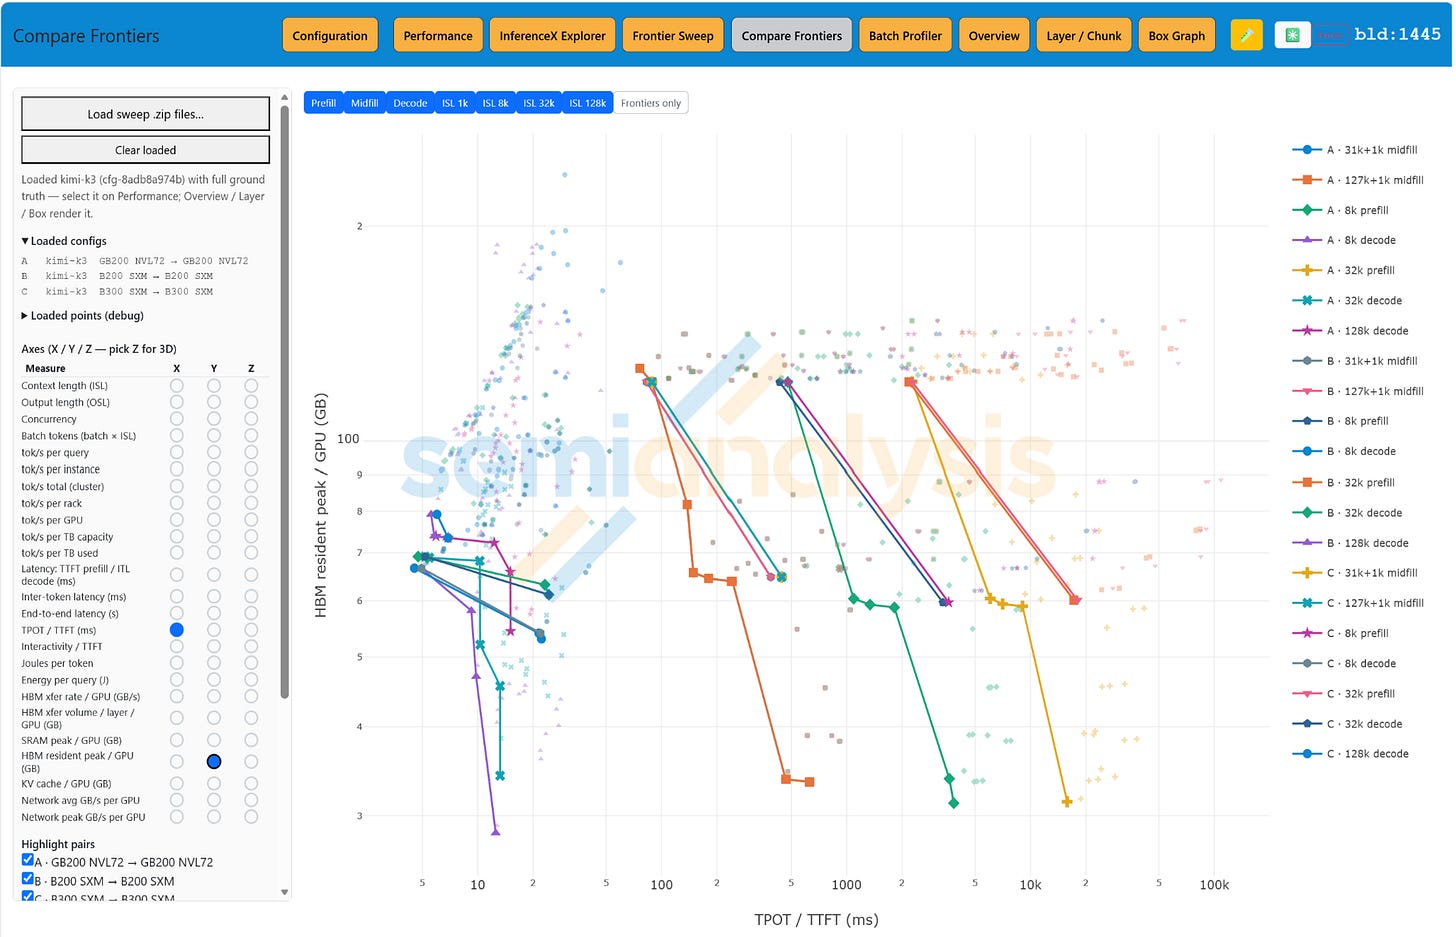
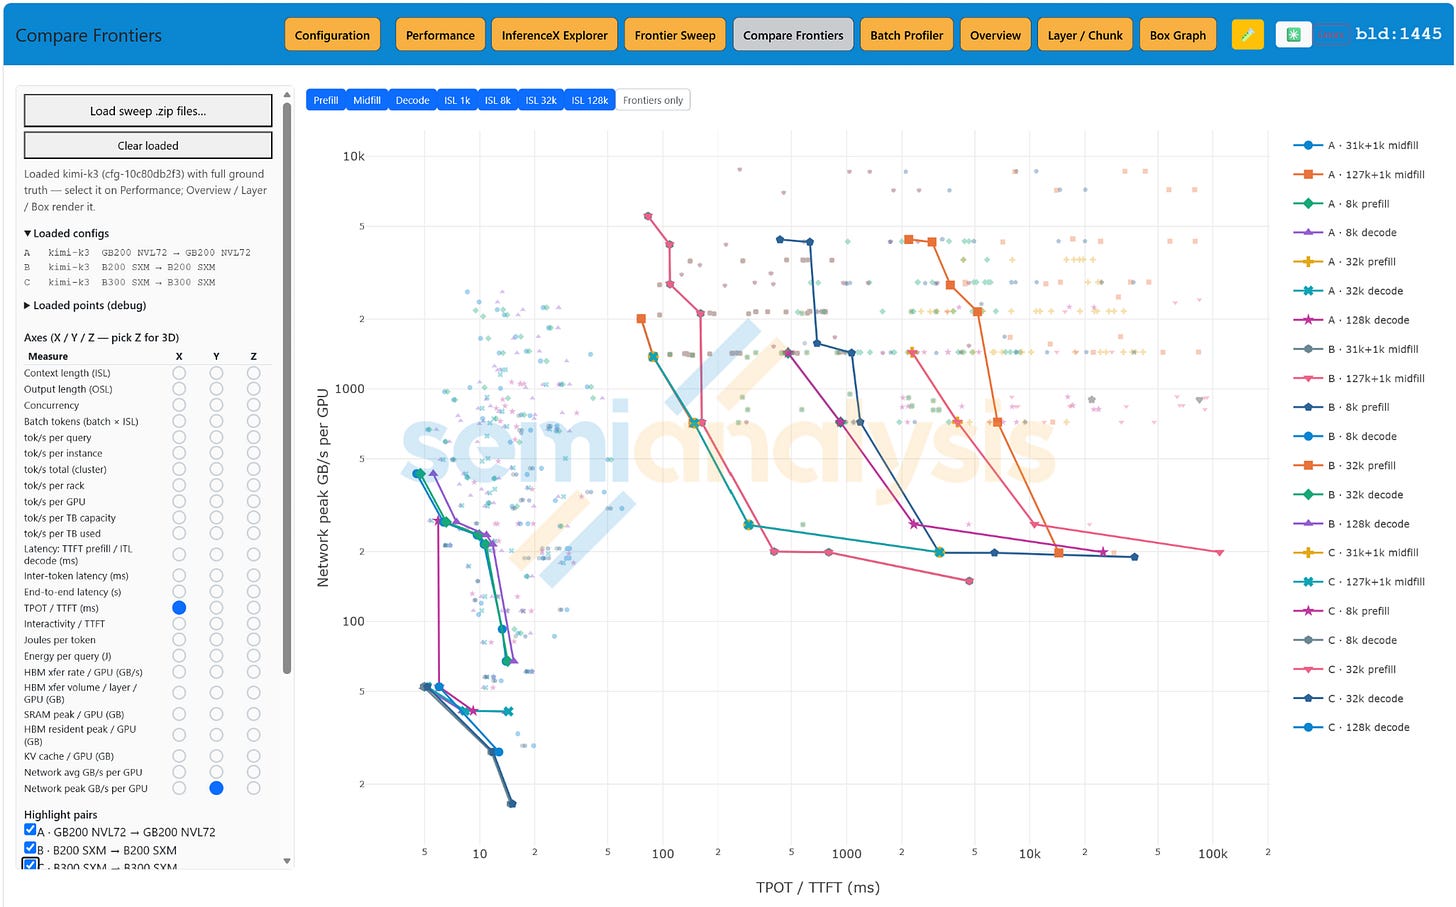
前面的章节描述了一种推理模型布局的方法。一个有效的检验方式,是将其应用于一个具体的前沿模型,并一并探讨由此产生的权衡。下图展示了 Kimi K3 在 B200、B300 和 GB200 系统上的建模性能,采用的配置从单机架 16 到 64 个 GPU 不等。这些是基于工作负载和硬件的推算结果,并非实测的基准数据。图中的连线标出了预测的 Pareto 前沿:即在不牺牲吞吐量或其他选定目标的前提下,交互性无法再提升的那些配置。
22.1 交互性与吞吐量
第一张图比较了两个指标:解码阶段的每个输出 token 耗时(或 prefill 和 midfill 的首 token 耗时),以及每 GPU 每秒 token 数。将吞吐量按每 GPU 归一化后,不同规模的配置就可以直接比较了。
左下方的分组包含 8k 和 32k 输入上下文的解码(decode)边界。三种 GPU 类型都存在可行配置。GB200 在大部分边界上都表现强劲,而 B200 和 B300 也提供了有竞争力的点。延迟最低的解码配置通常结合了流水线并行和张量并行。在面向吞吐量的一端,每 GPU 每秒 token 数最高的配置往往来自每 GPU 一个注意力实例,不使用张量或流水线并行,而专家并行则保持系统允许的最大宽度。
上中位置的分组是 midfill:先有 127k 个已缓存的输入 token,再追加 1k 个 token,然后进入解码。GB200 在低 TTFT 部分领先,无需流水线并行,使用 TP=4 或 TP=2。B300 在面向吞吐量的一端逐渐追上。B200 和 B300 通常使用 PP=4,专家并行限制在每个阶段内,这样专家 all-to-all 通信就保持在节点内部。
右上方的两个分组是 8k 和 32k token 的预填充(prefill)。三种 GPU 类型收敛到相似的配置:PP=4,其中 TP=4 或 TP=2 以牺牲一定吞吐量为代价换取更低的 TTFT。它们接近的预测性能反映了两点:这些 GPU 共享 Blackwell 计算架构,而且这些预填充工作负载本质上受计算能力限制。
Figure 26. Projected interactivity and throughput frontiers for decode, midfill, and prefill. Source: SemiAnalysis Inference Simulator.
22.2 每次查询的能耗
第二张图使用相同的模拟配置,但将纵轴改为每次已完成查询的能耗。解码是能耗最大的工作负载,因为建模的输出长度为 1,000 个 token,每个查询需要大约 1,000 次经过模型。Midfill 的能耗最低:它是在一次经过已有的长上下文之后,追加一段相对较短的序列。完整的 8k 和 32k 预填充则需要依次消耗更多的能量。
该模型包含了 Kimi K3 的局部注意力层,因此保留状态和计算量都反映了这种注意力结构带来的预期节省,而不是把每一层都当作全量注意力来处理。
Figure 27. Projected energy per query for the same decode, midfill, and prefill frontiers. Source: SemiAnalysis Inference Simulator.
22.3 快速内存需求
第三张图展示了每 GPU 的峰值 HBM 占用量。它不包括 KV 状态进出 worker 时使用的额外缓冲区,这些缓冲区可能为每个 GPU 增加数 GB 的占用。在对话轮次或智能体轮次之间,不活跃的 KV blob 可以并行传输到网络挂载的 DDR,包括挂载到节点 CPU 的 DRAM。这种内存更便宜、供应更充足,也不受 HBM 供应链的限制。
预测的边界集中在可行内存范围的低端。对于预填充和 midfill,台阶式的下降来自增加流水线并行以及提高张量或数据并行度,包括数据并行的环批处理(ring-batched)实例。解码则首先通过张量或数据并行来降低每 GPU 的占用量,之后才使用流水线并行。
即便预留了实际所需的 KV 传输缓冲区,大多数前沿配置在每块 GPU 上的占用仍低于约 80 GB。这印证了此前的结论:只要更广泛的存储与编排系统能及时转移闲置状态,带宽的价值可能超过在每个加速器上最大化 HBM 容量。
Figure 28. Projected peak HBM residency per GPU across the simulated frontiers. Source: SemiAnalysis Inference Simulator.
22.4 网络峰值与 scale-up 边界
第四张图展示了每块 GPU 的预估峰值网络流量。Prefill 和 midfill 阶段会密集使用网络来执行专家并行,因为同时有大量被路由的激活值在传输中。因此流水线并行在 B200 和 B300 系统上尤其有用:将一个阶段放置在节点内部,可以让其专家 all-to-all 流量保持在本地 NVLink 网络中。
GB200 NVL72 将 scale-up 带宽扩展到整个机架。因此更多 GPU 可以并行参与同一层,所有实例同步推进该层,从而在不跨越较弱的网络边界的前提下,同时改善延迟和吞吐量。
Decode 阶段的区间平均峰值较低,因为小批次一次只会查询相对较少的专家。但单次传输仍会以 NVLink 的物理速率突发;图中较低的数值只是因为测量区间长于传输本身的持续时间。在规划网络规模和解读利用率时,区分瞬时链路速率与持续流量非常重要。
Figure 29. Projected peak network traffic per GPU and the benefit of keeping expert traffic inside the scale-up domain. Source: SemiAnalysis Inference Simulator.
这四个视角讲述了一致的故事。最佳配置会随运行模式以及延迟-吞吐前沿上所选的点位而变化。Prefill 和 midfill 奖励有组织的并行与阶段本地的专家流量。Decode 在低延迟端受益于并行,但单 GPU 最高吞吐量来自更简单的 attention 实例配合更宽的专家放置。纵观所有预估的前沿,高速存储容量似乎不如网络布局、内存带宽和编排那样具有约束力。
结语
对推理而言,有价值的分析单位并非仅仅是总参数量,而是模型的活跃数据流与机器的内存、通信和时序层级相结合的整体。
MoE 提供了结构。层组不断重复。专家数量众多,但每个都可单独管理。Attention 覆盖面广,且日益受到 KV 状态的影响。各个操作按顺序执行,可以复用硬件。流水线并行、张量并行和专家并行各自可以沿着最自然的维度展开。Prefill 和 midfill 可以将路由整理为高效的专家批次,而 decode 则可以保持短批次和高交互性。
硬件可以体现这种结构。逻辑加速器对等集(peer set)提供了一个有界的扩展(scale-up)域。节点堆叠成机架,一个机架可以是一个扩展型 worker,也可以是若干个流水线阶段。共享存储让 KV blob 可以移动。数据中心网络连接的是有界的 worker,而不是承载每一次内部张量运算。调度则让可预测阶段与随机阶段保持稳定流动。
以这种方式把握问题并不能消除其规模,但能让规模更易于切分。模型、worker、机架、存储系统和调度器由此成为同一个连贯设计中的组成部分,可以被度量、被呈现,也可以被持续改进。