← 全部文章
Engrams Embedding Entendre: Codesign for Efficient DRAM/SSD Offloading
2026-09-18 · 原文
Engram 通过学习到的多 token 查找机制扩展了标准的 token embedding。模型可以直接检索重复出现的局部模式对应的向量,从而减少通过 attention 和前馈层重建这些向量的需求。
Engram 的模型架构优化意味着在相同的模型质量下,所需的 HBM 容量可以更低。这并不意味着对 HBM 的疯狂需求会消失,而只是说明模型架构会继续围绕这些约束进行创新。
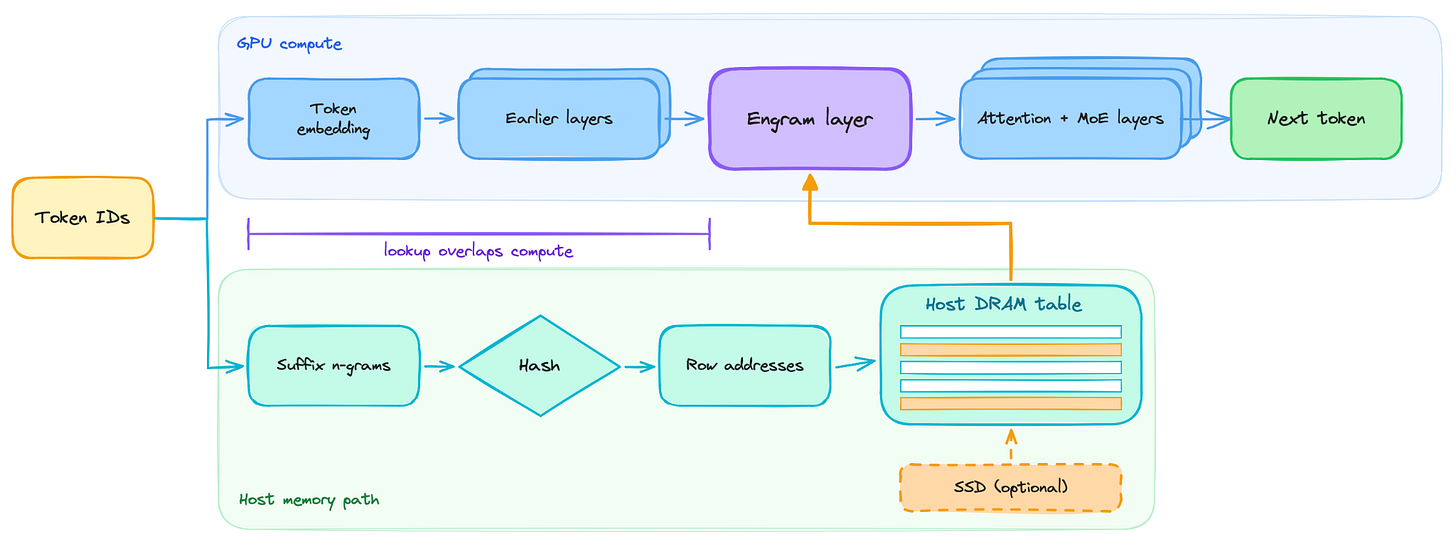
这种模型架构设计天然适合与参数 offloading 协同设计:每个 token 只访问少量 embedding 行,而这些行的地址取决于 token ID,而非隐藏状态。运行时可以在前面的层进行计算时,从主机 DRAM 预取这些行,从而将查找表保留在 HBM 之外,也无需传输整个权重矩阵。我们的 Memory 模型包含我们对 HBM、DRAM 和 NAND 供需情况的最新逐季度预估。
Source: SemiAnalysis
Offloading 释放出的 HBM 可用于模型权重和 KV cache,从而有可能支持更大的 batch 或更多并发会话。当 DRAM 成为下一个瓶颈时,NVMe 则提供了另一个存储层级。推荐系统早已将频繁访问或最近访问的 embedding 行缓存到更快的内存中,而将较冷的数据行放在 SSD 上。在 NVIDIA 因 Rubin Ultra 大幅降配(从每颗芯片 1024GB 的 HBM 缩减到如今约 200GB)而不得不调整路线图之后,像 Engram 这样的模型架构优化或许会大有帮助。
我们的 DeepSeek-V4.1-Flash 配置中,Engram 大约占用 189 GiB 内存。我们将其替换为内存映射(mmap)文件,并测量将 Engram offload 到 SSD 后的推理服务性能。
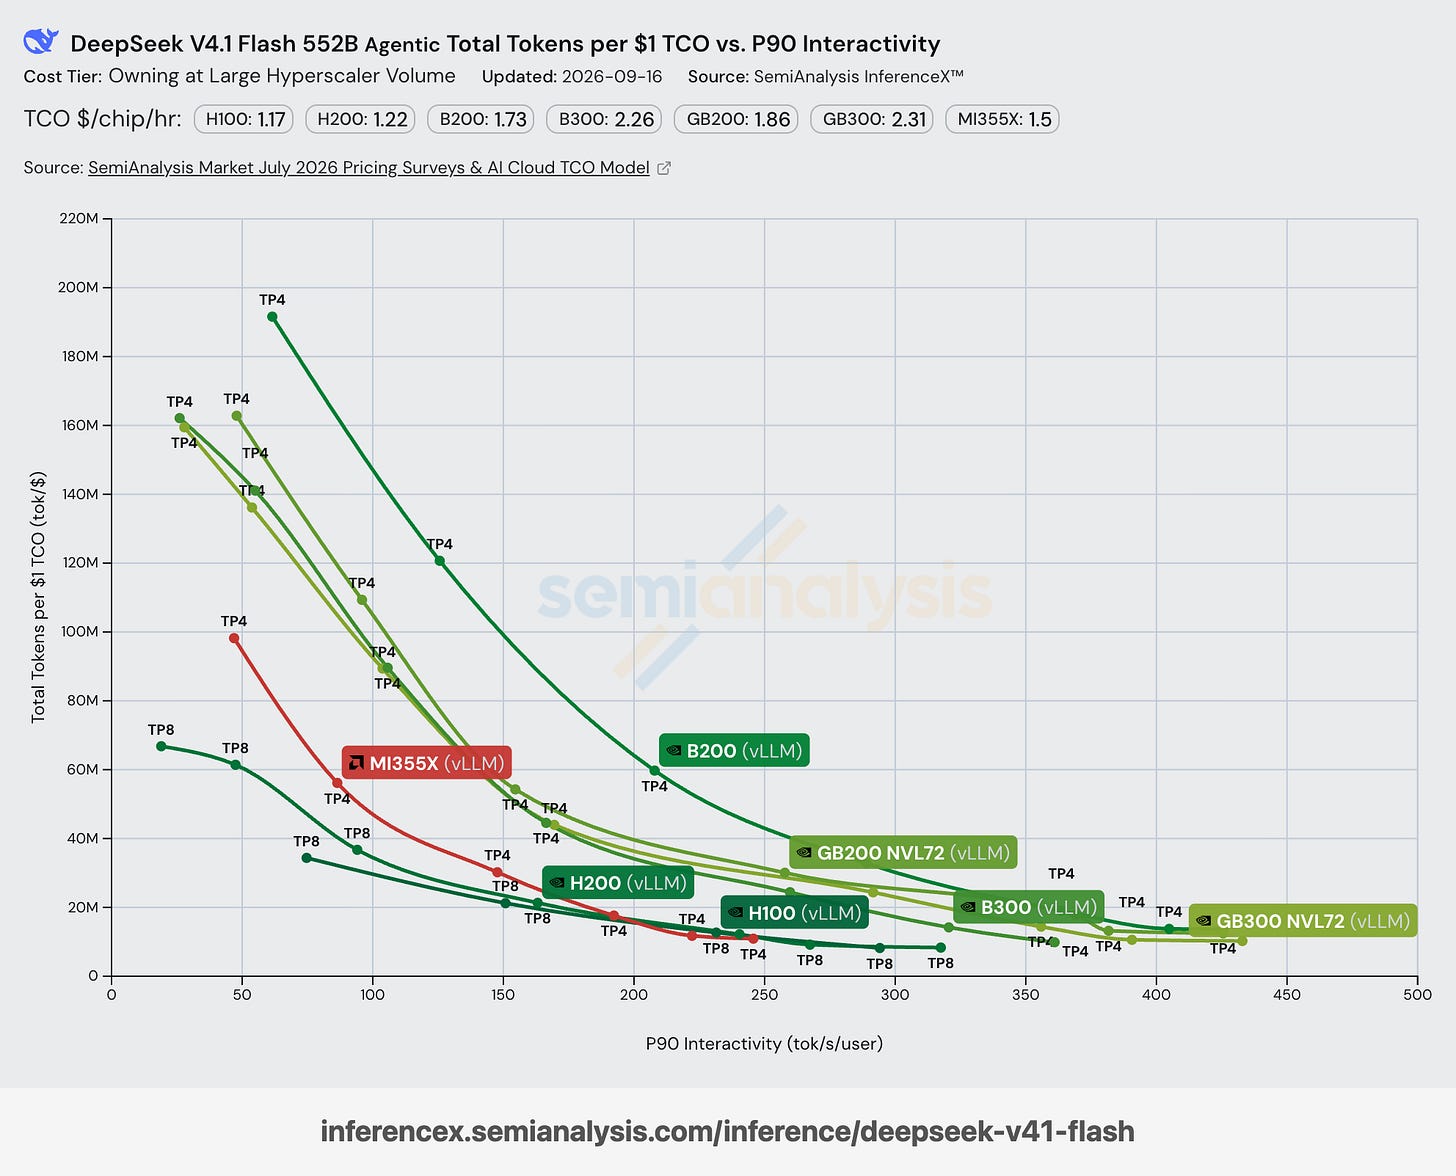
在报告的后续部分,我们将展示 Engram offloading 实验,以及在全部 6 款 NVIDIA GPU SKU 和 MI355X 上,对 DeepSeek-V4.1-Flash 等 Engram 模型进行官方 InferenceX 智能体推理服务测试的结果。不出所料,在超热门的 DeepSeek-V4.1-Flash 模型上,CUDA 护城河依旧让 MI355X 望尘莫及。
我们还展示了即使在超高容量 HBM 的 SKU 上,将 Engram offload 到 DRAM 对大多数 Pareto 前沿场景而言,也可能比将 Engram 保留在 HBM 中带来更好的性能。
我们的基准测试已被几乎所有主要算力买家广泛复现、验证和/或支持,包括 Google Cloud、Microsoft Azure、Oracle、Meta 等等。此外,它还获得了机器学习社区的支持,包括 vLLM、LMCache、SGLang、PyTorch、Huggingface,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等主要实验室的支持。
Source: InferenceX
如果你觉得这个开源基准测试和数据有用,请在 InferenceX 的 GitHub 仓库上点个 Star!InferenceX 是世界上唯一涵盖 TPUv7、Jalapeño、NVIDIA Rubin NVL72、AMD,以及即将加入的 SambaNova 和 Trainium 的推理基准测试。由于 AgentX 场景非常贴近真实的智能体推理工作负载,AMD 也已承诺在 MI455X UALoE72 上展开合作。
Source: SemiAnalysis
Engram 的优势
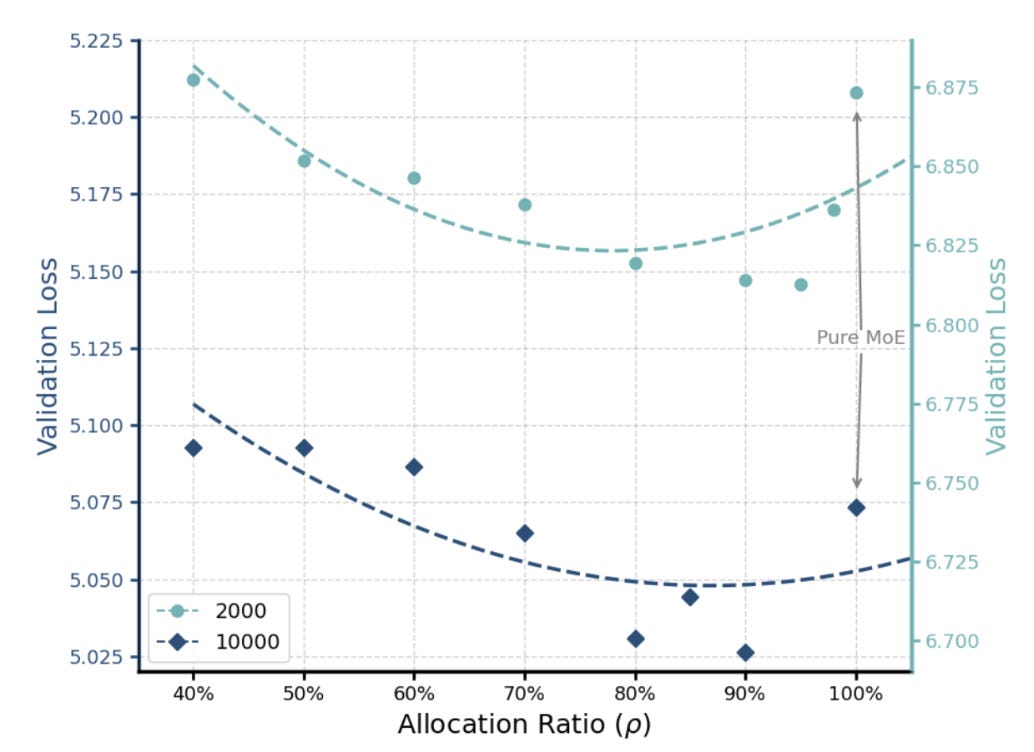
DeepSeek 并未发布原论文中训练好的两个 Engram 模型。我们使用其开源代码和训练超参数,在 fineweb-edu 上复现了该实验设置,每次运行的估算开销约为 6E18 FLOPs。我们观察到了同样的 U 形缩放趋势:
Source: SemiAnalysis
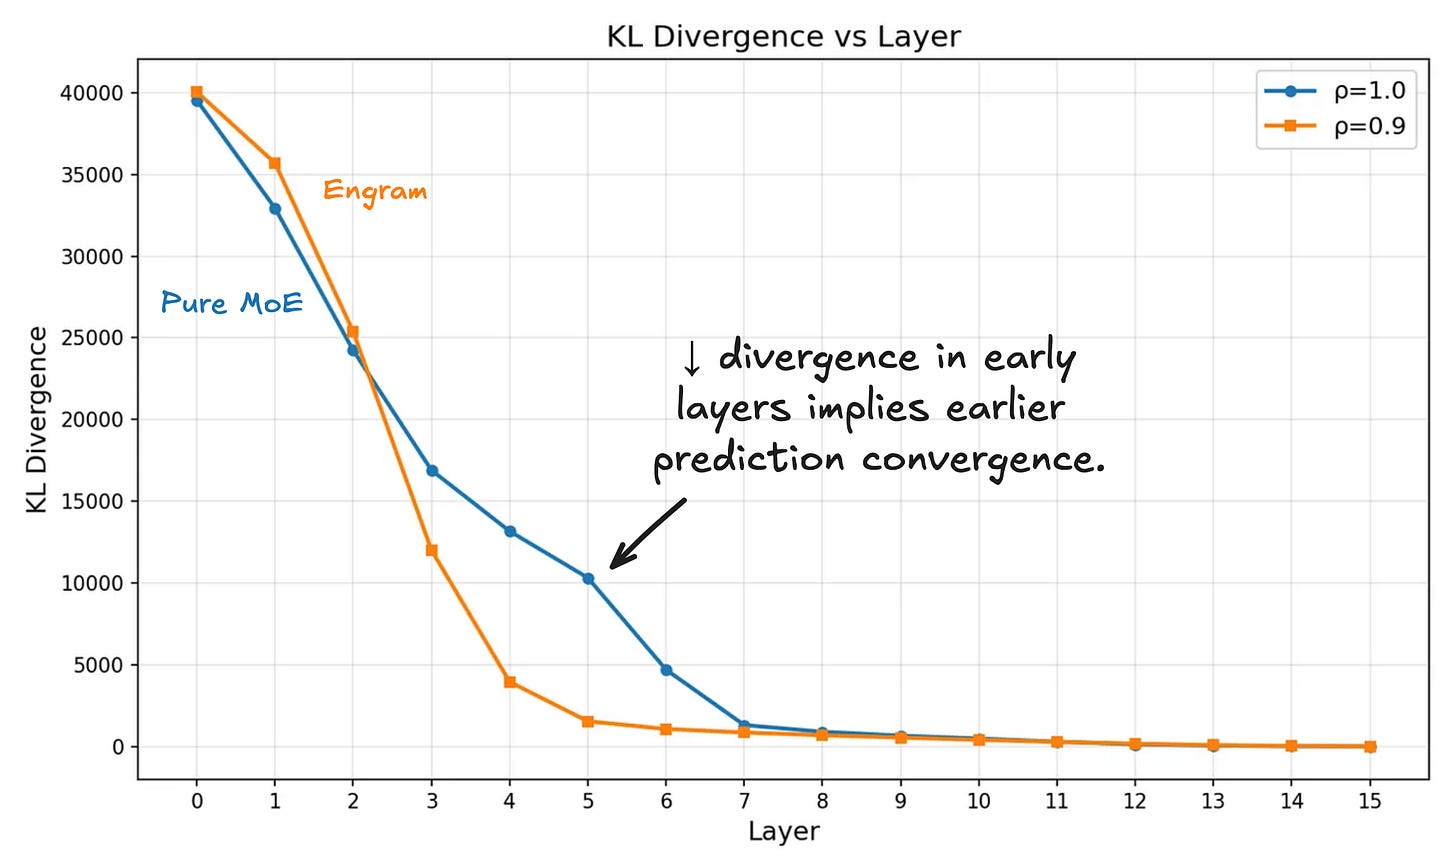
Engram 相比纯 MoE 基线带来了性能提升。我们还复现了 DeepSeek 的结果:使用 Engram 后,较早层的表征与较晚层的表征更加相似。
Source: SemiAnalysis
记忆的是什么?
与原 Engram 论文类似,我们可以探测 Engram 的门控得分,看看 DeepSeek-V4.1-Flash 最常利用哪些 n-gram。我们的门控扫描发现了人名、代码片段、关系型措辞以及模板化内容。这些示例的选取优先考虑有趣程度,而非门控强度。
一个出人意料的结果是《逆转裁判》(Wright: Ace Attorney)。
Source: SemiAnalysis
这些示例表明,学习到的记忆优化的是训练目标,而不是对哪些事实值得存储的判断。许可证信息、参考文献片段、API 样板代码和网站通用元素都可能提供预测捷径,因此额外的 Engram 容量的价值可能取决于数据预处理后留存的内容。这并不意味着表容量被「浪费」了:评估语料库的扫描既无法确定训练时的接触情况,也无法确定各类别所占用的容量。
对于卸载(offloading)而言,强门控并不能识别缓存热点行。低门控也不会自动减少读取:计算门控本身需要先取回 key,这会抵消融合内核带来的性能收益。要跳过读取,需要在检索之前引入一个独立的有效性预测器。
移除 Engram
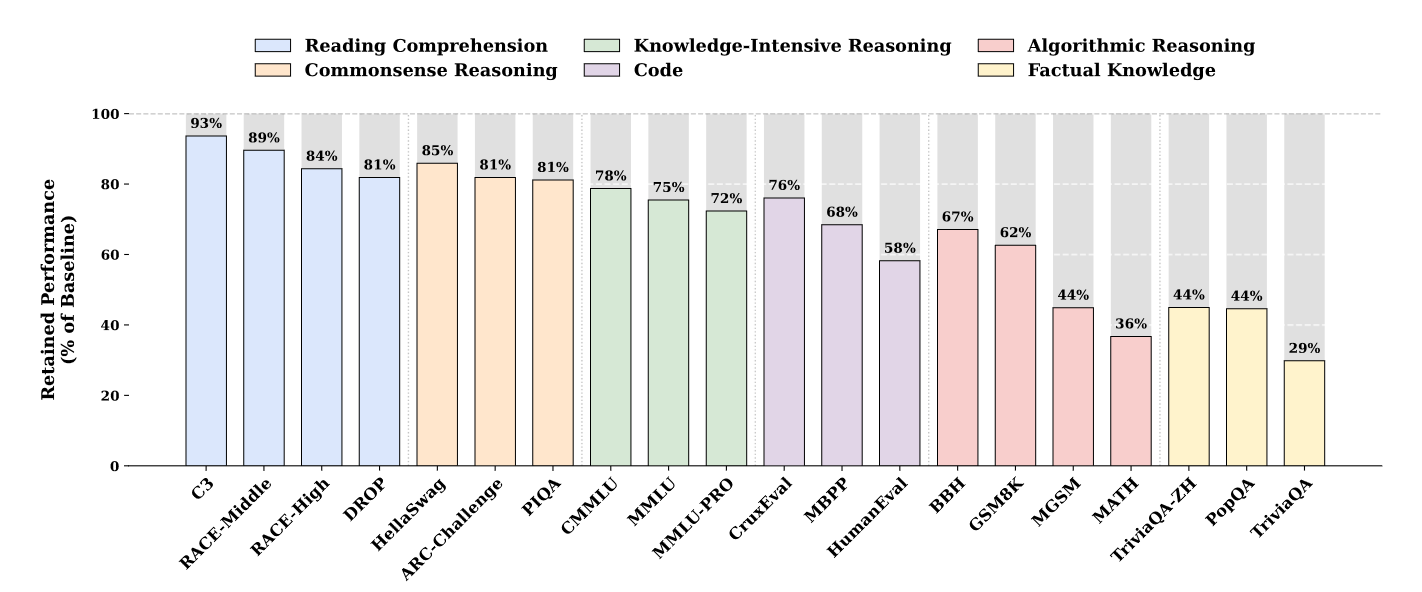
在原论文的推理时消融实验中,事实知识类基准仅保留了原有性能的 29–44%,而阅读理解类则保留了 81–93%。这是由训练与推理之间的失配造成的。因此,由此产生的性能退化衡量的是该已训练模型对 Engram 的依赖程度,而不是有无 Engram 训练的模型之间的性能差异。
Source: DeepSeek
在我们的消融实验中,抑制 Engram 会使所有评估领域的 token 似然值变差,尤其是百科文本和若干代码语料库。令人意外的是,GSM8K 的准确率始终处于测得的运行间波动范围之内,移除 Engram 没有产生任何影响。
Engram 并不是挂在原封不动的 MoE 旁边、可以随时拆下的字典。移除它会改变下游特征和专家选择。
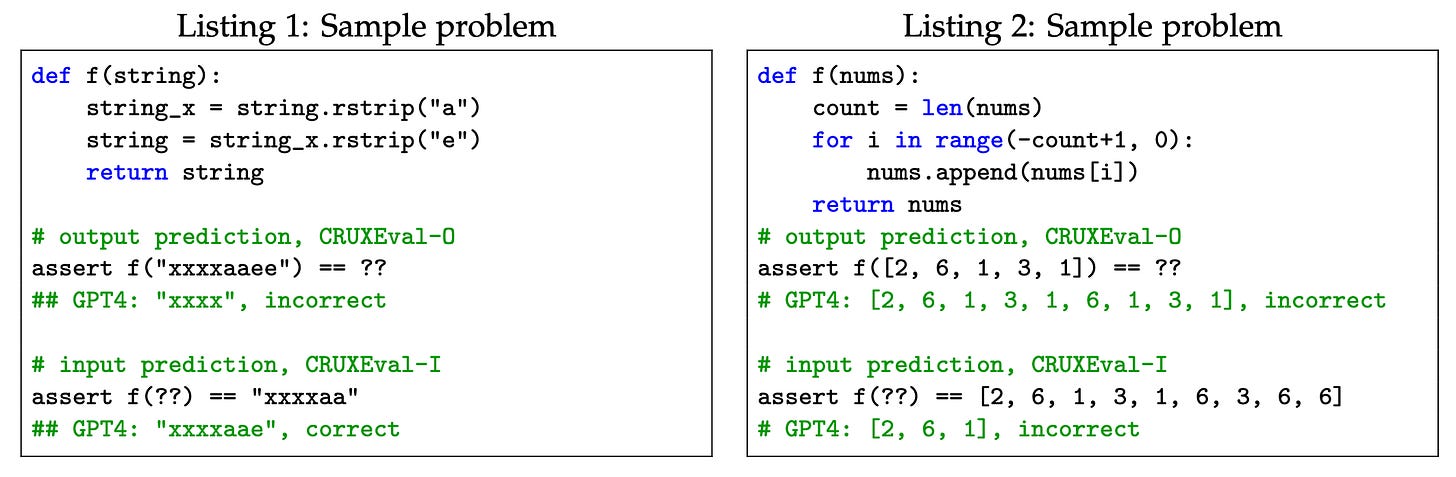
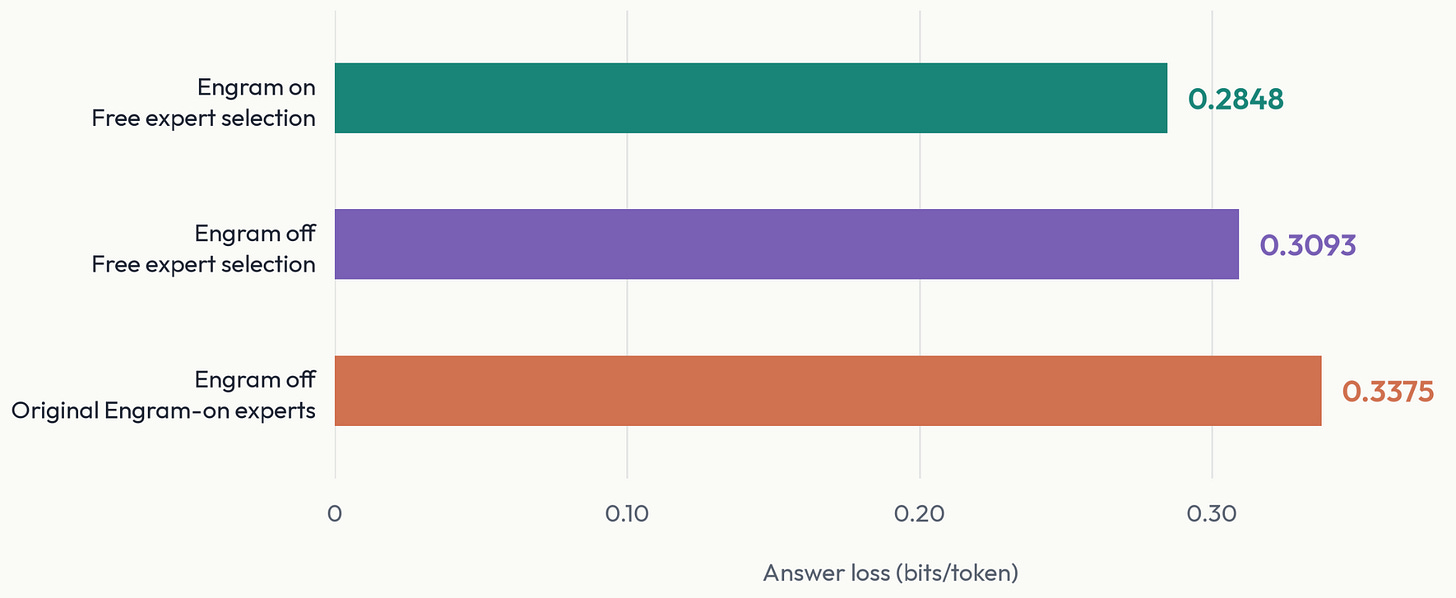
我们测试了重路由(rerouting)究竟是有害还是起到补偿作用,方法是在 CRUXEval 上进行一项固定 token 的教师强制(teacher-forced)实验。CRUXEval 是一个由小型 Python 函数组成的代码推理基准,模型需要根据函数代码和输入预测函数的输出,我们对参考答案进行评分。
Source: CRUXEval
移除 Engram 使答案损失从 0.2848 上升到 0.3093 bits/token。而强制被消融的模型沿用原始启用 Engram 时的专家选择,结果更糟,达到 0.3375 bits/token。
Source: SemiAnalysis
重新路由只能部分弥补缺失的记忆。记忆特性与专家选择是协同工作的,而不是遵循“记忆存储事实、专家负责推理”这种泾渭分明的分工。
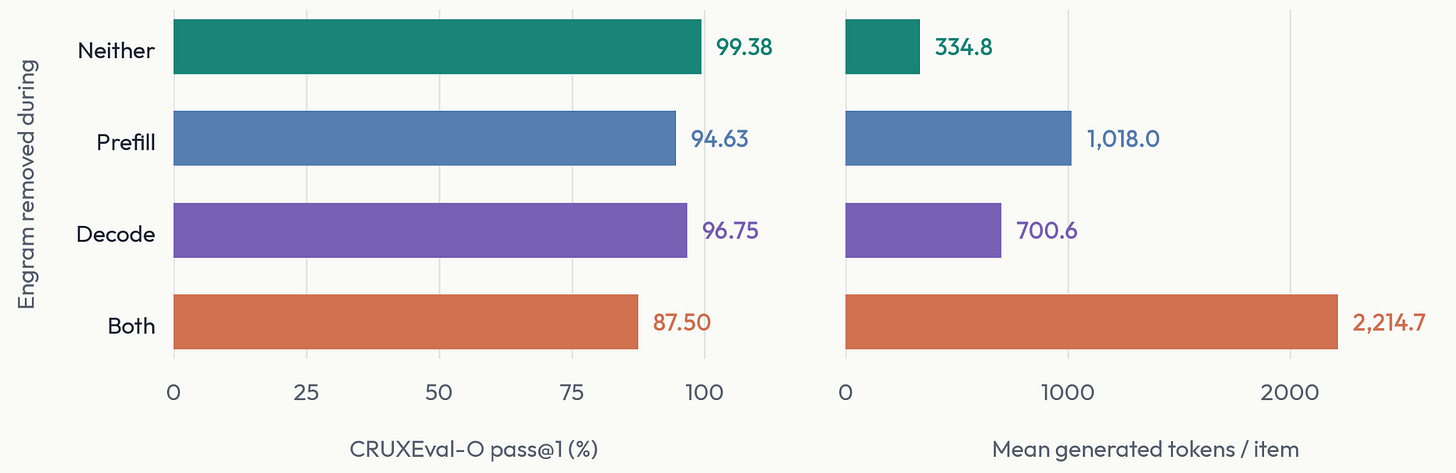
在同一个 CRUXeval 上,无论是哪个阶段移除 Engram,准确率都会下降、生成 token 数会增加;全程移除时变化最大。
Source: SemiAnalysis
保留 Engram 用于 prefill 比保留用于 decode 能得到更多正确答案,原因很可能是传给 decode worker 的 KV cache 语义信息更丰富,从而能够缓解一部分性能损失。
Agentic 推理服务性能
Engram 的表虽然很大,但每次查询的数据量很小。DeepSeek-V4.1-Flash 在两个 Engram 层各请求 24 行,对模型中每个被处理的 token 位置约 12.4 KiB,若分布在四块 GPU 上则每块 GPU 约 3.1 KiB。
Source: InferenceX
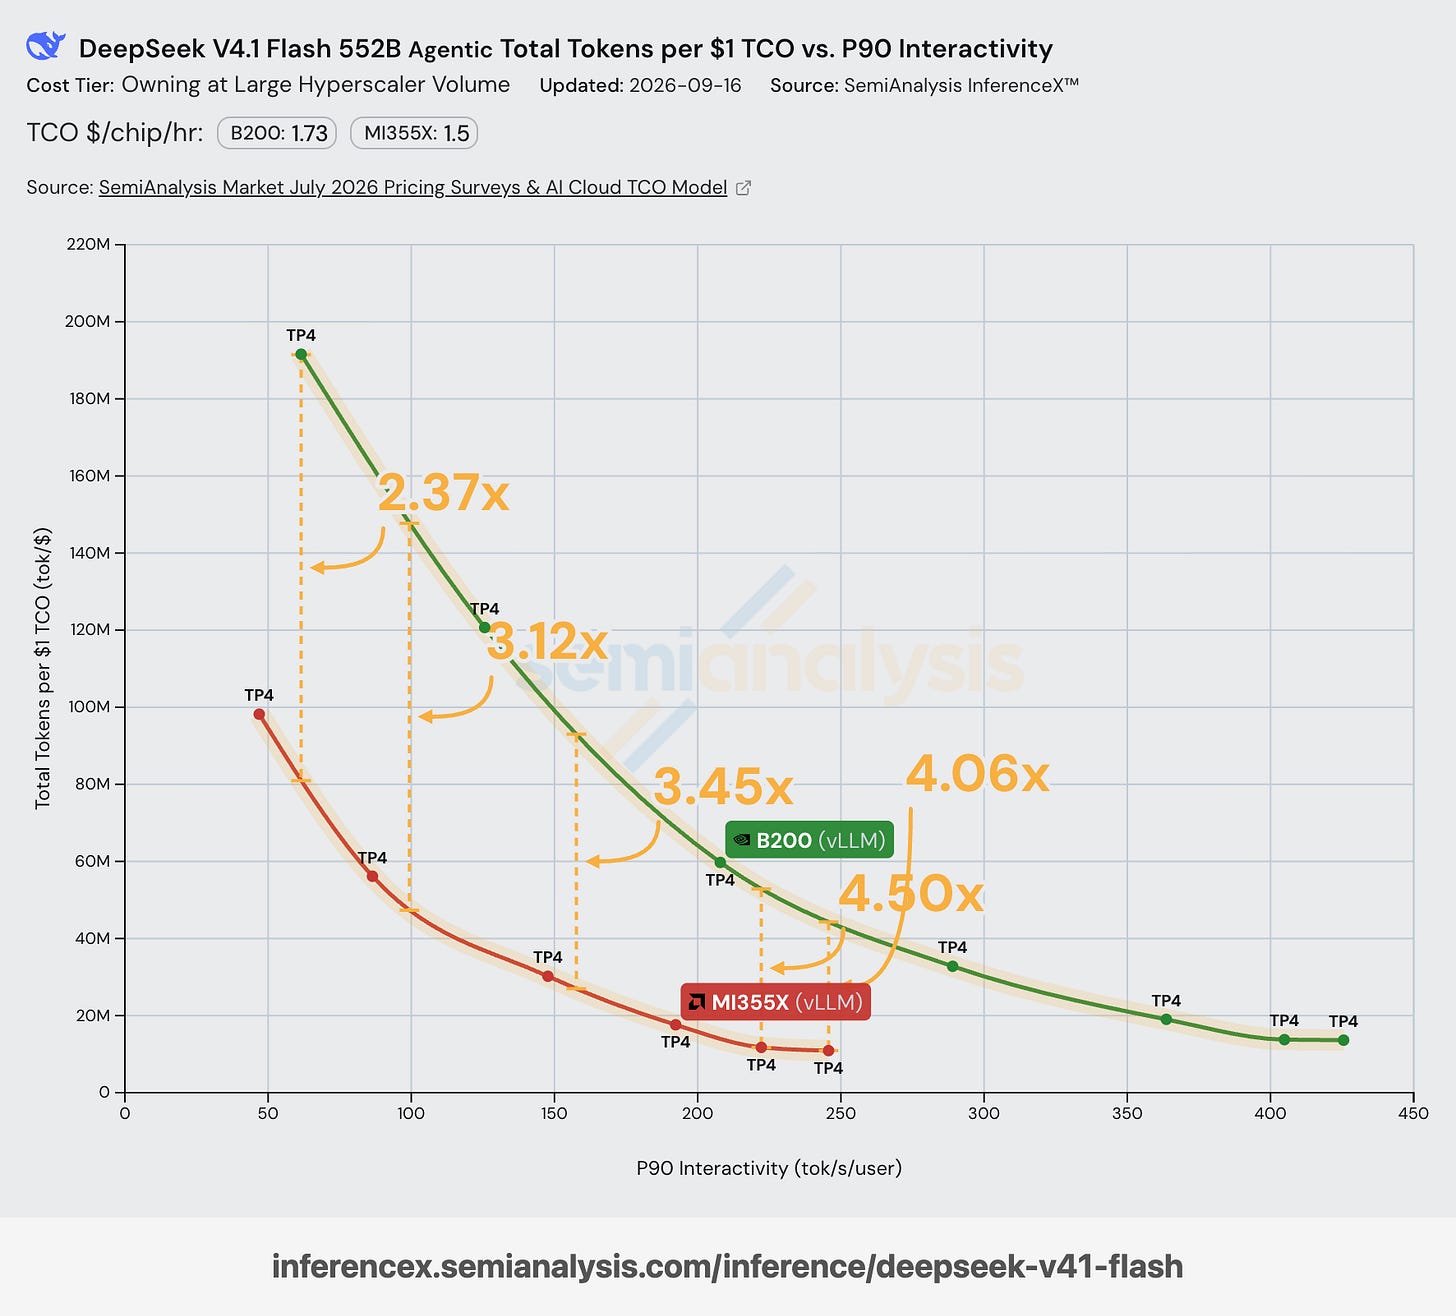
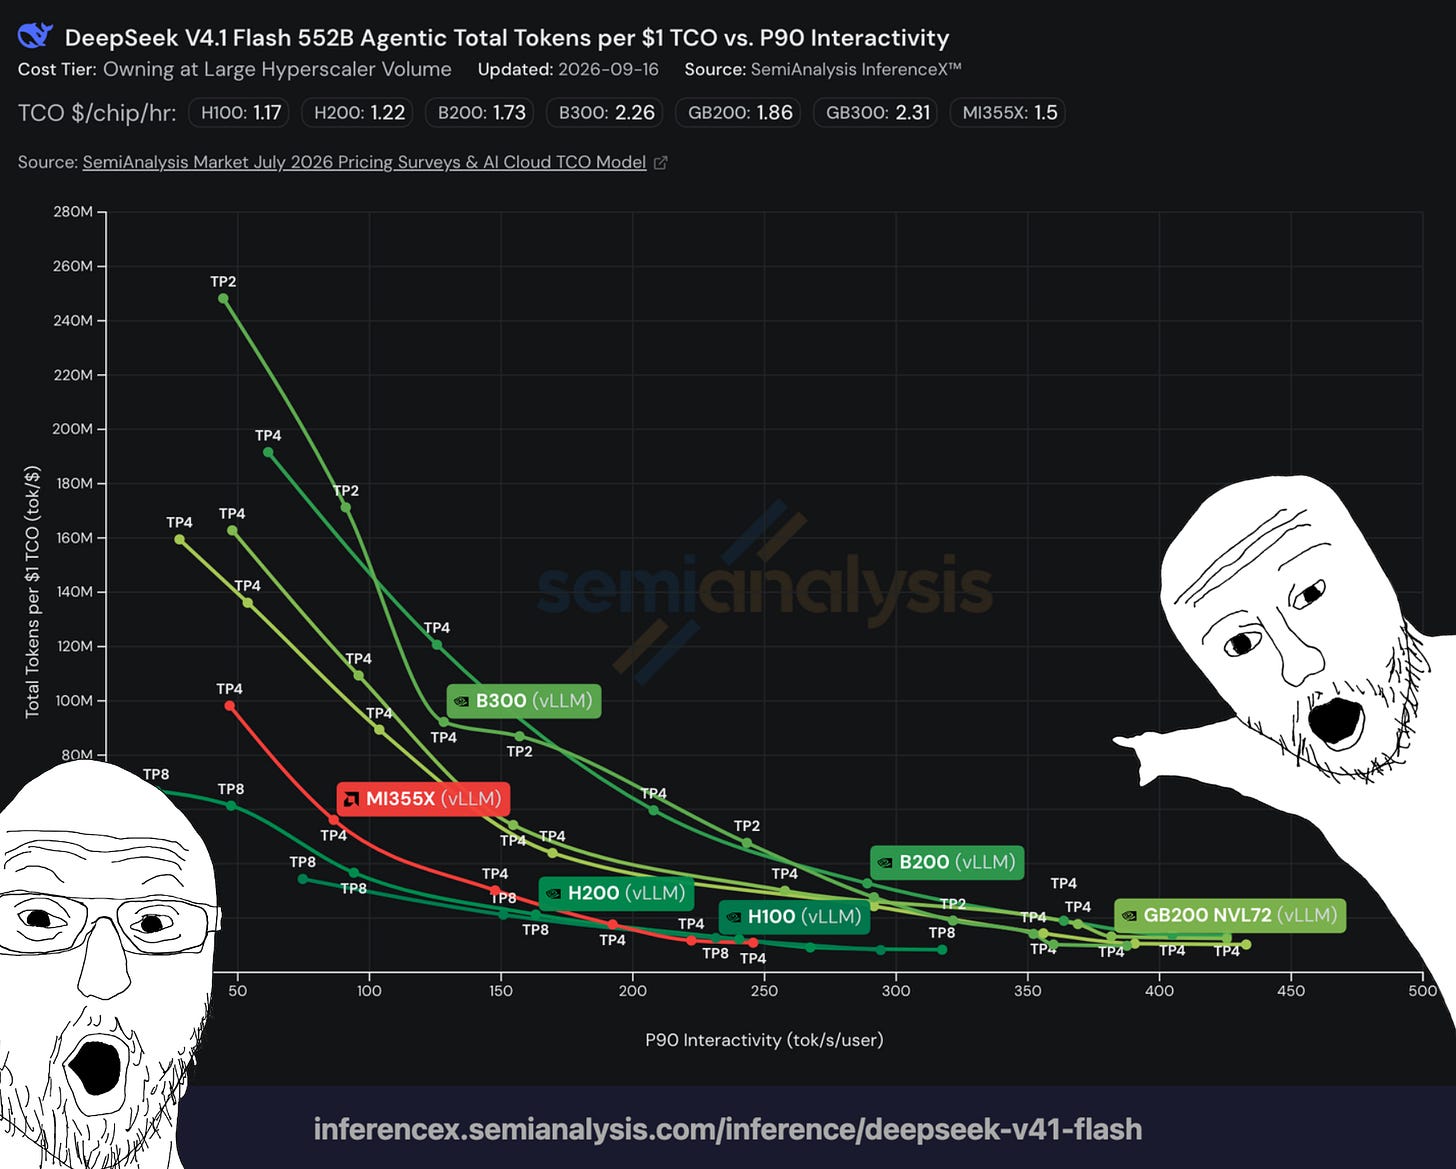
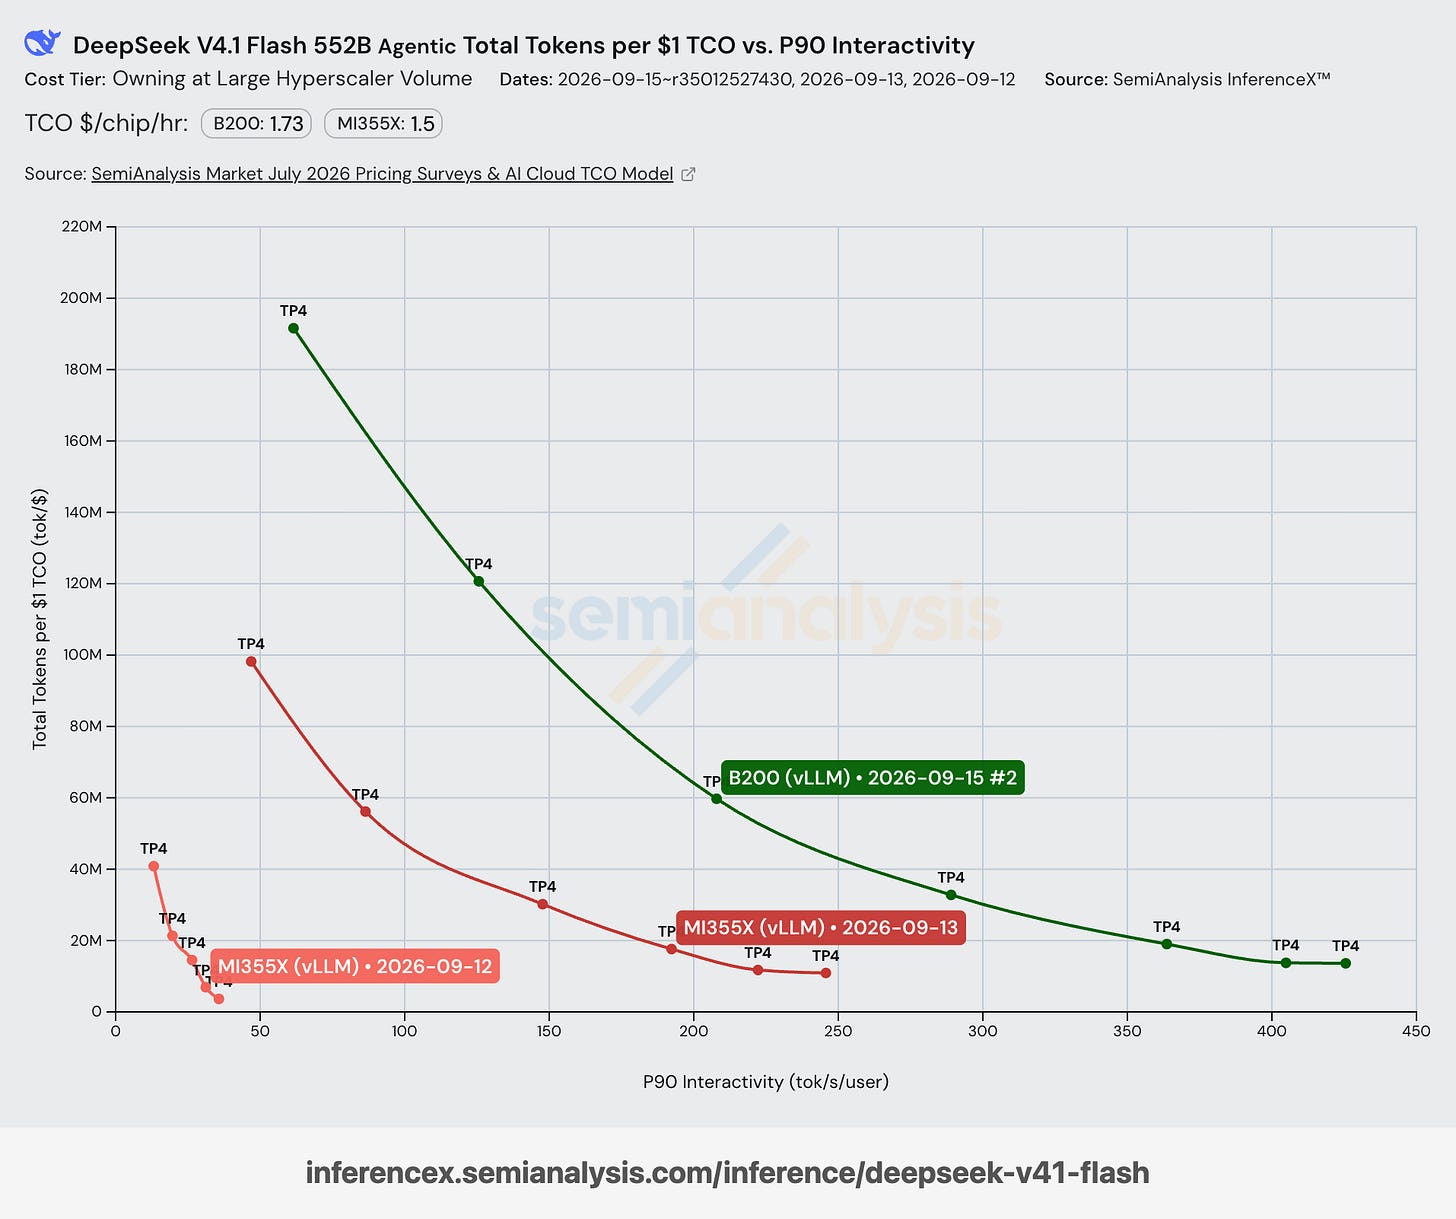
截至模型发布第 7 天,即使按 MI355X 更低的 TCO 归一化后,其每美元性能仍比 B200 差 2-4 倍。我们完整的总拥有成本测算来自我们的 AI Cloud TCO 模型,以及对 100 多家 GPU 云及其客户的月度市场调研。
Source: InferenceX
在 DeepSeekv4.1 Flash 发布的 Day 0,NVIDIA vLLM 在全部 6 个 SKU(H100、H200、B200、B300、GB200、GB300)上开箱即用,零问题!这要归功于 NVIDIA 和 Interact 团队的出色工作!相比之下,AMD vLLM 在 Day 0 无法运行 DeepSeekv4.1 Flash。来源:SemiAnalysis InferenceX
Source: InferenceX
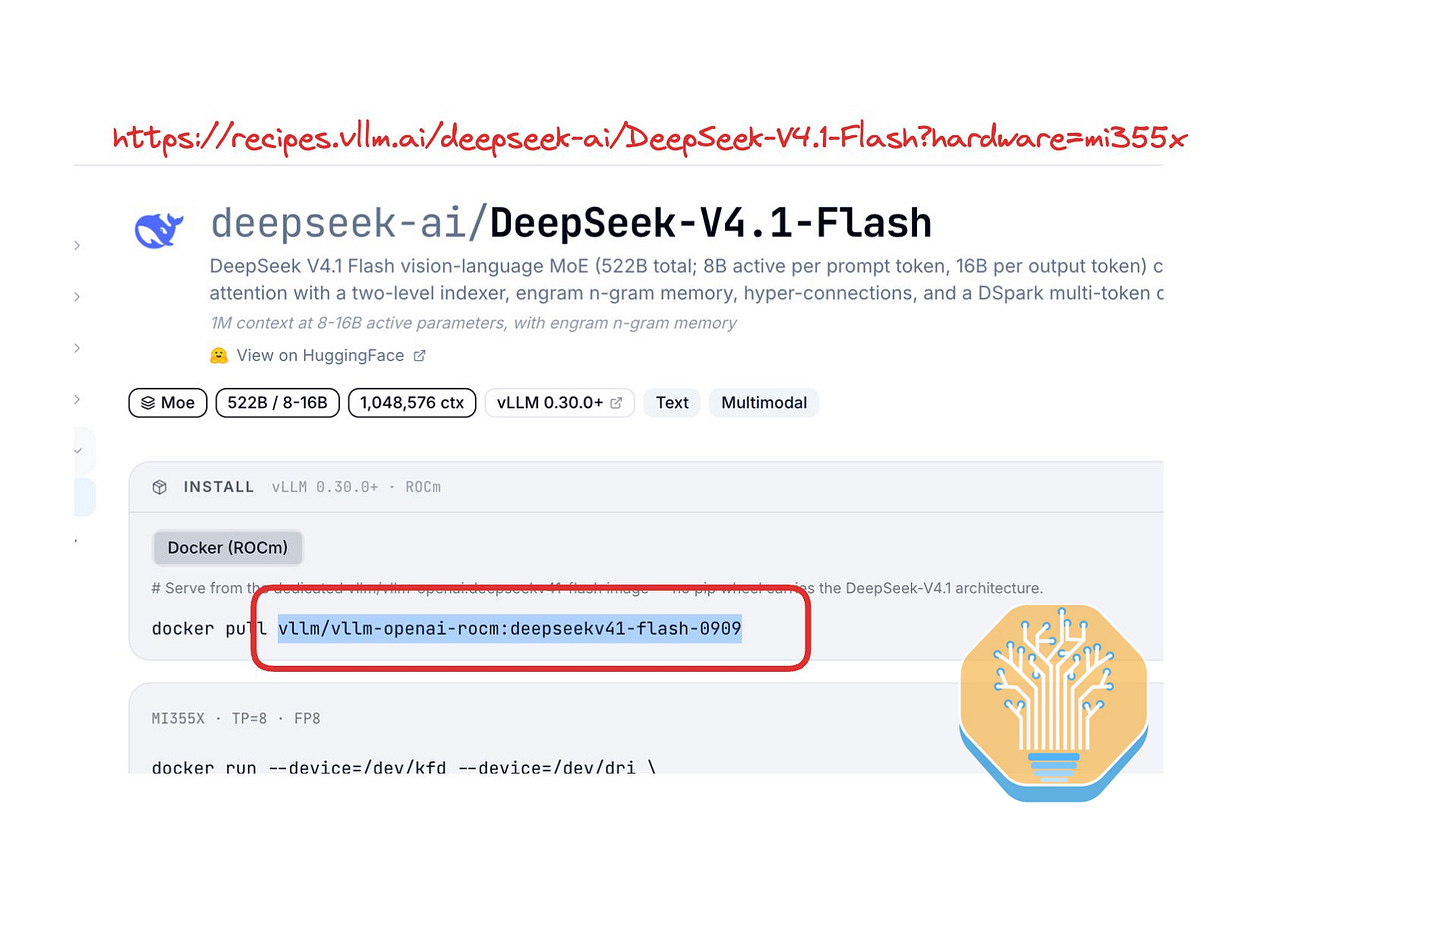
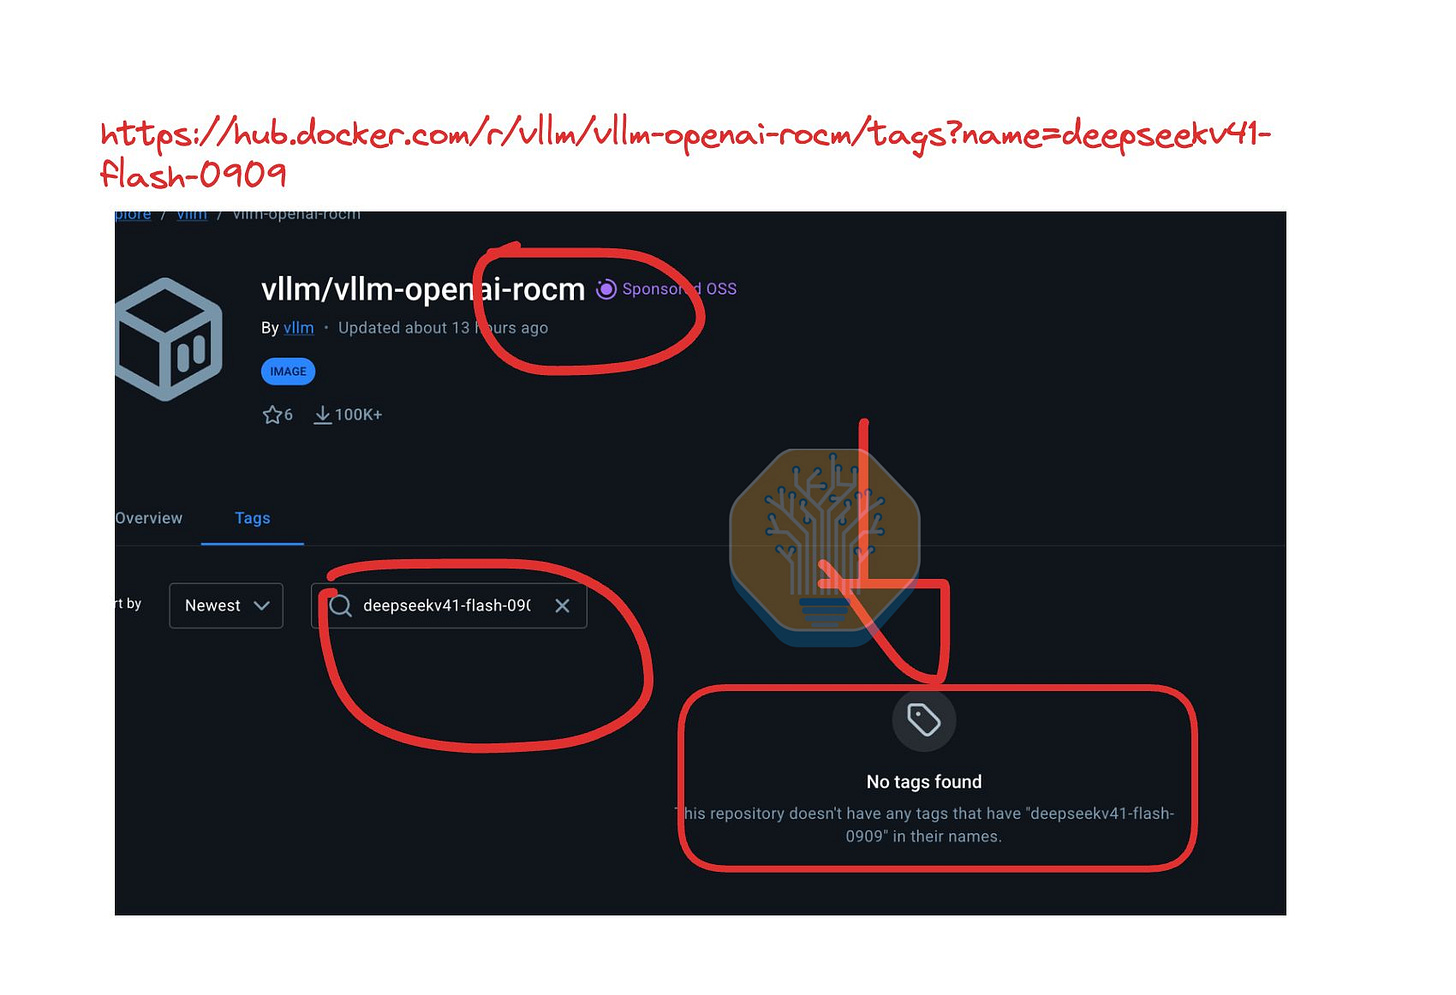
AMD 的 vLLM 文档指向使用 vllm/vllm-openai-rocm:deepseekv41-flash-0909 镜像,但从模型发布第 0 小时到第 23 小时,AMD 一直没有公开该镜像。AMD 声称“速度就是护城河”,但直到第 23 小时仍未发布。我们希望 AMD 团队今后能为第 0 小时的模型发布建立更好的流程。
Source: vLLM AMD
Source: vLLM, AMD, DockerHub
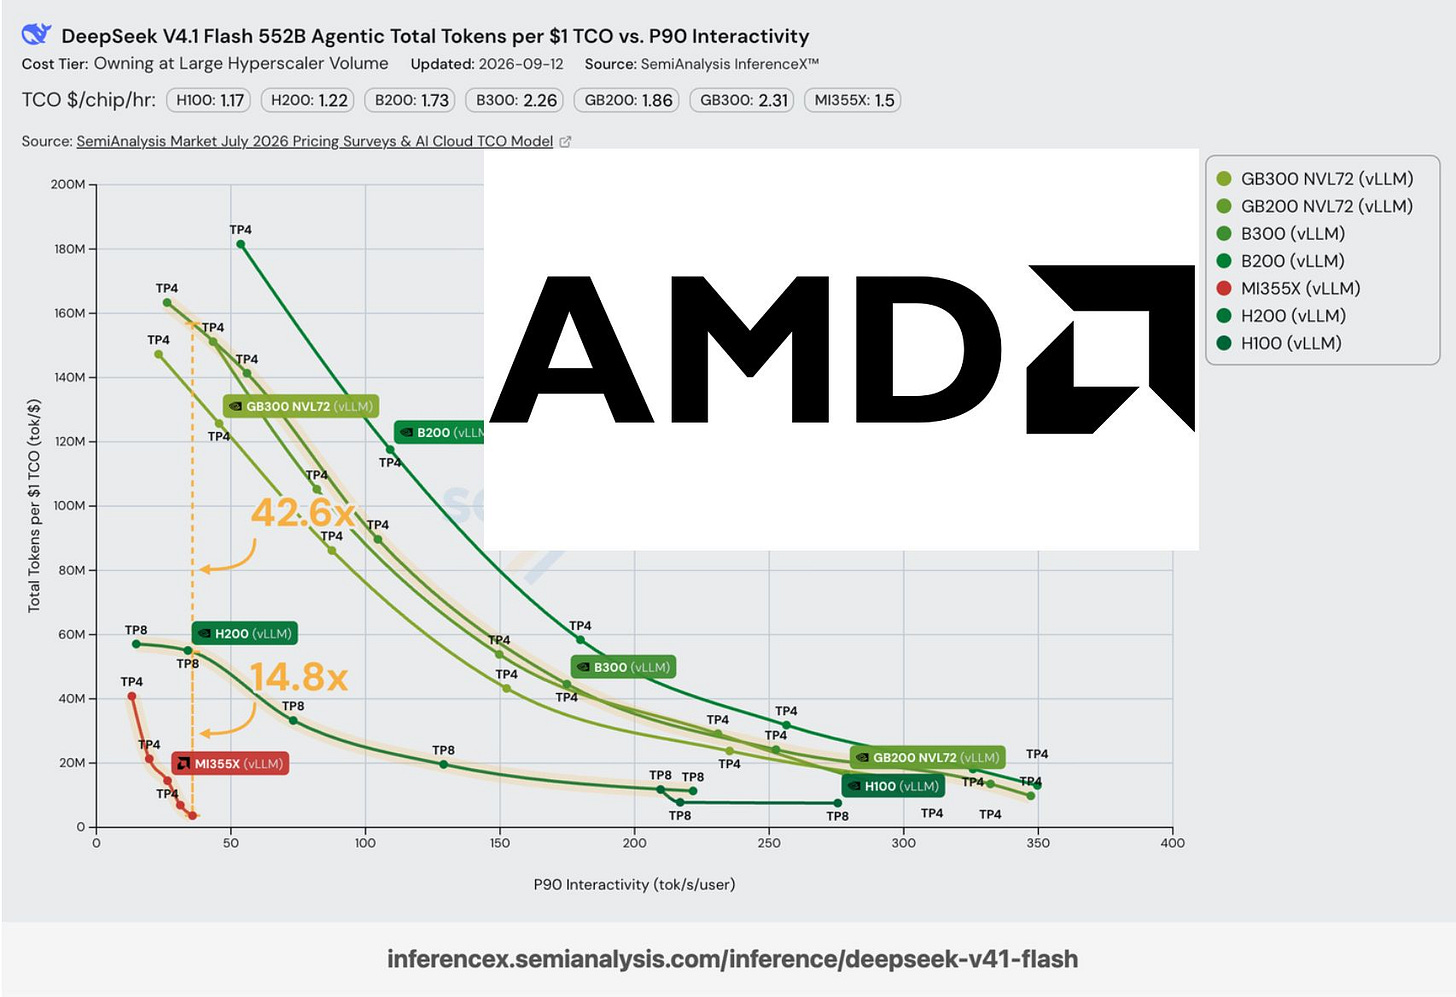
最终当 AMD 公开发布“Day 0”镜像支持时,从性能上看,其每美元性能目前比 H200 差最多 14.8 倍,比 B200/B300 差最多 42 倍。
CUDA 护城河的力量在于 NVIDIA 与其庞大的 600 万开发者社区生态的合作,其中包括大多数 vLLM、SGLang 和 Tokenspeed 的维护者,这意味着 CUDA 在 Day 0 就完成了优化。
Source: InferenceX
总体而言,AMD 确实取得了显著改进,但每美元性能目前仍比 B200 差 2-4 倍。
Source: InferenceX
AgentX Engram DRAM 卸载提升性能
HBM 和 DRAM 卸载使用同一个 GPU kernel 来选择行并反量化。在 HBM 模式下,它读取显存;在统一虚拟寻址(UVA)模式下,它直接读取锁定的主机内存。
两者都支持完整的 decode 图。将表放入 HBM 只会加速稀疏查询这一步,解码器的计算和通信保持不变,因此整体收益甚微,反而会占用本可供 KV cache 使用的显存。
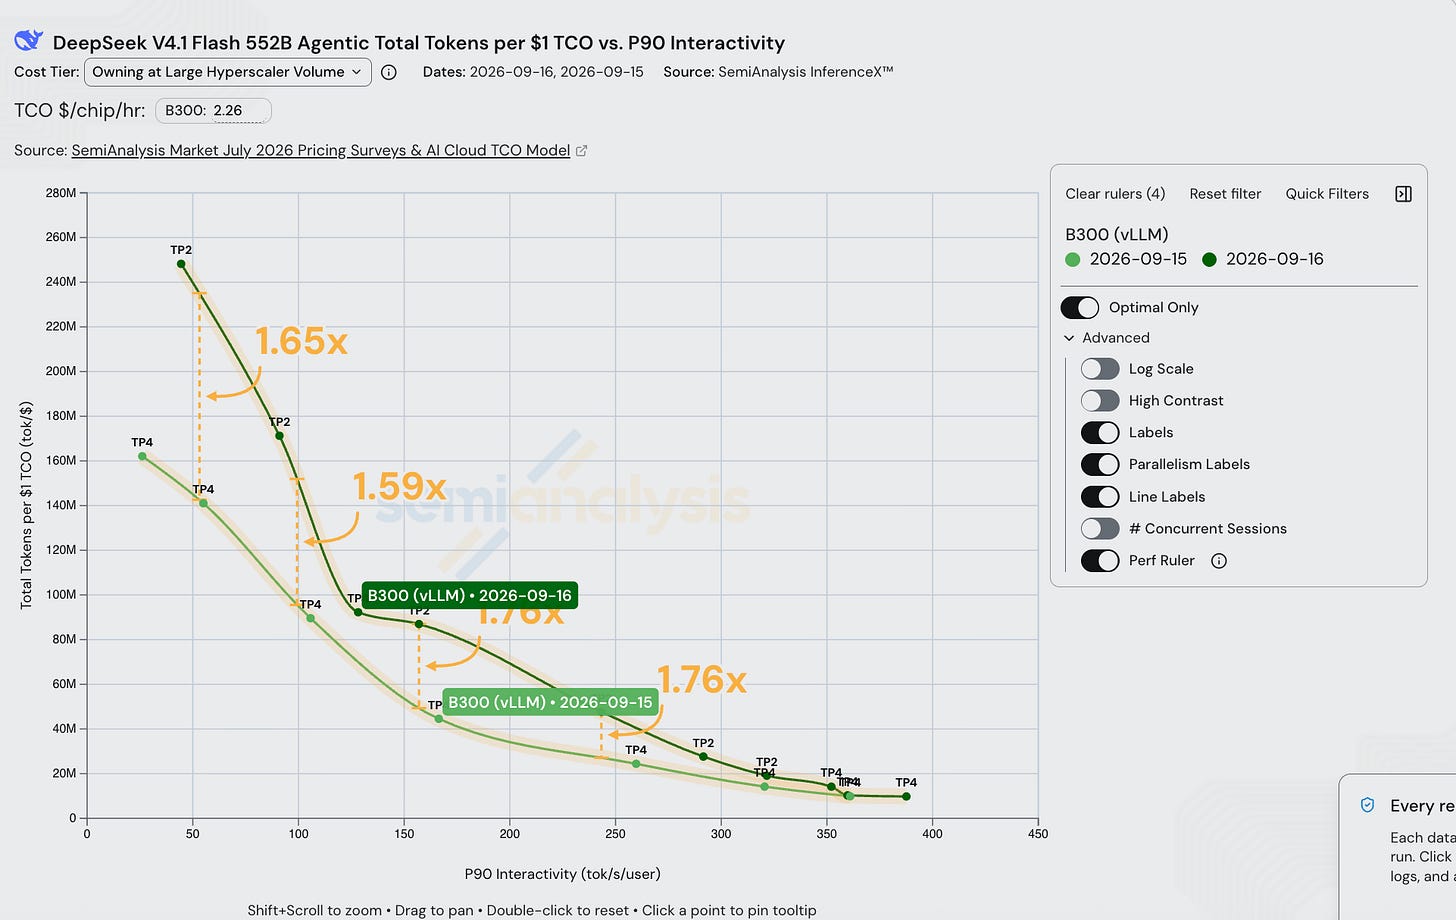
Engram 卸载到 DRAM 还有另一个好处:每个副本可以使用更少的 HBM GPU,从而降低通信开销。例如,在 B300 上启用 Engram 卸载后,我们可以从 TP4 切换到 TP2,使 Pareto 曲线最多提升 1.6 倍。
Source: SemiAnalysis InferenceX
在模型质量相同的情况下,所需的 HBM 更少,因为 engram 可以卸载到主机 DRAM。因此,HBM 带宽远比 HBM 容量重要。对于内存带宽至关重要的推理工作负载而言,4-hi HBM 提供了最佳的 $/带宽比,从而实现最低的单 token 成本。如果中国继续在模型架构上做出越来越多革命性的创新,未来甚至可能不再需要 HBM 堆叠(0Hi)。
此外,在 B200 和 week-0 堆叠上,将 Engram 表移回 HBM 并未带来改善,结果仍处于运行间的波动范围之内。这得益于针对 DRAM 卸载所做的优化工作,例如异步化和计算重叠。
SSD 卸载
在 B200 上,我们创建了一个未优化的 vLLM 分支,并将 Engram 表存储在本地 SSD 上的内存映射文件中。文件后备机制让操作系统可以在其他应用需要内存时回收表页面,而已经缓存在内存中的页面则无需再次读取 SSD 即可提供服务。此外请注意,我们当时无法开启 GDS
这个未优化的 SSD 实现改变了数据行到达 GPU 的方式。它先将行 ID 复制到 CPU,进行去重,再将所需的行收集到 pinned 缓冲区中,然后把这些行复制回 GPU 并反量化。这些工作在 GPU 执行图的各个分段之间进行。而原生 UVA 直接在 GPU 上完成行选择和反量化,避免了 CPU 往返。
温热的文件系统缓存可以消除物理 SSD 读取,但协调、行收集和数据传输仍然存在。这就是为什么一个已经缓存在 RAM 中的文件,其性能仍可能不如 pinned 的 DRAM 表。这里的对比衡量的是整个服务路径,并没有单独拆分每项操作所花费的时间。
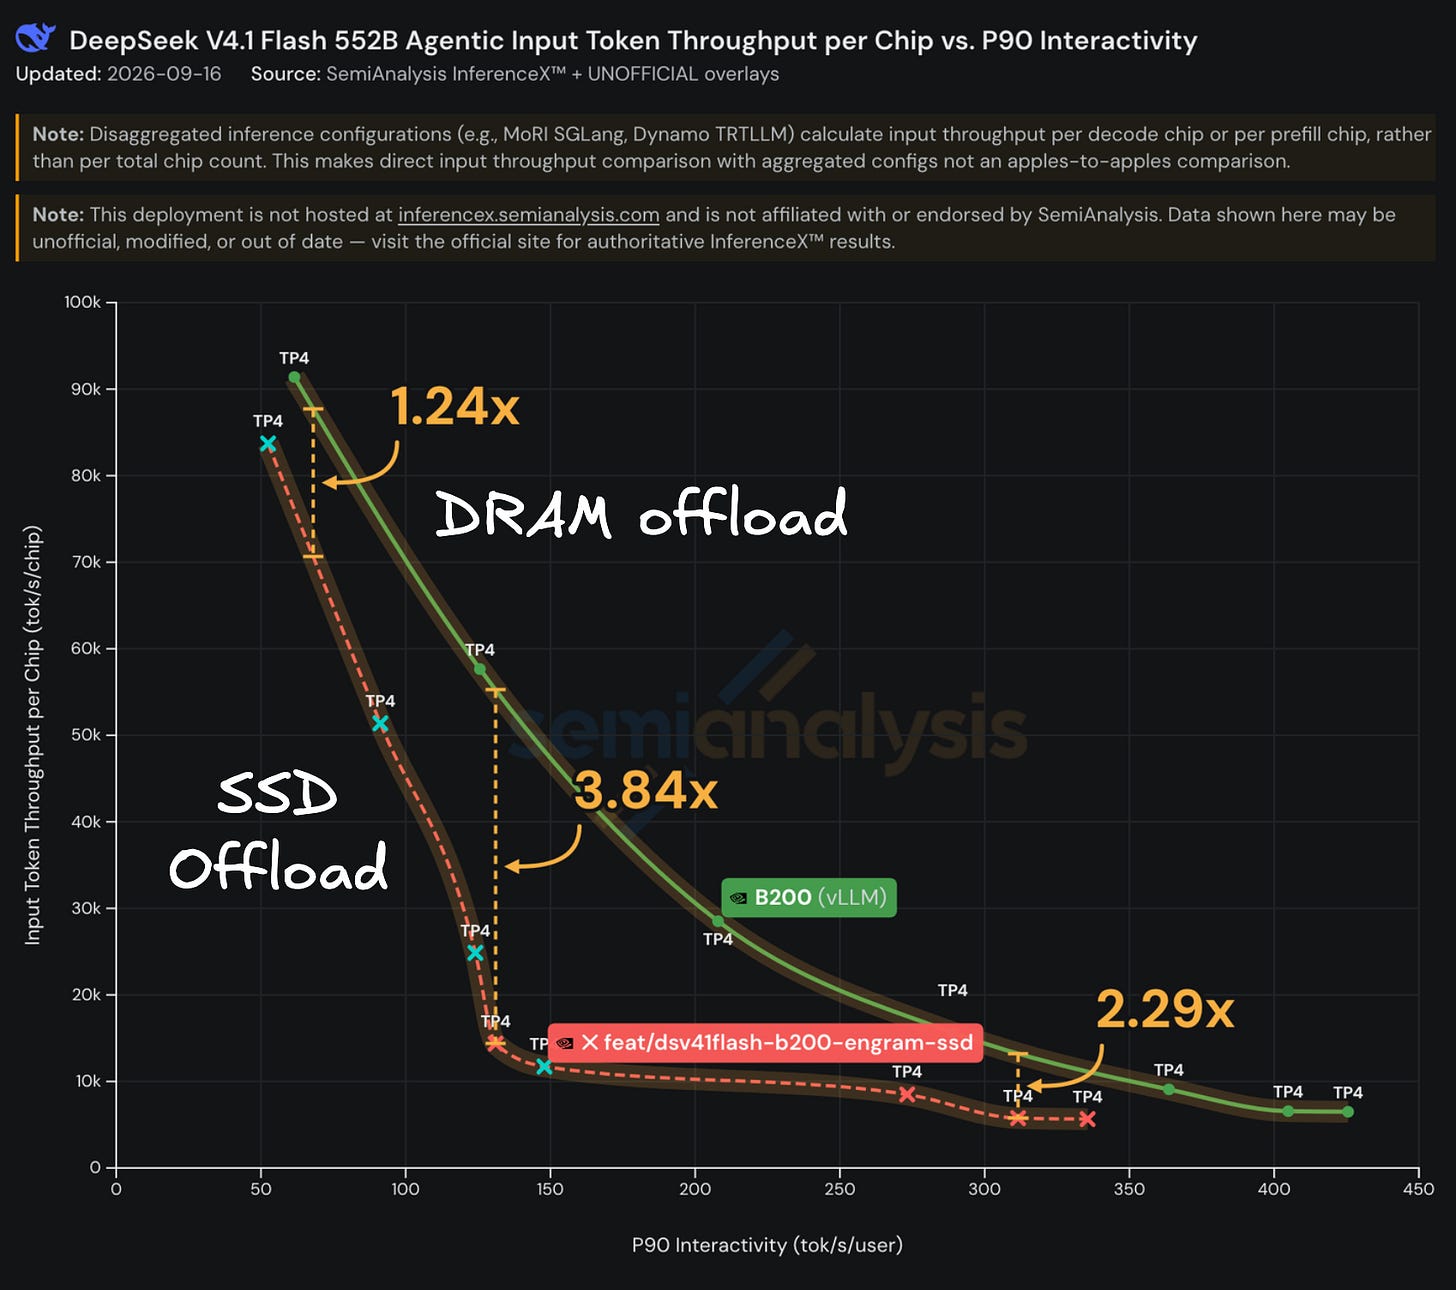
在单美元总 token 数和 P90 交互性这两项指标上,B200 的 DRAM 都优于两条实测的 SSD 服务曲线。在接近 125 tokens/s/user 时,DRAM 每美元可提供 1.21 亿总 token,而 SSD 仅为 5200 万。
Source: SemiAnalysis InferenceX
对于生产环境的部署而言,SSD 卸载很可能不值得付出这样的代价。在我们测量的 B200 配置上,SSD 卸载在两项指标上都处于劣势:每一个观测到的 SSD 数据点,都存在一个 DRAM 方案,能够同时提供更高的 P90 交互性和更多的单美元总 token。唯一的情况是
更便宜的存储并不自动意味着更便宜的推理服务。将 Engram 移到 SSD 后,那四块昂贵的 GPU 和服务器的其余部分依然保持不变。只有当回收的 RAM 能够带来更便宜的服务器配置或额外的有效容量时,才会产生经济收益。而当前这条未优化的路径两者都无法提供,并且当表页面驻留在内存中时,文件系统缓存仍会占用 RAM。
机制
接下来,我们将深入探讨 DeepSeekv4.1 Flash、LongCat 和 Qwen3.8 Flash Next 中的 ngrams 机制及其具体实现。