← 全部文章
Rubin NVL72 Agentic Inference: 67x better Performance per Dollar
2026-09-14 · 原文
Rubin 是首个为 Agentic 时代跨六款产品进行协同设计的平台:Rubin GPU、Vera CPU、NVLink 6 Switch、ConnectX-9、BlueField-4 以及 Spectrum-6。今天我们发布 Rubin 的首批经过验证的 Agentic 推理结果,测量基于我们的 Agentic 推理基准 AgentX。即使在早期预发布软件上,这些结果也已经说明了为什么极端的协同设计是必要的。
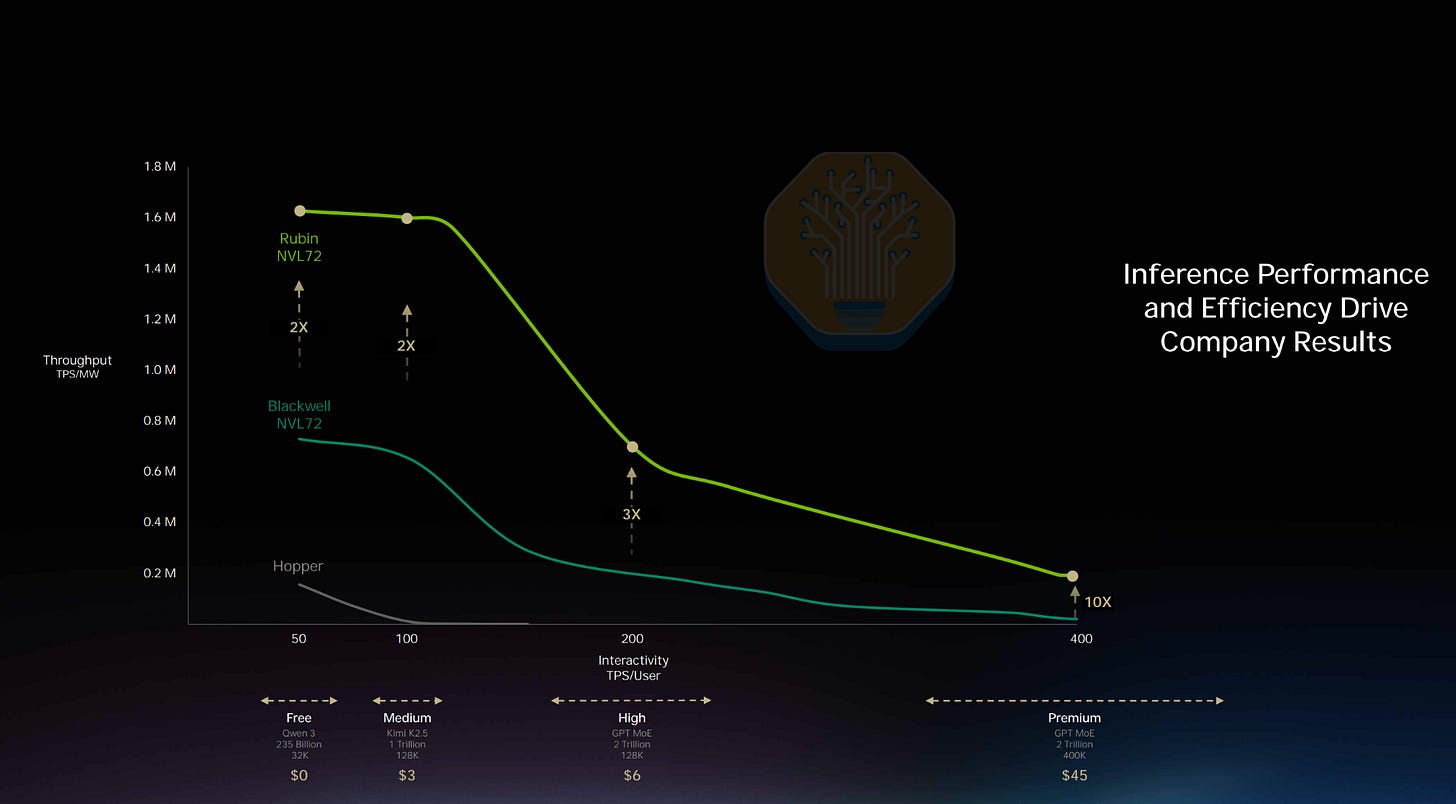
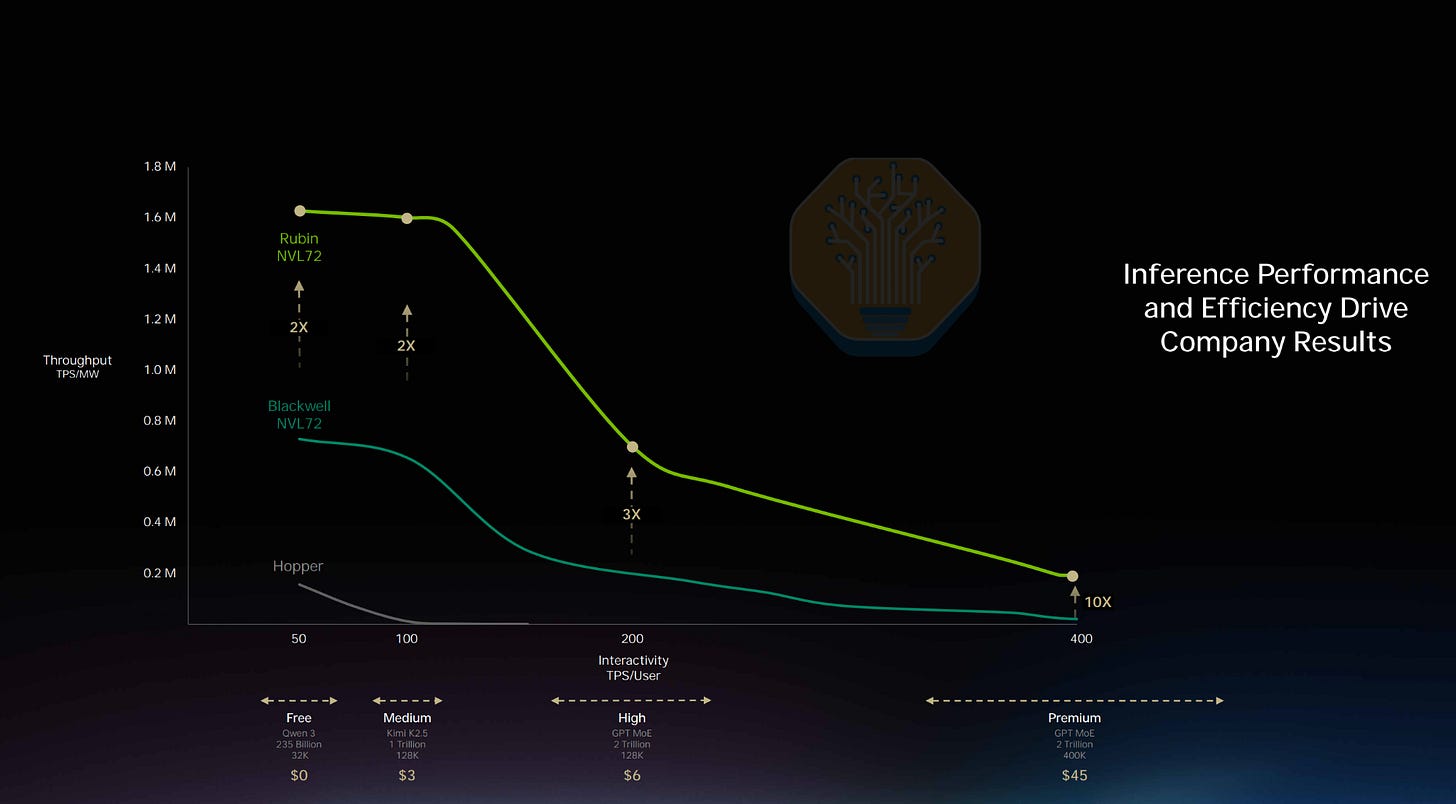
在 GTC 2026 上,Jensen 展示了一张图表,称 VR NVL72 在 O(1-3 Trillion) 参数量级、约 200 TPS 的模型上,每 MW 性能是 Blackwell 的 3 倍。但与 Rubin 在预发布软件上已经达到的实际性能相比,我们已经看到每兆瓦的 token 吞吐量最高提升 7 倍。Jensen 应该停止在 GTC 上故意保守地宣称性能。上次他在 GTC 2024 上这样做时,声称 GB200 NVL72 的性能是 Hopper 的 30 倍,但当我们实测时,性能比 Hopper 高出了 98 倍。
我们对性能结果的估算显示,即使在早期软件版本上,Rubin 每千兆瓦的盈利能力也比 Blackwell 平台高出 2 倍以上。随着 Rubin 软件栈和 kernel 库日趋成熟,以及开发者社区积累更多针对 Rubin 的优化经验,我们预计这一差距还会进一步扩大。
Source: NVIDIA GTC 2026 SandBagging Rubin Performance
我们使用业界标准的 Agentic 推理基准场景 AgentX 来评估性能。它会在我们数千颗芯片组成的集群上回放真实的 Agentic 流量。因此,实际的推理服务商和超大规模 AI 实验室可以全面参考这些结果,来判断哪些芯片在哪些场景下最高效。
我们的基准已被几乎所有主要的算力买家广泛复现、验证和/或支持,包括 Google Cloud、Microsoft Azure、Oracle、Meta 等等。此外,它还得到了 ML 社区的支持,包括 vLLM、LMCache、SGLang、PyTorch、Huggingface,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等主要实验室的支持。
Source: SemiAnalysis InferenceX
感谢 Jensen Huang、Ian Buck、Nick Comly、Kedar Potdar、Rohit Nagraj 以及中国大陆的 TensorRTLLM 团队,感谢他们协助下一代 Rubin 软件的搭建(bring up),并帮助验证我们的 Agentic 基准测试结果。
如果你觉得这个开源基准和数据有用,请为 InferenceX GitHub 仓库点个 Star!InferenceX 是世界上唯一一个涵盖 TPUv7、NVIDIA 和 AMD 的推理基准,很快还将支持 SambaNova 和 Trainium。由于 AgentX 场景非常贴近真实世界的 Agentic 推理工作负载,AMD 也已承诺在 MI455X UALoE72 上展开合作。
Source: GitHub
Agentic 工作负载入门
从宏观层面来看,Agentic 工作负载具有四个特征:
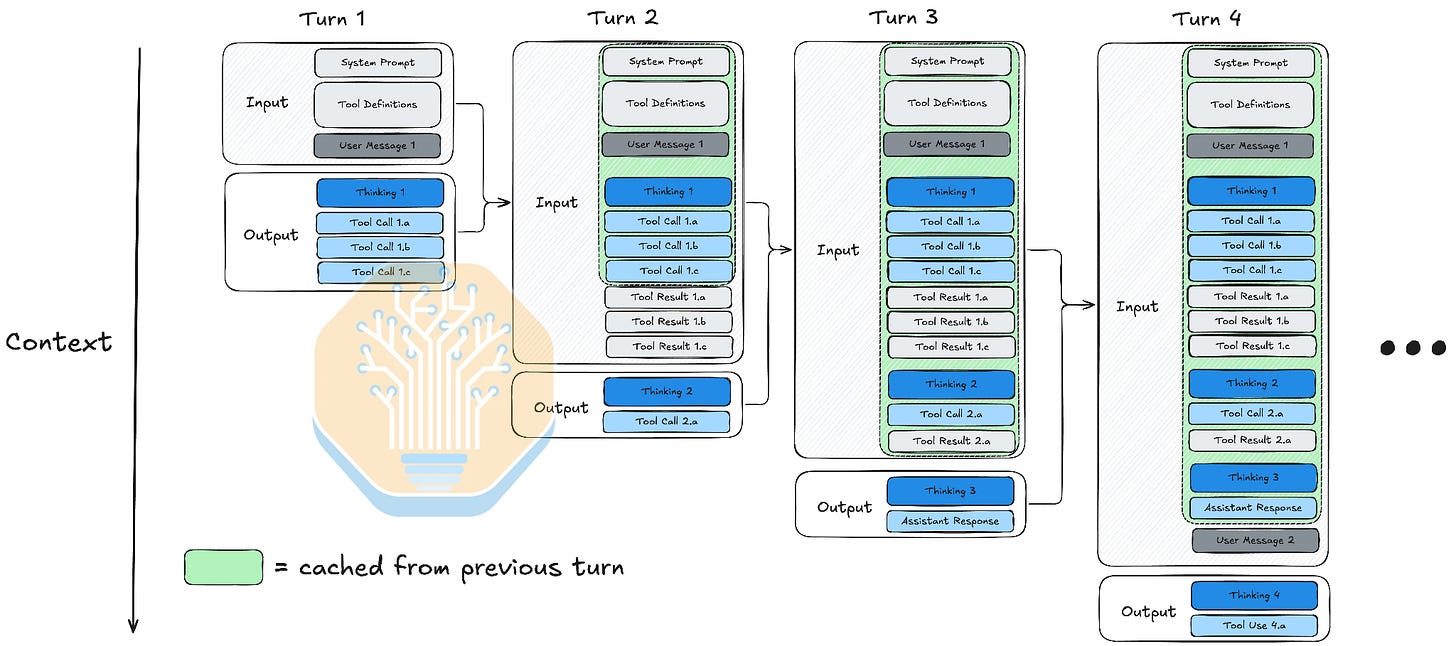
多轮交互:一个会话包含用户与助手之间数十甚至数百次交互,而聊天机器人场景中只有寥寥数次。这类工作负载结合了长上下文、高 prefill 复用率、子代理突发以及大量工具调用。 长上下文:系统提示词、工具定义以及大量的轮次使上下文迅速累积。 高前缀复用:由于对话是线性推进的,第 n-1 轮的输出会被拼接到第 n 轮(通常情况下),因此大部分上下文可以直接从 KV 缓存中读取而无需重新计算(这取决于可用于存储 KV 张量的存储容量)。随着 n 增大,缓存输入与未缓存输入的比值通常会趋近于 1。 子代理突发:一个会话会启动多个短生命周期的子代理,它们各自带有全新的上下文,从而产生突发式的 KV 缓存访问模式。 Source: SemiAnalysis, DeepSeek
关于方法论的更多内容,请参阅我们的 AgentX 文章。
Rubin:令人惊叹的单 TCO 性能
单总拥有成本(TCO)性能是评估 AI 加速器性能最重要的角度之一。在下面的图表中,Y 轴表示每 1 美元 TCO 能产出的总 token 数。实际上,这告诉推理服务商,他们每花费 1 美元的计算成本能生成多少 token。计算方式是将场景的总吞吐量除以全包服务成本(美元/芯片/小时 乘以服务所用的芯片数量)。
在 InferenceX 上,我们为每个 SKU 提供了多种不同的 TCO 数据,这些数据来自 SemiAnalysis AI Cloud TCO 模型。默认提供的场景如下:
超大规模自购(Owning at Large Hyperscaler Volume):拥有并运营硬件的每 GPU 小时建模成本,包括摊销在假定使用寿命内的服务器和网络 capex、托管费用、电力成本以及资本成本。该场景假设采用超大规模云厂商的采购和融资条件,包括批量折扣和定制服务器构建。 3 年期承诺租赁(Rent - 3 Year Commit):向云服务商支付三年期承诺预留的每 GPU 小时市场价格,基于 SemiAnalysis 租赁价格调研。 用户也可以在我们的计算器中编辑计算成本,以匹配他们实际支付的费用。更多数据,例如按需市场租赁价格和更短期的租赁承诺,可在 AI Cloud TCO 模型中找到。该模型来自我们对 100 多家 GPU 客户、GPU 新兴云厂商(neocloud)和超大规模云厂商的月度市场调研。
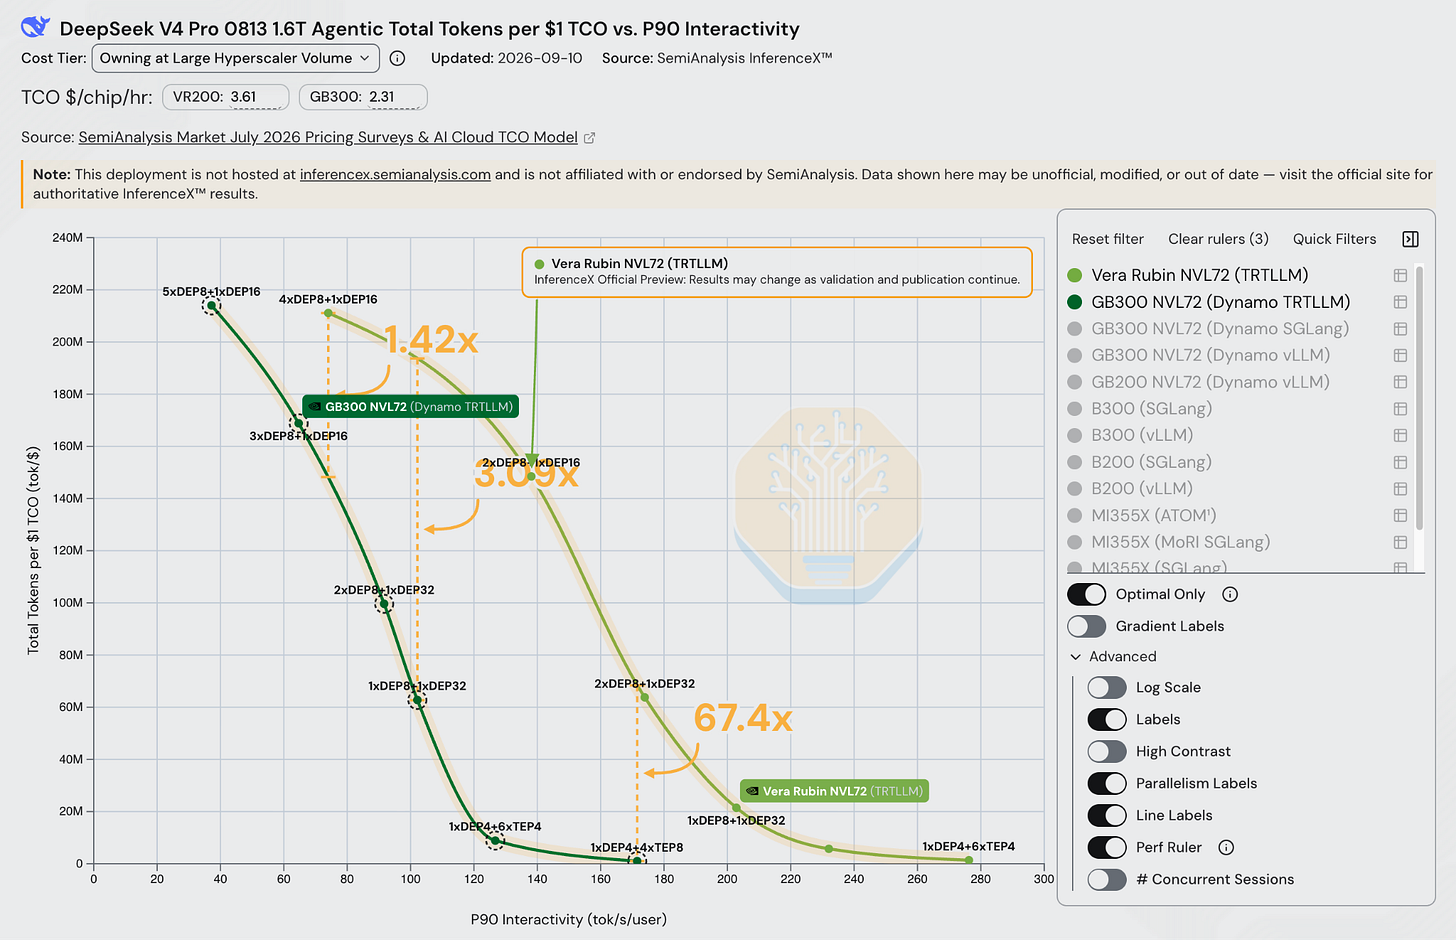
在单美元性能方面,Vera Rubin 相比 GB300 有显著提升。在 170 TPS 下,采用 Apples to Apples TRTLLM NVFP4 Dense 方案时,在自购成本假设下,Vera Rubin NVL72 的单位 TCO 总吞吐量约为 GB300 Dynamo TRTLLM 的 67 倍。此外,在大多数服务商实际部署该模型的前沿区间(60-100 TPS),与最新最强的 GB300 TRTLLM 配置相比,Vera Rubin 的单位 TCO 吞吐量达到 1.4 倍至 3 倍。
我们的机架采用的是量产版 SKU:每个计算托盘的 TDP 为 2300W,配备 1.5TB 的 CPU LPDDR5X 内存。关于 NVIDIA 为什么不得不将 Vera 的内存容量减半,我们在加速器与内存模型一文中做了更多讨论。本文将重点讨论 TRTLLM 的 Rubin 性能,我们预计后续文章还会涵盖 vLLM Rubin 和 SGLang Rubin 在智能体(agentic)推理工作负载上的性能。
Source: SemiAnalysis InferenceX
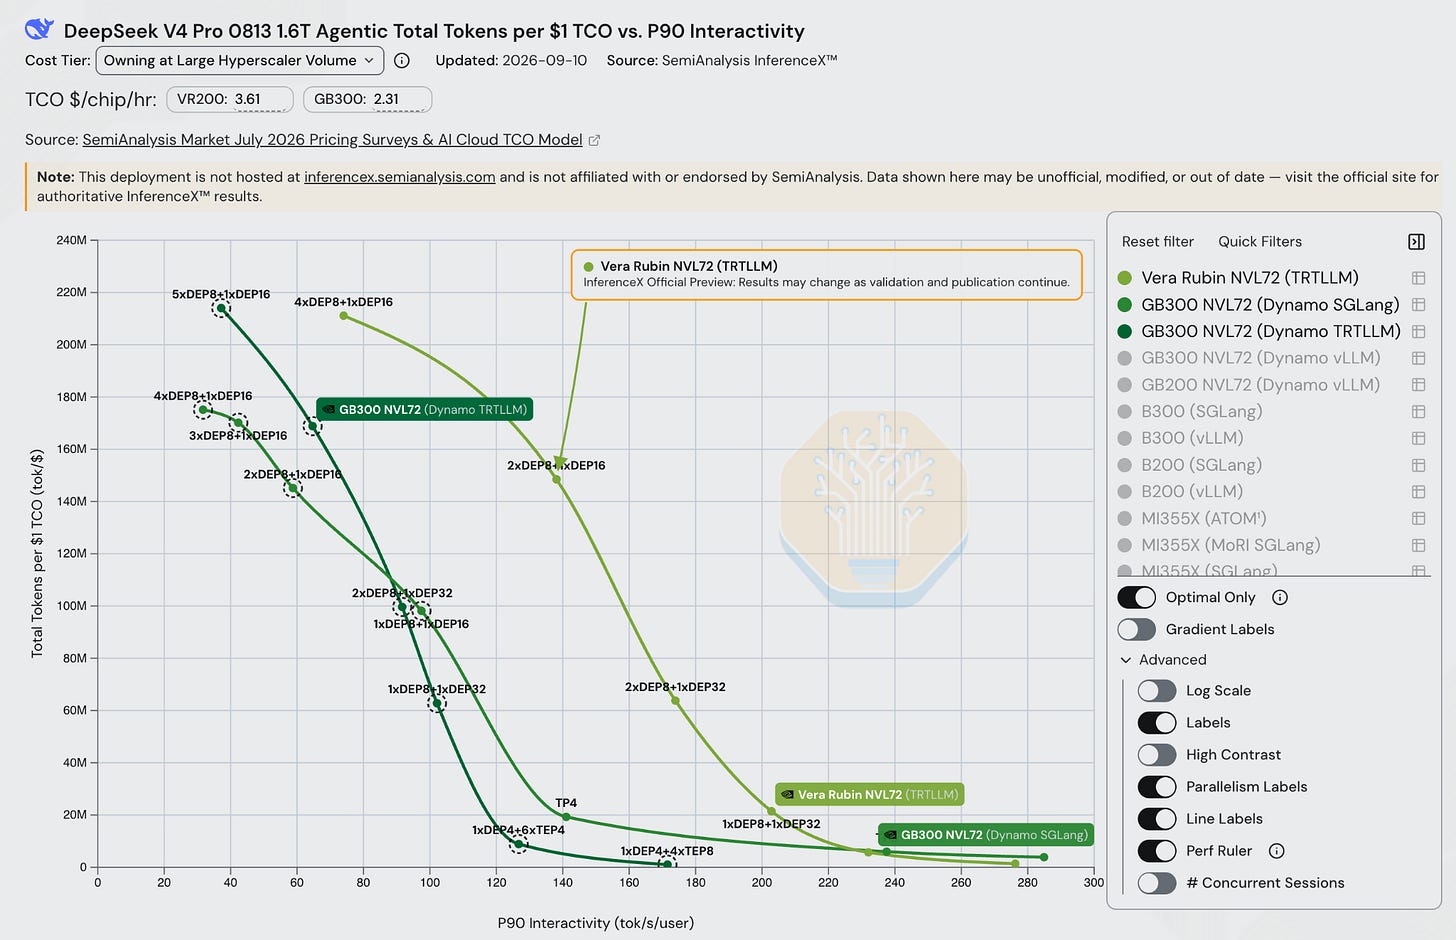
Vera Rubin 的 P90 最大交互性能比 GB300 Dynamo TRTLLM 高出约 61%,分别达到 276.24 与 171.53 P90 TPS。不过,如果使用开源的 SGLang 技术栈,GB300 可以达到与 Vera Rubin 相近的交互性能。
Source: SemiAnalysis InferenceX
我们认识到这是 TRTLLM 的一个预发布早期版本,性能只会不断提升,尤其是在前沿的“两端”(超高吞吐/超低延迟)场景。推动前沿向前拓展、并随时间推移持续展示性能改进,正是 InferenceX 的终极目标。在我们之前关于 InferenceX 的文章中可以了解更多相关内容:
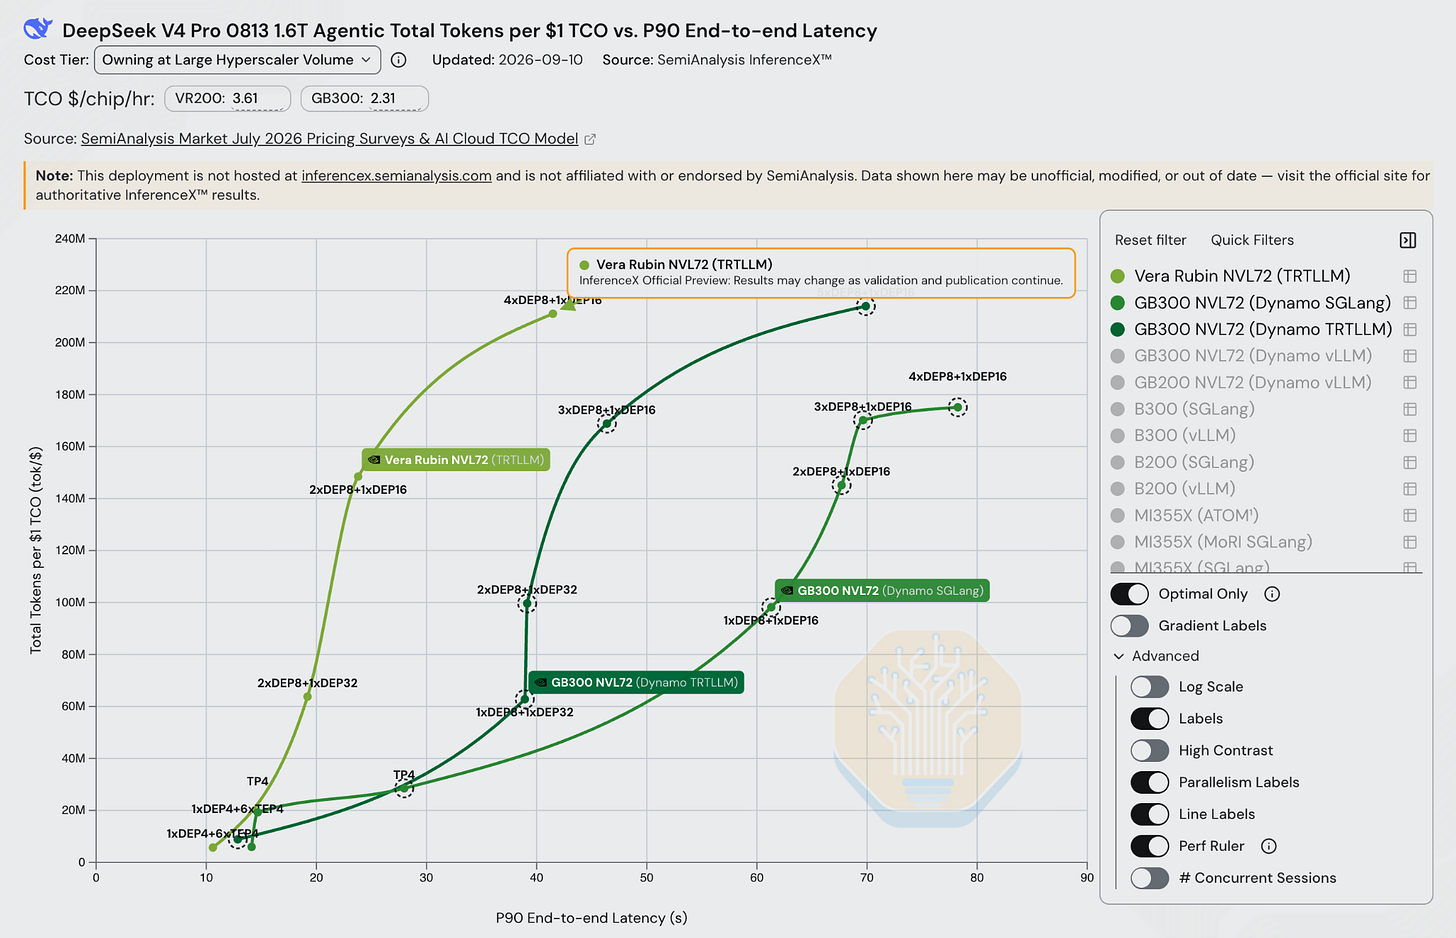
还需要注意的是,在高吞吐场景下,Vera Rubin 的 P90 E2E(端到端)延迟也明显更优。虽然交互性能(TPS)往往是性能基准测试的头条指标,但 TTFT(首 token 时间)和 E2E 延迟等延迟指标同样重要,而且是生产服务中事实上的 SLA 标准之一。
Source: SemiAnalysis InferenceX
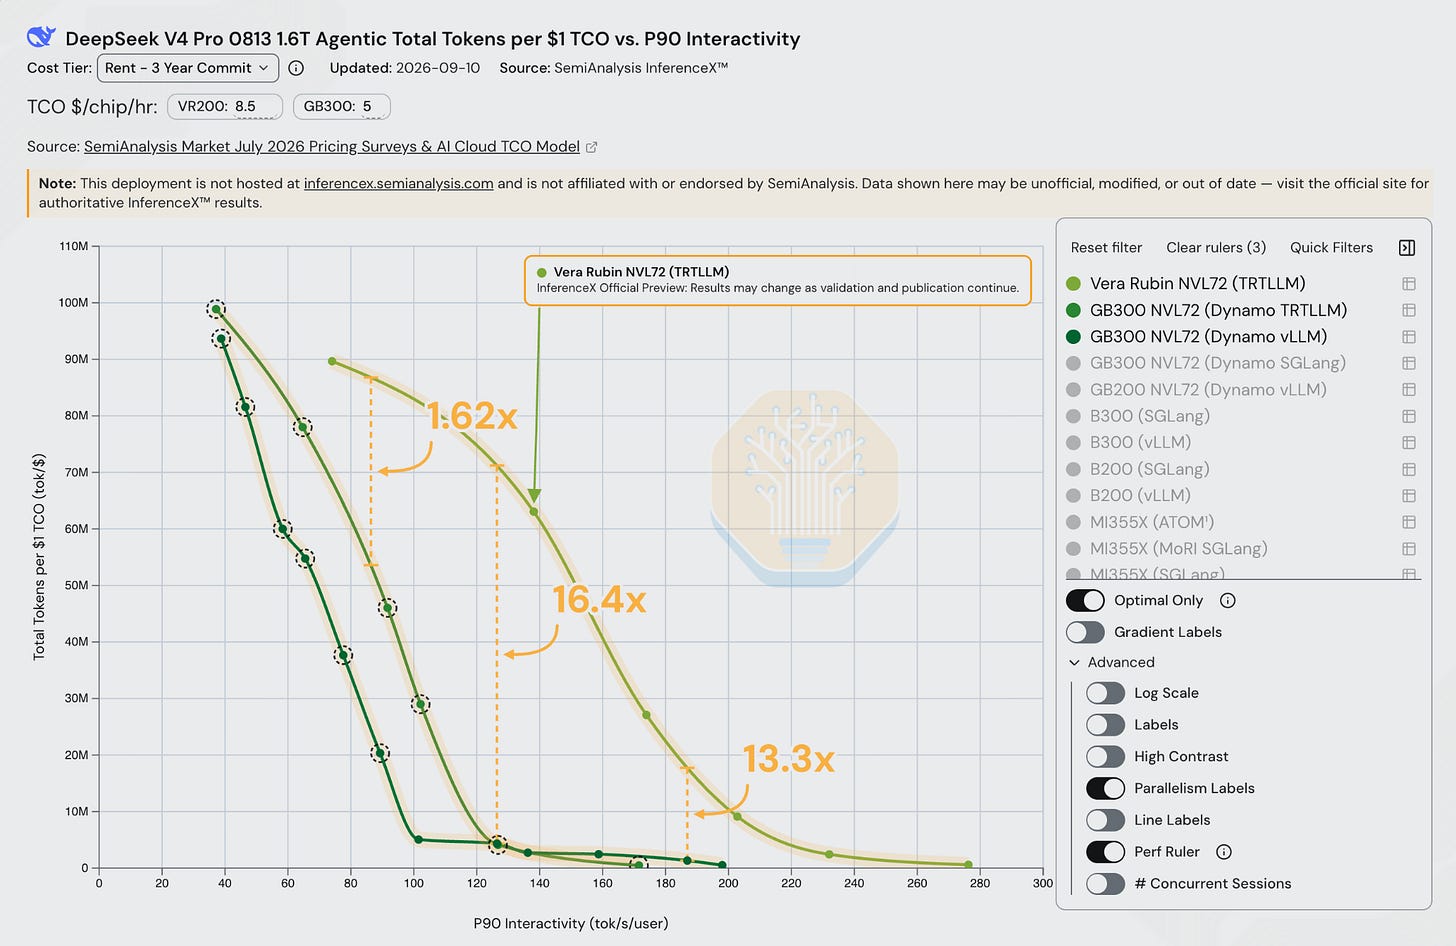
考虑到 3 年租用成本——2026 年 7 月时 Rubin 每芯片超过 8.5 美元/小时,Blackwell Ultra NVL72 为每芯片 5 美元/小时——这次升级仍然非常划算。在 80 TPS P90 交互性能下,Vera Rubin 在相同的租用 TCO 下可以多产出 62% 的总 token 数。在前沿曲线中交互性能更高的部分,Vera Rubin 每 3 年租用 TCO 产出的 token 数最多可达 16 倍。
Source: SemiAnalysis InferenceX
这里的结论非常简单:如果你有钱购买或租用 VR NVL72,那就应该出手——它能以显著更低的成本生成 token,从而为你赚更多的钱。正如 Jensen 那句名言所说:“买得越多,赚得越多”。
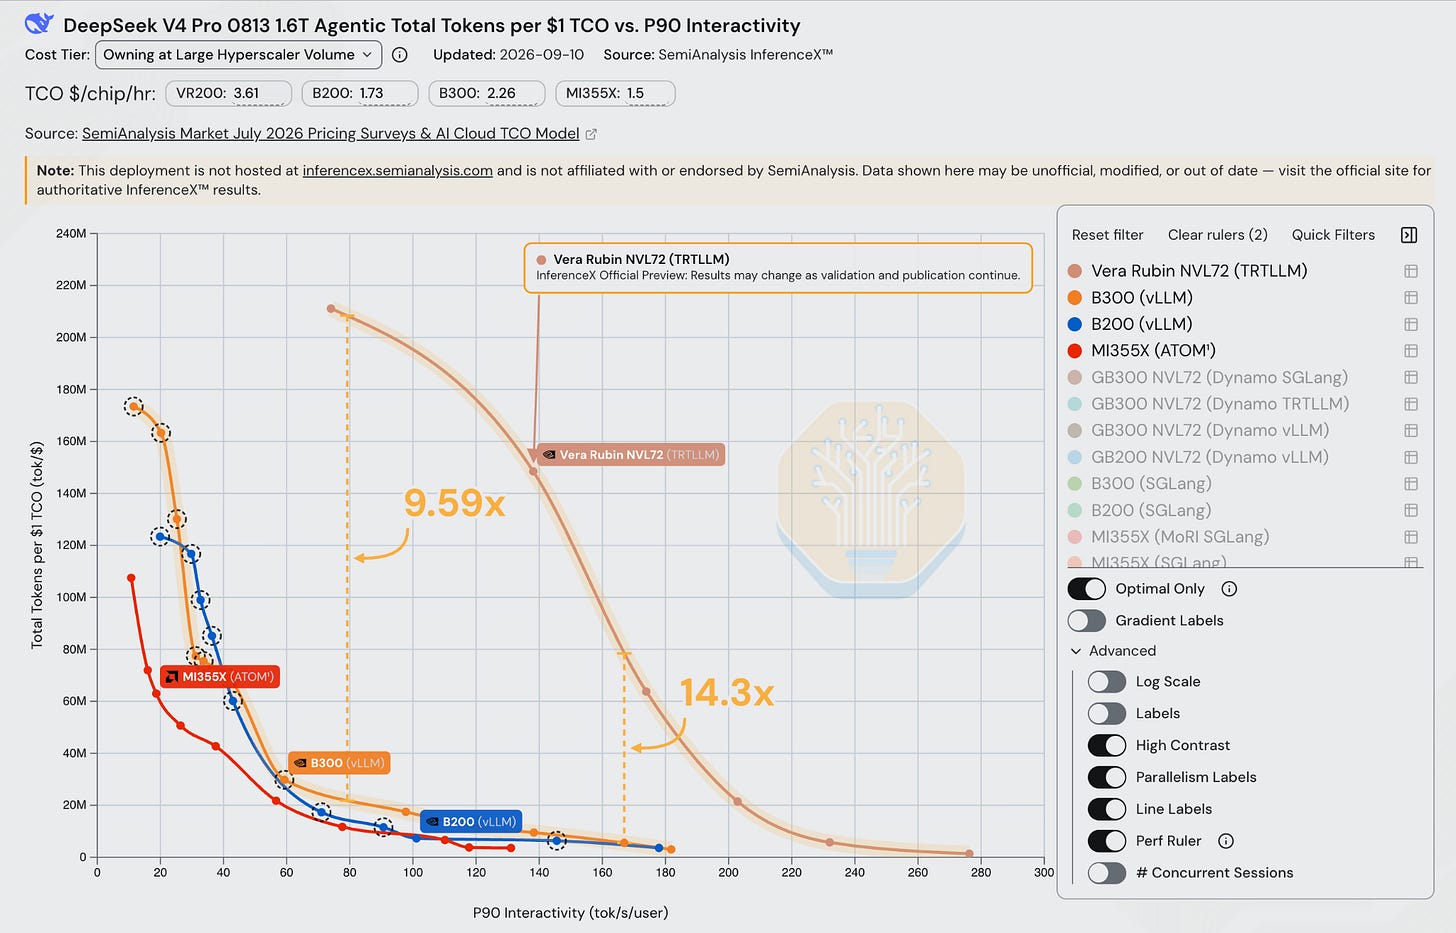
与单节点 Blackwell 和 MI355X 相比,在整个性能曲线范围内,单位 TCO 的性能差距会进一步拉大。在 80 TPS P90 SLA(再次强调,对该模型而言这是相当现实的指标)下,按照自有(owning)TCO 计算,推理服务商每美元所能服务的 token 数是 B300 的 10 倍。
Source: SemiAnalysis InferenceX
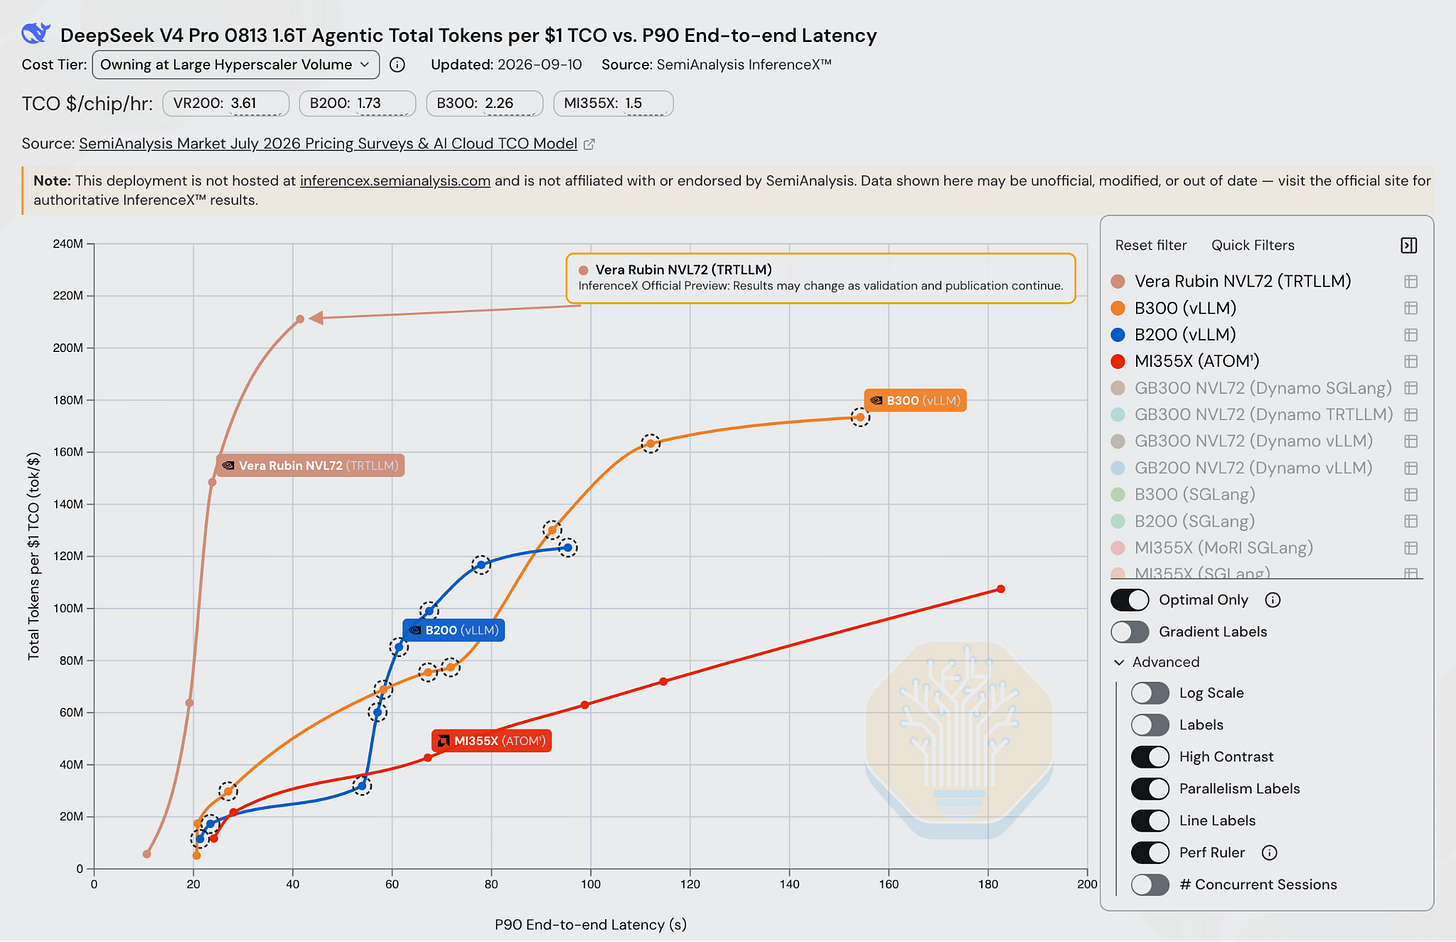
这一优势同样体现在 P90 端到端延迟上。如下所示,在自有成本假设下每美元 TCO 对应 6000 万 token 的吞吐水平时,Vera Rubin 的 P90 端到端延迟约为 20 秒,而运行最新 vLLM 服务技术栈的 B200/B300 为 60 秒。在每美元 1.6 亿 token 的水平下,P90 端到端延迟差距扩大到约六倍:Vera Rubin 为 20 秒,而 B200/B300 为 120 秒。
Source: SemiAnalysis InferenceX
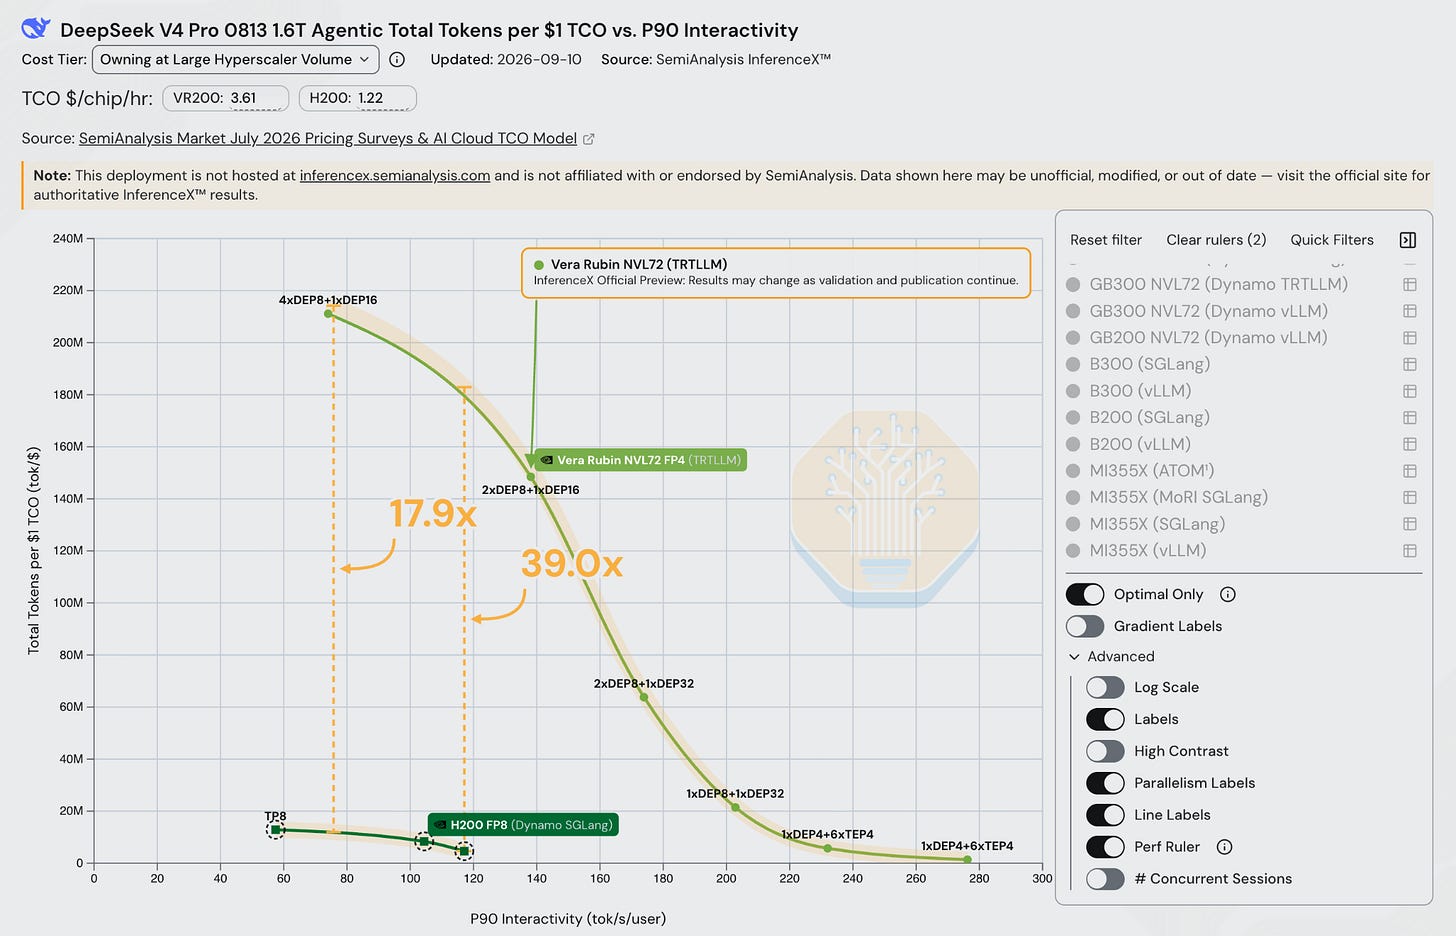
在智能体(agentic)工作负载上,Vera Rubin 让 H200 的竞争力看起来就像一台 TI-84 计算器。在 P90 交互性目标为 80 TPS 时,Rubin 每 dollar 产生的 token 数量是 H200 的 18 倍。在 120 P90 TPS 时,这一优势扩大到 39 倍。Rubin 的优势在离线批量推理中较小,而在训练中更为明显,因为我们看到大型实验室正在逐步将 Hopper 迁移到训练任务上。
Source: SemiAnalysis InferenceX
Source: Texas Instruments
Rubin 的每瓦性能——Jensen 再次在性能上有所保留
拥有充足电力供应的数据中心的可用性往往是部署更多芯片的限制因素,因此功耗效率至关重要。如果你能在每 GigaWatt 电力下生成更多 token,那么你就能在每 GigaWatt 电力下获得更多收入和利润。
SemiAnalysis 数据中心行业模型
在 GTC 2026 上,Jensen 展示了这张图表,将 Rubin 与 Blackwell 在一个 2T 参数的 MoE 大模型上进行了比较,显示 VR NVL72 在万亿参数模型上以约 200 TPS 的速度实现了每 MW 3 倍的性能。但与 Rubin 在预发布软件上已经展现出的实际性能相比,我们已经看到每 MW 的 token 吞吐量最高可达 7 倍的提升。Jensen 需要停止在 GTC 上对性能声明的保守陈述。他上次在 GTC 2024 发布 GB200 NVL72 时就是这样,当时他宣称它将比 Hopper 快 30 倍,但经过我们的测试,它的性能实际比 Hopper 高出 98 倍。
Source: NVIDIA
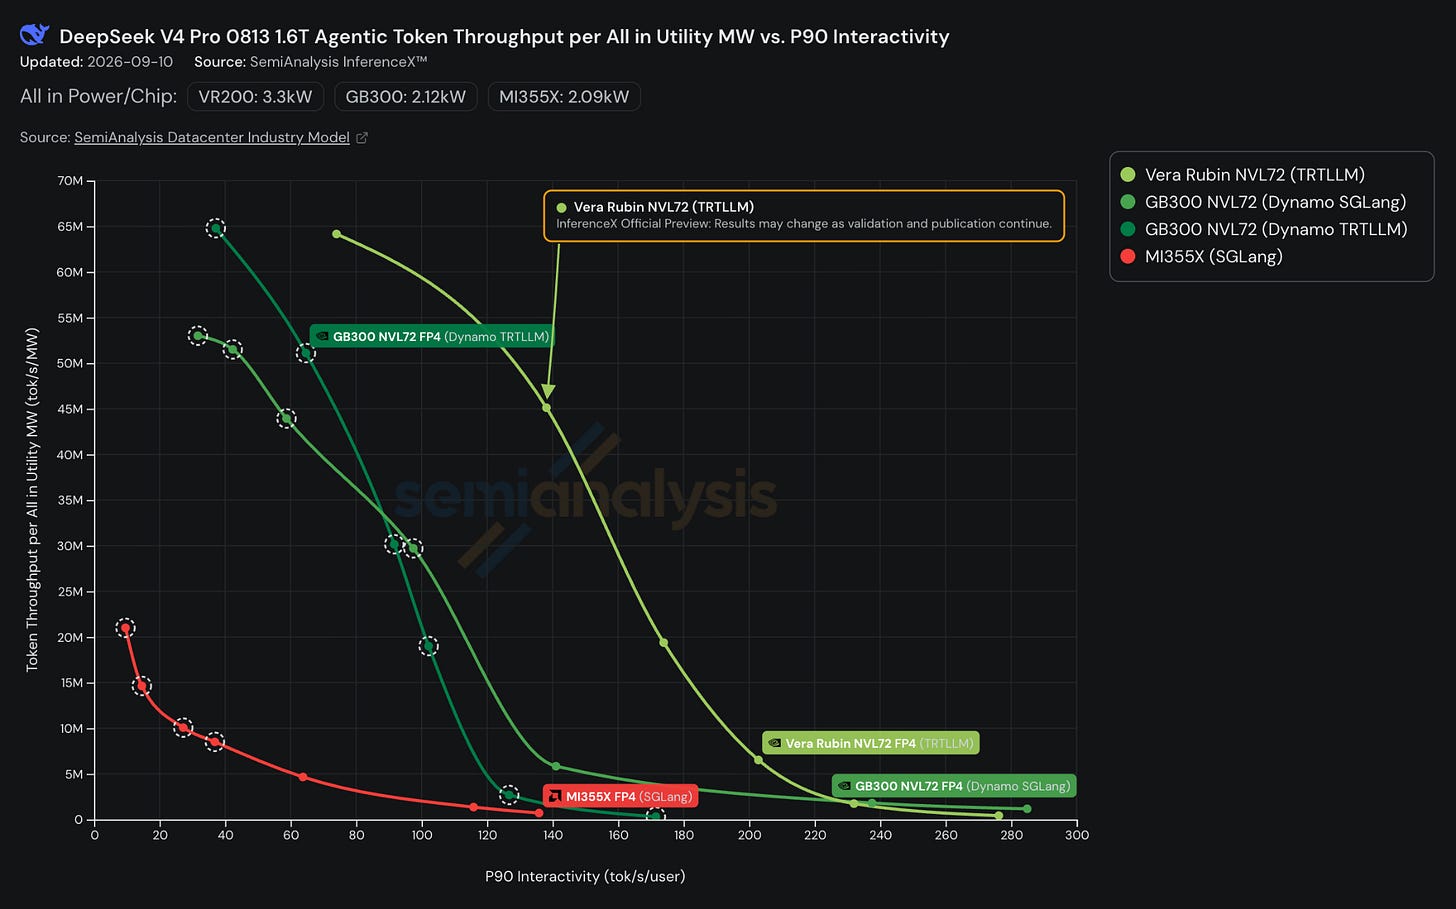
P90 交互性描述的是单个响应的流式传输速度,使用 P90 完整响应 token 间延迟的倒数来衡量。在固定的交互性目标下,曲线越高意味着该部署能够在相同的电力预算内服务更多的总流量。首个 token 的初始等待时间和整体响应时间在之前的延迟分析中是单独考量的因素。
Source: SemiAnalysis InferenceX
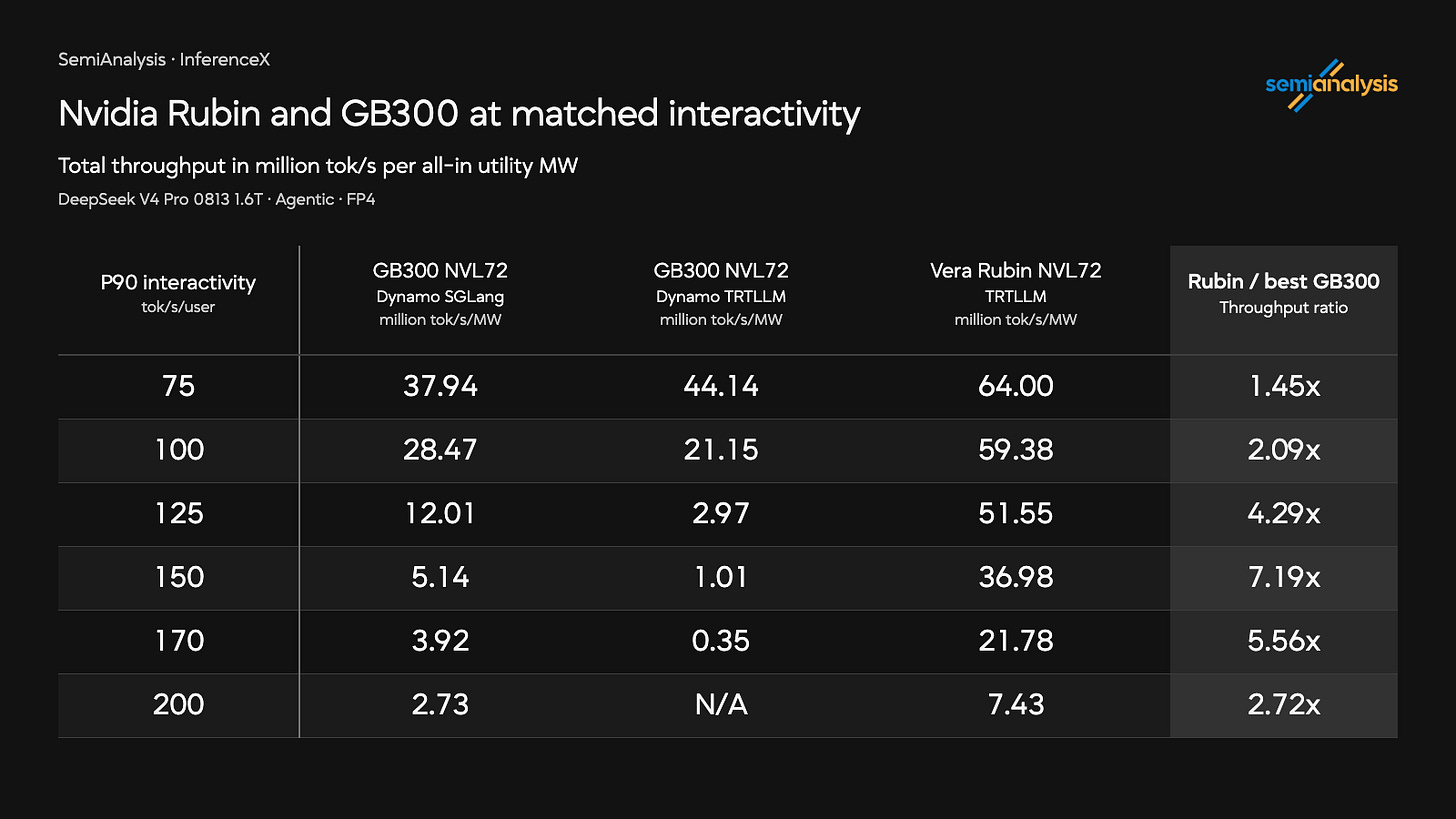
对于 DeepSeek V4 Pro 智能体工作负载,在下方比较的匹配目标下,Vera Rubin 每 MW 提供的总 token 吞吐量远高于 GB300 和 MI355X。这一优势的大小取决于交互性目标以及用于比较的推理引擎。
在 100 TPS 下,Rubin 提供约 5940 万 tok/s/MW,相比之下 GB300 Dynamo SGLang 为 2850 万,GB300 Dynamo TRTLLM 为 2110 万。在该目标下,相比更强的 GB300 引擎有 2.09 倍的优势。MI355X SGLang 达到 201 万 tok/s/MW,因此在这个特定工作负载和快照下,Rubin 领先 29.5 倍。SGLang 是在该目标下所测得的 MI355X 引擎中最强的。
在 100 TPS 下的更广泛硬件比较中,B200 SGLang 达到 695 万,B300 vLLM 达到 556 万,H200 Dynamo SGLang 达到 226 万 tok/s/MW。H200 使用 FP8,此比较中的其他配置均使用 FP4。这些是对所测得的硬件与软件配置的比较,包括它们的缓存和并行策略选择。
该表展示了优势在整个曲线上的变化情况,吞吐量以每电力 MW 的总 token 数(百万 tok/s)来衡量。表中数值为插值结果,即根据实测基准点之间的数据估算得出,以便在不同引擎之间以相同的速度目标进行对比。N/A 表示该目标超出了对应引擎的实测范围。
Source: SemiAnalysis InferenceX Preview
在 150 TPS 下,Rubin 保持了接近 37 百万 tok/s/MW 的水平,约为 GB300 SGLang 的 7.2 倍。随着速度要求进一步提高,这一优势逐渐缩小,在 200 TPS 时降至 2.72 倍。最强的 GB300 引擎也会随目标速度而变化:在 75 TPS 时 TRTLLM 领先,而在图中所示的更高目标下则是 SGLang 领先。
这一区别在前面讨论的工作点附近尤为重要。在恰好 170 TPS 时,Rubin 每 MW 的总吞吐量是 GB300 TRTLLM 的 62.9 倍,而后者的曲线已接近其最快实测端点。在相同目标下与 GB300 SGLang 相比,倍数为 5.56 倍。因此,在引用高交互性场景下的性能提升时,标明所用引擎至关重要。
Rubin 的另一个特性是一流的动态功率调度(dynamic power shifting)集成,称为 “DSX MaxLPS”。这意味着无需再按最大 TDP 加上 10-20% 的超额配置系数来供电,GPU 集群运营方可以对其推理工作负载以及未来工作负载的代理指标进行功耗画像,并根据实际功耗在同一数据中心电力容量内塞入更多 GPU。这是因为在推理工作负载中,尤其是中等偏快的速度下,GPU 并不会耗尽其全部功耗预算。因此,在数据中心内智能地调配电力,就能容纳更多 GPU。我们即将推出的 PowerX 与 InferenceX 的集成,将使我们能够以更细的粒度测量每 GigaWatt 的吞吐量。
每 Gigawatt 的年收入与利润——买得越多,赚得越多
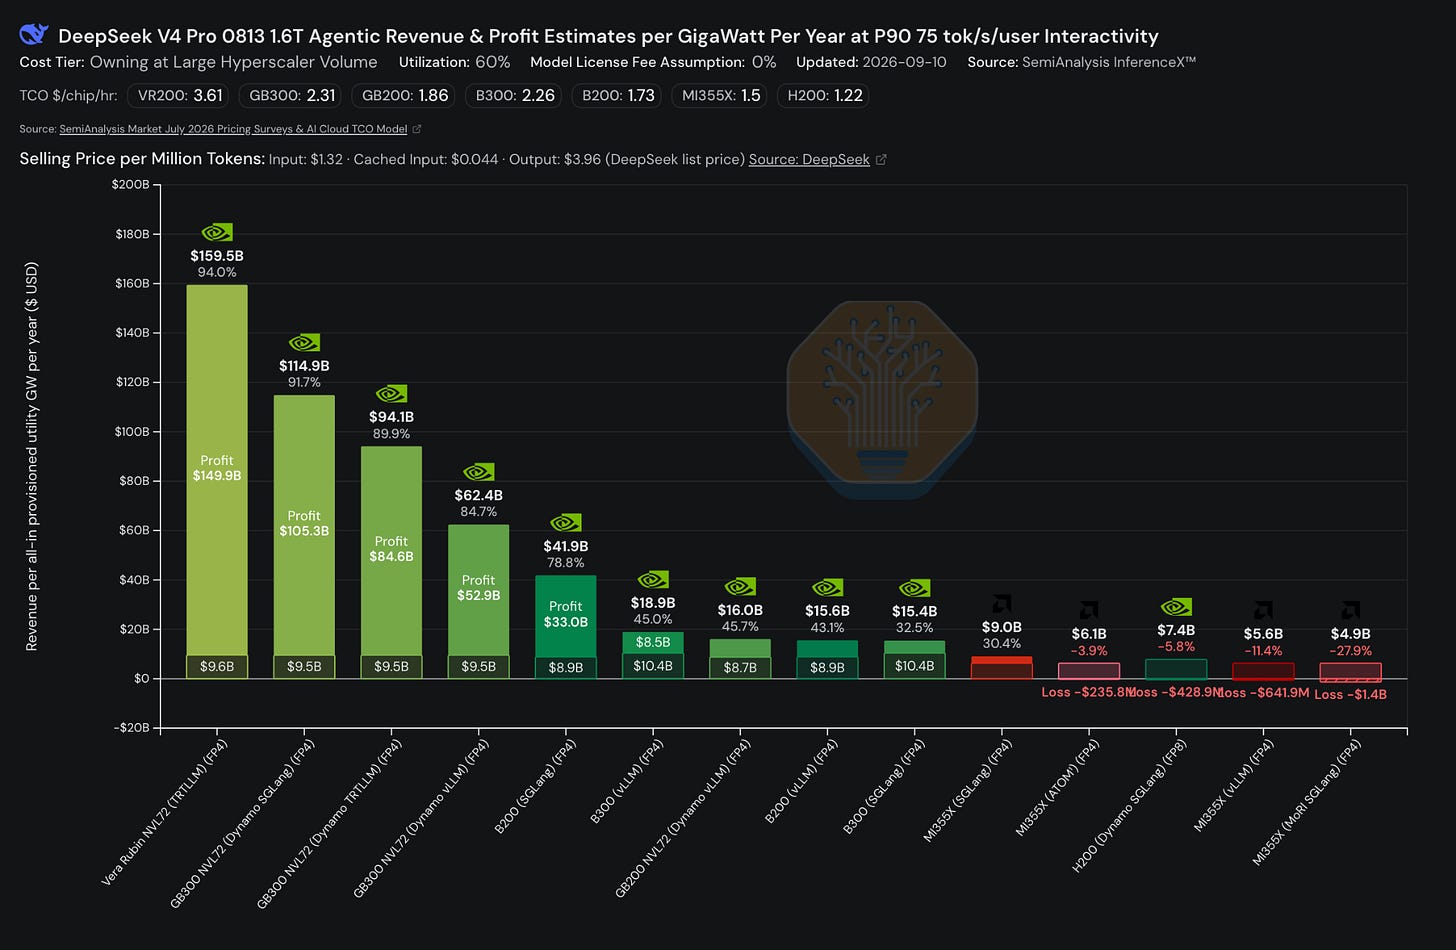
在撰写本文时,DeepSeek V4 Pro 1.6T 已被替换为 DeepSeek V4.1 Flash。不过,其规模使其可以作为 O(1-3T) 参数级别 LLM 的代理模型。由于 DeepSeek V4 Pro 采用 MIT 许可证发布,因此没有许可费用。
在固定电力预算下,Rubin 的优势不仅在于能处理更多 token。它让运营方能够在无需获取额外电网电力的前提下,拥有更多将需求变现的容量。在 75 TPS 交互速度、60% 利用率且无模型许可费用的条件下,Vera Rubin 在每全包(all-in)电力 GW 下可产生 1595 亿美元的年收入和 1499 亿美元的模拟利润。在这一年收入对比中最强的 GB300 配置——Dynamo SGLang——则分别产生 1149 亿美元和 1053 亿美元。因此在相同的电力分配下,Rubin 可带来约 39% 的额外收入和 42% 的额外模拟利润。
Source: SemiAnalysis InferenceX
绝对差异约为每 GW 每年 446 亿美元的额外模拟利润,在线性缩放的情况下,10 MW 规模约为 4.46 亿美元。由于这两种配置显示的每 GW 年成本相近,大部分增量收入会直接计入模型的利润指标。
同样的优势也带来了定价空间。在保持工作负载组合、吞吐量和计费利用率不变的前提下,Rubin 可以将缓存输入、非缓存输入和输出 token 的价格降低约 28%,同时在所示价格下实现与 GB300 Dynamo SGLang 相同的每 GW 收入。因此,运营商可以根据模型的需求弹性,选择将效率提升保留为额外利润,或者利用它进行价格竞争。
下面我们将讨论每种 NVIDIA 芯片在整个机群生命周期内的总收入。