← 全部文章
Where Does a Robot Think – On-Device vs Datacenter Inference – On-Device vs Datacenter Inference
2026-09-09 · 原文
在 AI 短暂历史的大部分时间里,它都活在屏幕之后。这种情况正在开始改变。
先是聊天机器人,擅长回答问题或起草邮件。然后是 Agentic AI——这类模型不只是回应,还能在计算机上完成真正的工作:操作软件、调用工具、独立完成多步骤任务。如今的前沿是物理 AI,即超越屏幕、感知世界并作用于世界的智能。其中最大的一块是机器人,而这个领域仍处于早期阶段:硬件、模型和商业模式,此刻都还在探索之中。
具身问题
在 LLM 领域,硬件迁就模型。对超大规模云厂商和 AI 实验室而言,没有严格的延迟要求,支出上限却极高,因此流程很简单:训练时尽可能多地投入数据和算力,然后再想办法部署训练出的模型。模型优先,硬件为其服务。而机器人领域正好相反。更严苛的约束颠倒了设计顺序:你首先要弄清在机器人上部署一个模型需要什么,然后再构建一个合适的模型。有两个约束在驱动这一点。
第一个是时间。机器人运行实时控制回路,不能错过任何截止时间。LLM 慢一点并不影响最终输出。但如果机器人反应慢,它周围的世界已经变了,等到它要执行动作时,这个动作早已过时。
第二个是成本。使用 LLM 时,它运行在用户提供的屏幕之后。而在机器人领域,制造商必须同时构建算力和机器人本体,并且要在每一台设备上预先支付这笔费用,资本开支可能非常庞大。一旦达到规模化,这笔前期投入可能达到数十亿,甚至数万亿美元——如果我们最终真能实现十亿台机器人的话。
正因这两个约束,在机器人领域,机载硬件是固定的,模型要围绕它来设计。即便拥有超大规模云厂商级别的资金,大部分资本也必须投向机器人和工厂本身,而不是算力。因此,模型能力受限于能在机器人上负担得起的实时硬件上运行的内容,而智能则成为一种需要在延迟和单体经济效益之间精打细算的资源。
机器人模型仍然很小……
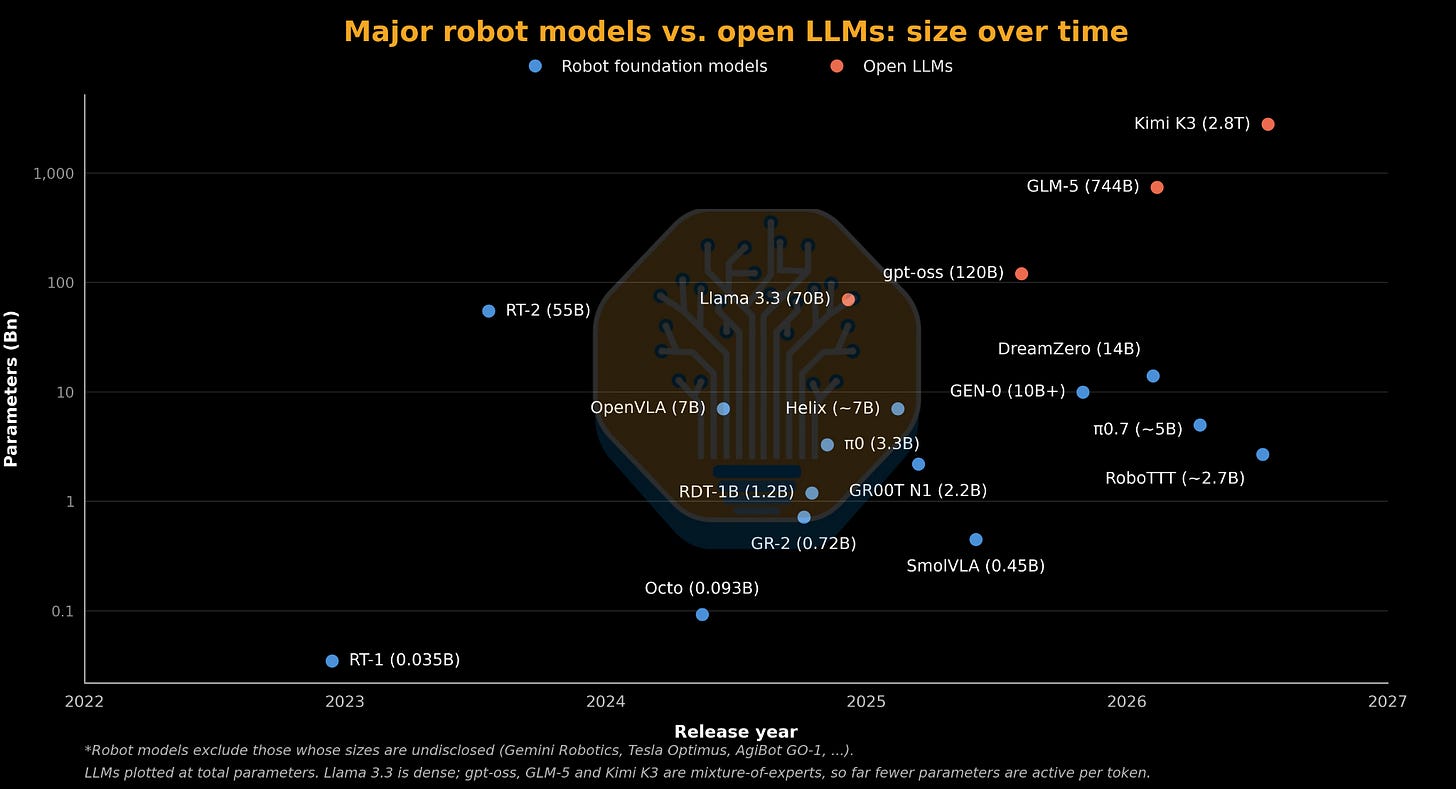
这就是前沿机器人模型远小于前沿 LLM 的原因——后者已突破万亿参数规模。如今大多数前沿机器人模型大约在 50 亿到 140 亿参数之间:Physical Intelligence 的 π0.7 为 50 亿参数,NVIDIA 的 DreamZero 为 140 亿参数。
Source: SemiAnalysis
在 LLM 领域,Scaling Law 一直成立,扩大规模持续拓宽了单一模型所能解决的问题范围。早期结果显示,机器人领域可能同样如此。数据曾是一个瓶颈,但随着世界模型和具身化人类数据采集的发展,数据规模正在扩大。不过,具身 AI 也面临语言模型从未遇到过的限制,比如数据稀缺和真实世界交互的成本,因此规模化能否带来同样的回报,确实仍是一个悬而未决的问题。
如果机器人模型继续扩大规模,那么问题就变成了:考虑到上述的延迟、成本和模型限制,这些算力究竟应该在哪里运行。这个领域确实存在分歧,不同公司押注的方向各不相同。Figure 将其自研的 Helix 模型完全放在机器人本体上运行。Physical Intelligence 的 π0.7 模型则走向另一个极端,在机器人之外的单块 H100 上运行策略。NVIDIA 的 DreamZero 是一个基于视频扩散骨干网络构建的 140 亿参数“世界动作模型”,仅为了实时运行就需要机器人之外的两块 GB200 GPU。
我们的观点是,级联式架构不可避免。一些机器人会在本体上运行认知,另一些则会把认知卸载到数据中心里的 GPU。如今最大的机器人模型厂商,比如 NVIDIA 和 Google DeepMind,会倾向于云端方案:在云端 GPU 上运行重型认知,机器人本体上只保留一个小型边缘模型,负责底层控制和安全。
规模较小的厂商,比如 Dyna 和 Sunday,最初可能更倾向于能跑在 Jetson 或消费级 GPU 上的模型。因为它们早期部署的场景都是范围狭窄、可控的环境,本体推理已经足够。不过,随着部署规模扩大,它们最终会收敛到某种本体算力与机器人外部算力的组合—— whichever 能为其商业模式带来最佳性能和经济效益的组合。
把 GPU 从机器人上移走有实实在在的好处,但也带来真实的挑战。其中首要问题是延迟,而且这种方案并非处处可行。在连接条件差的环境中,云端部署根本行不通。尽管有这些困难,机器人外部算力仍然是有益的,某些情况下甚至是必需的,接下来的章节会说明这一点。
机器人中的模型
在讨论为什么机器人模型应该在机器人之外的数据中心运行之前,先简单介绍一下机器人模型的工作原理,以及我们讨论的是哪些模型。
机器人控制是一个很宽泛的领域。硬编码控制——工程师为每一个动作编写规则和数学公式——几十年来一直靠嵌入式算力驱动着工厂运转,小型任务专用策略也完全可以装在本体上运行。但这不是我们要讨论的主题。我们讨论的是数据驱动的通用型机器人技术,即由大型基础模型驱动的机器人,因为那才是前沿所在。
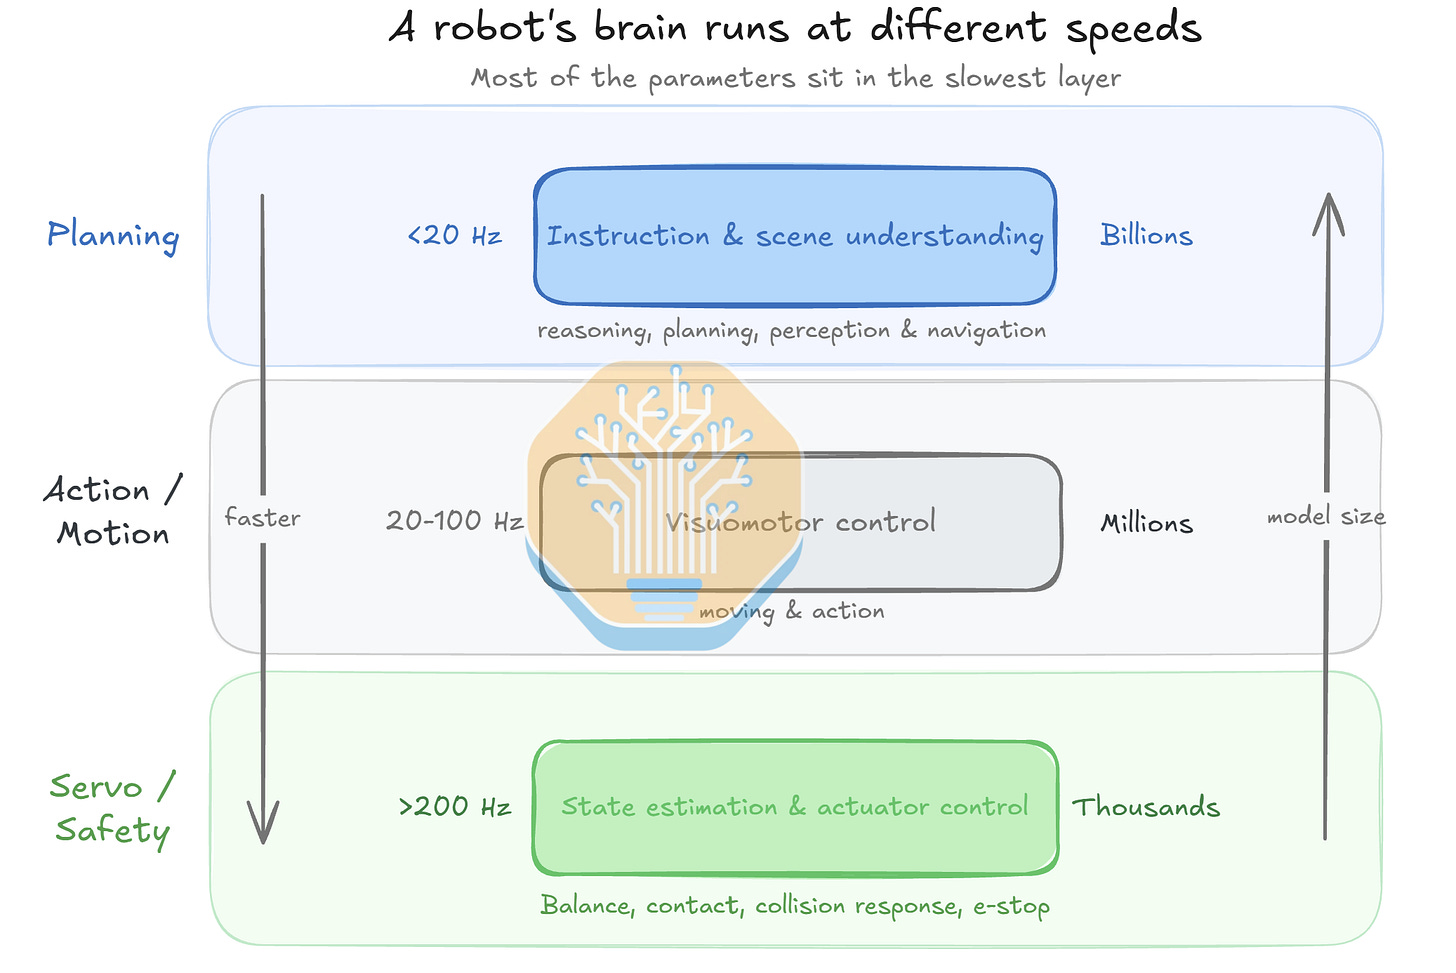
即便在数据驱动的通用机器人模型内部,架构也各有不同。有些是单体式的:一个模型直接从摄像头看到的内容映射到电机的运动方式。许多则是分层式的:一个又大又慢的模型决定做什么,一个又小又快的模型把它转化为动作,每秒执行数百次。我们关于机器人外部数据中心算力的论证,针对的正是这些分层模型——它们的大脑分离成两层或多层,最常见的是规划层和动作层。
规划层是慢速、高层的部分:它感知场景、进行空间推理并规划任务。动作层是快速、低层的部分:它把这些计划转化为电机指令。规划层也是模型中较重的部分,但它更宽容:每秒只更新几次,并且与控制循环异步运行。因此在下一个计划还在生成时,动作层仍会继续按照最近的计划执行动作。这种解耦让规划层可以吸收无线往返带来的延迟,甚至抖动,而动作层以数百 Hz 的频率运行,完全无法容忍这些延迟。所以规划层是迁移到数据中心的天然候选者,而快速控制循环则保留在本地。
Source: SemiAnalysis
规划的计算量与机器人工作的通用程度成正比。一个为处理开放式任务而打造的通用机器人,需要一个能进行真正推理的大型规划模型,而这类模型非常重。这种推理恰恰就是被推到数据中心的部分。专用机器人则相反:执行单一重复性工作的窄域策略几乎不需要高层规划,因此整个模型足够小,可以直接留在机器人本体上。
为什么 DC GPU 更适合……
专用机器人在很大程度上已经被解决了:工厂多年来一直依靠硬编码的自动化技术运行,而非现代 AI。但专用机器人是刚性的,一个工位只能完成一个任务,当瓶颈转移时就会闲置。通用机器人才是前沿方向,因为一台灵活的机器人可以胜任多种工作,可以随时重新部署到出现瓶颈的地方、应对不断变化的产品组合,以及处理非结构化工作的长尾需求。这与丰田生产方式(Toyota Production System)的诸多经验教训之一相吻合:多技能工人能够减少浪费并提高经济效益。因此,通用机器人市场的 TAM 十分庞大,不仅覆盖制造业和仓储业,还包括家庭等各种场所。
对通用性的要求越高,就越需要依赖计算量(FLOP)巨大的基础模型和数据中心级算力。并非每台机器人都需要最大的通用性,许多任务用较小的模型就能很好地完成。但在灵活、通用机器人的前沿领域,数据中心级算力是必不可少的。
LLM 与机器人模型的 Token 流量对比
LLM 吞吐和输出的 token 数量巨大且呈突发性:先要预填一个长 prompt,然后是长篇生成,期间 KV cache 一直在增长。这就是内存墙问题:既要容纳不断增长的 cache,又要为每个 token 提供流式读取权重和 cache 的带宽。这使得 LLM 服务受限于带宽。
机器人模型恰恰相反,它是一条较小的稳定数据流,更像节拍器,而不是一次爆发。它从不停止,因为机器人不是回答完一个问题就停下,而是与运动中的世界锁定在一个闭环里:每隔几分之一秒接收一帧新画面,并输出一小段动作。每一帧都由专用硬件(ISP 和视频编解码 ASIC)压缩成固定且紧凑的 token 预算,大约几十到几百个 token。因此,机器人模型并不像 LLM 那样在同等程度上受限于内存容量和带宽。
Source: SemiAnalysis
前沿机器人模型对 FLOPs 的渴求
制约前沿机器人模型的有时是内存,但更多时候是运行它所需的 FLOPs。
这类工作负载非常吃 FLOPs:VLA(视觉-语言-动作模型)是一个数十亿参数级的模型,比之前的专业策略模型大了几个数量级,而其视觉和语言阶段——即占工作量主体的部分——在任何高性能 GPU 上都是算力受限的。WAM(世界动作模型)则更重。它不是直接输出一个动作,而是生成预测未来的视频,再从中推导出动作,这一过程需要迭代去噪,意味着一个动作可能需要对模型进行多次完整的前向传播。
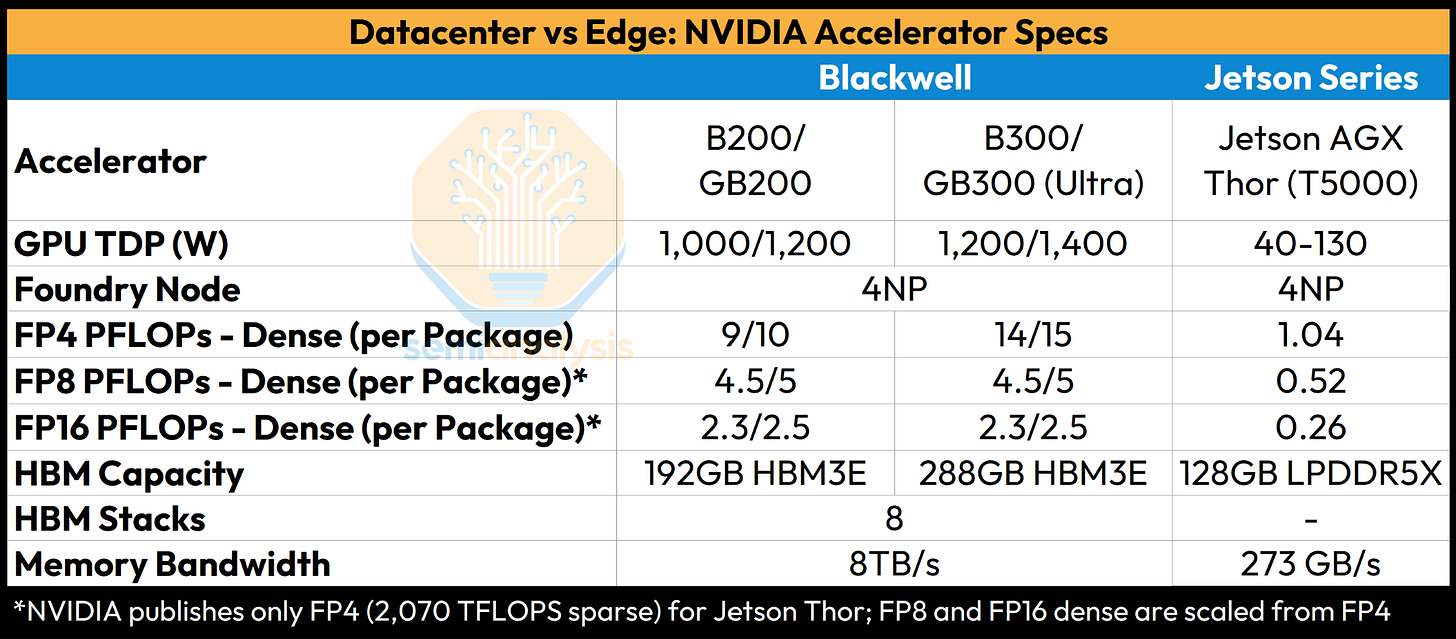
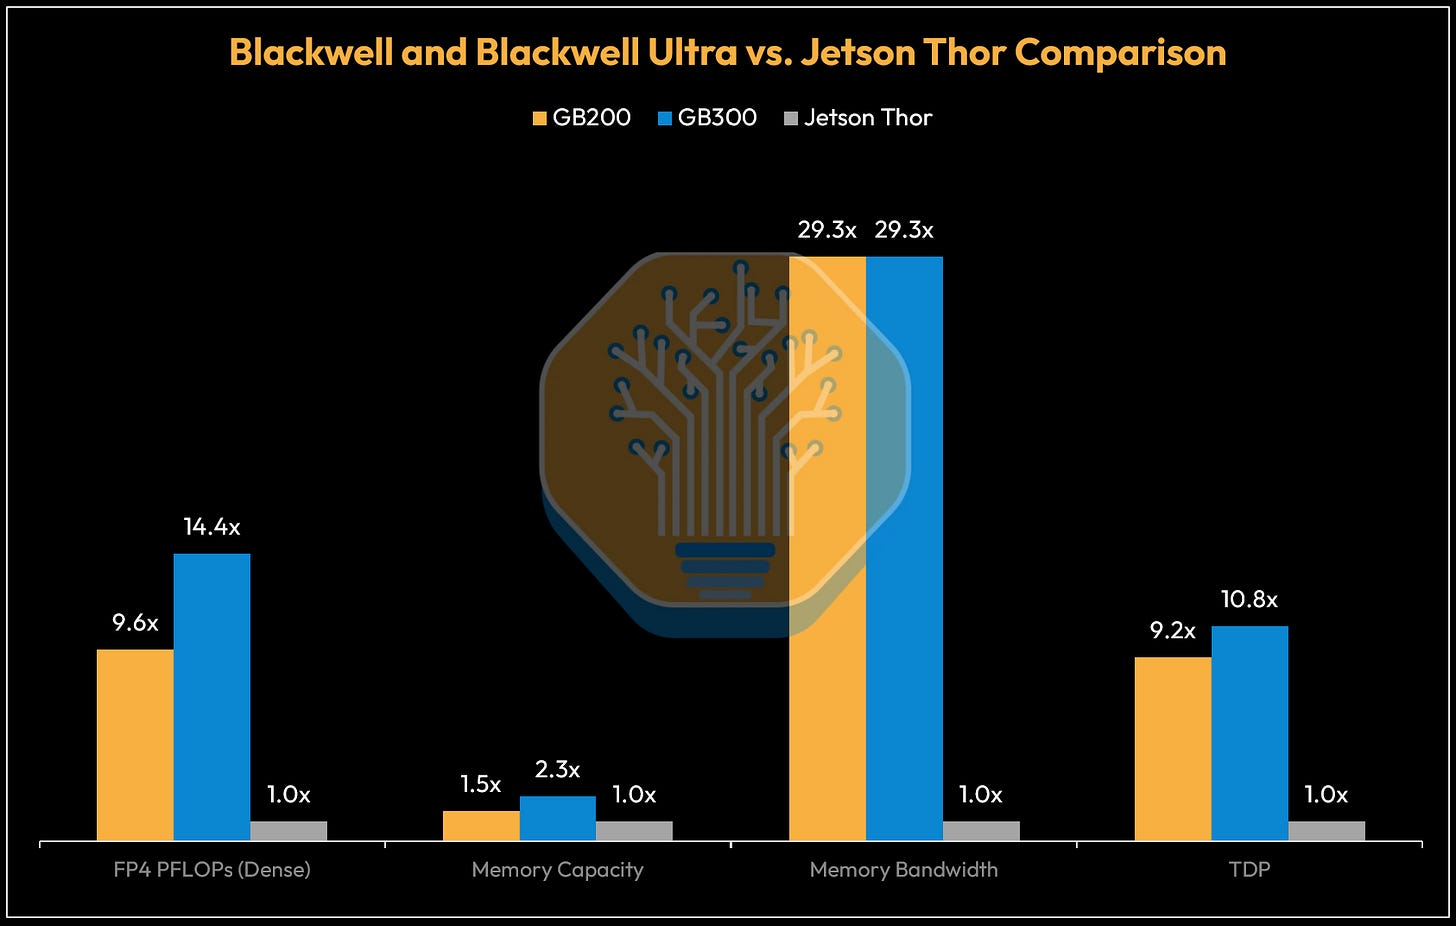
边缘端芯片跟不上。Nvidia 最新的 Jetson Thor 是同类最佳的机器人大脑,但其算力仅约为单块 B200 的十分之一、B300 的十四分之一左右。DreamZero(一个 14B 的 WAM)需要两块 GB200 GPU 才能达到约 7Hz,这大约是单块 Thor 所能提供的算力的二十倍。若在 Thor 上运行同一模型,频率会跌到远低于 1Hz,对实时控制来说太慢了。
Source: SemiAnalysis
Source: SemiAnalysis
将机器人模型移出设备
如果 Jetson Thor 跟不上,而我们将繁重、计算密集的工作负载卸载到数据中心,那就意味着要让本地计算专注于安全环路和高频控制环路的优化,并全力投入网络接口的优化。
首要考虑的是我们需要达到、并且要稳定达到的端到端(glass-to-glass)延迟预算。网络会带来带宽和稳定性问题,而在传输图像数据时,我们对这一点的感受最为明显。
快速、可靠地传输图像数据,绝不仅仅是给设备装上一个专用压缩 ASIC 就万事大吉,整个上游图像处理流水线都必须优化。噪声是压缩的天敌:图像的时空结构越少,就越难压缩。因此,一个针对网络传输优化的优秀本地计算系统,会优先保证那些从源头上把噪声挡在图像之外的组件:光学系统、低光照下的传感器性能、传感器信噪比(SnR)、热管理,以及图像信号处理器(ISP)。
ISP 会把杂乱的模拟信号转换为数字信号,但如果 ISP 没有针对压缩进行专门优化,就会损害压缩效率。而且,当我们把整个成像管线视为一个整体来考虑时,我们是在为模型做优化,而不是为了人类观看。这类似于 WAM 不需要典型视频扩散模型所用的额外去噪步骤;它们解决的是不同的任务。同样的原则在这里也适用:我们关心的是良好的模型输出和低码率,而不一定是漂亮的图像(见下文)。
Left image is more pleasing to the eye, but the right image has a higher SnR. Source: NASA
网络状况会引入大量变数,因此本地计算还必须对 ISP 和压缩码率进行动态的实时自适应调整,类似 WebRTC 的做法,从而优雅地应对持续波动的网络状况,同时不损害模型性能。
要构建一条能够输出干净、可自适应调整的数据流的管线,还需要专门为“卸载”调优的硬件——让数据比特按时离开设备、送达目的地。长期以来,移动芯片组的优先级都在下行速度上,但机器人需要巨大的上行容量来向外传输高保真遥测数据,而下载的数据量则可以相对较小。这意味着需要多个合理布局的发射天线,因为环境和机器人本身都可能遮挡信号。这也意味着要支持更广泛的射频(RF)频段,以便通过多信道实现更高的吞吐量和更少的拥塞——尤其是考虑到工厂环境。针对接入点之间的切换以及 WiFi 与 5G 之间的快速切换来优化硬件和嵌入式固件至关重要,因为典型的切换耗时会在短期内耗尽延迟预算。抖动(jitter)是最大的敌人。
最终目标是一个高度协同的混合架构:本地保留适量(但不过度充裕)的 FLOPs 用于安全和高频控制,同时能够可靠地卸载基础模型(foundation model)中的“基础”部分。这不是一个完美的系统:一旦网络连接变弱或完全中断,仍然需要简单的控制回路作为兜底。我们还需要延迟看门狗(latency watchdog)、心跳超时机制,以及对远程动作的新鲜度(staleness)约束。
功耗
数据中心 GPU 必须在机器人之外运行,因为电池根本喂不饱它。单块 Blackwell GPU 的功耗约为 1.2-1.4 kW,必须液冷,且为机架部署而设计。相比之下,一个人形机器人电池仅能储存约 2 kWh 的能量,正常运动时功耗为几百瓦,峰值时一两千瓦(含所有部件),这也是为什么它的机载大脑是一块 40 到 130 W 的 Jetson Thor。如果给机器人装上一块数据中心 GPU,仅这块芯片的功耗就会超过整台机器人,它要求的散热能力机器人也无法承载,电池几分钟内就会被耗干。卸载则绕开了功耗限制:机器人只需携带一块 20 到 30 W 的感知计算加无线板卡来连接数据中心 GPU,轻松控制在预算之内。
供应链之墙
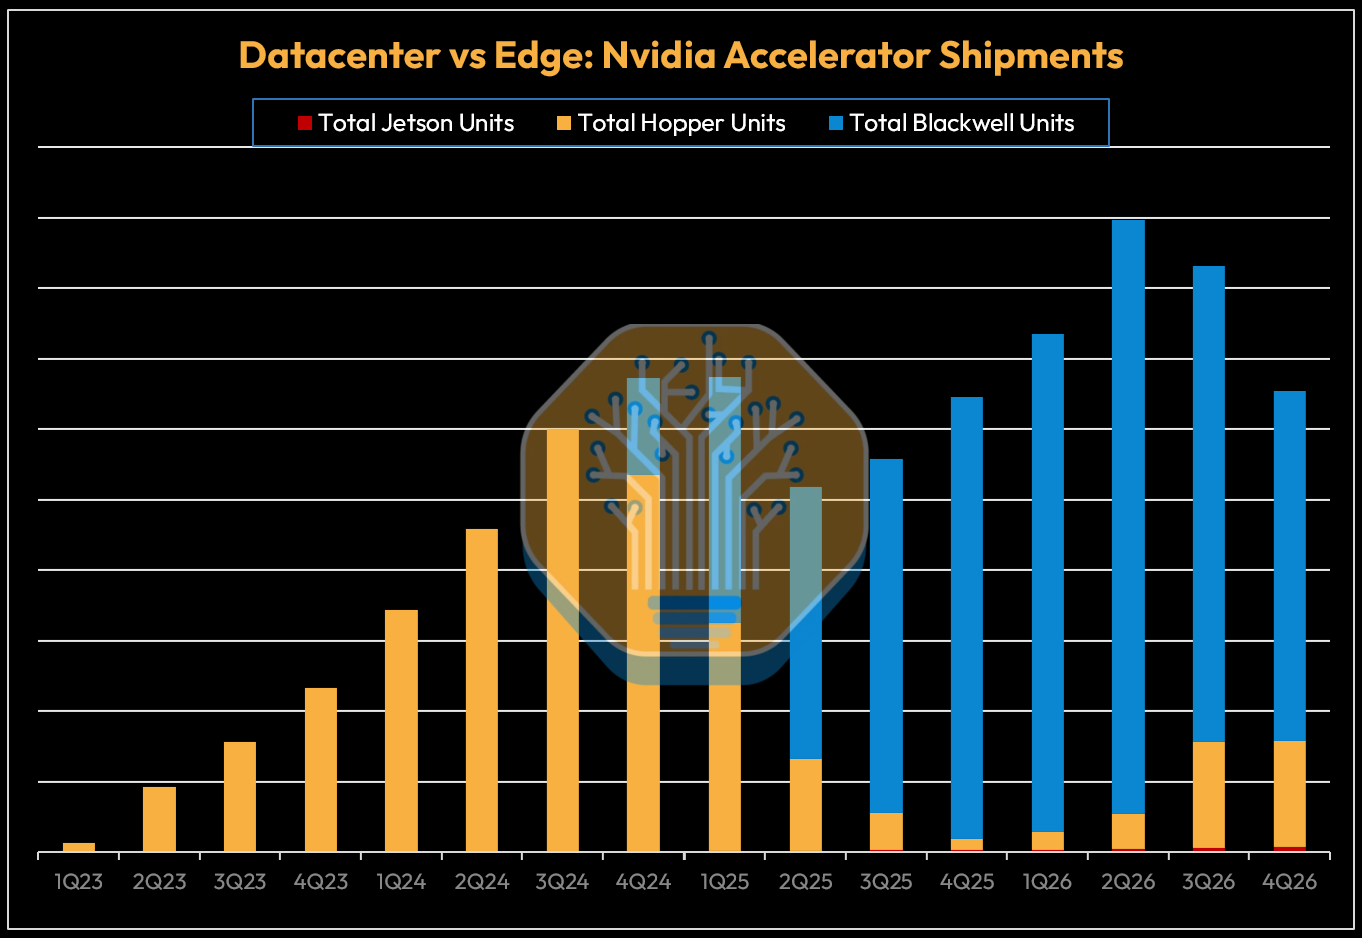
Nvidia 的加速器产出几乎全是数据中心芯片:Hopper 在 2023 和 2024 年经历了漫长的爬坡期,随后交接给 Blackwell。Blackwell 在 2025 和 2026 年迅速放量,在产品组合中占据主导地位。而用于机器人的 Jetson 产品线,只是图表底部一条细细的红色细条,即便到 2026 年也几乎看不见。原因在于:机器人市场尚处于萌芽阶段,真正的出货量还要等很多年,而且现在几乎没有可以构建的应用场景。
Source: SemiAnalysis Accelerator Model , we withheld Rubin shipments on this chart, buy the data
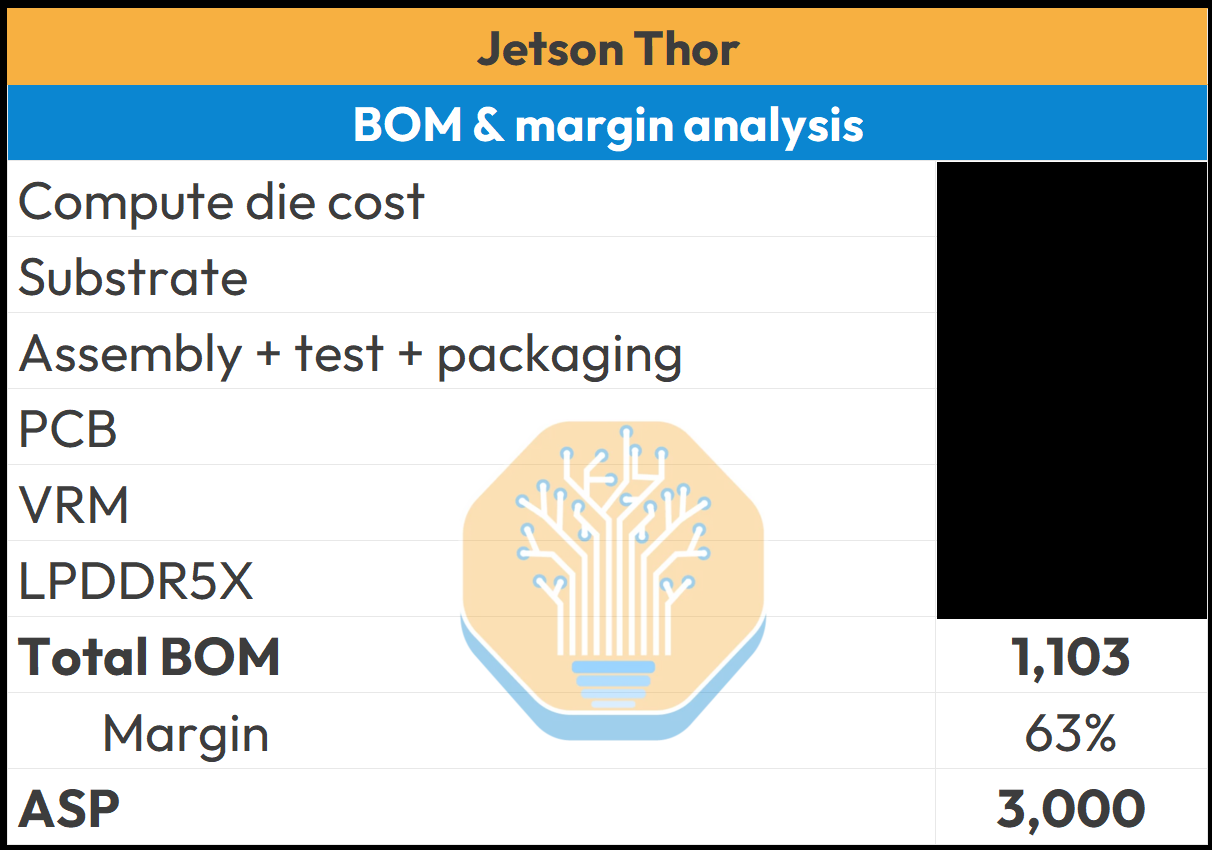
利润率也印证了同样的情况。需求还没有到来,但一旦到来,价格会上涨,Jetson 的利润率也会出现拐点。但目前,一块 Blackwell 数据中心 GPU 的毛利率远高于一个 Jetson 模块:前者大约在 70% 多到接近 80% 的区间,后者只有 60% 多。因此,Nvidia 有充分的动力把稀缺的先进制程晶圆产能投向数据中心,而在机器人市场规模还很小的时候,几乎没有理由去扩大边缘侧芯片的产能。此外,像 Jetson Thor 这样的机器人芯片,单位算力所需的内存也多得多,这是一个重大瓶颈。
Source: SemiAnalysis Accelerator Model
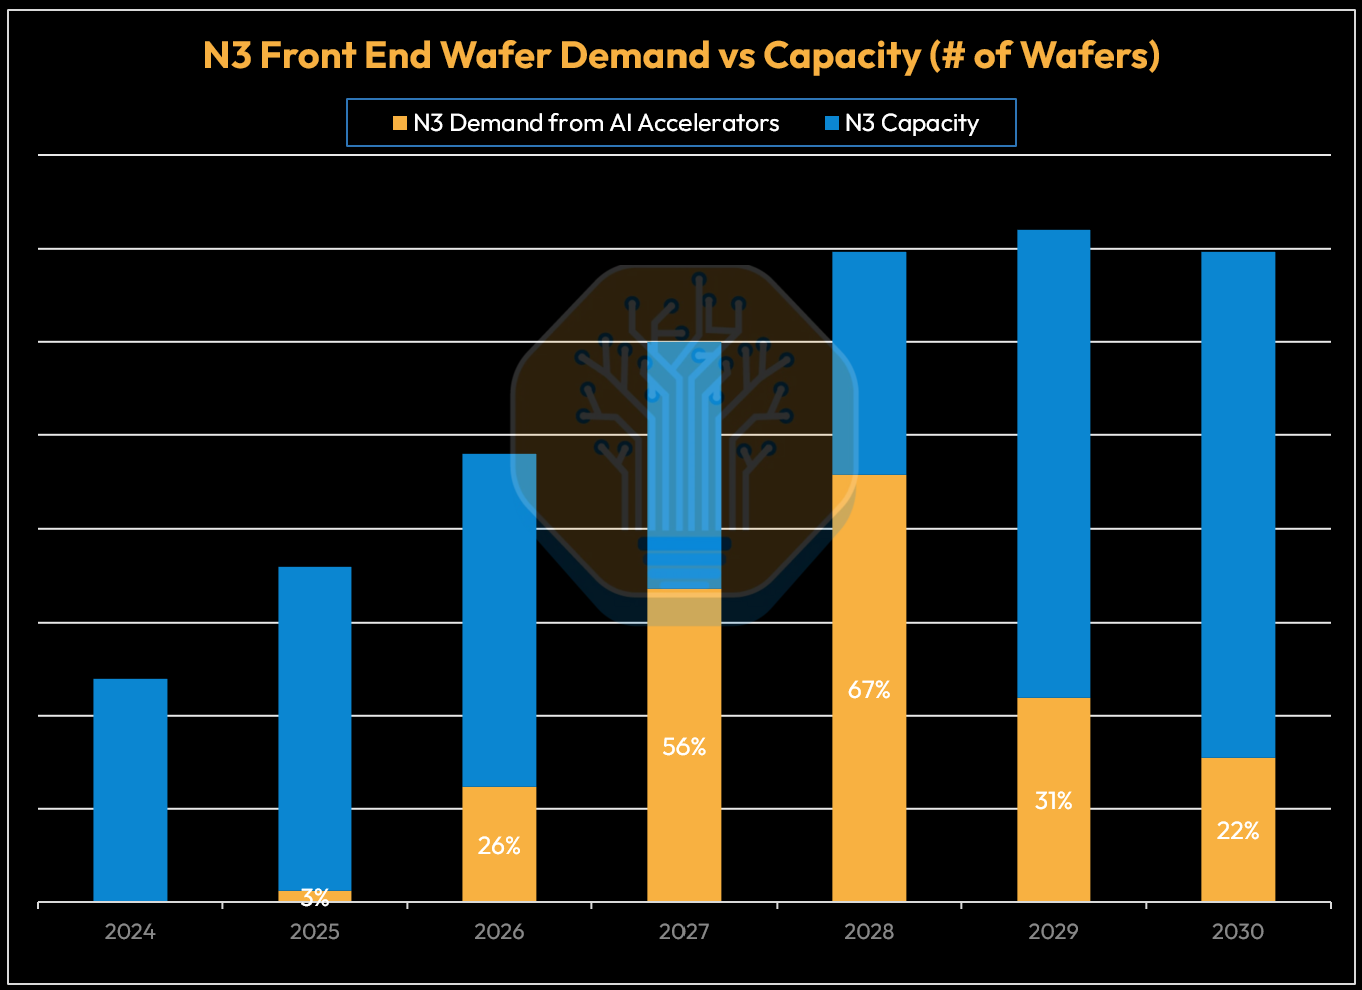
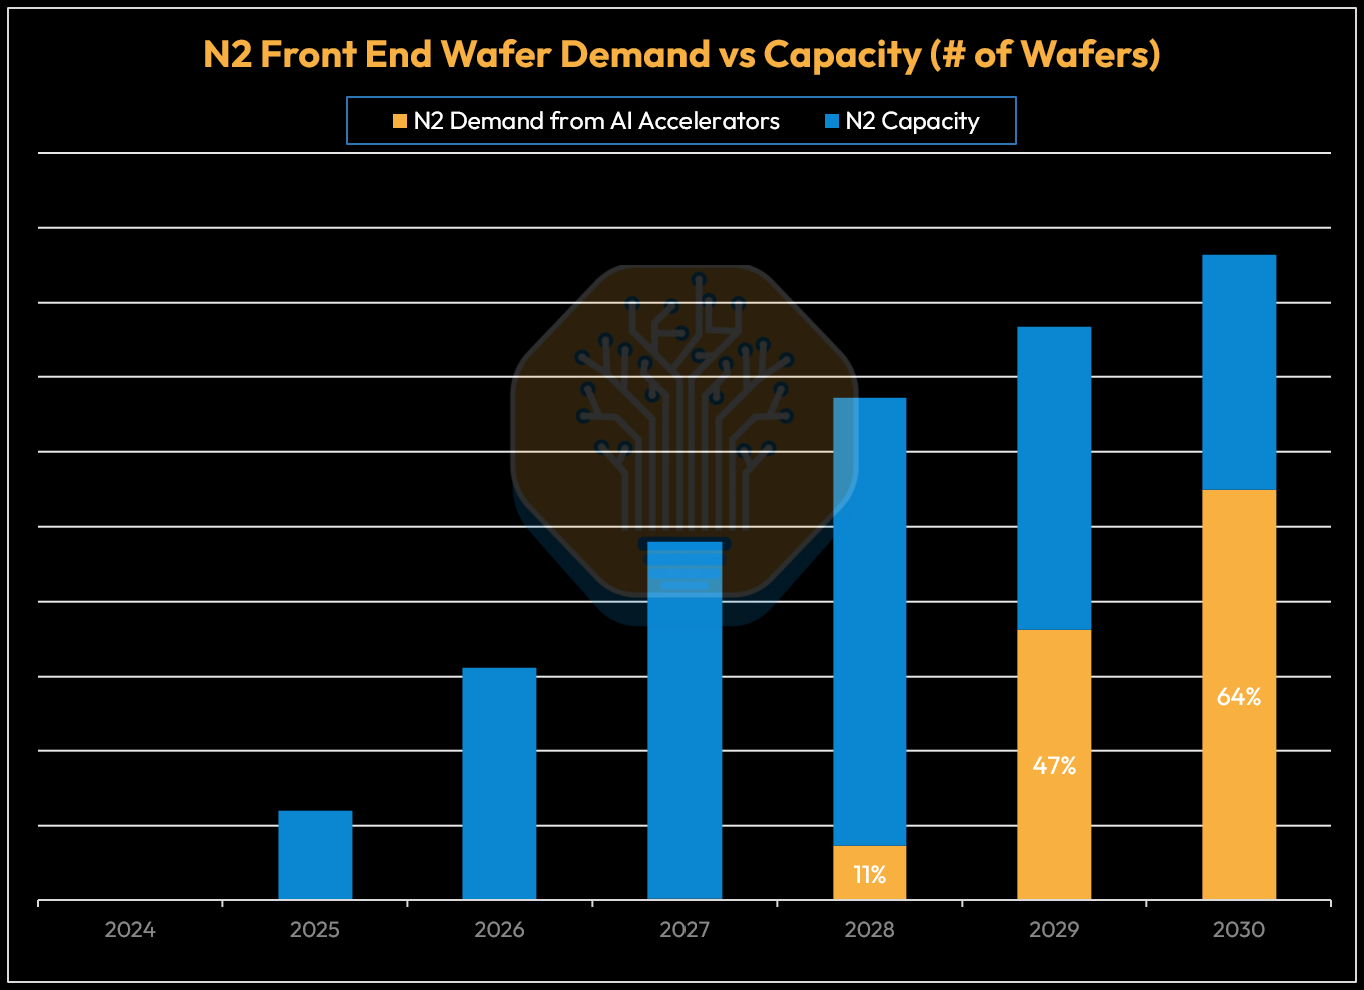
更糟的是,机器人芯片正在向数据中心争夺的那些制程节点收敛。Nvidia 的 Jetson 产品线过去是有缓冲的:上一代 Orin 采用的是三星的 SF8 工艺。而当前的 Thor 已经追平到了 Blackwell 所用的 TSMC N4。随着机器人运行越来越强大的模型,其芯片也必须保持在最先进制程上:Thor 的下一代很可能会与 Rubin 一起迁移到 N3,再下一代与 Feynman 一起迁移到 N2——而这些恰恰是整个 AI 加速器路线图都在争夺的节点。因此,出货量小、利润率低的 Jetson,在先进制程晶圆的争夺中,永远只能排在队列末尾。
Source: SemiAnalysis Accelerator Model
Source: SemiAnalysis Accelerator Model
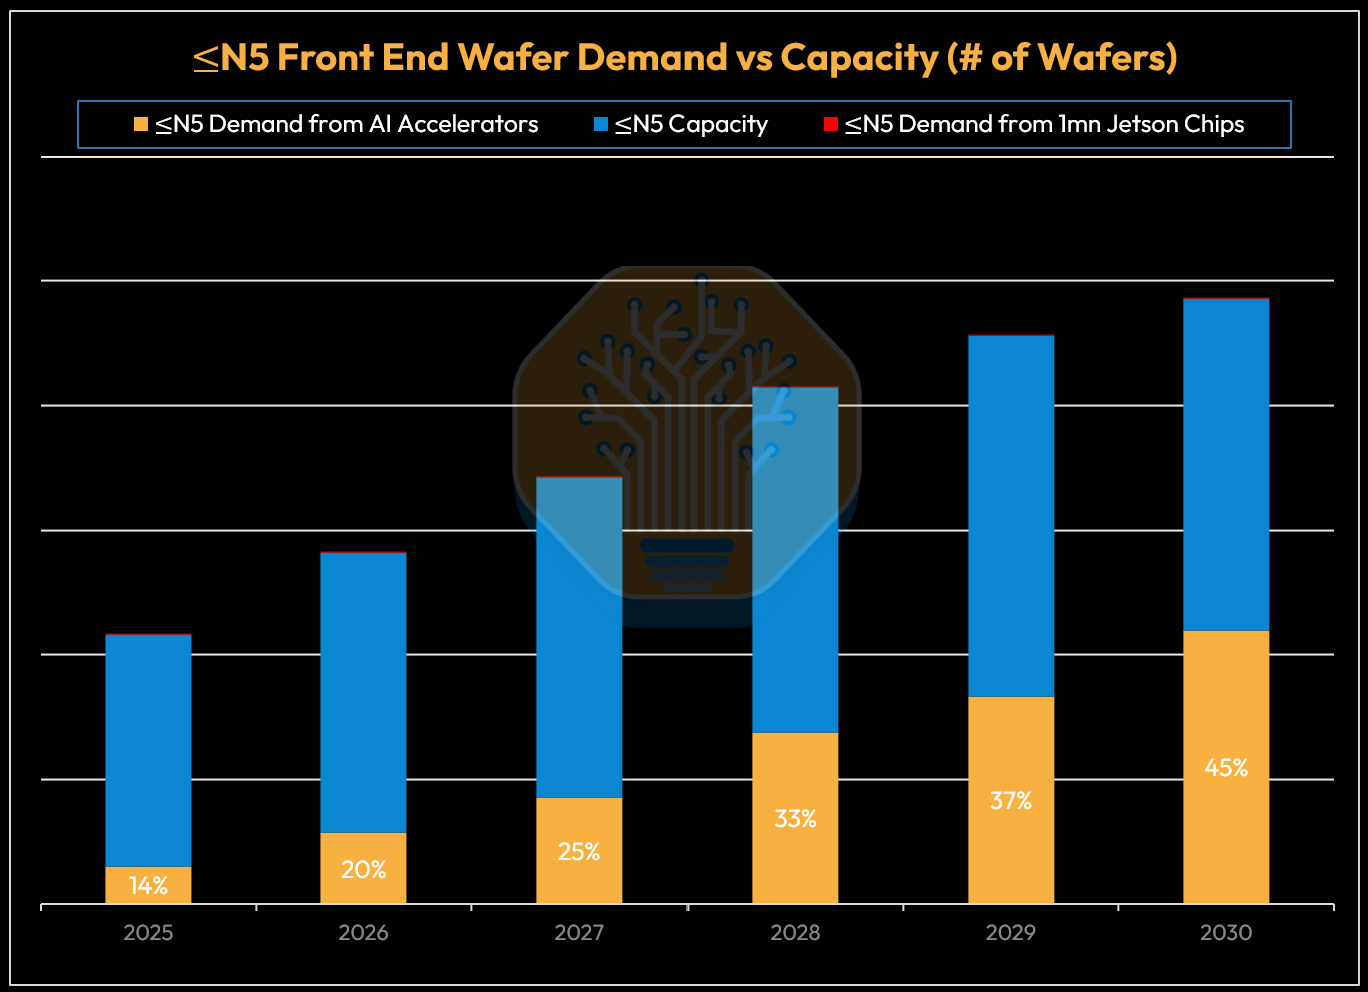
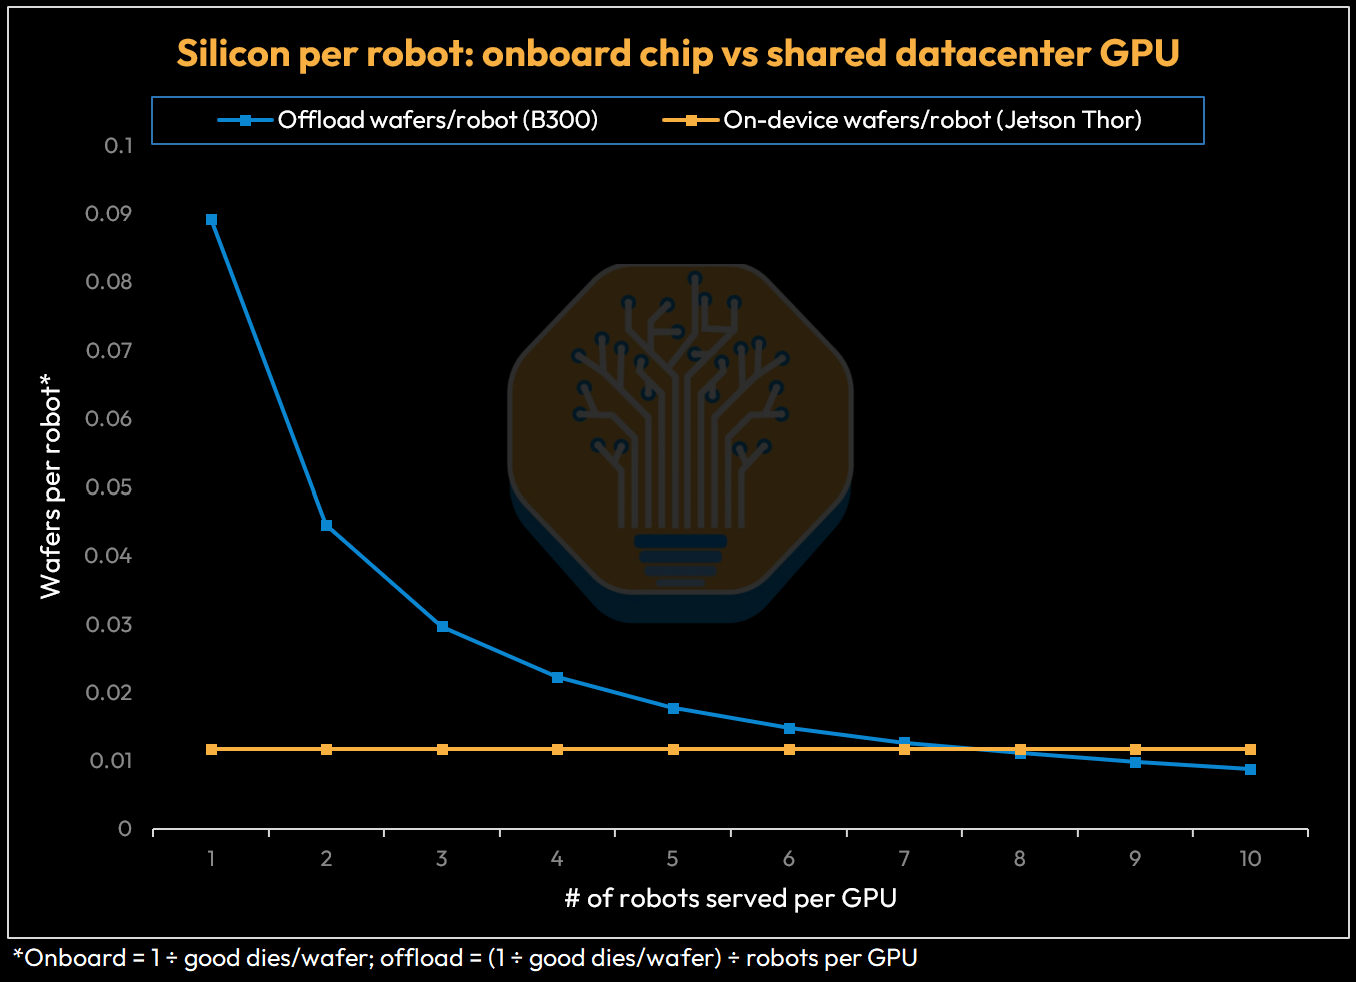
但机器人带来的晶圆需求并不是产能紧张的根源。到 2030 年,一百万颗 Jetson 级别的芯片,每颗约 400mm²,全年也只需要大约一万片晶圆,相对于数据中心 GPU 的放量来说只是个零头。因为 Thor 的裸片面积还不到半个光刻掩模版的大小,而且眼下根本就没有那么多机器人。只有当机器人每年需要数千万颗芯片时,供应才会真正紧张,而这要远远超出 2030 年。所以,真正的问题不在于机器人能不能拿到晶圆,而在于硅片效率:对于给定规模的机器人集群,哪种方案消耗的先进制程硅片更少?是给每台机器人都装上一颗芯片,还是用共享的数据中心 GPU 来提供它们的认知能力。
Source: SemiAnalysis Accelerator Model
如果用每台机器人消耗的晶圆数来衡量硅片效率,机载芯片与共享数据中心 GPU 的曲线大约在每颗 GPU 对应 7 台机器人处交叉。超过这个点之后,用共享 GPU 提供认知能力,每台机器人消耗的硅片就比每台机器都装一颗芯片更少。这才是这里真正关键的地方:因为当晶圆厂供应紧张时,每台机器人消耗硅片更少的方案,才是能够规模化的方案。
Source: SemiAnalysis
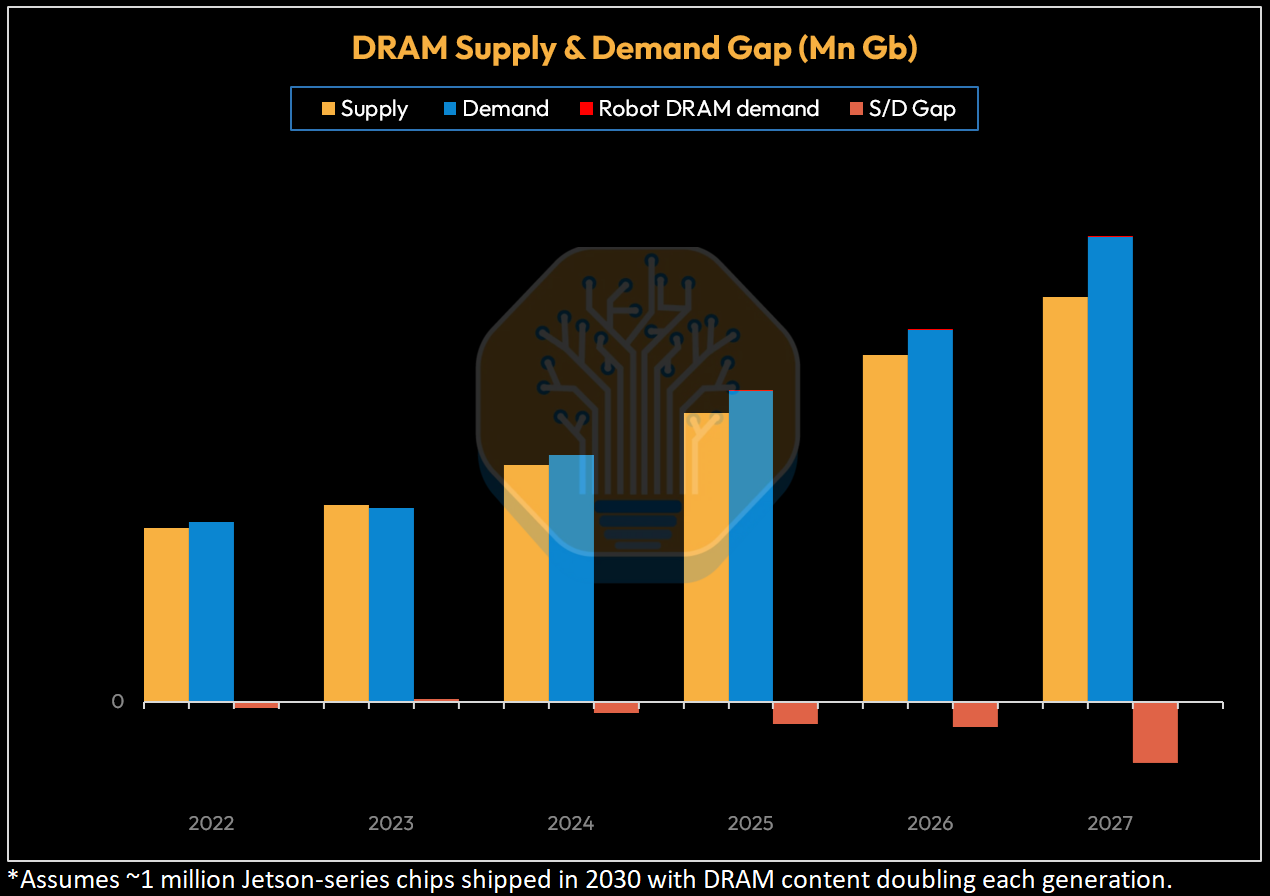
另一个主要瓶颈是内存。每一代 Jetson 都比上一代搭载更多 DRAM:Jetson Xavier 用的是 32GB,AGX Orin 是 64GB,Jetson Thor 现在则用上了 128GB 的 LPDDR5X,而且未来几代还会继续攀升。尽管 DRAM 晶圆总产能持续增长,但大部分新增产能都被用于 AI 加速器的 HBM 吸收了。
这样一来,机器人大脑所依赖的普通 DRAM 和 LPDDR 供应,就只能去争夺日益萎缩的非 HBM 晶圆池。同样地,当 DRAM 成为稀缺资源时,每台机器人耗用更少 DRAM 的方案才是可扩展的方案。这些 LPDDR 更好的归宿是分配给 Vera GPU,或者制成 HBM 晶圆。
Source: SemiAnalysis Memory Model
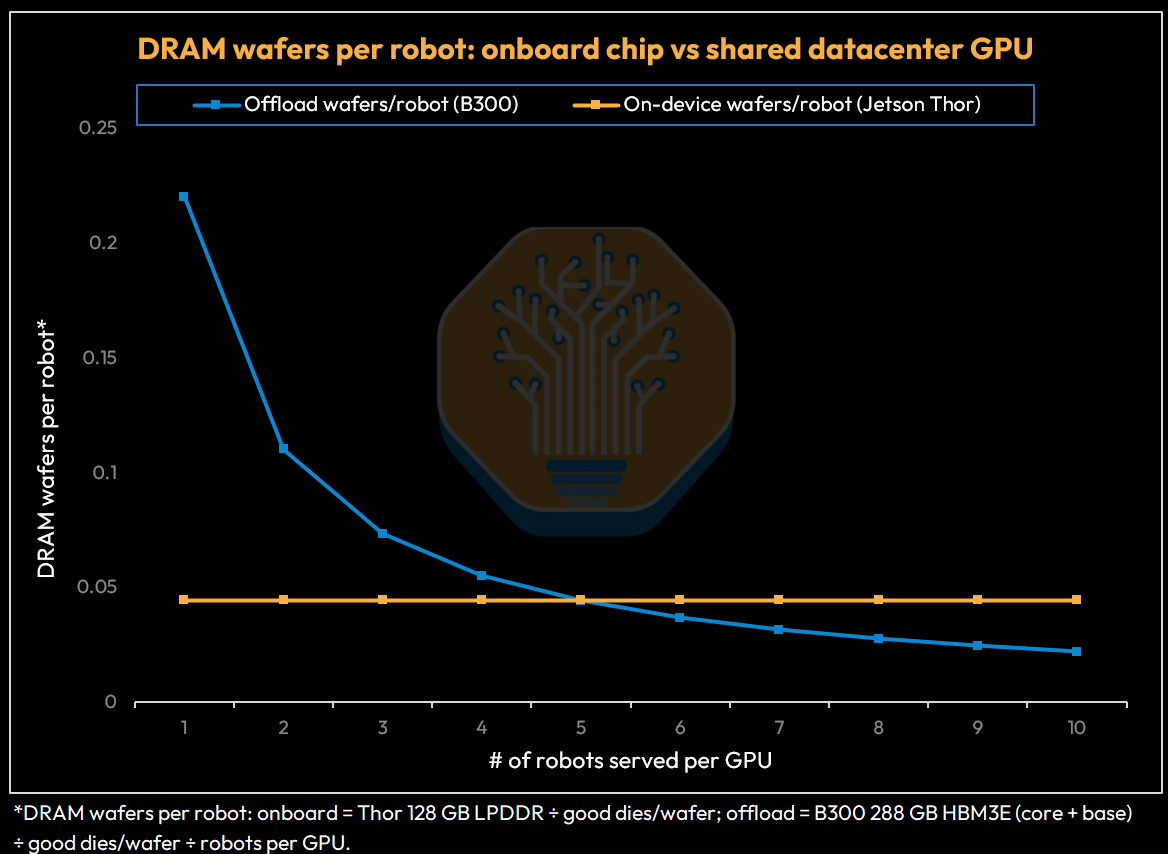
内存方面的情况也类似:板载芯片与共享数据中心 GPU 的交叉点大约在每块 GPU 服务 5 台机器人。超过这个数量后,用共享 GPU 提供认知服务,比在每台机器里装一颗芯片所需的每机器人 DRAM 更少。
Source: SemiAnalysis
TCO 结论:一台 B300 服务器 vs. 56 台 Thor
我们在真实的 B300 上运行了 RoboArena 目前的领跑者 DreamZero,采用了 NVIDIA WAM 论文中的推理优化(CUDA graphs、DiT 缓存、NVFP4 量化,以及把调度器搬到 GPU 上)。我们还运行了单步去噪以对齐 DreamZero-Flash 的设置,但没有使用 Flash 的重训练方案,因此任务质量尚未经过验证。
DreamZero 的服务负载呈现 prefill 型特征:每次推理都会将一整块视频 latents(数千个 token)并行送入 14B DiT,因此 B300 在 batch size 为 1 时就已是计算受限。批处理因此毫无收益:FLOPs 随 batch size 一比一增长,每台机器人都只能等更久。取而代之,我们采用时分复用,让 B300 逐个顺序服务每台机器人。这是视频生成式 WAM 特有的情况。像 π0 或 GR00T 这类 VLA 则正好翻转了 roofline 曲线:几百个 token 穿过一个小骨干网络,GPU 受限于内存带宽,因此批处理能把相同的权重读取摊销到多台机器人上,吞吐量随 batch size 几乎线性增长。服务 VLA 机队要用连续批处理;服务视频 WAM 则一次只服务一台机器人。
我们做的一个关键假设是网络 RTT 为 10ms,也就是说 GPU 部署在机器人附近的本地环境。每次推理为机器人买来接下来 1.6 秒的动作,这使得 1.6 秒成为我们的延迟预算:一个请求在网络、排队和计算上总共可花费的时间,超过这个时间机器人就会耗尽指令、在动作中途卡住。
Source: Nvidia
我们在下图中查看 p99 延迟(蓝线),即第 99 百分位的响应时间。100 个请求中有 99 个会比这个值更快返回,所以它实际上就是最坏情况。在这里它比中位数(绿线)更重要,因为只要任何一个数据块迟到,机器人就会立刻卡住。我们看到,一块 B300 GPU 最多能处理的机器人数是 7 台。在 7 台机器人时,p99 为 1.16 秒,仍低于上限,整个运行过程中没有遗漏任何数据块。
Source: SemiAnalysis
既然知道了每块 GPU 可以时分复用服务 7 台机器人,那么根本性的 TCO 问题就摆在眼前:
将计算卸载到 B300 服务器更便宜,还是在 Jetson Thor 上进行端侧推理更便宜?
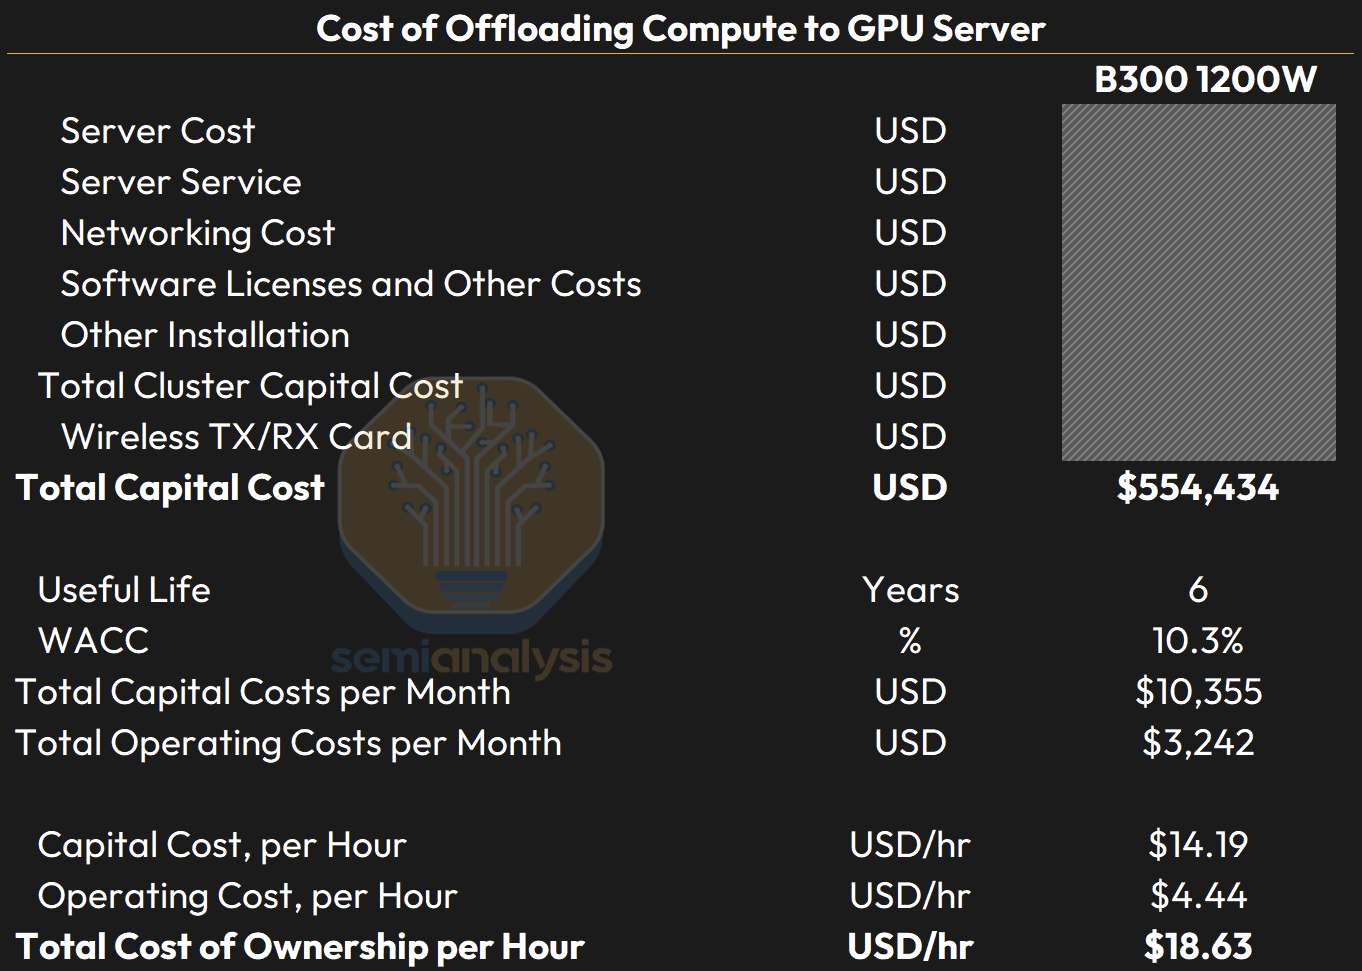
我们构建了两种场景:卸载场景假设一台 Blackwell 级服务器可以服务 7 个机器人(即一台 B300 NVL8 服务器服务 56 个机器人);端侧场景则是同样的 56 个机器人,每个机器人搭载自己的 Jetson Thor。在这两种场景中,两种情况下通用的部分(即机械部件、机器人外壳)不计入 BOM 成本计算。
我们还会讨论这种部署机制所面临的最大挑战。