← 全部文章
TPU Inference Externalization Full Steam Ahead - InferenceX
2026-09-07 · 原文
十多年来,整个行业一直在看着 Google 用自研芯片构建起一个帝国。搜索、广告、YouTube 以及每一代 Gemini 模型都运行在 TPU 上。很少有加速器像它这样受到如此多的架构审视,也很少有芯片会引发这么多关于“离开设计它的公司之后,性能和经济性会怎样”的争论。Anthropic 是 TPU 最大的用户,到 2029 年其用量将超过 Deepmind 自身的用量。
Source: Google
Google 内部的成功从来不是问题。问题在于,业内其他厂商究竟能获得多少这种优势。如果你拿一个开放权重模型,通过熟悉的推理引擎来提供服务,能否在对业务至关重要的经济学指标上击败 NVIDIA?
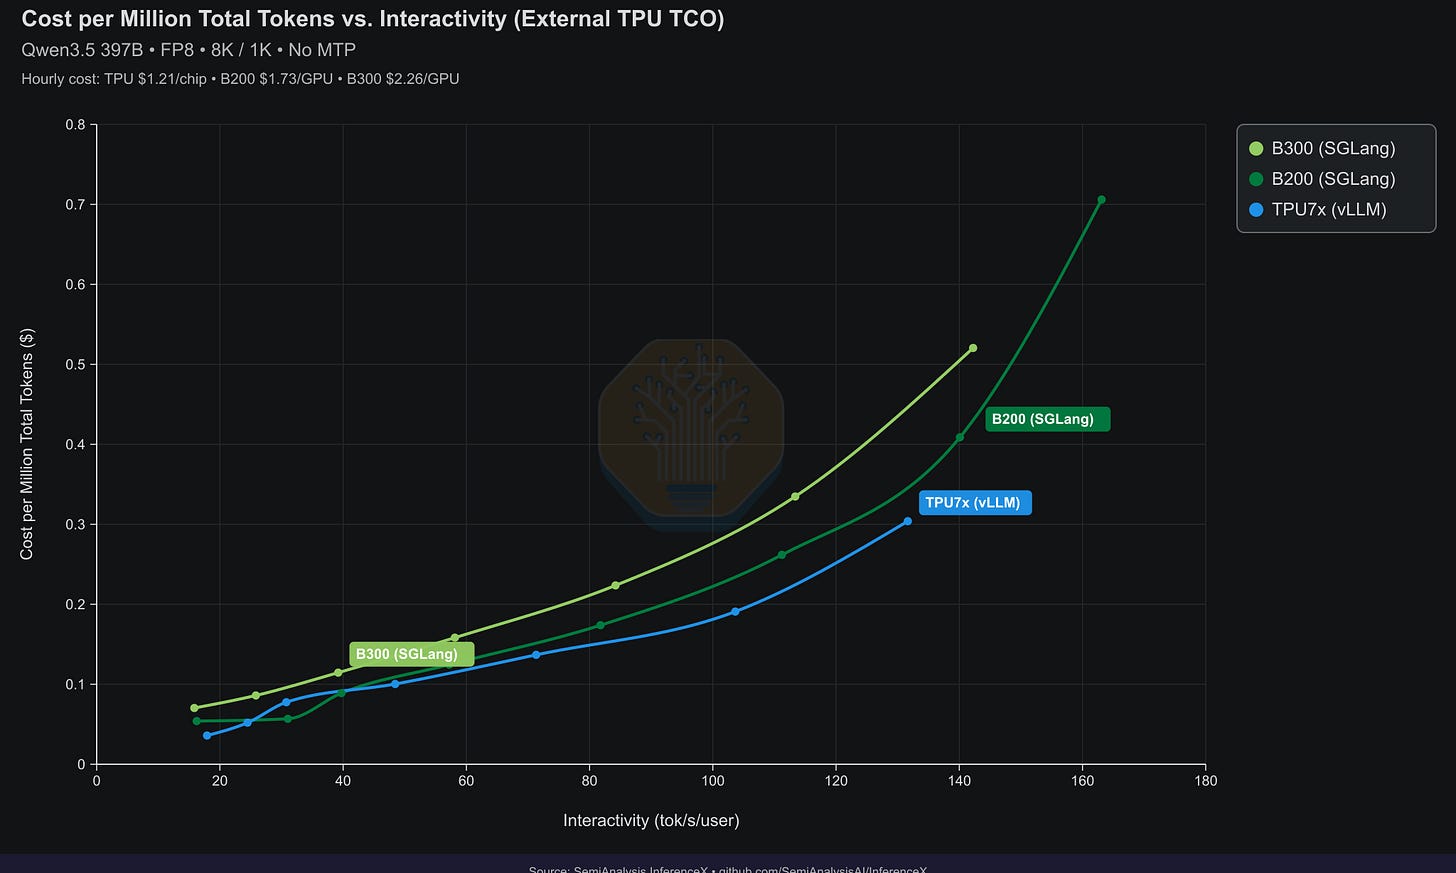
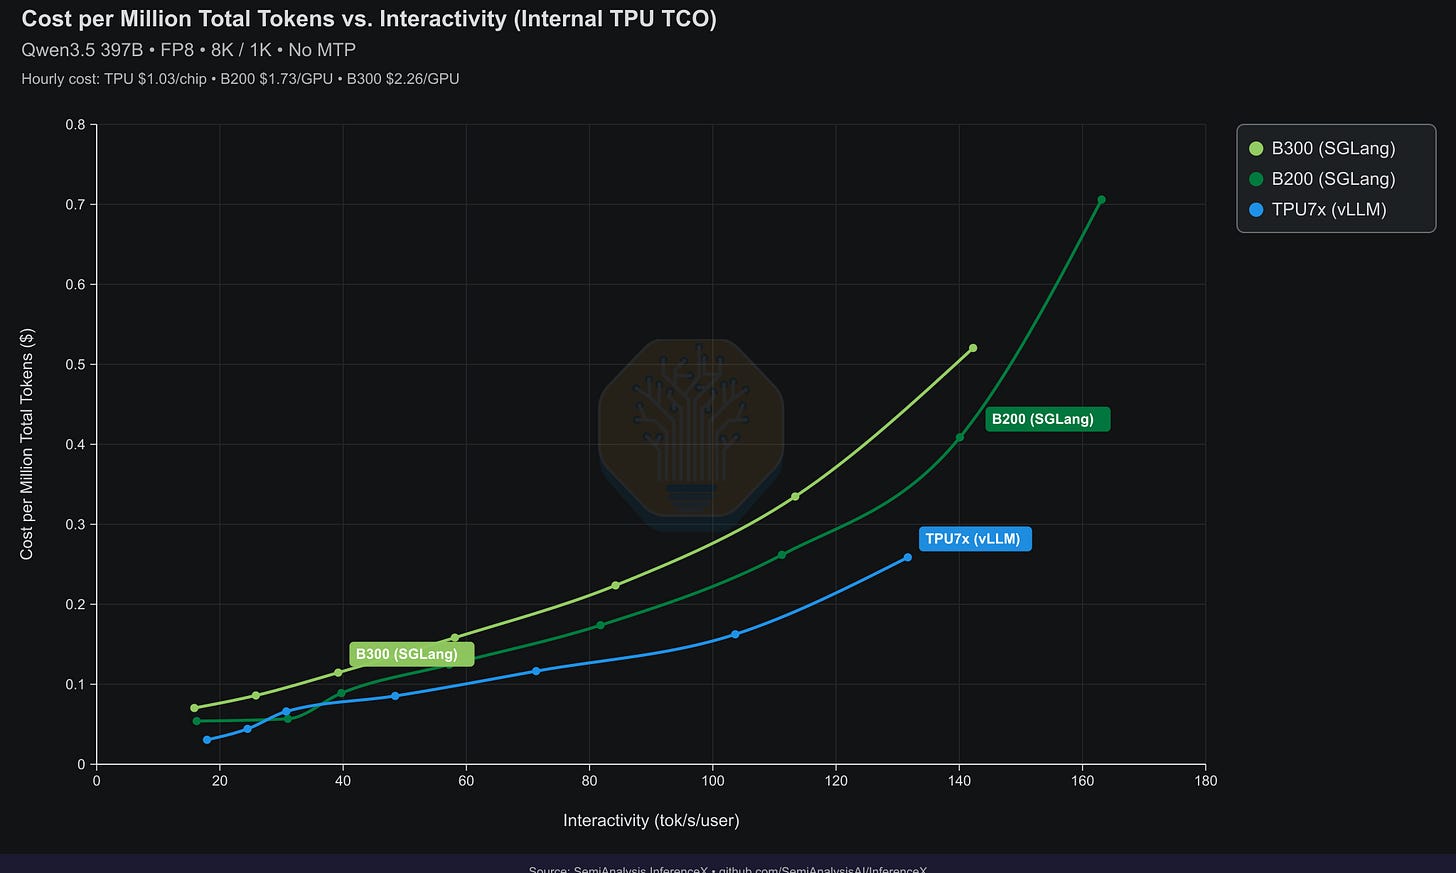
今天,我们在 InferenceX Official Preview 上发布 TPUv7 Ironwood 的首批第三方推理结果。在与 B200/B300 的同类对比测试中,Ironwood 的每美元性能最高可提升 50%。它的优势覆盖了 Pareto 曲线的大部分区间。我们从两个角度分析了经济学:Google 内部的总拥有成本(TCO),以及真实客户实际支付的外部 TCO。
Ironwood(TPUv7)是 Google 第一代真正参与争夺外部推理工作负载的芯片,客户可以 outright 采购,也可以通过 Google 自己的云来租用。2025 年 11 月,我们就已经指出 Anthropic 非常青睐 TPU,并承诺使用超过一百万颗(其中约 40 万颗以上为直接采购,60 万颗以上通过 GCP 租用),主要用于训练,但也用于推理。我们的 Accelerator Model 收录了 Anthropic TPU 出货量以及 Google 整体 TPU 季度出货量的最新数据,还包括对 TPUv8i、v8t 以及各种 v9 / v10 的预估,等等。
我们很高兴看到新的 TorchTPU 栈——也就是 TPU 的外部软件栈——发展得如此迅速。在文章后半部分,我们将讨论 TPU 软件外部化接下来需要完成的工作,包括优化投机解码、分离式预填充(disaggregated prefill)、KV 缓存卸载(KV-cache offloading)、多轮次智能体工作负载等。即便如此,我们 SemiAnalysis 坚信 TPU 外部化正朝着正确的方向全速前进。此外,与仍在学习建立“测试优先”软件文化的 AMD 不同,Google 拥有数十年的软件工程经验和极其成熟的以质量驱动的文化,因此我们预计外部 TPU 软件将快速走向成熟。
在本文中,我们将介绍针对开放权重模型的 TPU 内核和服务栈所做的全部优化,包括 DP attention 优化、MoE 路由与内核优化,以及减少 GDN 内核中的填充(padding)。我们还将深入剖析 TPU 系统,并讨论出色的 TPU 性能工程师们正在推进的下一步工作,目标是让这套软件栈得到广泛应用。
Google 用十多年时间展示了它能用 TPU 构建出什么。现在,轮到我们衡量业内其他厂商能用 TPU 做到什么了。
感谢 Google 的 Chris Chan、Jahangir Hasan、Wangyuan Zhang、Anne Stern、Puneith Kaul、Ruizi Dong、Sangam Jindal、Qi Zhou、Madhan Jaganathan、Gang Ji、Jun Wan、Devanshu Jain、Jiaxin Cao、Srinath Mandalapu、Haowen Ning,以及 Inferact 团队,感谢他们打造了这个出色的 TPU 基础和性能表现!同时也要感谢同样在开发 TorchTPU SGLang 的 RadixArk 团队。
InferenceX 官方预览:TPUv7 Ironwood 对决 Blackwell 与 Blackwell Ultra
在与 Nvidia GPU 的同规格对比测试中,即将推出的原生 TorchTPU vLLM 技术栈已经展现出强劲的表现。Google 正在使用 FP8 精度的 Qwen3.5 397B 作为初始适配模型。本文后面的章节将深入分析:对于外部的 TPU vLLM/SGLang 推理服务而言,为什么全新的 TorchTPU 方案相比之前的 TorchAX 路径是一项显著进步。
在这一基础打好之后,Google 计划将支持扩展到其他开放权重的模型,包括 Kimi K3 和 GLM5.3。我们相信,一旦对少数几个模型完成了充分优化,为大量热门开源模型在接近第 0 天就添加优化支持将变得容易得多。目前,vLLM 和 SGLang 的第 0 天支持集中在 Nvidia 上,对 AMD 也有尚可的第 0 天覆盖。我们预计,在不久的将来 TorchTPU 将足够稳定,vLLM 和 SGLang 的维护者可能会将 TPU 加入第 0 天支持列表。该技术栈预计将于 10 月左右结束私有测试阶段并开源。
在聚合式服务的同规格对比中(FP8 精度、单 token 预测),TPU 的每美元性能比运行 FP8 的 B200 和 B300 高出最多 50%。当在 NVIDIA GPU 上使用 FP4 精度提供推理服务时,相比 FP8 会有质量损失。TPUv7 不支持原生 FP4 计算,因此在 FP4 方面 NVIDIA GPU 仍保持领先。这一局面将随着支持原生 FP4 的 TPUv8i 而改变,我们坚信 TPUv8i Boardfly 将能够与 Rubin NVL72 一较高下。
我们相信,一旦 Google 启用分离式服务和投机解码,在对比双方都开启 MTP 和分离式服务的情况下,TPU 的每美元性能优势仍将保持。本文后续会讨论 Google 在 TorchTPU 基础打好之后计划添加的各项优化。为了控制适配初期的范围,Google 最初专注于 8k1k 基准测试。不过我们相信,TorchTPU 技术栈在智能体负载上同样会有出色的表现,今年晚些时候我们也会发布这方面的测试结果。本文稍后还会介绍 TPU 外部推理的下一步计划和路线图。
TPU 在每美元性能上称王
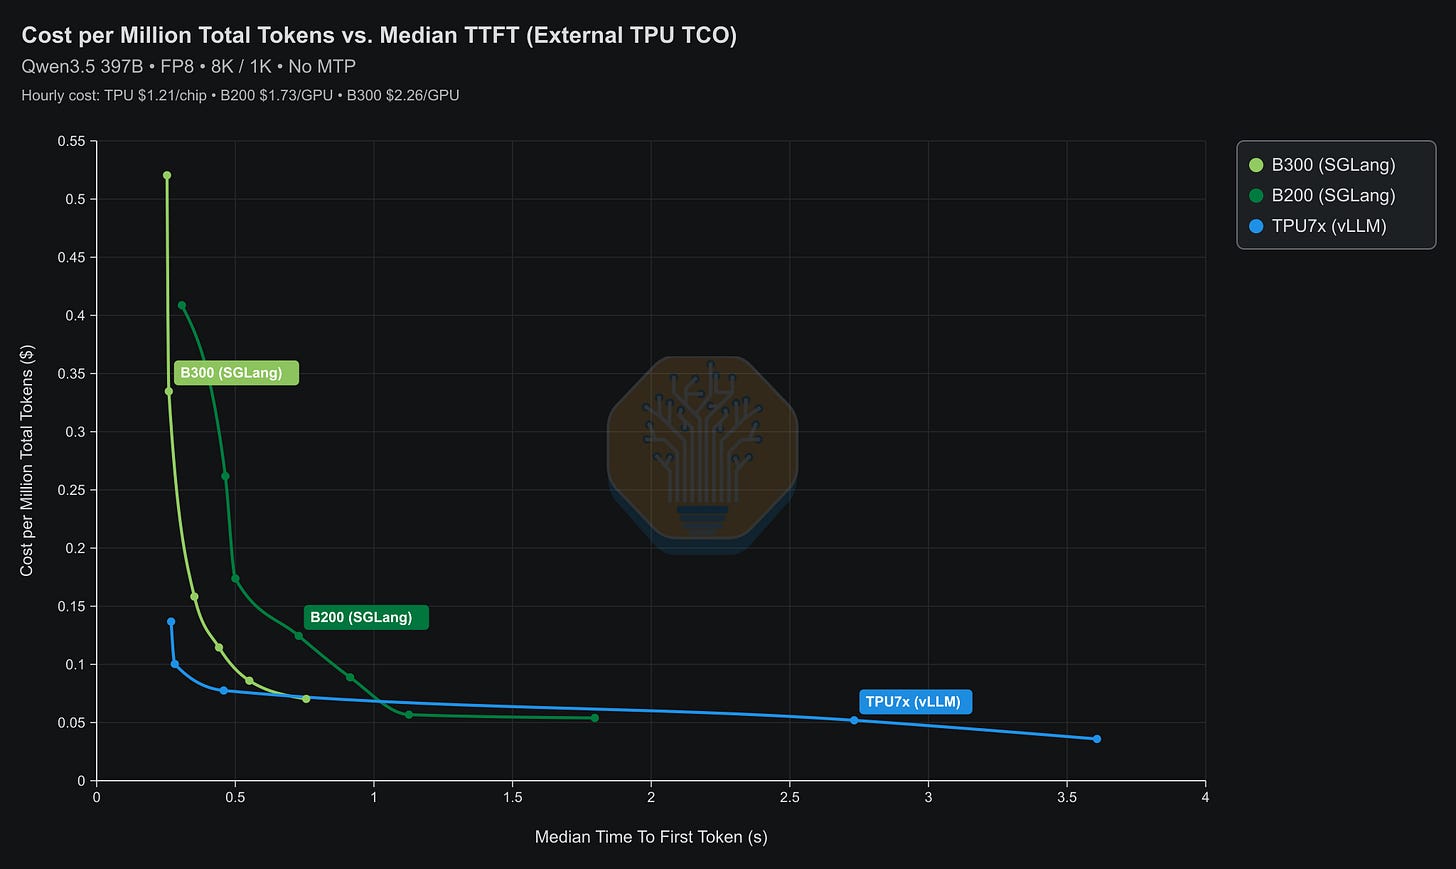
在每用户 100 tokens/s 的交互性水平下,Ironwood 处理每百万总 token 的成本约为 0.181 美元,而 B200 为 0.222 美元,B300 为 0.276 美元。也就是说,在提供相同的单用户生成速度的前提下,成本比 B200 低约 19%,比 B300 低 34%。
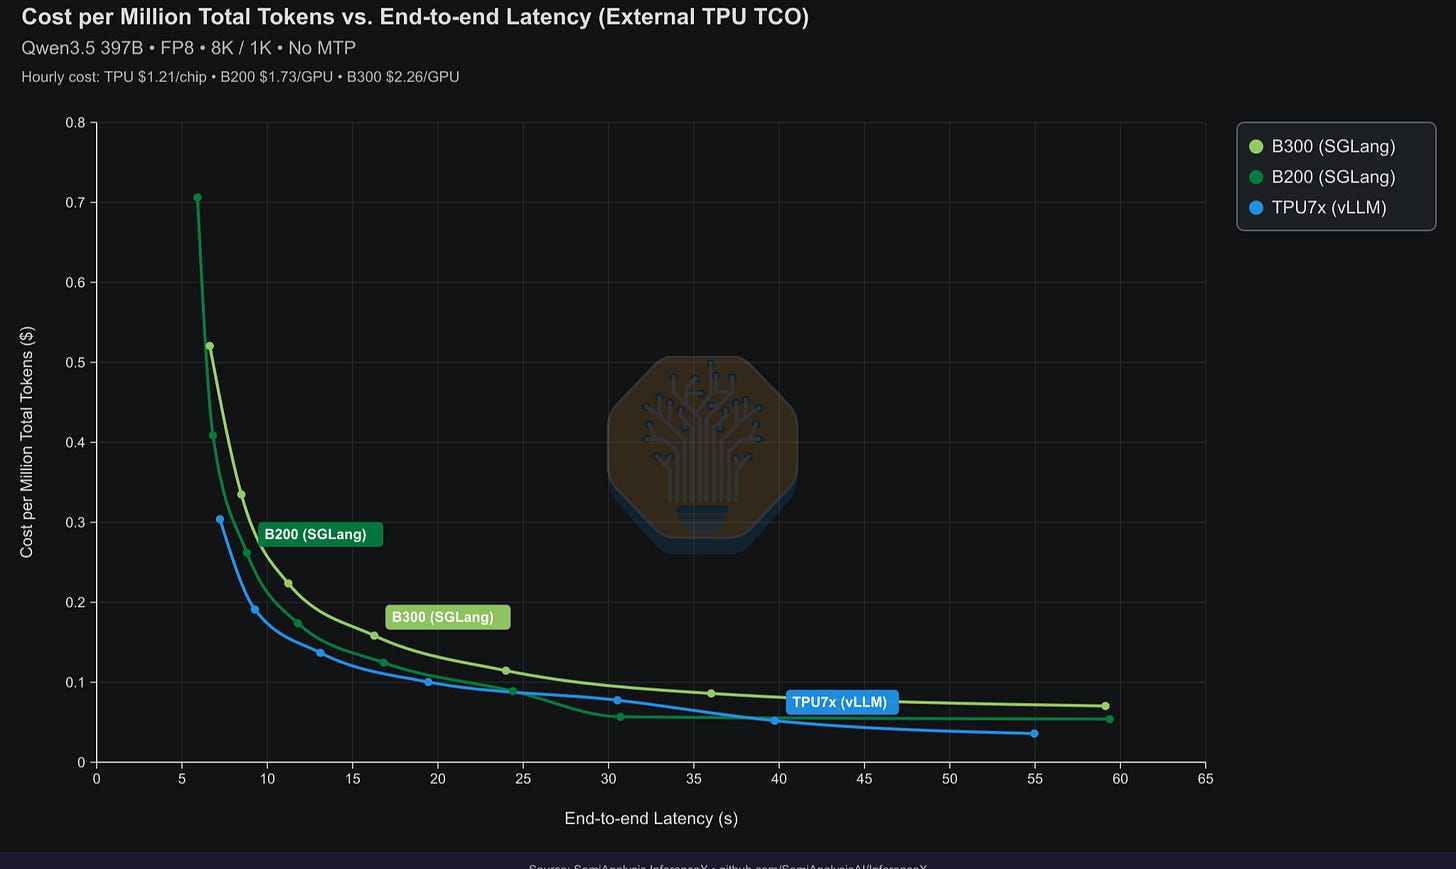
在本次对比中,我们使用外部 TPU 的 TCO 与超大规模实验室采购 TPU 时 B200/B300 的 TCO 进行比较。去年,SemiAnalysis 加速器模型率先披露了 Google 正在对外出售 TPU,而不仅仅是通过 Google Cloud 出租。TPU 更低的小时成本在大部分交互性区间内抵消了其较低的吞吐量。SemiAnalysis TCO 模型提供了 TPU BoM 估算和 TCO 估算的完整细分。
Source: SemiAnalysis InferenceX Preview
Source: InferenceX Preview
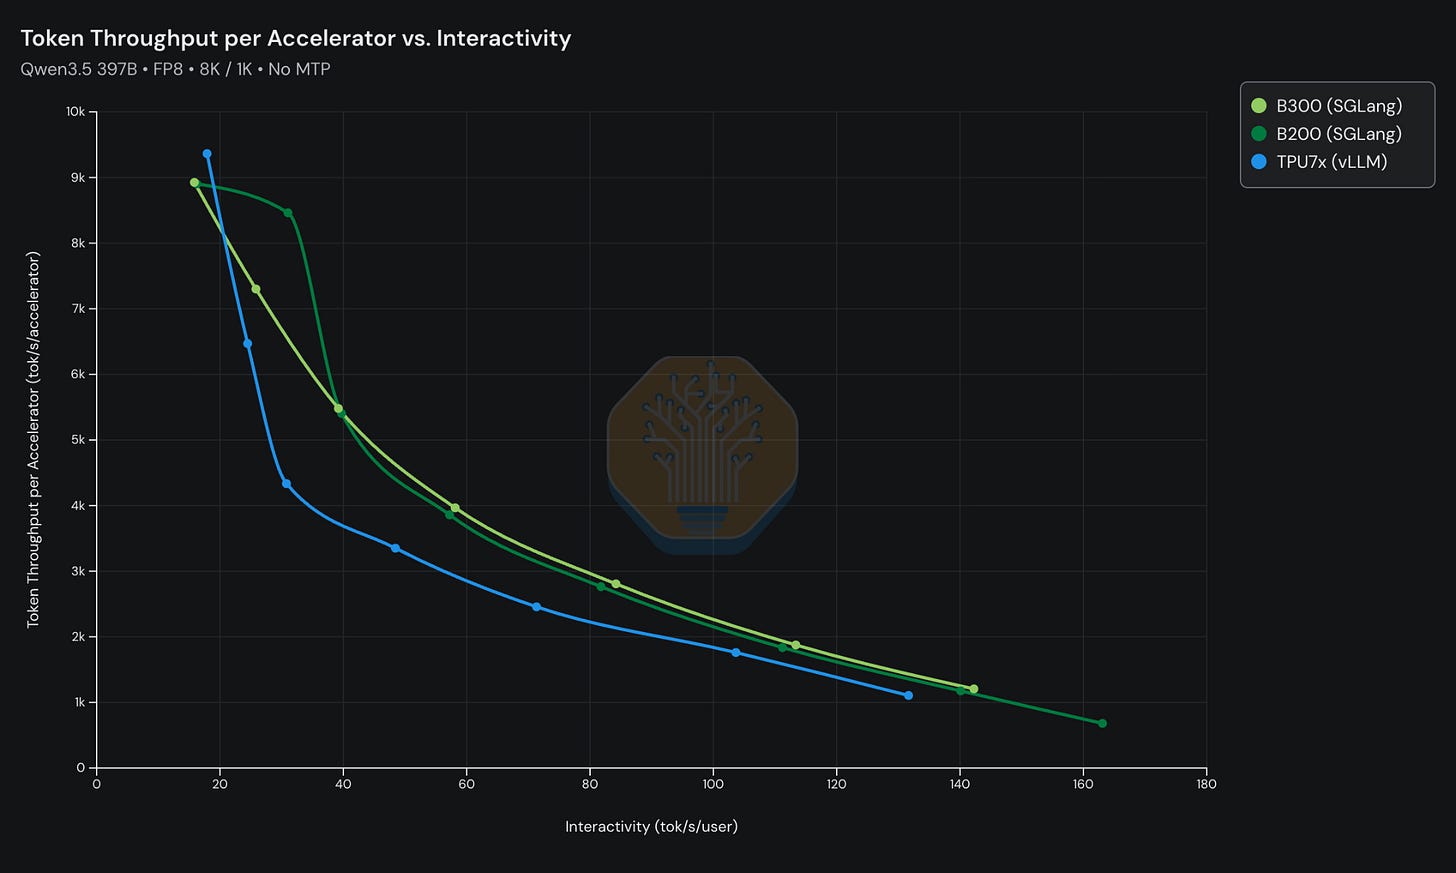
在大部分原始性能曲线上,TPU 并没有超越 Nvidia GPU。不过,这一对比并未考虑 TPU 更低的 TCO。TPU 的买家主要关心的是他们能创造多少收入,也就是每美元性能和每瓦特性能。
话虽如此,在交互性为 20 tok/s/user 时,Ironwood 在原始吞吐量上也处于领先,达到每芯片总计 9,364 tokens/s,而 B200 为 8,903,B300 为 8,925。这比这两款 GPU 在这些测试中的吞吐量高出约 5%。结合更低的建模小时成本,Ironwood 每美元产出的 token 比 B200 多 50.4%,比 B300 多 96.0%。
Source: SemiAnalysis InferenceX Preview
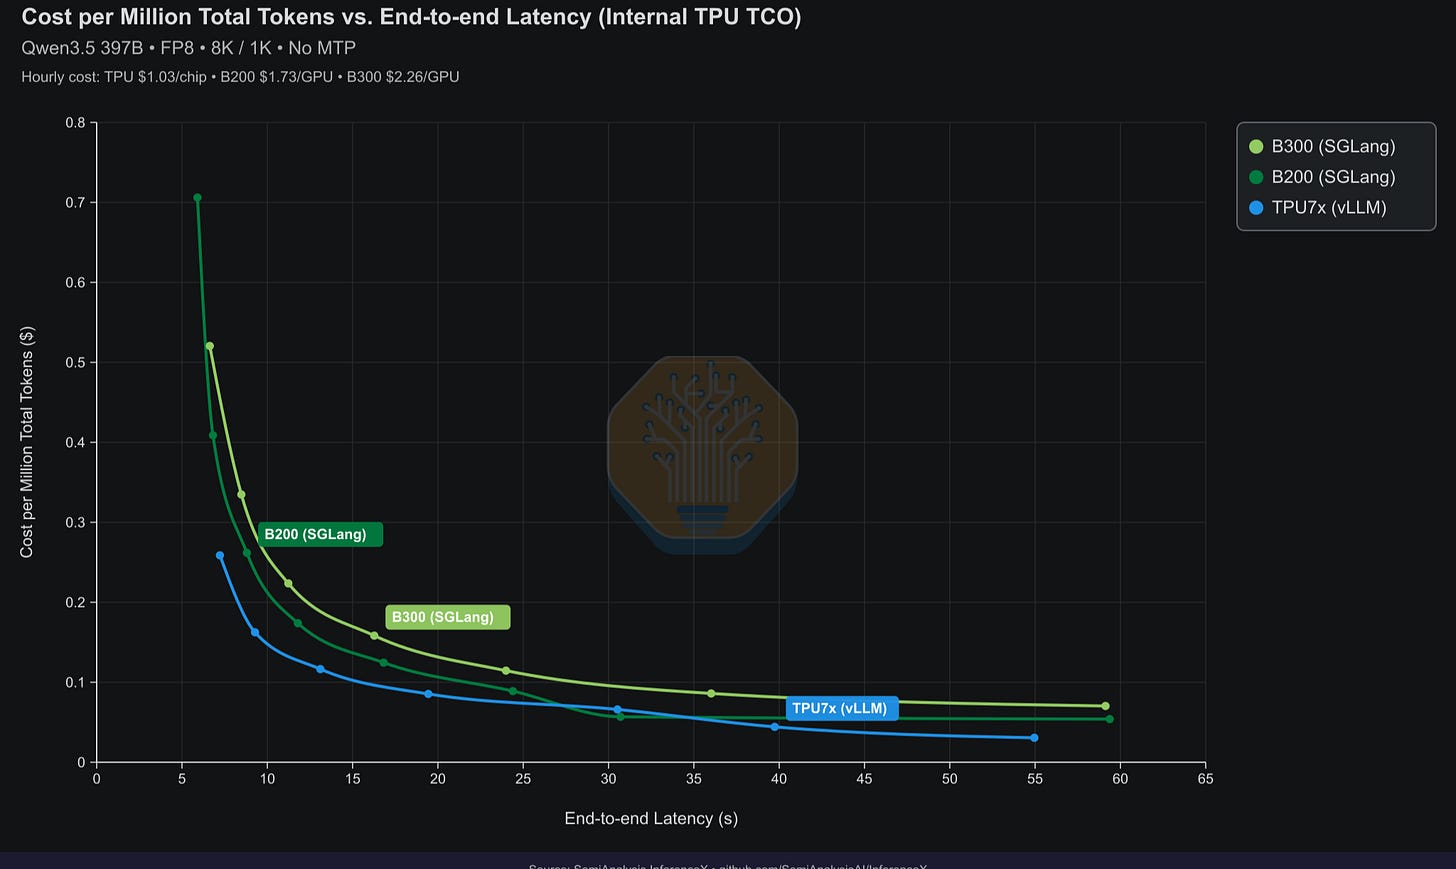
如果我们考虑 Google 内部工作负载的 TPU TCO,即每芯片小时 $1.03,那么在并发度 256 时,每美元性能优势相对 B200 扩大到 76.7%,相对 B300 扩大到 130.2%。然而,这些高并发结果伴随着延迟上的权衡。例如,在并发度 256 时,TPU 的平均 TTFT 为 5.41 秒,而 B200 为 3.75 秒,B300 为 2.40 秒。前文讨论的 50% 到 96% 的优势专门适用于这个数据点,而不是每一个延迟目标。
Source: SemiAnalysis InferenceX Preview
从端到端延迟来看,Ironwood 在最高吞吐量点之后仍具竞争力。在 20 秒的中位响应时间下,Pareto 曲线显示 TPU 每百万总 token 的成本约为 $0.098,而 B200 为 $0.106,B300 为 $0.132。因此,TPU 的成本比 B200 低约 8%,比 B300 低约 25%。
Source: SemiAnalysis InferenceX Preview
Source: SemiAnalysis InferenceX Preview
尽管有上述种种结果,在 Apples to Apples 曲线的一小段区间内,B200 仍然可以胜出,包括在 30 秒中位响应时间附近。然而,在更长的响应时间下,TPU 会重新夺回每百万 token 成本更低的优势,同时在图中所示的重叠区间内保持相对 B300 的成本优势。
SemiAnalysis 是一份读者支持的出版物。如需接收新文章并支持我们的工作,请考虑成为订阅者。
Apples to Bananas:GB300 NVL72 分离式架构对比 TPUv7 聚合式架构
Google 内部已在生产环境中运行分离式推理(disaggregated serving)多年,这条技术路线经过了深度优化,但对外的 TPU 推理服务栈尚未拥有完全优化的分离式路径。因此,目前在进行“分离式对分离式”的对比时,GB200/300 NVL72 在性价比(perf per dollar)上更具竞争力。不过,我们预计这一差距将在几个月内缩小。随着 Google、Inferact、RadixArk 和 SemiAnalysis 陆续落地各项优化,TPUv7 将重新具备与 GB200/300 NVL72 竞争的实力,我们也会在后续文章中发布 TPUv7 分离式与 GB200/300 NVL72 分离式的对比结果。TPUv7 Pod 可以通过低延迟的 ICI 互连网络扩展到 1000+ 芯片以上,因此可以实现 NVIDIA NVL72 无法做到的大模型分离式和超宽 EP(ultra wideEP)等优化。
即使是拿 TPUv7 聚合式服务(aggregated serving)与 GB300 NVL72 分离式服务这种不对等的比较,采用内部 TCO 数据来看,TPUv7 在高延迟以及中低延迟区间仍具备相当的竞争力。但在中高 e2e 延迟区间,GB300 NVL72 分离式服务相比 TPUv7 聚合式服务拥有一项单独的优势。
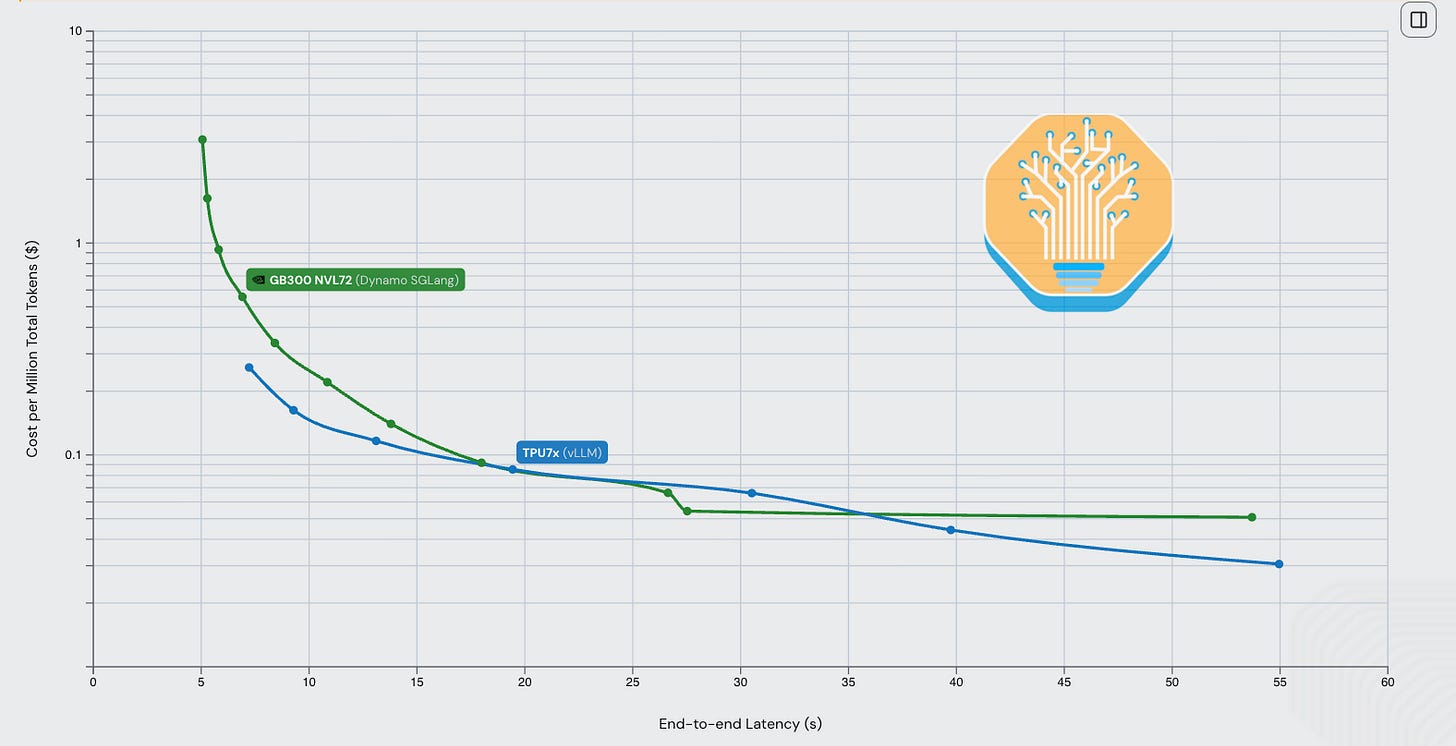
Source: SemiAnalysis
具体来看 GB300 NVL72 分离式与 TPUv7 聚合式的对比:在低延迟和高 e2e 延迟区间,两者具备竞争力;但在中间区间,GB300 相比 TPUv7 聚合式约有 30% 的性价比优势。我们坚信,一旦 TPUv7 上的分离式服务完成优化,它将在整条 Pareto 前沿上与 GB300 NVL72 全面抗衡。
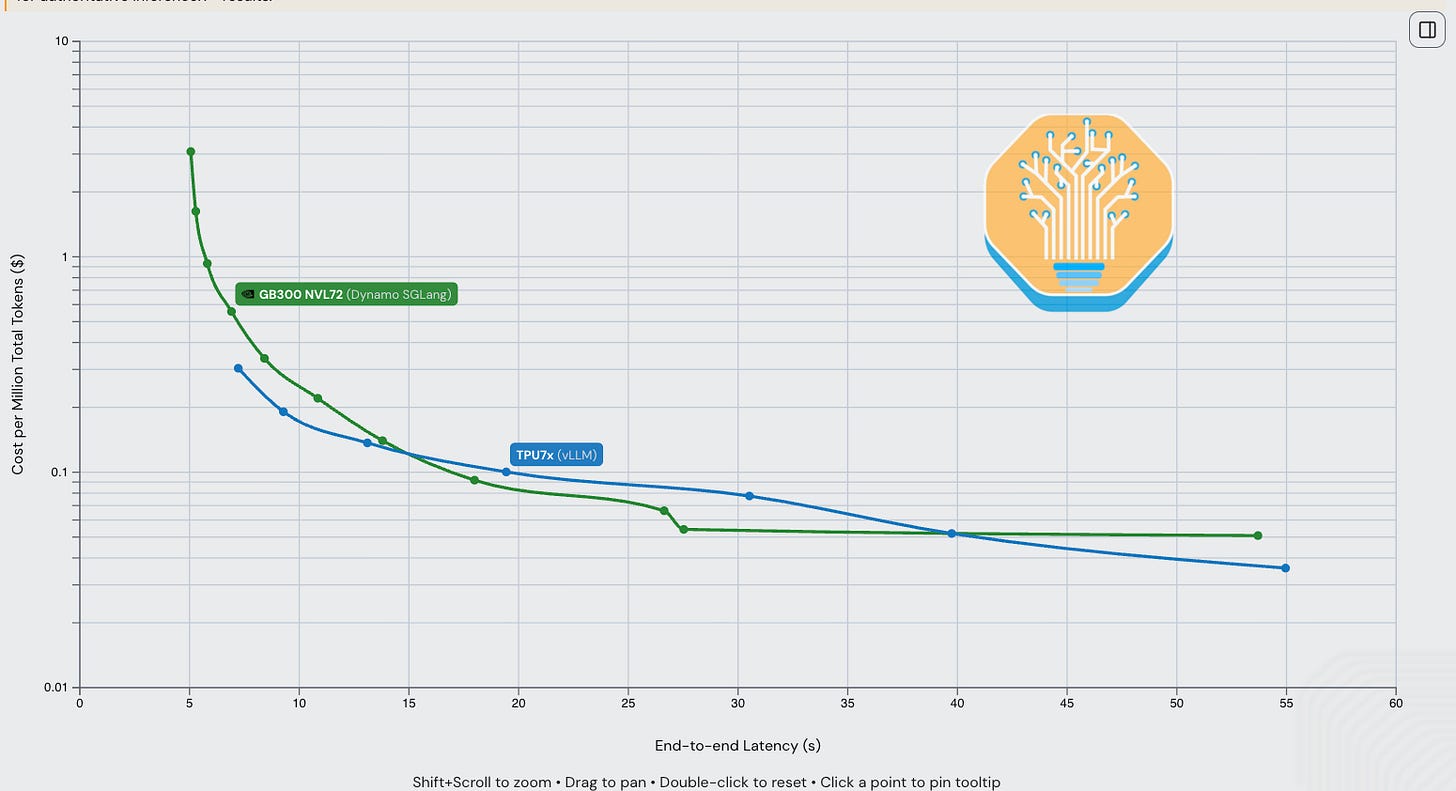
Source: SemiAnalysis
使用全新原生、一等公民 TorchTPU 后端进行推理服务 vs. 之前的 TorchAX 技术栈
之前的 TorchAX vLLM 后端
Google 此前使用 TorchAX 后端,将 vLLM 和 SGLang 中基于 PyTorch 的实现翻译为 JAX。TorchAX 的初衷是让开发者能够通过 JAX 运行 PyTorch 模型定义。然而,这一方案存在的问题促使 Google 与 PyTorch、vLLM 及 SGLang 社区合作,推出了名为 TorchTPU 的新方案。它允许开发者将 TPU 作为原生 PyTorch 设备使用,而 StableHLO、XLA 以及面向 TPU 优化的 Pallas 内核则在幕后负责底层执行。在接下来的章节中,我们将展示这个全新 TorchTPU 后端与 NVIDIA Blackwell 及 Blackwell Ultra GPU 的性能对比。
vLLM 的 TPU 支持经历了三个不同的阶段:
- 第一个 TPU 原型使用 PyTorch/XLA。其惰性执行模型(lazy execution model)将各个操作收集为计算图,交给 XLA 编译,而不是立即执行每个 PyTorch 操作。
- 当前公开的后端 tpu-inference 在有 TPU 优化的 JAX 实现可用时会优先使用;否则,由 TorchAX 将原始 PyTorch 模型翻译为 JAX 可执行的操作。其目标是复用成熟的 TPU 原语和并行支持,而无需重写每一个 PyTorch 模型。
- 即将推出的第三种设计 TorchTPU,允许 vLLM 将 TPU 作为原生 PyTorch 设备使用。它将成为未来 SGLang 和 vLLM 在 TPU 上的首选后端。
下图放大展示了第二阶段,说明了 vLLM 的 tpu-inference 后端如何将直接的 JAX 模型与通过 TorchAX 运行的 PyTorch 模型结合起来。
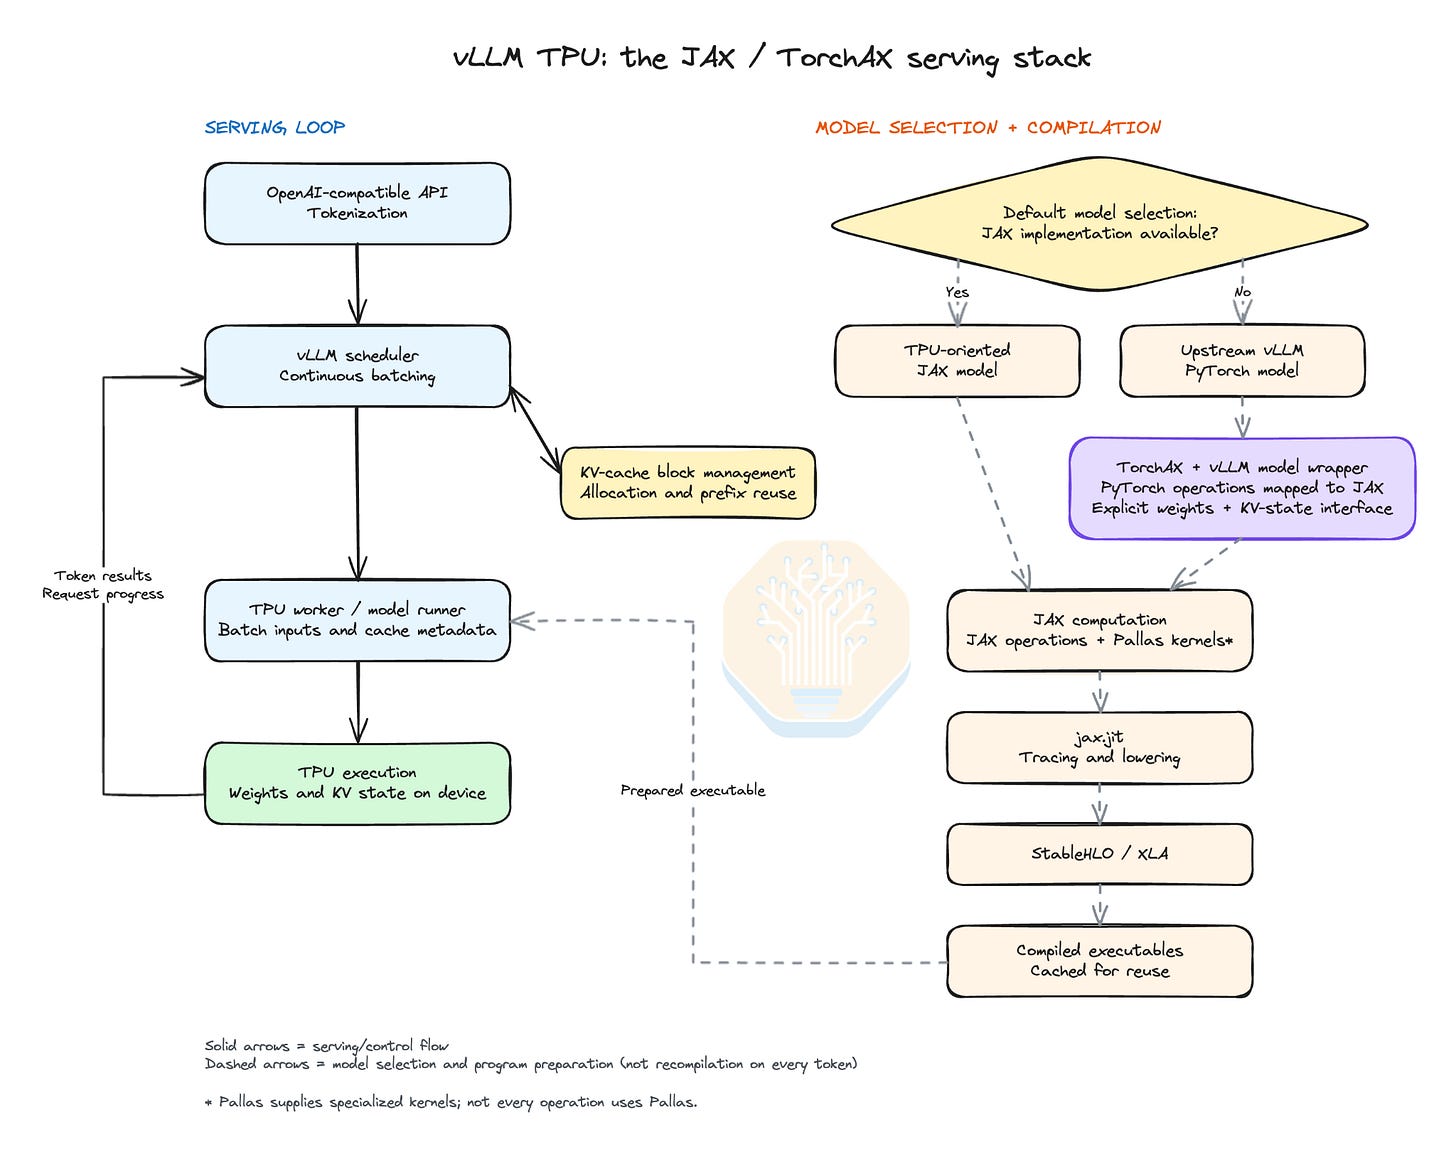
Source: SemiAnalysis/vLLM
最初选择 JAX 是出于务实的考虑。在上一次公告中,Google 描述了在底层优化、分页注意力(paged attention)以及让 vLLM 的 worker 模型适配 TPU 执行方面遇到的困难。他们认为 JAX 能提供更成熟的 TPU 原语和并行支持。TorchAX 让团队无需重写每一个 PyTorch 模型就能利用这些能力,同时面向 TPU 的 JAX 实现也可以共享相同的内核和编译器工作。
使用 TorchAX 时,开发者仍然用 PyTorch 编写模型,但由 JAX 在 TPU 上执行。TorchAX 充当两个框架之间的转换层。正如 TorchAX 文档所解释的,torchax.tensor.Tensor 的行为与普通的 PyTorch 张量一样,但其底层由 jax.Array 支撑。当模型调用一个张量操作(在 PyTorch 中称为 ATen 操作)时,TorchAX 会通过 __torch_dispatch__ 钩子拦截它,并将其转换为一个或多个 JAX 操作。因此,即使计算由 JAX 完成,模型仍可以保持用 PyTorch 编写。
vLLM 还必须管理在生成过程中不断变化的状态,尤其是 KV 缓存,它存储来自先前 token 的注意力信息以便复用。vLLM 的模型包装器将模型权重和 KV 缓存以显式状态的形式呈现给 JAX。这个过程称为函数化(functionalization),它把原本发生在 Python 对象内部的变化转换为编译器能够追踪的输入和输出。然后 jax.jit 可以将每个推理步骤捕获为计算图,并送入 JAX 的编译流水线以供重复执行。
在此之后,每个组件都有明确的分工。Pallas 为性能关键的操作提供经过优化的 TPU 内核。StableHLO 以编译器可以处理的标准化格式表示程序,XLA 则将其转换为可在 TPU 上执行的代码。在 vLLM 的标准 PyTorch 路径中,torch.compile 负责协调图捕获和编译。而在 TorchAX 路径中,JAX/XLA 流水线已经完成了这些任务,因此 vLLM 会绕过常规的 torch.compile 路线。这些转换层曾引发许多问题,而 TorchTPU vLLM 技术栈正是旨在解决这些问题。
之前的 SGLang JAX 后端
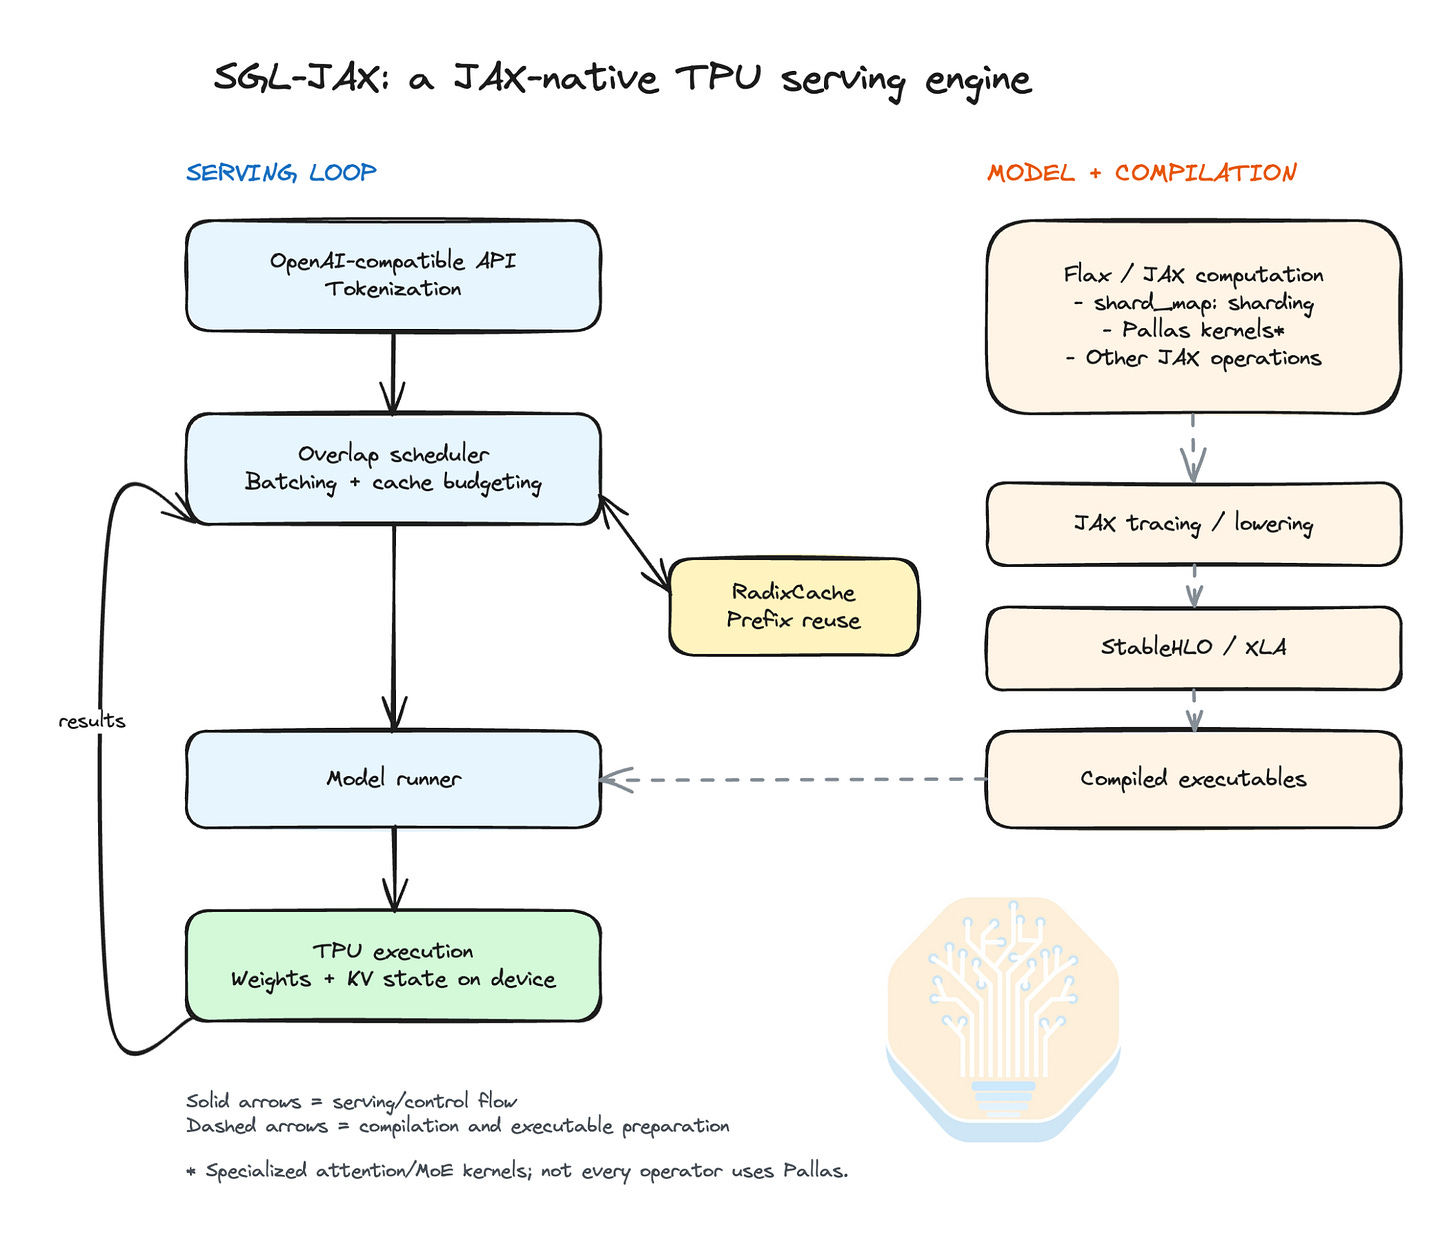
Source: SemiAnalysis/SGLang
SGLang 目前公开的 TPU 技术栈使用 SGLang-JAX。SGLang-JAX 做出了与 vLLM 的 TorchAX 后端类似的权衡,但采用了不同的方式。它不是通过 TorchAX 转换的 PyTorch 版 SGLang 运行时,而是一个独立的 JAX 原生服务引擎。它将 SGLang 风格的调度和前缀缓存与 JAX 模型及 TPU 专用内核相结合。Google 和 RadixArk 已宣布将 SGL-torchtpu 作为一个额外的 PyTorch 原生后端,以扩展可用的服务路径。
转向新的原生一等公民 TorchTPU 后端
TorchTPU 将框架边界移入 PyTorch 本身。它利用 PyTorch 的 PrivateUse1 后端扩展点,在 device="tpu" 上暴露一个普通的 torch.Tensor,而不是由 JAX 数组支撑的包装器。PyTorch 的 dispatcher 会将 ATen 操作路由到 TPU 后端。开发者可以以 eager 模式运行代码来进行调通和调试,也可以调用 torch.compile 进行图捕获。在编译路径中,TorchDynamo 和 AOTAutograd 生成 FX 图,TorchTPU 将其 lowering 到 StableHLO,再由 XLA 生成 TPU 可执行文件。Google 的会议幻灯片明确说明了编译器的选择:这条路径使用 XLA,而不是 Inductor 和 Triton。
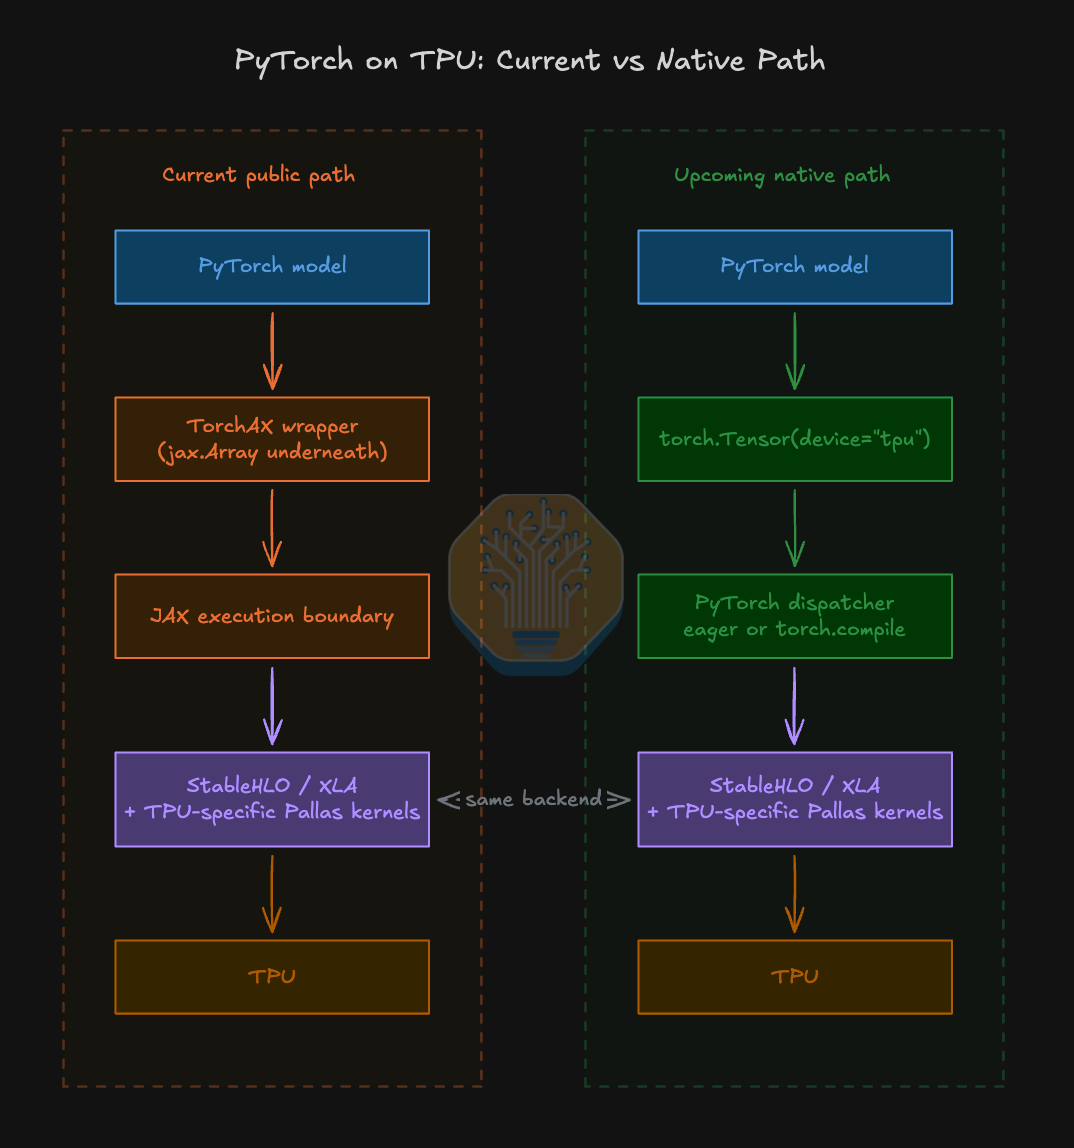
Source: SemiAnalysis/PyTorch/Google
因此「原生」有一个明确的范围。它涵盖 PyTorch 张量、分发(dispatch)、eager 执行、编译入口以及分布式 API。XLA 仍然是编译器,kernel 层继续使用 TPU 特定的实现。TorchTPU 可以调用 Pallas 和基于 JAX 的自定义 kernel。Helion 的 TPU 后端也会生成 Pallas。面向用户的框架变成了 PyTorch 原生的,而编译器和性能关键型 kernel 仍然保持对 TPU 的针对性。
开发者可以使用 .to("tpu"),同时保留熟悉的分布式接口和服务引擎代码。Google 的文档说明支持 DDP、FSDP2、DTensor、每设备一个进程(one process per device),以及 MPMD 和 SPMD 两种执行模式。这些接口与 PyTorch 服务引擎已经采用的进程和分布式模型相契合。
对 vLLM 和 SGLang 而言,机会在于可以复用更多上游的模型代码、调度器、continuous batching、API 和特性逻辑,而不必跨越 PyTorch 到 JAX 的边界重新构建它们。即便最终的 TPU 实现仍然需要专门的 kernel,这也能降低模型和引擎特性的调通成本。
原生的 PyTorch 支持并不能消除对 TPU 特定优化的需求。Pallas 和 TorchAX 的用途不同:TorchAX 允许 PyTorch 模型代码通过 JAX 执行,而 Pallas 用于直接为 TPU 硬件实现性能关键的操作。移除 TorchAX 并不意味着移除其底层的 Pallas kernel。由于 TorchTPU 允许原生 PyTorch 代码调用 Pallas 和 JAX kernel,为早期技术栈开发的 kernel 可以迁移到新的技术栈中。
与 GPU 版 PyTorch vLLM 类似,要实现高性能推理,仍然需要自定义 kernel。张量形状和布局仍需调优,以便高效利用 TPU 的矩阵乘法单元。我们相信,大多数现有的 Pallas kernel 可以轻松迁移到新的原生 TorchTPU 服务技术栈,但这并不意味着每个现有 kernel 都能原封不动地迁移过来。诸如包装器、张量布局和运行时集成等许多方面,可能仍需要稍作适配和验证。
与 Google TPU 团队的深度生态合作
vLLM 和 SGLang 是两大主流的开源生产级推理服务框架。Inferact、RadixArk 和 Red Hat 正在与 Google 深度合作,致力于让 TorchTPU 后端在这两个框架中都获得一流的使用体验。这种社区支持对于 TPU 推理的外部推广极为重要。
Source: Inferact
截至 9 月初,TorchTPU 仍处于私有测试阶段,预计在 10 月中旬的 PyTorch Conference 期间开源。我们很高兴看到它将 TPU 在 PyTorch、vLLM 和 SGLang 中推向一流体验。一旦 TorchTPU vLLM 和 TorchTPU SGLang 完成开源,我们会将 InferenceX/AgentX 的 TPU 基准测试从我们的 fork 分支迁移到公开仓库中。
Source: RadixArk
TPU 推理优化深度解析
为了优化原生 TorchTPU 服务栈的首个适配模型在 TPU 上的推理性能,我们投入了数百小时的工程时间和大量 PR。正如文章后文所述,TPU 架构与 GPU 架构存在差异,因此需要一套专属的优化方案才能高效运行模型。下文将介绍那些提升(或在某些情况下是使能)Qwen3.5-397B 及其他模型在 Ironwood 上性能的优化措施。其中大部分 Pallas 内核优化都可以迁移到新的原生 TorchTPU 技术栈中。
DP Attention 优化
有一个问题并非 TPU 特有,那就是如何将模型架构的并行性有效映射到硬件上。以 Qwen3.5 的 GQA 注意力层为例,它有 32 个 query 头,但只有 2 个共享 KV 头。在 TP8(8 个逻辑设备)下,query 计算可以均匀分配到 8 个设备上,每个设备处理 4 个 query 头。然而,KV 头无法在这些设备间均匀划分。每个 KV 头被 16 个 query 头共享,这意味着 4 个设备需要相同的 KV 数据来计算各自的局部注意力。当 TP 数量超过 KV 头数量时,标准做法是在各个 TP rank 之间复制 KV 头。vLLM 已经支持这一机制,TPU 后端只需一个兼容性修复即可启用该现有行为,避免不必要的 All-to-All 通信。
针对更高并发度的服务场景,TPU 后端还新增了对八路注意力数据并行(DP8)与八路专家并行(EP8)组合的支持,简称“DP attention”或 DEP8。这种方案不再将每个请求的注意力计算拆分到全部 8 个设备上,而是让每个设备处理不同的请求子集,并将这些请求的两个 KV 头都保留在本地。注意力权重会被复制,但 KV 缓存中保存的是不同请求的历史记录,而不是同一份历史记录的重复副本。与此同时,512 个路由专家仍然分布在各设备之间,避免了复制规模大得多的专家权重池。要实现这一方案,需要在服务引擎中协调请求分配、循环状态槽位(recurrent-state slots)以及块表(block tables)。
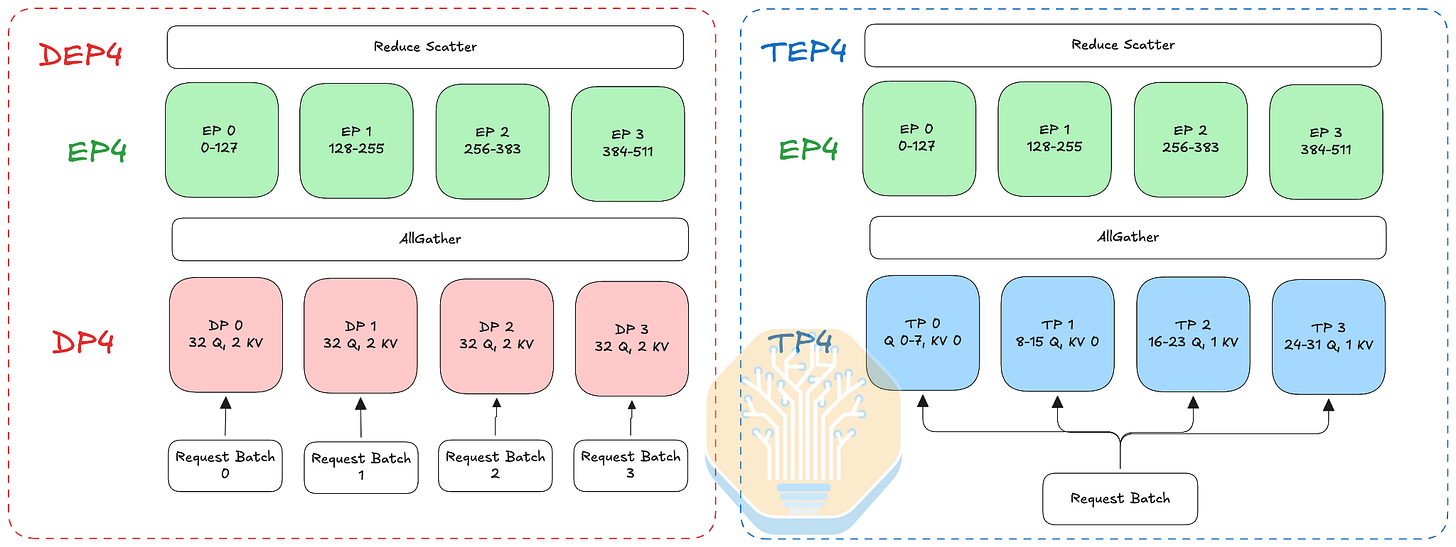
Source: SemiAnalysis
通信优化
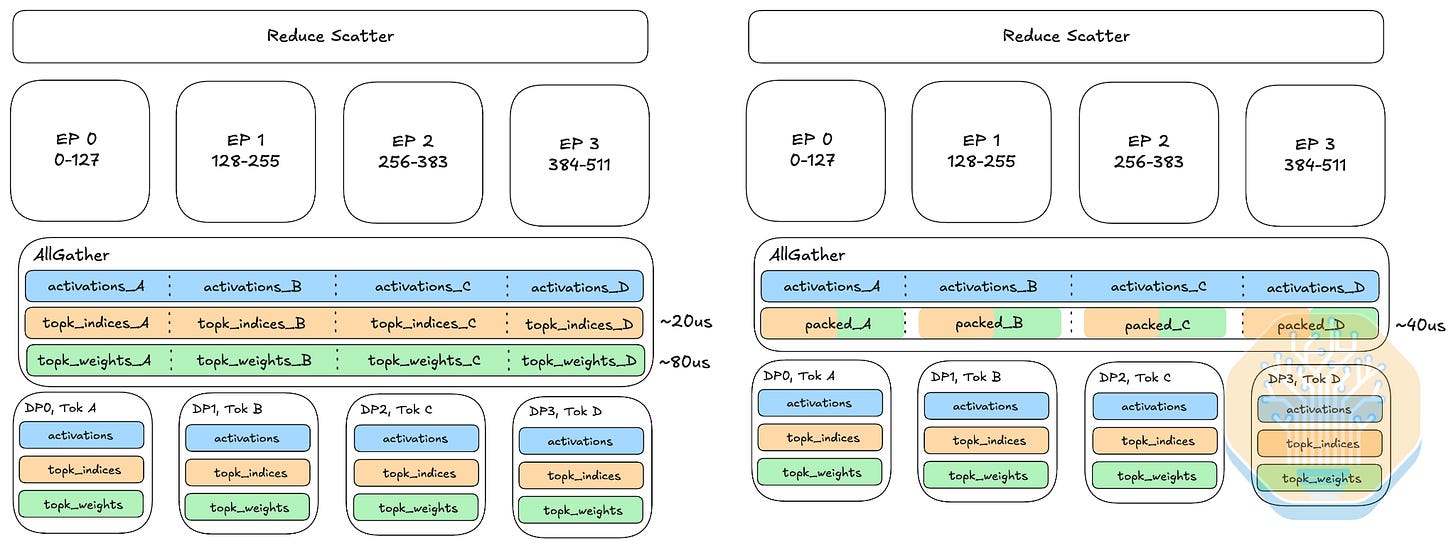
在采用 DP attention 和 EP 的情况下,TPU 的 GroupedGEMM 实现会在专家运行前 all-gather(全收集)token 激活值和路由元数据,然后使用 reduce-scatter(规约分发)对加权输出求和,并将每个 token 的结果返回给其对应的 attention rank。该后端最初分别收集所选专家的 ID 和路由权重。Google 将二者合并为一次 all-gather,从而省去了一次额外的集合通信——对于这么小的数组,这次通信的延迟可能主导整个传输时间。该 PR 报告称,在 DeepSeek-V3 的测量中每层可节省约 80 微秒。80 µs 听起来虽小,但 DeepSeek-V3/R1 有 58 层都需要执行这个 AllGather。跨所有层累计,仅此一项每次前向传播(forward pass)就能节省约 4.64 ms(80 µs × 58),从而降低 TPOT、提升交互性。
Source: SemiAnalysis
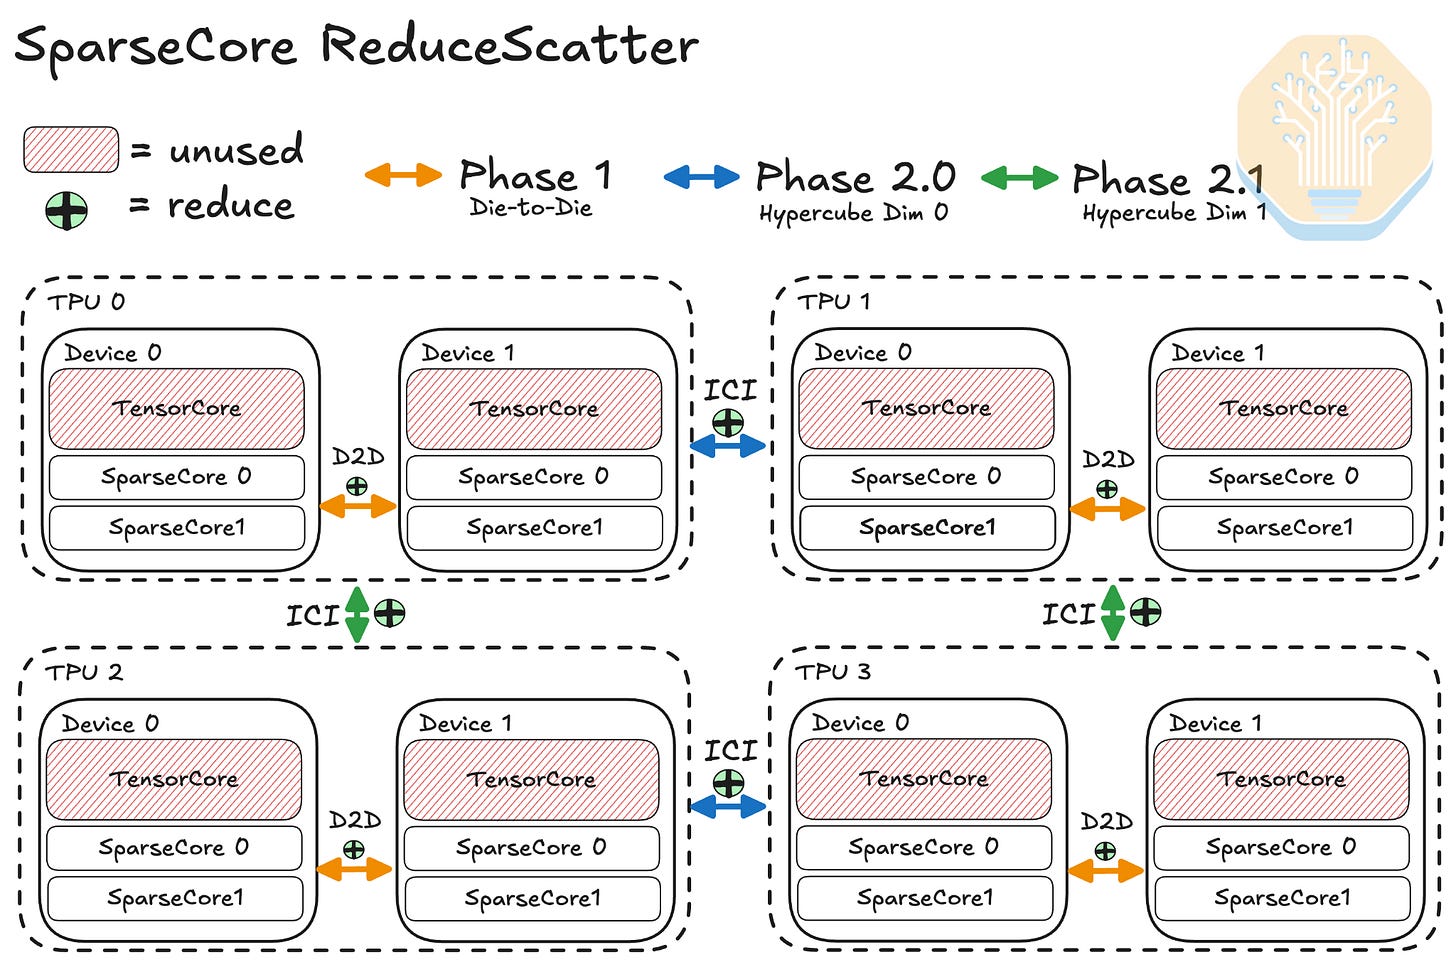
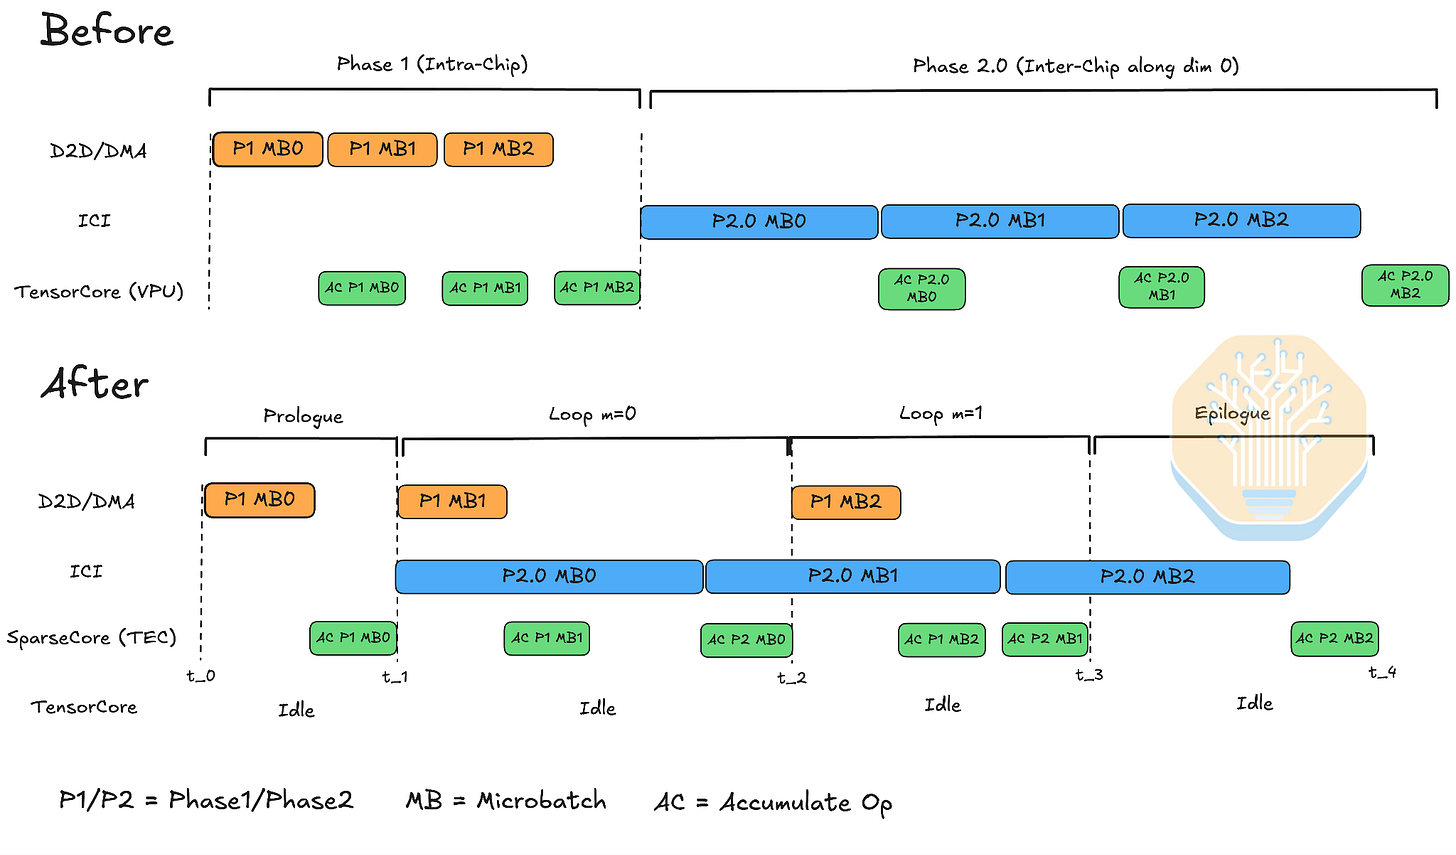
Google 还在 SparseCore 上实现了 ReduceScatter 集合通信(SparseCore 更适合数据搬运这类不规则操作),并利用 Ironwood 更快的 die-to-die(裸片间)链路,先在每个芯片内部合并各份贡献,再跨芯片交换部分和。这种每芯片双设备(two-device-per-chip)的布局以及芯片间的 ICI 网络将在下一节介绍。通过双缓冲(double buffering),内核可以在累加一个数据块的同时传输另一个数据块,使本地规约和 die-to-die 传输与较慢的芯片间流量相互重叠。在 SparseCore 上运行该集合通信还能释放 TensorCore,使其可以执行其他操作。
Source: SemiAnalysis
Source: Google and SemiAnalysis
在上图中,各个通信阶段相互重叠,从而缩短了端到端执行时间。以标记为 t_1 的时间点为例:此时,MB(microbatch,微批次)1 的芯片内 DMA ScatterReduce(P1)已完成。MB0 的跨 ICI 维度 0 的 ScatterReduce(P2.0)此时可以执行,同时后续 MB 的 P1 也可以并发进行。与基线相比,该优化在并发度 64 到 512 范围内使 8k1k 的吞吐量提升 4.1% 到 14.2%(其中并发度 256 时为 8.5%),并在并发度 512 时使 1k8k 的吞吐量提升 26.1%。
感谢阅读 SemiAnalysis!本文为公开文章,欢迎分享。
分享
将这一集合通信从 TensorCore 迁移到 SparseCore,还意味着在集合通信运行期间,TensorCore 上可以流水线化地执行其他工作。但并非所有集合通信都值得迁移。在某些情况下,将集合通信卸载到 SparseCore 反而会降低性能。例如,对于 Qwen3.5,现在采用一个阈值来决定何时将 all-reduce 和 all-gather 操作卸载到 SparseCore:当规模较小的集合通信能放入 VMEM、且卸载到 SparseCore 的开销反而会让它变慢时,就保留在 TensorCore 上执行。默认阈值由 VMEM 容量推导得出。该 PR 报告称,8k1k 吞吐量在并发度 64 时提升 2.7%,在并发度 128 时提升 5.7%。
优化 MoE 路由与专家内核
混合专家(MoE)层会为每个专家产生不规则的 token 分组,这些参差不齐的分组必须被重新整理成 TPU 矩阵单元能够高效处理的形式。下文中的部分改动是对路由和分组矩阵乘(grouped-matmul)后端的一般性改进,任何 MoE 模型都能从中受益。另一些改动则是在 Qwen3.5 上直接测量的结果。
SemiAnalysis 是一份依靠读者支持的出版物。若想接收新文章并支持我们的工作,欢迎成为免费或付费订阅者。
第二版分组矩阵乘(grouped matmul)重构了专家输入馈送到 MXU 的方式。它消除了冗余的 tile 计算;传输大小按有效行数而非填充后的最大值来确定;对专家权重采用三重缓冲,使下一组的权重在当前组计算时已经在传输中;并将组元数据生成融合进内核。
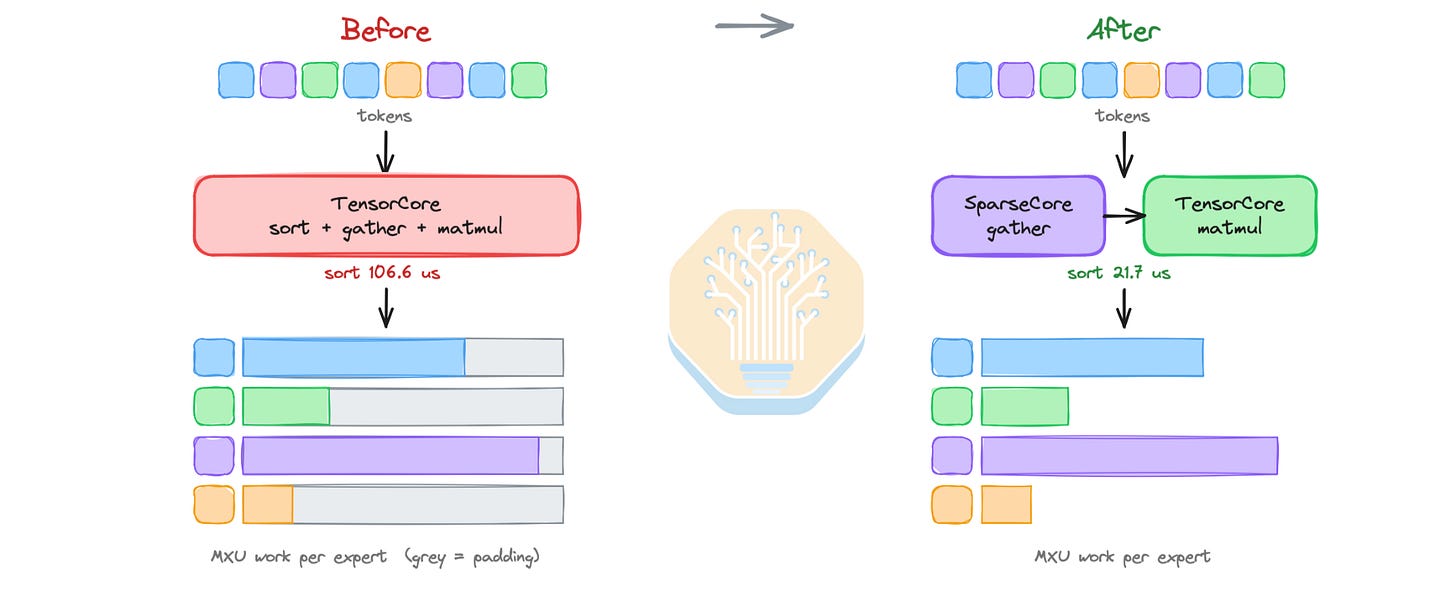
随后,专家输入的不规则重排被迁移到了 SparseCore 上。SparseCore 负责数据搬运,将每个专家的 token 聚集为连续的分组,而 TensorCore 则专注于执行专家矩阵乘法。后续的一次重写改进了内存读取流水线,并将合并(combine)工作按 token 和隐藏维度进行拆分。该 PR 报告称,与最初的 SparseCore 内核相比,8k1k 服务吞吐量提升了 12%,同时 TTFT 和 TPOT 也有所降低。
Source: SemiAnalysis
另一项优化将 ragged gather-reduce 路径中的 top-k 权重收集迁移到了 SparseCore 上。这里的 gather 是指从同一设备上的内存中读取选定的条目,而不是跨设备的 all-gather。此前,TensorCore 在预处理阶段收集路由权重和源索引,这限制了 TensorCore 与 SparseCore 的重叠执行。将这些 gather 操作移入 SparseCore 内核后,在 DeepSeek-V3 微基准测试(batch 为 2k、16 路专家并行)中,TensorCore 开销从 29 µs 降至 14 µs,整体操作延迟从 146 µs 降至 137 µs。
对于小 batch,通用 ragged 路径的开销超过了它所整理的工作本身。因此,一种专用的小 batch 置换方案会构建 one-hot 矩阵,并使用普通矩阵乘法将 token 置换到对应的专家,再对结果进行逆置换。在 8k1k 工作负载上,该方案在并发 64 时将吞吐量提升了 7.3%,在并发 128 时提升了 5.1%。
一项进行中的(WIP)改动将专家 ID 和 token 索引打包成单个排序键,这样 XLA 只需执行更简单的排序,同时又能保留所需的顺序。排序延迟从 106.6 µs 降至 21.7 µs。该 PR 报告称 8k1k 服务吞吐量提升了 0.6% 到 8.5%,而且同一改动还启用了 FP8 all-gather。
优化 Gated DeltaNet Pallas 内核
Gated DeltaNet(GDN)是一种循环计算。也就是说,在每一步中,运行状态会被衰减,用一个秩一项更新,然后被投影以产生输出。想要深入了解 GDN 等线性注意力机制,请参阅以下文章:
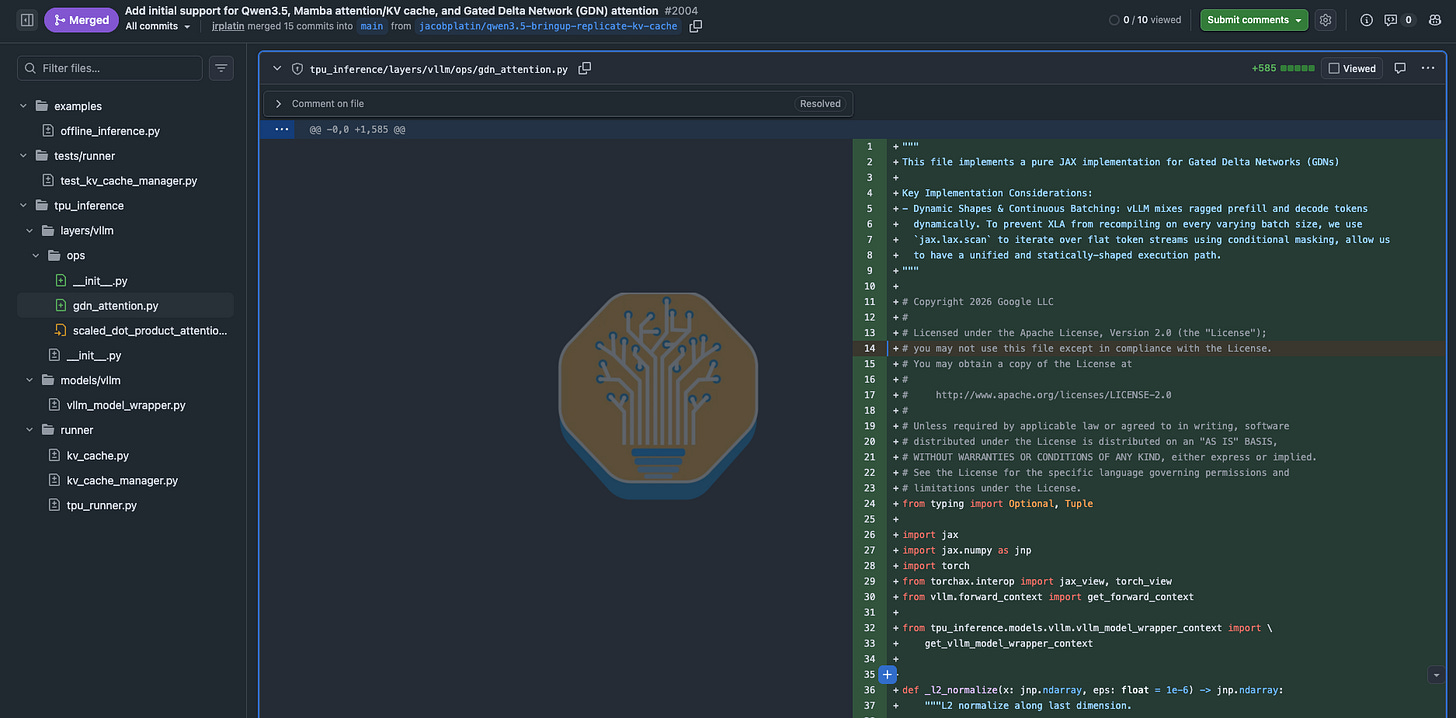
以下改动展示了其矩阵运算、向量更新和状态传输如何在 MXU、VPU、VMEM 和 HBM 之间进行调度。最初的 Qwen3.5 支持以纯 JAX 实现了因果 Conv1D 和 GDN,将它们接入 TPU 算子分发,并启用了循环状态缓存。后续的 PR 对这些实现进行了优化。
Source: GitHub
另一项容易实现的优化,是通过重新调整输出投影计算中的代数结构,使 MXU 和 VPU 的工作得以重叠。此前,VPU 先对衰减后的状态应用秩一更新,然后 MXU 再将更新后的状态与查询相乘以产生输出。这种依赖关系迫使 MXU 处于等待状态。
将衰减后的状态记为 S,修正向量记为 Δ,键和查询分别记为 k 和 q,输出可以展开为:
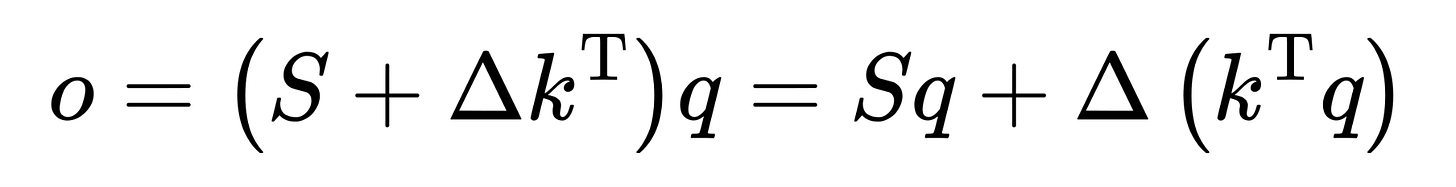
Source: SemiAnalysis
现在 MXU 可以直接根据衰减后的状态计算 Sq,同时 VPU 为下一个 token 构建更新后的状态。当前更新对输出的贡献则单独计算:先算出 kᵀq(每个头一个标量点积),再进行一次小规模的缩放向量加法。这样就把状态更新从 MXU 的依赖路径中移除了。据报告,8k1k 吞吐量在并发 64 时提升 2.79%,在并发 512 时提升 4.48%。
下一项改动通过在解码循环内部对 Q 和 K 进行切片,减少了向量寄存器的溢出,使同时存活(活跃)的值更少。decode-64 内核速度提升约 20%,但端到端收益较小:在并发 512 时,8k1k 提升 0.8%,1k8k 提升 3.8%,因为该内核只是解码步骤的一部分。
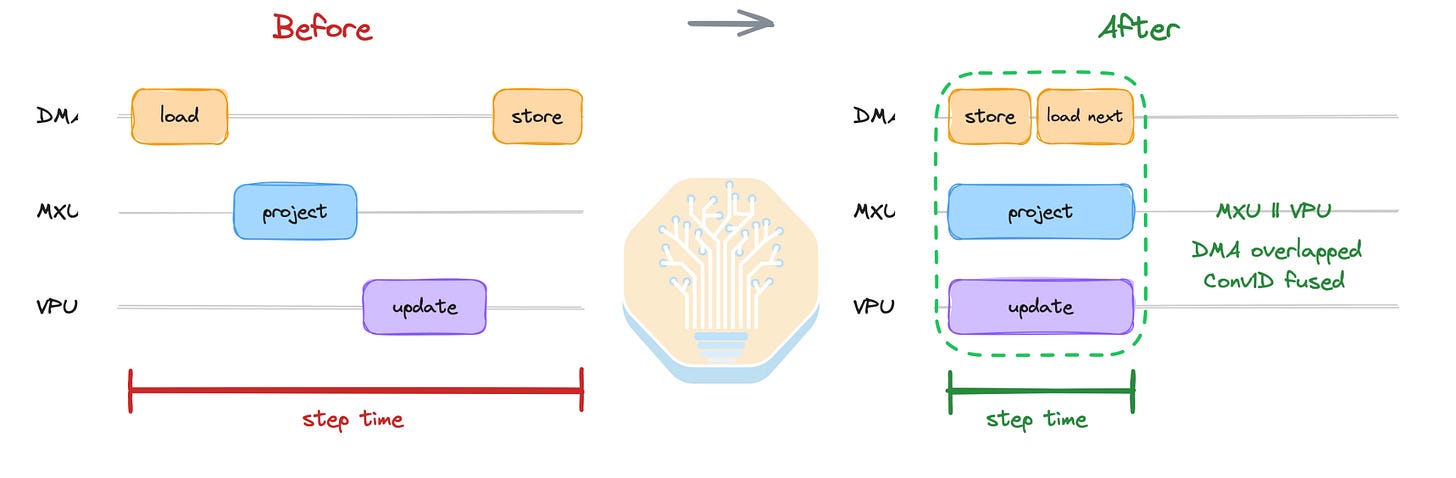
异步状态传输利用双缓冲让 DMA 与计算重叠。第二组缓冲区占用的额外 VMEM 一度导致数据并行注意力性能回退。通过复用现有的暂存缓冲区并缩短临时变量的生命周期,恢复了这部分容量并消除了性能回退。据报告,在并发 512 时 8k1k 吞吐量提升 11.3%。
GDN v3 将 Conv1D 和 GDN 融合为单个内核以减少 HBM 往返次数,改进了预填充(prefill)的数据布局,并将预填充/解码混合执行统一到一条路径。据报告,内核级别的加速为:解码 1.41 倍、预填充 1.60 倍、混合批次 2.14 倍。这些测量仅针对内核本身,并不能证明端到端服务收益。
Source: SemiAnalysis
仅仅改善单个内核内部各操作之间的重叠,就能获得显著的性能提升!
管理混合状态与分页注意力
Qwen3.5 是一个混合模型,包含两种状态:GQA 层会累积随 token 数增长的 KV 历史,而 GDN 层则为每个请求维护一个固定大小的循环状态。状态分配、存储精度、注意力页大小以及物理数据布局,共同决定了 HBM 实际可用容量的大小,以及注意力的运行效率。
SemiAnalysis 是一份依靠读者支持的出版物。若想接收新文章并支持我们的工作,欢迎考虑成为订阅者。
批量不规则分页注意力(batched ragged paged attention)将多个序列打包到同一批次,预先计算页元数据,并采用三重缓冲来改善流水线并减少填充。这一变更为共享注意力后端奠定了基础。该 PR 的工作负载示例使用 Qwen3-32B,因此其测量结果应与 Qwen3.5-397B 的结果分开看待。
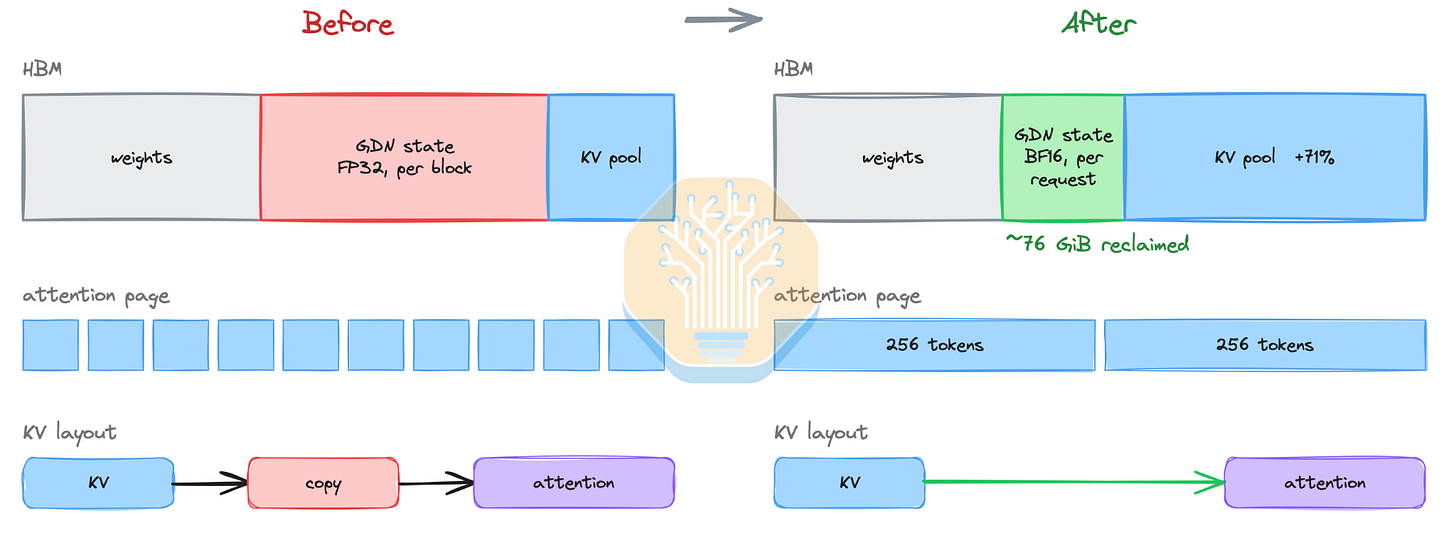
循环状态(recurrent state)现在采用紧凑分配方式,大约每个活跃请求占用一个槽位,而不是每个层组占用 num_blocks 个槽位。在所报告的配置中,这释放了约 76 GiB 的 HBM,并将注意力块池扩大了 71%,使并发 64 下 1k8k 输出吞吐量提升 18%。
循环状态以 BF16 存储,将其 HBM 占用减半,同时在 VMEM 内部仍保持 FP32 算术运算。这既节省了内存容量和传输带宽,又保留了 FP32 精度。所报告的 1k8k 吞吐量提升为并发 512 下 15%。
移除旧的混合模型页大小对齐约束后,批量注意力可以使用合适的 2 的幂次页大小,包括 256 个 token。并发 512 下 1k8k 吞吐量提升约 7%。这适用于非前缀缓存路径,与后文引入的对齐检查点模式是不同的。
Source: SemiAnalysis
通过根据 KV 头数量选择重塑路径,避免了不必要的 KV 布局拷贝,而不是强加一种只有其他形状才需要的布局约束。并发 512 下 Qwen3.5 8k1k 吞吐量提升约 4.1%。
减少填充与低并发开销
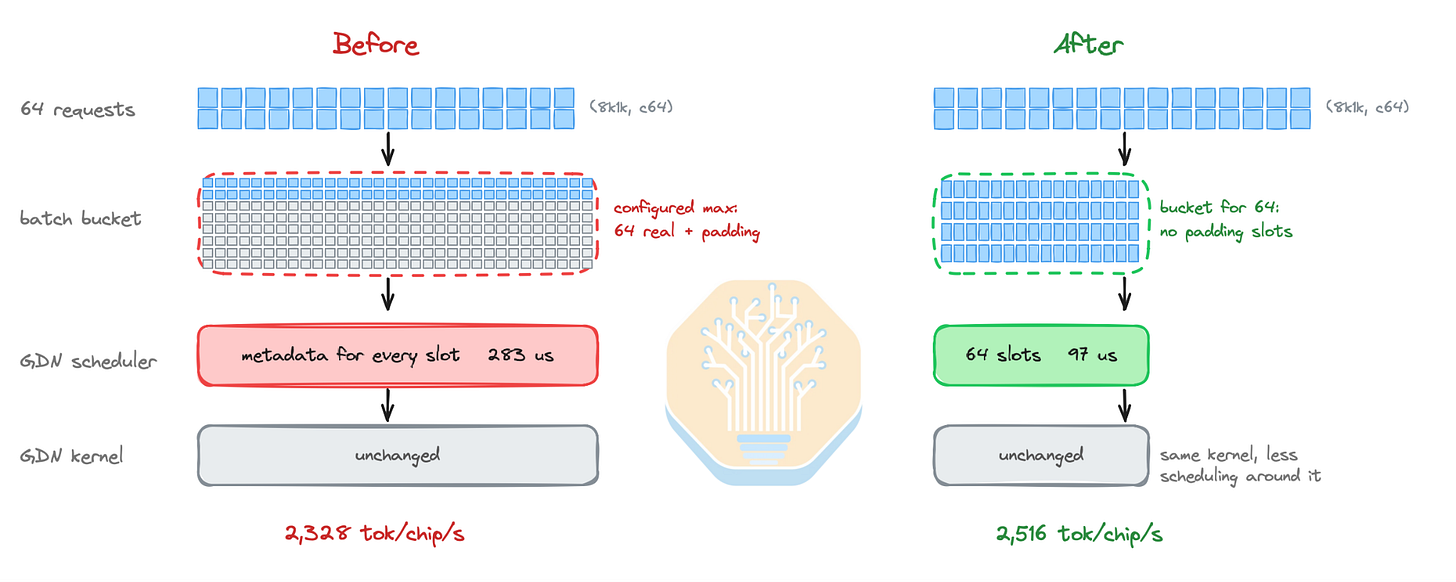
当只有四个或八个请求在运行时,针对数百个并发请求调优的配置就会造成浪费:编译的形状分桶过大,元数据按配置的最大值分配,而且填充 token 会触发无用的专家计算。InferenceX 的工作点恰好处于这些低并发场景,这促使了以下改动。
请求元数据现在按活跃请求数量分桶,而不是始终按配置的最大值分配。在 8k1k 并发 64 的测试中,GDN 调度开销从 283 µs 降至 97 µs,吞吐量从 2,328 提升到 2,516 tokens/chip/s。
Source: SemiAnalysis
针对 InferenceX 的 Qwen3.5 显式调优缩小了旋转表(rotary table),按每个 DP rank 设定序列上限,并为并发 4 增加了专用注意力分桶。并发 4 下的综合收益为:8k1k 提升 13.3%,1k1k 提升 15.5%。
进一步一轮低并发调优切换到 TP8 注意力加专家并行,减小了最小 token 分桶,并将填充 token 路由到专家零,使其不再触发额外的专家权重加载。1k1k 综合收益为:并发 4 下 22.9%,并发 8 下 18.1%。在 8k1k 上,并发 4 吞吐量提升 9.2%,但并发 8 下降 5.3%。
为混合模型启用前缀缓存
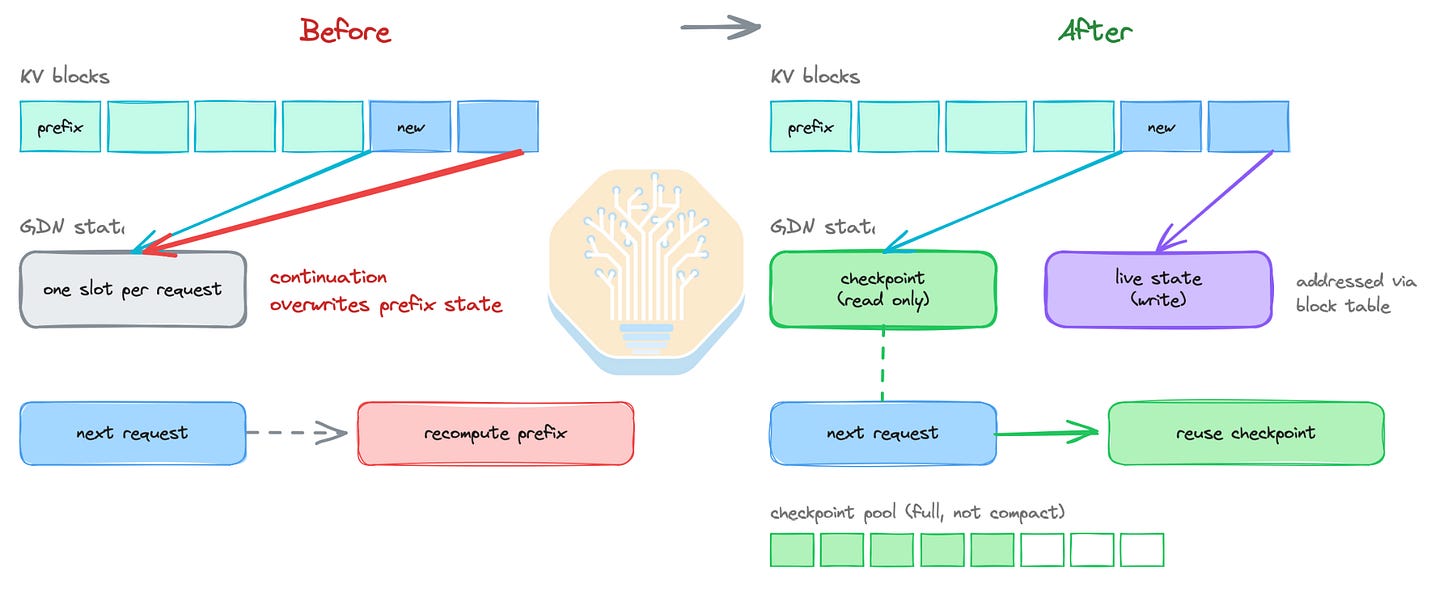
上述加速是在随机输入基准上测得的,请求之间没有任何共享内容。前缀缓存对于智能体和多轮对话负载至关重要,因为这些负载会复用很长的系统提示词和对话历史。对于混合模型,缓存的前缀必须同时保留其 KV 块和前缀末尾的 GDN 循环状态。而循环状态通常在请求继续执行时就会被覆盖,这使得前缀缓存比“常规”注意力模型更难实现。
支持 DP 的混合前缀缓存解决了这个问题:它为 GDN 分配了独立的槽位,分别用于读取检查点和写入实时状态。这样,请求继续执行时就不会再覆盖与其缓存前缀关联的检查点。状态地址由块表(block table)派生,这与定位 KV 块所用的结构是同一个。检查点按对齐的缓存粒度保存,因此保存的状态总是与 KV 块边界对齐。这种模式需要一个完整的检查点池,而不是前面描述的紧凑的按请求分配方式,以牺牲一些 HBM 换取跨请求的复用。只有当前缀真正被共享时,其收益才能体现出来。
Source: SemiAnalysis
分页注意力中的 Lane 布局与流水线深度
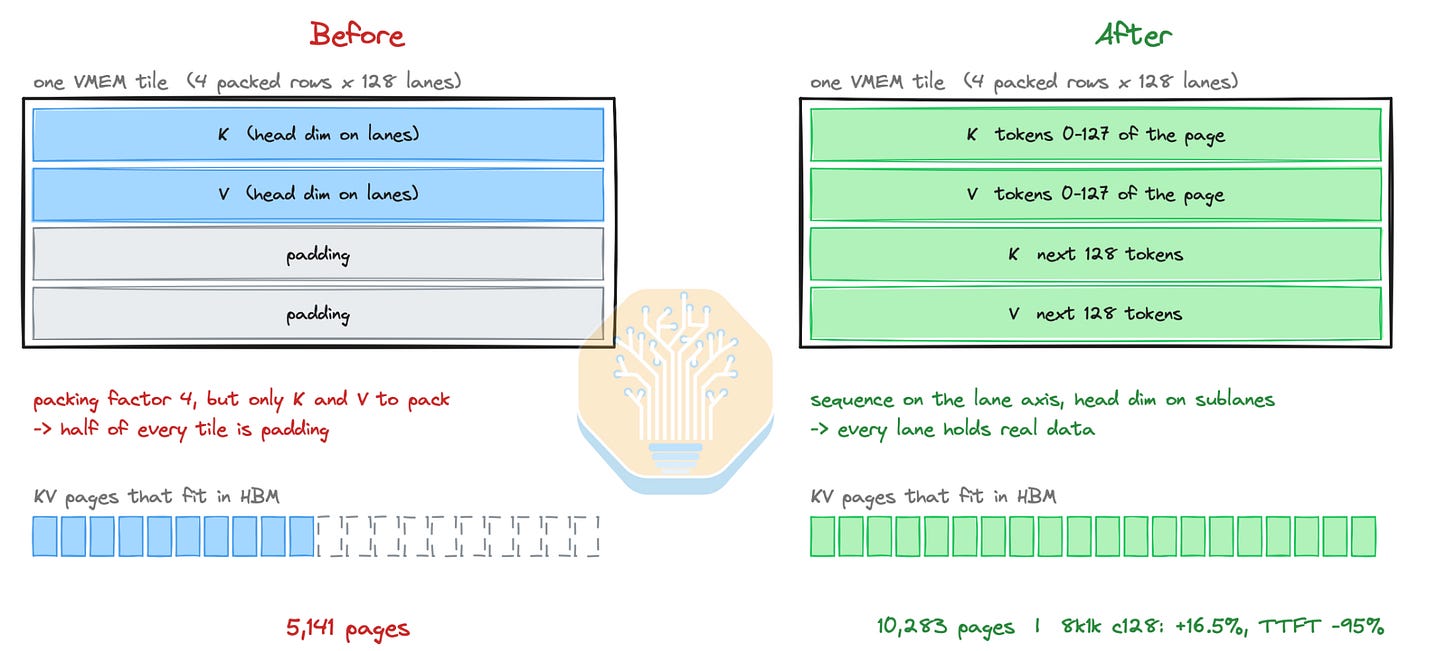
两个硬件事实决定了 KV 缓存在 TPU 上的布局方式。我们将在下一节更详细地讨论 TPU 硬件。第一,向量单元处理的是最后一维为 128 个 lane 宽的 tile,因此任何末尾维度小于 128 的数组都会被填充到 128。第二,Pallas 内核通过双缓冲来隐藏 HBM 延迟:在计算当前块的同时预取下一个块。两个块都必须放进 VMEM,因此计算块的大小决定了预取能达到的深度。这两个约束都在损耗容量和吞吐量。
在批量注意力内核中,KV 缓存沿 head 维度打包 key 和 value,对于 FP8 而言打包因子是四。一个每设备只有单个 KV head 的模型只有两个可打包的对象,因此每个 tile 的一半都浪费在了填充上。sequence-on-lane 布局解决了这个问题:它将页面的 token 放在 128-lane 轴上,而将 head 维度放在子 lane 轴上。这样,可用的 KV 页数量翻倍(在所报告的配置中从 5,141 增加到 10,283),而且 head 维度只需是 32 的倍数而不再是 128 的倍数,这使得 head 维度为 64 的模型也能使用该内核。这种布局在低并发下会使单 token 延迟增加约 3%,但在 8k1k、并发 128 的场景下,额外的容量将吞吐量提升了 16.5%,并将 TTFT 中位数降低了 95%,因为请求不再需要等待 KV 空间。
Source: SemiAnalysis
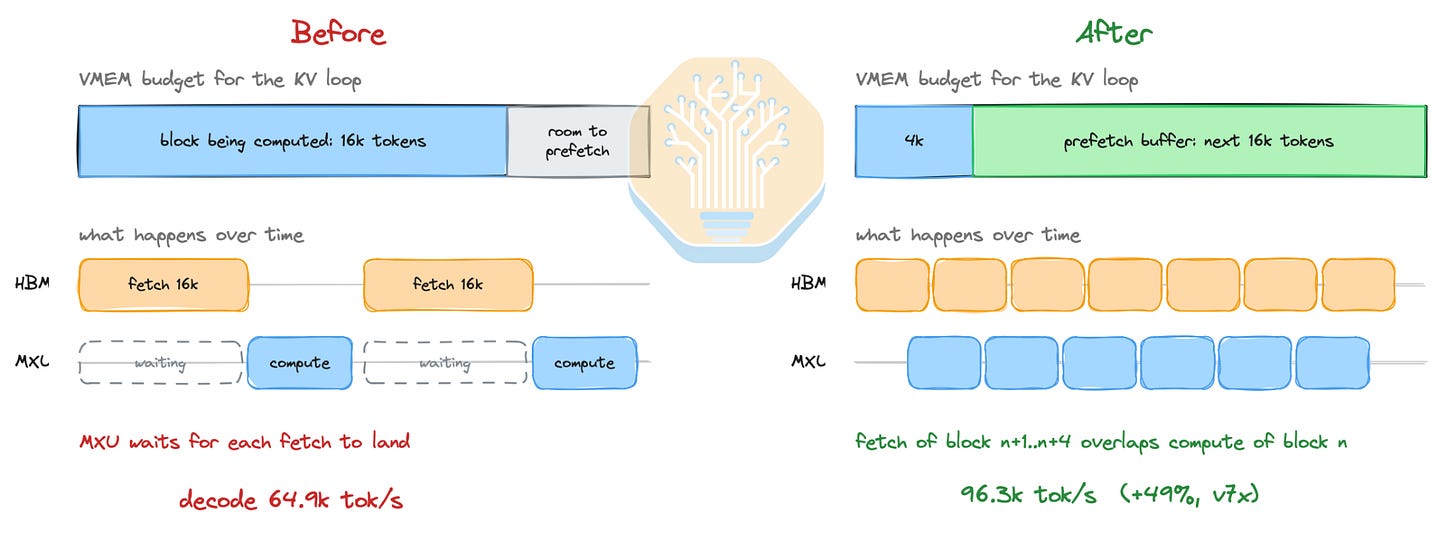
RPA v3 的 block-size 启发式策略也存在类似的盲点。在 v7x 解码期间,它将 KV 计算块设置为与 KV 读取块相同,约为 16k 个 token,这几乎没有给预取缓冲区留下任何 VMEM。将两种块大小分离后,KV 读取块保持在 16k 个 token,同时将计算块减少到 4k。这为流水线腾出了空间,使其能够超前于 MXU 运行,解码吞吐量从每秒 64.9k 提升到 96.3k 个 token,在 Qwen3-0.6B 上的四次运行中稳定复现了 49% 的提升。在整个 block-size 扫描过程中,吞吐量呈现出标准的倒 U 形曲线。调优参数表无法体现这一改进,因为它为每种形状只存储了一个 block size,这就是为什么该改动最初以环境变量覆盖的形式落地。后续工作将扩展该表,以分别存储读取块和计算块的大小。
Source: SemiAnalysis
TPU 系统级协同设计与网络解析
正如我们在 TPU King 一文中所说,Google 在推理方面的单 token 成本优势源于协同设计。Google 并不追求单芯片的极致性能,而是将计算裸片、裸片间互连结构和编译器放在一起设计,从而能够将计算与通信作为一个整体系统来优化。这种联合优化有助于解释 Ironwood 的性价比表现。以下各节将探讨芯片与网络如何协同工作。Anthropic 是 TPU 的忠实拥趸,并在训练中大量使用 TPU。
Ironwood 芯片
TPUv7 Ironwood 打破了 TPU v4 和 TPU v5p 所采用的 MegaCore 惯例——后者将两个物理核心融合为一个共享单一内存空间的逻辑加速器。而 Ironwood 拥有两个独立的计算裸片,每个裸片各自运行一个独立的逻辑设备。两个裸片之间通过高带宽的裸片间互连连接,而非统一的内存架构。JAX 和其他框架现在将每个芯片上的它们呈现为两个独立设备。每个 Ironwood 芯片配备 2 个 TensorCore 和 4 个第三代 SparseCore。SparseCore 用于加速嵌入查找等稀疏操作,否则这些操作会拖垮稠密矩阵引擎。
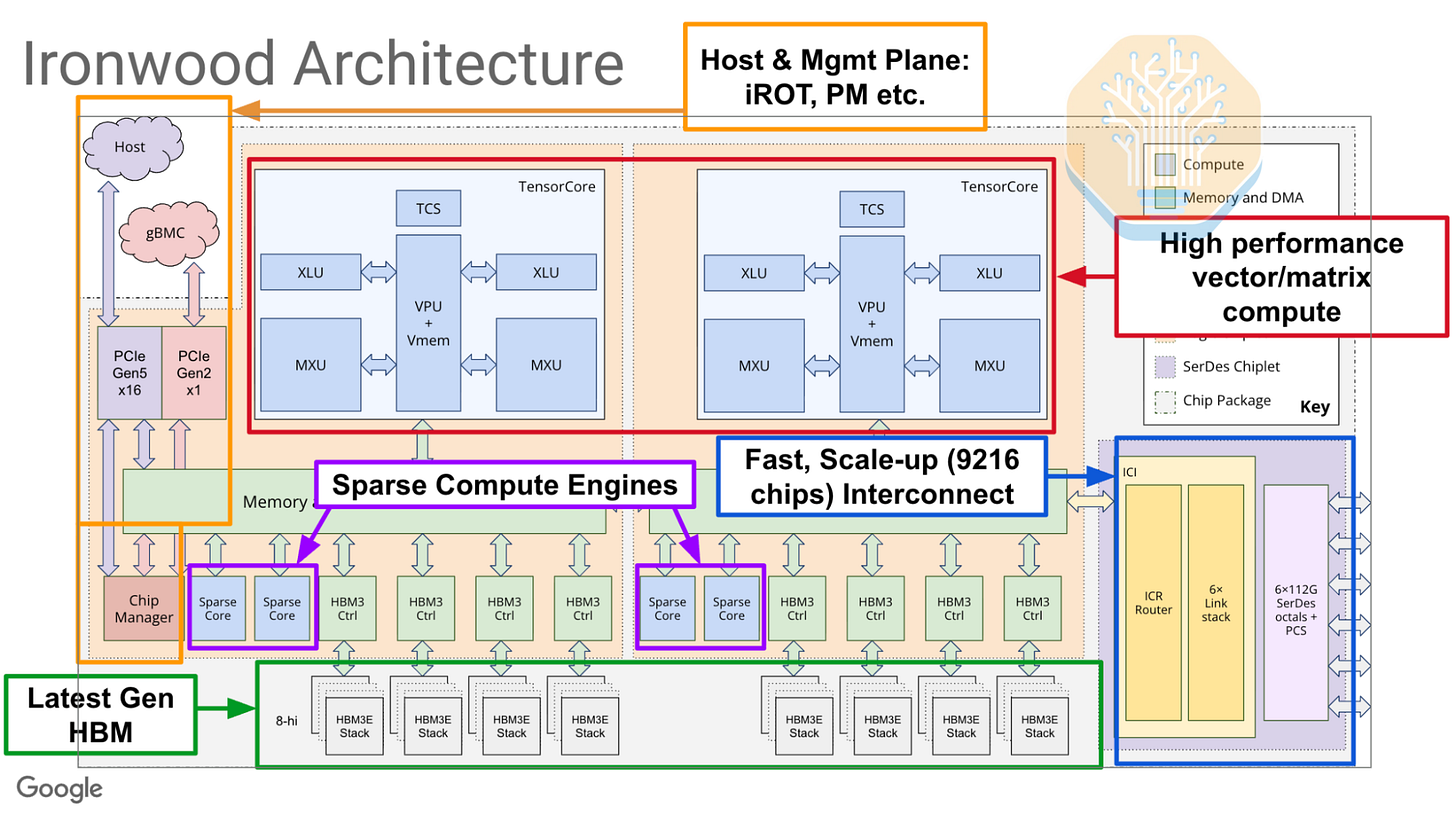
Source: Google
在内存方面,每个芯片的 HBM 容量约为 Trillium 的 6 倍,这一跃升直接影响 KV cache 的余量和 batch size。值得注意的是,Ironwood 是首个原生支持 FP8 硬件的 TPU 世代,而之前的世代只能通过软件模拟 FP8。
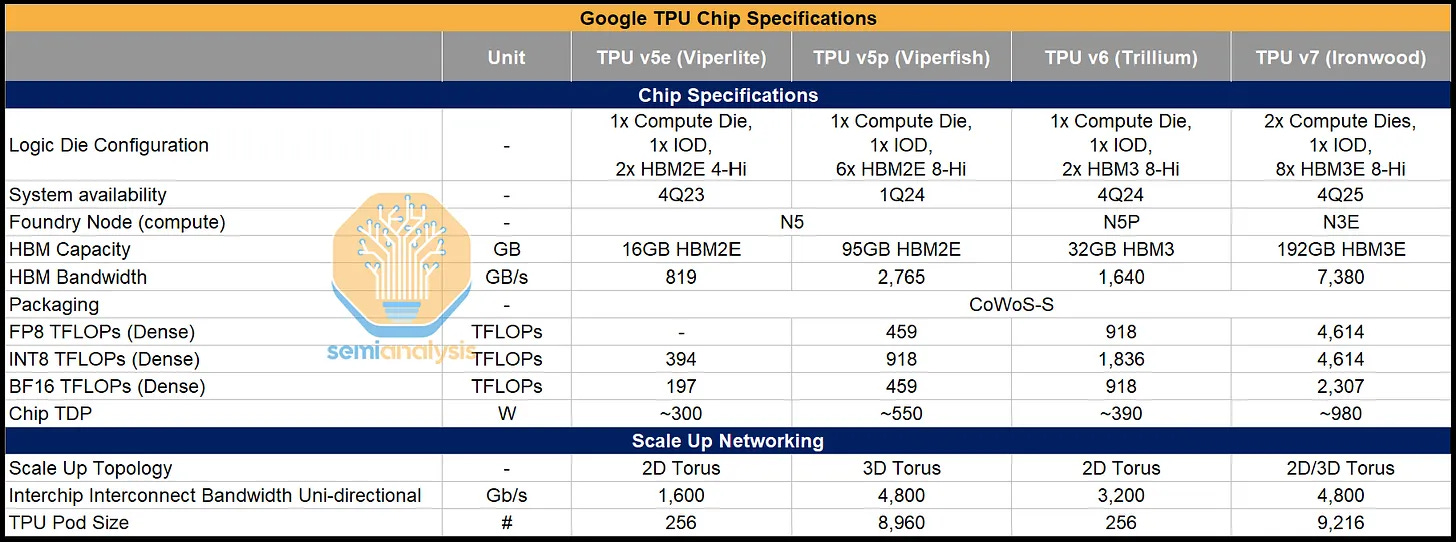
Source: SemiAnalysis
关于 Ironwood 的更多信息,请阅读我们的 TPUv7 文章
MXU 以及形状为何重要
矩阵乘法单元(Matrix Multiply Unit,简称 MXU)是真正执行乘法运算的引擎,它是一个脉动阵列(systolic array):一个由乘累加(MAC)单元组成的二维网格。权重被加载到阵列中并保持不动。激活值从边缘流入,部分和逐格在网格中传递,并在传递过程中不断累加。最终结果从另一侧流出,中间过程完全不需要访问内存。从初代到 v5 的每一代 TPU 都采用 128x128 的 MXU,每个周期可执行 16,384 次 MAC 运算。从 TPU v6e 开始一直到 Ironwood,阵列规模翻倍为 256x256,即每个周期 65,536 次 MAC 运算,相比上一代设计每周期可提供 4 倍的 FLOPs。
强烈推荐阅读《scaling book》(又名机器学习系统圣经),其中包含关于 TPU 和扩展性(scaling)的顶级权威信息。
SemiAnalysis 是一份依靠读者支持的出版物。如需接收新文章并支持我们的工作,欢迎考虑成为订阅用户。
问题在于,更大的脉动阵列只有在能被填满的情况下才是“免费”的。矩阵的各个维度都需要填充(padding)到至少与 MXU 边长相等——旧世代是 128,v6e 和 v7 则是 256——而 XLA 编译器会尽职地把任何更小的维度填充到铺满整个 tile。每个被填充的单元在该周期仍然占用一个 MAC 单元,乘以一个对结果毫无贡献的零。Llama 3 8B 就是一个例子,它的注意力头维度是 128。在 Ironwood 的 256x256 MXU 上,这个头维度恰好是阵列原生宽度的一半,这导致两个注意力矩阵乘法的 MXU 利用率上限只有 50%(而不是 75%,因为只有头维度是 128)。
这一影响比某个模型的注意力层更为深远。过去那些可以随意选择的架构超参数(比如头维度、经过张量并行切分后保留的 KV 头数量、以及 MoE 专家宽度),如今越来越需要考虑 TPU 的 tile 几何结构,因为形状不匹配会直接拖累实际吞吐量,无论技术栈其余部分做得多好都是如此。算子(kernel)的作者也需要明确考虑这一点。像 ragged paged attention 这样的生产级注意力算子,在 XLA 默认的 tiling 布局效率低下时,会使用显式的打包(packing)维度来减少填充。
TPU 很挑剔
GPU 的矩阵核心处理的是小 tile,因此各种头维度、专家宽度和切分后的 KV 头数量都能接近峰值性能。在 H100 或 B200 上,用 64 代替 128 的维度几乎不付出任何代价,反而能换来更便宜的注意力层。GPU 架构让研究人员可以优先考虑评估(evaluation)性能而不损失推理性能。但对 TPU 而言,这个超参数就变成了一种权衡。
如前所述,这些选择在 256 宽的脉动阵列上并非没有代价。按照将 Llama 3 8B 的注意力矩阵乘法上限限制在 50% 的同样计算逻辑,head 维度为 64 时,在还没写一行 kernel 代码之前,这个上限就已经被压到 25%。而 gpt-oss 恰好采用了 64。DeepSeek 的 MLA 将其 query/key 维度拆分为 128 加 64,总计 192,这对任何 2 的幂次阵列来说都很别扭,对宽阵列来说则更加糟糕。
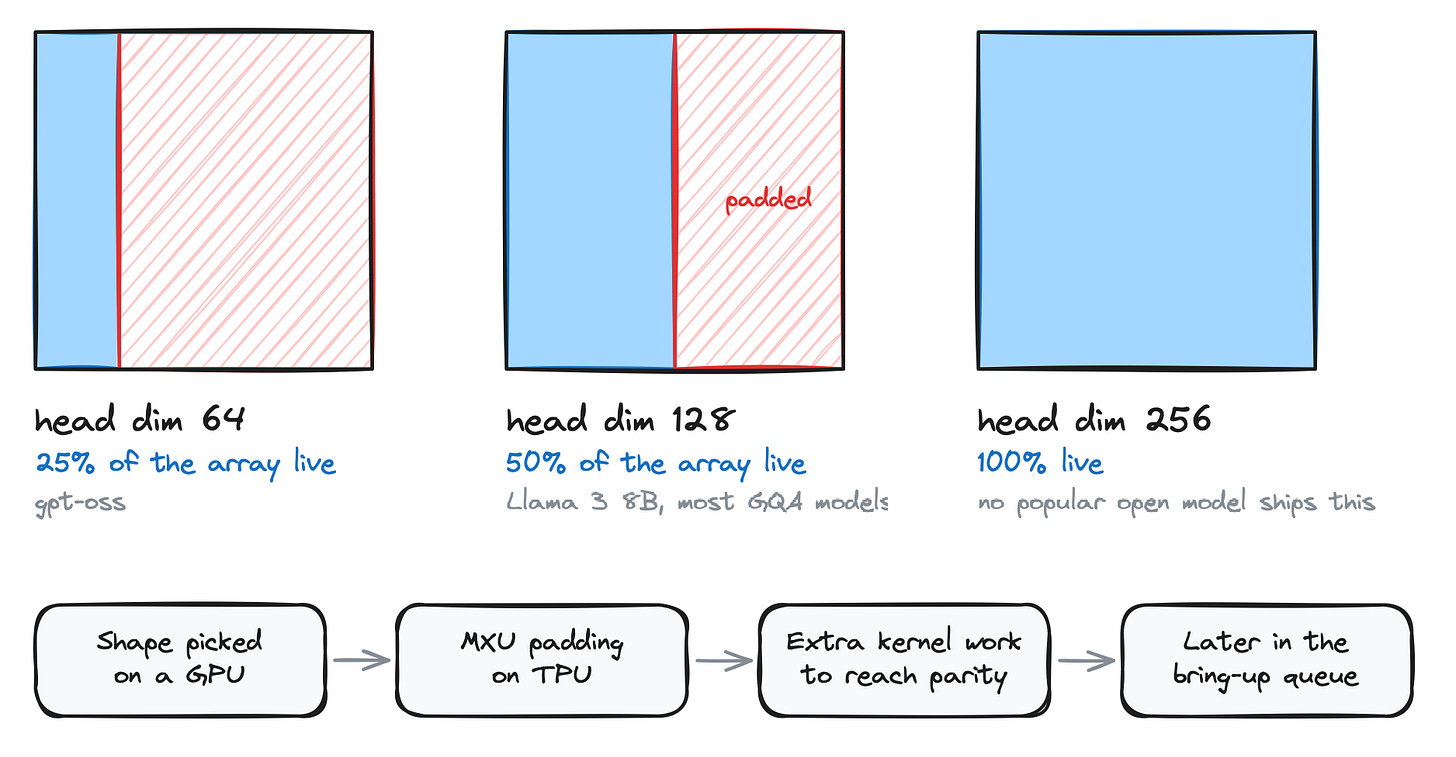
其后果是,模型适配(bring-up)的成本差异巨大,而且与其流行程度几乎没有相关性。一个形状规整的模型只需要调度、服务部署和调优工作,以周为单位即可完成。而一个与 tile 几何结构相冲突的模型,在达到同等性能之前就需要编写新的 kernel,更不用说在单位美元性能上取胜了。Kernel 工程师是有限的,因此将外部化(externalization)优先安排到硬件没有先天劣势的模型上,是理性的选择。我们预计任何处于这种地位的加速器厂商都会做出同样的举动。
环形拓扑(Torus Topology)
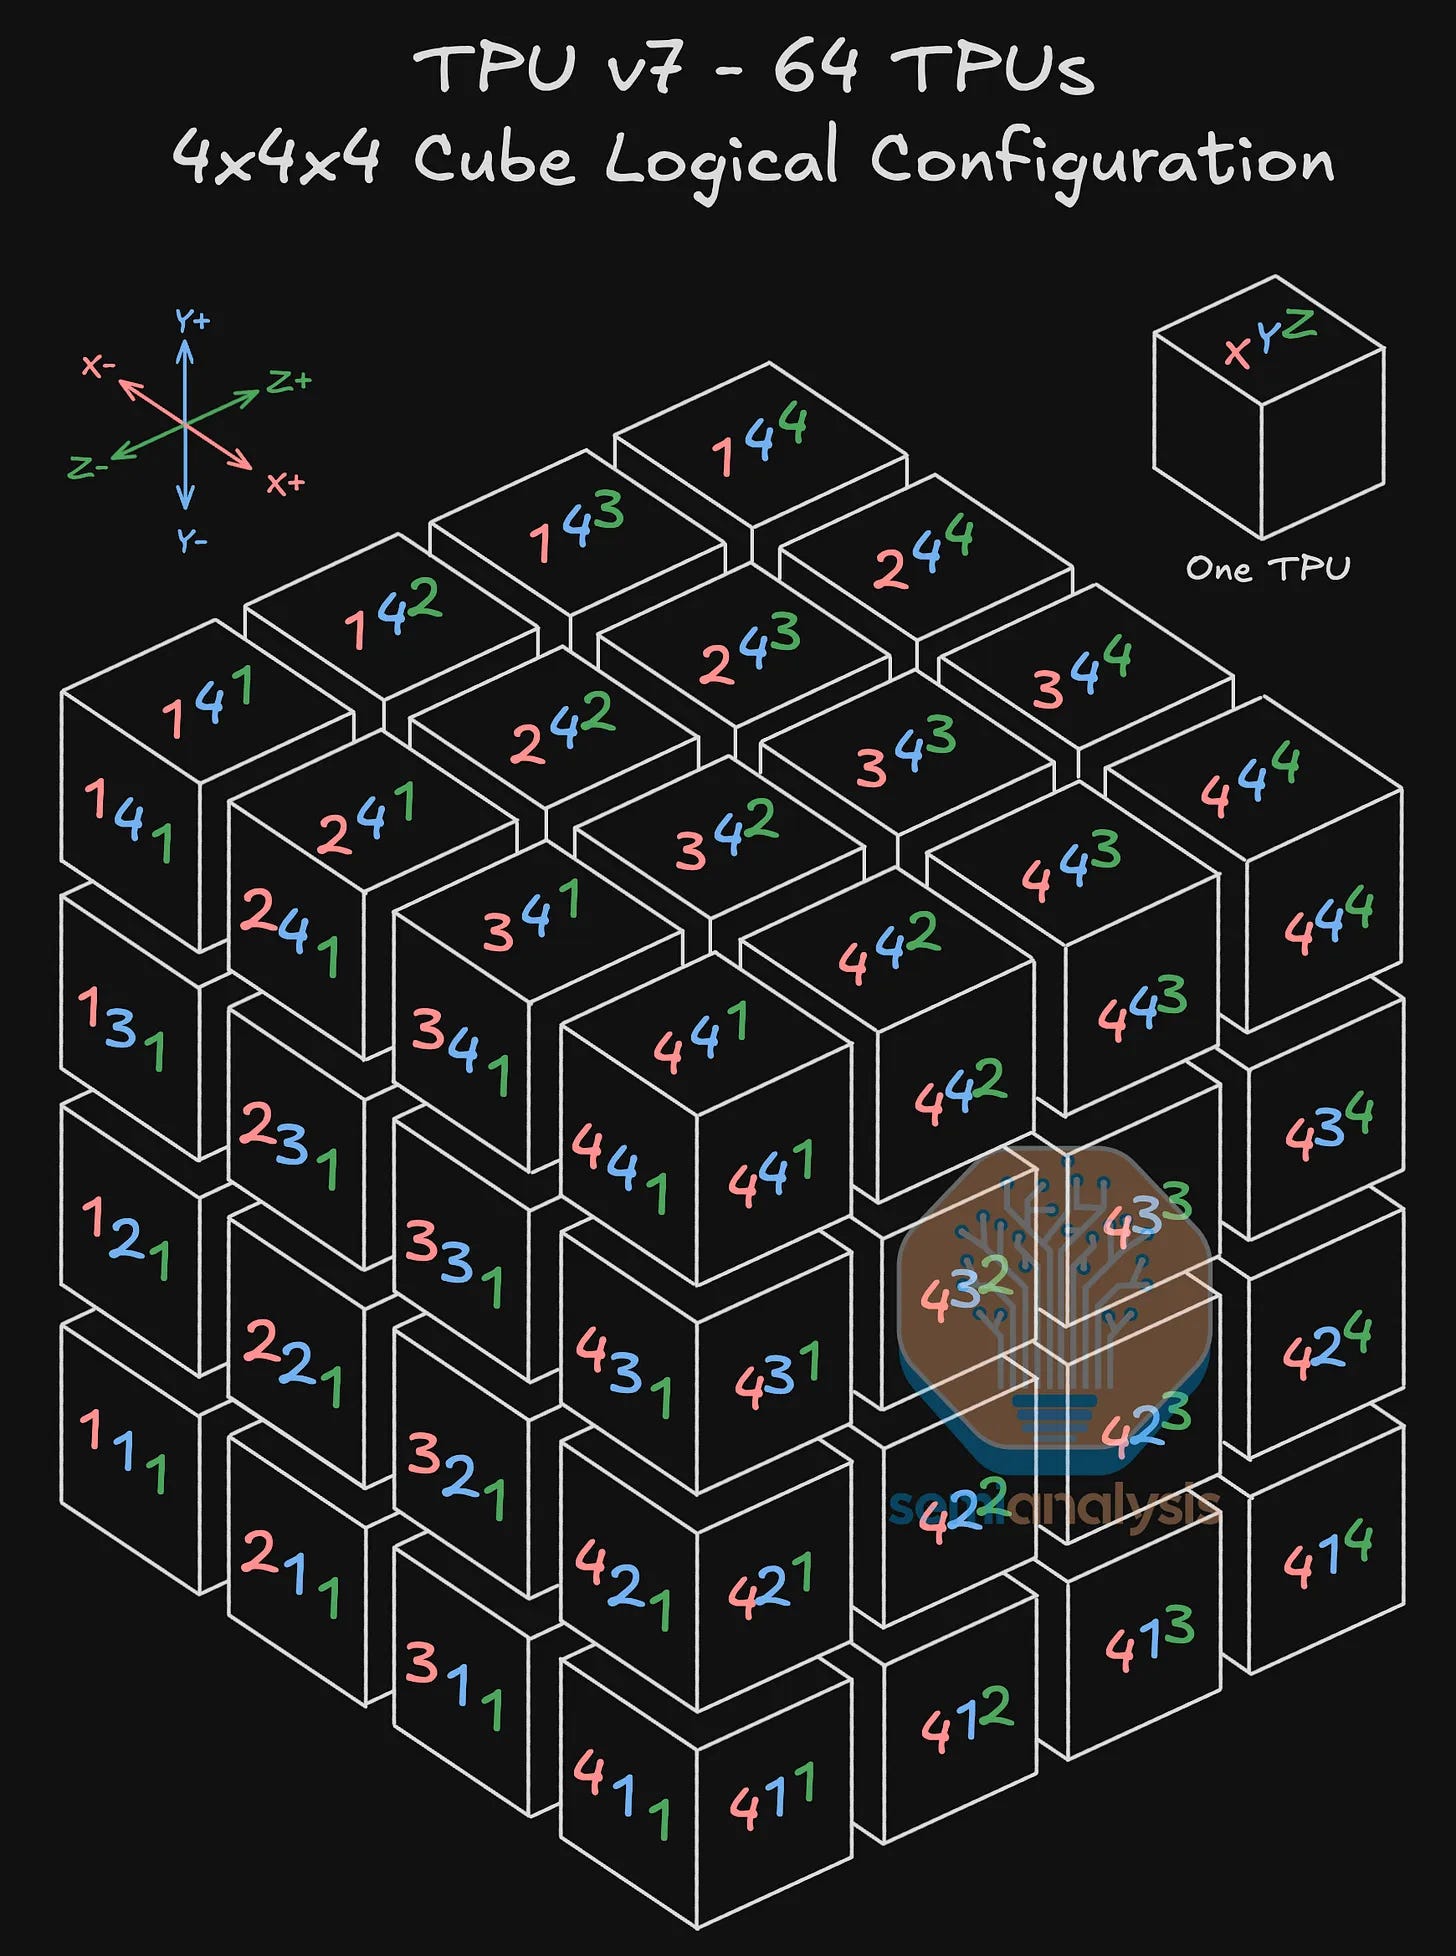
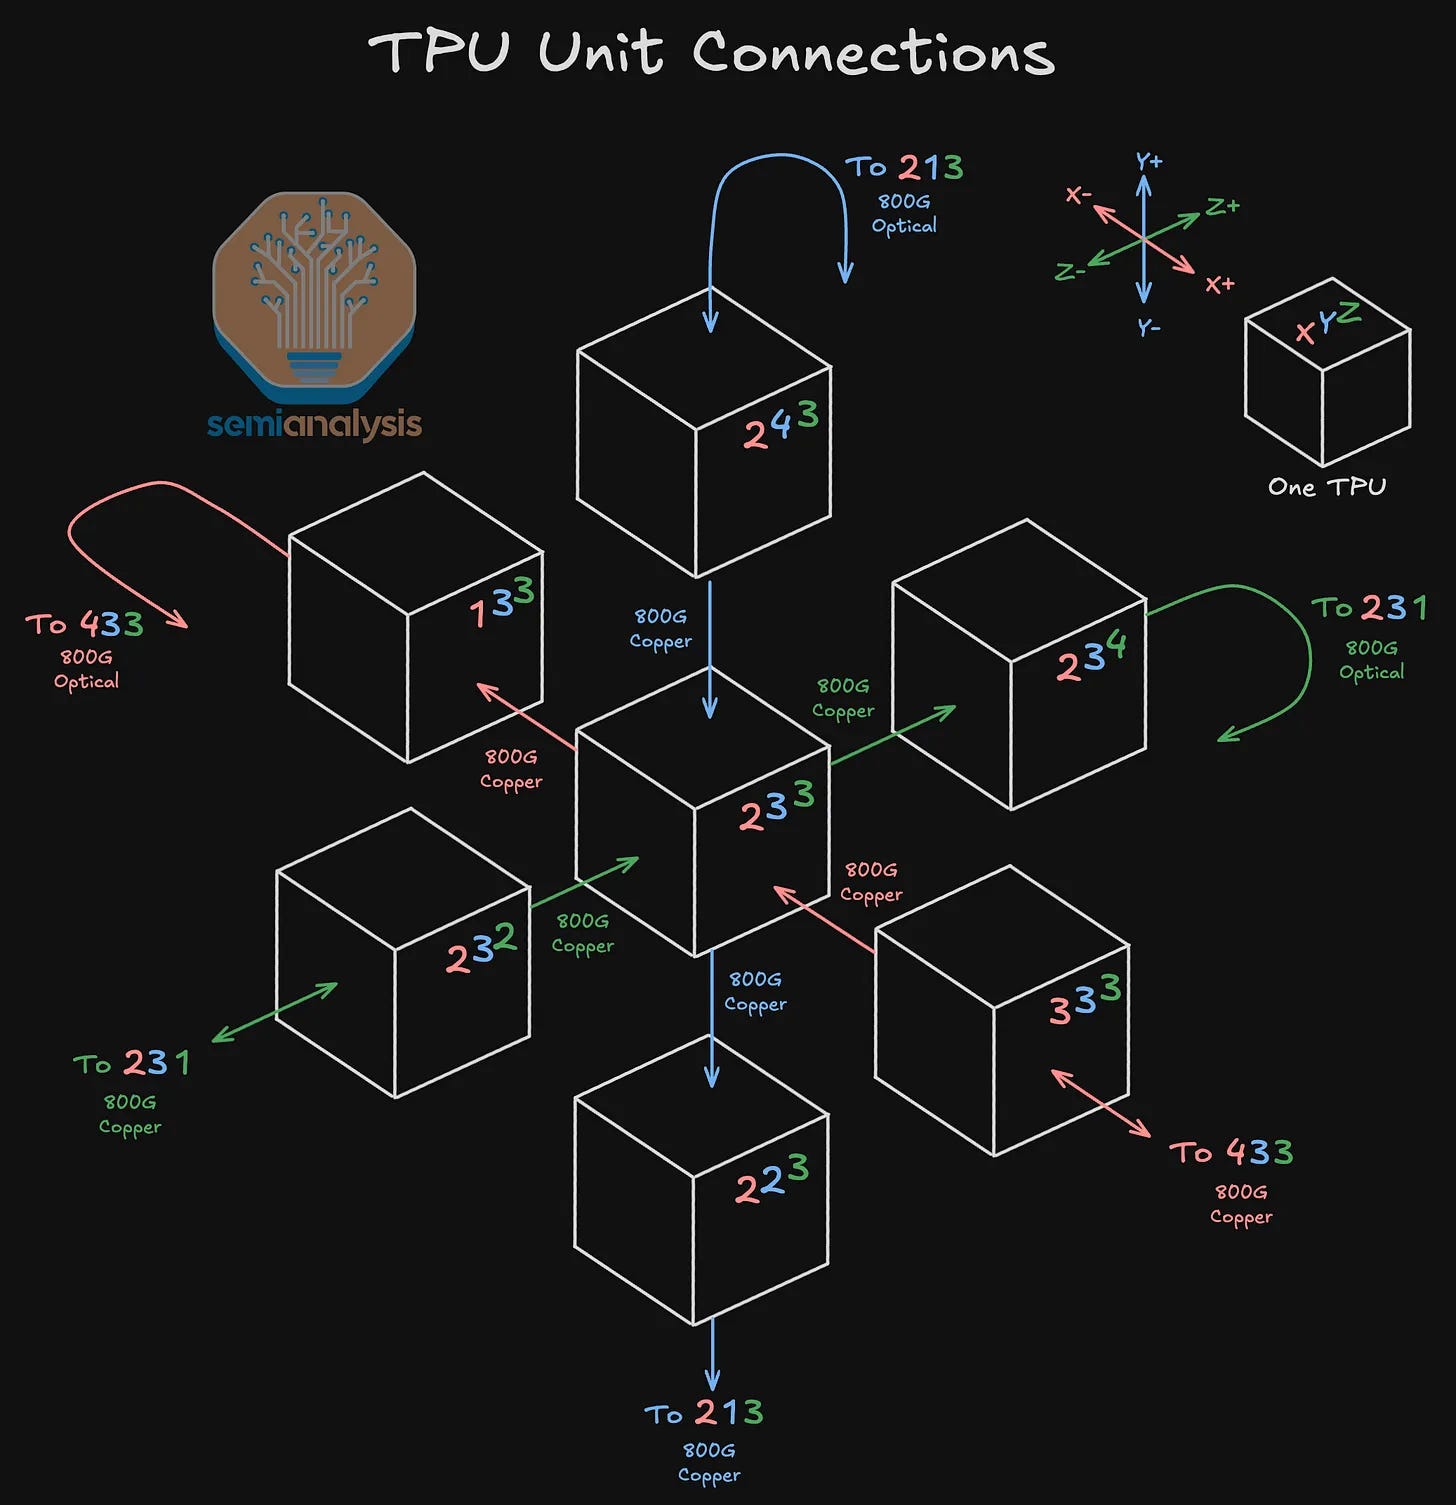
大规模的推理和训练需要跨越数千颗芯片,这些芯片之间需要持续通信。TPU 通过一种名为 ICI(Inter-Chip Interconnect)的定制网络进行点对点连接。ICI 完全绕过了主机 CPU,使芯片能够直接交换激活值和梯度,而无需通过 PCIe 和通用网卡转发。ICI 背后的拓扑结构一代代演进:TPU v2 和 v3 采用 2D 环形拓扑,每颗芯片与 4 个邻居相连;从 TPU v4 和 v5p 开始,Google 转向 3D 环形拓扑,每颗芯片沿 +/-X、+/-Y 和 +/-Z 轴与 6 个邻居相连。Ironwood(TPUv7)延续了这一 3D 环形拓扑。其基本构建模块是由 64 颗芯片组成的 4x4x4 立方体,其尺寸刚好可以整齐地映射到一个物理服务器机柜上。
Source: SemiAnalysis
环形拓扑与普通网格的区别在于其首尾环绕的链路。将一条线的两端连接起来形成一个环,可以把最坏情况的跳数距离从 N 缩短到 N/2。这和让 Pac-Man 的迷宫感觉比实际更小的技巧是一样的。Google 更进一步采用了“扭曲环面(twisted torus)”,一种类似莫比乌斯带的环绕方式,将平均跳数进一步降低。为了扩展到单个 4x4x4 立方体之外,Google 使用光路交换机(Optical Circuit Switches,OCS)将多个立方体缝合在一起,从而在一个更大且可重构的拓扑中保持环绕特性,一直扩展到 Ironwood 完整的 9,216 颗芯片超级舱(superpod)及其总计 42.5 FP8 exaflops 的聚合算力。OCS 在运维上的回报是:Google 可以在几秒钟内通过反射镜物理重新布线,绕过失效链路或损坏的芯片,而无需派技术人员到运行中的数据中心重新熔接铜缆。
Source: SemiAnalysis
这种横向扩展设计在当时具有革命性意义。在 NVL72 机柜出现之前,无法装进单个 8-GPU 节点的模型不得不采用流水线并行,因为节点间的 InfiniBand 速度太慢。而在 TPU pod 上,ICI 环面网络能在整个 pod 范围内提供 NVLink 级别的带宽,在 v5p 上最多可扩展至 8,960 个芯片。凭借这样的带宽,DSV3 规模的模型可以采用张量并行、专家并行和数据并行(FSDP 式权重分片)的方式分片到整个 pod 上,而无需将各层拆分到不同的流水线阶段。
尽管 TPU 环面网络的跳数比单跳 NVLink 交换设计更多,但我们即将发布的 CollectiveX/NetworkingX 结果表明,在很多情况下,对于小型 EP 消息,TPU 环面网络的延迟低于单跳 NVSwitch。
展望未来:TPUv8i 的 Boardfly 网络
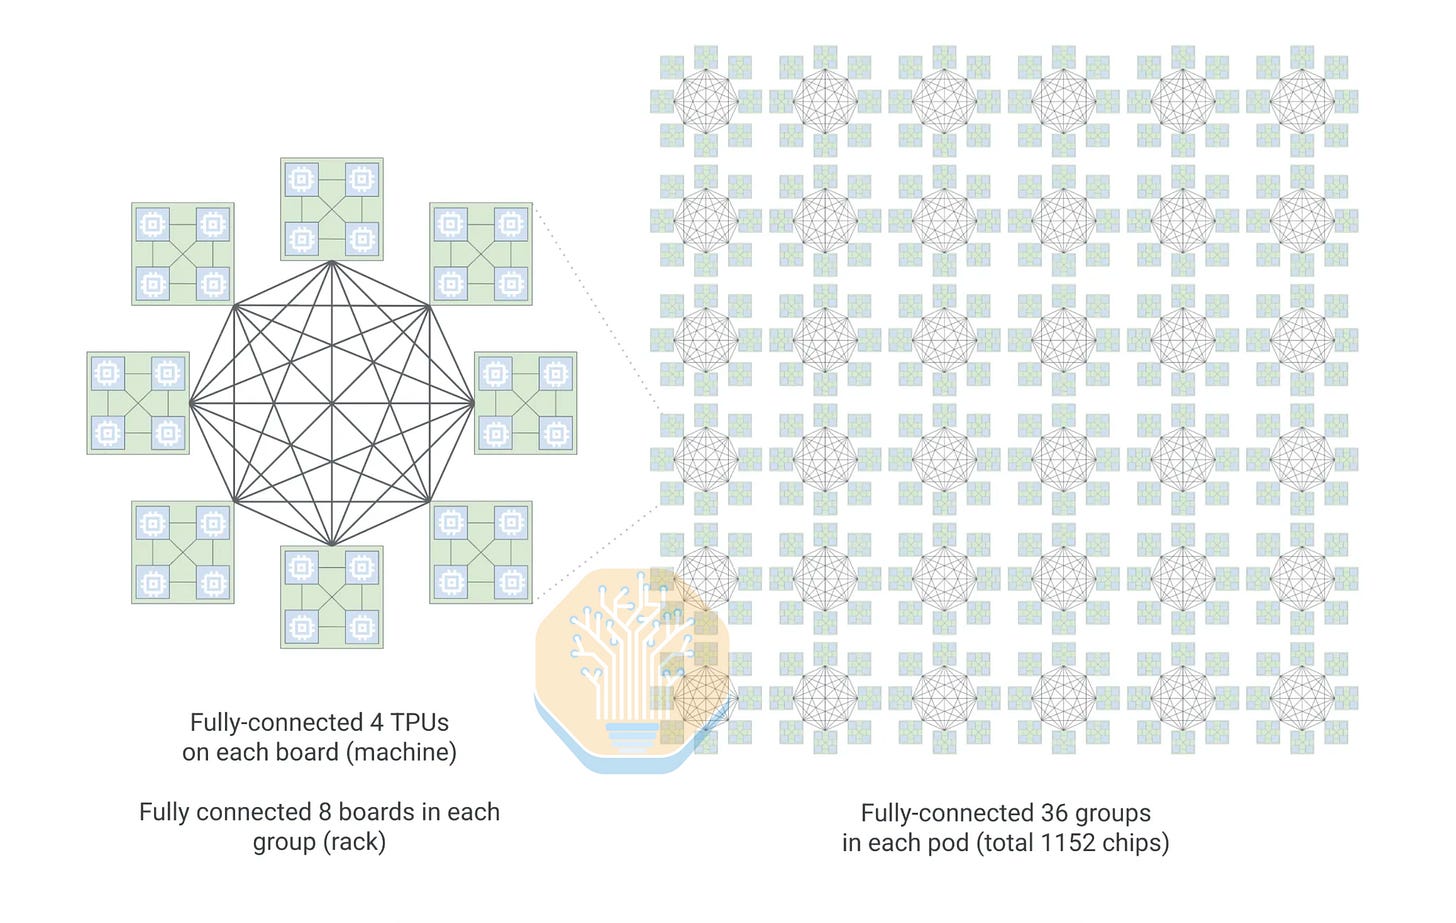
Google 新发布的第八代 TPU 产品线包含两款专用芯片:面向训练的 TPU 8t 和面向推理的 TPU 8i。这是 Google 首次将训练和推理拆分为两种不同的架构设计,而不是发布一种兼顾两者的架构。TPU 8t 在纵向扩展上延续了 3D 环面网络的传统,但 TPU 8i 用一种名为「Boardfly」的新拓扑取代了环面。这个名字致敬了高性能计算领域长期使用的蜻蜓(dragonfly)式高阶数网络设计。Boardfly 采用更扁平的高阶数交换机层级化 fabric,而非最近邻 mesh。Boardfly 拓扑会影响每芯片的网络接入资本开支。
其收益是网络直径相比同等规模的 3D 环面减少超过 50%,在 1,024 到 1,152 芯片这一可比规模下,大约从 16 跳降至约 7 跳。更少的跳数意味着集合通信操作的尾延迟显著降低。一旦你需要在 MoE 层之间路由 token,或者运行多轮智能体工作负载(每多一跳都会叠加成用户可感知的延迟),这一点就至关重要。TPU 8i 还提供了 19.2 Tb/s 的 ICI 带宽,是上一代的两倍;以及 384 MB 的片上 SRAM,是上一代的三倍,这一容量专门用于将推理和智能体模型的 KV cache 保留在片上,而不必在 HBM 之间来回搬运。
Source: Google
不过,这些硬件余量本身并不会自动转化为收益。要把更低直径的网络和更大的片上缓存转化为每 token 成本的降低,仍然需要软件栈跟上节奏。下一节将介绍相关的路线图,包括投机解码、prefill-decode 分离(disaggregation),以及在生产环境中充分利用 TPUv8 所需的更广泛的模型支持。
夯实 TPU 基础的下一步
这些预览结果为在同一硬件上进一步优化确立了起点。我们预计,随着 TPU 外部化(externalization)工作的持续推进,性能还将不断提升,而整个软件栈仍有大量工作要做。
启用并优化投机解码(MTP)
Google 团队需要重点优化的第一个领域是投机解码(speculative decoding)。一个轻量的小型草稿模型会向前预测若干个 token,主模型则在一次前向传播中完成全部验证,不匹配的预测会被丢弃。保留下来的结果与模型自己生成的完全一致。投机解码是无损的,质量零损失。
它之所以有效,是因为 decode 阶段受限于带宽而非算力。要为单个用户生成一个 token,就必须把整个模型的权重从 HBM 中读出。这次权重读取是主要开销,而且无论验证一个 token 还是五个 token,开销几乎没有变化。当内存系统承担了全部工作时,矩阵计算单元大部分时间都在空转。投机解码正是利用这些闲置算力,把一次非常昂贵的权重读取分摊到多个 token 上。这也是 MTP、DSpark 这类一次性起草多个 token 的方法如此低成本、如此高效的原因。
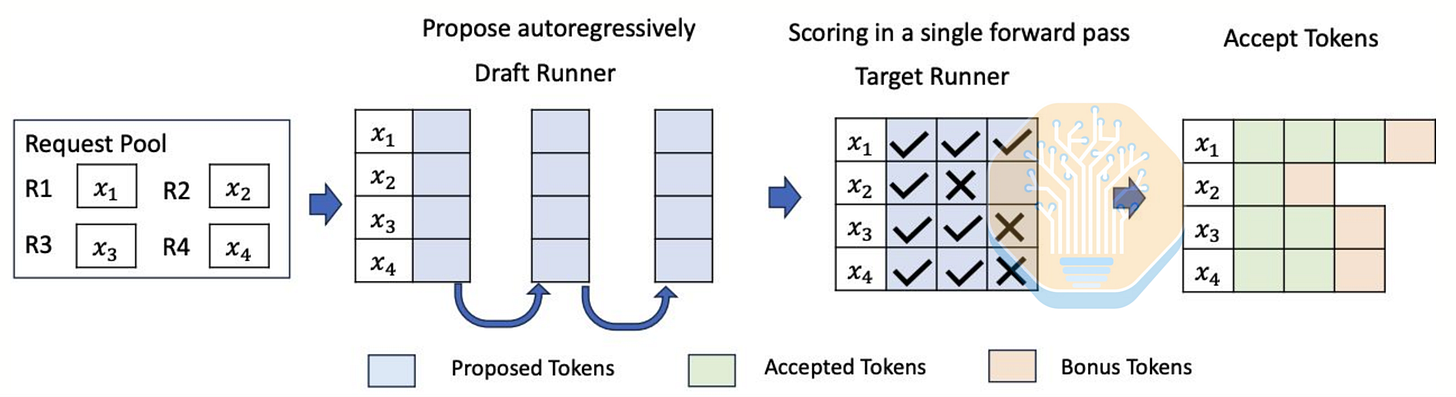
Source: vLLM
Prefill-Decode 分离与 KV-cache 卸载
Prefill-Decode(PD)分离是 TPU 团队正在对外输出的另一项优化。它将 prefill 和 decode 分配到不同的 TPU 资源池,使每个池都可以根据工作负载独立调优和扩缩容。
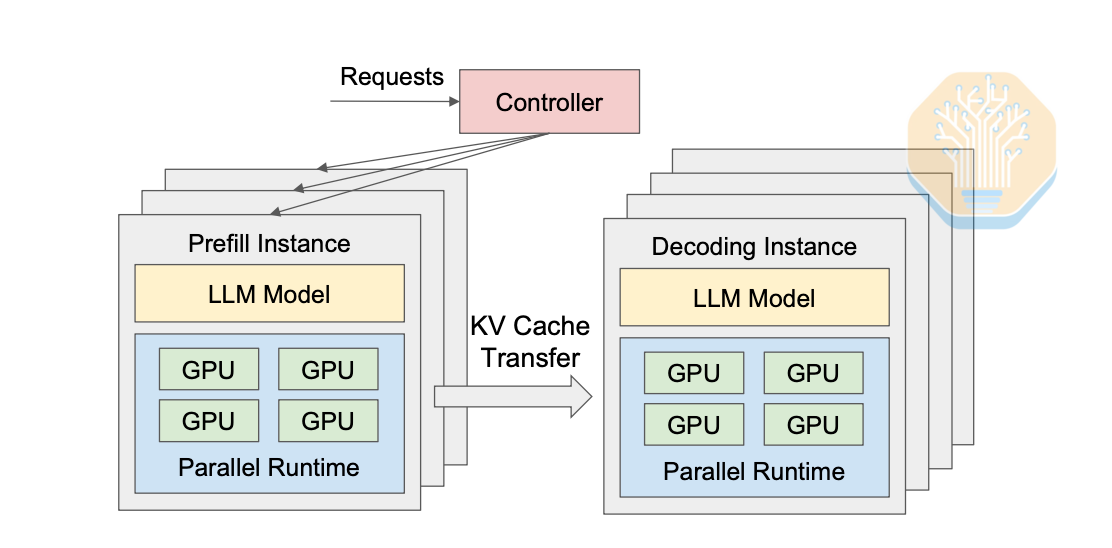
Source: DistServe
Google 在内部为 Gemini 服务运行 PD 分离已有很长时间,但相关工作直到几个月前才开始对外输出。这项工作包括 llm-d 中的 TPU 支持,以及开源 TPU-Sync(前身为 TPU-raiden)——这是 Google 的分离式 KV-cache 传输库。TPU-Sync 原生支持 JAX 和原生 TorchTPU 栈,并且可以通过提取原生 PJRTBuffer 硬件描述符来实现零拷贝传输。借助分离式 PD,我们认为 TPUv7 能够成为 GB200/GB300 的有力竞争者,甚至在性价比上超过它们。
SemiAnalysis 是一份依靠读者支持的出版物。如需接收新文章并支持我们的工作,请考虑成为订阅用户。
TPU-Sync 还支持原生 TPU KV-cache DRAM 卸载。对于大模型和中大规模 batch size 的场景,HBM 已经无法容纳所有用户的 KV cache,这项能力必不可少。很高兴看到 Google 也在将其 DRAM 卸载优化对外公开。
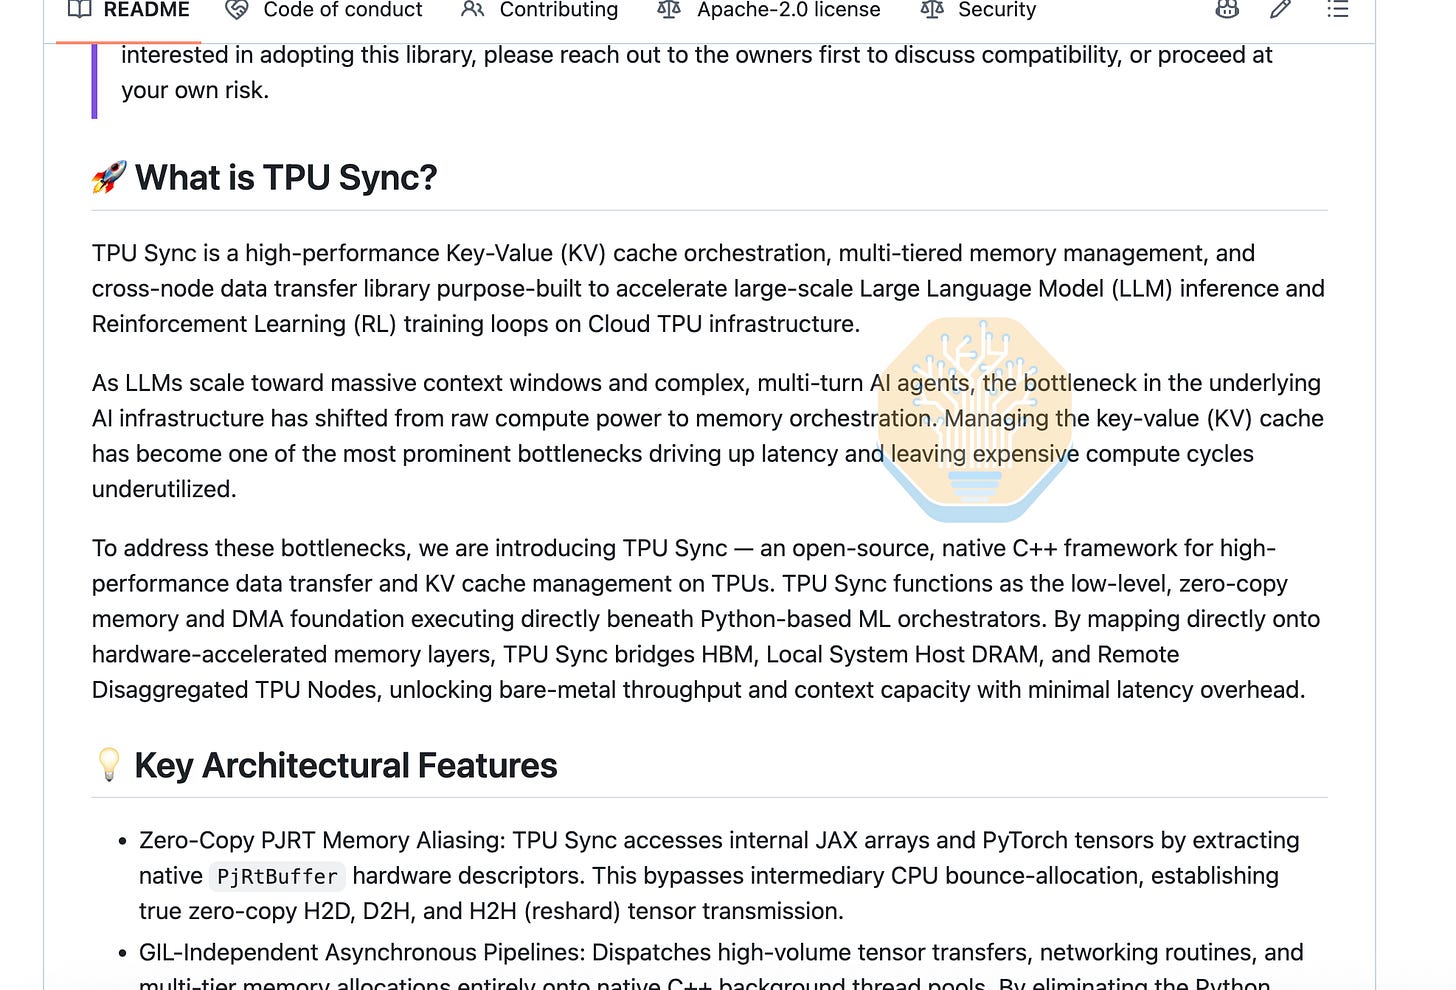
Source: GitHub
Google 正在对外输出其原生 TPU 卸载栈,并支持业界标准的 Mooncake Store 卸载库,以及 Mooncake Store 的 DRAM P2P 池化功能。我们认为 Mooncake Store 的支持将基于 tpu-sync 中的原语来实现。
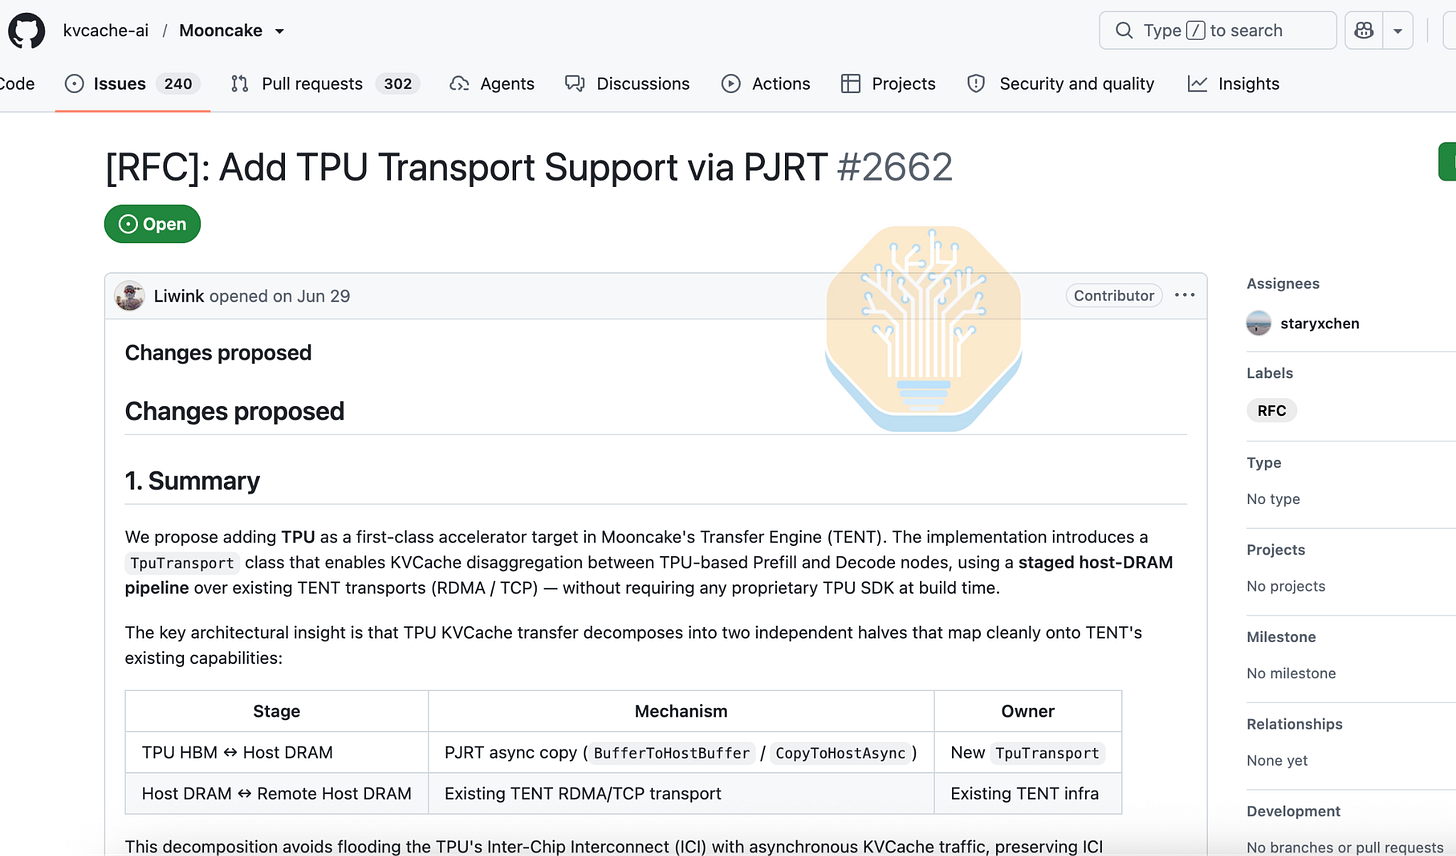
Source: GitHub
通过 P2P 池化,每台 TPU 主机上的 KV-cache 存储会被聚合成一个统一的逻辑内存池,因此任何服务器上的 TPU 都可以访问其他服务器的 KV cache。这将多个节点的内存贡献统一到了一个共享的逻辑池中。
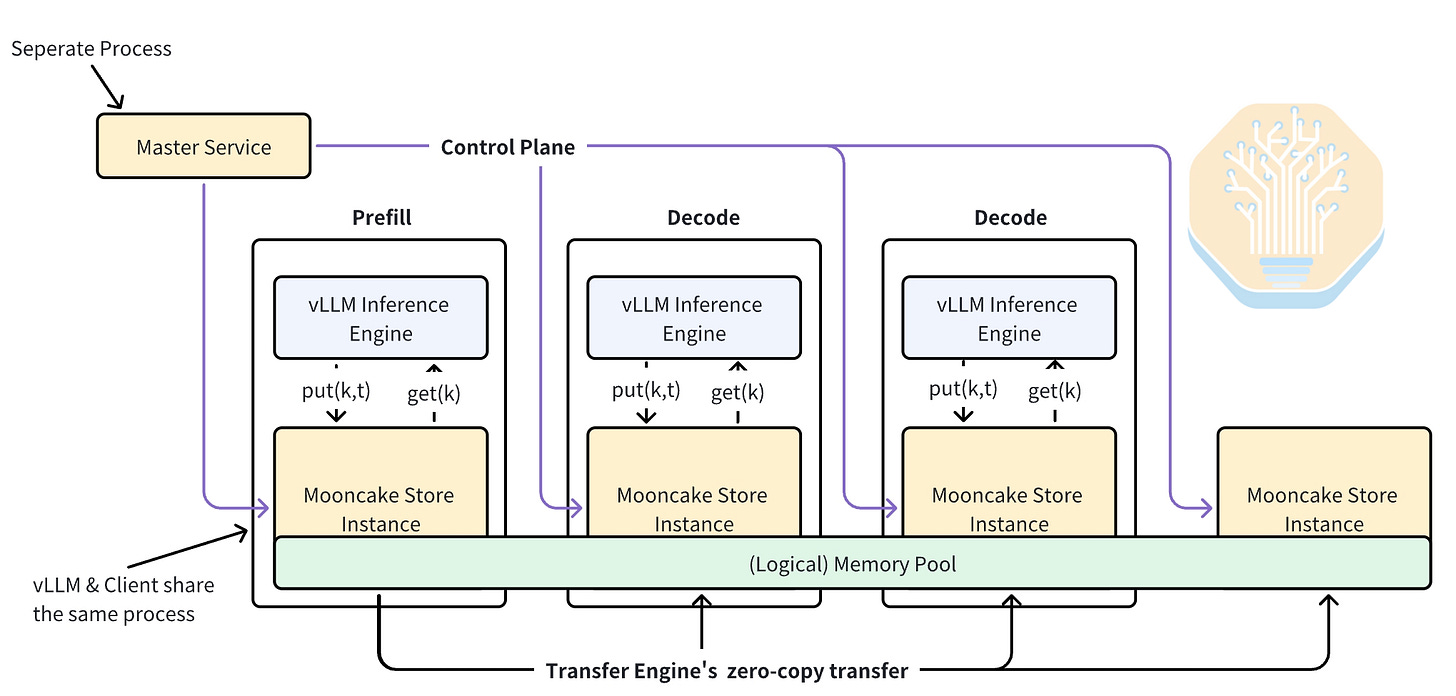
Source: Mooncake
此外,Mooncake Store 除了支持 WEKA/Vast 等传统分布式文件系统后端之外,还将多台服务器的 NVMe 存储汇聚为一个统一的逻辑存储池。
AgentX TPU
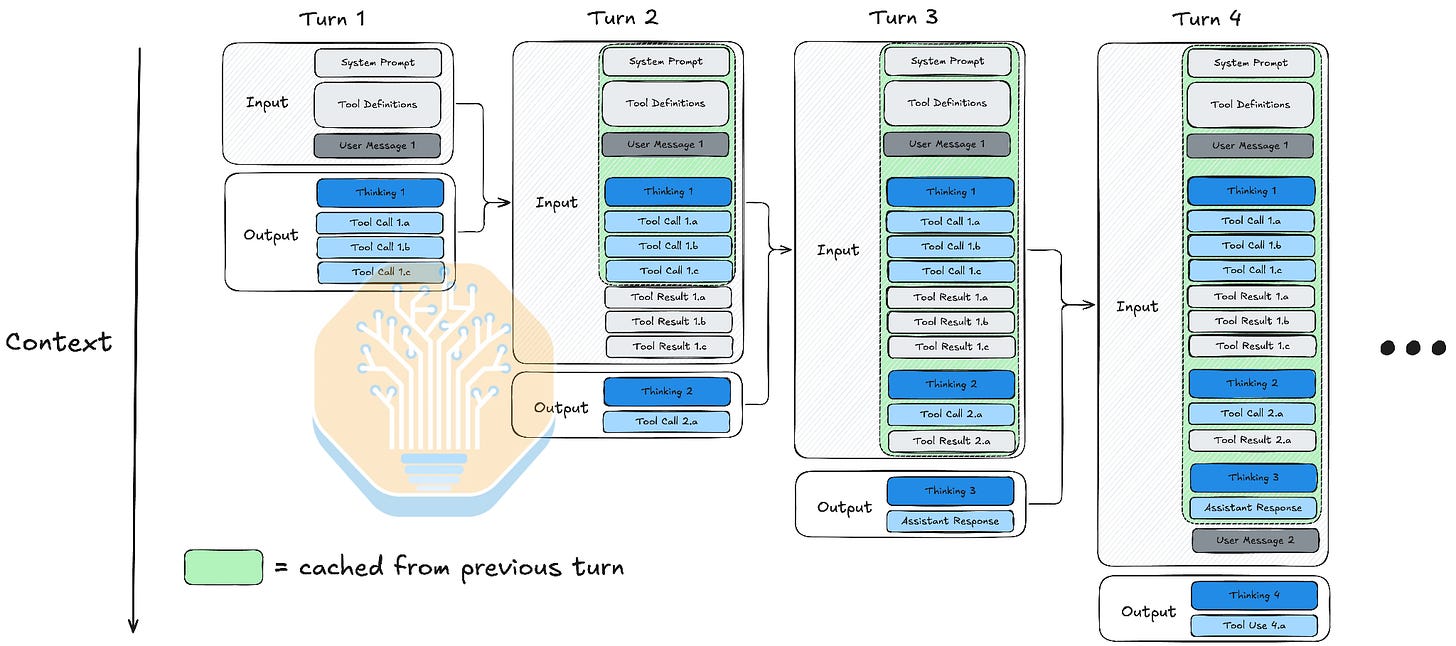
对于长上下文、多轮次的智能体(agentic)工作负载来说,KV-cache 卸载尤为重要,因为优化的 KV-cache 存储可以实现很高的 KV-cache 命中率。
总体而言,智能体工作负载具有四个特征:
- 多轮次:一个会话包含用户与助手之间的数十甚至数百次交互,而聊天机器人场景中通常只有寥寥几次。这类工作负载将长上下文和高预填充(prefill)复用与子智能体突发请求及大量工具调用结合在一起。
- 长上下文:系统提示词、工具定义以及大量的轮次使上下文迅速累积。
- 高前缀复用率:由于对话是线性推进的,第 n-1 轮的输出(通常)会被拼接到第 n 轮,因此大部分上下文可以直接从 KV cache 中获取,而无需重新计算(这取决于可用于存储 KV 张量的存储容量)。随着 n 的增长,已缓存的输入相对于未缓存输入的比例通常趋近于 1。
- 子智能体突发:一个会话会启动多个具有全新上下文的短生命周期子智能体,从而产生突发性的 KV-cache 访问模式。
我们了解到,许多 Google TPU 客户已经在询问 AgentX 的性能结果,我们很高兴地宣布,我们也正在努力将 TPU 引入 AgentX!
Source: DeepSeek, SemiAnalysis
Ironwood 没有原生 FP4 支持,因此目前公平的对等比较对象是 FP8 的 Blackwell:FP8 对 FP8 不存在质量损失,而 FP4 对 FP8 则会给 FP4 一侧带来质量差异。Google 的 TPUv8i 具备原生 FP4 加速能力,因此当我们把 TPUv8i 引入 InferenceX/AgentX 后,我们将进行 FP4 对 FP4 的比较。
SemiAnalysis 是一份依靠读者支持的出版物。如需接收新文章并支持我们的工作,欢迎考虑成为订阅用户。
我们坚信,在原生 TorchTPU 的稳定基础之上构建原生的 vLLM 和 SGLang 支持,是 TPU 对外开放(externalization)的正确方向。TorchTPU 旨在取代之前的 TorchAX 技术栈,后者很快将被弃用。Google 下一步将致力于让 Kimi K3 和 GLM5.3 在 AgentX 等单轮次和/或智能体工作负载上运行,同时也会支持 Google 自家的开放权重模型(如 Gemma4)。一旦有若干模型在 TorchTPU 技术栈上运行起来,后续新增模型将变得容易得多,TPU 支持也将更接近在模型发布当日(day 0)就能就绪。
罗马不是一天建成的,所以我们不应期待 TPU 的对外开放会一蹴而就。但我们坚信,这一进程正在以极快的速度推进。
TPU 高性价比总拥有成本
我们在 SemiAnalysis AI TCO Model 中详细列出了 TPUv7 的完整 BOM 和 TCO 估算。以下是其结构性概览。