← 全部文章
AgentX - InferenceXv3: Does CUDA Moat Hold up in Agentic Inferencing?
2026-08-24 · 原文
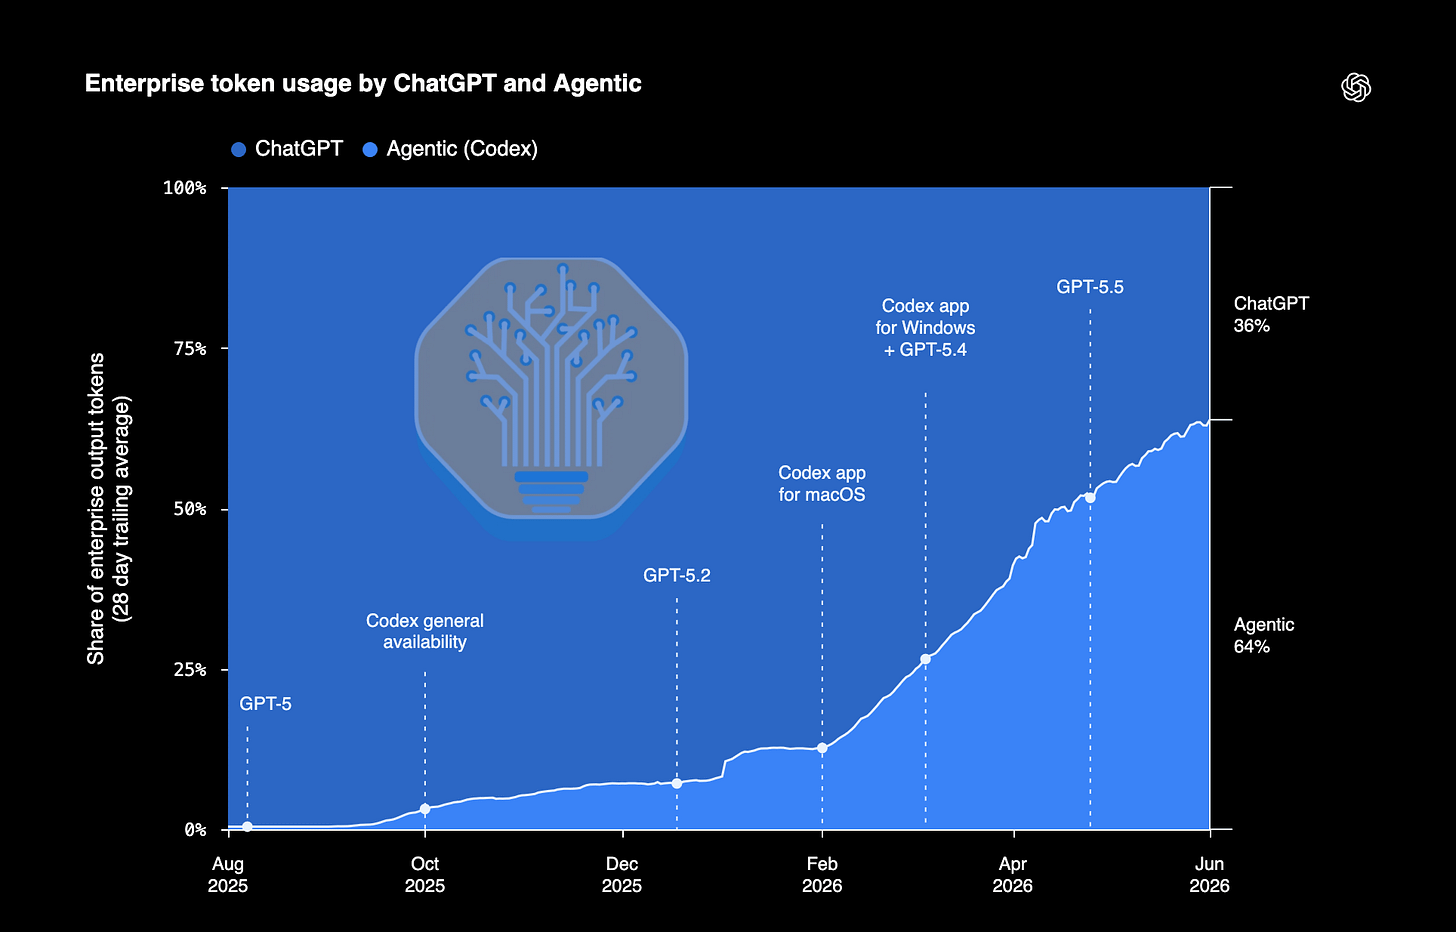
自2025年11月Claude Code迎来转折点以来,长上下文、多轮Agent工作负载迅速增长。它们现在主导着生产环境推理的流量。2026年4月,OpenAI的企业级Agent支出超过了ChatGPT的支出。
Agent工作流已经明确接过了接力棒。今天,我们发布AgentX 1.0——这是全球首个完全开源的多轮Agent编码推理基准测试,支持100万上下文,采用Apache 2.0协议发布。我们的完整仪表板可在此处访问。
Source: SemiAnalysis
过去,大多数人基于固定序列长度的预填充和解码工作负载来衡量性能。但这并不是衡量工作负载的准确方法。真实场景是多轮、长上下文、高预填充复用,并伴随子Agent突发请求、KVCache卸载以及大量工具调用。因此,我们旨在为行业构建一种衡量AI软硬件性能的正确方法。
我们花费了超过300万美元构建这个数据集。今天,我们将其全部开源。InferenceXv3实现了AgentX,在现有的“固定序列长度”场景(8k1k、1k1k、1k8k)之外,增加了一个全新的真实场景。它使用Agent编码流量替代了之前8k输入和1k输出token的单轮流量,从而改进了基准测试场景。
完整的测试矩阵在约2MW的持续运行算力上运行,涵盖超过1000个芯片,涉及广泛的SKU型号。其中包括MI355X、GB300 NVL72、GB200 NVL72、B300、B200、MI325、MI300X、H200和RTX Pro Servers。Rubin将于本月晚些时候登场,而TPU和Mi455X UALoE72将在今年晚些时候推出。如果您认为我们的免费开源工作有价值,请在GitHub上为我们点个Star。
令人高兴的是,NVIDIA和AMD在Agent工作负载上都展现出了出色的性能。NVIDIA在许多前沿模型上表现优异,而AMD在一些特定对比中的某些前沿模型上也表现良好。
Source: SemiAnalysis GitHub
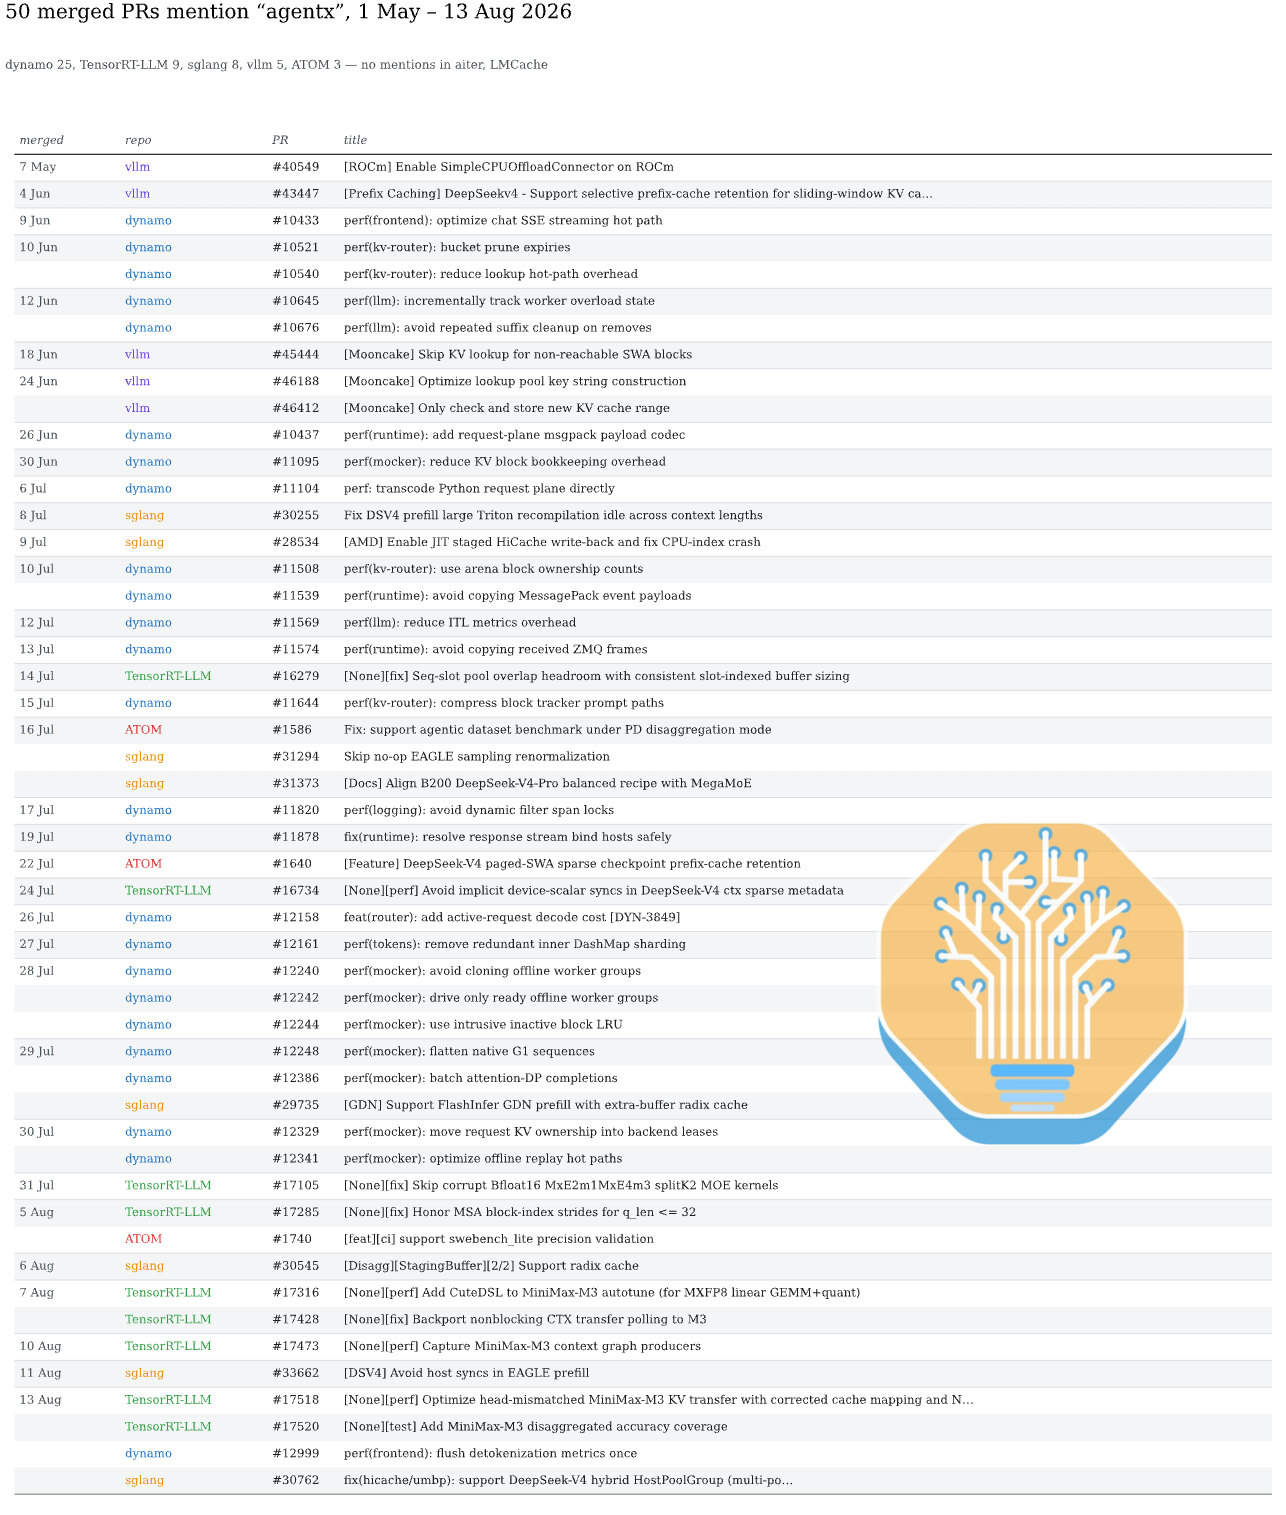
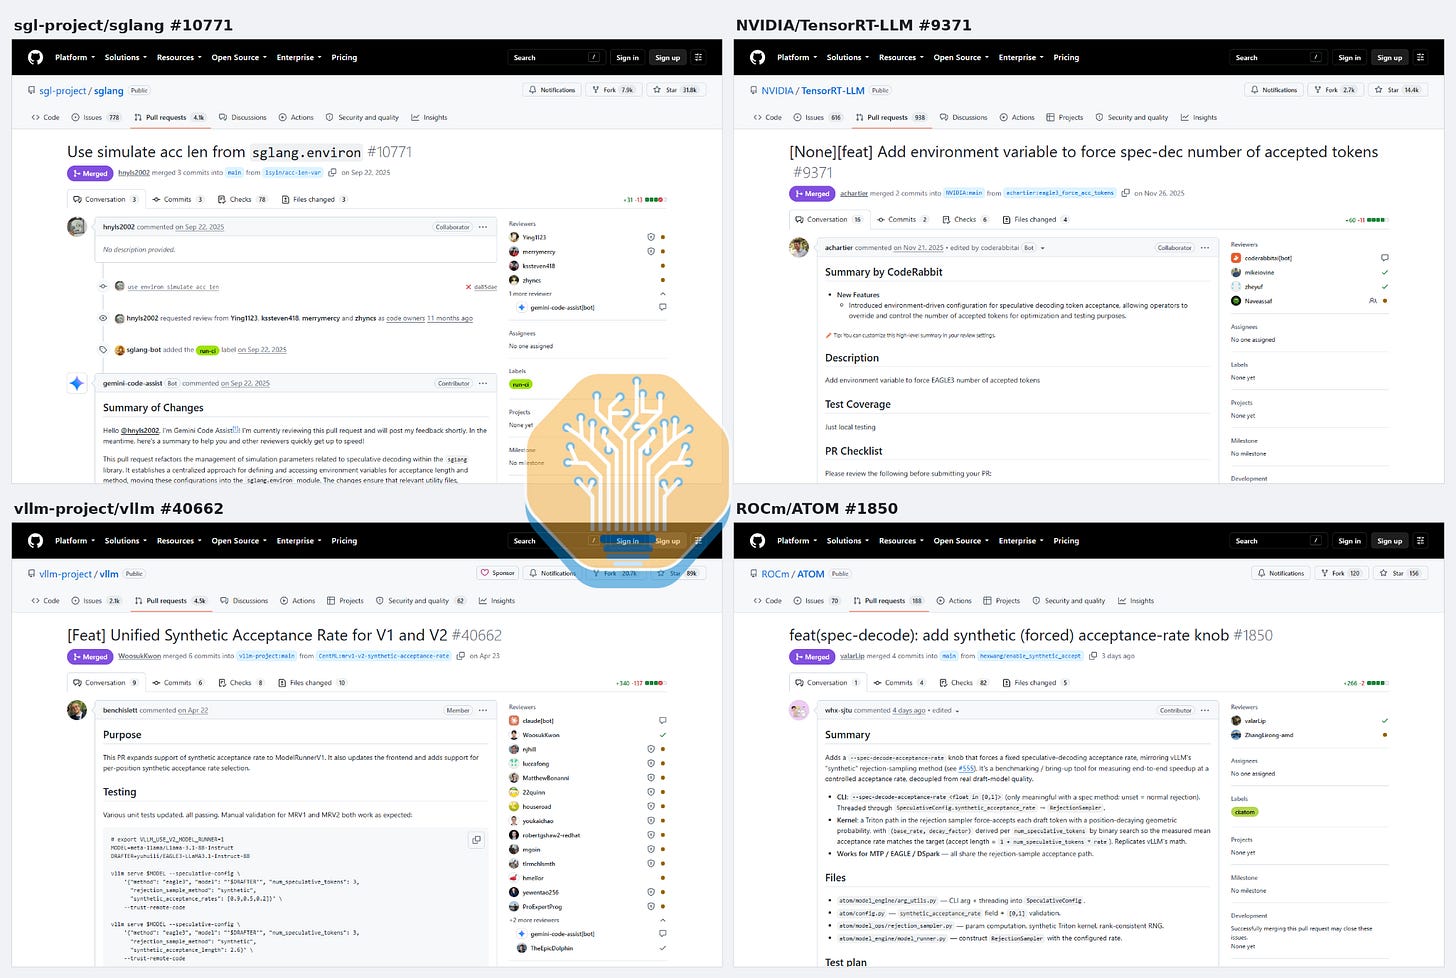
AgentX在头几个月产出的最有价值的成果并非初始测试结果。而是该基准测试已经产生的巨大行业影响。针对vLLM、SGLang、TensorRT-LLM、ATOM、AITER、Dynamo、LMCache和Mooncake,已有超过70个上游PR用于优化真实生产环境的Agent工作负载,这些优化均将AgentX作为北极星基准测试代理。这些优化改进大部分都可迁移到生产流量中。我们将在文章后面对每项优化进行深入探讨。
Source: SemiAnalysis
开源是InferenceX的核心原则。因此,相比大多数使用这个词的人,我们开放了更多的技术栈。这包括开放的前端、通过易于使用的REST API提供的公共数据库(多个顶级AI实验室的容量规划团队已经在使用该API)、公开的GitHub Actions CI来源、日志,以及每个数据点的准确性验证。至关重要的是,我们的基准测试配置主要在上游镜像上跟踪 recipes.vllm.ai 和 SGLang cookbook。这样我们衡量的是真实客户所体验到的性能,而不是去测试经过特殊基准优化的镜像。
在三到四周内,我们将发布一篇 AgentX 更新文章。内容将涵盖对智能体(agentic)工作负载的进一步优化,以及来自 AMD 和 Nvidia 的最新性能测试结果。需要指出的是,智能体工作负载的特征正在快速演变。InferenceX 将继续保持敏捷,对相关工作负载进行基准测试。
InferenceX 百分之百致力于开源——如果没有 OSS 合作伙伴的贡献与支持,这一切都将无法实现。我们要感谢以下对 AgentX 1.0 的发布做出巨大贡献的人士:
Inferact/vLLM:Roger Wang、Yifan Qiao、Simon Mo、Jeff Ma 等众多贡献者 RedHat/llm-d:Michael Goin、Robert Shaw、Tyler Michael Smith RadixArk/SGLang:Baizhou Zhang、Yuwei An、Mingyi Lu 等众多贡献者 LMCache/TensorMesh:Samuel Shen Weka:Callan Fox、ValB MoonCake Maintainers:Teng Ma、Xu Wenjie、Ke Yang AMD:Thomas Wang、HaiShaw、Andy Luo、Seungrok Jung、Chun Fang、Parth Panchal、Bill He、Theresa Shan、Hongxia、Fangzhou、Gilbert Lei、Yanfei Wang、Duyi Wang、Peng Sun、Lingpeng Jin、Simon Danielsson、Xiaohu Guo、Haichen Zhang、Chang Liu、Doug Lehr、Poovaiah Palangappa,以及 AMD 上海研发中心的许多其他同事 Nvidia:Xin Li、Anthony Casagrande、Kedar Potdar、Ankur Singh、Ishani Dhanani、Nick Comly、Nvidia 上海 TensorRT-LLM 团队及众多其他贡献者 Anthropic 团队,感谢他们迅速修复了多个 Bug,使 AgentX 的实现成为可能 GitHub:感谢 Austen Stone 协助提升 AgentX 所使用的 GitHub Actions 的可靠性 以及许多其他贡献者 此外,我们还要感谢所有支持我们开源 InferenceX 倡议的企业与机构,包括 Meta、Microsoft、Oracle、OpenAI、MiniMax、Moonshot Kimi、Alibaba Qwen 和 Zhipu GLM。
Source: InferenceX
智能体工作负载简介
从宏观层面来看,智能体工作负载具有四个显著特征:
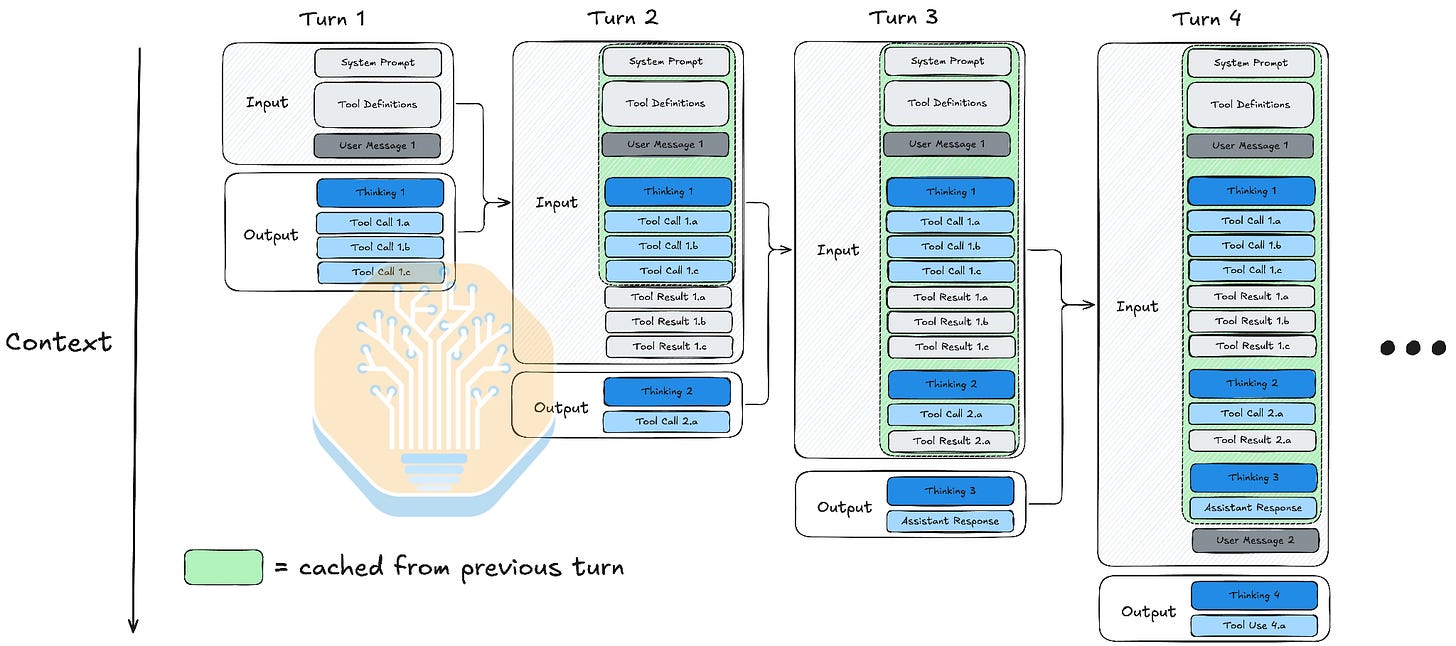
多轮交互:与聊天机器人场景中寥寥几轮的交互不同,智能体会话包含大量的用户与助手交互(数十甚至数百次)。这种多轮交互伴随长上下文、高前缀复用率,并存在子智能体突发调用和大量工具调用的情况。 长上下文:系统提示词、工具定义以及大量的交互轮次,使得上下文长度迅速累积。 高前缀复用率:由于对话呈线性推进,第 n-1 轮的输出通常会拼接到第 n 轮的输入中,因此大部分上下文可以直接从 KV 缓存中读取,而无需重新计算(这取决于可用于存储 KV 张量的存储容量)。随着 n 的增加,已缓存输入与未缓存输入的比例通常趋近于 1。 子智能体突发调用:一个会话会启动多个带有全新上下文、生命周期短暂的子智能体,从而形成突发性的 KVCache 访问模式。 Source: DeepSeek, SemiAnalysis
考虑到上述特点,对这些工作负载进行基准测试,与现有的固定序列长度基准测试有着本质区别。也就是说,Agent推理本身就是一个系统问题。由于前缀复用率极高,必须跨节点/秩(rank)高效传输KV张量(NIXL、MORI-IO、Mooncake)。此外,为了最大化缓存命中率,不同的对话应根据匹配前缀所在位置被路由到不同的节点/秩(LLM-d、Dynamo、vLLM/SGLang router)。长上下文对话给KV缓存的HBM容量带来很大压力,必须将KV张量卸载到不同层级的内存(DRAM、SSD),而且这一过程需要高效执行(Mooncake Store、LMCache、vLLM Simple Offloading、SGLang HiCache)。
这与固定序列长度、单轮对话的工作负载截然不同。在这种工作负载中,前缀复用并不关键,推理性能主要反映芯片或kernel的基线性能。这并不是说InferenceX上海量的固定序列长度数据不重要。事实上,剥离Agent服务的复杂性后,可以更清晰地看出低层推理性能优化的进展。它也为AgentX的结果提供了重要的基线参考。
为了让AgentX工作负载尽可能贴近真实场景,我们收集了393条SemiAnalysis内部的匿名Claude Code执行轨迹,作为初始语料进行回放。为了在匿名化内容的同时保留原有的前缀复用模式,我们采用了类似Qwen-Bailian数据集的方法。这是最早的生产环境执行轨迹语料库之一。随后,我们使用AIPerf,在多级并发客户端条件下,按照原始的请求调度时间线重建了这些轨迹。我们与Anthropic合作上线了两个Claude Code功能,才使AgentX数据集得以成形。在此感谢Anthropic团队的帮助。
https://github.com/anthropics/claude-code/issues/49207 https://github.com/anthropics/claude-code/issues/66761 关于Agent工作负载的简要介绍,应能为读者理解下一节的结果提供充分的背景知识。在后面的章节中,我们将对方法论、回放测试工具以及数据集进行更深入的技术探讨。
Agent编码推理性能
在评估编码推理性能时,OpenAI、Anthropic、xAI等前沿实验室主要关注三点。分别是单位美元性能与交互性(TPOT)的关系、TTFT(首字响应时间)以及整体端到端任务完成情况。每兆瓦性能同样不可忽视。毕竟,陆地数据中心的电力供应是核心瓶颈(金钱只是社会建构,这些实验室的资金仿佛取之不尽,但在当今时代,算力所需的电力却难以轻易获取)。我们的数据中心模型对电力需求与供给的逐季度增长情况进行了估算。
在本节中,我们将重点介绍前沿模型在智能体整体性能方面的一些趋势。我们强烈建议读者以此为参考,亲自去探究相关结果。所有数据均为开源,社区有机会针对当前真实世界推理性能的状态,得出自己的结论。
DeepSeek V4 Pro 0813
DeepSeek V4 Pro 0813 是一款来自中国的广受欢迎的前沿开放权重模型。该模型拥有约 1.6 万亿个参数,其中激活参数量为 490 亿。
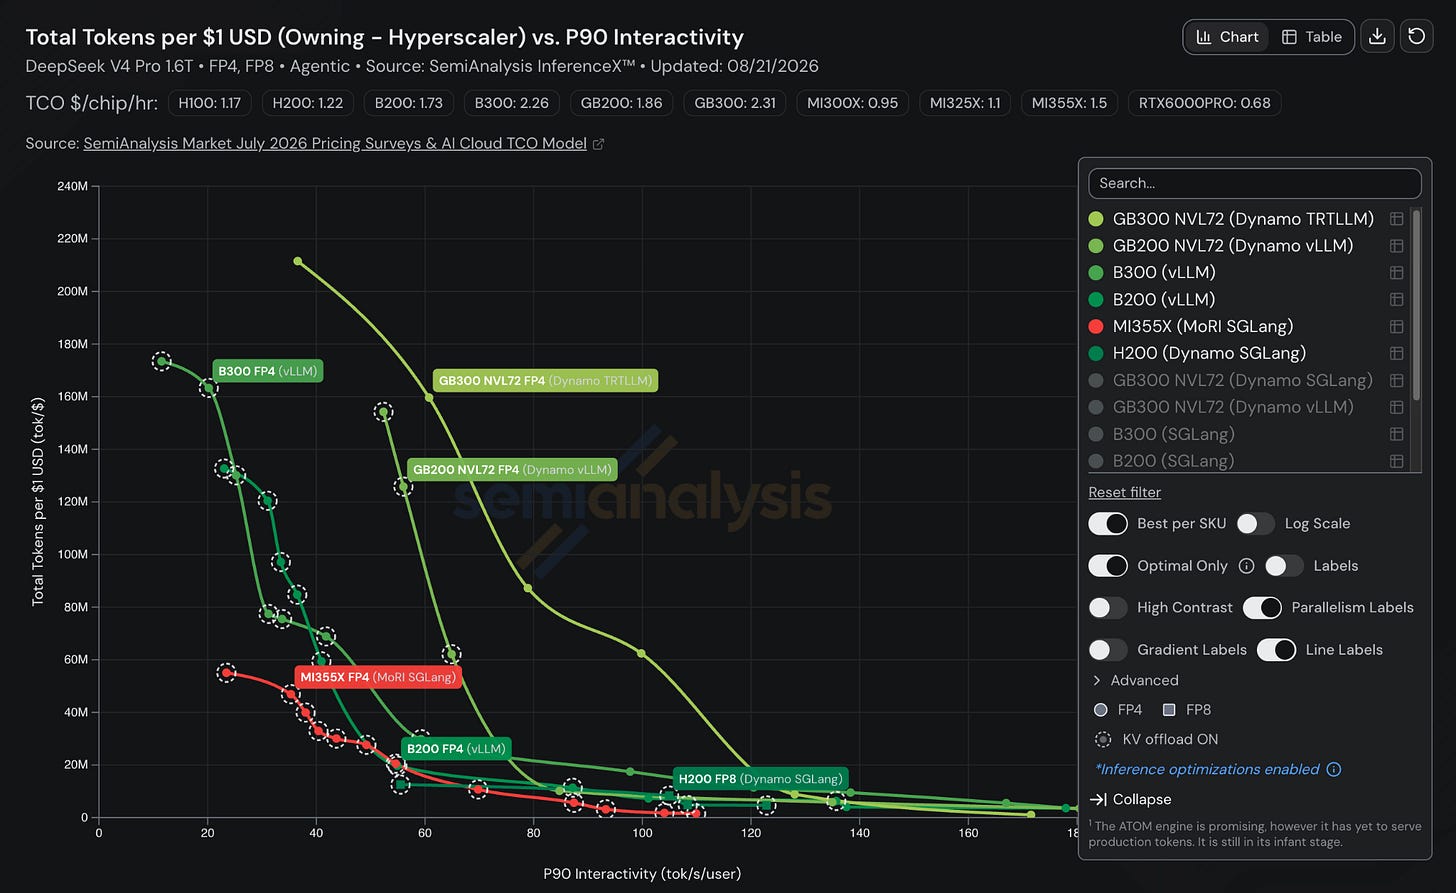
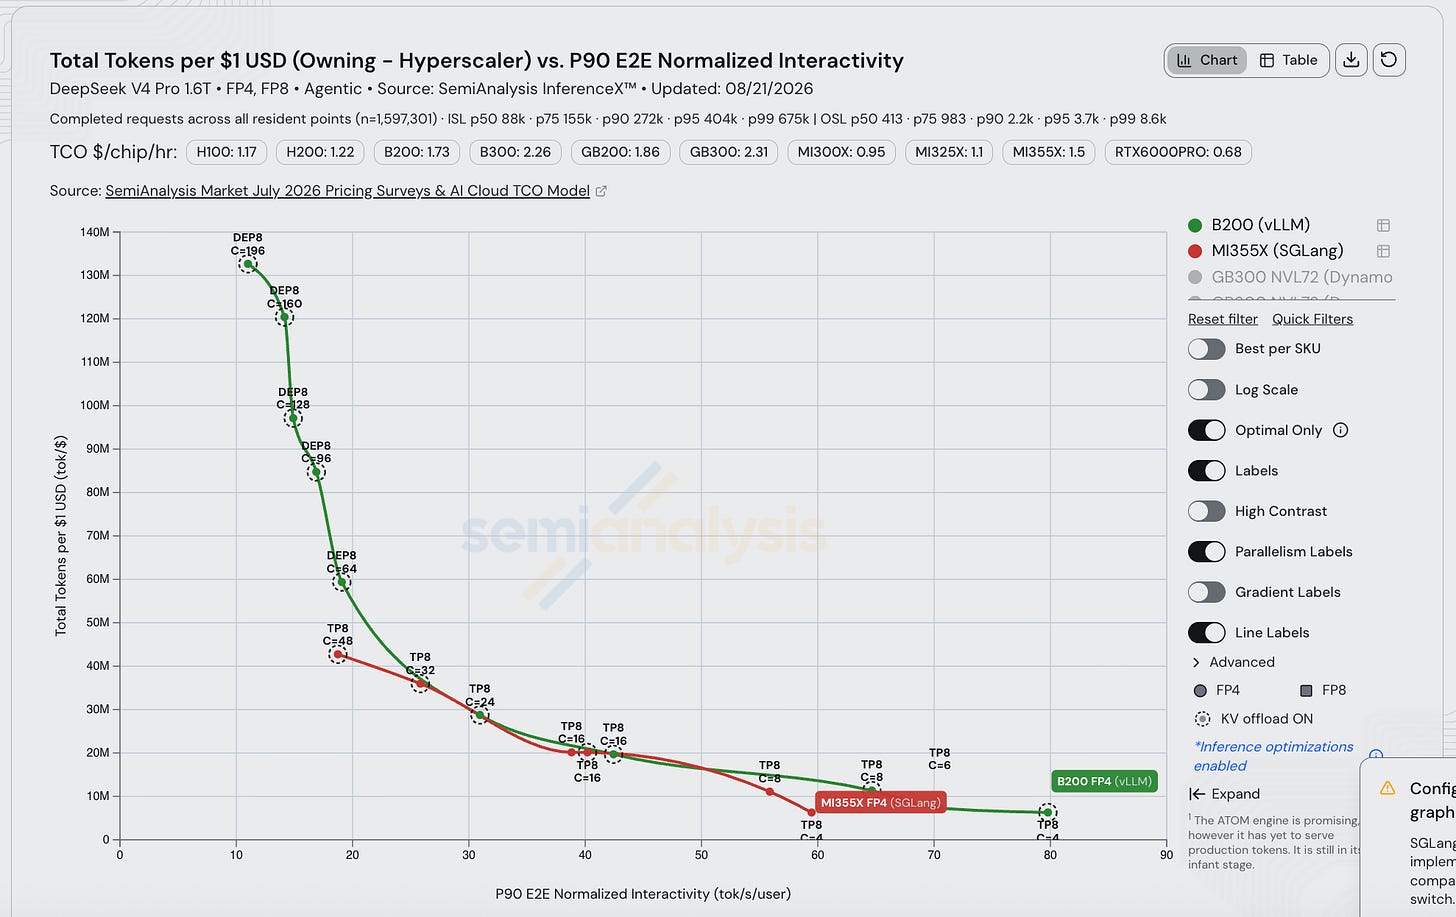
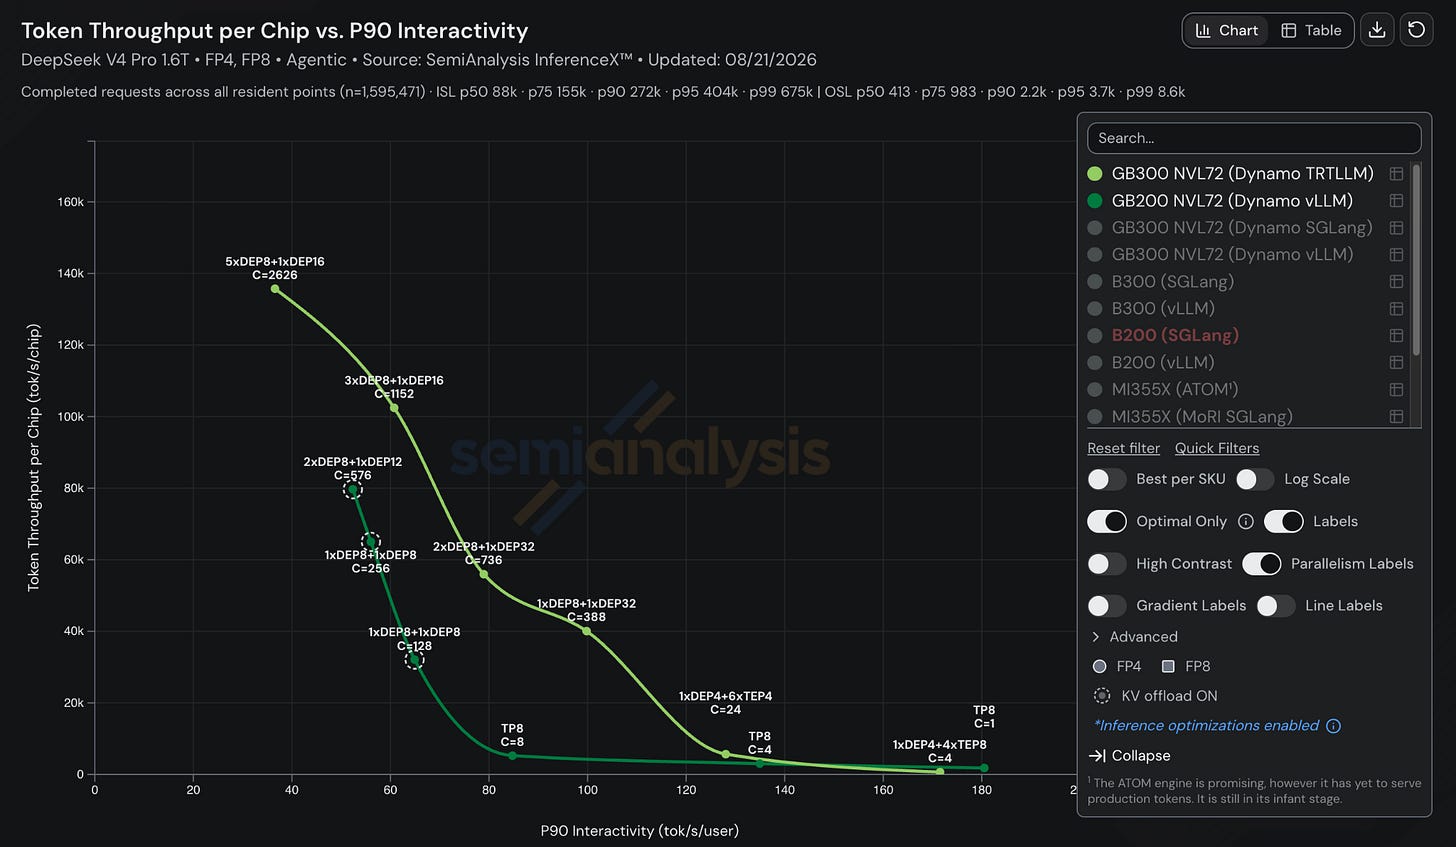
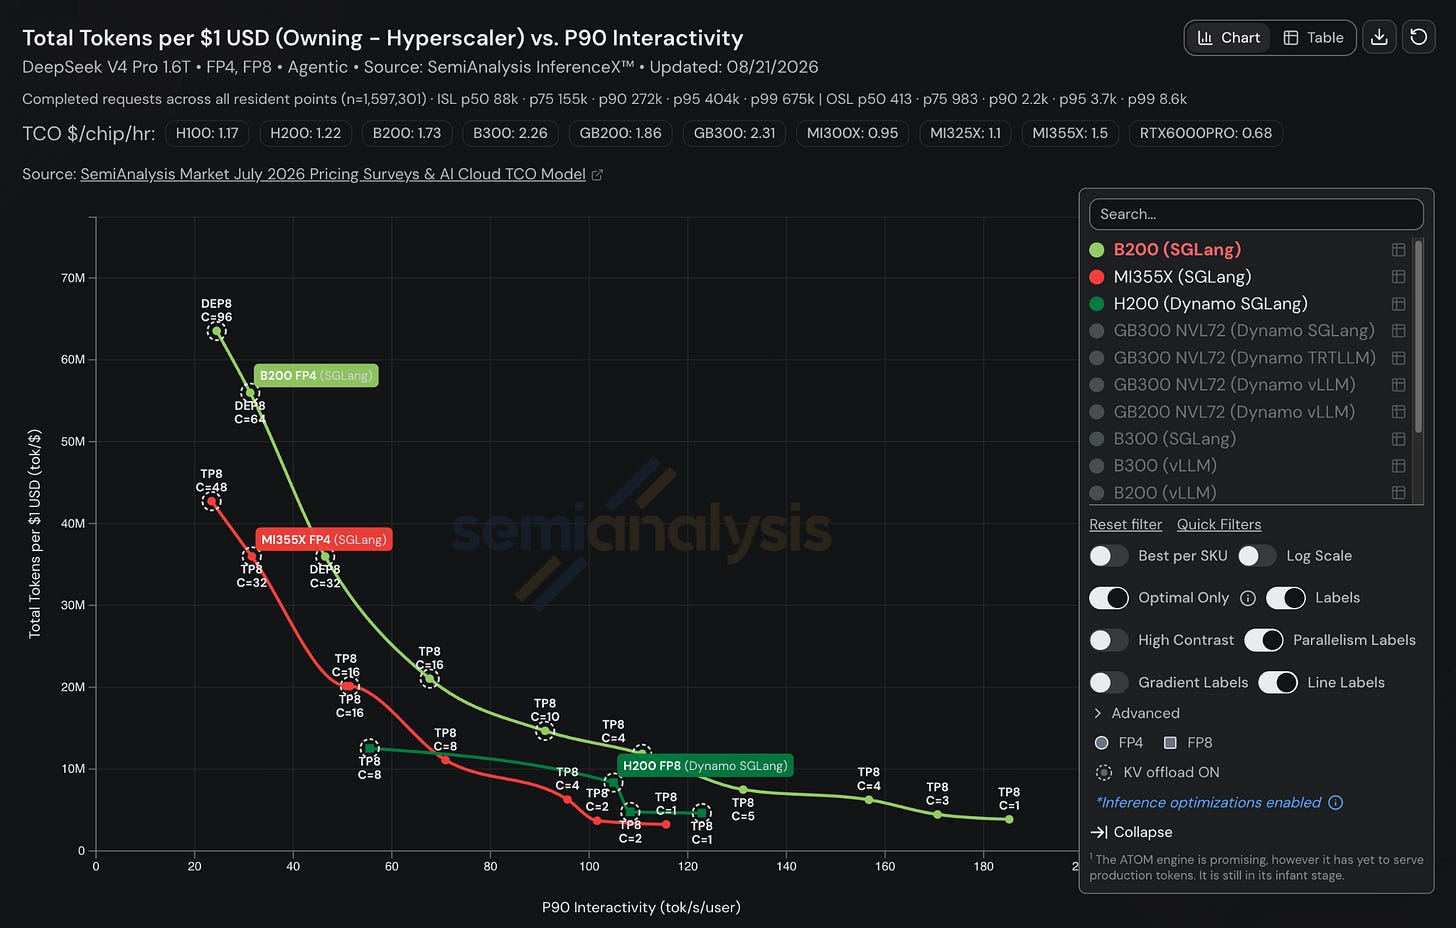
截至 8 月 21 日,下图展示了所有提交中每个 SKU 的最佳性能,并按总拥有成本 (TCO) 进行了归一化处理。
在所有 DeepSeek v4 运行中,所有请求的 ISL/OSL 分布如下:ISL p50=88k,p90=272k,p95=404k,p99=675k;OSL p50=413,p90=2.2k,p95=3.7k,p99=8.6k。
Source: InferenceX
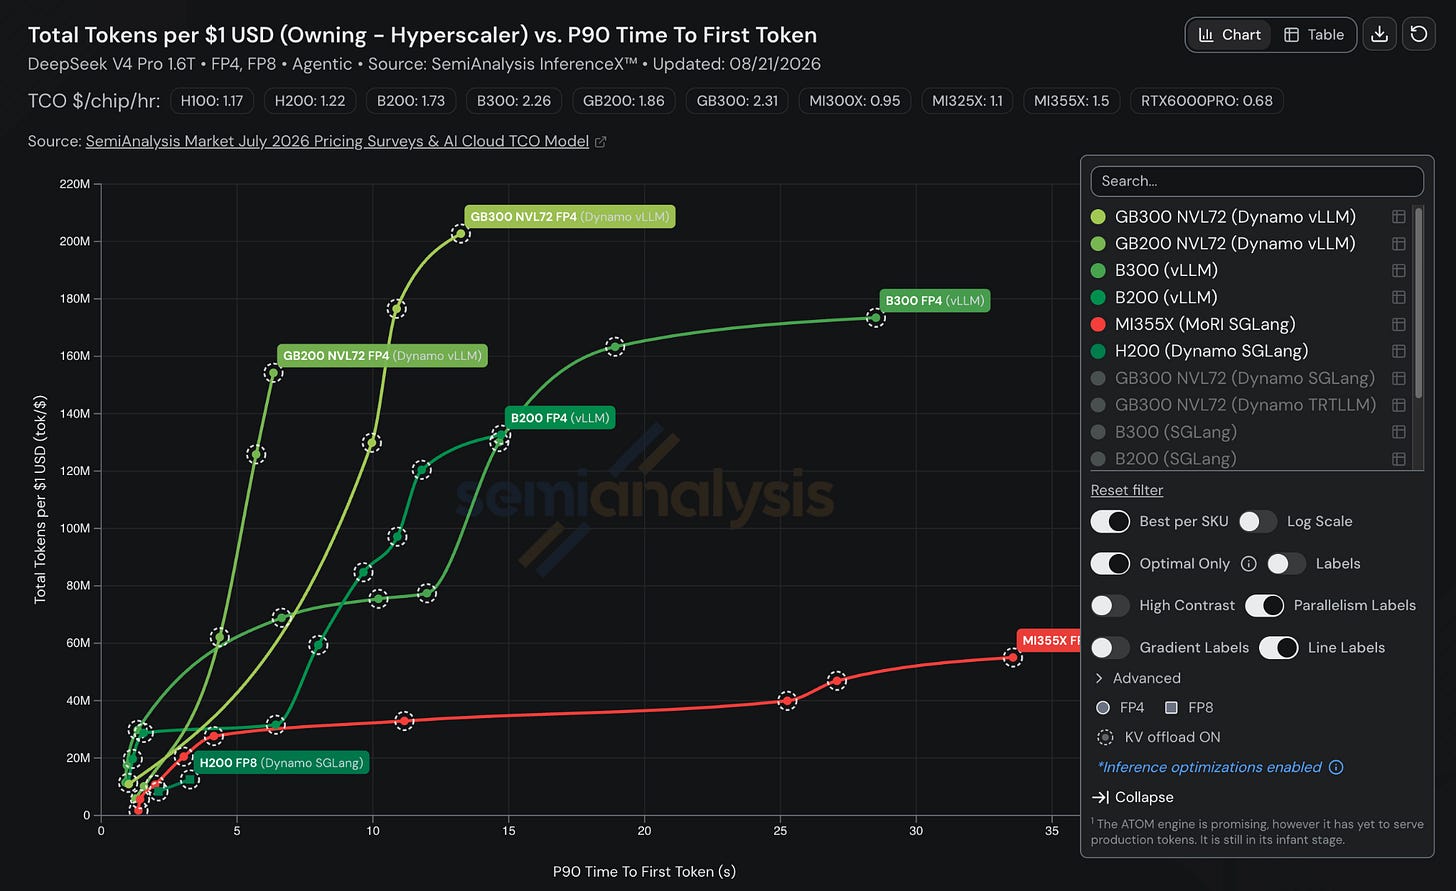
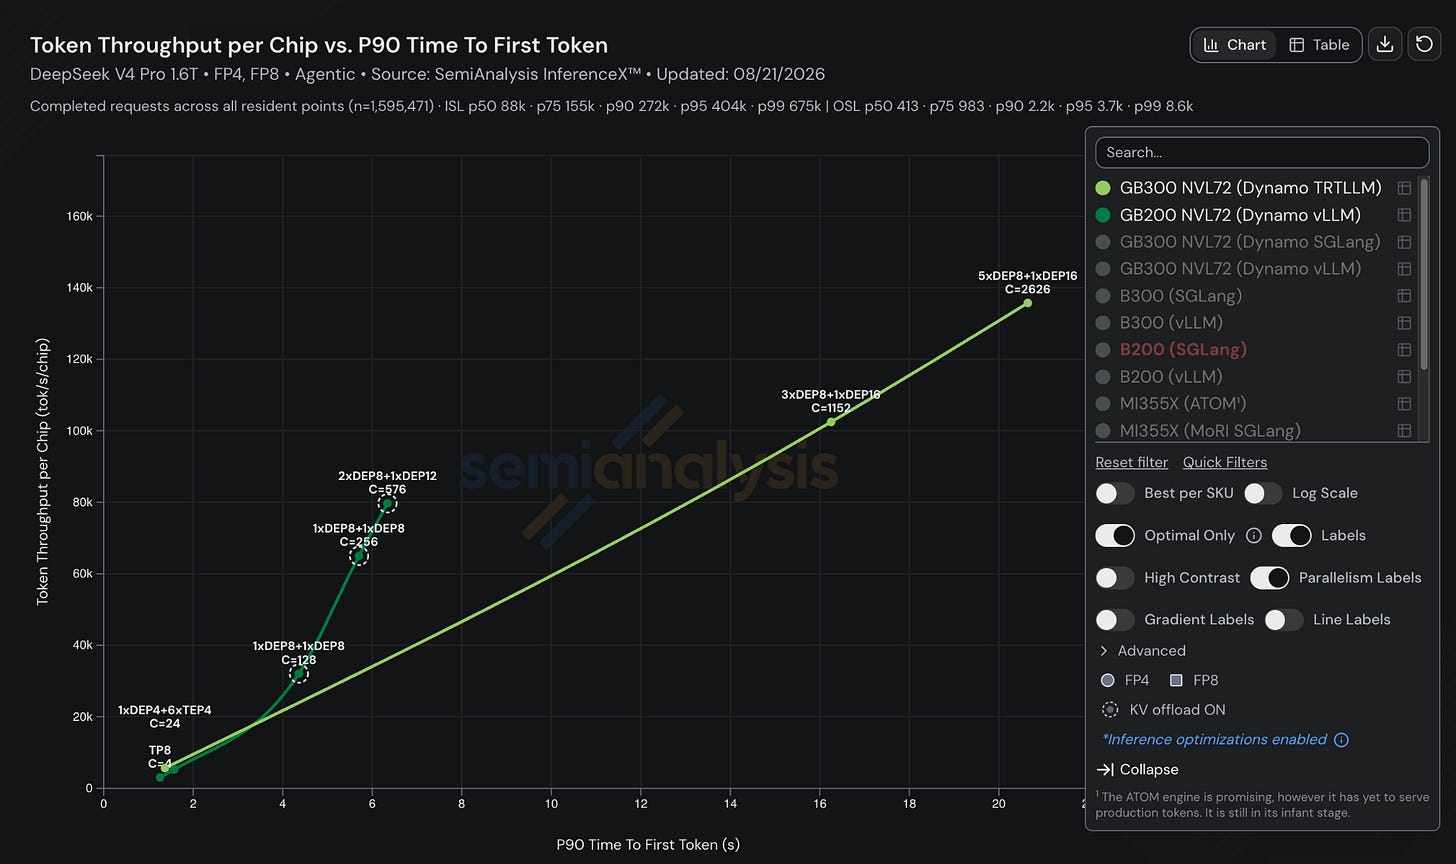
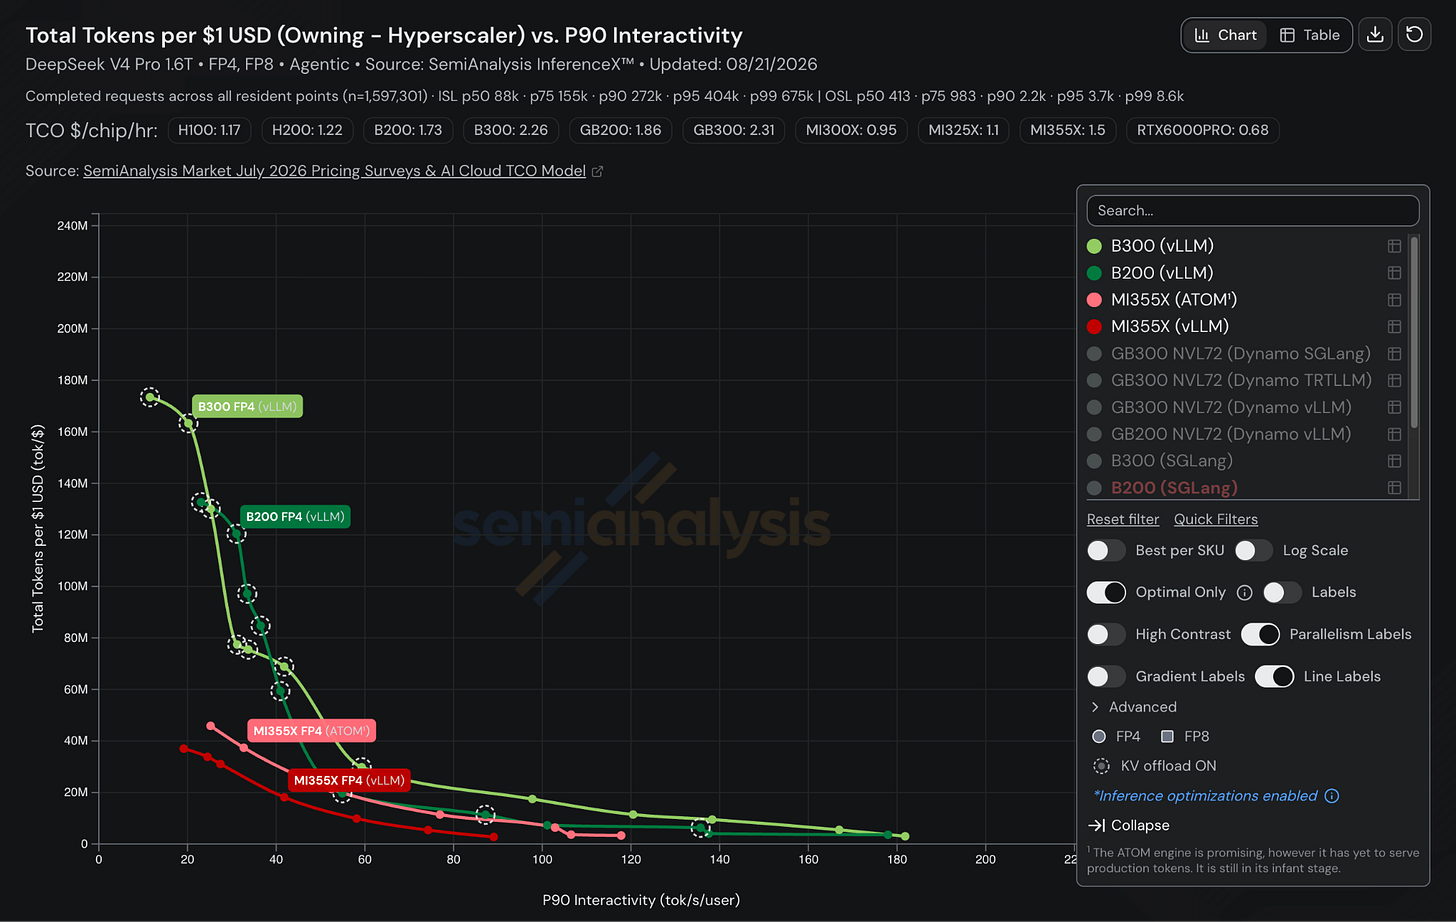
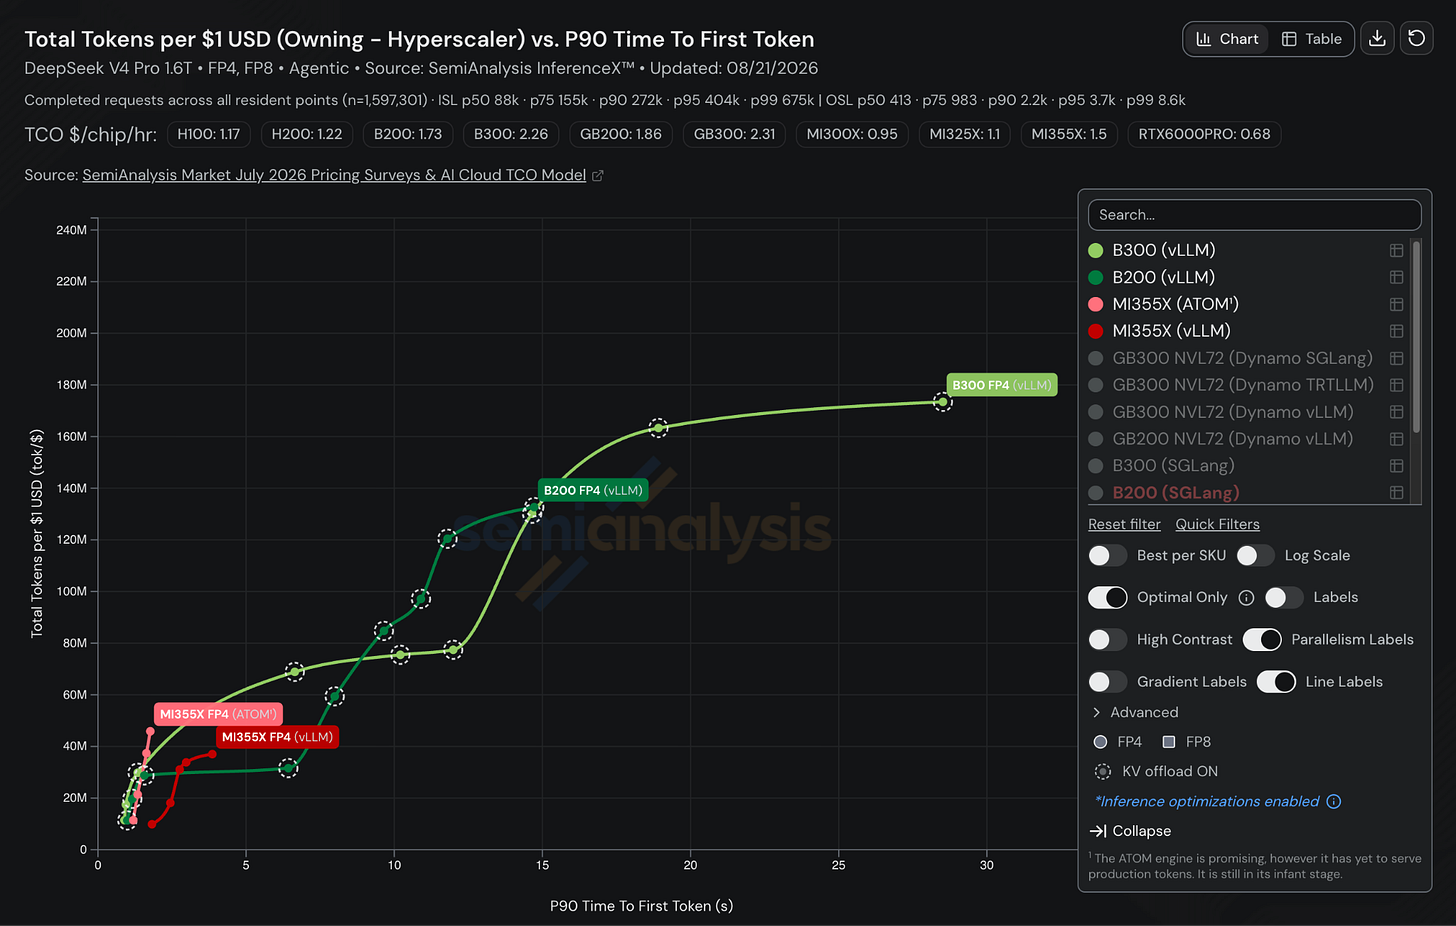
通常来说,同时考虑单用户每秒 Token 数(TPS,也称交互性)和 TTFT 非常重要,因为这两者往往此消彼长。例如,在上图中,某些 SKU 在保持不错的交互性的前提下实现了很高的吞吐量,但 TTFT 却严重下降。所谓“可接受”的 p90 TTFT,因应用场景而异,差异很大。对于大多数服务于智能体工作负载的生产系统来说,p90 TTFT 通常在 200-5000ms 之间。如果超过了 5-10 秒,就已经逼近“在线推理”的极限了。当然,在曲线的超高吞吐量区间,依然存在一些实际应用场景,在这些场景中延迟并不重要,反而更看重系统的高利用率(例如批处理、运行时间极长的智能体等)。
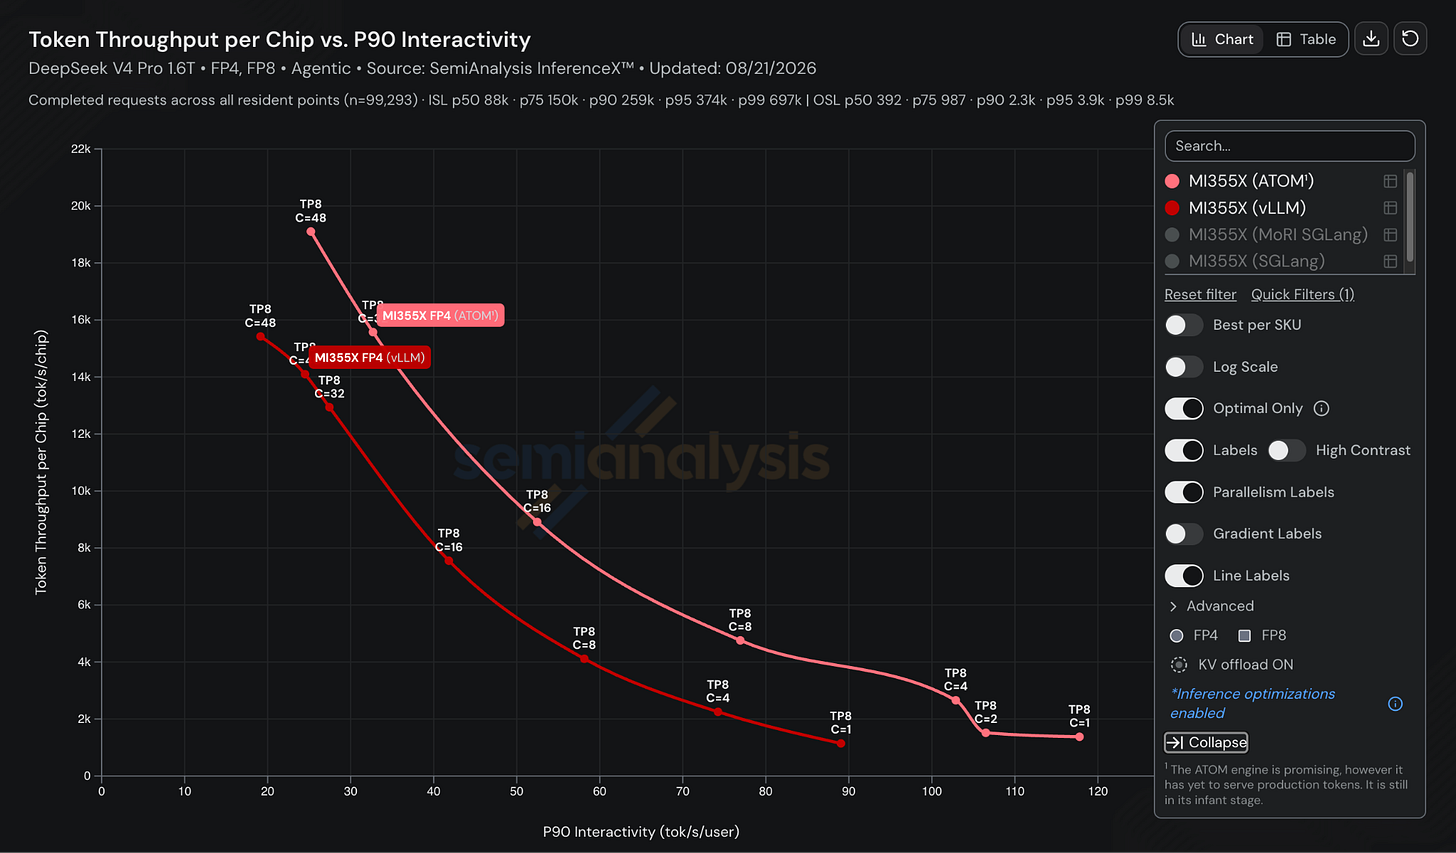
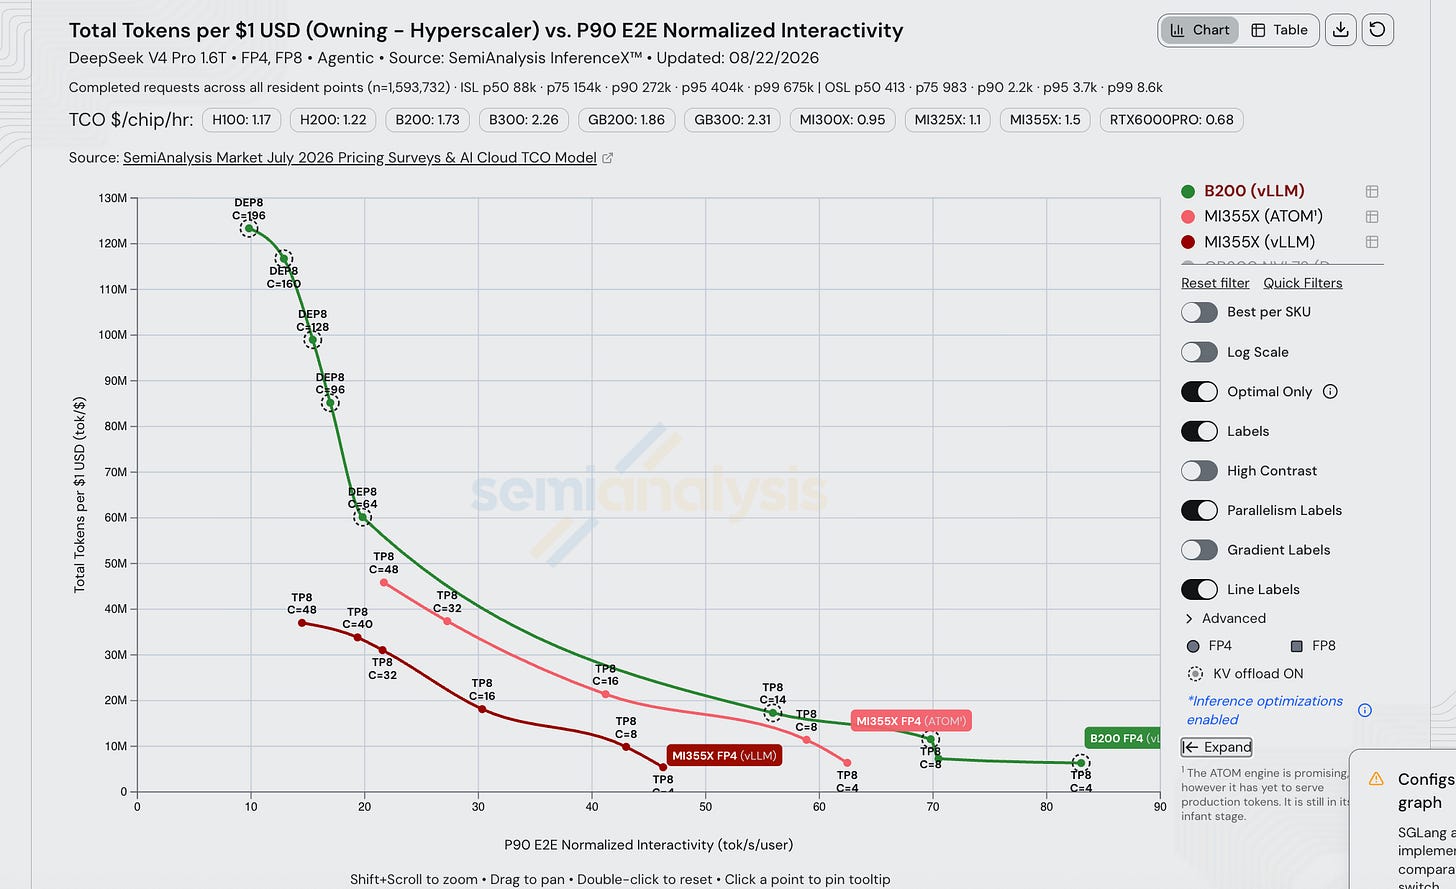
在单节点性能方面,MI355X 的开源实现(vLLM)性能落后于厂商专用的 ATOM(AMD 对标 TensorRT LLM 的产品)。AMD 正借助 ATOM 快速推进技术前沿,这一点非常出色。不过我们建议,他们应将向 vLLM 上游贡献这些改进放在更高优先级的位置。
Source: InferenceX
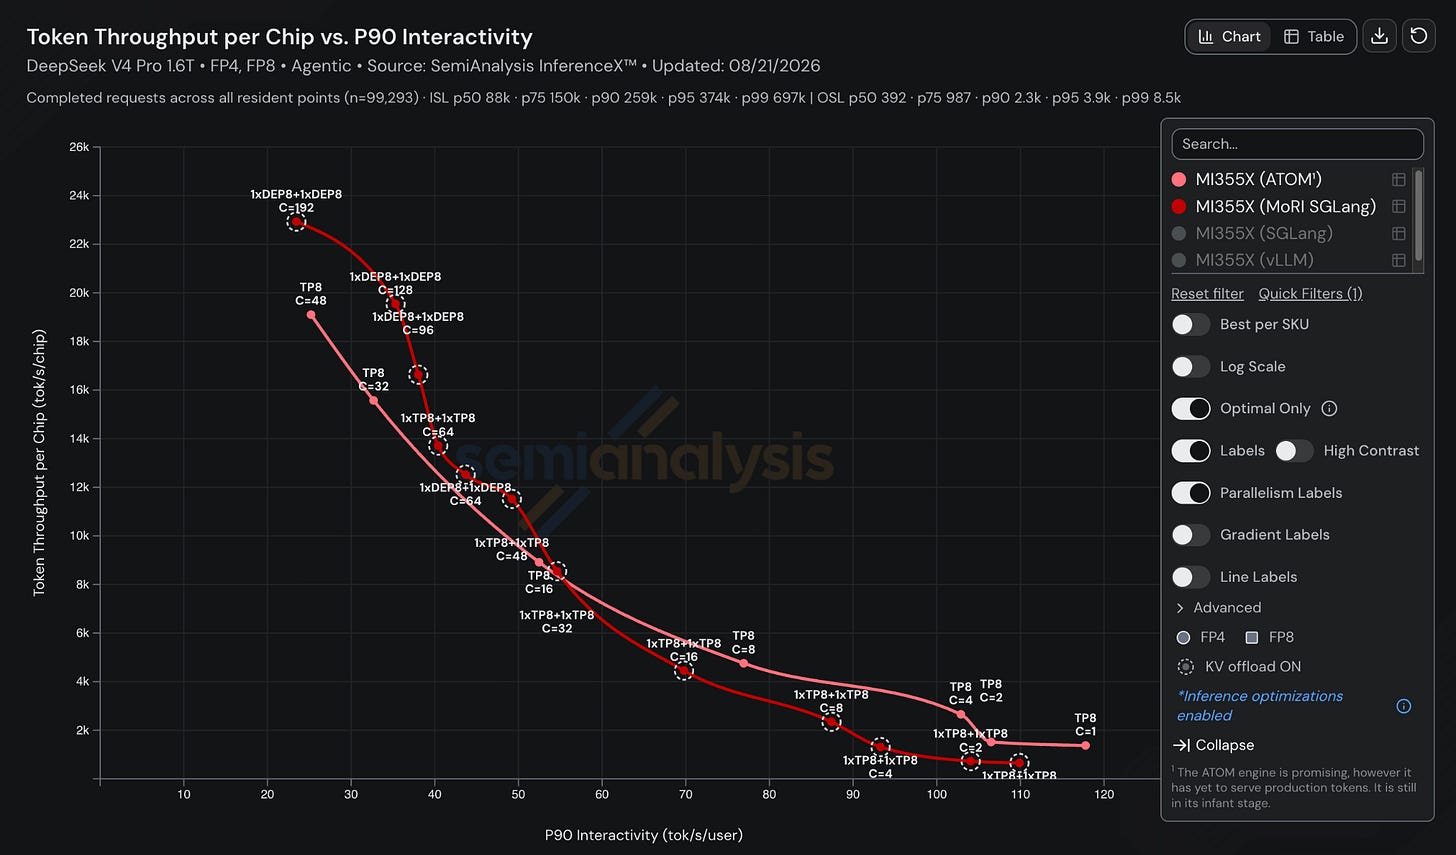
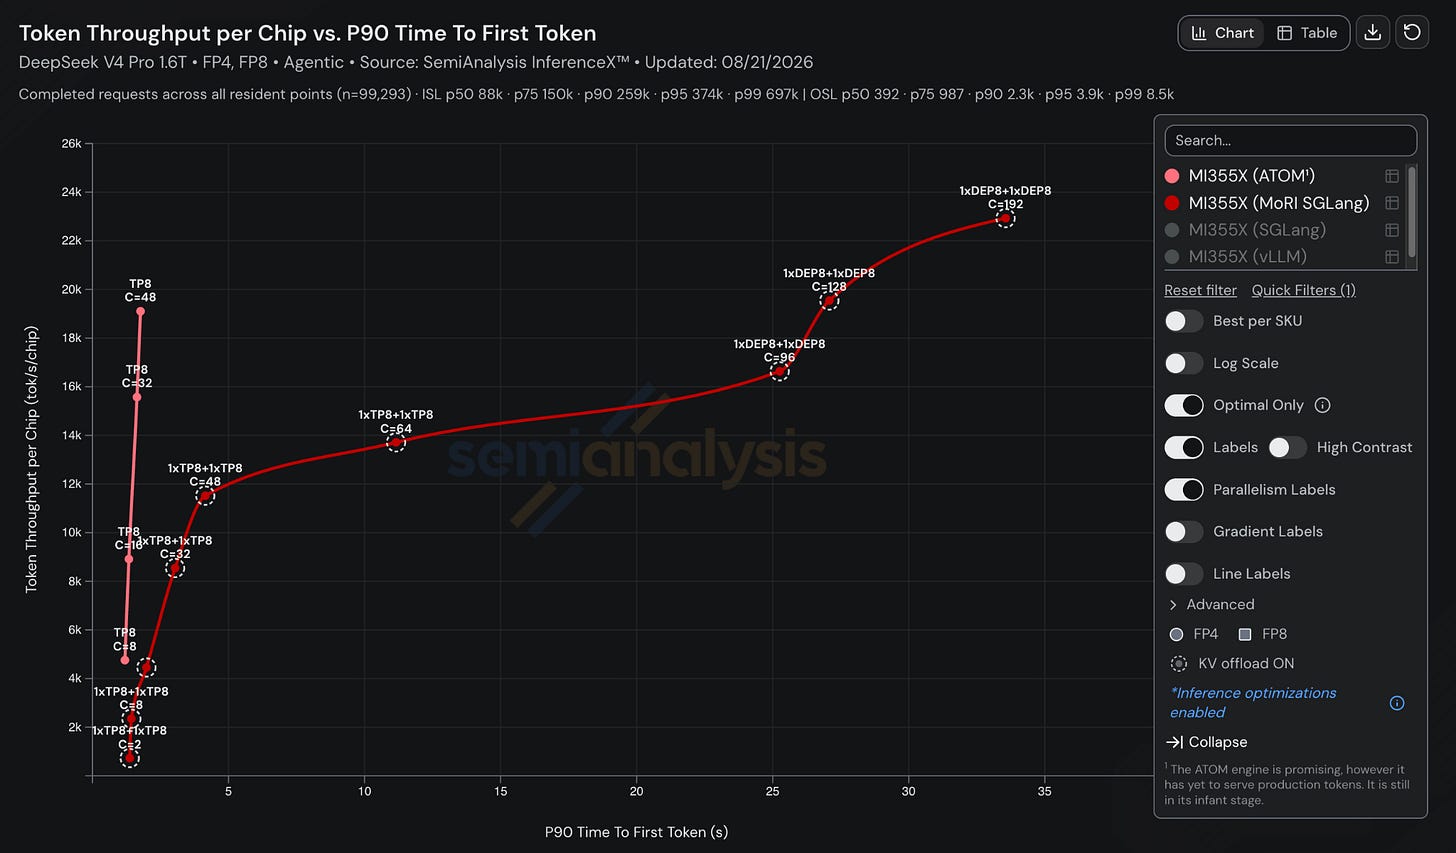
过去六个月里,AMD 的分布式推理 (DI) 团队在 8k1k 场景上取得了长足进展。不过,要使 DI 成为能够应对实际工作负载的可行方案,该团队仍有段路要走。在单 GPU 吞吐量与交互性的对比方面,我们发现 1xDEP8+1xDEP8 分离式配置仅在高吞吐场景下能带来微小的性能提升,而在低延迟场景中反而表现更差。
更糟糕的是,在中高交互性配置下,吞吐量的任何提升都被 p90 TTFT 的显著飙升所掩盖。原因之一是在并发量达到 64 时使用了 SGLang 的 --enable-prefill-delayer 参数。该参数会推迟 prefill 请求的接纳,以便 DP rank 能够组成更满的批次(最多可持续 30 次前向传播)。此外,这些配置点还将分块 prefill 的大小从 8192 增加到了 65536。
Source: InferenceX
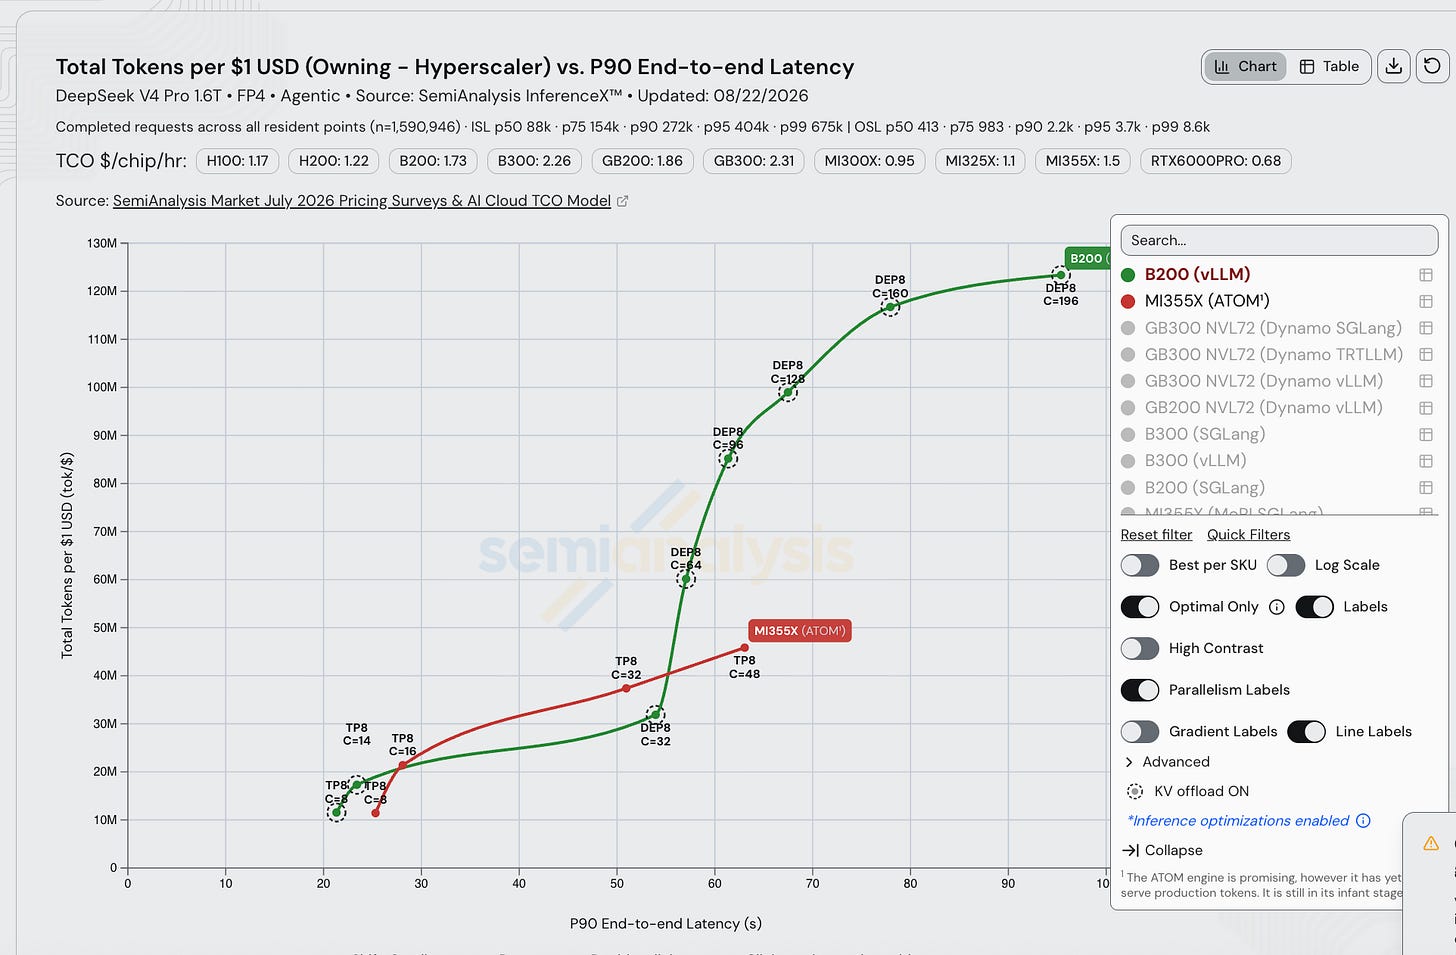
在端到端延迟方面,ATOM MI355X 超过了 B200 vLLM(不过它并没有超过 B300 或 B200 SGLang)。问题在于,由于缺少大量功能,中国或西方的大多数 AI 实验室都不愿在生产环境中使用 ATOM,目前只有阿里巴巴公司的一个小型广告业务部门在用。阿里旗下的主要 Qwen LLM 团队在生产环境中也并未使用 ATOM。
Source: InferenceX
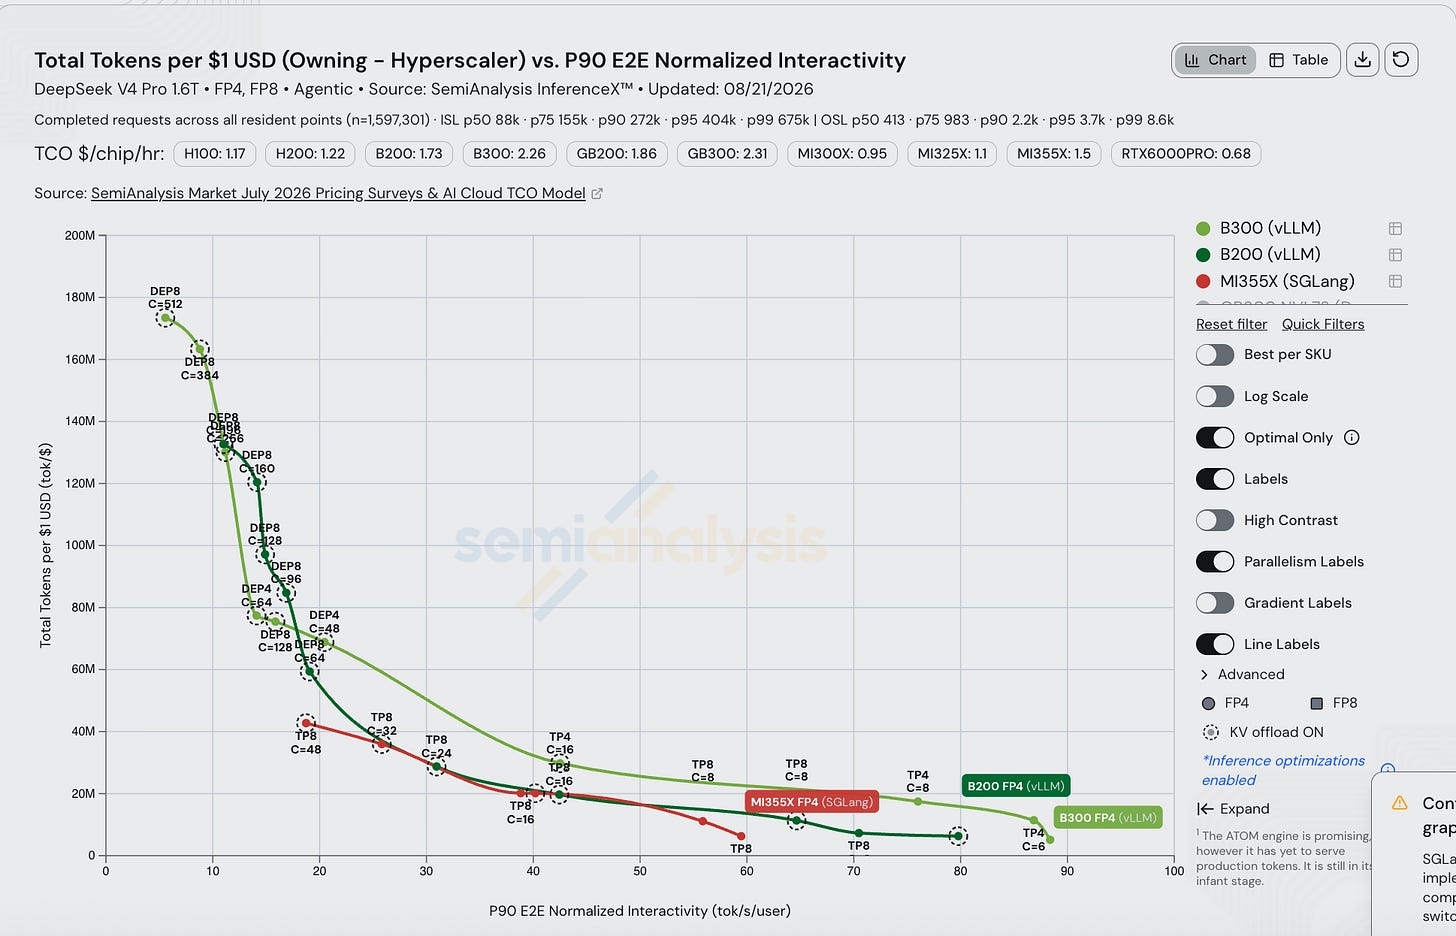
在 2026 年 8 月 21 日之前,AMD MI355X 强大的 SGLang 开发团队在端到端(e2e)性能上,其性价比曾与 B200 vLLM 持平。
Source: InferenceX
然而,B300 vLLM 和 B200 SGLang 的表现依然优于 AMD 的 MI355X。
Source: InferenceX
在 2026 年 8 月 21 日之后,得益于 Inferact 和 Nvidia 对 vLLM 的优化,Nvidia B200 的性价比超过了 MI355X。这是一场势均力敌的较量,我们非常期待看到未来几周的性能优化进展。我们很快会发布一篇 AgentX 的更新文章。
AMD 已列出其 DeepSeekv4 vLLM 优化方案,其中包含许多可用来提升性能的亮点。
Source: SemiAnalysis
现在来看 Nvidia。其最具竞争力的解决方案是 GB300 Dynamo TRTLLM 和 GB200 Dynamo vLLM。这两种配置都依赖 PD 分离(PD disagg)技术,以在合理的交互性下实现高吞吐量。此外,GB300 配置采用了宽 EP(DEP32)解码实例,从而在前沿中段实现更高的吞吐量。
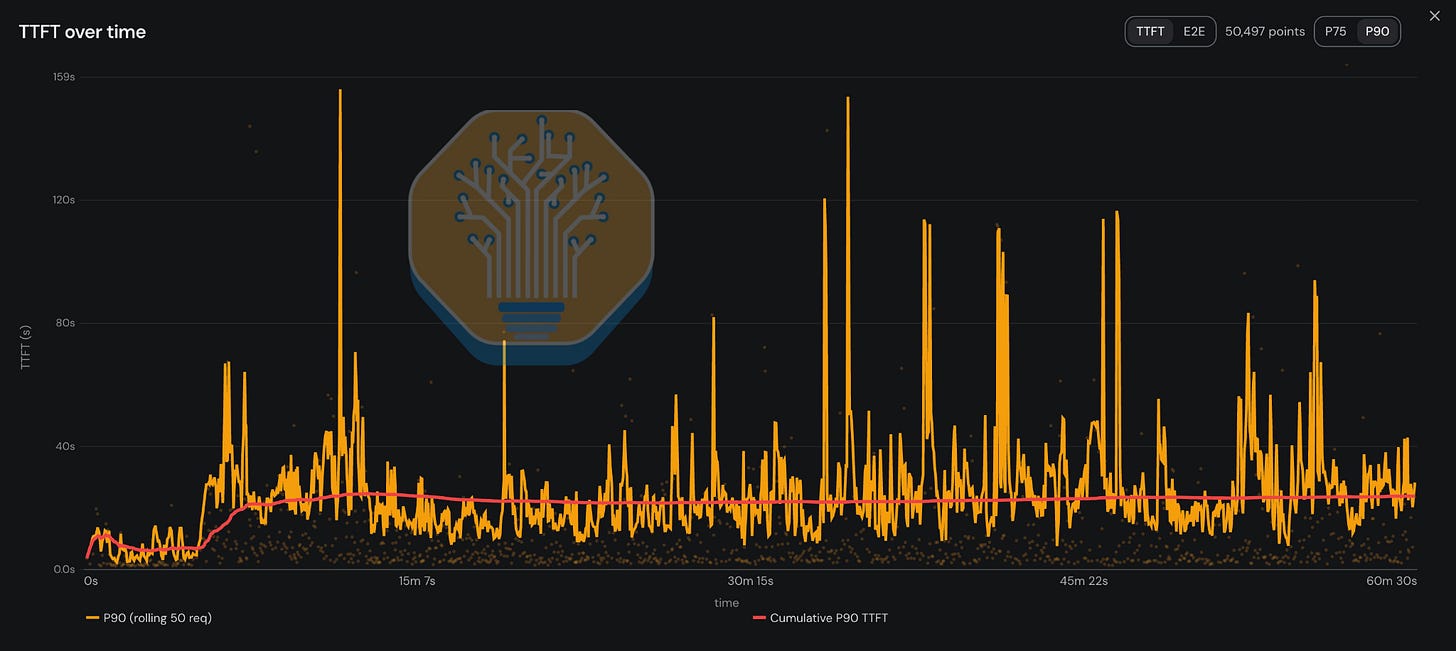
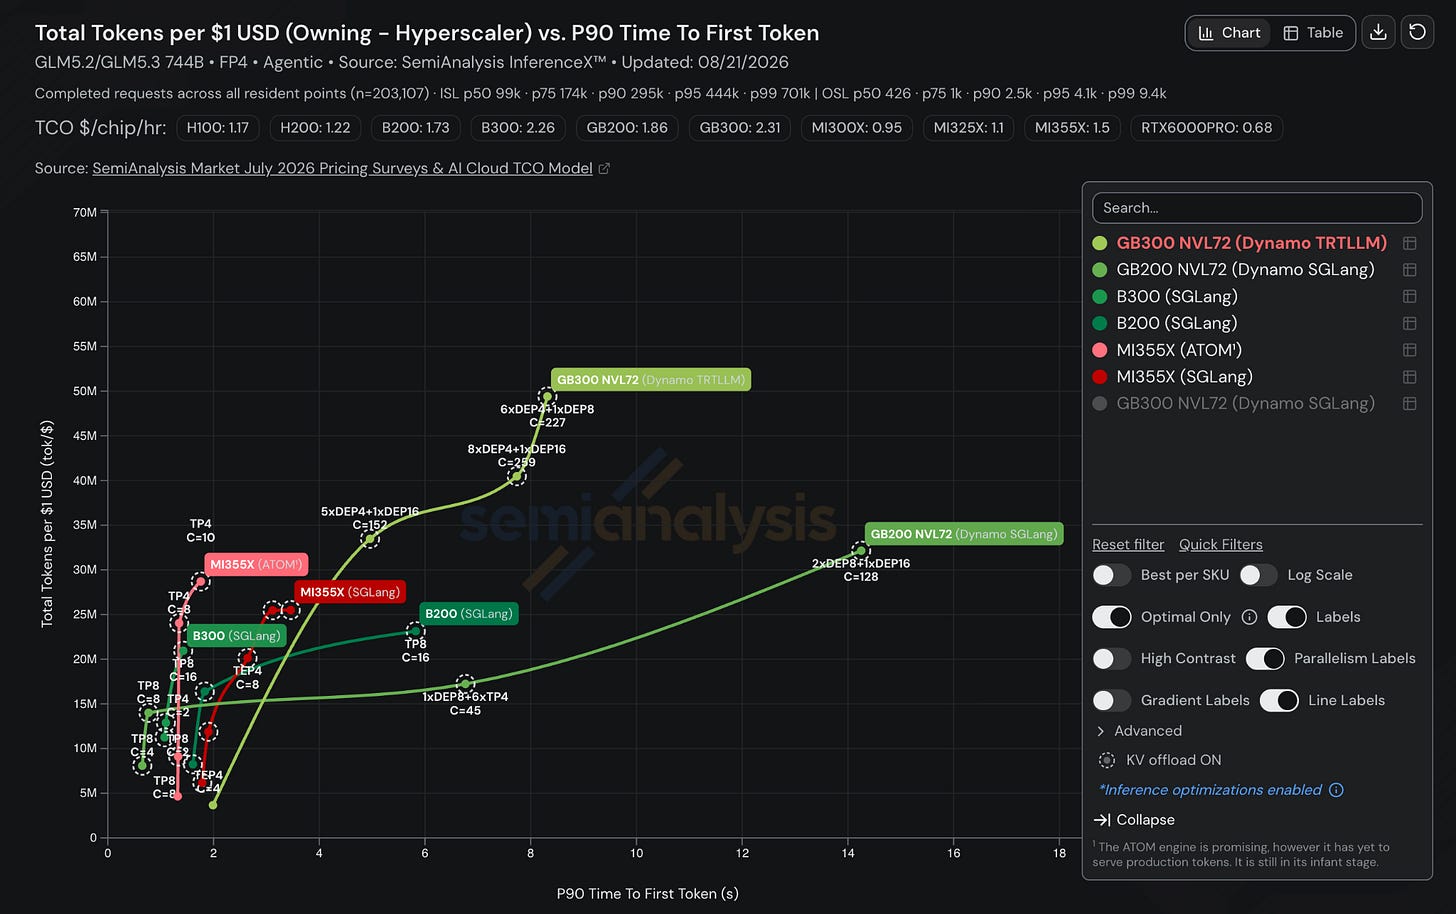
需要注意的是,与 TTFT 相比,2xDEP8+1xDEP12 的 GB200 节点在 TPS 上更接近 3xDEP8+1xDEP16 的 GB300 节点。再次强调,TTFT 通常对工作负载的“突发性”更为敏感。由于 GB300 节点实现了高得多的整体并发量,它会产生更多子代理流量,进而引发更多冷预填充。我们可以在该节点的 TTFT 图表中看到这一点:
Source: InferenceX
Source: InferenceX
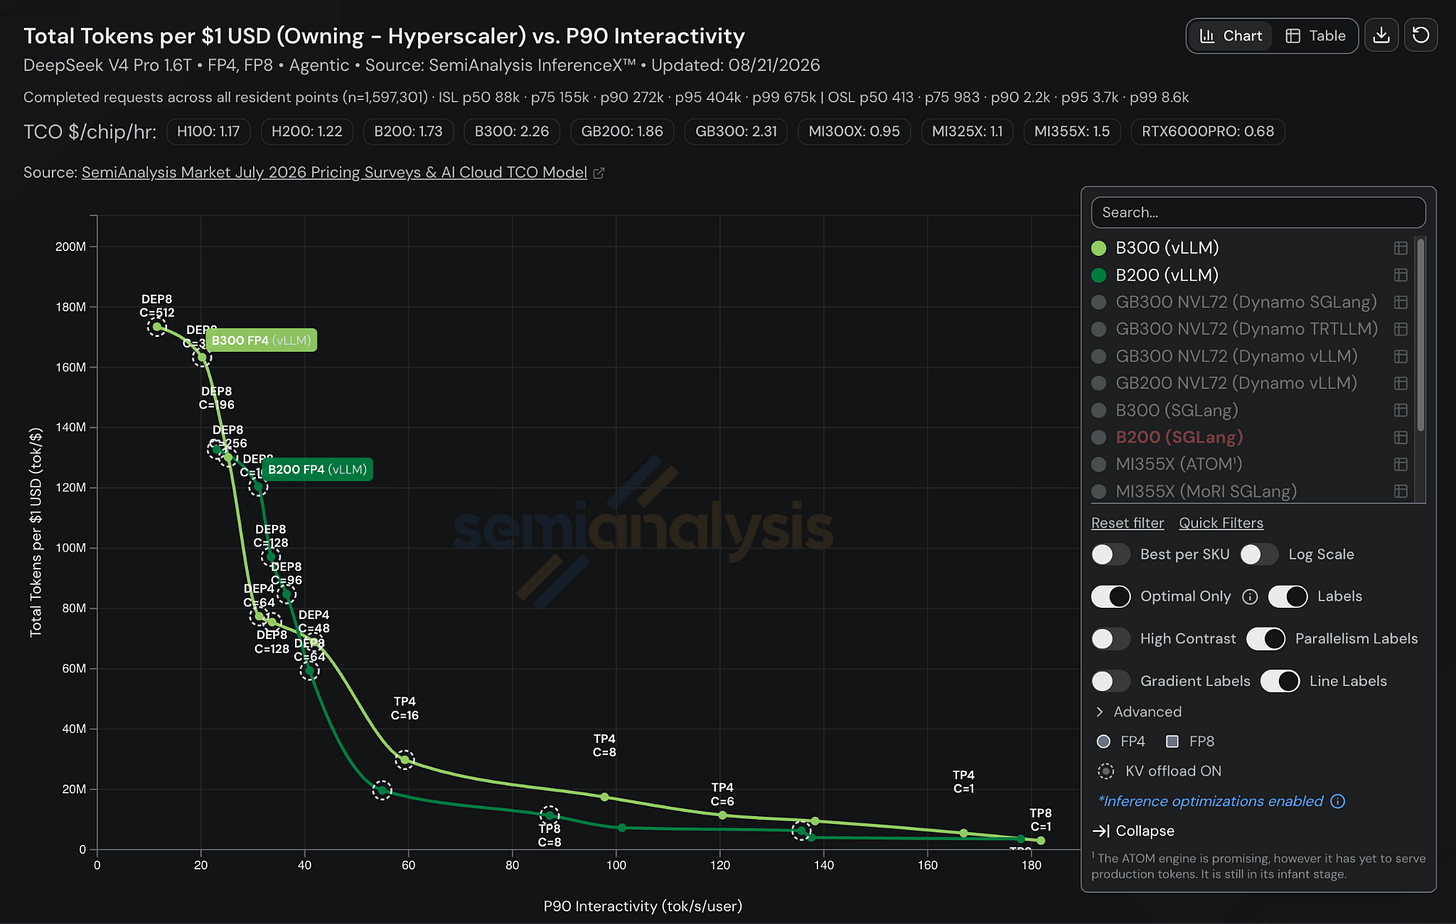
按 TCO 归一化后,B300 vLLM 与 B200 vLLM 的综合性能表现十分接近。主要区别在于,由于 B200 的 HBM 容量增加了 50%,B300 能够从中“榨取”出额外的吞吐量。
Source: InferenceX
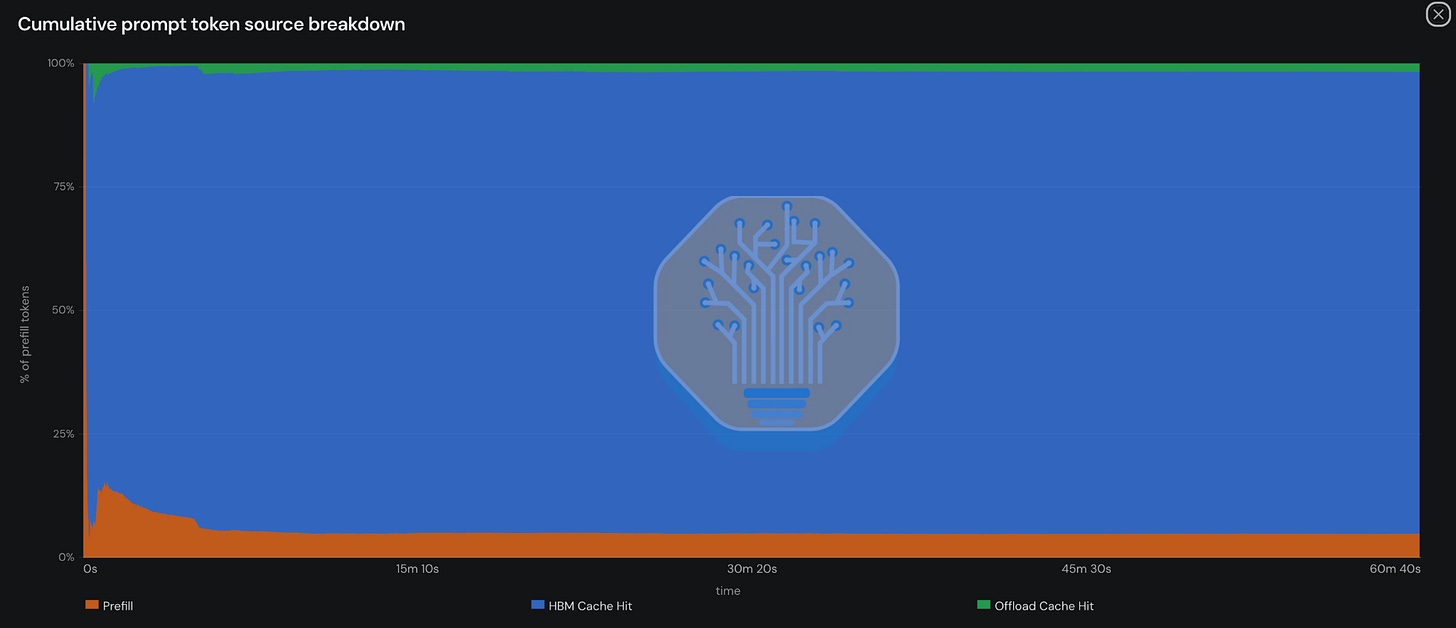
我们可以利用 AgentX 新增的服务器指标可视化功能,进一步直观展示这一差异。
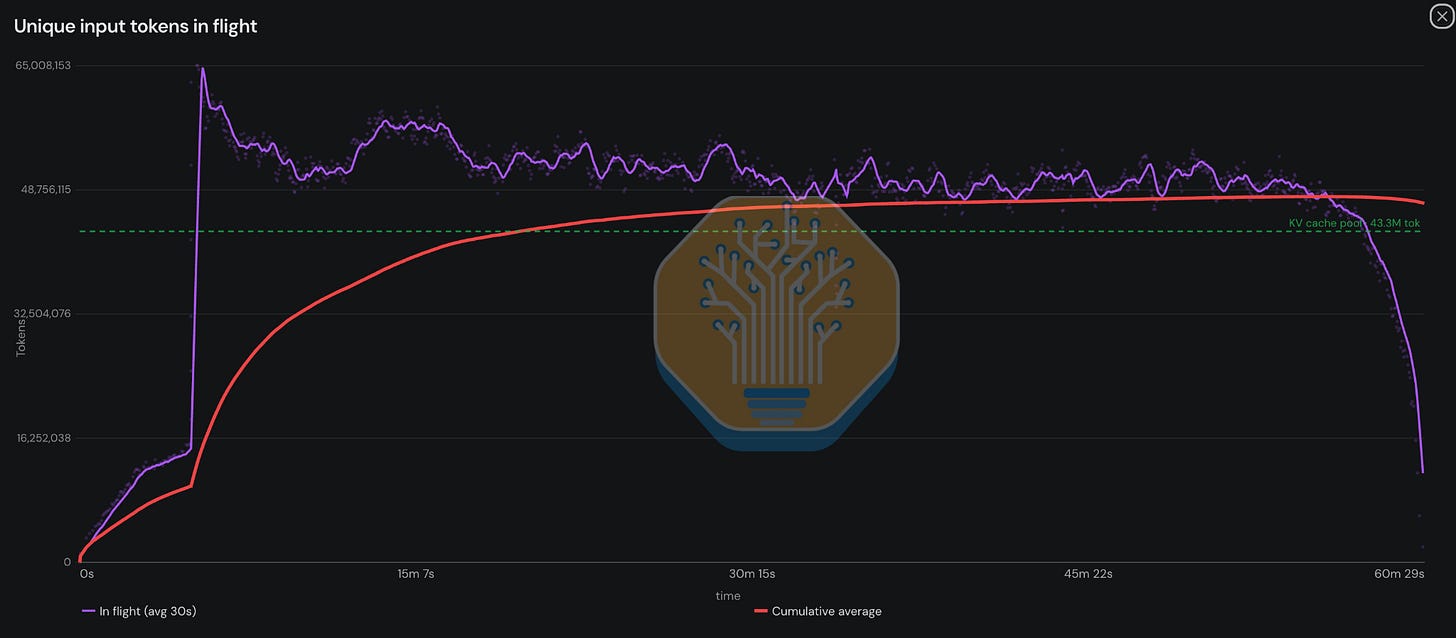
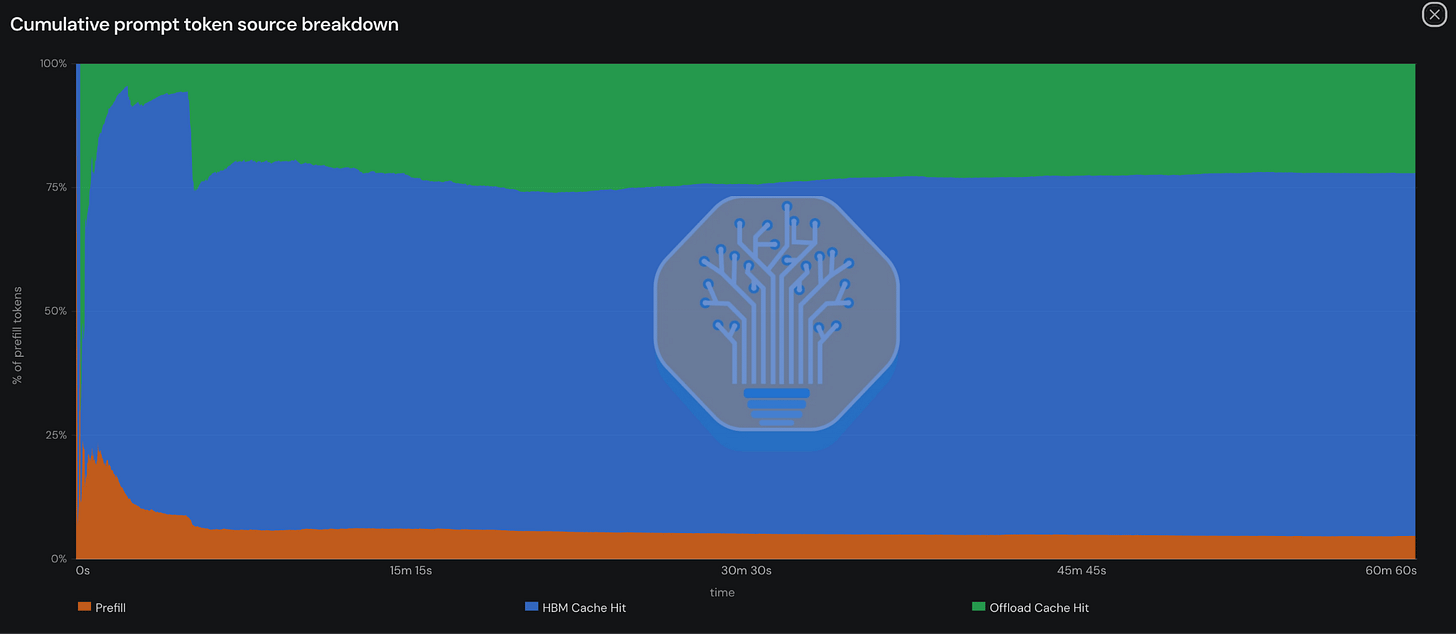
在 384 个并发代理轨迹的负载下,B300 vLLM DEP8 借助 vLLM 简单卸载(simple offloading)技术配合 3TB DRAM,实现了 91% 的 HBM 缓存命中率,外加 1.36% 的 DRAM 缓存命中率。这是因为在该配置下,HBM KV 缓存工作集大小约为 4300 万个 token,而负载在任何给定时间都几乎没有超过这一进行中的 token 数量。
Source: InferenceX
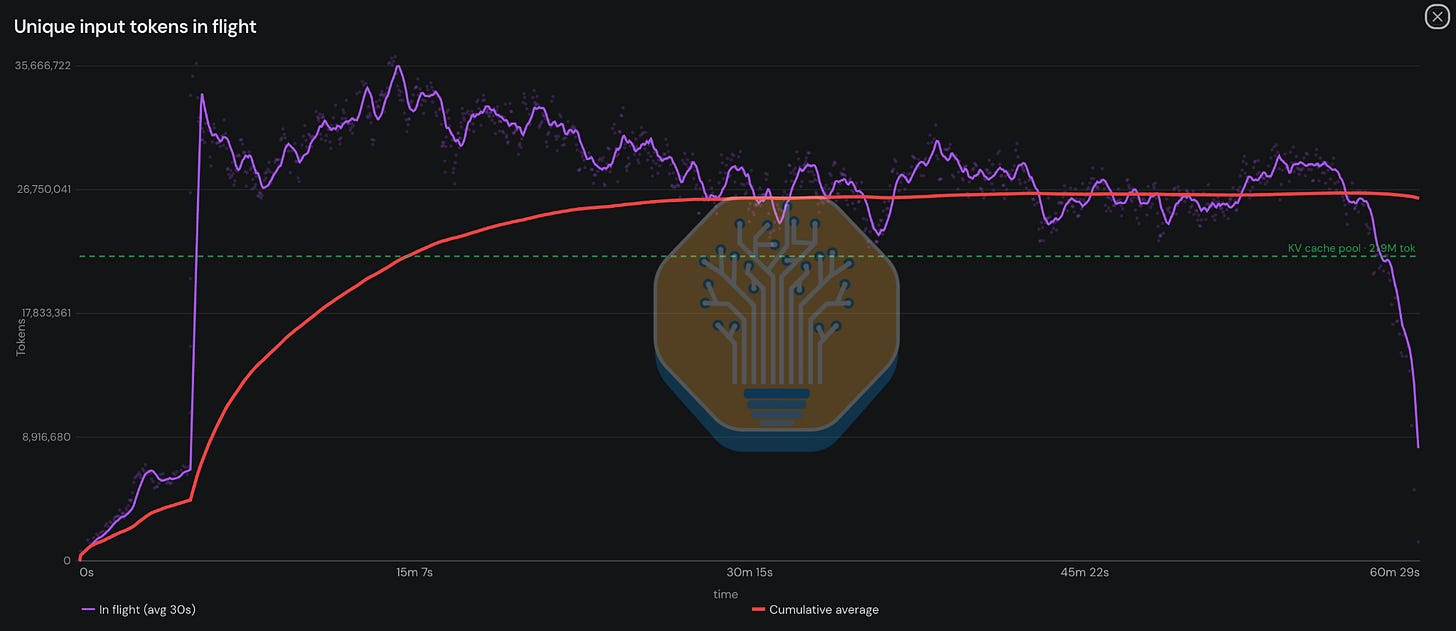
在 B200 并发量为 196 时(其他所有参数保持不变),我们观察到 HBM 缓存命中率仅为 73%,因此更加依赖 DRAM,其卸载缓存命中率接近 20%。我们发现 B200 的 HBM KV 缓存工作集大小为 2200 万个 token,大约是 B300 的一半。
DRAM KV 卸载通常采用写穿式缓存实现。这意味着,写入 HBM 缓存的每个前缀也会同时写入 DRAM 缓存。因此,当可用于卸载的 DRAM 容量远大于(1.5 到 3 倍)HBM KV 缓存容量时,这种机制最为有效。
Source: InferenceX
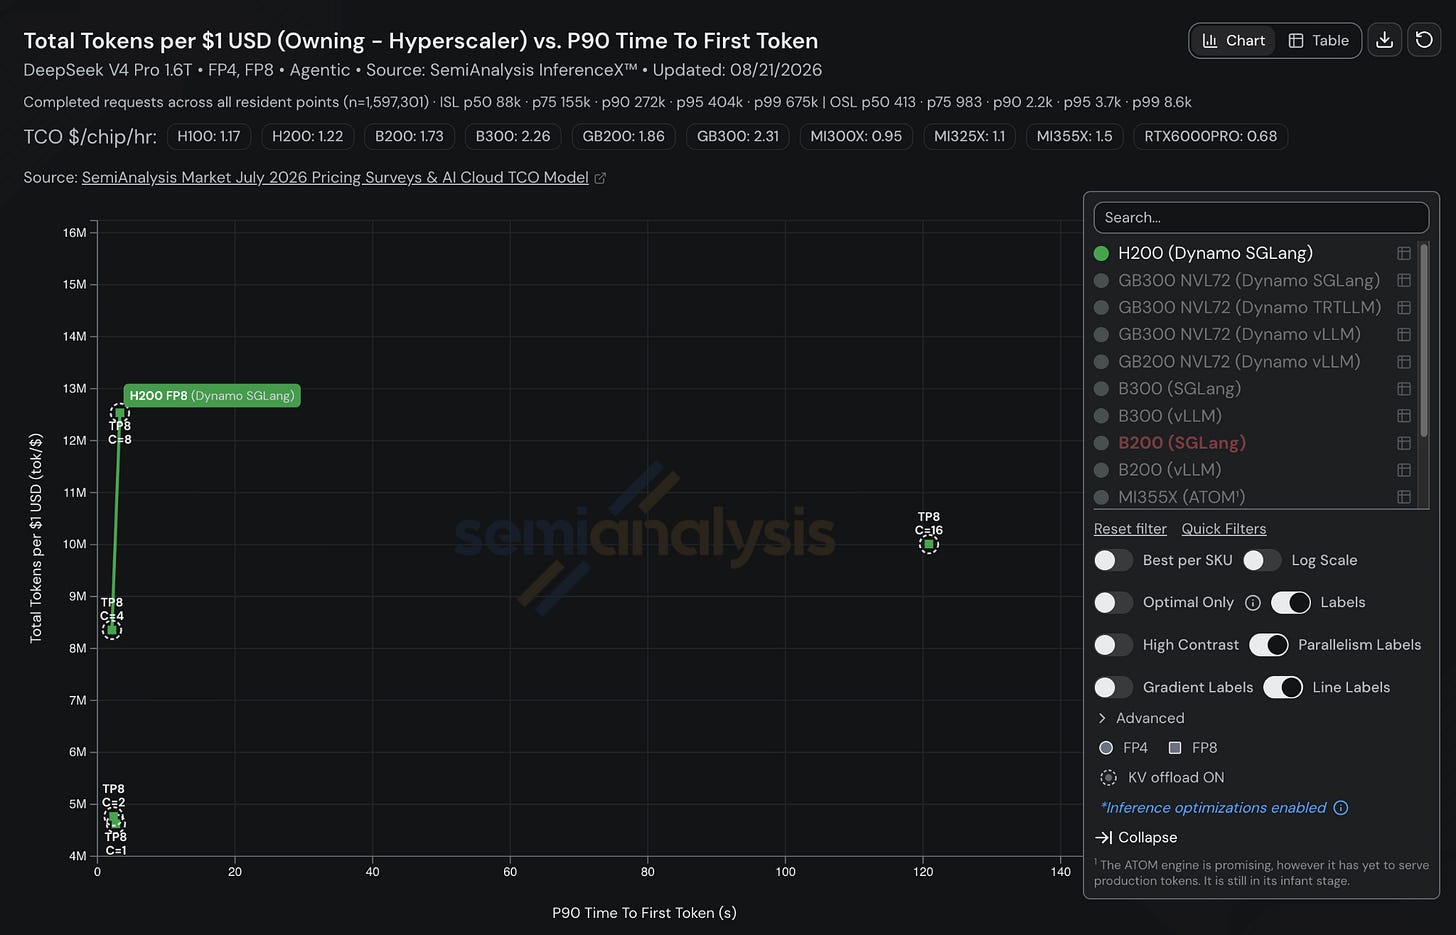
在低并发场景下,H200 SGLang FP8 能够运行 DeepSeek v4。从性能/价格比的角度来看,它甚至能与 B200/MI355X SGLang 竞争。然而,由于 HBM 容量不足,在高吞吐量场景中,它无法与更新的 SKU 抗衡。
Source: InferenceX
此外,在更高并发度下依赖 DRAM KV 卸载,会导致用户规模扩大时出现不合理的延迟。
Source: InferenceX
总体而言,与其主要竞争对手 B200 和 B300 相比,MI355X 表现相当不错。在曲线的低吞吐量/低延迟区域,性能最为接近。因为在这些区域,仅部署了张量并行和更基础的内核。AMD 需要优化 MI355X 上的 DEP 内核,以便在高吞吐量场景中提升竞争力。考虑到其 HBM 容量比 B200 多出 1.5 倍,这一点尤为重要。
Source: InferenceX
Kimi K3:2.8 万亿参数
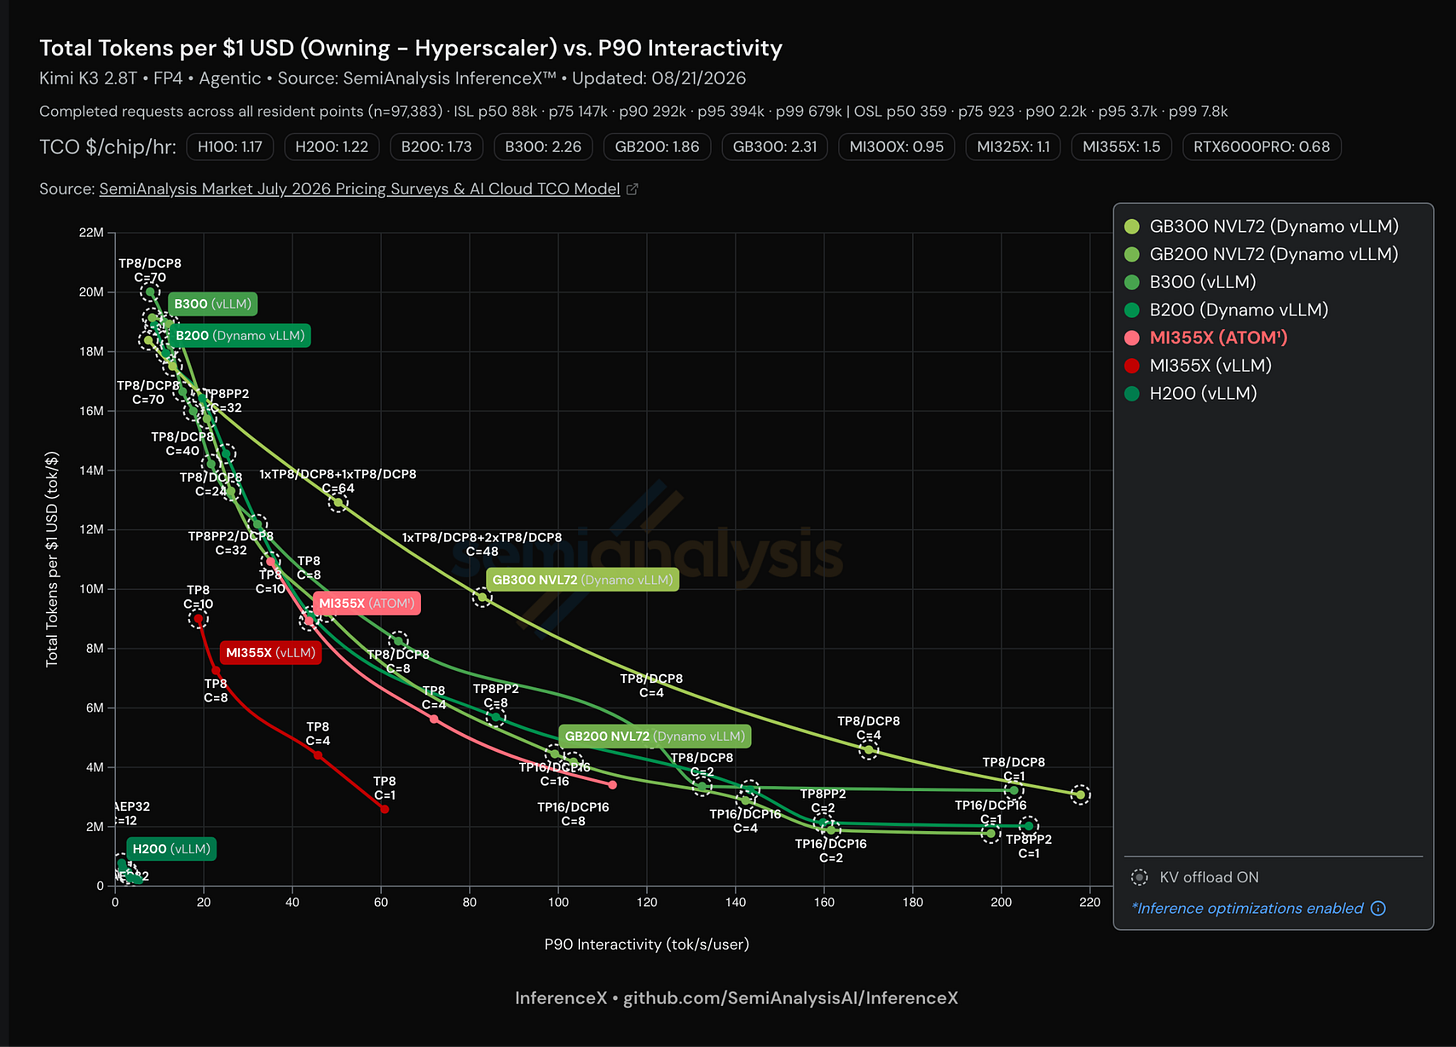
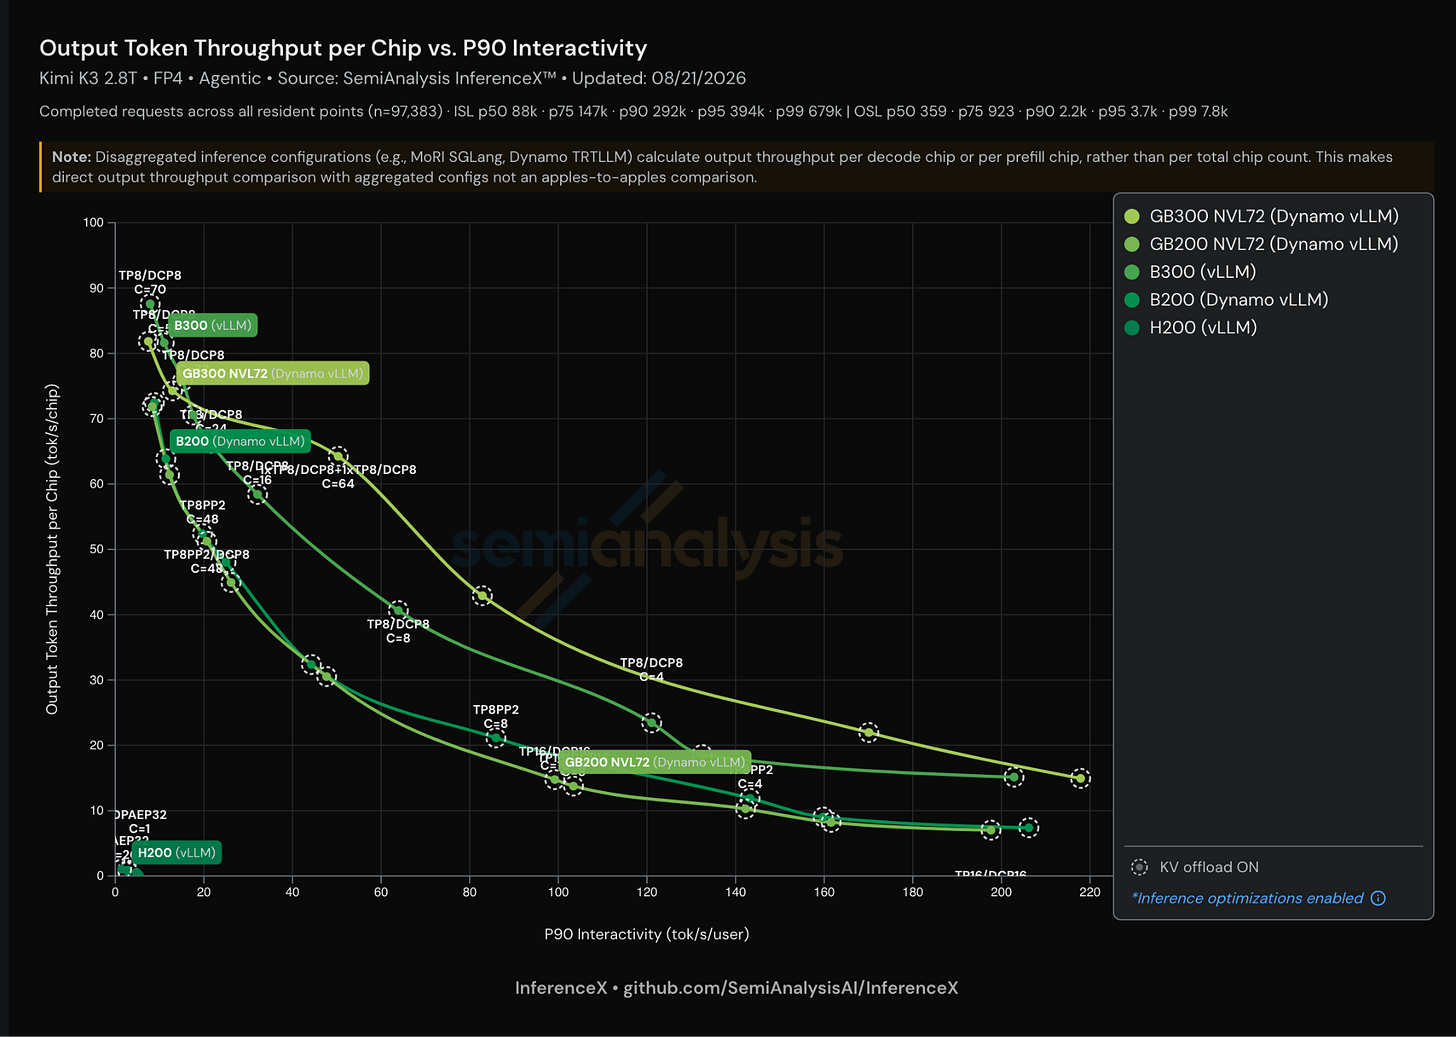
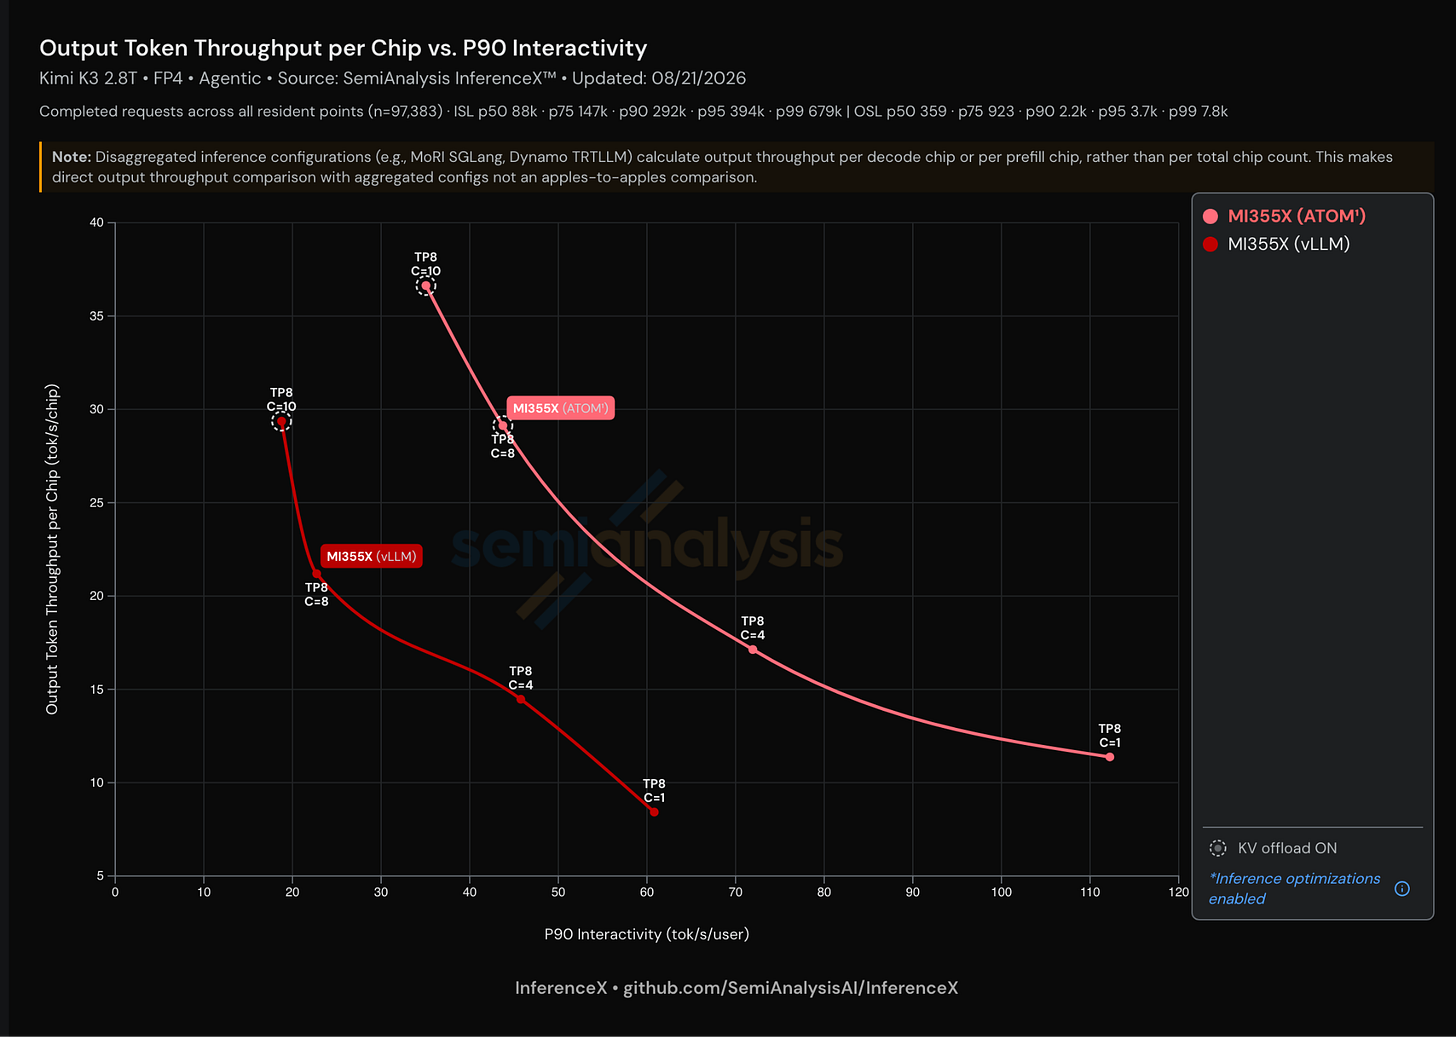
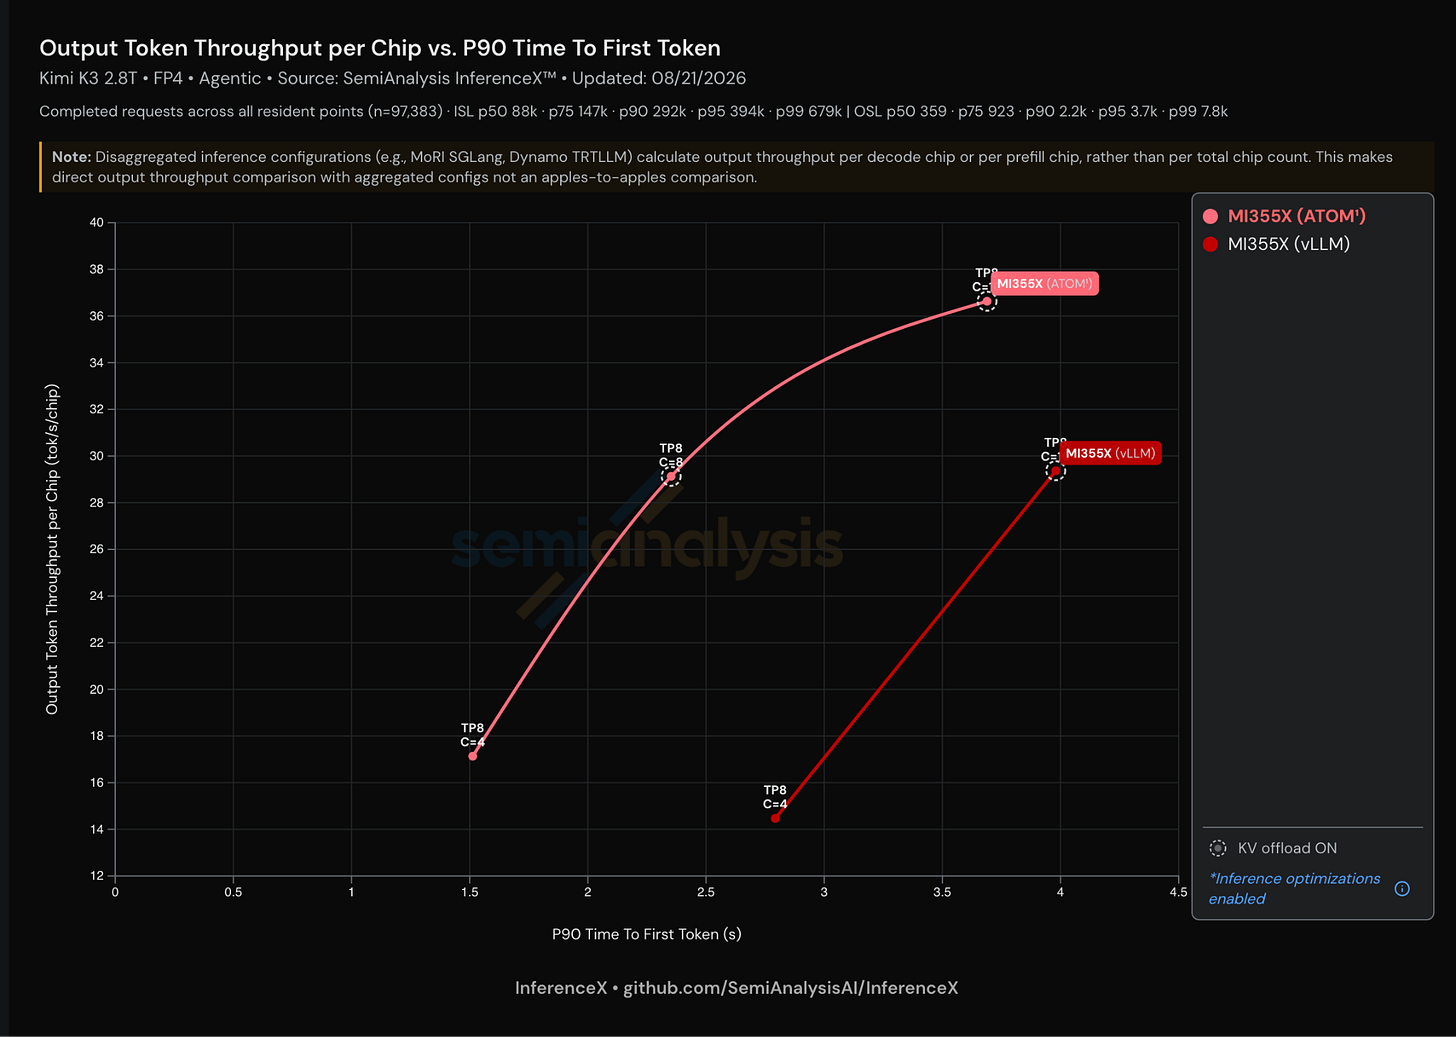
Kimi K3 是来自中国的另一个前沿开放权重模型,总参数量达到 2.8 万亿。就参数量而言,这与 Claude 的 Mythos/Fable5 模型架构处于同一量级。我们将其作为开放权重代理模型架构使用。Kimi K3 模型非常庞大,甚至无法装进单个 B200 服务器。必须使用宽 EP/宽 TP 或流水线并行,才能容纳所有权重。在 vLLM 上,推测解码/DSpark 此前完全无法与流水线并行配合使用。直到最近情况才有所改善。因此,B200 在 Kimi K3 上的表现非常糟糕,并被 MI355X 全面碾压。因为 B200 无法在流水线并行下使用推测解码。
对于短上下文单轮工作负载,MI355X vLLM 在第 0 天就能开箱即用。但对于长上下文多轮工作负载,MI355X 的 AITER 和 Triton 内核在第一周出现了严重的崩溃问题。对于真实场景的工作负载,上游 vLLM 在 MI355X 上完全无法使用。
Source: SemiAnalysis InferenceX
Hopper 难以运行 Kimi K3 的 AgentX 工作负载。因为 Kimi 是一个超大规模模型,且 vLLM 维护者和 NVIDIA 一直未将重点放在优化 Hopper 以运行 Kimi K3 上。Hopper (SM90) 需要针对 K3 定制调优的内核,并配合 TP32/EP32 调优的形状,才能在高交互性场景下提供服务。
Source: SemiAnalysis InferenceX
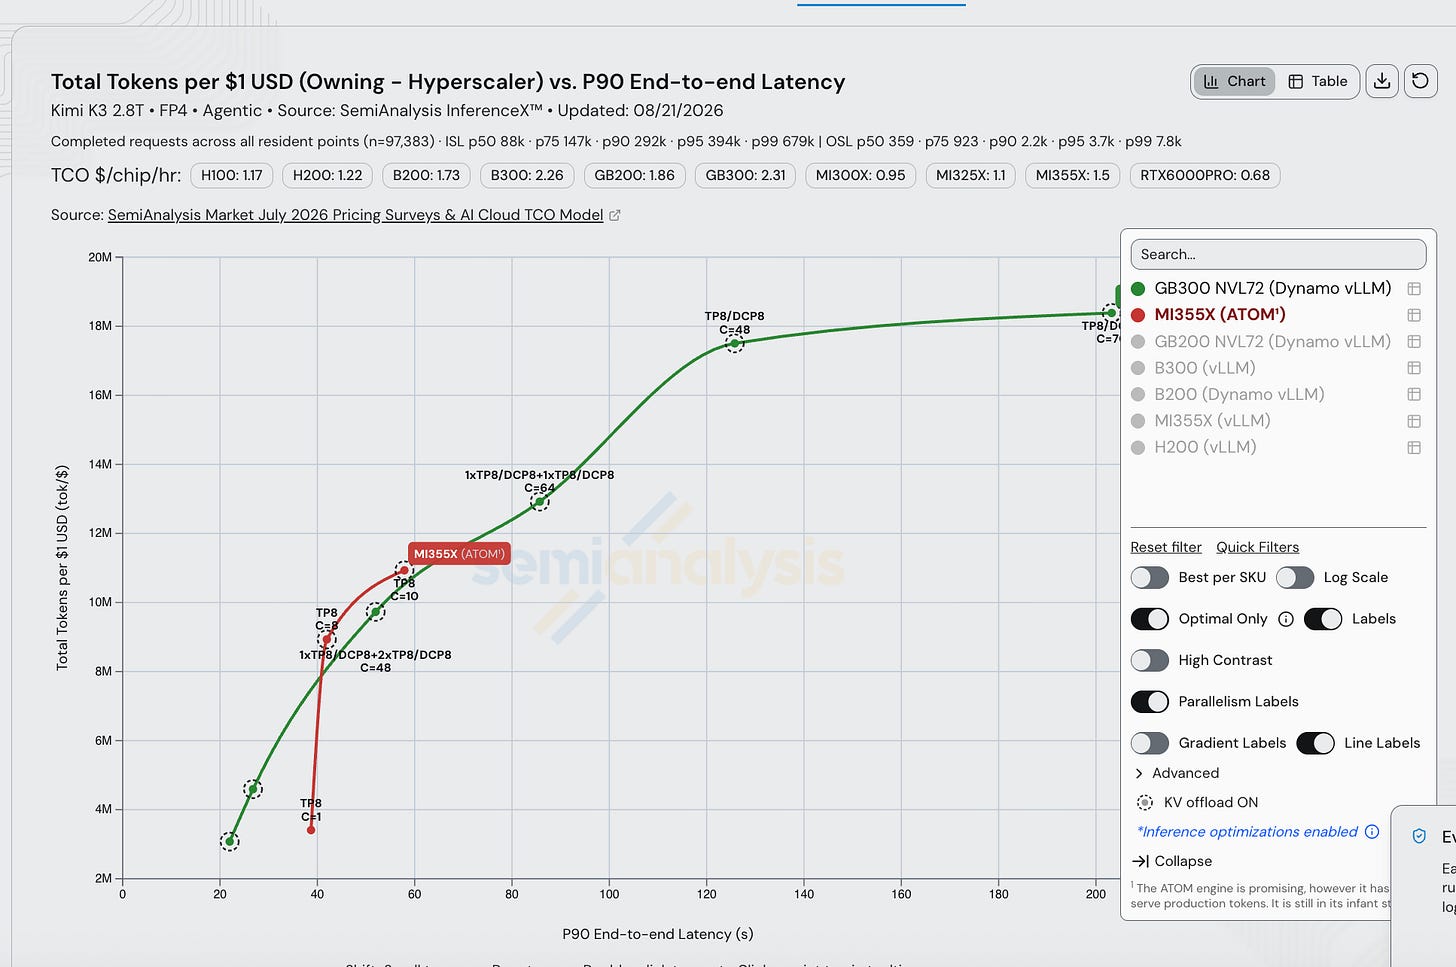
AMD 正借助 ATOM 快速提升 K3 性能,我们认为这非常出色。然而,我们鼓励 AMD 进一步优先将这些改进推送到上游 vLLM。ATOM 目前是 AMD 性能最好的引擎,但对于使用上游开源服务栈的客户而言,vLLM 依然是更具相关性的比较基准。
Source: SemiAnalysis InferenceX
在端到端延迟为 40 到 60 秒的区间内,MI355X ATOM 的单位美元性能甚至超越了 GB300 NVL72 vLLM。
Source: SemiAnalysis InferenceX
MiniMax M3
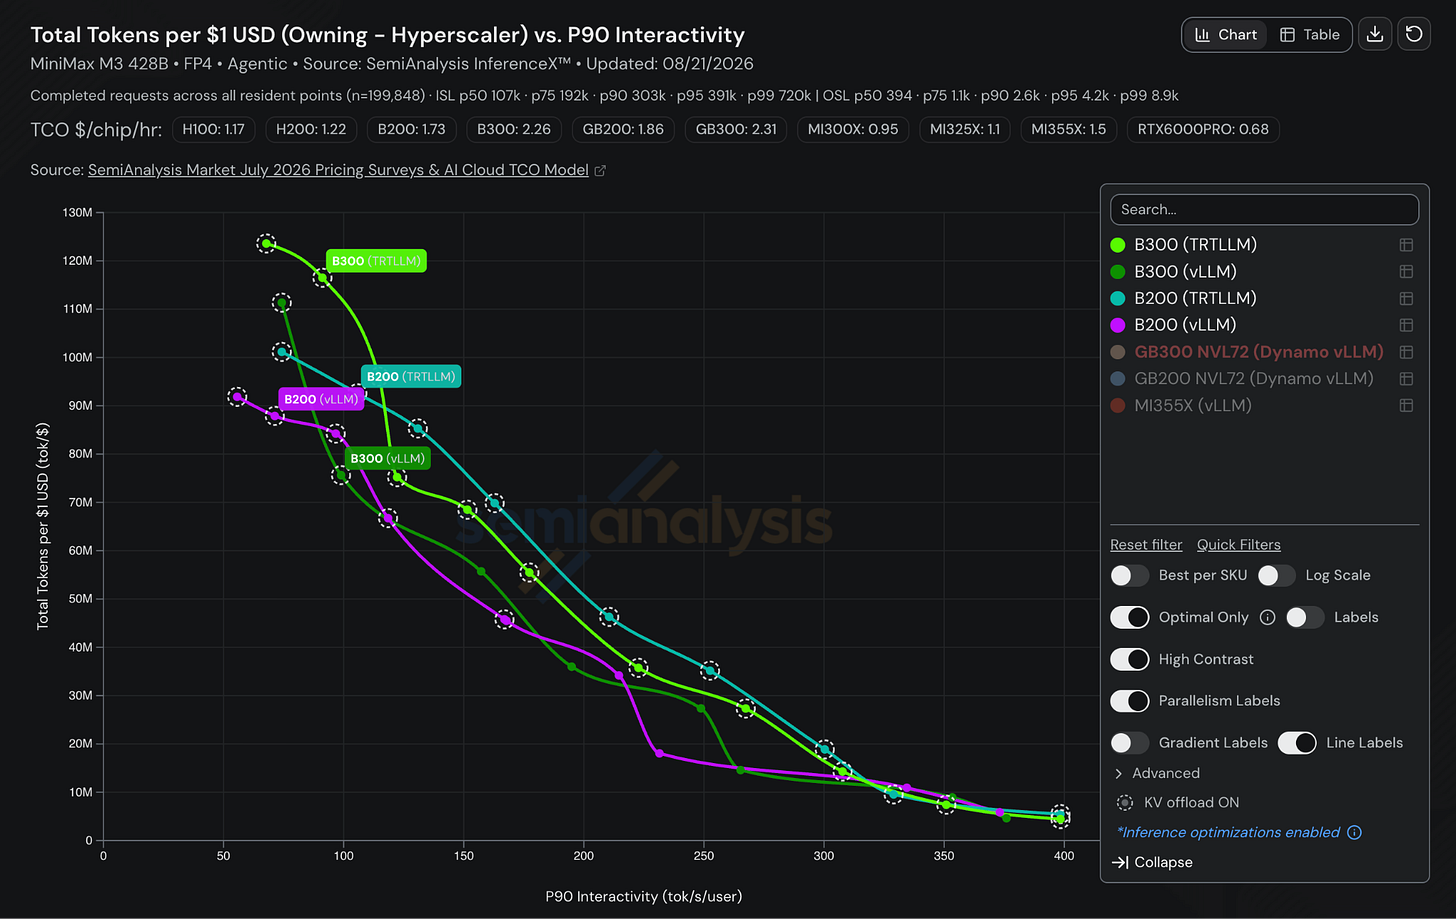
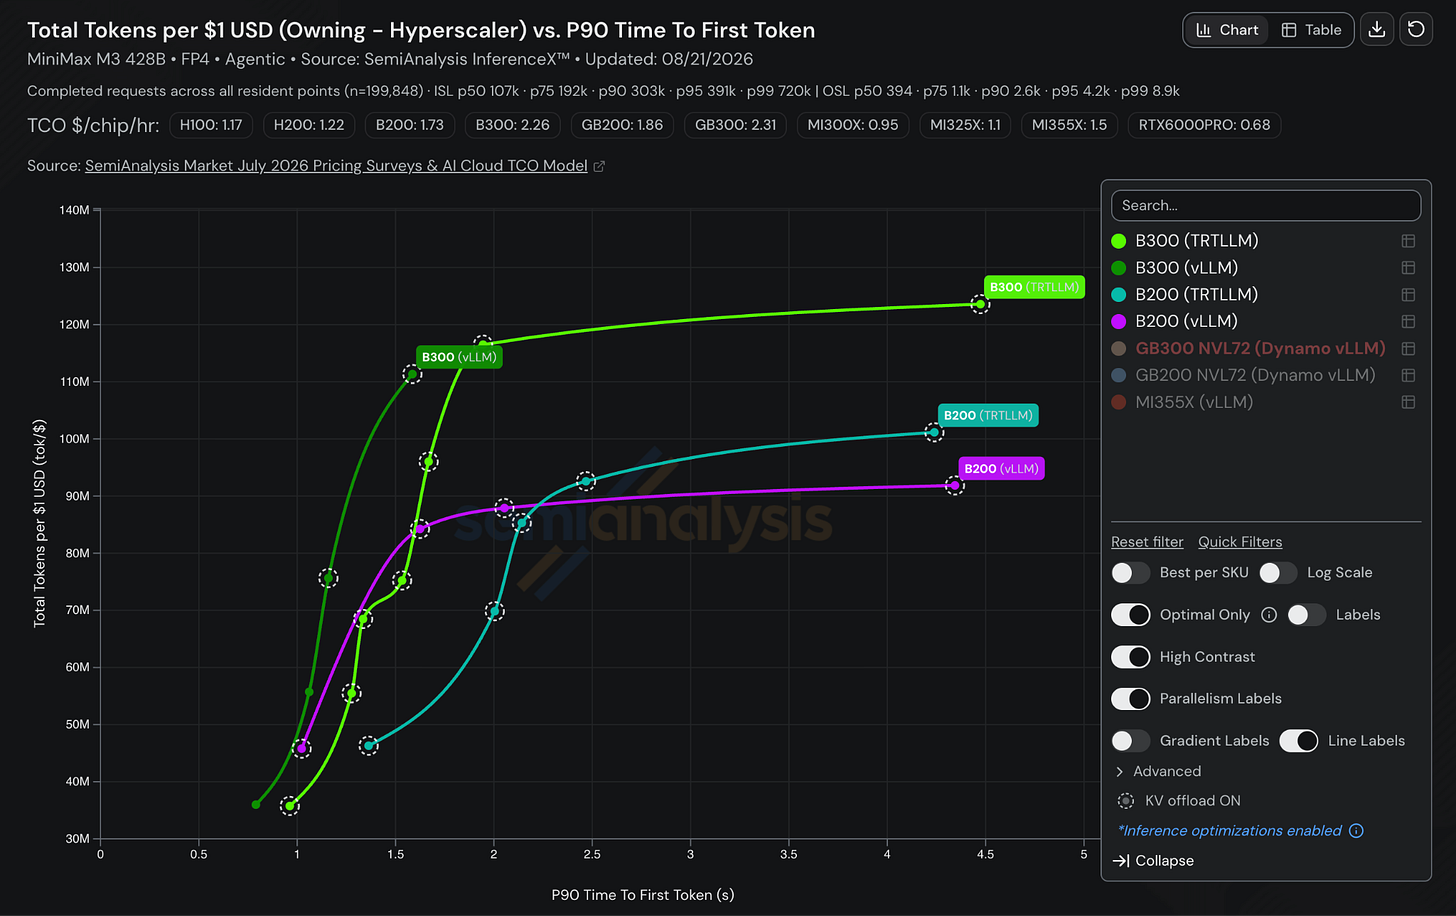
在 MiniMax M3 432B 上,Nvidia 彻底击败了所有竞争对手。AMD 在 MiniMax 上的软件性能非常糟糕,尤其是在高上下文长度下。这是因为 AMD 的工程领导层只注重短上下文、单轮工作负载的调优,而忽略了长上下文、多轮工作负载。
Source: SemiAnalysis InferenceX
B300 TRT-LLM TP2 占据了 M3 的王者地位。由于缺乏 DP-attention,这在 M3 上并非最优选择,因为 KV cache 的局部性成为了路由限制因素。这一点在后面会进一步解释。对于 GB200,在并发数为 40 时,TP4/EP4/DPA 的吞吐量仅为纯 TP4 的 0.60 倍,且 p90 TTFT 高出 3 倍以上。在并发数为 32 时,其缓存利用率达到 28.8%,而理论值为 96.0%。每个 DP rank 都拥有池中私有的一份。如果一个 30 万 token 的会话重新落入错误的 rank,就会重新计算所有内容。在 M3 前沿没有出现带 EP 的 decode 配置,这可能是因为并发数不够高,无法平衡所有专家的负载。
在 TCO 归一化吞吐量方面,B200/B300 在 MiniMax M3 上也完全击败了同级别的机架级产品。在 AgentX 上,机架级的优势并不那么明显。这是因为 Dynamo 路由器可能成为瓶颈,其工作量随活跃前缀的数量和长度而增加。针对此问题的优化措施,以及那些使吞吐量提升了两位数百分比的修复,将在本文后续部分讨论。此外,目前没有针对 wideEP、wide DCP 或 wide TP 调优良好的 kernel。由于 GB200/300 的 TCO 更高,若不使用 wide EP/wide DCP,其单位 TCO 的性能表现会更差。
话虽如此,我们也期待 Nvidia 针对该 SKU 的机架级解决方案能有进一步的优化。我们一定会在后续文章中重点介绍这些内容。
尽管 P90 ISL 达到了 31.7 万,但目前没有任何提交采用上下文并行。由于只有 4 个 KV head,DCP 即使在 TP8 下也仅限于 2。此外,MSA 索引器需要自己独立的上下文并行处理(已提交了一个 vLLM PR)。有关此主题的更多讨论,请参阅“上下文并行”部分。
Source: SemiAnalysis InferenceX
Nvidia 的所有帕累托最优点在并发数超过 20 时都启用了 KV offload。但对于 AMD,没有任何帕累托最优点使用向 DRAM 的 KV offload。在其他模型上,AMD 使用 KV offload 的频率也低于 Nvidia。原因在于,在 AMD vLLM 上,用于 CPU KVCache offload 的 GPU 到 CPU 传输效率极低。在 ROCm 7.14 之前一直缺少 hipMemcpyBatchAsync API。如果没有 hipMemcpyBatchAsync,vLLM 原生的 Simple CPUOffloading 就需要执行从 CPU 到 GPU 的串行化 Memcpy,而无法将它们批量打包成更大的消息。
值得一提的是,在吞吐量与 p90 交互性的对比方面,vLLM 的性能与 TRT-LLM 非常接近。此外,在吞吐量与 p90 TTFT 的对比上,vLLM 表现更优。
Source: SemiAnalysis InferenceX
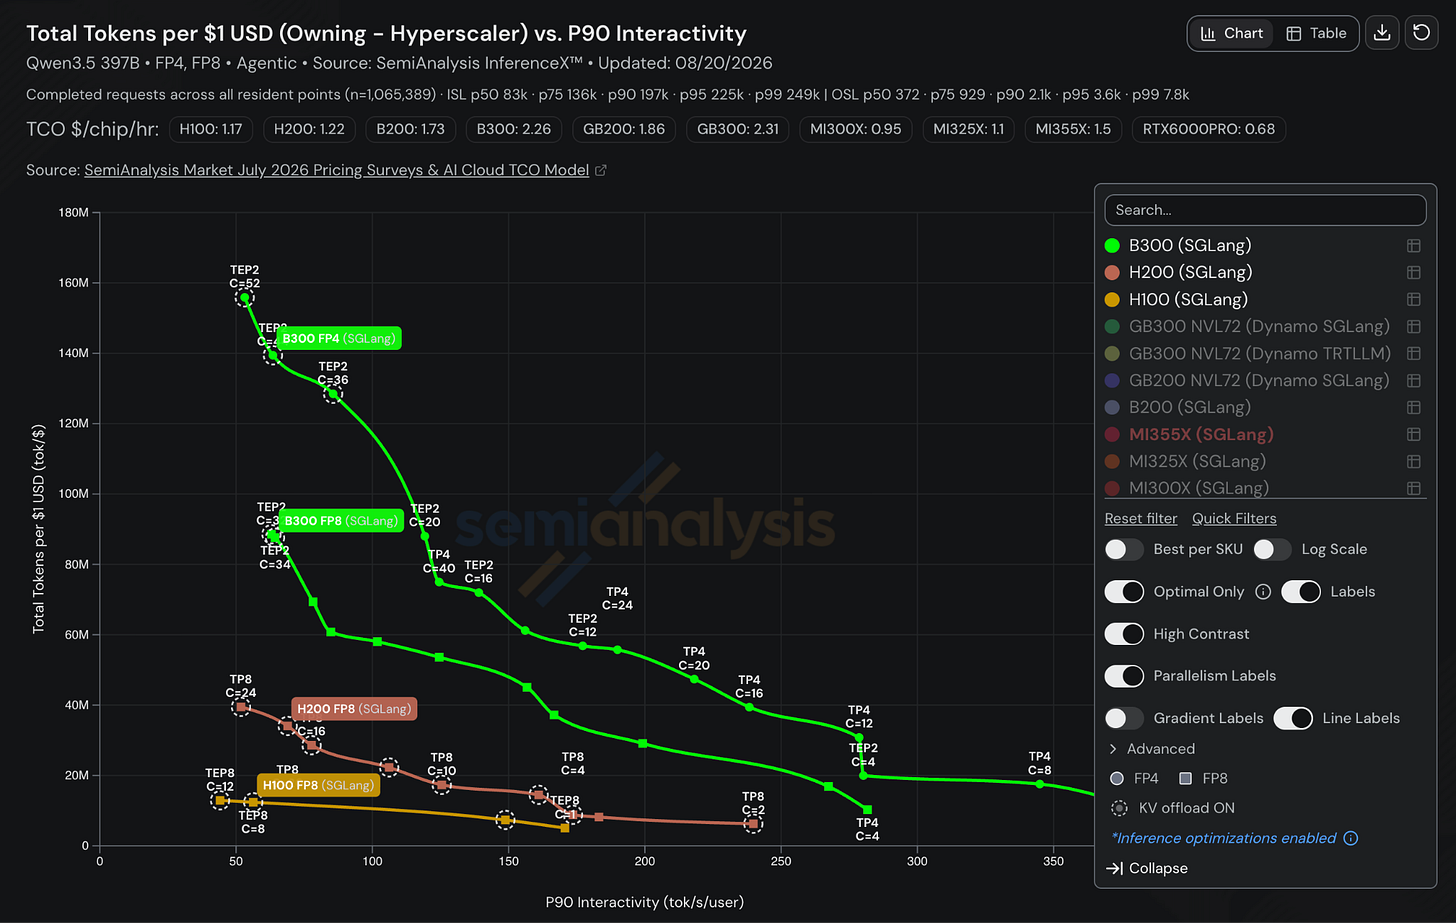
Qwen3.5 397B
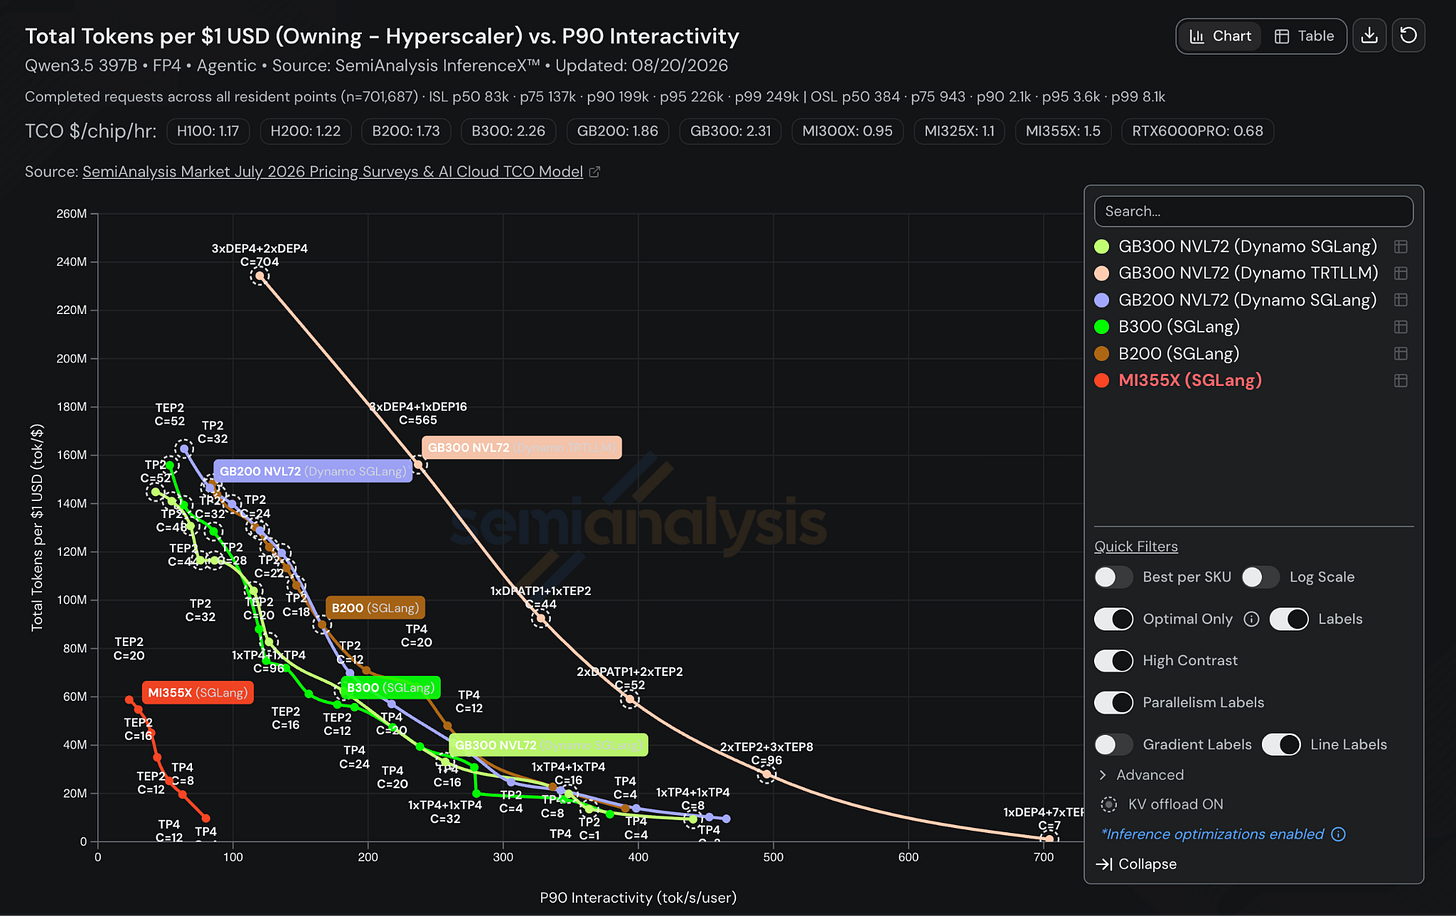
Qwen3.5 397B 每隔几层就使用 GatedDeltaNet 来替代标准注意力机制。GatedDeltaNet 由 MIT/Nvidia Research 发明。在理论上,它的状态存储需求是恒定的。而标准注意力机制的存储需求则是线性的。这意味着,与同等规模的密集注意力模型相比,它的存储需求更低。与 Nemotron 灾难那样的端到端模型训练研究不同,Nvidia Research 在 GDN 等基础研究方面表现出色。LatentMoE 等技术也已应用于前沿模型。
需要注意的是,该模型的原生最大上下文长度为 262k tokens,因此我们使用了截断的数据集。这模拟了较小模型上的工作负载。在这些模型上,最大上下文长度经常会被达到,需要进行多次压缩。这也正是用户实际使用该模型的方式。
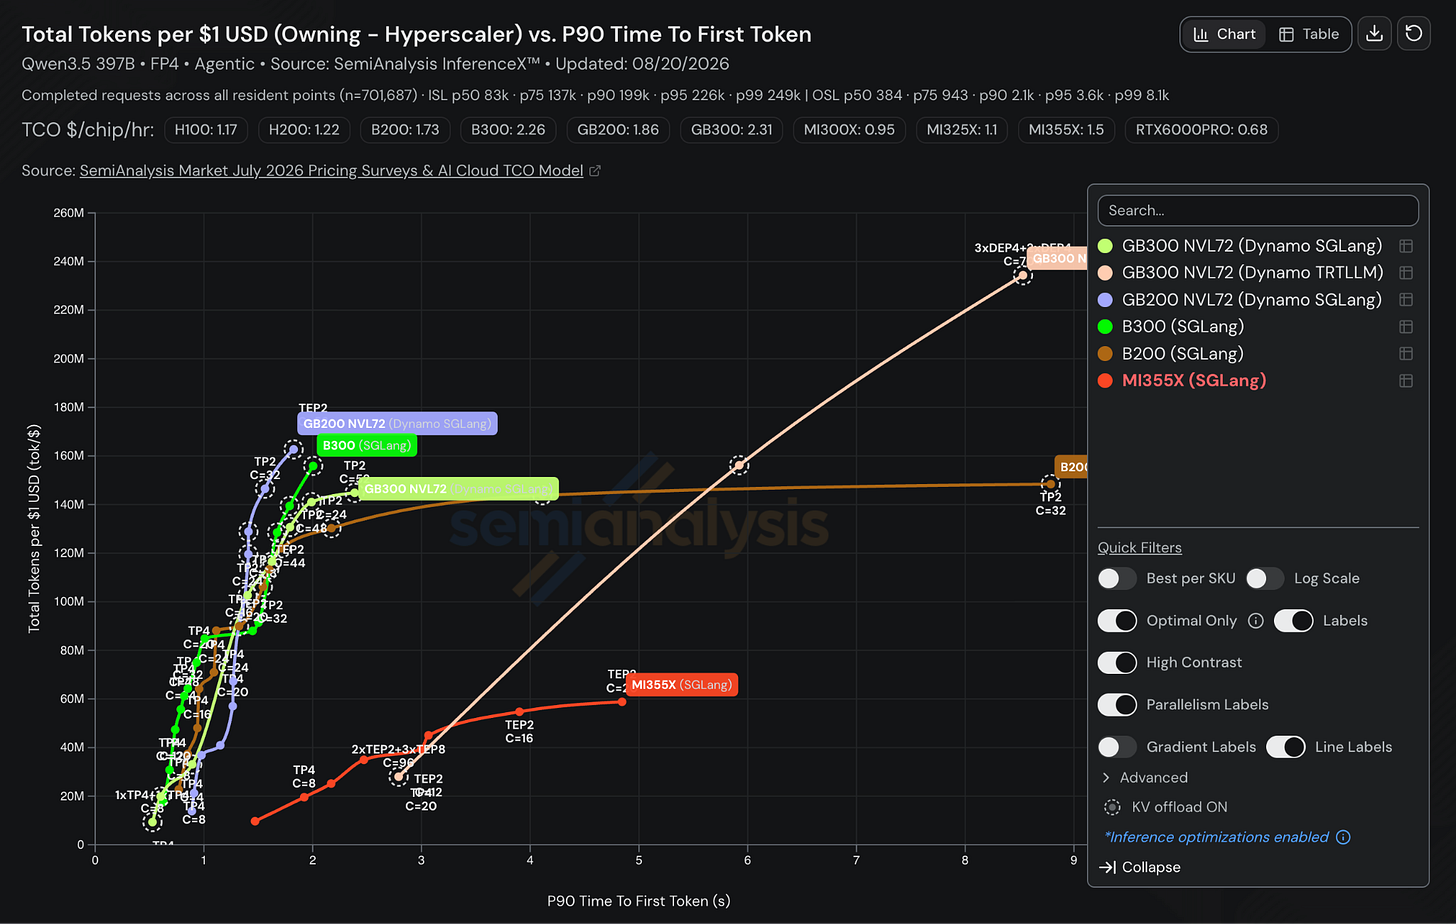
对于 Qwen3.5,在 SGLang 对比 SGLang 的测试中,NVIDIA 表现强劲。其性能达到了 90 tok/s/user,优势超过 20 倍。在 Qwen3.5 SGLang 方面,AMD 目前毫无竞争力。
Source: SemiAnalysis InferenceX
我们再次观察到,Nvidia 过度优化了交互性,却牺牲了 TTFT。在 TRT-LLM 的案例中尤其如此。在上图中,与 TRT-LLM 相比,所有 Nvidia SGLang 提交结果的 p90 TTFT 都要低得多。
在 Qwen3.5 上,B300 FP4 相比 H100 的单位美元性能提升了 12 倍。
Source: SemiAnalysis InferenceX
GLM 5.3
GLM 5.3 是在 GLM5.2 744B 的基础上构建的,并进行了额外的后训练。这是一个前沿级别的模型。
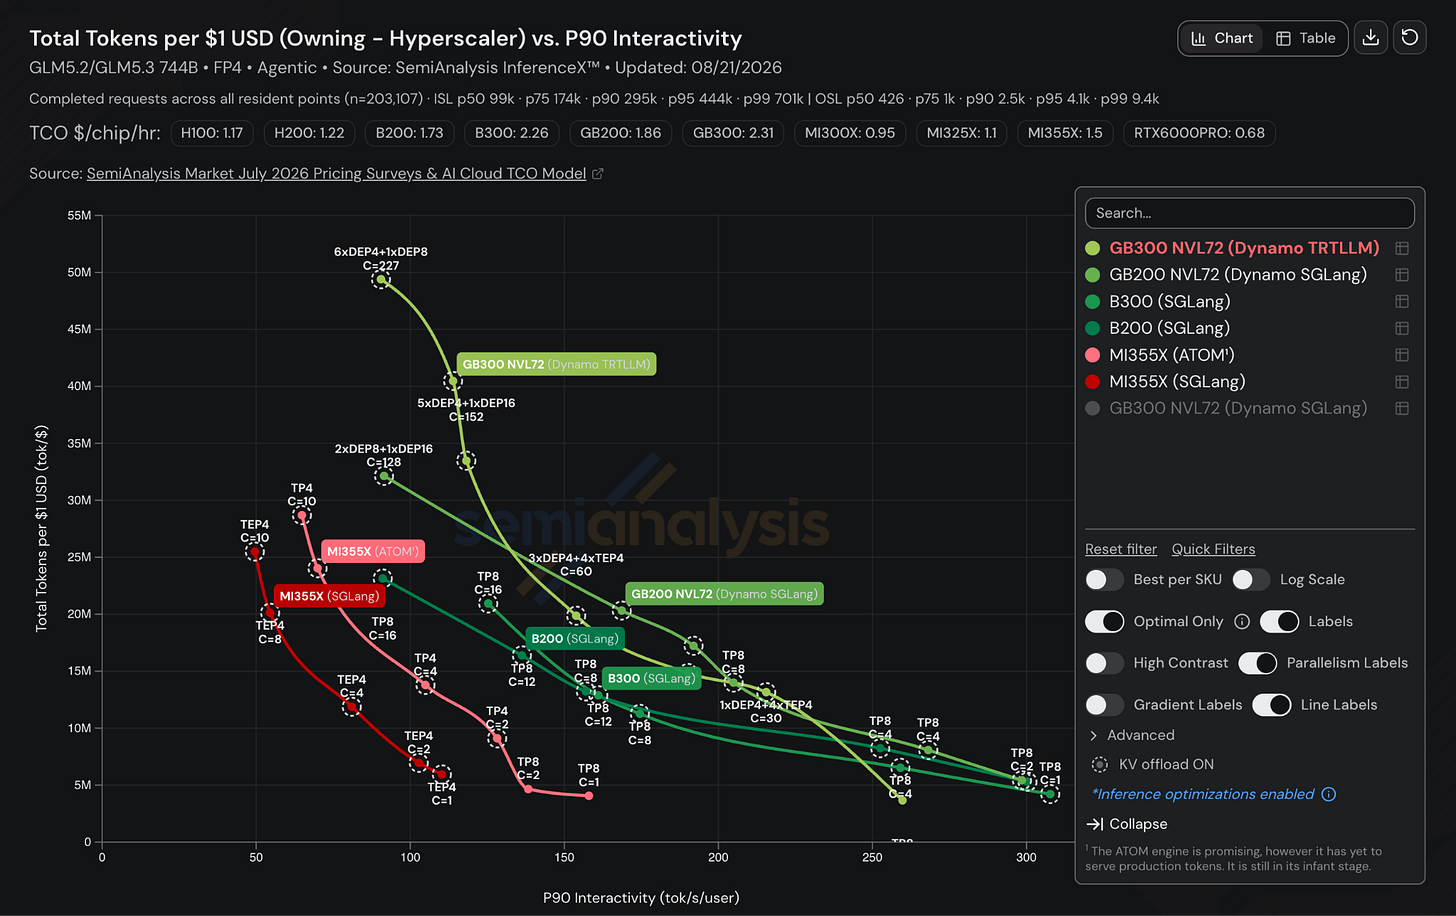
在 OSS SGLang 性能方面,这又是一个 Nvidia 在实际 Agentic 推理性能上击败 AMD 的模型。在 150 tok/s/user 的 p90 交互性下,Nvidia 的成本效率最高可达 5 倍。考虑到 AMD 软件的现状,在 150 tok/s/user 的速度下,Nvidia 的性能优势如此巨大,以至于即使竞争对手的芯片硬件免费提供(但提供商当然仍需支付数据中心托管、电力及其他运营成本),使用 Nvidia 的单 token 成本依然更低。
我们期待 AMD 在未来几周内即将发布的 AgentX 更新文章中带来性能优化。该文章还将包含一些其他非常激动人心的结果。
Source: SemiAnalysis InferenceX
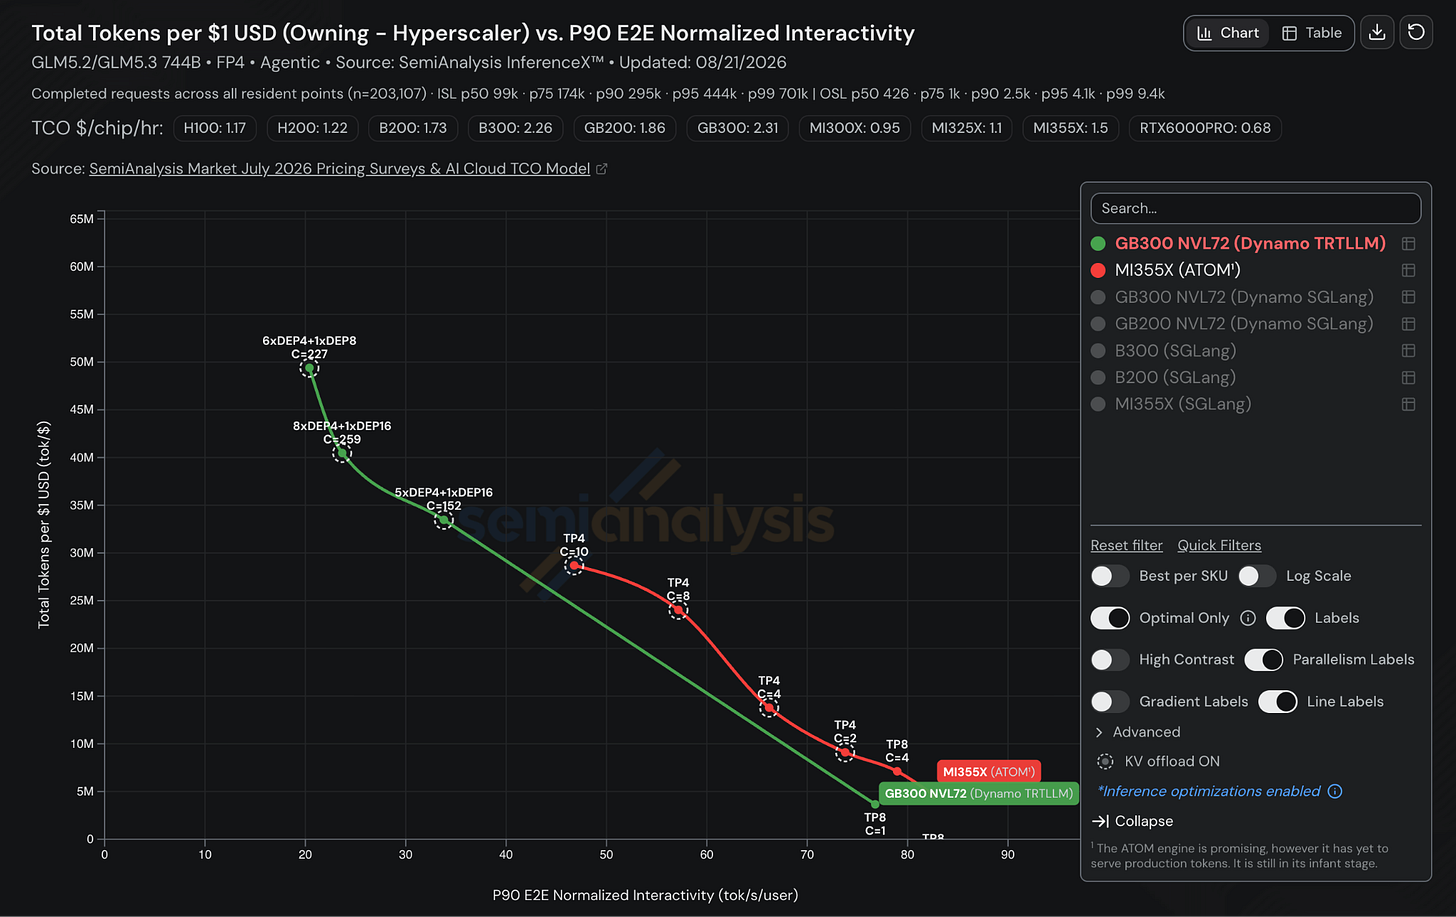
观察 ATOM 的表现,在 p90 E2E Normalized Interactivity 的部分区间内,AMD 的单位美元性能优于 GB300 NVL72 SGLang,甚至超过了 TRTLLM。AMD 团队在这些结果上做得非常出色。我们再次期待 AMD 能将这些优化移植到 SGLang。同时,我们也期待 Nvidia 在未来几周内快速优化 GB300 NVL72。
Source: SemiAnalysis InferenceX
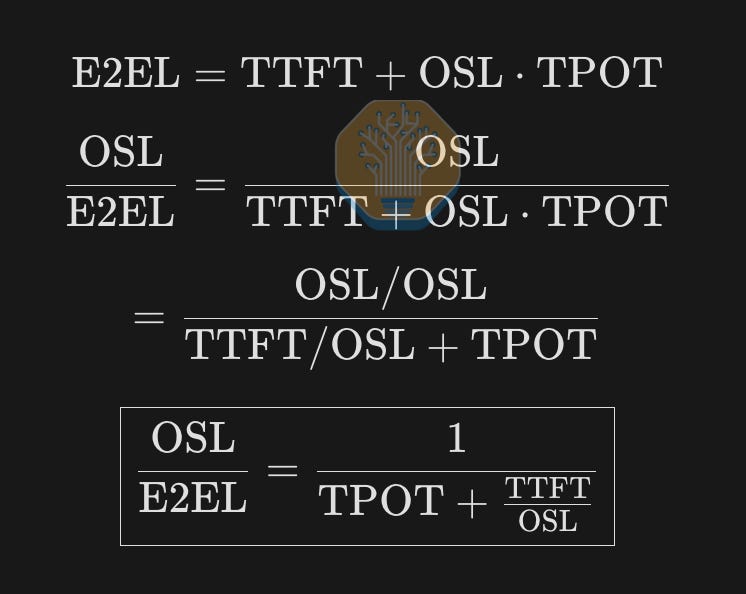
我们在此引入一个实验性指标,称之为 E2E Normalized Interactivity。从宏观层面来看,该指标旨在评估用户在综合考虑 TTFT 和 TPS 时的响应速度。其定义为 OSL/E2EL。代入 E2EL 等于 TTFT 加上 OSL 乘以 TPOT 这一关系(实际上只有 OSL - 1 个 tokens 被解码),我们得到以下等式。
这实际上是交互性(即 1/TPOT 部分)加上与 TTFT 成正比的额外惩罚。
Source: SemiAnalysis
请注意,该指标是实验性的,并不完美。例如,它对高 TTFT 的惩罚力度很大,而且无法涵盖某些优化(如 PD 分离)的所有细节。在 AgentX v1.0 的所有提交中,都是分别针对常规交互性和 TTFT 进行优化的。我们将继续研究新的北极星指标,以全面反映现代智能体推理的各种细节。
AgentX 的行业影响 - 针对智能体工作负载的优化
AgentX 在最初几个月里最具影响力的成果,并非产出了开源数据集,而是其产生的行业影响:AgentX 合作伙伴创建了 50 多个上游 PR,以 AgentX 为北极星指标,来优化真实的智能体工作负载。AgentX 的真实智能体流量基准测试不仅涵盖原始的 prefill 和 decode 内核,还测试了从 KV cache 生命周期、混合注意力缓存正确性、CPU KV 卸载、传输进度、路由亲和性,到增量分词、请求序列化和调度器簿记的整个端到端 token 生成过程。所有这些步骤对于每一个生产级智能体部署都至关重要。
这只是我们持续使命的延续,旨在帮助生态系统加速改进,并在软件领域实现光速提升。一个很好的例子是 SemiAnalysis 与 AMD 软件开发团队的多年合作。在此期间,我们不断提供反馈和建议,帮助他们实现软件开发原则的现代化。这不仅促成了许多加速 AMD 进展的变革,而且对使 AMD 开源技术在智能体工作负载上接近一流水平也起到了关键作用。
分布式推理生态系统简介
如前所述,智能体推理本质上是一个系统级问题,而不仅仅是芯片/内核级问题。此外,当大型分布式系统处理数十万个智能体请求时,请求调度和 KV cache 管理会变得非常复杂,并对性能产生实质性影响。例如,子智能体会产生突发的 KVCache 模式,如果优化不当,就会错误地驱逐主智能体的缓存。
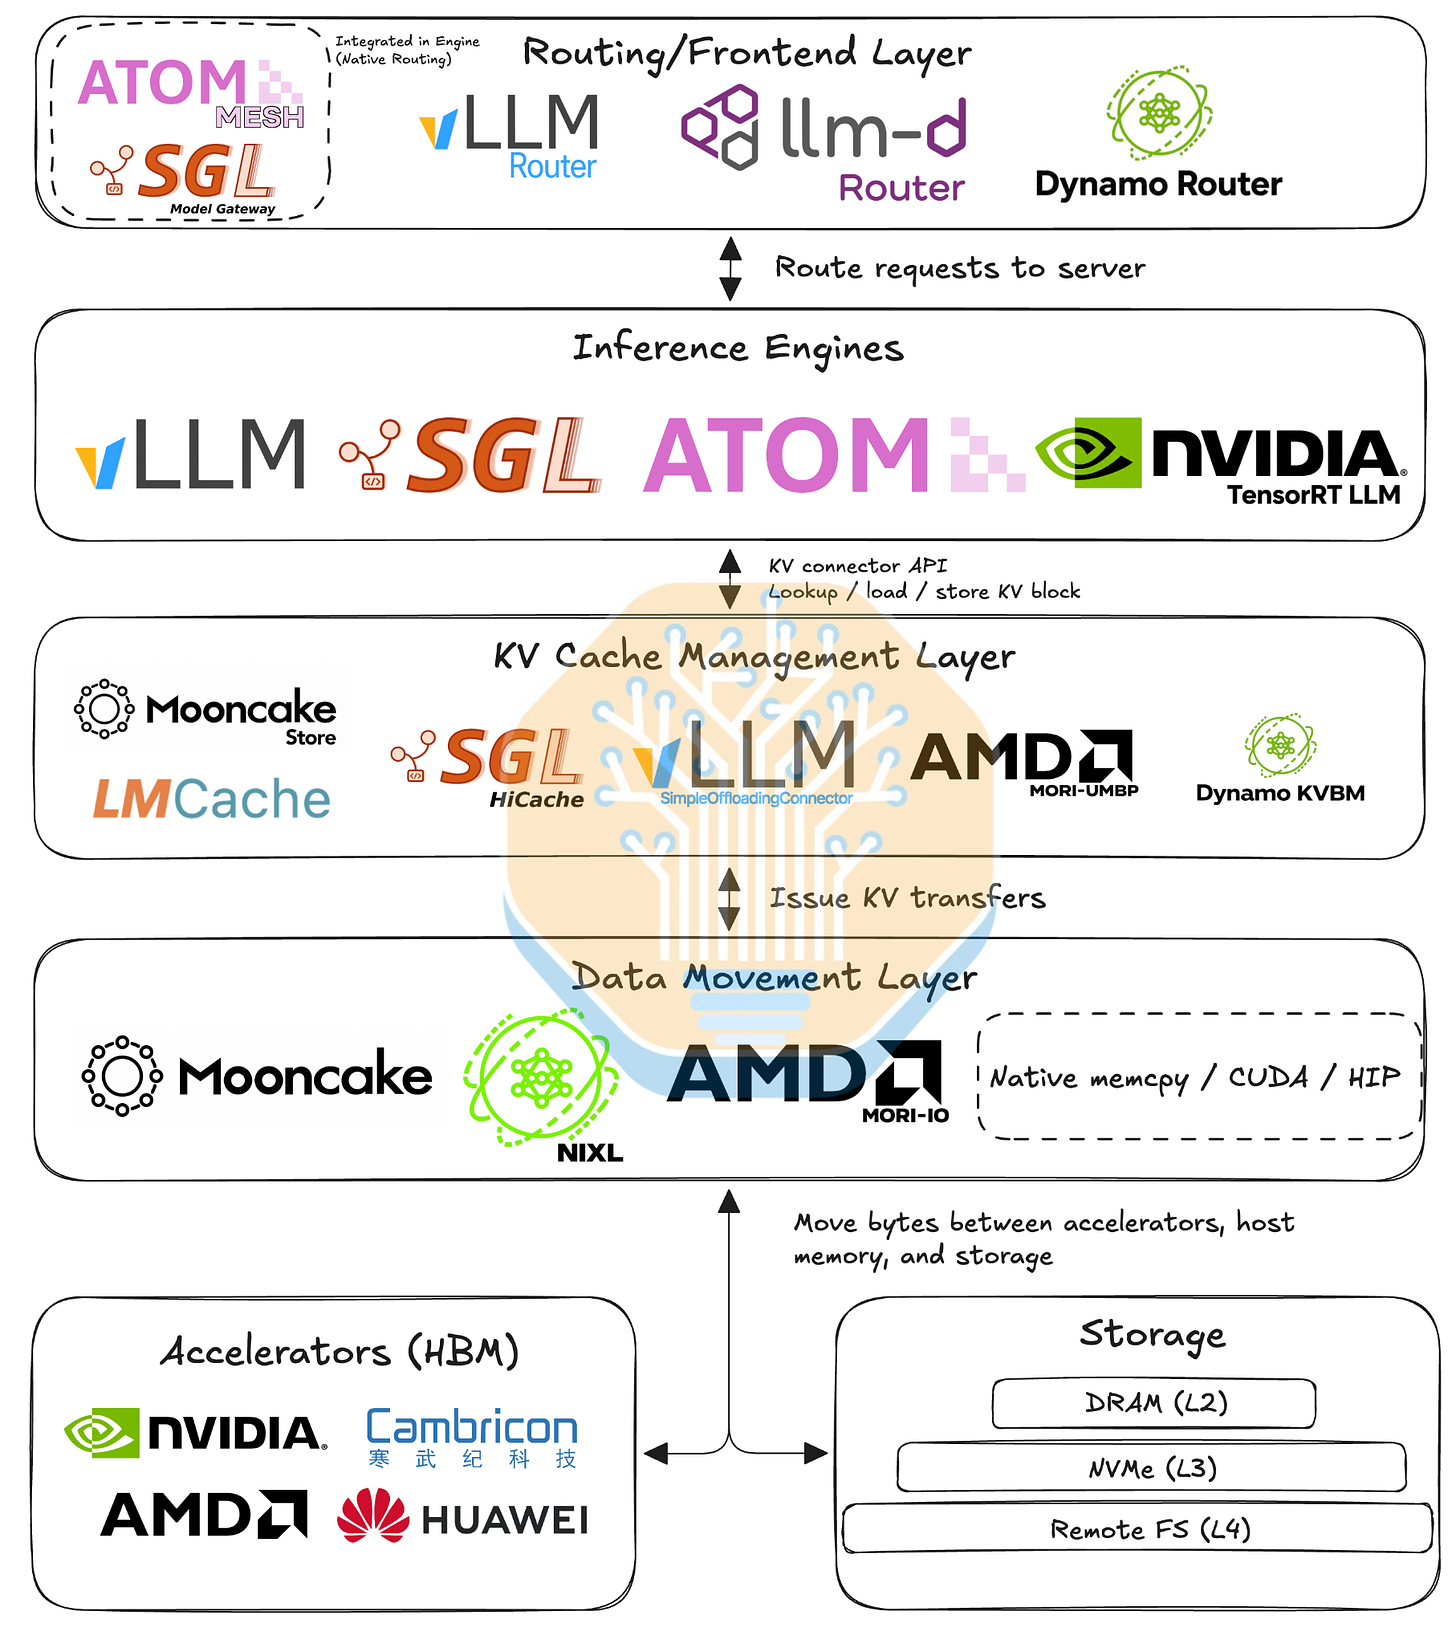
下图展示了宏观层面的技术栈。在顶层,路由器(有时称为“前端”)将请求路由到不同的 worker。例如,当服务器运行数据并行注意力时,每个 DP rank 都有独立的 KV cache。为了避免任何一个 KV cache 发生频繁抖动,系统会根据不同的策略进行路由,比如采用一致性哈希策略。在这种情况下,同一会话/子智能体中的请求会通过其唯一 ID 进行路由。
Source: SemiAnalysis
对于大多数路由策略而言,不同路由器实现之间并没有显著差异。有些是独立的组件,例如 vLLM router 和 llm-d router;而另一些则集成在引擎内部,例如 SGLang model gateway 和 ATOM Mesh。
请求经路由后,会交由 vLLM、SGLang 等推理引擎的调度器处理。引擎负责实际执行推理,并通过 API 返回结果。此外,每个引擎都有一个接口,用于将引擎内部的 KV cache 连接到外部 KV cache 管理器。这构成了一个“可插拔”的生态系统,使不同的 KV cache 管理器能够与各种推理引擎集成。
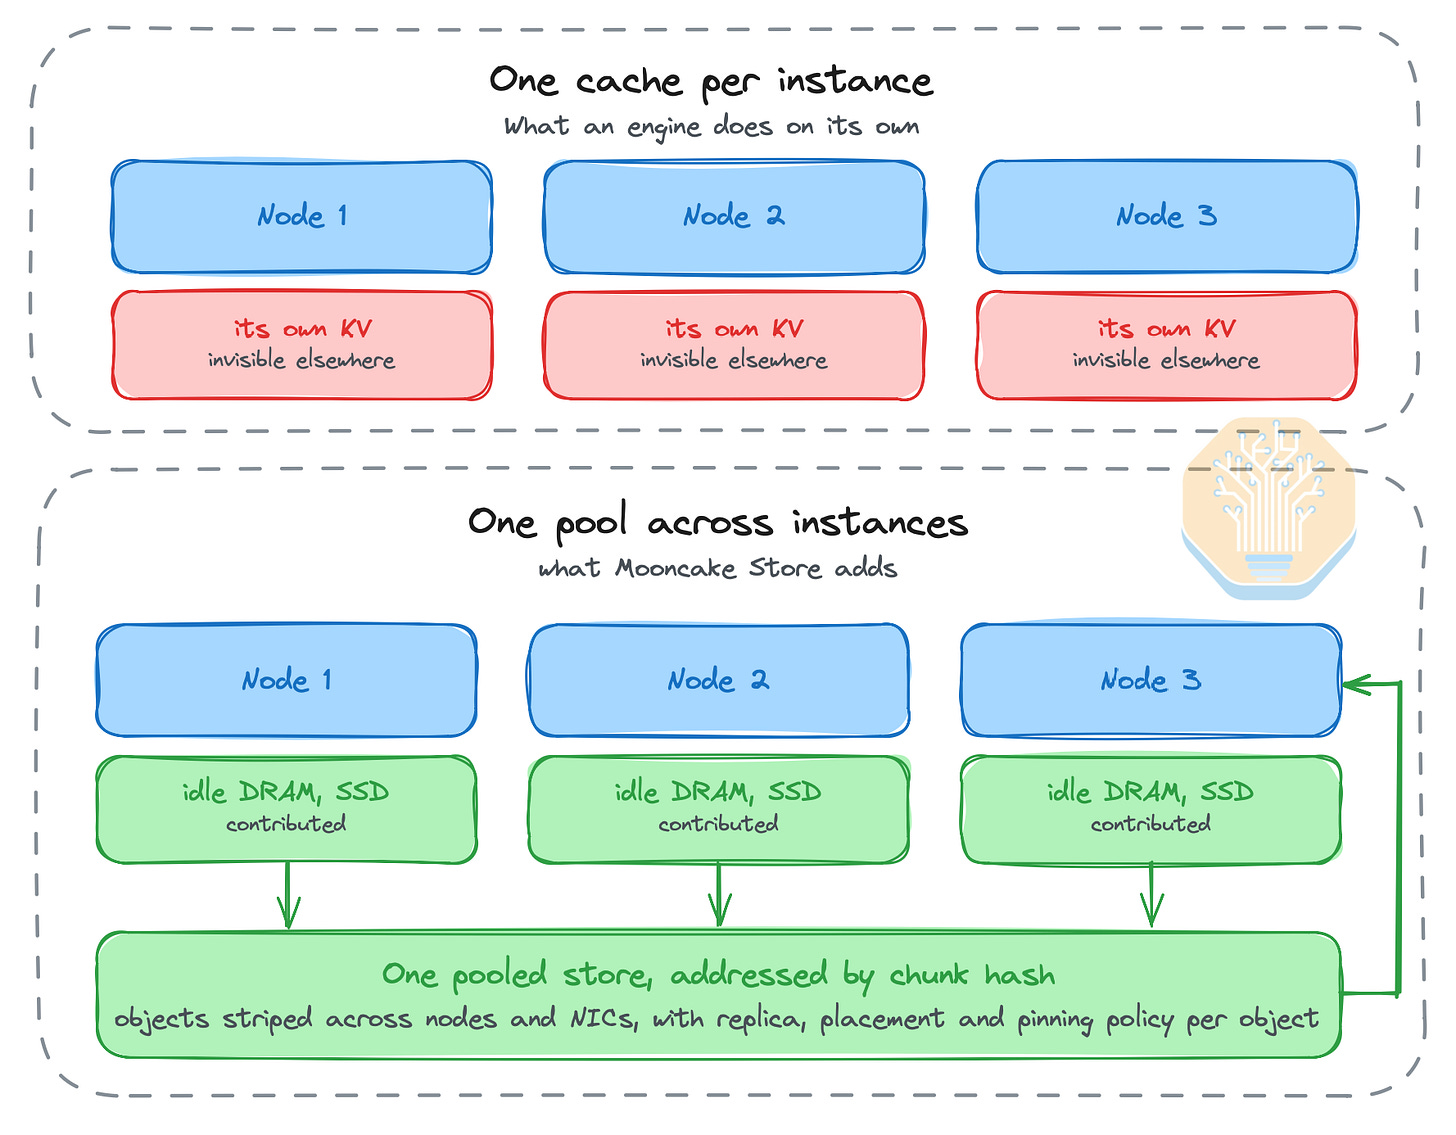
当前 AgentX 结果中使用了一种简单的部署方式,即将 Mooncake 和 vLLM 运行在同一节点上。每个 vLLM worker 都内嵌一个 Mooncake Store 客户端,并将一部分主机 DRAM 贡献给外部 KV-cache 池。vLLM 通过 MooncakeStoreConnector 接口连接到该池,将可重用的 KV block 加载到 GPU 内存中,并将新计算的块保存回主机内存。Mooncake Store 负责管理外部缓存,包括缓存的放置和驱逐;而 Mooncake Transfer Engine 则执行 GPU 内存与 CPU 内存之间的实际数据移动。
不同的 KV cache 管理器可能会使用不同的传输引擎,在内存层或机器之间(例如 prefill worker 和 decode worker 之间)进行物理上的数据移动。例如,Mooncake Store 使用 Mooncake Transfer Engine 在 GPU 内存、主机 DRAM 和远程节点之间移动 KV block。
部署时可以使用 Mooncake Store 将可重用的 KV block 卸载到主机 DRAM,同时使用 NIXL 直接将特定请求的 KV 从 prefill GPU 传输到 decode GPU。Mooncake TE 负责处理 Mooncake Store 路径的数据移动,而 NIXL 则在支持的设备上利用 UCX 和 GPUDirect RDMA 处理独立的 prefill-decode 路径。因此,多种 KV 管理和传输路径可以在同一个推理引擎内共存。
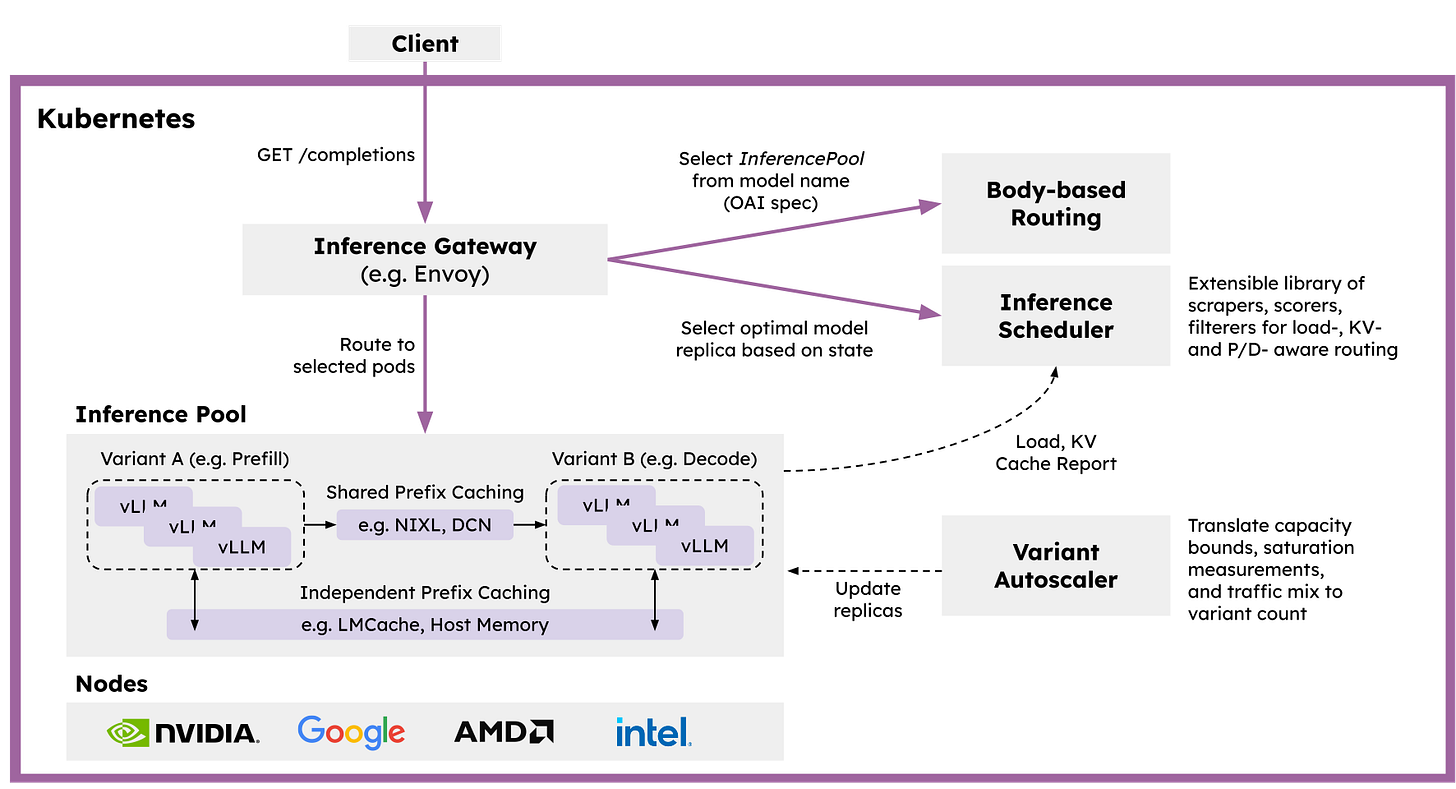
该生态系统由许多独立的组件构成,包括推理引擎、路由器、KV-cache 管理器、数据传输库和集群控制器。诸如 Nvidia Dynamo、llm-d 和 AMD Infera 等平台会将这些组件的特定组合“打包”成完整的软件发行版。它们发布兼容的容器镜像、连接器、部署清单和编排逻辑,使这些组件能够作为一个系统进行部署和运维。最终的产品通常是协调配合的容器集合,而不是单一的整体服务(例如:Dynamo、llm-d 和 Infera 通常部署在 k8s 上,用于协调大型分布式系统)。
Source: RedHat / llm-d
上下文并行
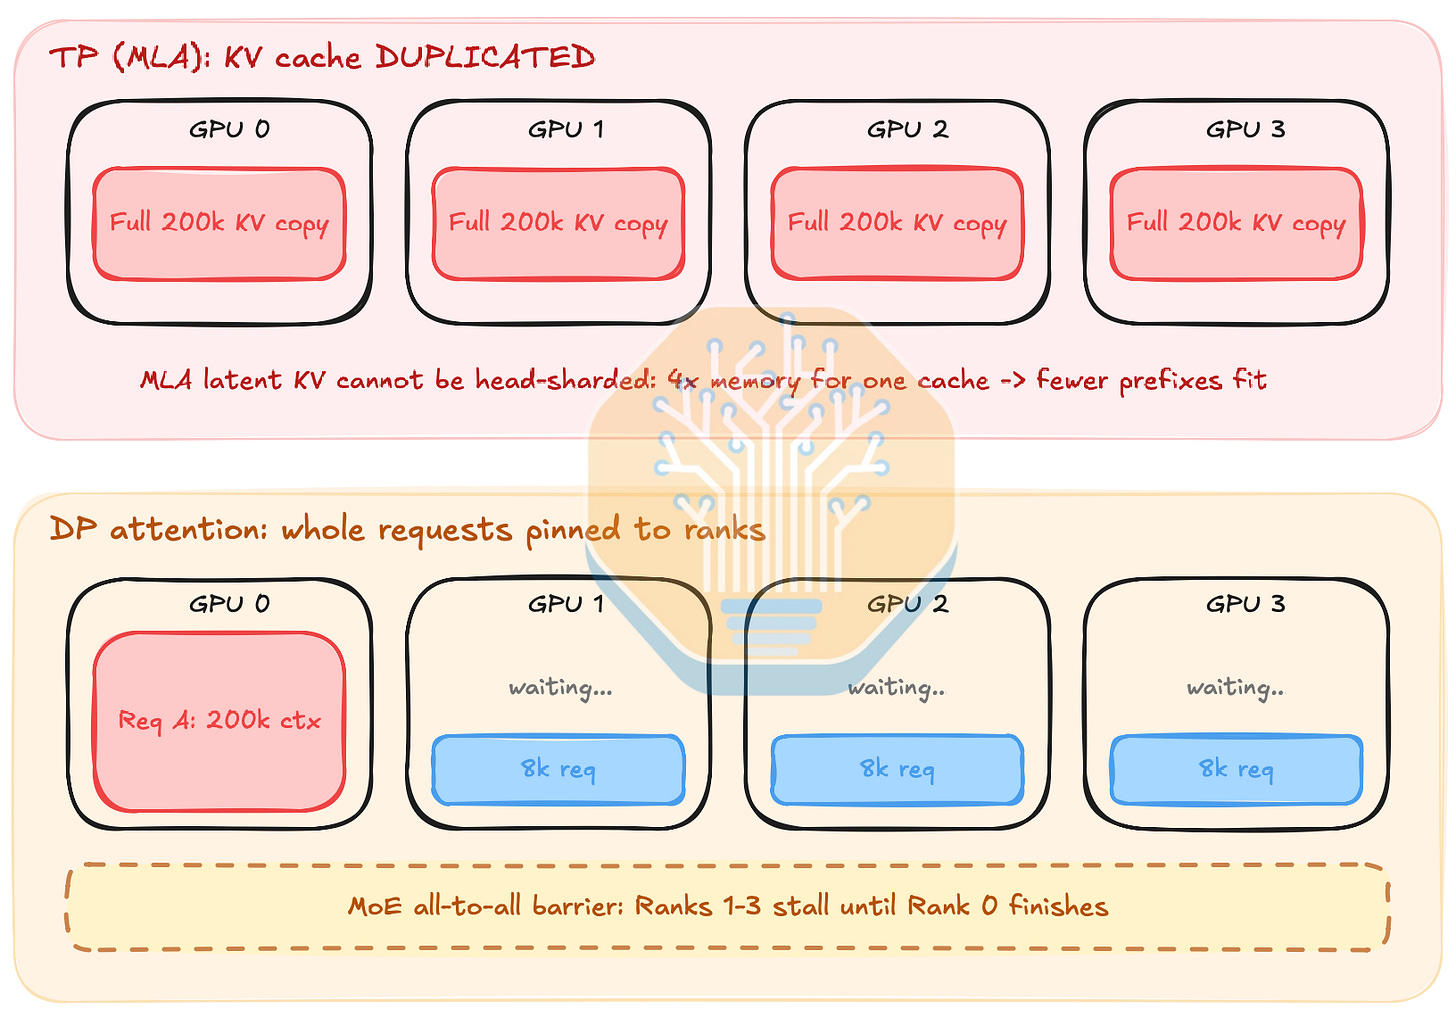
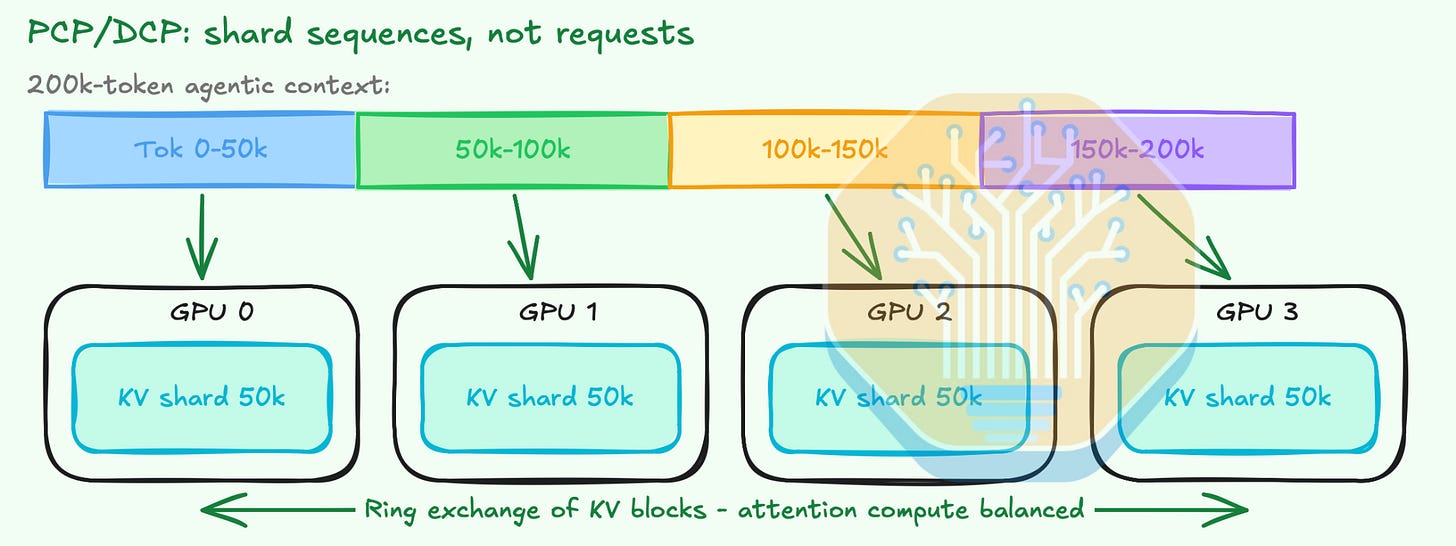
长上下文有利于并行技术,而固定的 8k prompt 无法充分发挥这一点。因为在 8k 长度下几乎没什么可拆分的,而且 TTFT 本身就很短。此外,TP 和 DP attention 等并行策略在更长上下文中的效果并不理想。例如,TP 会导致完整的 KV 在每个 rank 上都被复制。对于 DP attention,虽然 KV 是共享的,但在处理长上下文时容易遇到瓶颈。因为长上下文工作负载也会导致可能的上下文长度方差变大。
Source: SemiAnalysis
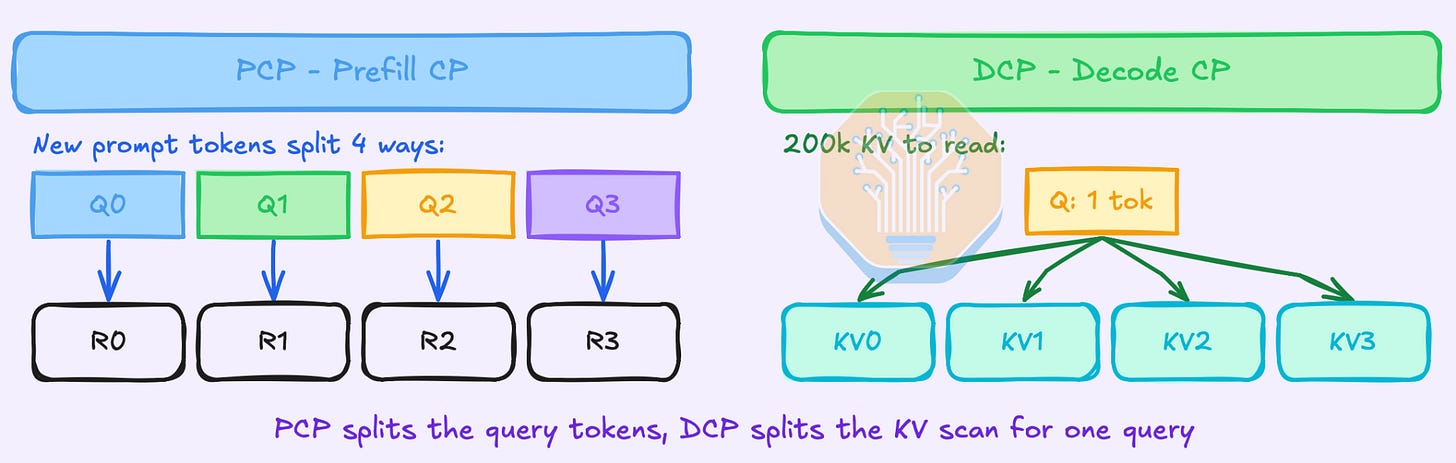
Context parallelism 是一种将 query token 拆分到多个 GPU 上的并行技术。它有两种形式:用于 prefill 的 PCP 和用于 decode 的 DCP。在 PCP 中,每个 rank 对其分配到的 query chunk 进行 prefill(KV 通过环传递)。由于 prefill 通常是计算密集型任务,这种方式可以并行化 FLOPs。这样不仅加快了 prefill 速度,还避免了单个 rank 上出现巨型 prompt 的 prefill 峰值。对于 DCP,每个 rank 扫描其 KV 分片,然后以 flash-decode 的方式合并部分 attention 结果。由于 decode 受限于内存带宽,并行的 KV 读取可以提高 tok/s。
Source: SemiAnalysis
这项并行技术部分由 Nvidia Research 发明。Nvidia Research 擅长此类基础研究。但在端到端训练研究方面,他们推出的糟糕的 Nemotron3 Ultra 模型着实让美国蒙羞。该模型目前甚至被微小的 Qwen3.8 27B 模型大幅击败。DCP/PCP 构成了 CUDA 护城河的一部分,因为 AMD 对 DCP/PCP 的实现尚未优化。在 vLLM 支持矩阵中,所有 AMD 后端均不受支持。
接下来几节中提到的一些改动主要针对 DCP/PCP。
vLLM Agentic 优化
我们与来自 Inferact、Red Hat、NVIDIA 和 AMD 的 vLLM 维护者合作。我们将 AgentX 的真实回放器作为指路明灯。最终的修复已合并到上游,其中大部分优化都高度适用于生产环境。以下是一些示例:
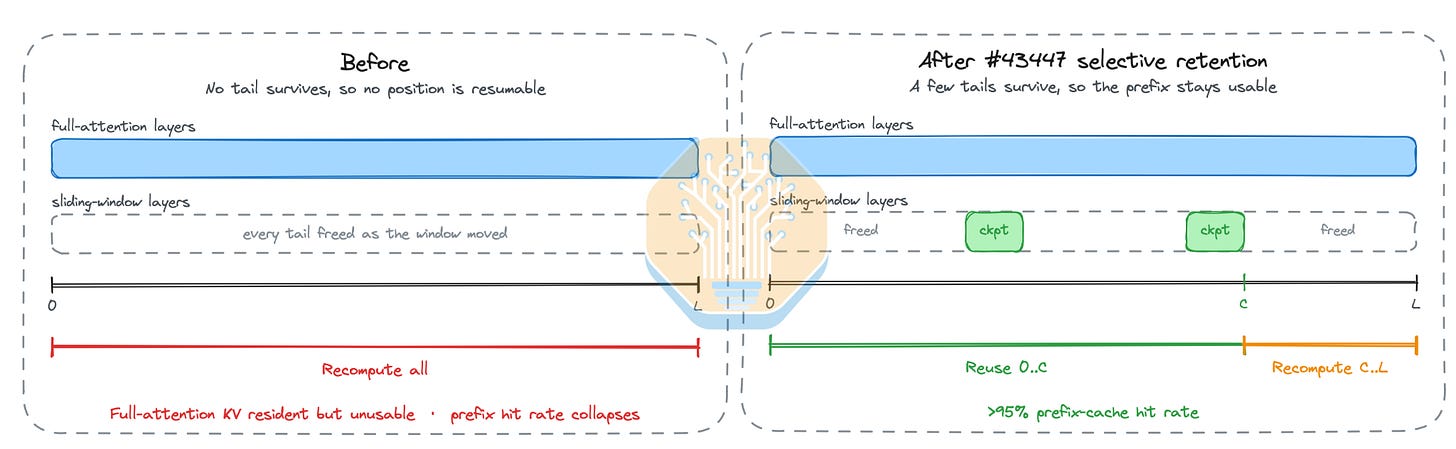
vLLM 改进了混合 attention 的 prefix caching。这样短期的滑动窗口分配就不会驱逐有用的长上下文检查点。选择性保留维护了稀疏重放边界。据报道,在十四个并发请求且上下文长达一百万 token 的情况下,prefix cache 命中率超过 95%。同样的可达性策略也应用到了 Mooncake 中,并移除了无法访问的滑动窗口查找。早期的后续工作也停止了对永远无法重用的滑动窗口块的卸载,并将推测性前瞻块保留在缓存的 prefix 中。
Source: SemiAnalysis and vLLM GitHub PR for Agentic Workloads
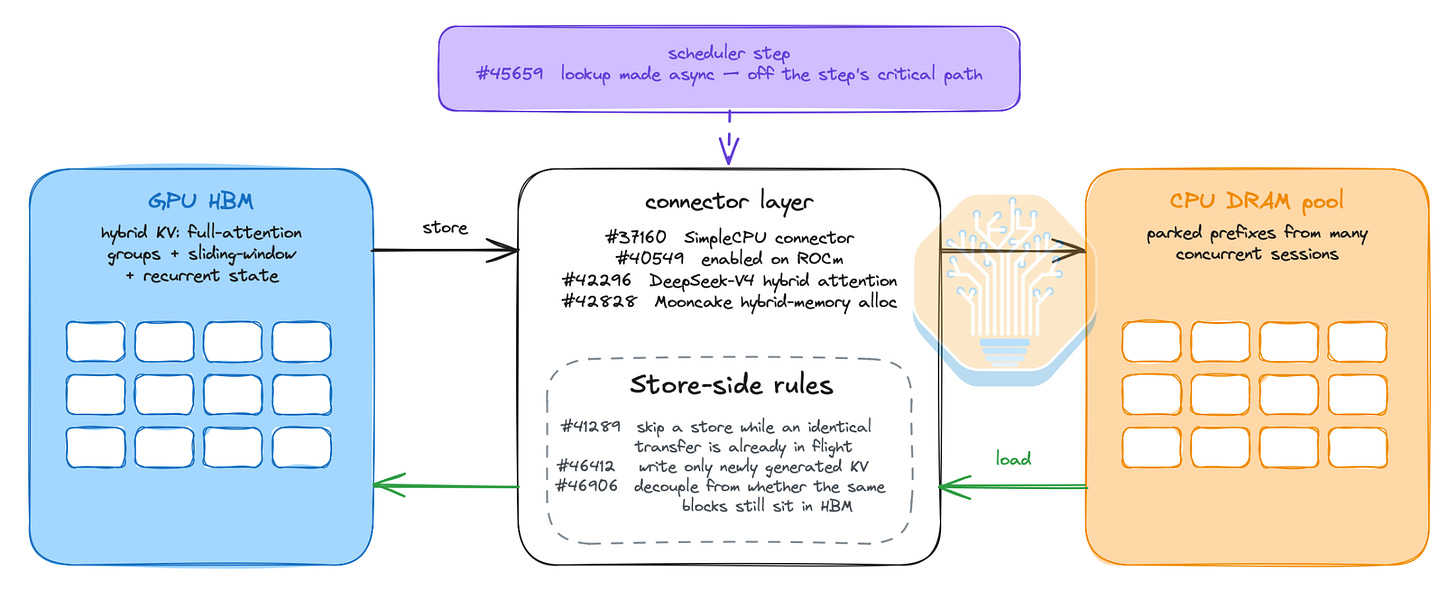
高并发智能体场景下的 Agentic Workloads 需要进行卸载。得益于前文提到的 AgentX 的影响,vLLM 上已经有相关工作流,旨在为混合模型(而不仅仅是统一的全注意力模型)提供 CPU KV 卸载支持。这种区别非常关键。统一模型对每个 token 只有一种 KV 布局,因此连接器可以用单一的块几何结构来描述需要保存的内容。混合模型则同时承载多个缓存组,每个组具有不同的形状和生命周期。假设布局统一的连接器无法表达特定块属于哪个组。因此,对于长会话最需要卸载的模型来说,该功能此前一直不可用。通用的 SimpleCPU 连接器率先问世,先在 ROCm 上启用,随后扩展至 DeepSeek-V4 混合注意力。报告显示,当前缀无法再容纳于 HBM 时,与重新计算前缀的方式相比,该方案的输出吞吐量提升了 81.7%,平均端到端延迟降低了 46.6%。
Mooncake 也获得了同等的混合内存分配支持。在分离式推理中,同样的布局问题再次出现。一个待处理的变更在 1P1D 预填充/解码分离架构中,通过 MoRI-IO 传输 Kimi-K3 的 conv+ssm 循环状态及注意力 KV;否则解码侧将从未初始化的循环状态启动。该循环状态槽位复用了现有的 remote-block-ids 通道,因此分离路由器无需针对模型进行修改。该路径已在 MI355X 上完成端到端测试,各节点间通过 RDMA 实现 TP8,且两侧均启用了 DSpark 推测解码。
在对实际工作负载进行性能分析时,vLLM 维护者注意到,在卸载过程中开销转移到了存储路径上,该路径的写入操作过于频繁且数据量过大。目前已有三项新修复解决了这一问题:当相同的传输任务正在进行时,将跳过后续存储操作。这样一来,共享同一前缀的并发会话只需支付一次开销,而非每个会话各付一次。存储操作仅覆盖新生成的 KV 范围,因此扩展历史的会话只需写入增量,而无需在每一轮重写整个前缀。最后,存储不再取决于相同的块是否仍驻留在 HBM 中。因此,当在其下层发生驱逐时,已调度的任务不会被丢弃。
加载路径则进行了单独优化,因为每次调度决策时都会发生查找操作,而非仅在数据实际移动时。在调度路径中实现异步查找,使连接器脱离了单步执行的关键路径。因此,一个执行步骤在接纳新任务前无需再等待 CPU 端的缓存查询。紧凑的零拷贝查找键、并行的接收端加载,以及预构建的 Mooncake 键字符串,随后消除了剩余的 CPU 和传输开销。
Source: SemiAnalysis and vLLM GitHub PR for Agentic Workloads
长生命周期的混合状态也强制要求修复正确性和记账问题,这些问题在固定形状请求中很少遇到。vLLM 会针对每个混合缓存组发出缓存事件,正确分发分布式上下文存储中的步长,并在分布式上下文和预填充阶段正确计算查找前缀。一项相关的上下文并行记账变更,将缓存所有权与分片的 token 范围对齐。现在,推测状态可以跨越合并的 Mooncake 组并通过 SimpleCPU 协调器进行传递,从而防止重复轮次缓存悄悄丢失 EAGLE 状态。
着眼于在 vLLM 中优化 Agentic 工作负载的 ROCm 侧,相关工作在缓存层之下继续推进,剩下的开销来自各层而不是每个请求。一旦前缀得以保留并准时到达,剩下的就是 decode 步骤本身。在一个会话中运行数千次的 decode 步骤,必须为每一次可避免的拷贝和每一个不匹配的内核付出代价。
有三项待定的变更旨在攻克这一层:
一项 Kimi-K3 的变更将 KDA decode 结果直接写入层输出缓冲区,从而移除了每个 KDA 层的一次设备拷贝;单独看节省的开销很小,但这会在每个解码 token 的每一层中重复出现。 第二项变更选择使用 AITER sparse-MLA decode 内核来替代通用路径,据报告,AgentX 输出吞吐量提高了 5.22%,且 token 间延迟显著降低。 第三项变更很好地说明了测量形状的重要性有多大。一项配套变更将全图注意力投影通过经过调优的 AITER GEMM 进行路由,在低并发下的固定序列上实现了 2.3% 的提升。这表明,内核级的变更可以在统一形状上展现出明显的增益,但在 agentic 追踪中,该增益会被追踪本身引入的缓存与调度波动所掩盖。一项待定变更将这种形状敏感性直接转化为调度标准本身:它用 gfx950 上的混合 AITER/原生路径,替换了 DeepSeek V4 C4A 选择器在 ROCm 上的 top-k 瓶颈,将短上下文和中等上下文通过 AITER 路由,并将长上下文通过图安全的调优原生后备路径进行路由。据报告,其端到端选择器加速比达到了 1.21x 到 1.76x,在 84 种形状的矩阵上,decode 内核的几何平均加速比为 1.2x 到 2.9x。 SGLang Agentic 优化
AgentX 团队一直与来自 RadixArk、Meta、Nvidia 和 AMD 的 SGLang 维护者密切合作,推动使用 SGLang 运行的 Agentic 工作负载的优化。这极大地提升了生产环境下的推理性能。下面我们将深入探讨这些优化。
我们先来解释,在分配器侧,SGLang 的滑动窗口机制是如何解决与 vLLM 保留策略相同的冲突的。窗口页和前缀页取自同一个池,而窗口是更贪婪的消费者:它会不断轮换,而前缀则保持静止。因此在内存压力下,临时分配就会挤占持久分配。
三项设计改进从不同角度着手解决这一问题。其中一项改进是在页面离开窗口时主动将其释放,而不是等待驱逐压力来发现它们。这样,失效的窗口状态就不会再为它无法使用的页面展开竞争。另一项改进将计算锁限制在单一窗口内,从而限制了处理中的请求一次能固定多少池容量。第三项改进则移除了已经失去作用的过期完整 KV 条目。
然而,主动释放机制存在一个分叉型的盲区:从共享前缀分支出去的请求,在分支点处的窗口状态已经被释放时,仍可能持有可复用的完整 KV。此时,仅仅因为缺少了廉价的半区,整个前缀都会被重新计算。Open work 会在这些分支点保留 SWA 状态,让分叉请求继承该窗口,而不是重建窗口。
除此之外,ROCm ring-cache 修复针对的是正确性,而非容量问题。环形缓冲区在设计上会复用槽位。如果复用的槽位中旧内容仍被引用,会导致输出错误,而不是输出变慢。在单一的 8k 提示词下,这些问题都不会显现。因为窗口永远不会越过前缀,池也永远不会发生争用。但在多轮混合会话场景中,正是这些改进决定了昂贵的全注意力历史记录能否留存到下一轮。
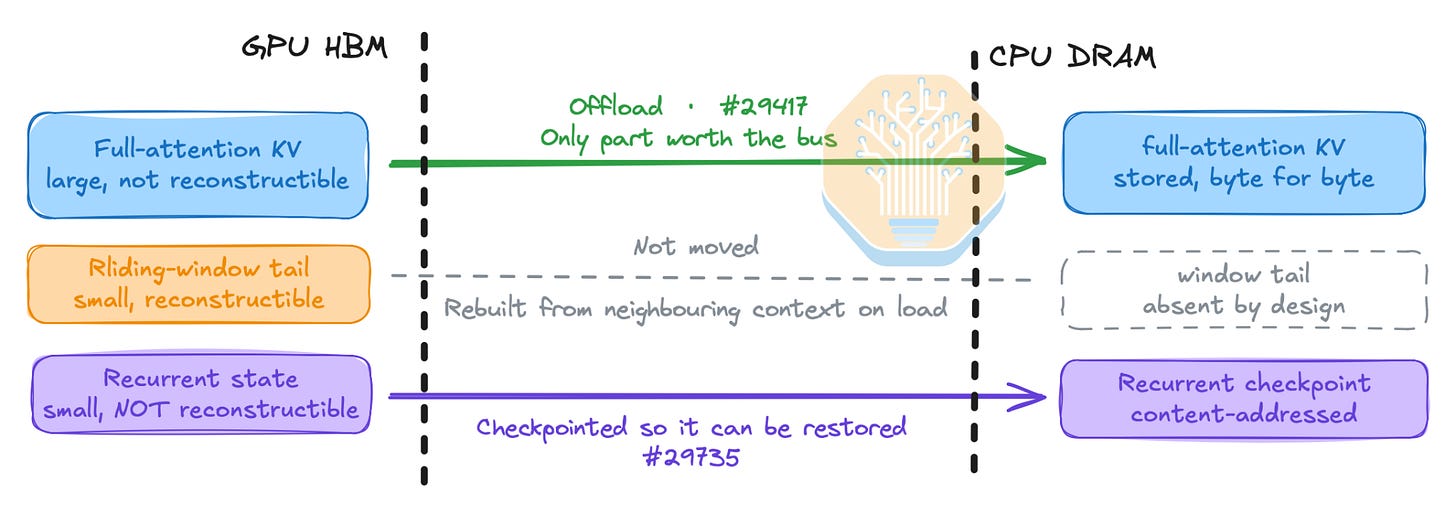
HiCache 是 SGLang 首个内置的体系级卸载机制。它面临着与 vLLM 连接器相同的混合问题,并通过一种非对称方案加以解决:卸载全注意力缓存,并在取回时重建较短的滑动窗口尾部。只有昂贵的半区才值得跨总线传输。而廉价的半区,重建速度比直接读取更快。在 AMD 平台上,分级写回机制确保了这种传输在发生时不会阻塞引擎。循环状态是最后遗留的缺口,因为它无法像窗口尾部那样从相邻 token 重建。FlashInfer GDN 检查点让它得以参与前缀复用,并在 92.4% 的缓存命中率下,将吞吐量从 47,771 提升到了 53,004 tok/s/GPU。
Source: SemiAnalysis
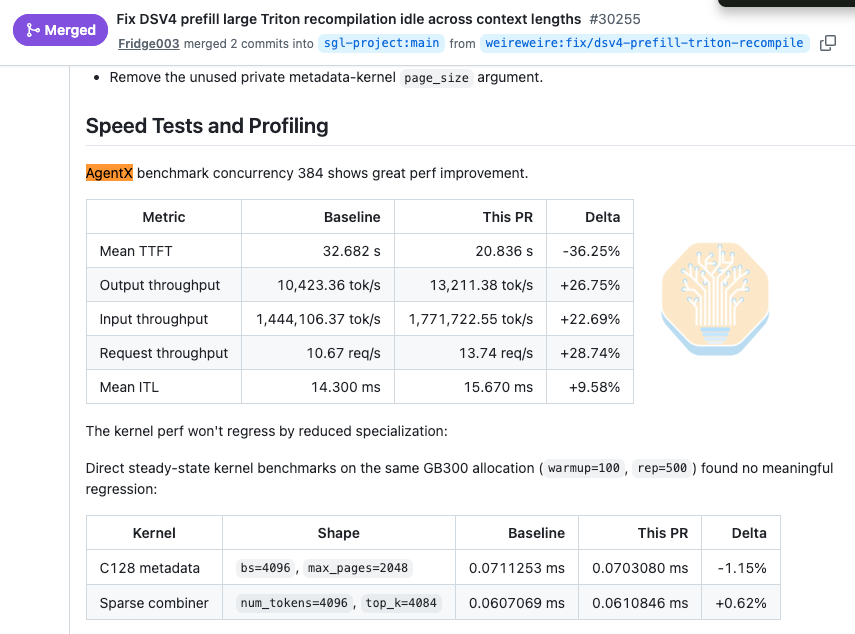
另外两项改进解决了变长流量影响内核管线的问题。AgentX 的实际会话通常以不断变化的上下文长度到达,这与生产环境的流量模式相似。一个对长度进行特化的简单运行时,几乎会为它看到的每个请求编译一个新的内核。SGLang 维护者通过将上下文长度作为运行时标量传递来解决这个问题,而不是将其折叠进一次编译中。这使得 AgentX 并发 384 的输出吞吐量提升了 26.75%,平均 TTFT 提升了 36.25%。这些提升是通过消除编译实现的,而非源于更快的计算速度。
Source: GitHub
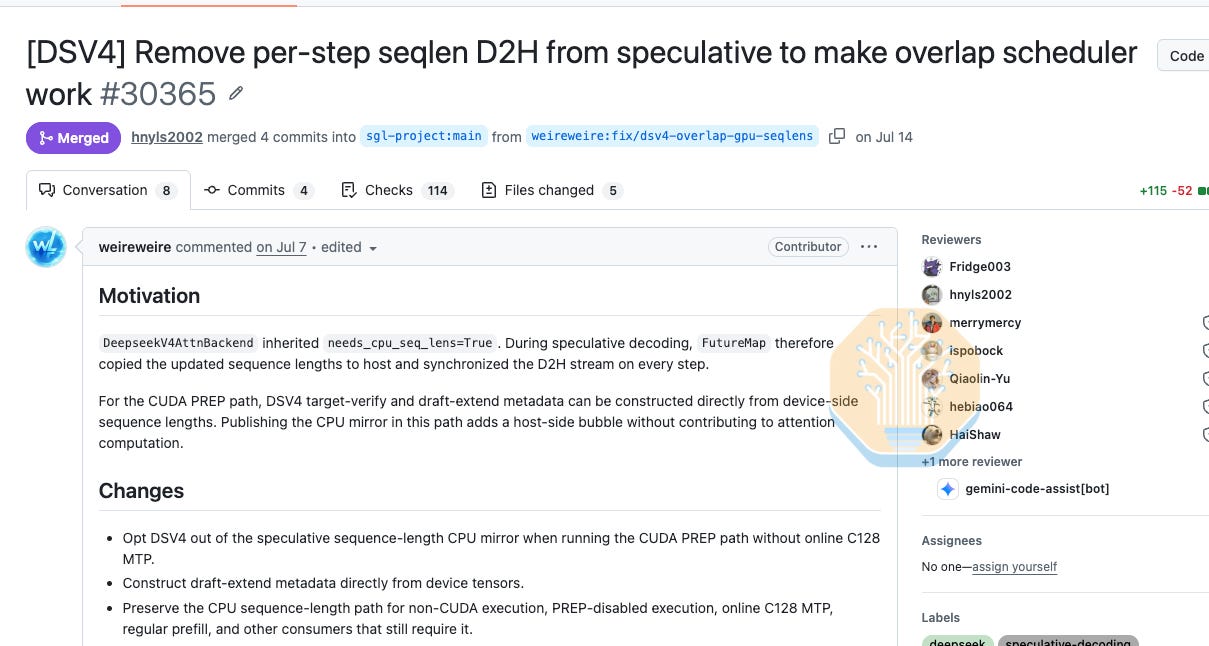
基于同样的思路,移除每步的设备到主机序列长度同步,消除了一个解码气泡。这个气泡的存在仅仅是因为主机想要知道一个设备已经拥有的长度。
Source: GitHub
可变长度在注意力 kernel 内部也会造成影响。在 GB300 上,混合上下文的解码批次会产生“尾部税”:一份匹配的性能分析报告显示,在 9.8 ms 的解码步耗时增量中,有 8.4 ms 归因于注意力机制,其中最长的请求拖延了常驻 kernel 的共享波。Open work 将 TRTLLM MHA 解码批次拆分为按 KV 长度排序的组,这样短请求就不必再等待最长的请求完成。
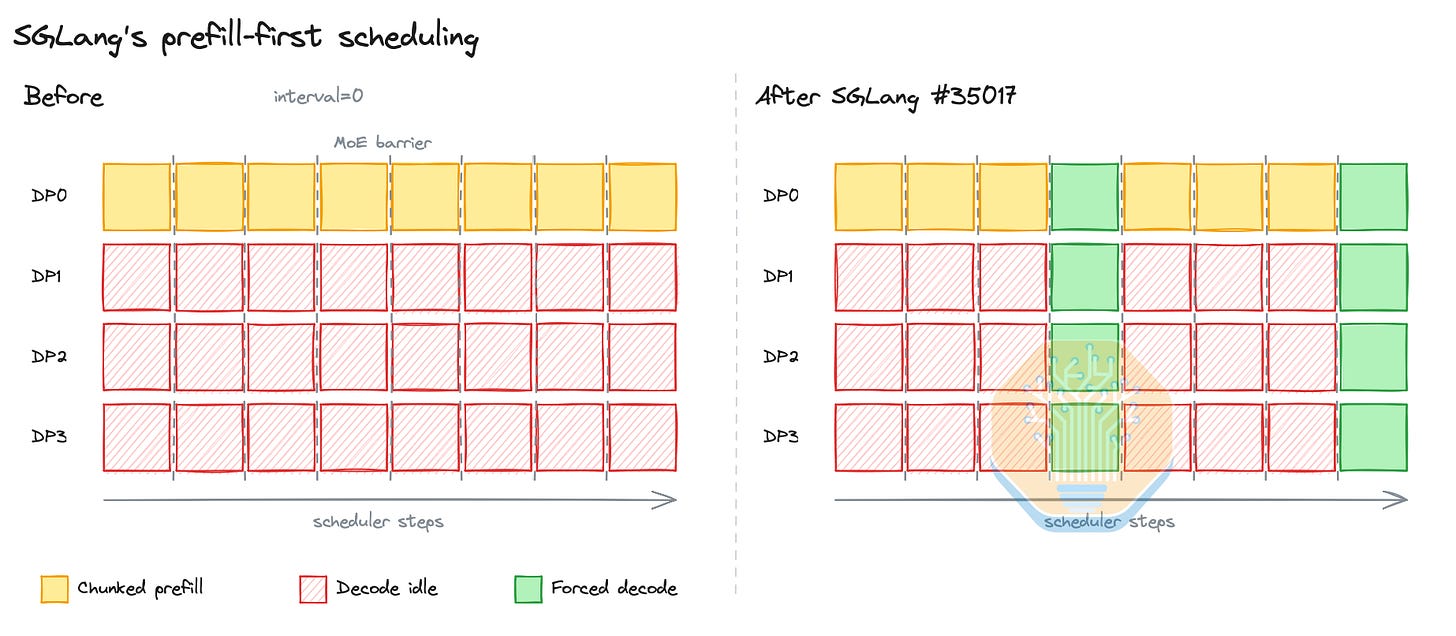
在上一层,即调度器层面(而非 kernel 内部),解码同样可能面临资源匮乏。在 DP attention 下,每个 rank 在本地调度注意力任务的同时,都会加入同一个 MoE 集合通信。因此,当某个 rank 持续接收分块 prefill 的续接任务时,它会不断在“prefill 优先”的决策中胜出,而其他 peer rank 上正在运行的批次只能原地等待——这一现象已在 AgentX 的运行中观察到。通过配置 prefill 后的解码间隔,可以强制在多轮 prefill 之间插入解码轮次。在 AgentX DSv4 Pro 上,这使得输出吞吐量提升了 141%,p99 的 Token 间延迟降低了 97.3%。代价是中位数 TTFT 从 36.5 秒升至 59 秒,即以首次 Token 的等待时间换取了流的平滑度。
Source: SemiAnalysis
当请求不包含可复用的历史记录(例如子智能体启动时),将其分配给任何一个 worker 都可以,此时负载均衡是唯一需要考虑的问题。当请求携带了 1 MB 的缓存前缀时,将其发送给未持有该前缀的空闲 worker 将是代价高昂的选择。路由器需要知道状态已经存储在哪里。SGLang 引入了 DP cache affinity,使得会话会固定在持有其缓存的 rank 上。在该 PR 中,同时实现了感知 DP 的 prefill 和 decode 路由,使得分离式部署的双方都能做出一致的决策。此外,它还将缓存均衡作为路由信号,确保亲和性不会退化为单一热点 worker。路由器只能基于已知信息采取行动,因此混合缓存事件也具备了感知 radix-cache 和感知 sliding-window 的能力。
推测解码受到了特别关注。因为 MTP 增加了第二份较小的单请求状态,该状态必须像主缓存一样在所有环节中存活下来。SGLang 修复了分离式服务中的草稿窗口传输问题,使该状态在跨越 prefill 到 decode 的边界时保持完整;为高并发在线解码添加了重叠调度;移除了一次无效的 EAGLE 重归一化操作;并在 EAGLE prefill 期间避免了主机同步。关于资源租约调度和数据并行图元数据修复的开源工作仍在延续这一目标:即确保在请求可以被撤销并恢复(而非简单运行至完成)的情况下,重叠调度依然安全可靠。
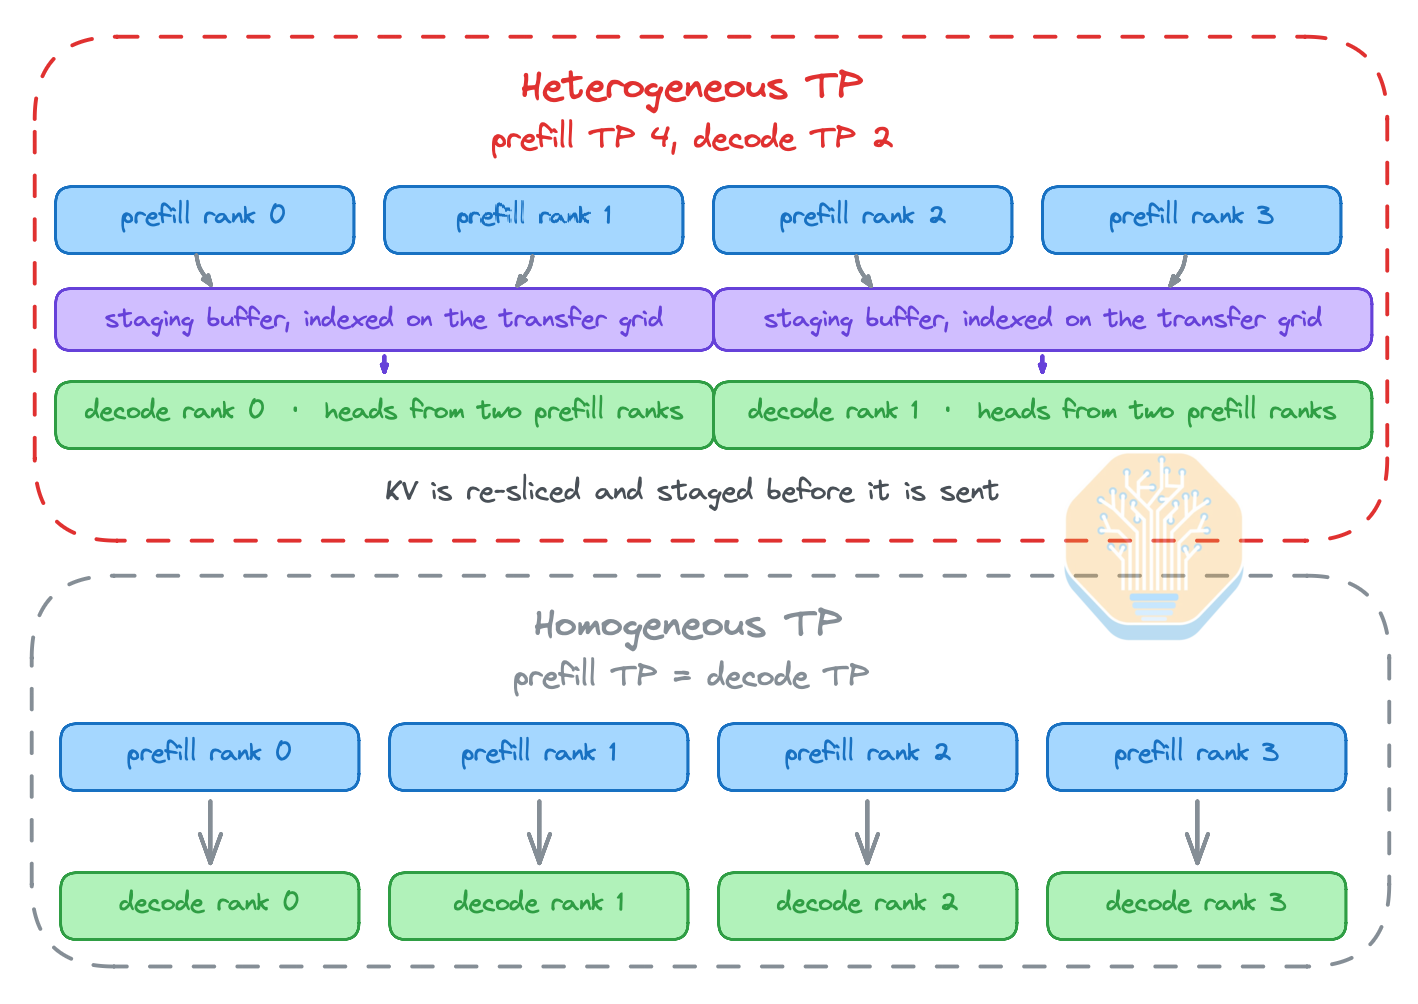
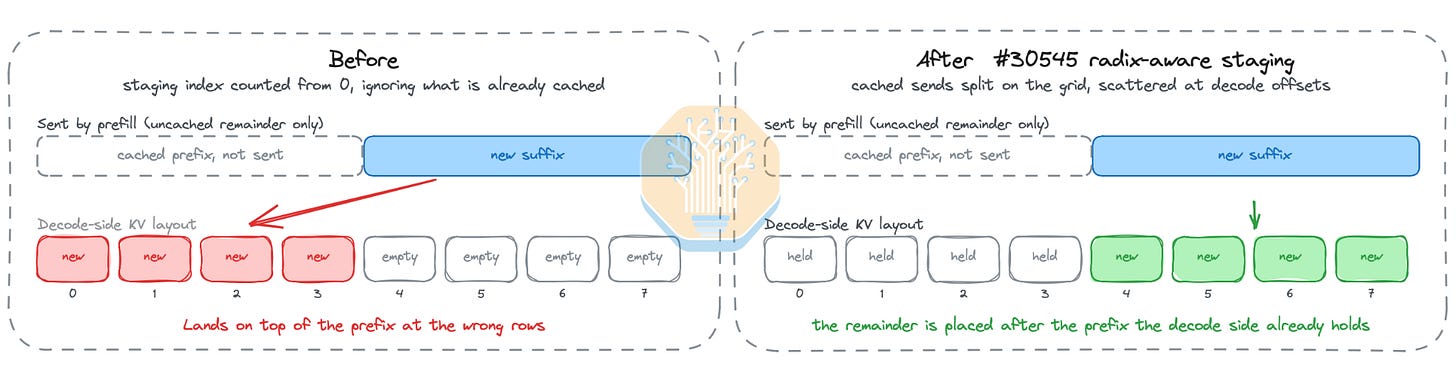
在审视采用异构 Prefill 和 Decode 拓扑的 Agentic 工作负载时,需要用到前缀感知暂存。而这正是前缀缓存与架构解耦产生冲突的地方。当双方的分片方式不一致时,KV 无法作为一条连续的数据流进行复制。它必须在传输网格上进行切分,并在 Decode 侧预期的偏移量处重新组装。前缀命中不仅不会简化此过程,反而会增加难度。因为 Prefill worker 现在只发送未缓存的剩余部分,而 Decode 侧仍然期望获得完整且位置正确的缓存。暂存缓冲区中的 Radix-cache 支持会在该网格上切分缓存的发送数据,并将其分散到正确的 Decode 偏移量处。
Source: SemiAnalysis
然而,这会导致正确性问题。一个 127,500 token 的共享前缀测试的正确率从 128 次中猜对 2 次,提升到了 128 次全对。这意味着缓存之前被静默放置在了错误的位置,而吞吐量基准测试原本会将其评定为一个快速、自信却错误的答案。在 AgentX 的对比中,在每 GPU 总吞吐量几乎不变的情况下,每用户输出吞吐量中位数额外提升了 9.6%。传输本身也存在无用开销:Decode 侧的 PREBUILT 批次从不进入模型前向传播,但每个传输的 prompt 依然会被展平并复制到一个 CUDA 输入张量中,而首个 Decode 步骤实际上是从中继元数据重建该张量的。去掉这种无用的 prompt 传输是最大的单项收益。它在 AgentX GB300 上使每用户输出吞吐量提升了 18.0%,每 GPU Decode 吞吐量提升了 12.7%。后续的优化将 Prefill DP-rank 引导查询移出了 Decode 调度器的关键路径,使得原本在结果消费时同步支付的 HTTP 往返时间得以重叠,在同一部署上又实现了 1.36% 的每用户输出吞吐量提升。正在进行的工作依然沿着这一方向展开:UMBP 中的多池 DeepSeek-V4 支持、跨越 MoRI 传递的统一 KV HiSparse 状态,以及在 Decode 终止且无可见内容时保留 Prefill 拥有的 token。HiSparse 相关工作应被视为针对长上下文的容量与正确性使能因素,而不是高并发下的吞吐量提升方案,目前它还不是。
Source: SemiAnalysis
TensorRT-LLM Agentic 优化
接下来,我们将介绍 TensorRT-LLM 近期的一些优化。首先,我们来看 TRTLLM 针对多轮对话的独特前端优化。这是一种仅因多轮工作负载而产生的开销。对话的每一轮都会重新发送完整的历史记录外加一点点新内容,而简单的实现方式会对所有内容重新进行 tokenization。每 KB 的 tokenization 成本很低,但如果每轮都对相同的 100,000 个 token 重复进行 tokenization,代价将是灾难性的。
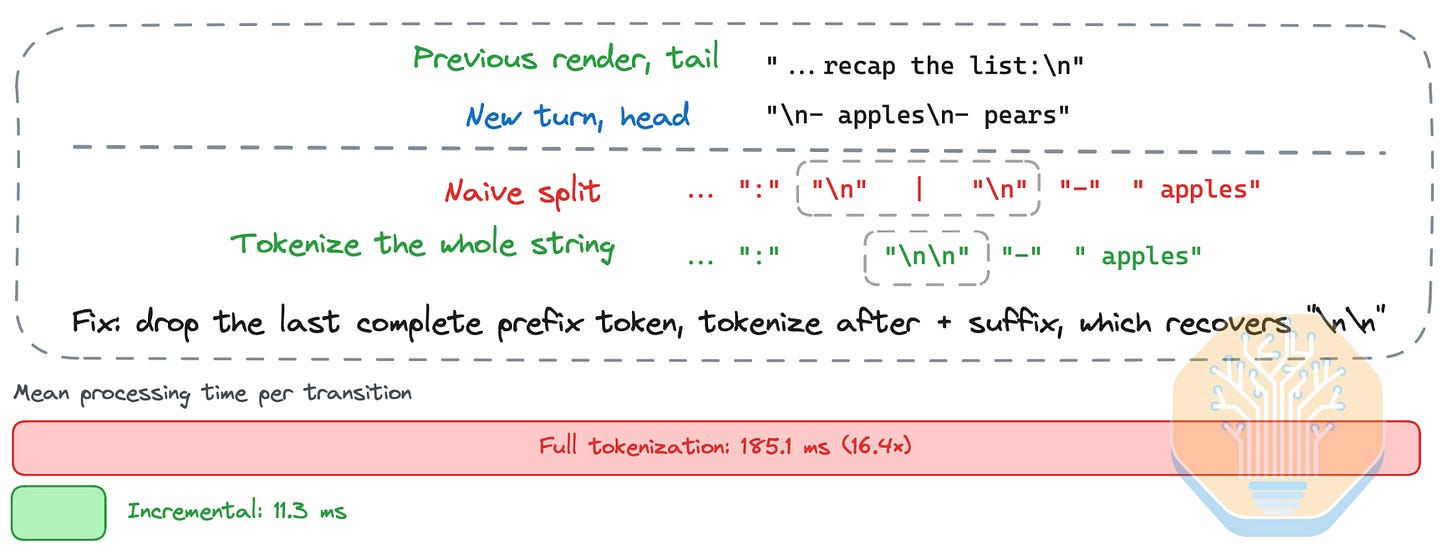
一个明显的修复方法是只对新的后缀进行分词。但这种方法存在一个很容易被忽略的错误,因为字节对编码(byte-pair encoding)并非位置无关。Token 可能会跨越拼接边界进行合并。因此,在边界处拆分文本并拼接两个 Token 序列,可能会产生与对整个字符串进行分词不同的序列。这会悄无声息地偏离前缀缓存所基于的原始序列。
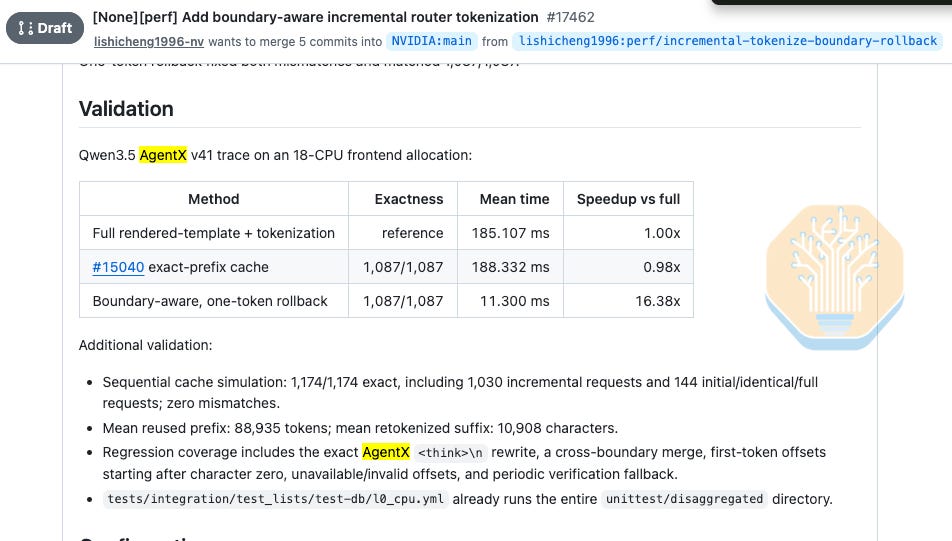
TRTLLM 实现了边界感知增量分词(Boundary-aware incremental tokenization)来处理这个问题。其具体做法是找到渲染文本的公共前缀,回退一个完整的 Token,以便重新计算任何跨越拼接边界的合并部分,然后只对发生改变的后缀进行分词。在 Qwen3.5 AgentX 追踪记录上,这种方法在所有 1,087 次转换中都与完整分词的结果完全一致。这一正确性是通过实际测试验证的,而非主观假设。同时,它将平均处理时间从 185.1 毫秒降低到了 11.3 毫秒。
Source: GitHub
固定的 8k1k 请求没有先前渲染的对话轮次可供复用,因此不会出现上述情况。另外,聊天模板渲染已被移至输入处理池中。这样一来,较长的模板就不会再导致其后的主请求循环发生串行阻塞。
Source: SemiAnalysis
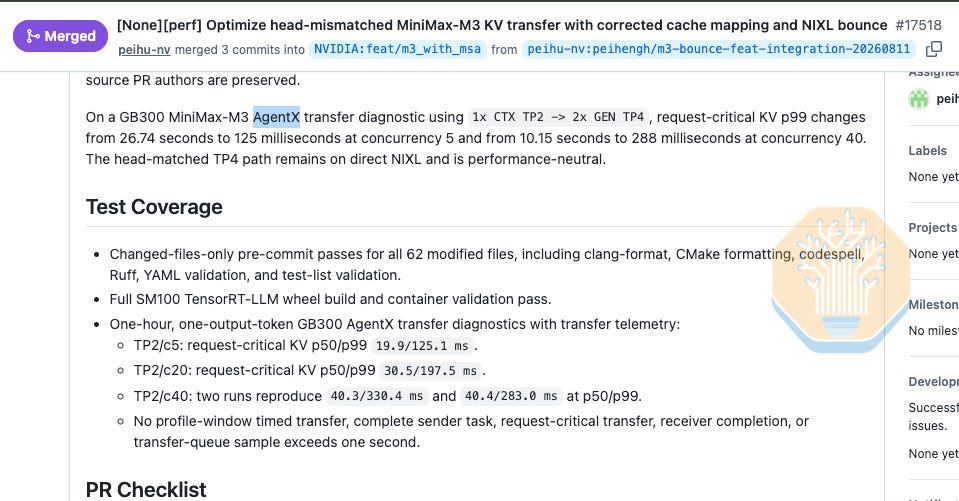
MiniMax-M3 的工作重点是解耦式 KV 迁移,其中的故障出在粒度问题上。当 Prefill 和 Decode 阶段的注意力头布局不一致时,一个逻辑请求的 KV 数据就不再是少数几个大型连续内存区域,而是变成数千个小型跨步片段,每个片段都会转化为一个独立的传输描述符。需要传输的字节数没有改变,但每个描述符的开销却急剧飙升。而且,在那些至关重要的长提示词上,开销的飙升最为严重!经过修正的多池映射和分块 NIXL 弹跳路径,通过一个有界可复用内存区将这些碎片合并起来。它以一次额外的暂存拷贝为代价,将描述符的数量减少了几个数量级。其 AgentX 诊断工具将请求关键的 KV p99 延迟,在并发数为 5 时从 26.74 秒降至 125 毫秒,在并发数为 40 时从 10.15 秒降至 288 毫秒。
Source: GitHub
非阻塞上下文迁移轮询机制通过及时回收已完成的传输来保护同一路径,即使在调度发生停滞时也能发挥作用。这打破了之前的恶性循环,即已完成的 KV 块保持锁定状态,从而阻止新的请求被准入。调度停滞本身也有一个可以消除的原因。在 GB300 解耦上下文 worker 上,DeepSeek-V4 的上下文稀疏注意力元数据中存在隐式的设备标量同步。避免这种同步消除了每个步骤中 18 次各 4 字节的设备读取操作,而这些操作每次都会强制触发 cudaStreamSynchronize。该修复方案将主机侧计数以普通 Python 整数形式传递,使得执行线程在一个步骤的大部分时间内不再持有 GIL,从而避免 KV 迁移线程和响应线程在后面排队等待。
TensorRT-LLM 还将不规则的 long-context 工作转移到了更高效的执行路径上。MiniMax-M3 的 context graph 生产者捕获了稳定的稀疏生产者,同时保留了依赖于请求的 eager attention。在 AgentX 测试中,其每用户输出吞吐量提升了 12.58%。一项开放的原生 KV-event 生产变更,减少了 KV-aware 路由路径上的分配和转换工作。
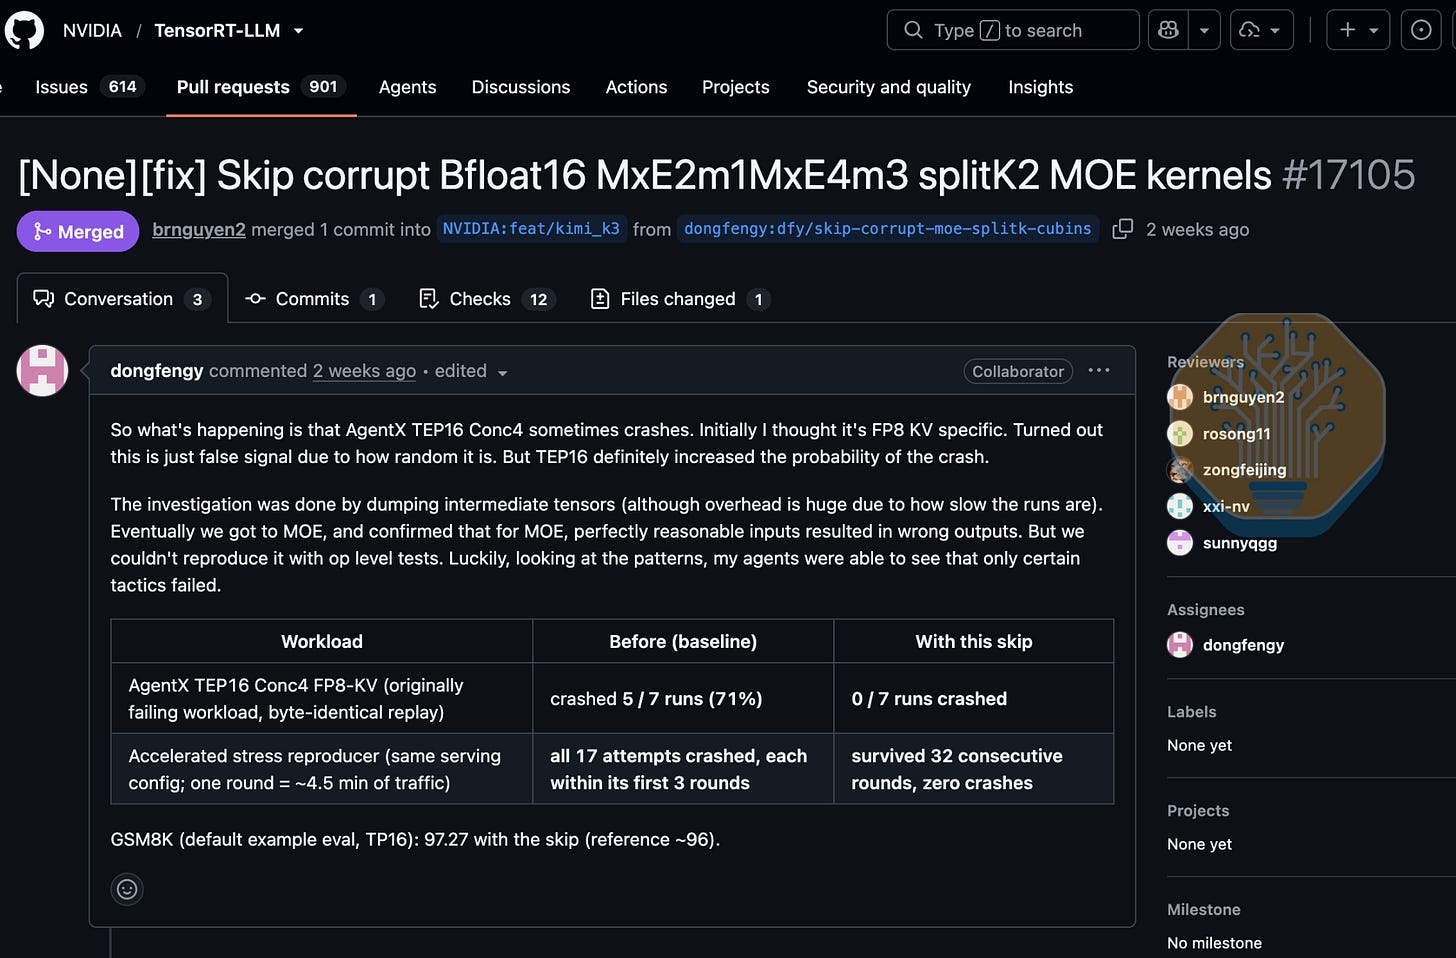
AgentX 还暴露了内核选择和调度器生命周期方面的故障,这些问题只有在扩大规模和长时间运行时才会出现。其中两个问题与内核选择有关。MiniMax-M3 在 MXFP8 autotuning 中增加了 CuTeDSL 选项,扩大了候选集,在低并发聚合点上,将每 GPU 的输出吞吐量提升了约 7% 到 10%。另一方面,TensorRT-LLM 禁用了损坏的 split-K MoE 策略,因为此前该策略导致七次 AgentX 运行中有五次崩溃。禁用后,在随后的七次匹配运行中没有出现任何崩溃。速度快但结果错误的策略,比仅仅是速度慢的策略更糟糕。如果不将其从池中移除,自动调优器会积极地选择它。选择错误并非内核出错的唯一方式:对于短查询,MiniMax-M3 旧版的 sparse-attention 路径会向 SM100 内核传递一个非连续的、head-major 的 block-index 视图。内核将其读取为连续数据,从而选择了错误的 KV 页,并产生不正确或非有限的输出。针对 q_len ≤ 32 的情况,遵循 block-index 步长修复了索引问题。这既不需要物化张量,也不需要添加内核。在随后的 GB300 上,五组匹配的完整 AgentX 对比测试均顺利完成,服务错误为零,且没有出现非有限标记。
Source: TRT Github
另外两个属于生命周期 bug,这是长时间运行的典型故障,而不是大规模运行的典型故障。Sequence-slot 预留空间和一致的 slot-indexed 缓冲区大小分配,能够处理一种暂时的重叠情况:即一个即将完成的请求和一个新接纳的请求同时需要一个 slot。在持续不断的到达和离开流中,这种重叠窗口会频繁出现,而在固定批处理中则完全不会遇到。随后的一项 attention-data-parallel dummy-request 修复,使九个 Qwen3.5 分离式单元保持存活;而此前大多数单元在几分钟内就会失败。这就是能够通过基准测试的配置与能够在实际会话中存活下来的配置之间的区别。
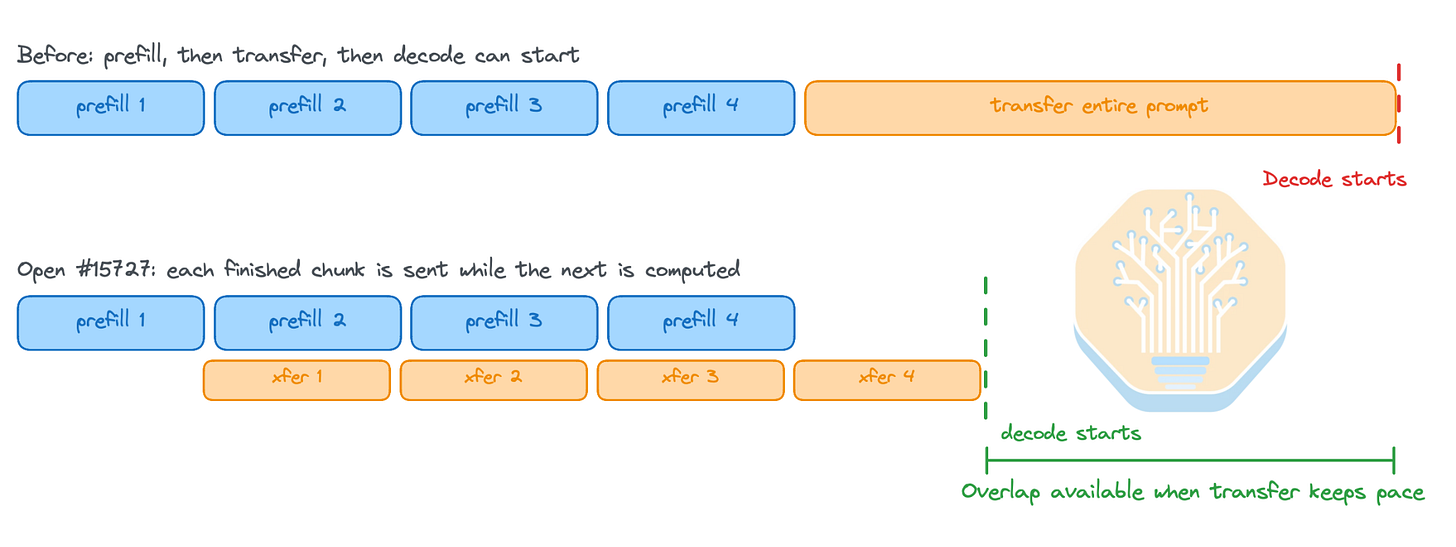
两项开放的传输变更针对非常长的分离式 prompt,它们共同展示了修复一个瓶颈如何产生下一个瓶颈。在默认设置中,decode worker 必须等待整个 prompt 完成 prefill 并传输完毕后才能启动。因此,两个昂贵的阶段会相继执行,尽管第一阶段是增量产生输出的。流水线式 KV 传输会在每个 prefill chunk 完成后立即开始发送,从而使传输过程与 prefill 计算重叠。这样只有最后一个 chunk 会处于关键路径上。
这种改动导致 chunk 处理变得非常频繁,从而暴露了原本只需执行一次的操作。其后续处理每次只检索当前 chunk 所属的 block ID,而不再获取整个 prompt 的 block 列表。对于一个 128,000 token 的 prompt,如果将其切分为 1,024 token 的 chunk,两者的区别在于:前者只需构建一次包含 4,096 项的列表,而后者则需要为每个 layer group 重复构建 128 次。如果每个 chunk 的处理开销随 prompt 的总长度线性增长,这种开销增长模式将直接抵消流水线机制刚刚带来的收益。
Source: SemiAnalysis
AMD ATOM 智能体优化
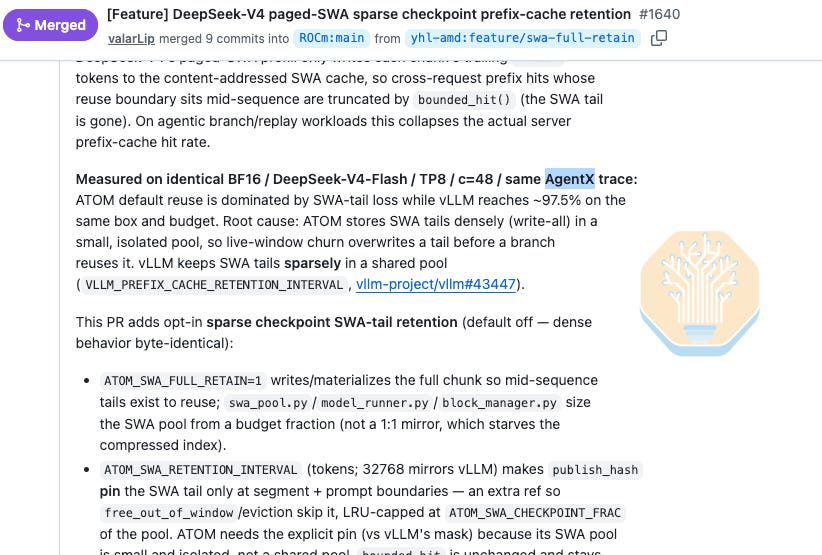
AMD 的 ATOM 引擎最初仅为单轮工作负载而设计,并未针对真实生产环境中的智能体多轮工作负载进行优化。因此,为了良好支持长上下文多轮工作负载,需要对 ATOM 核心引擎和底层 kernel 进行大量修改。相较于目前 vLLM/SGLang 的发展水平,ATOM 在支持智能体工作负载方面仍有很长的路要走。AgentX 被设定为 ATOM 重构以支持智能体工作负载的现实北极星目标。接下来我们要讨论的 ATOM 首项优化是,巧妙地利用稀疏 checkpoint 保留机制来实现 DeepSeek-V4 的分页滑动窗口注意力。合并后的实现会保留选定的窗口尾部数据,使分支和重放请求能够在有效的边界处恢复。其测量结果清晰地分离了这两种效果:在并发度为 48 的同一 AgentX trace 上,实际前缀命中率从 5.6% 提升至 96.45%,滑动窗口机制造成的损失从 91.35% 降至 0.16%。第二个数据是第一个数据背后的机制支撑。十分之前缀匹配在找到后被丢弃,原因正是缺少窗口尾部数据,因此缓存并未未命中,而是被强制失效。
Source: GitHub
在测量上述效果之前,必须先落实两个缓存管理器的修复。这两个修复值得注意,它们展示了缓存自称健康但实际上却不作为的典型情况。其中一个修复阻止了 free-pool 命中时破坏共享缓存条目。另一个 deferred-output 修复则在默认调度器模式下恢复了前缀哈希功能,将重复的长 prompt 从零缓存 token 状态转变为复用所有完整的前缀 block。另一项独立的改动使前缀命中的 prefill 阶段保持在优化的 sink attention kernel 上运行,而不会回退到通用路径。这样,缓存命中就不会悄悄消耗掉其本应节省的部分开销。
混合模型还携带循环状态或压缩器状态,它与普通的 KV 有一个决定性的区别:无法根据周围的 token 重建。窗口尾部可以根据相邻上下文重新计算,但循环状态是之前所有内容的累积结果。如果丢弃该状态,唯一的恢复方法就是重新回放序列。ATOM 为这种按请求的状态提供了内容寻址的检查点生命周期机制,让生成的对话轮次留下可复用的恢复点,而无需为它们预留单独的受保护缓存。在一项测试中,某请求复用了 512 个已生成的 token,仅需计算 2 个 token 的后缀。
调优细节与功能本身同等重要。无条件发布检查点在零命中流量上会损耗 17.5% 的吞吐量。这是由每个不再返回的会话所付出的代价,以帮助那些会返回的会话。按 token 间隔设置检查点避免了这种损耗,且固定 1k1k 吞吐量保持在测量噪声范围内。这就是相关的安全特性:旨在服务于智能体复用的功能,不应给永远不会使用该功能的工作负载带来额外负担。
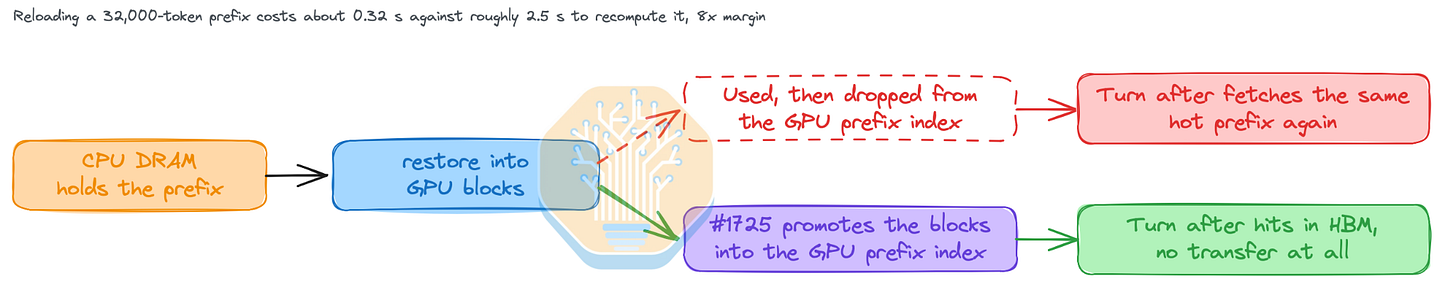
ATOM 针对AgentX的 CPU 路径始于证明卸载合理性的算术逻辑。独立的 LMCache 卸载从 CPU 加载 32,000 个 token 的前缀大约需要 0.32 秒,而重新计算大约需要 2.5 秒,性能差距达八倍。这使得在此上下文长度下跨越总线是值得的,而对于短提示词则不成立。
该路径其余部分的关键在于所有权和索引放置,而非带宽。ATOM 沿用了 vLLM 的多连接器设计,该设计允许预填充(prefill)工作进程将 KV 发送到远程解码(decode)工作进程,并同时将相同前缀保存到 CPU。在两个消费者都完成之前,不会释放这些块。两个独立的读取者读取相同块的场景,在单轮对话中不会出现。
将恢复的块重新提升至 GPU 前缀索引中,修复了一种更隐蔽的浪费。如果不这样做,从 CPU 加载的前缀在使用后不会被注册为常驻状态,因此下一轮会再次跨总线获取相同的热门前缀,导致为一个已经存在于 HBM 中的缓存反复支付传输开销。后续工作一并修复了异步保存顺序、打包 KV 几何结构、未对齐交接以及远程请求核算等问题,在两轮、2,638 个请求的验证中消除了重载损坏问题。只有当相同的块被多次保存、驱逐和恢复时,此 Bug 才会暴露。
Source: SemiAnalysis
分布式路径在不同的代码库中重复出现,这种模式在 SGLang 和 Dynamo 中已经初现端倪:路由必须知道状态存放在哪里。ATOM 的路由器名为 ATOMesh,它是 SGLang 路由器的一个分支,删除了大部分功能。然而,ATOMesh 仍需要 SGLang 的缓存感知路由功能,因此只能将该功能加回来。ATOM 引入了 KV 生命周期事件,供缓存感知路由器使用,这样路由器才能确切掌握状态的位置。它还支持多节点预填充和解码路由,以及会话粘性数据并行路由。这种粘性策略是一种需要明确指出的双面妥协:对话会返回到拥有其状态的正常 worker,但空闲分配会过期,以防止会话离去后,粘性策略导致集群永久性负载不均。
随后,解耦机制需要迁移模型实际保留的所有数据,而这些数据并不总是统一的缓存。DeepSeek-V4 会迁移其混合 FP8 和 BF16 缓存布局下的两个缓冲区。EAGLE 解耦则会在目标缓存之外,一并迁移草稿模型的独立 KV 缓存。这与 TensorRT-LLM 和 SGLang 各自曾需解决的“第二缓存”问题如出一辙。远程 KV 的准入和背压机制则闭环了整个流程:它会阻止解码端接收超出其安全恢复能力的驻留传输。这其实就是“接受无法完成的任务”在解耦架构下的具体表现。
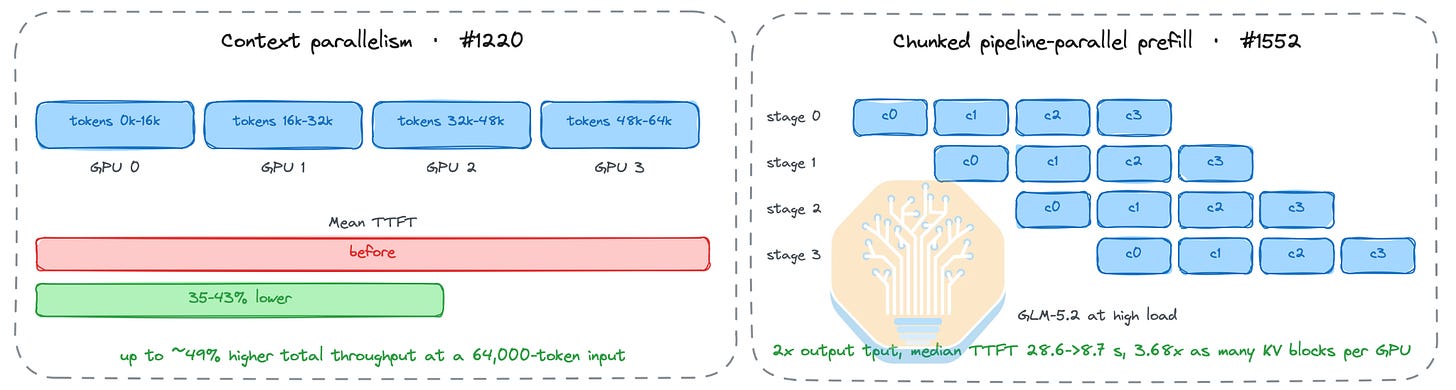
在 ATOM 上,PCP 报告称平均 TTFT 降低了 35% 到 43%。在 64,000 token 输入的情况下,总吞吐量提升了约 49%。这种提升幅度随输入长度增加而扩大,而非取决于批处理大小。要在实际中应用这一成果,需要使其与会话依赖的其他所有机制兼容。因此,DCP 已适配前缀缓存、分块预填充和 FP8 KV,并随后扩展至 MTP。无法与前缀缓存共存的并行策略,无异于用一个长上下文优势去换取另一个。在单个 GPU 内部同样存在并行度受限的问题:批大小为 1 的 MLA 解码没有可分配的 head 或 query 维度,仅有 KV 遍历过程。而 16 的硬编码拆分预算,导致该遍历过程只能在 gfx950 的 256 个 CU 中的 16 个上运行。一项尚未合入的修改将停止覆盖内核自身的拆分推导逻辑,使 Aiter 能够根据机器的集群数量,将遍历过程切分为相应份数。
分块流水线并行预填充从内存端着手解决同一问题。它用流式传输的分层阶段交接,取代了重复的张量并行通信操作。其在高负载下的 GLM-5.2 测试结果是本节中最详尽的数据:输出吞吐量翻倍,TTFT 中位数从 28.6 秒降至 8.7 秒,且每个预填充 GPU 容纳的 KV 块数是原先的 3.68 倍。最后一项数据尤为关键,因为预填充 GPU 的容量,决定了在部署触及 HBM 内存墙之前,系统能同时处理多少个长会话。
Source: SemiAnalysis
ROCm AITER 智能体优化
ATOM/AMD vLLM/AMD SGLang’s long-context execution depends on matching lower-level AITER kernels, because a parallelism strategy at the engine layer is only real if the kernels can express it. Prefill context-parallel process groups provide the extra query-sharding dimension that prefill context parallelism needs, and also widen fused-kernel row indexing for prompts above 131,000 tokens. Decode context parallelism (DCP) shards KV across the tensor-parallel GPUs already present, so a longer sequence or a larger batch fits without replicating the whole cache on every rank.
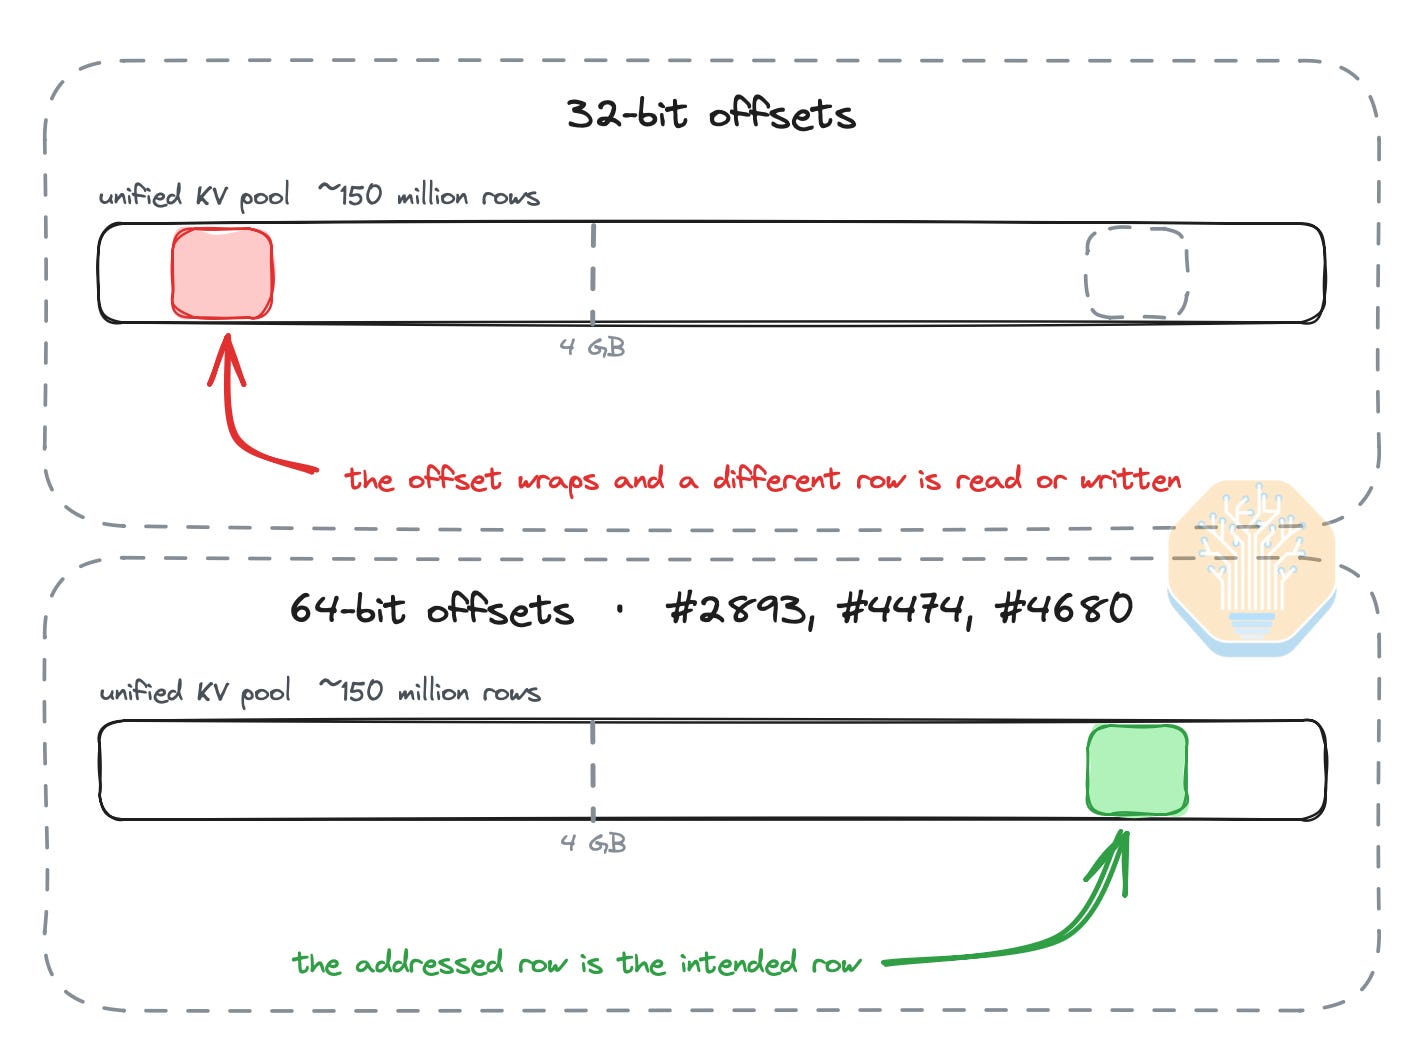
Large caches also exposed a class of failure that short fixed requests essentially never reach: address width. A 32-bit offset is entirely adequate until a single cache pool crosses the boundary, at which point the arithmetic wraps and the kernel addresses the wrong row without any error being raised. AITER added runtime 64-bit dispatch for batch prefill above 4 GB , 64-bit MLA offsets above 2 GB , and 64-bit addressing throughout DeepSeek-V4’s unified cache paths , the last preventing silent reads and writes to the wrong row in pools of roughly 150 million rows.
Source: SemiAnalysis
DeepSeek-V4 decode also gained a persistent MLA kernel for 64-head and 128-head MTP packings . Those two head counts are what ordinary decoding and speculative verification actually produce, so this gives the engine a dedicated long-context path for its common shapes instead of treating them as incidental variants of a kernel written for short contexts. It is the same argument as the vLLM AITER sparse-MLA selection above: in long context, the generic path is not a modest compromise, it is the wrong kernel.
Dynamo Agentic Workload Optimizations
A good chunk of Nvidia submissions use the Dynamo Inference Orchestration and Router Systems. Dynamo’s AgentX series shows that the distributed serving layer can become the bottleneck once engine kernels improve. The router’s work is proportional to the number and length of live prefixes rather than to the number of tokens generated, so a workload of many long, overlapping, long-lived sessions loads it in a way that fixed-shape traffic never does. The first series of PRs reduced the cost of each routing decision: less work on the lookup hot path , no redundant suffix invalidation , and finally batched KV matching, registration, ownership, and terminal dereferences , which reported a 22.2% median output-throughput gain at concurrency 512. Batching helps here for the same reason it helps in an engine: the per-item overhead was dominating the item.
Source: GitHub
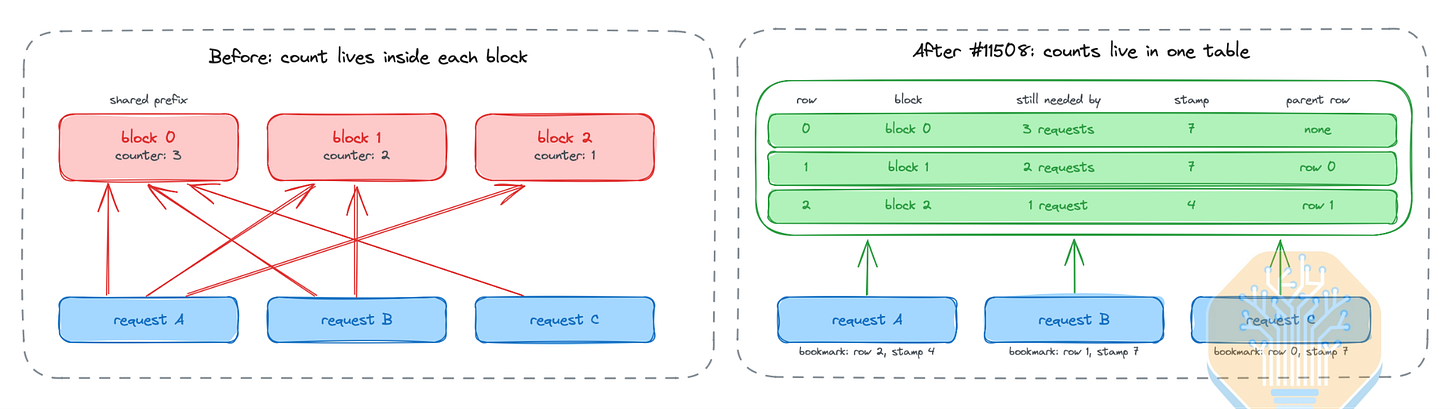
第二批 PR 改变了所有权的表示方式,这是底层更难解决的问题。每个缓存块都需要归属于依赖它的请求,这样既能保证使用期间不被释放,又能在所有请求完成后不被长期占用。数千个并发会话共享重叠的前缀,使得记账本身成为不小的开销。Dynamo 从共享块链转变为 arena 级别的所有权计数,最终采用了特定于后端的请求租约。每一步都在不断粗化跟踪的单元。这种租约设计使 vLLM 后端的 AgentX 重放时间降低了 23.7%,SGLang 后端降低了 22.0%。同时降低了峰值内存。这表明之前的表示方式才是问题所在,而非流量本身。
Source: SemiAnalysis
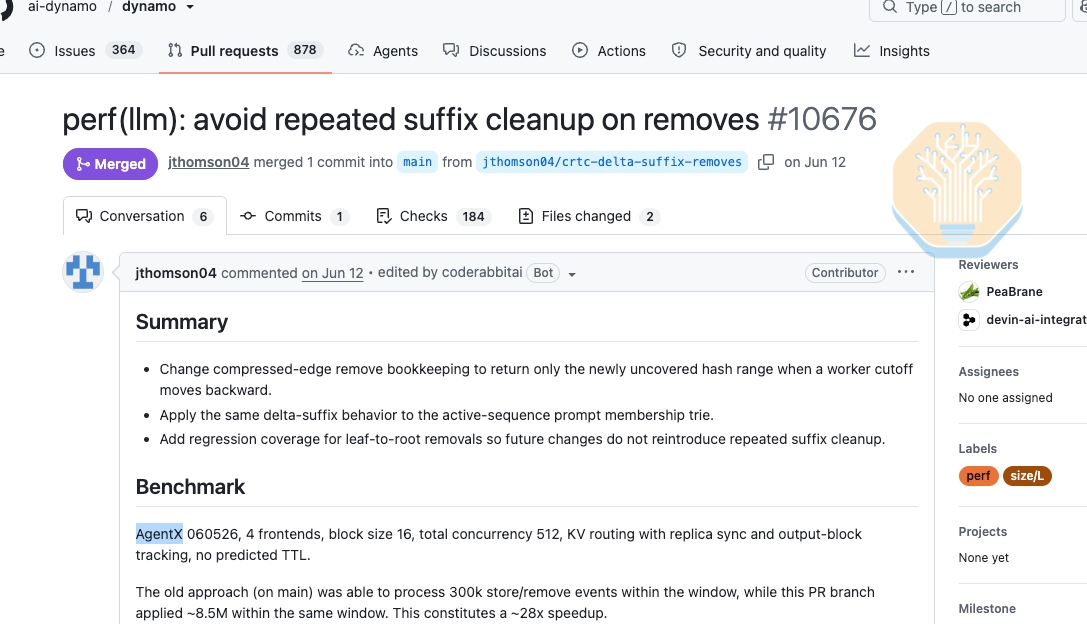
随后的路由性能分析消除了具有相似特征的开销。在过去,由于实时状态的数据量较小,周期性扫描或全量重算是可以接受的。分桶过期清理替代了与所有跟踪对象成比例的扫描,将高变动率下的 AgentX 吞吐量提升了 13.7%。仅处理增量的后缀清理机制只处理发生变化的部分。在相同时间窗口内,它吸收了约 28 倍的存储和移除事件。压缩提示路径使前端 CPU 占用降低了 35.3%,并显著改善了首 Token 延迟的长尾时间。这一点至关重要,因为该工作负载中的提示词很长,且大部分存在重复。现在,过载状态采用增量方式跟踪,而不再进行全量重算。
有一项路由调整是刻意权衡的结果,而非纯粹的提升。Dynamo 现在可以在路由评分中加入活跃解码请求的权重。这样一来,如果一个 worker 已经在处理长时间运行的解码任务,它的开销看起来就比单看队列深度时要高得多。在报告的调优点上,这以较小的吞吐量代价换取了 AgentX 中位延迟的改善。只有在请求长时间占用 worker 时,这种选择才会显现出明显效果。目前有一个后续任务,计划将这种权衡封装为一种新的 Agentic Router 预设。该预设将在相同方向上进一步推进:将前缀重叠的权重设为 2,预填充负载的缩放系数设为 4,并将活跃解码请求的权重设为 64。在这个调优点上,该权衡不再损耗吞吐量。在 8xH200 AgentX 运行测试中,该预设与默认成本函数相比,将固定窗口的已完成输出吞吐量提升了 8.26%。运行级别的 p95 首 Token 延迟降低了 43.1%,p95 Token 间延迟降低了 22.6%。并且额外完成了一条完整轨迹。
接下来优化的是请求层面。因为 Agentic Trace 并非只发送一个请求和一个响应。它会发送多个携带大致相同提示词的相关请求,并将每个 Token 作为独立帧流式传回。因此,序列化和数据拷贝的开销是按轮次和 Token 计算的,而非仅发生一次。改用 MessagePack 请求载荷使吞吐量提升了 8.1%,并在 AgentX 测试中将平均首 Token 延迟降低了 9.7%。直接使用 Python 转码则从该路径中彻底移除了中间值树结构。
随后是一系列变更,这些变更都是为了减少拷贝,而不是提升单次拷贝的速度。这些措施包括:不再拷贝 MessagePack 事件负载,不再拷贝接收到的 ZeroMQ 帧,以及不再为每个 token 承受完整的 inter-token-latency 指标开销。基于同样的原因,我们也缩短了聊天流式传输的热路径。单独来看,这些改动并不起眼;但由于它们会乘以每个并发会话中流式传输的每个 token,最终决定了前端能支撑多少请求/秒。
随后,针对高并发场景的性能分析发现了一些与数据搬运无关的开销。静态日志过滤器移除了一个共享的 span-matcher 锁。这解决的是竞争点问题,而非数据量问题,并将报告的前端吞吐量从 932 提升到了 1,133 请求/秒。更简单的位置基数桶在 32-worker 运行中,将 mocker 的峰值内存降低了 5.51 GiB。一项待提交的改动将去标记化(detokenization)指标的刷新频率改为每次响应刷新一次,而不是在每个流式传输块上都更新累计计数器。这在对应的诊断性能分析中,大约使前端 CPU 时间减半。最后这个例子最能说明这一类问题:该插桩(instrumentation)逻辑单次调用开销很小,但在每个 token 都调用一次的情况下,却会造成巨大的性能损耗。
LMCache Agentic 优化
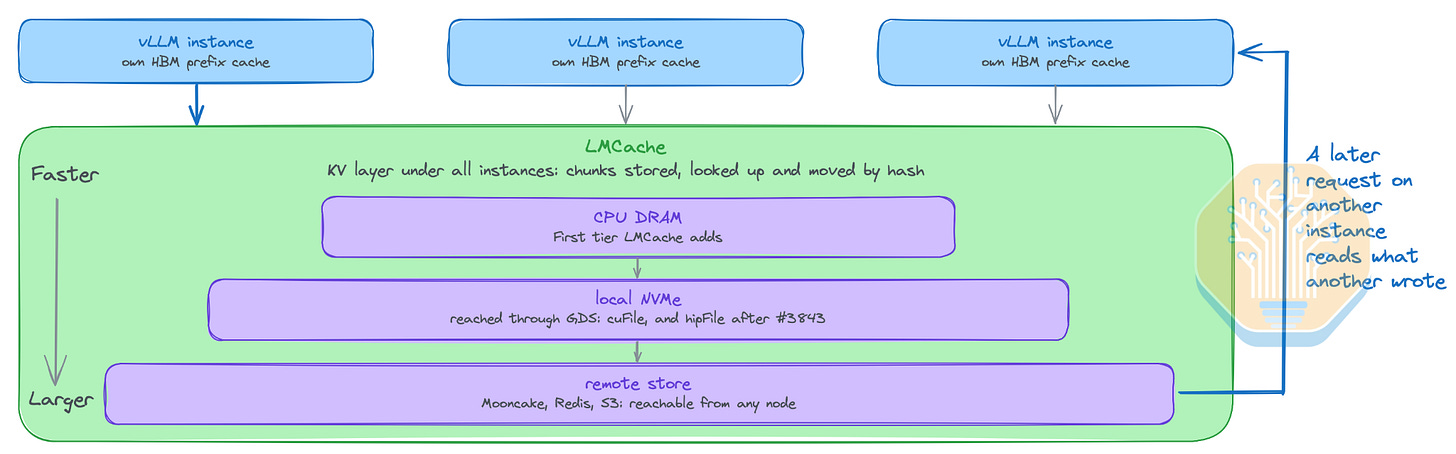
LMCache 是一个开源的 KV 缓存层,位于 vLLM 等推理引擎之下。它通过前缀哈希作为键,在 CPU DRAM、本地 NVMe 和远程后端(Mooncake、Redis、S3)中存储可复用的 KV 块。LMCache 可作为 vLLM 原生 offloading 连接器的替代方案。
Source: SemiAnalysis
针对 Agentic 场景下缓存访问的数据量和特征,LMCache 的多进程路径进行了调整。这次调整始于一个故障场景,该故障不是性能变慢,而是彻底停滞。当许多请求的上下文超过 100,000 个 token 时,如果每个请求在开始前都要为其整个负载预留块,那么池会被这些都在等待、却无一能进展的请求耗尽。分块外部缓存加载则改为按块预留资源。这样,多个加载过程可以交错进行并逐步释放资源。在并发度为 32 时,验证测试完成了 120 个请求,而旧路径在 28 个请求后就死锁了。在并发度为 48 时,即使 KV 池占用率高达 98.5%,系统依然能保持运行。
其他改动则旨在减少数据搬运量,并降低运行时的干预频率。仅存储 DeepSeek-V4 混合组中的有用部分,使每 token 的存储量减少了近 20 倍。滑动窗口预取现在只加载活跃窗口,而不是加载永远不会被读取的窗口状态。这与应用了 vLLM 在 offload 中的可达性论证相同,只是我们从存储侧切入。此外,每个对象组仅进行一次原生传输调用,消除了在暂存拷贝和内核启动过程中重复的 Python 锁交接。这种开销与对象分块的数量成正比,而非与数据字节数成正比。
目前 LMCache 有两项改动是 AgentX 专有的,但尚未合并。其中混合锁计数修复,防止了一个请求释放另一个请求在共享滑动窗口或循环状态块上的读锁。多个请求必须共享相同的块,因此计数必须按块而非按持有者进行,且驱逐机制必须真正启动。在启用 DRAM 卸载的 Kimi-K3 长时间运行中,这三个条件同时满足,随后在驱逐开始时产生了数以万计的警告和损坏的生成结果,最终导致 GPU 崩溃。如果不是这种长时间、共享且内存压力较高的运行,该问题就不会暴露。
LMCache 的另一条并行工作线使得上述所有功能在 AMD Instinct 硬件上均可用。CacheBlend 的非前缀复用依赖 flashinfer,而后者仅支持 CUDA。因此,我们用 Triton 块稀疏注意力后端重新实现了所需的三个内核:带 CSR 索引和 log-sum-exp 输出的块稀疏注意力、因果预填充,以及 log-sum-exp 输出融合。随后在检测到 ROCm 或缺失 flashinfer 时,系统会自动路由到这些内核。ROCm 的 Dockerfile 参照 CUDA 构建和轻量级镜像进行了同步。此外,AMD hipFile 后端扩展了 GDS L1 平板文件层。该层此前仅通过 NVIDIA cuFile 访问存储,现在则通过 ctypes 绑定 ROCm 的 hipFile,并根据 torch.version.hip 进行分发。原有的 cuFile 路径保持不变。
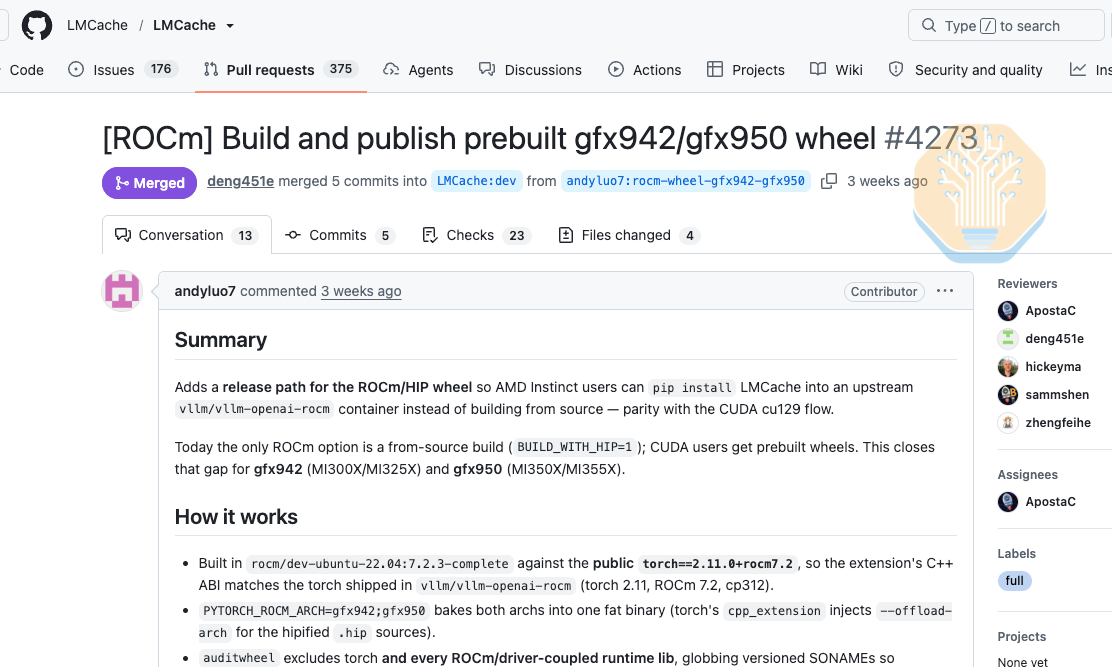
分发是剩余的缺口。CUDA 用户安装预构建的 wheel 包,而 AMD 用户则需从源码构建。我们与 AMD 合作发布了预构建的 gfx942 和 gfx950 wheel 包,从而填补了这一空白。该包可安装到上游镜像中,并在 MI350X 上通过了全部 56 项 KV 迁移内核测试。此外,它发布在 GitHub release 上而非 PyPI,因此直接执行 pip install lmcache 仍会安装 CUDA 构建版本。后续的一行代码修复将绑定挂载的仓库标记为 git 安全目录。这仅在 CI 中会失败,原因是在 runner 所拥有的检出路径上,容器以 root 身份运行,而 setup.py 中的版本内省逻辑拒绝读取该目录。
Source: GitHub
支持 DCP 的 CPU 卸载解决了一个简单的不兼容问题。长上下文使得两项功能必须同时启用,但此前它们却无法兼容。启用解码上下文并行后,每个 rank 仅持有一段 KV。因此,任意单个 rank 保存的内容无法用作有效前缀。该修复在保存前收集分散的片段,并在加载后重新分配。若不进行此修复,启用上下文并行会悄无声息地禁用 CPU 缓存命中。这恰恰发生在促使这两项功能诞生的长前缀场景中。其验证过程记录了超过 30,000 次 CPU 命中事件,且单请求加载达到了数十万个 token。
Mooncake 智能体优化
Mooncake 承载着 Moonshot 旗下 Kimi 的生产流量,同时也服务于多家实验室的生产流量。在解耦的 vLLM 和 SGLang 配置中,它是底层的传输引擎。直到最近,Mooncake 的 AMD 支持仍存在不足。它既未支持 RDMA 注册,也未提供可安装的软件包。
Source: SemiAnalysis
在 Nvidia 上为 RDMA 注册 GPU 内存,需要使用 nvidia-peermem 内核模块,或者导出一个 dmabuf 文件描述符。AMD 没有 nvidia-peermem 的等效组件,因此 GPU-direct RDMA 完全没有可用路径,部署时只能回退到通过主机 DRAM 来中转 KV。一个 HIP dmabuf 注册分支添加了与现有 CUDA dmabuf 路径对应的实现,通过 ROCm 而非 CUDA handle 调用来导出,并且会先解析真正的分配基址,因为缓存分配器会将张量紧凑排列在更大分配区域内的某个偏移位置。主机内存仍然可以直接注册。
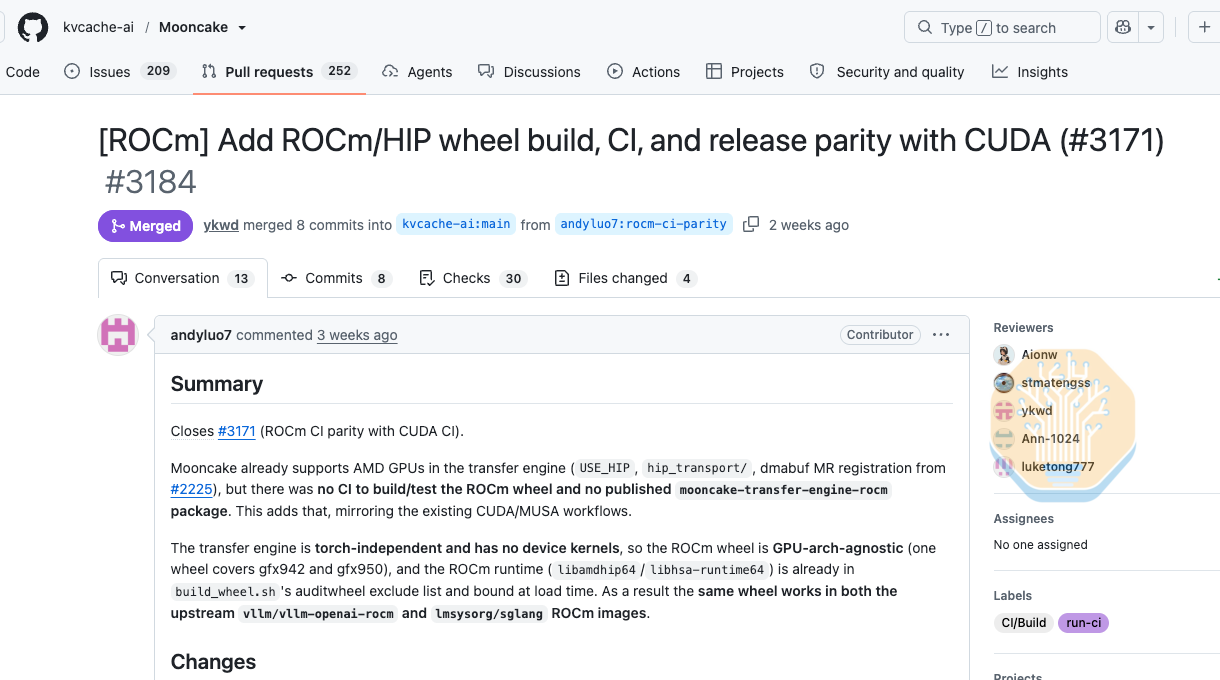
无法安装的支持不算真正的支持。Mooncake 发布了 CUDA 和 MUSA wheel,但没有 ROCm 包,因此 AMD 用户必须在每个镜像中从源码构建引擎。一个 ROCm wheel、CI 和发布路径将 mooncake-transfer-engine-rocm 与它们一起发布到 PyPI。这项由 AMD 工程师 Andy Luo 完成的工作,源于他在使用 AgentX 亲自测试 agentic 工作负载时发现的一个现象:在 ROCm 上从源码构建 MoonCake 并不是一个优先支持的模式。
Source: GitHub
传输引擎没有设备内核,也不依赖 torch,因此一个架构无关的 wheel 就可以覆盖 gfx942 和 gfx950。ROCm 运行时是在加载时绑定的,而不是内置在包中,这意味着同一个 wheel 无需修改即可在 vLLM ROCm 上游镜像和 SGLang ROCm 镜像中正常工作。这经过了完整的交叉验证:包括 MI300X 和 MI355X,分别在 vllm/vllm-openai-rocm 和 lmsysorg/sglang 下运行,执行 master 二进制文件并进行带有数据校验的 HIP 缓冲区传输测试。该 pull request 增加了针对 Python 3.10 到 3.13 的标签触发发布机制。一个待办的后续工作是添加一个自建的双节点 MI350X 外部 prefill 和 decode 层,以便在真实硬件上验证 ROCm 分离式路径,而不仅仅是编译通过。
这些 PR 结合起来意味着,AMD AgentX 运行环境现在可以从已发布的制品中,将传输引擎和 KV 缓存层安装到标准的上游镜像中,并直接在 GPU 内存与网络之间移动 KV。
其他优化
上述改动解决了长上下文的成本问题:必须保留的 prefix,必须保持正确的混合缓存,以及必须跟得上的传输。但还存在许多 day-zero 适配和正确性相关的 bug,它们导致请求失败的程度,丝毫不亚于百万 token 的会话。
MiniMax-M3 测试了这些 ROCm 工作是否真正带来了 day-zero 的就绪状态。Advancing AI 的报告直接进行了对比:AMD 首个公开的分离式方案 MI355X FP4 在一月份达到了 InferenceX,但落后 Nvidia 数月之久;而 M3 FP4 分离式部署则在 day-zero 当天完成。相比于 DeepSeek-R1 时期需要数月才能达到对等,这是一种进步。有三个 vLLM 修复处于 day-zero 路径上,且每一项都是正确性修复,而非性能优化。
首先,解耦(Disaggregation)被阻止了。NixlConnector 的握手过程断言 SPLIT 区域的 block_len 会随 prefill 到 decode 的 TP 比例缩放,但实际上 block_len 取决于每个 rank 的 KV heads 数量。M3 有 4 个 KV heads,因此 TP4 prefill 配合 TP8 decode 时,受 GQA 限制,两侧每个 rank 只能分配到一个 head,两边长度相等,而断言却要求比例为二。结果握手被拒绝,没有传输任何 KV,decode 从零开始重新生成了一切,gsm8k 得分为 0。按照实际的 head 比例进行校验后,此问题得以修复。
另外两个问题是平台差异导致的。对于所有的 E4M3 配置,M3 的 sparse-attention 后端将基于字节的 FP8 缓存读取为 float8_e4m3fn。然而 gfx942 的平台 dtype 是 e4m3fnuz,这两种编码并不相同。因此,在 kernel 使用它们之前,必须对 K 和 V 进行修改。prefill 和 decode 的封装也遗漏了对 FNUZ 类型的 FP8 检查。使用平台 dtype 作为缓存视图后,这两处问题都得以解决。另外,M3 分别提供了 NVIDIA 和 AMD 的独立模型文件,但只有 NVIDIA 版本实现了 EAGLE3 接口。因此,在 ROCm 上引擎初始化时,推测解码因报出 model-does-not-support 错误而中止。补齐 AMD 模型的功能后,推测解码得以恢复,MI355X 的 gsm8k 得分与未开启 EAGLE3 的 MI355X 运行结果以及 B200 相当。
上文的 TensorRT-LLM 部分涵盖了 M3 中针对长上下文的特定工作。内容包括:解耦 KV 传输中的描述符激增问题、上下文图捕获、稀疏块步长、autotuner 候选项,以及必须从池中移除的损坏的 split-K MoE 策略。
本地的 AgentX 测试矩阵结合了会话感知或 KV 感知路由、长度不一且多变的对话历史、MTP、混合注意力机制、聚合与解耦服务,以及跨越 HBM 容量瓶颈的并发扫描。其中包含了 GPU 常驻对比,以及通过 vLLM SimpleCPU、Mooncake、LMCache 和 SGLang HiCache 进行的 CPU DRAM 卸载。正是这种组合激活了上述上游工作。旧的固定序列矩阵通常只创建一个 prompt,执行一次 prefill,解码出一个固定的续写内容,然后丢弃该请求。因此,它无法衡量跨轮次的缓存存活率、重复 tokenization、会话亲和性、缓存事件流量、卸载波动、调度器停滞期间的传输进度,或是长期存活的归属记账情况。
允许的优化策略将 CPU KV 卸载视为可选项。厂商可以使用 vLLM connectors、LMCache、SGLang HiCache、Mooncake、Dynamo KVBM 或其他 CPU DRAM 连接器;如果关闭卸载能获得更好的延迟和吞吐,也可以选择关闭。NVMe 卸载则被推迟。CPU DRAM 必须随使用的 GPU 比例进行扩容,对于非标准化 DRAM 系统,这包括 3 TB 的容量上限。标准化 DRAM 系统没有硬性上限,但仍须遵循同样的比例规则。目前,本地生成器对所有 runner 都统一应用了 3 TB 的上限限制,因此尚未实现针对标准化 DRAM 系统的例外处理。
新增的优化面不仅仅是更长的上下文,而是对不断增长的会话状态进行保存、迁移、路由、重建和反复处理。AgentX 使这些开销变得足够大,从而推动了 vLLM、SGLang、TensorRT-LLM、ATOM、AITER、Dynamo 和 LMCache 等上游通用组件的全面改进。直接搜索 NIXL 和 Mooncake 并未发现带有 AgentX 标签的运行时 PR,因此它们的相关影响依然通过上述引擎连接器的改动来体现。
AgentX 方法论深度解析
AgentX 在开源真实世界长上下文、多轮代理轨迹重放方面带来了巨大转变。我们在自己的数据集中收集了价值超过 300 万美元的 token 轨迹,该数据集包含来自 Claude Code、OpenAI Codex 等产品的真实流量。除了构建数据集,我们还开发了一套全面的方法来公平地重放这些流量模式。我们的目标是尽可能还原真实流量,同时公平合理地评估 GPU 资源需求。
我们将深入探讨代理轨迹数据集、重放方法以及代理的整体行为。推荐希望深入了解代理工作负载整体特征,以及测试框架在底层如何编排请求的读者阅读本文。
价值 300 万美元的代理流量轨迹收集器
在最初设计 AgentX 时,我们的核心目标是让基准测试在 KV 工作负载形态和 KV 重用模式方面尽可能贴近真实情况。我们开始尝试重放一些现有的数据集,例如 SWE-bench、Qwen-Bailian 以及来自 HuggingFace 的一些零散的 Claude Code 轨迹。当时,这些数据集并未包含子代理、100 万上下文、上下文压缩、动态工作流等近期定义代理轨迹的关键特征。在 SemiAnalysis,团队大多数成员都是 AI 重度用户,在编程、分析师研究、Excel 建模、社交媒体运营等各种任务中广泛使用代理。因此,我们认为最可行且最真实的轨迹可以通过内部收集来获取。
为了收集大量轨迹,我们创建了一个代理来拦截发往 Claude / Codex 的 HTTP 请求。然后,希望上传轨迹的用户只需将 Claude / Codex 配置中的 base URL 指向该代理即可。截至撰稿时,我们已收集了超过 8,000 个会话、340 万次请求和 6100 亿个 token。这些数据总计代表了超过 300 万美元的支出。我们已将其中具有代表性的会话子集开源,用于 AgentX v1.0 基准测试。
尽管 Agentic 框架看起来很复杂,但它们最终都是在编排一系列 HTTP 请求。每个请求都包含系统指令、工具定义和累积对话历史的某种组合。随着会话的推进,这段历史会不断增长并被反复发送回模型,从而产生长上下文和高前缀重用率。这正是 AgentX 旨在重现的场景。
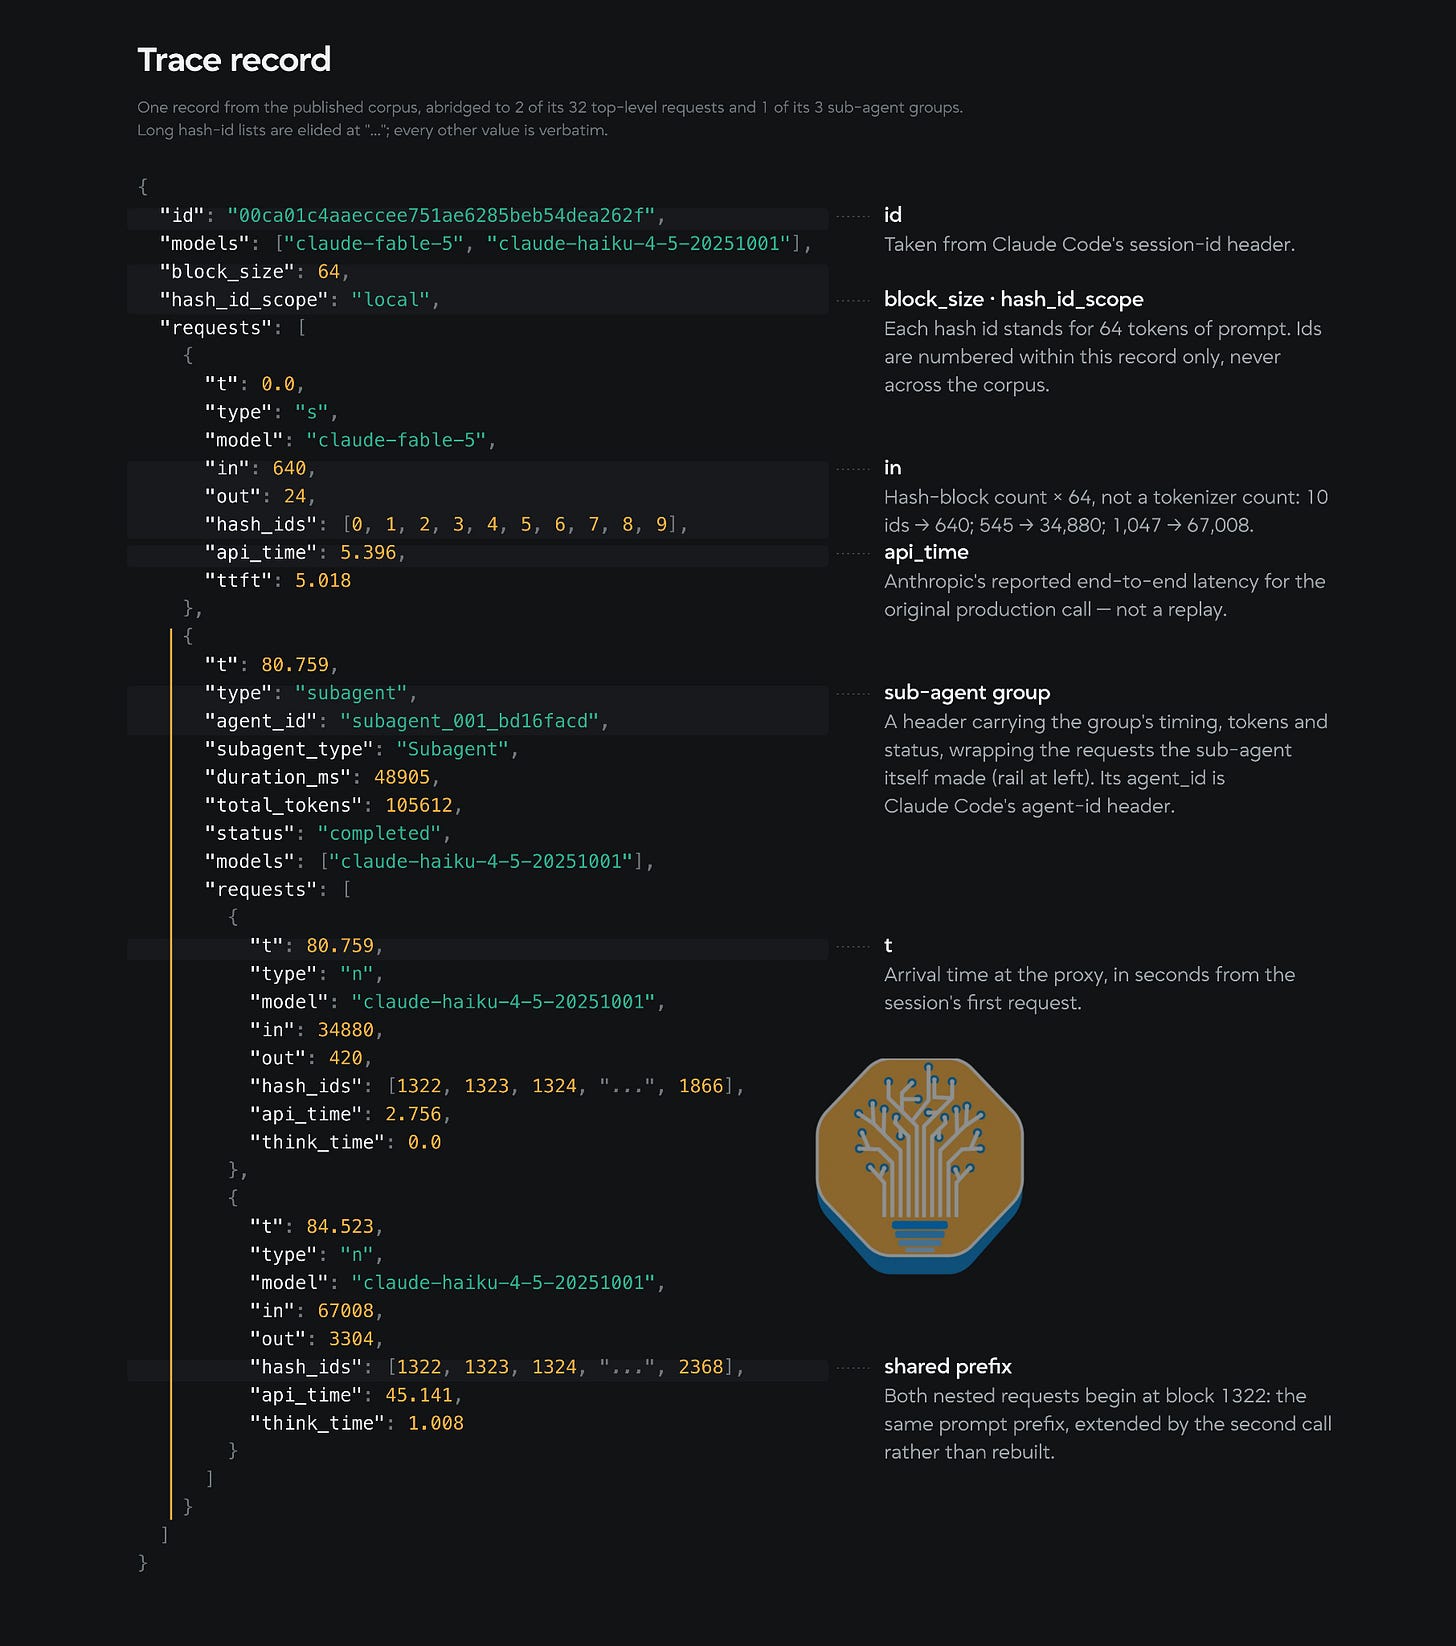
我们的代理会在这些请求和响应发生时将其记录下来。它还会提取元数据/HTTP 标头,例如时间戳、对话 ID 和子代理 ID。这让我们能够还原对话的结构(包括请求顺序、并发分支,以及每个会话大致的父子结构)。正是依靠这些元数据,我们才能近似地按照原始 Anthropic API 服务器所见的那样来重放这些轨迹。
为了保护员工隐私,重放数据集不包含任何原始提示词、源代码、工具参数或工具结果。相反,我们对每个请求的内容进行分词,然后将其分组为 64 个 token 的块,最后用会话级链式哈希替换每个块。因此,匹配的提示词前缀会产生匹配的哈希前缀,同时不会泄露其内容(本文对此策略有更多讨论)。在重放期间,这些哈希块随后可以被替换为例如编程数据集中的 token。这样,我们就保留了原始工作负载在上下文增长和对话 KV 重用方面的近似模式。
值得注意的是,这个过程必然是不完美的。主要原因在于,在使用前沿模型提供商的 API 时,终端 LLM 服务器实际看到的很多内容都是隐藏的。例如,SOTA 模型的思考/推理内容现在在 HTTP 请求中已被加密,并被替换为确定性哈希,以试图阻碍蒸馏攻击。然而,这似乎并没有像大型实验室计划的那样顺利……
Source: SemiAnalysis
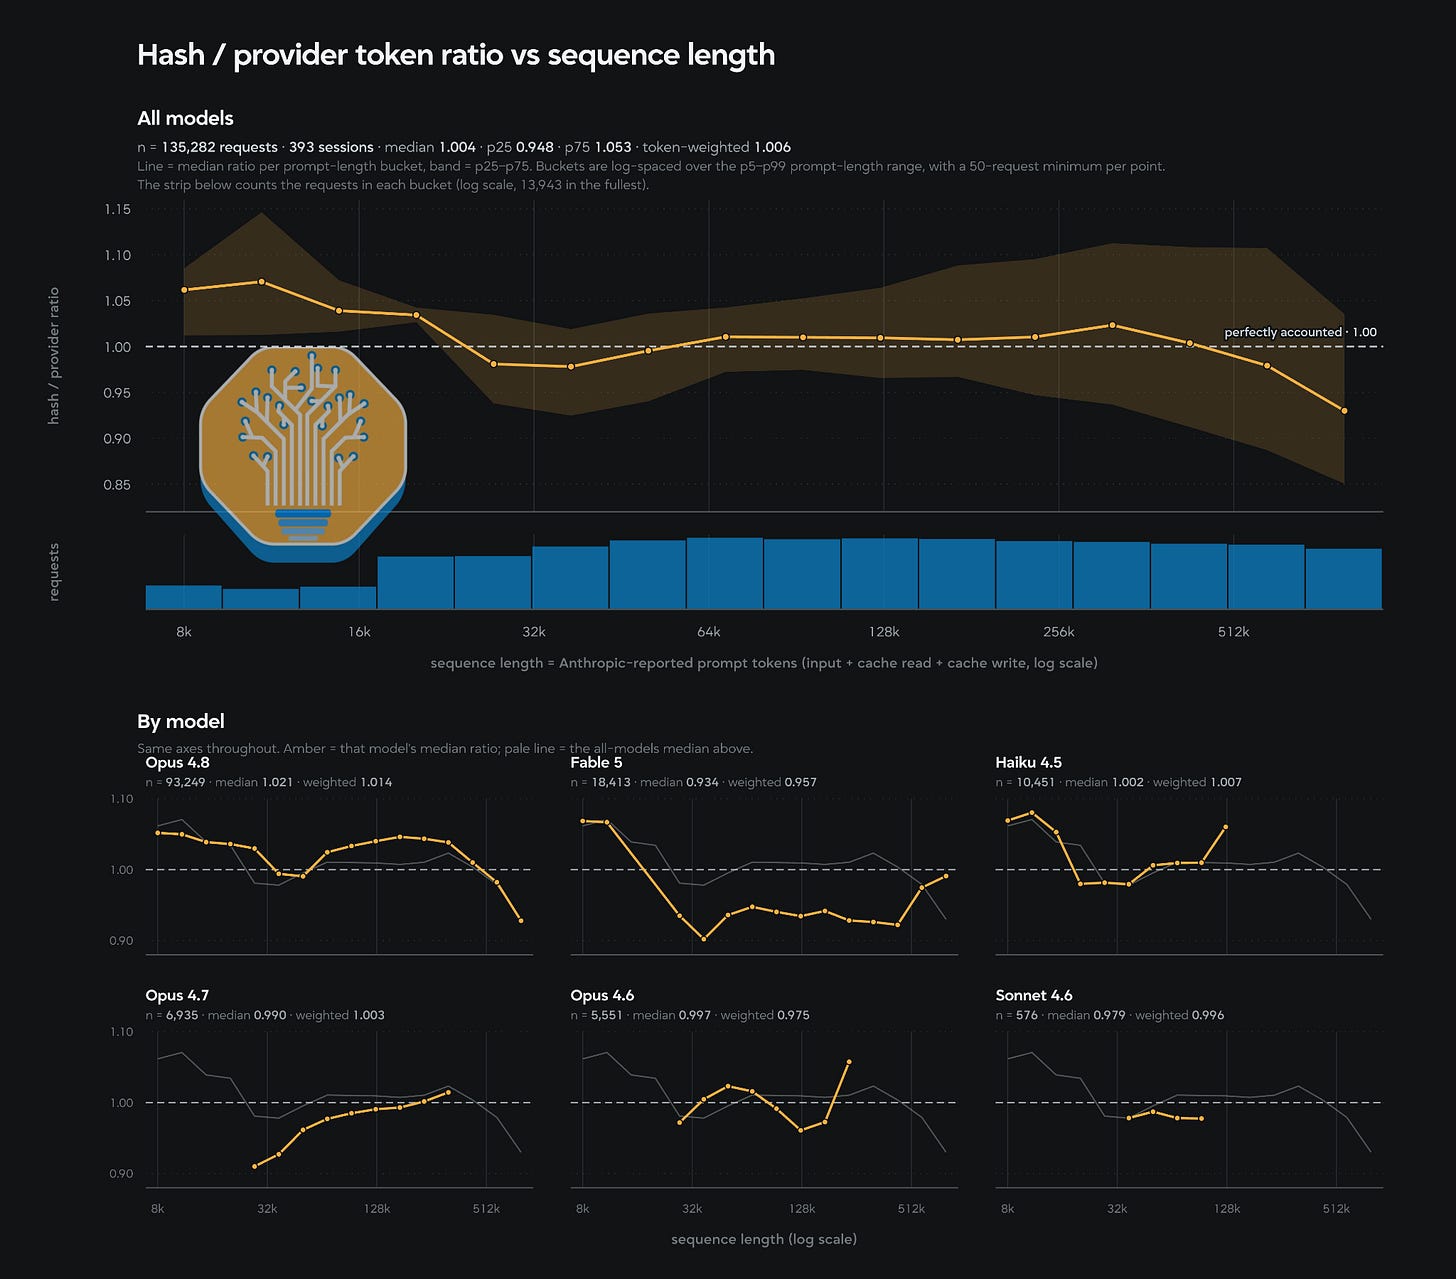
此外,虽然我们可以访问用户/助手消息、系统提示词、工具使用等的所有原始内容,但 API 提供商会在服务器端应用额外的聊天模板,而这些是不透明的。我们也无法观察 Anthropic 的专有分词器或服务器端工具引入的上下文。此外,图像和文档的网络传输表示形式与模型处理的 token 数量之间,也没有直接的对应关系。我们使用确定性占位符和经过经验校准的特定模型填充,将重建的提示词长度调整至最接近服务器实际所见内容的估计值。
由于信息不完整,我们无法完美捕获并重放 Anthropic / OpenAI 服务器实际所见的 Claude Code / Codex 轨迹,但我们可以做到非常接近。下图显示了在所有请求长度和模型中,哈希 token 数量(经过我们的近似/处理后)与真实 API 提供商 token 数量之间的比率。
Source: SemiAnalysis
总而言之,由于信息不完整,要完全按照原始服务器的重放方式来收集真实的 Claude Code 轨迹并非易事。不过,我们已有足够的上下文信息,可以高保真地收集并重放轨迹,从而精确匹配原始的流量模式、时间、前缀缓存以及 DAG 模式。
AgentX $3Mil 数据集
AgentX v1.0 使用的数据集可在 HuggingFace 上找到。它是上一节提到的 8.3k 会话代理语料库的一个子集,共包含 393 个会话。此外,我们还进行了一些后处理来清理异常数据,例如:
移除 Claude Code 安全监视器(自动模式)请求以及标题生成请求,因为这些是 Claude Code 特有的,不一定能代表常规的 Agent 流量 移除重建输入长度大于 990k tokens 的请求(我们的估算可能偏高) 移除重复请求(如果连接中断,代理有时会收到完全相同的请求) 此外,每个对话都被格式化为 WEKA 轨迹格式。该格式由 Callan Fox 在其 kv-cache-tester 项目中提出。我们选择这种格式来存储轨迹信息,主要是因为我们与 Callan 密切合作开发了该基准测试,并发现它非常适合用于存储按会话划分的轨迹。总的来说,轨迹格式的选择具有很强的任意性,我们的代理数据集也可以映射到 Mooncake 等其他格式。
Source: SemiAnalysis
应用这些处理之后,我们得到了以下数据集。请注意,图中各 X 轴的标度并不完全相同。
Source: SemiAnalysis
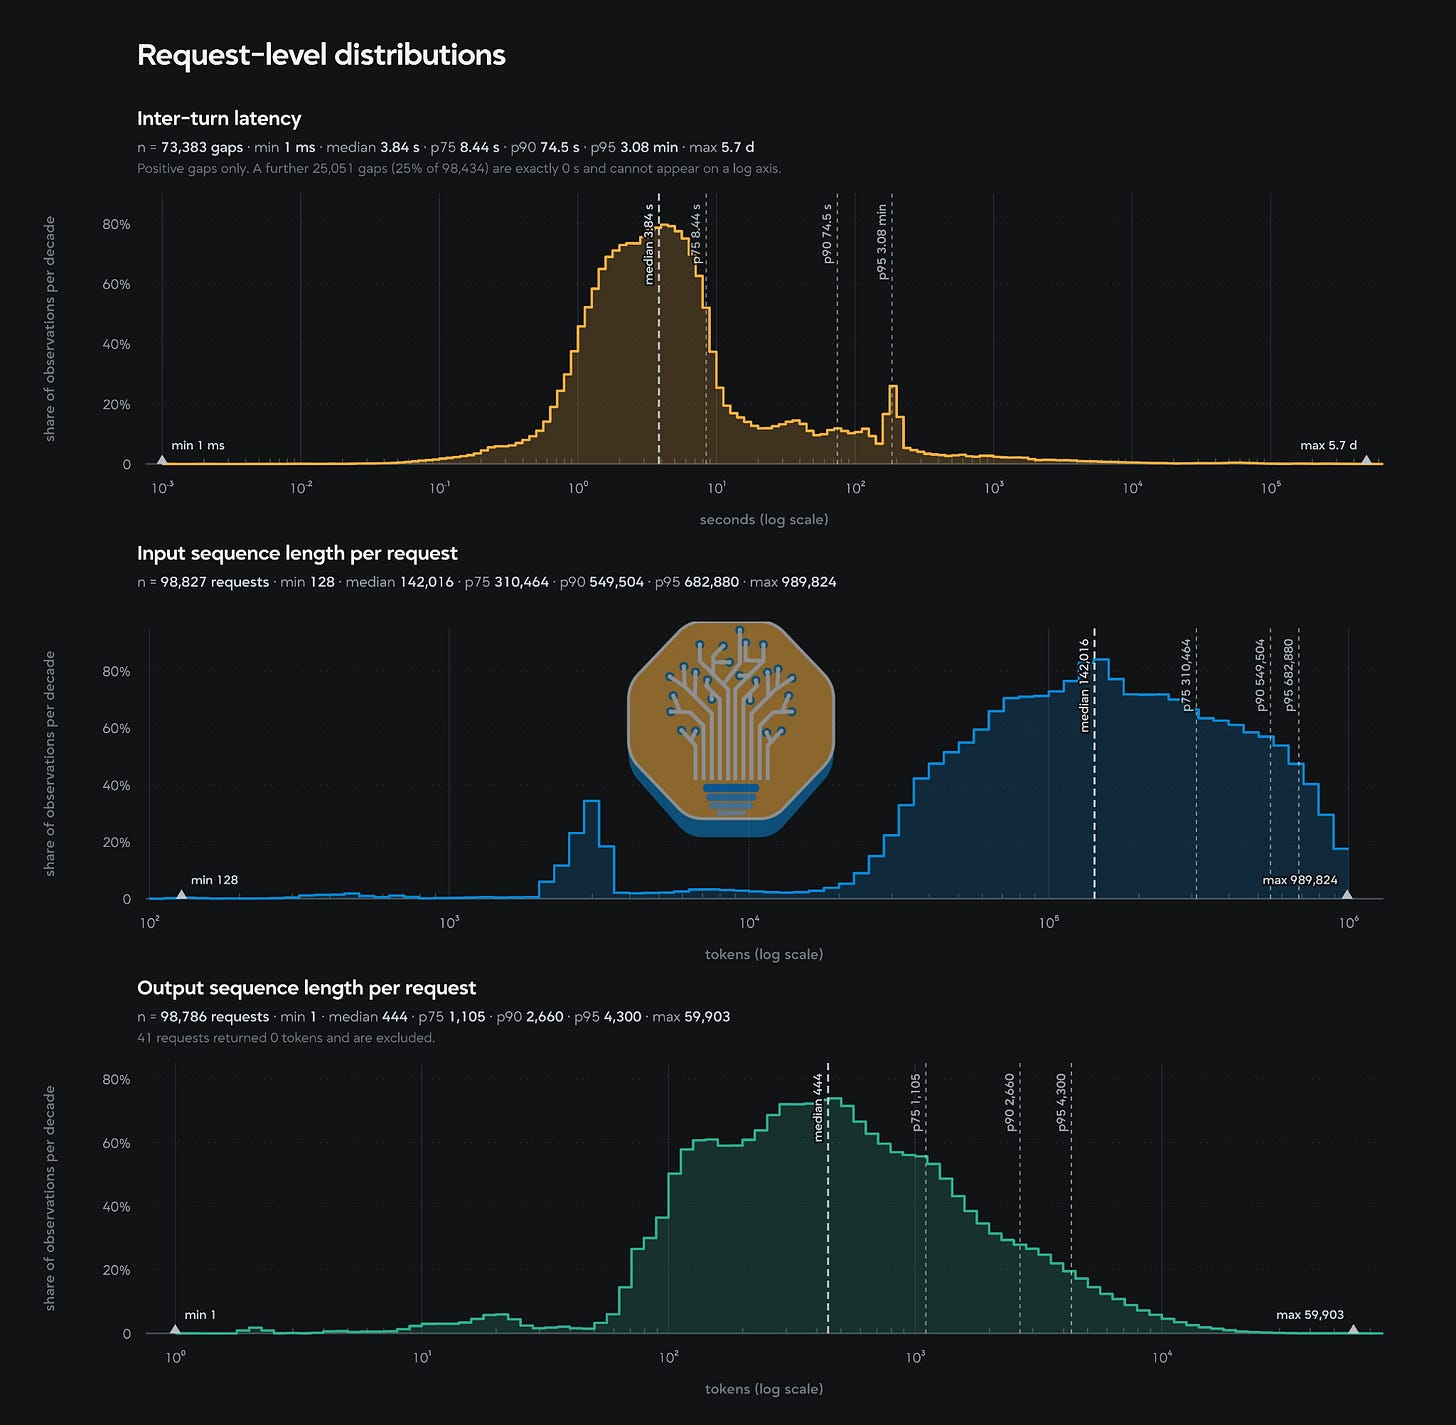
ISL/OSL 以及轮间延迟(在 Agent 任务中,主要是工具使用时间)的分布大致呈对数正态分布。ISL 的中位数为 142k tokens,OSL 的中位数为 444 tokens。轮间延迟(或称“工具使用时间”)的中位数为 3.84 秒。只有约 10% 的轮间延迟超过 1 分钟。这些较长的延迟很可能来自于框架等待人类实际响应的空档。
值得一提的是,由于注入的上下文数量和类型不同,这些请求分布会因所使用的框架而异。例如,已知 Pi 在注入框架上下文方面较为精简,而 Claude Code 则恰恰相反。此外,ISL/OSL 的分布还取决于具体模型,因为不同模型的分词器生成的 token 数量可能不同。然而,考虑到全球相当大一部分 Agent 编码流量都流经 Claude Code,我们认为该数据集具有很强的代表性。
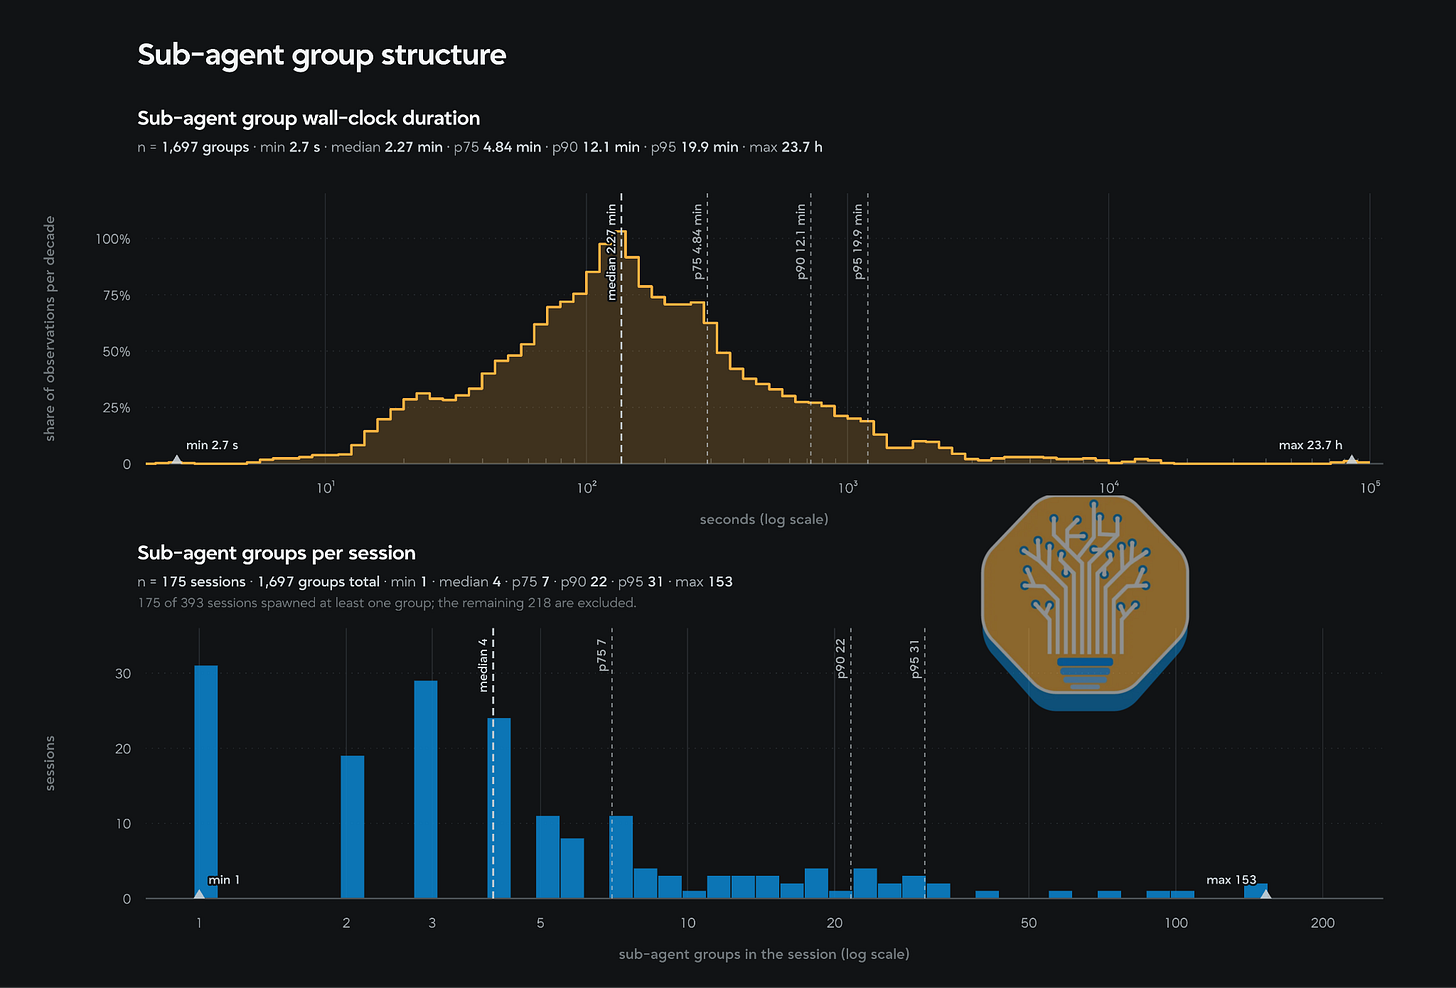
该数据集还包含 175 个至少带有一个子智能体的会话(约占总会话数的 44%)。数据集共有 1,697 次子智能体运行记录,每个会话的中位数为 4 次。子智能体的实际运行时间中位数(从首次请求开始到末次请求结束)为 2.27 分钟。该分布同样大致遵循对数正态分布。
Source: SemiAnalysis
This dataset includes context up to 1M context, meant to test the more recent frontier open-weight models. Additionally, we have a truncated 256k context length dataset which we replay against models with a max context length of 256k or less.
Agentic Traffic Trace Replayer
Rather than build a replay solution from the ground up, we decided to partner with AIPerf , a vendor agnostic HTTP replayer tool from Nvidia that is adopted by many in the industry including tenstorrent, AWS, AMD, etc. While the intention is to integrate AgentX features into the upstream repo, we maintain a separate fork to be even more vendor neutral such that we have control over allowing even more 3rd more contributions. Again, thank you to the AIPerf team, especially Anthony Casagrande, for the help and dedication to building a realistic and representative agentic benchmark.
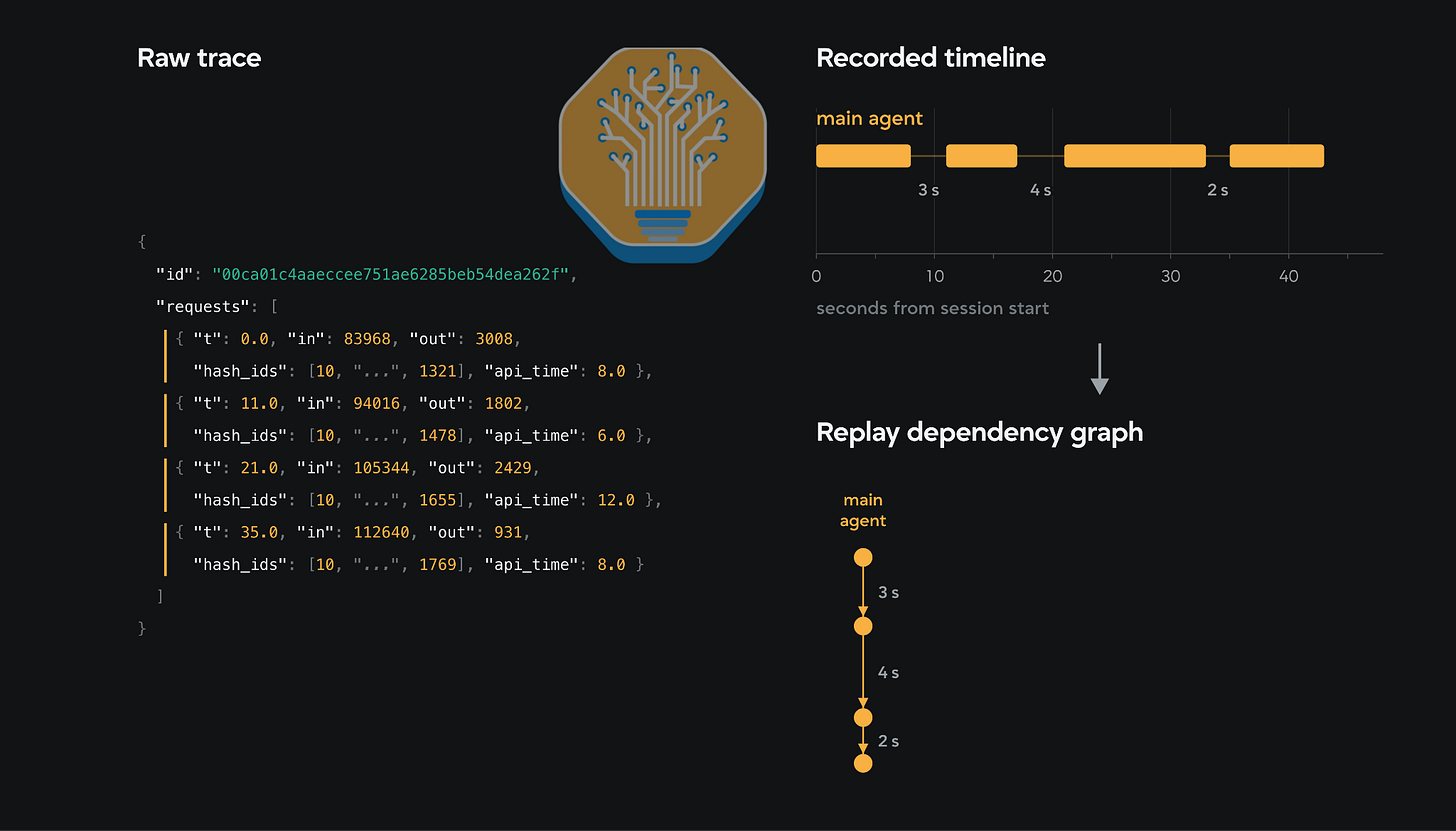
An agentic session is naturally described as a directed acyclic graph (DAG). Each request is a node, and an edge means the request at its head cannot be issued until the one at its tail has completed. Every edge additionally carries a delay, specifying how long to wait once that precondition is met.
The simplest session is completely linear, with no subagents and no parallel requests, each request depends on exactly one predecessor. The graph degenerates to a line and the only thing an edge encodes is the inter-turn latency (aka, tool use time or “think” time), which is the client’s local work rather than the model’s.
Source: SemiAnalysis
In agentic traces, subagents can also be spawned. A subagent is a separate stream of requests that has its own context, typically to do a focused task. Multiple subagents can run in parallel to do more aggregate work, and subagents can run in parallel to the main agent in some cases. The main agent then waits on groups of subagents to finish, and then incorporates their outputs back into the main agent’s context (while this is not always the case, this is the most common pattern).
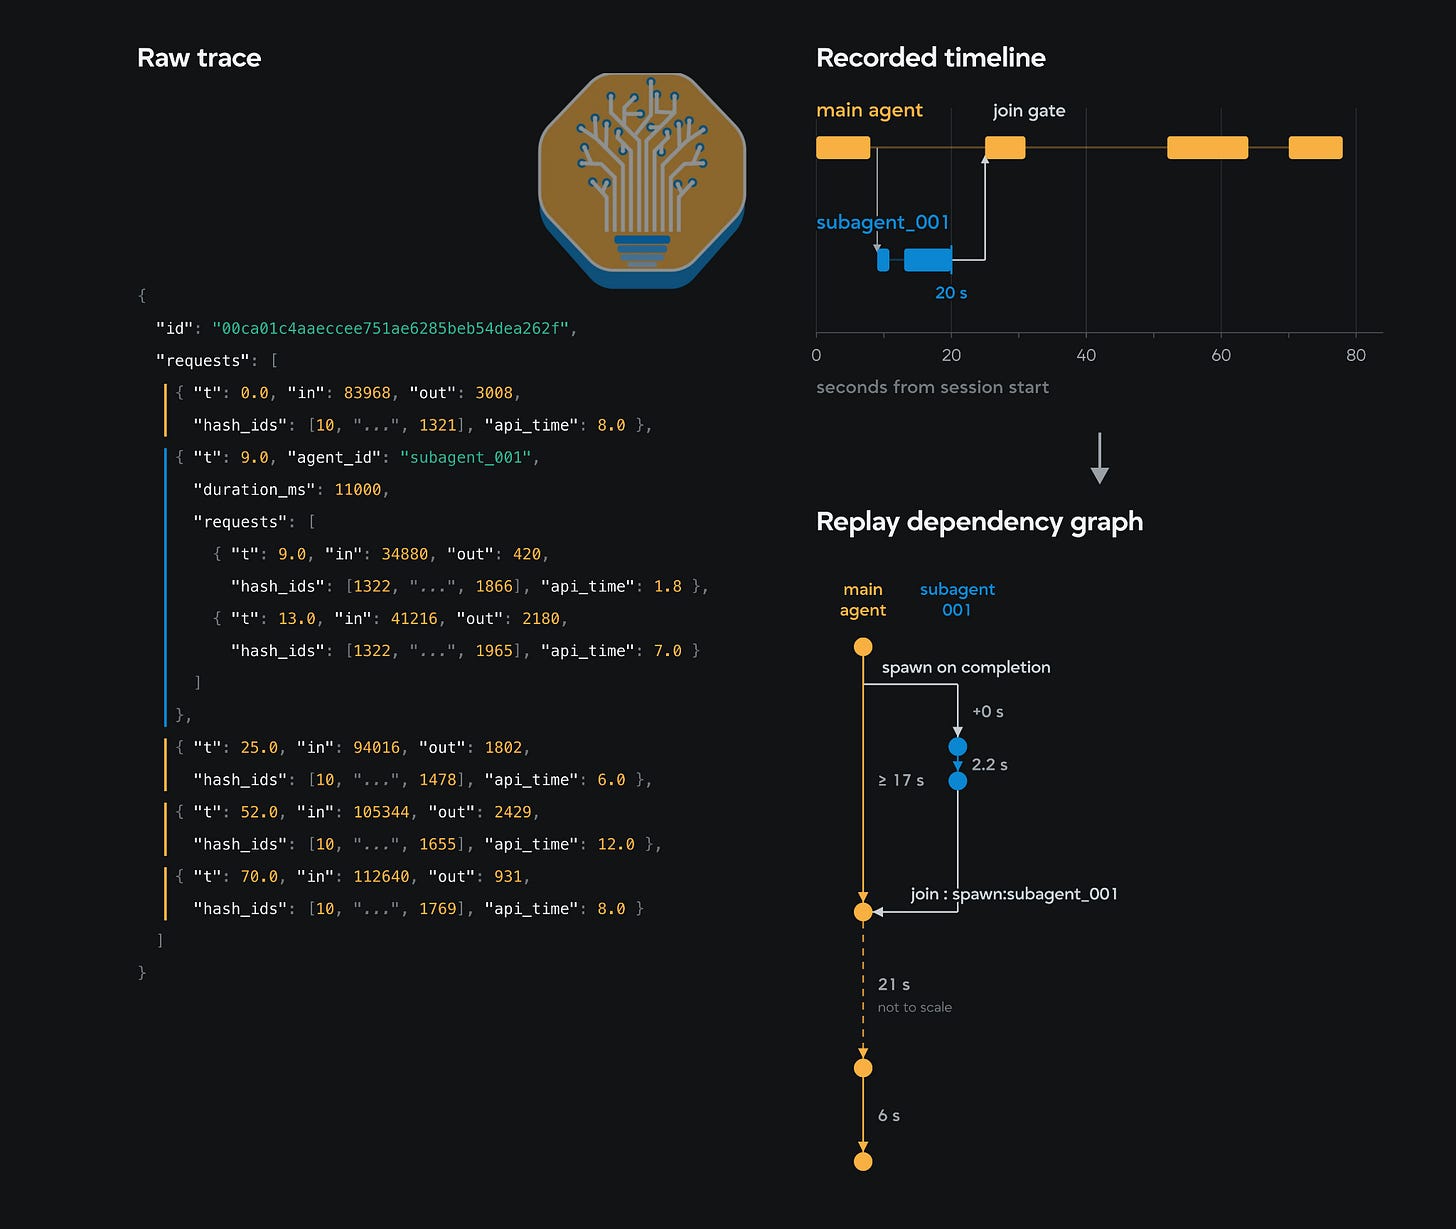
This behavior is responsible for turning the linear chain of requests above into a DAG, where certain requests are dependent on others. When a group of requests belonging to one subagent is identified, AIPerf finds the most recent main agent predecessor and designates it as the “spawning” request. Similarly, the “join” request is identified by the subsequent main agent request after the duration of the subagent group completes.
在下面的示例中,子代理组包含一个单独的子代理(001),它运行了两个请求。主代理的初始请求完成后,子代理的第一个请求会立即发出。该请求完成后,会有一个 2.2 秒的回合间延迟,用来代替工具使用的实际耗时,随后发送子代理的第二个请求。主代理的第二个请求是子代理 001 的汇合点。当同时满足以下两个条件时,该请求才会发出:距离主代理的首次响应至少已过去 17 秒,并且子代理 001 的第二个请求已完成。
一个小的局限在于,HTTP 时间戳揭示了时间,但不一定能揭示因果关系。在下面的示例中,如果子代理 001 完成,且距离主代理请求 2 的记录开始时间还剩 7 秒,我们无法判断这 7 秒是代表子代理返回后执行的工作,还是已经在进行的独立工作。因此,AIPerf 保留了这两个约束条件:请求 2 需要等待其记录的主路径延迟,并等待子代理 001 完成。这重现了观察到的时间和拓扑结构,但未重现框架内部隐藏的依赖关系。我们希望在 AgentX 的后续版本中改进这些问题。
Source: SemiAnalysis
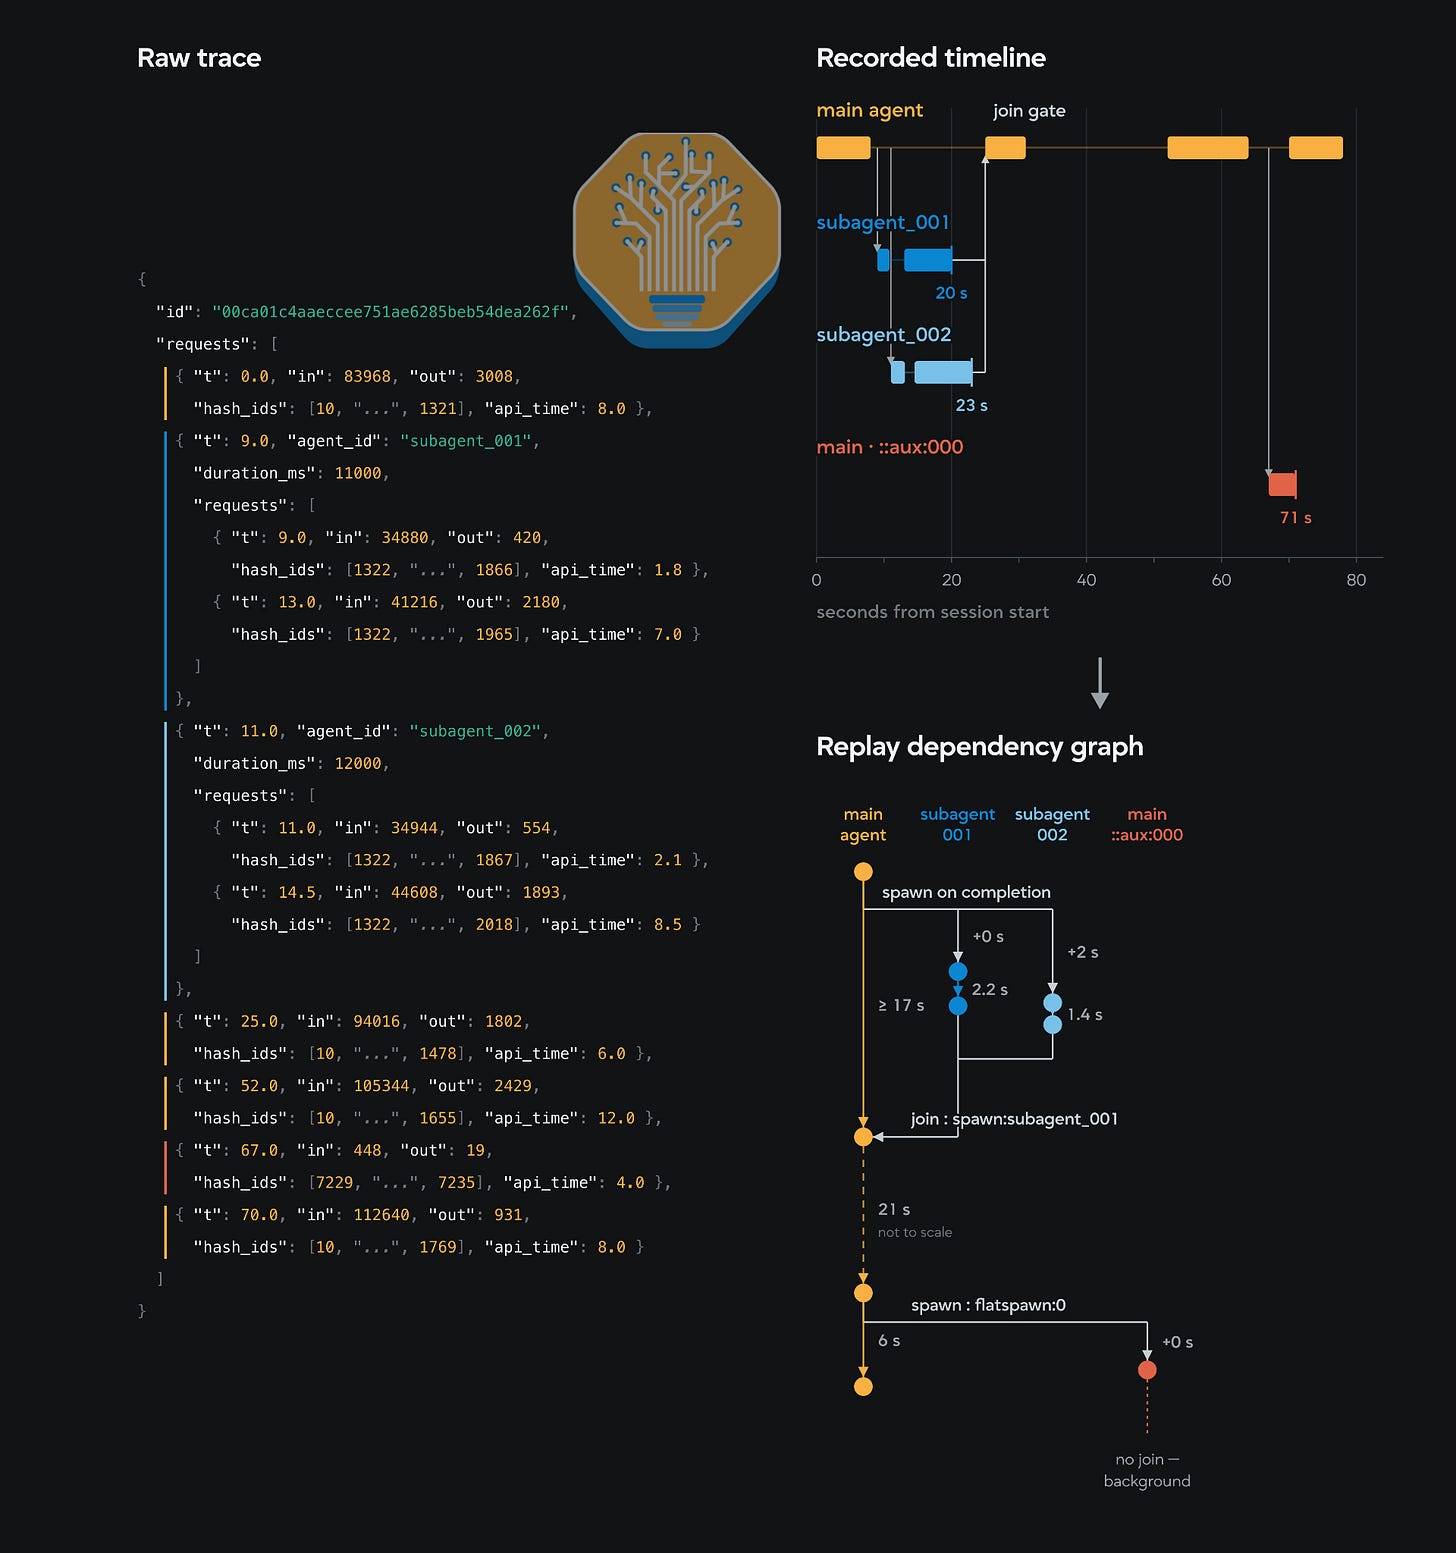
单个请求也可以生成多个子代理。在下面的示例中,子代理 001 和 002 都将它们的生成父级标识为主代理请求 1,然后在主代理请求 2 处汇合。
AIPerf 还可以识别“辅助”请求,这是一次性请求,与流中的任何其他请求不共享上下文。它们从主代理分出,且从不汇合。在实际应用中,这类请求类似于 Claude Code 的“总结当前会话”请求,与对话的上下文无关。另一个很好的例子是 Claude Code 的“/btw”功能。
Source: SemiAnalysis
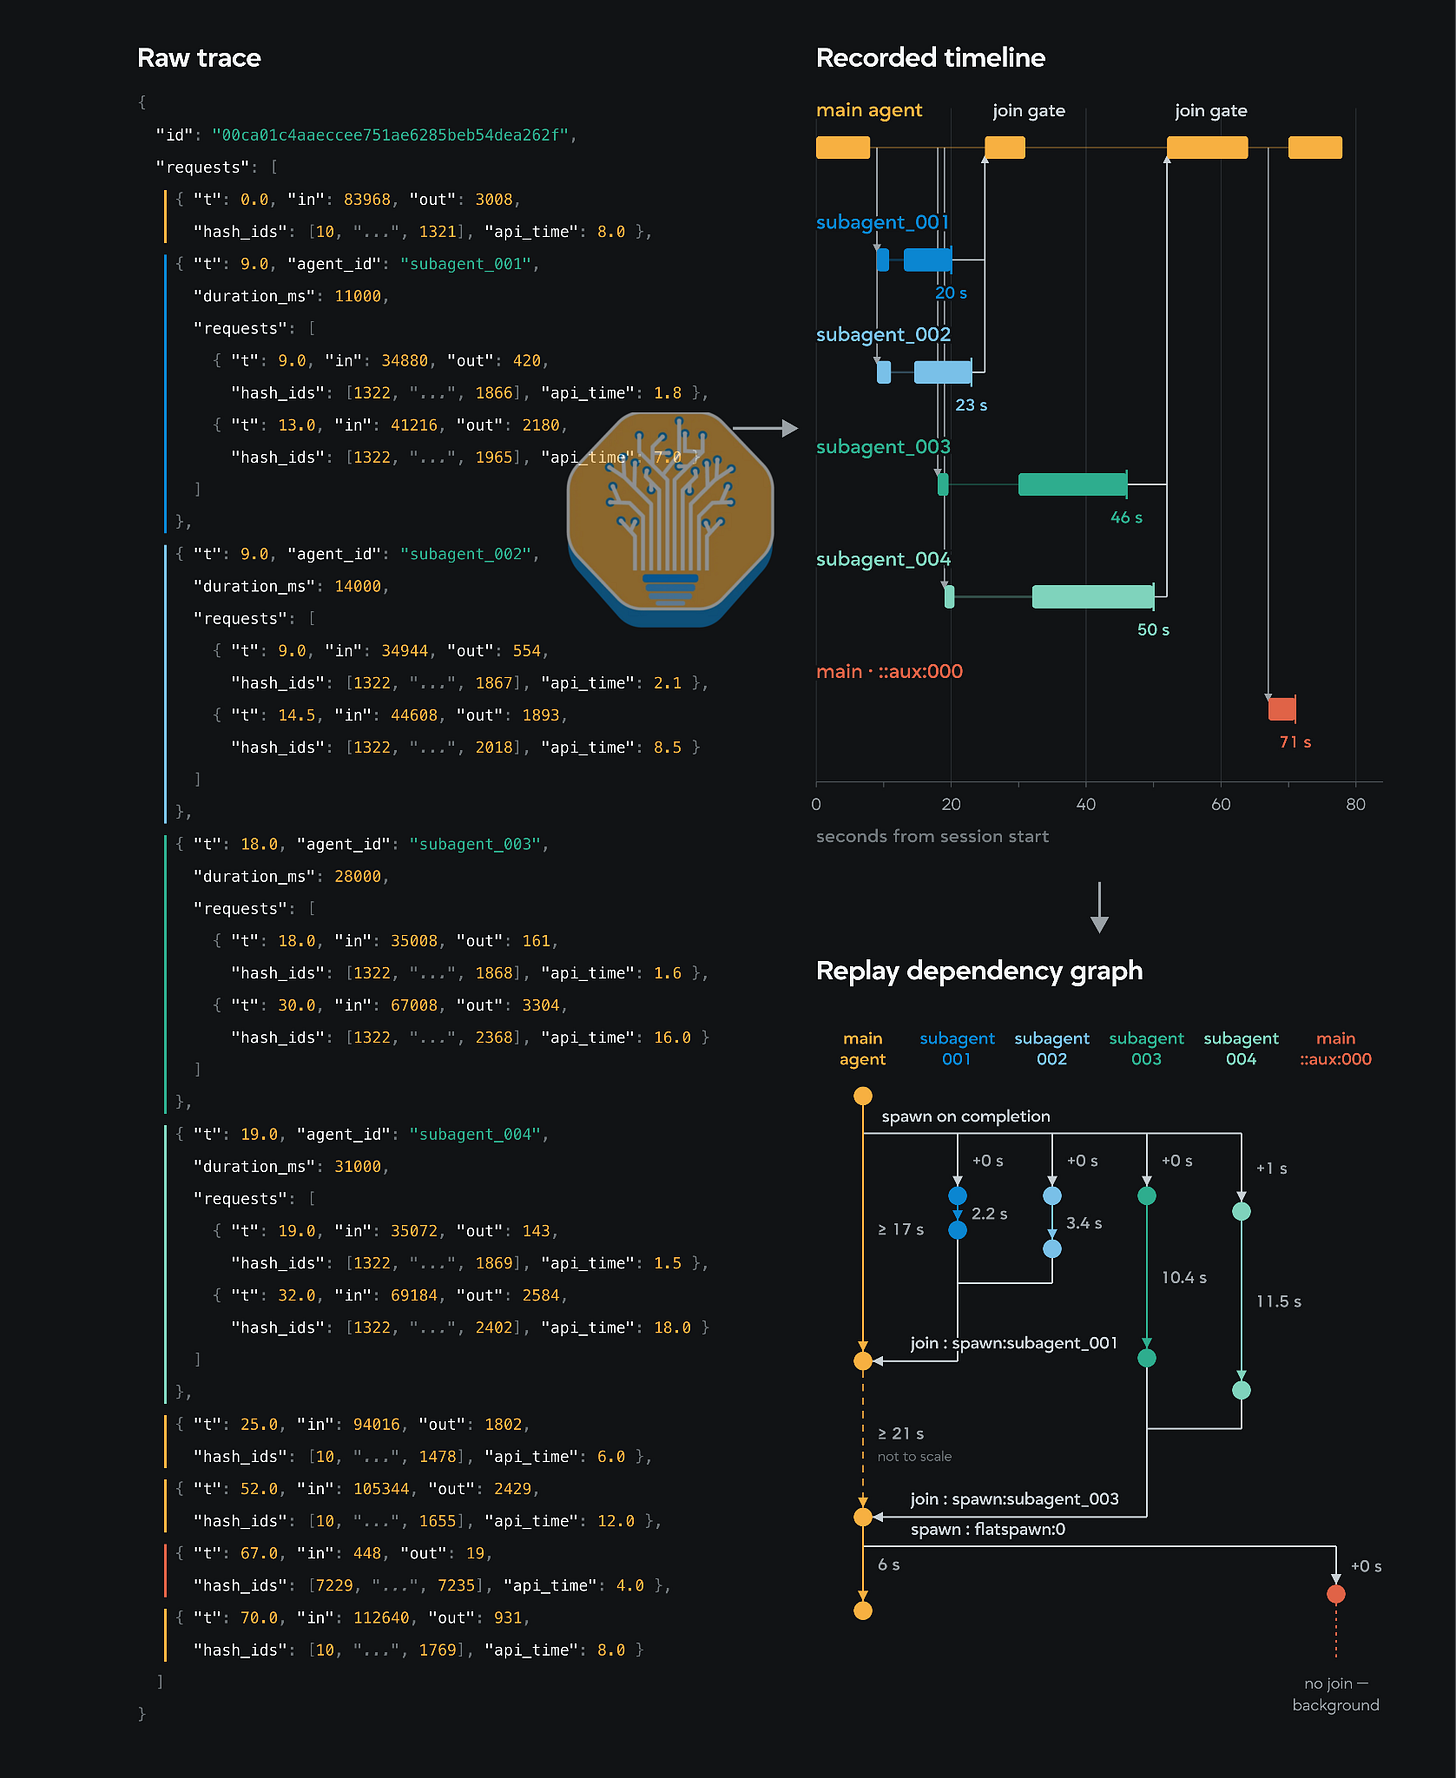
下面的示例将上述内容整合在一起。这是你在实际数据集中会看到的 trace 片段类型。我们有五个并行流从一个主代理请求分出,按照它们汇合到的主代理请求分为不同的组。
子代理 001 和 002 分别在第 20 秒和第 23 秒完成,因此之后在 25 秒开始的第一个主代理请求是它们的汇合点。子代理 003 和 004 在同一间隙生成,但运行时间更长,分别在第 46 秒和第 50 秒完成,因此它们在 52 秒处汇合。AIPerf 通过(生成请求、汇合请求)这对键来标记每个子代理,这意味着即使这四个流都从同一个节点分出,它们也会合并为两个分支。分支采用其第一个成员的名称,这就是汇合边被标记为 subagent 001 和 subagent 003 的原因。
这也是主代理与其自身子代理发生重叠的第一个案例。在 25 秒时发出请求,而 003 和 004 仍在运行:主代理只在与它汇合的组上阻塞,而不是在所有运行中的子代理上阻塞。
辅助链会附加到时间上最近先于它的主智能体请求上。在这里,这指的是 52 秒处的请求,而不是开启会话的那个请求。因此,该节点同时做两件事:接收第二个子智能体组的 join 操作,并生成一个一次性请求。当然,辅助请求永远不会 join 回来。
Source: SemiAnalysis
深入探讨 AgentX
Pareto 前沿扫描
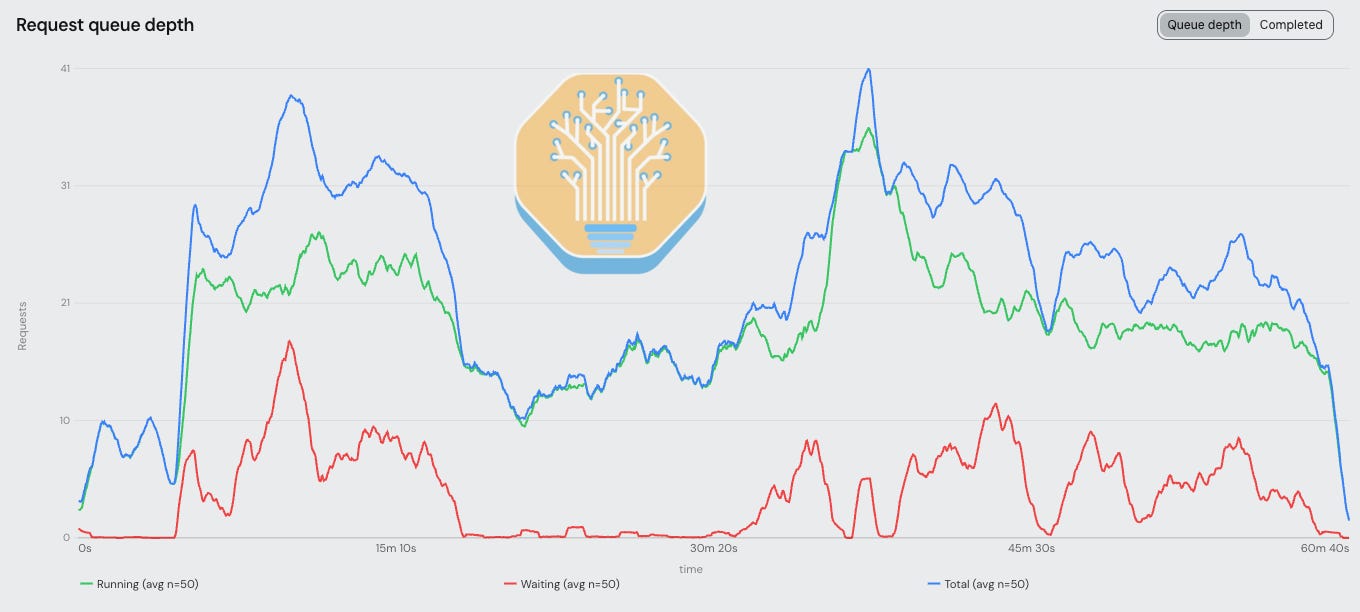
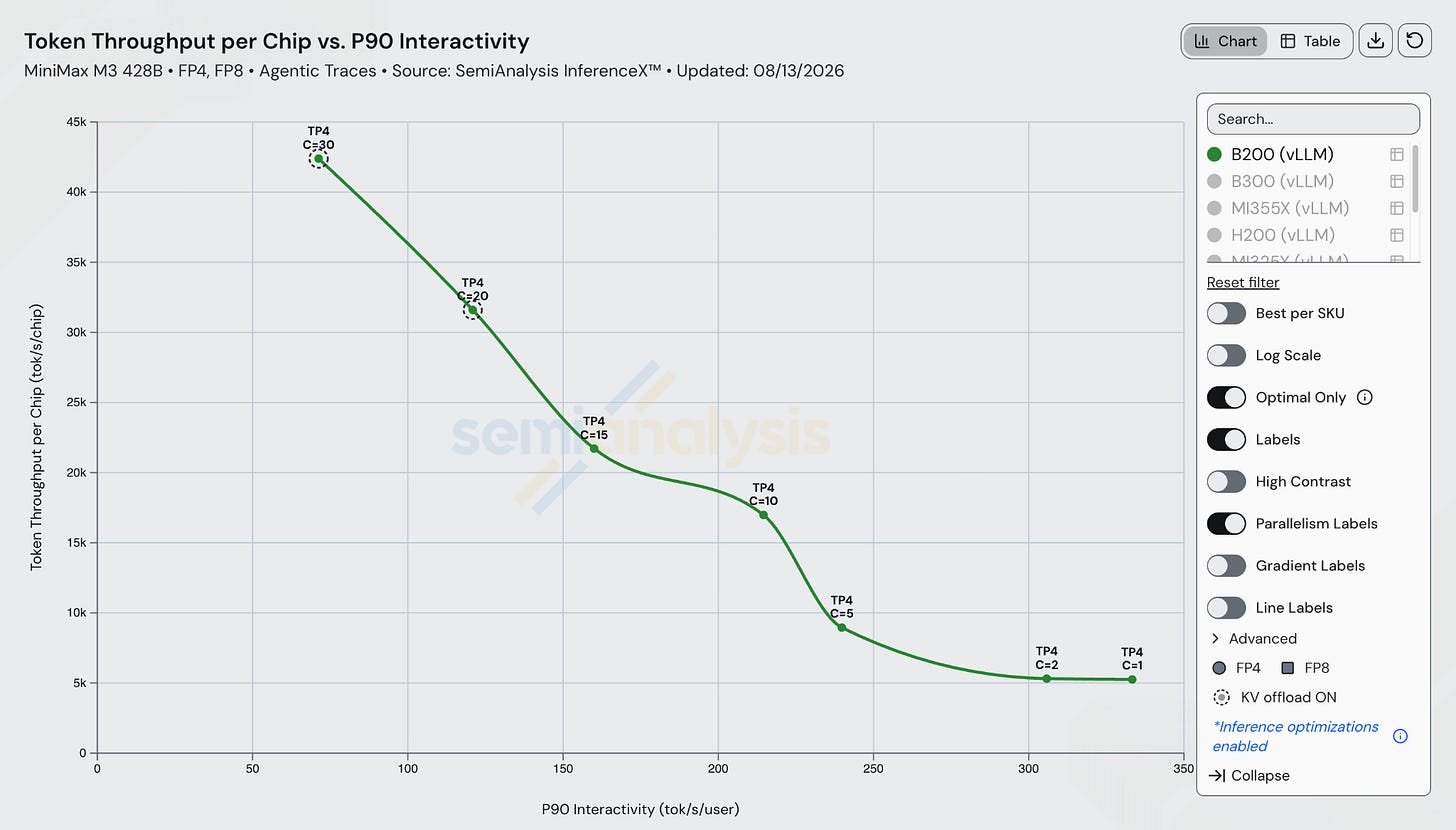
在 AgentX 工作负载中,为了生成 Pareto 前沿,我们针对单个部署逐步调整并发 Claude Code 会话的数量。由于每次对话都包含真实的轮次间延迟和子智能体使用情况,我们得到了一种更加波动且更真实的流量模式。下面的示例展示了在运行 MiniMax M3 的 B200 TP4 vLLM 服务器上,重放 40 个并发客户端的情况。
Source: SemiAnalysis InferenceX
Source: SemiAnalysis InferenceX
最后值得讨论的一点是,在评估智能体工作负载时,哪些指标是重要的。我们认为交互性(TPS,即每秒 token 数)和首 token 延迟(TTFT)依然重要,并且这些是评估 SLO 的行业标准。在查看 AgentX 结果时,将 TPS 和 TTFT 结合起来考量极其重要,因为有些推理优化可能会以牺牲一方为代价来改善另一方。
我们目前正在致力于定义一种以合理方式结合 TPS 和 TTFT 的新指标。这还应考虑到,在智能体工作负载中,人们通常更关心任务完成的端到端速度,而不是接收 token 的速度或 TTFT。
最后值得一提的是,当前形式的端到端延迟意义已经不大,因为端到端延迟与 OSL 成正比。因此,P90 端到端延迟受最长输出序列长度尾部 10% 的影响极大。虽然整体比较某些配置的总体性能仍然有参考价值,但我们建议转而关注 TPS 和 TTFT 的组合。
预热、计时、确定性与对话复用
AgentX 的目标是对已经处于稳定状态的系统进行基准测试。对于智能体工作负载,这意味着性能分析应从部分上下文轨迹已被缓存的起点开始。为了模拟稳定状态,最好不是所有对话都从第 0 轮开始,否则可能会引发“惊群效应”。
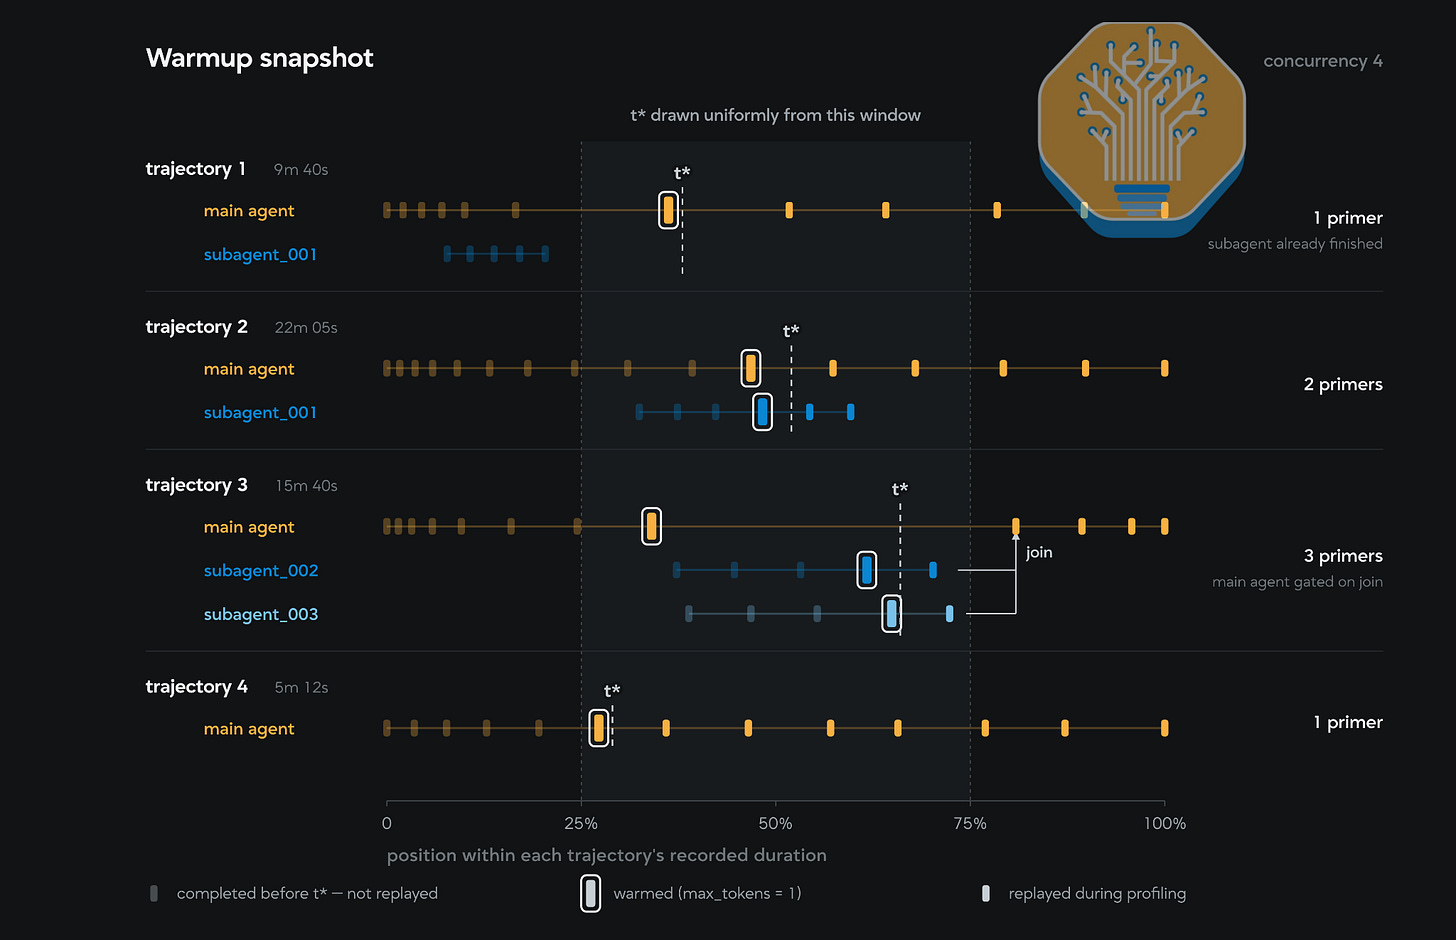
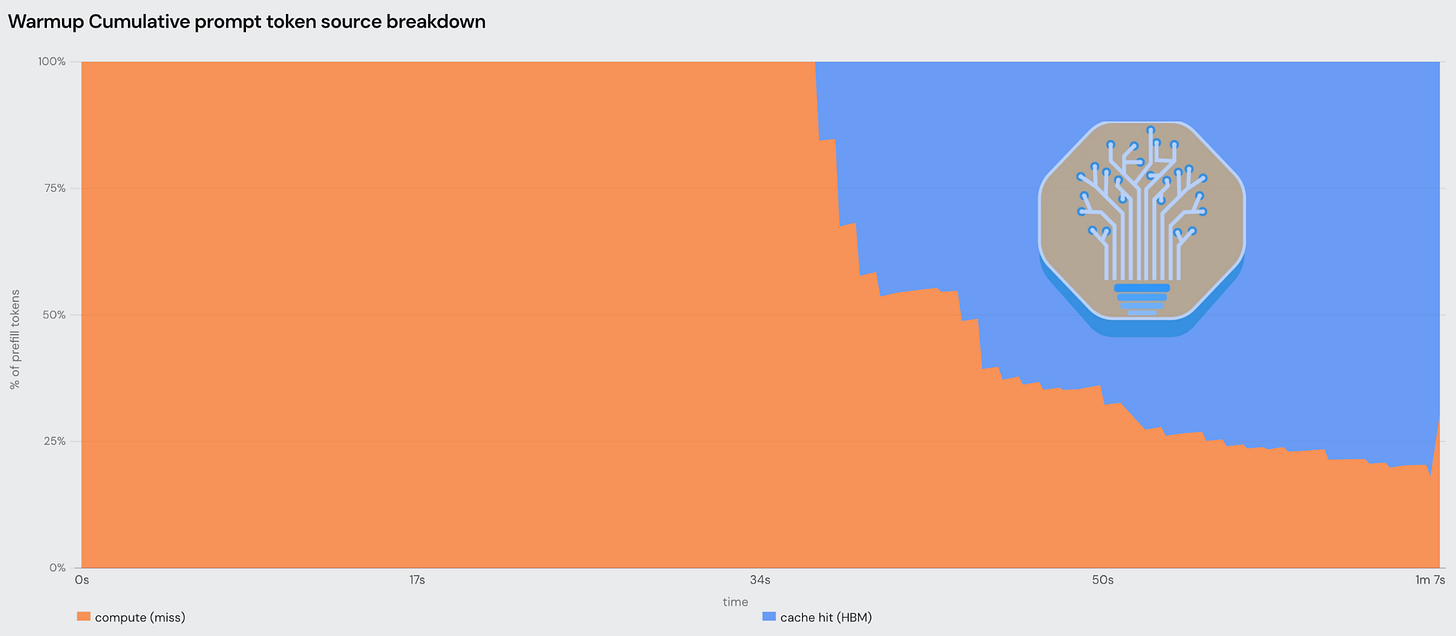
预热分两个阶段进行。首先,AIPerf 使用固定的随机种子,在每次对话 25% 到 75% 的时间点之间选取一个实际时间点。在该时间点,它会识别出每个活跃的请求流,包括主智能体和任何活跃的子智能体,并发送该时间点之前各流最近的请求。这些引导请求会重建该时间点的对话状态,并被同时派发。AIPerf 会等待这些请求处理完毕后再继续。
Source: SemiAnalysis
在第二阶段,每个回放通道会额外推进 10 个请求,为 KV 缓存的生成提供更多机会。所有预热请求均忽略轮间延迟,并将最大输出长度设为一个 token,从而大幅缩短预热时间。
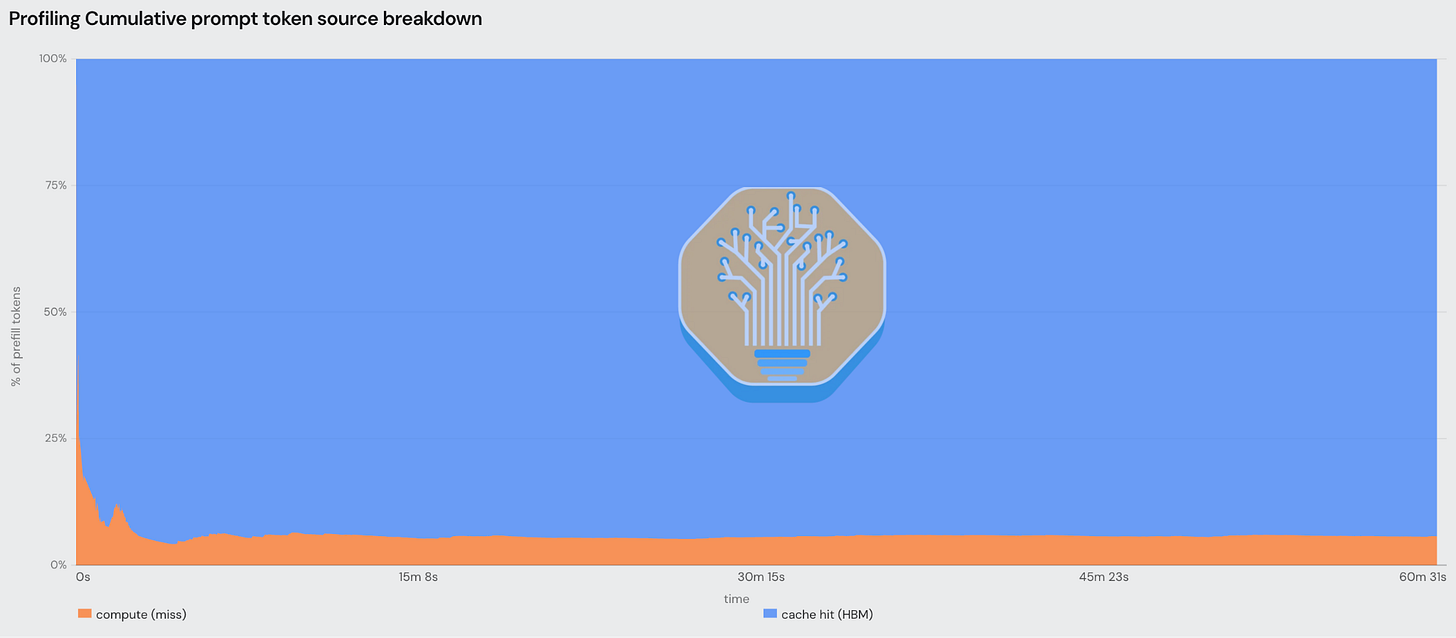
Source: SemiAnalysis
预热完成后,性能分析阶段开始,持续时间为 1 小时。所有指标均严格在这一时段内收集。为了保证可复现性,AIPerf 接受一个随机种子,确保每次运行都能确定性地采样对话,使对话从同一起点开始,并且每次运行都以相同的合成内容重建对话。在性能分析期间,我们对每个流施加 5 分钟的空闲时间上限。这样,较长的轮间间隔就不会在整个基准测试期间一直占用工作通道。我们实施这一限制,以便能够在 1 小时内有效完成基准测试。在 AgentX 的后续版本中,我们将引入 NVMe 卸载功能,届时可能会选择增加该上限,以便测量更长的 TTL。就目前而言,5 分钟是合理的,因为这是 Anthropic 默认的 KV 缓存 TTL。
这种级别的确定性确保了在相同推理引擎、硬件、并发度和服务器设置下,运行结果具有可复现性。然而,由于 AgentX 是一个闭环基准测试,不同的配置会以不同的速率完成不同数量的请求,这使得它们遇到的工作负载会产生一些自然差异。这种差异在较低并发度下最为明显。此时完成的请求较少,工作负载趋向数据集整体分布收敛的机会也更少。
在性能分析期间,当一段对话完成时,其回放通道会从数据集采样器中选择另一段对话。每次回放都会获得一个唯一且确定性的缓存清理标记。该标记会前置于每个独立的上下文前缀链,包括主 Agent 链以及任何全新上下文的子 Agent 链或一次性链。分叉出的子 Agent 会继承父 Agent 的标记。该标记在同一次回放内保持不变,从而保留其 KV 重用模式;但在不同回放之间会发生变化,以防止出现人为偏高的缓存命中率。这也使得在并发度高于数据集中对话数量(393)的情况下,依然可以运行测试场景。
AgentX 的公平推测解码方法论
如前所述,数据集在采集时进行了匿名化处理。这意味着 64 token 的哈希块必须在回放前用合成数据填充。AIPerf 通过从合成的编码/工具使用 token 池中进行确定性采样来实现这一点。
重要的是,KV 重用模式和请求时序都得到了保持,但合成请求数据确实带来了一些额外的考量。具体而言,在合成数据上运行推测解码方法,可能会导致推测器拒绝或接受的 token 数量与非合成数据相比出现异常(因为推测器并未基于合成数据进行训练)。
我们在 InferenceX v2 的文章中讨论过这个不足。此后,我们改进了测试方法。我们与社区紧密合作,确保大多数开源推理引擎都提供了一种机制,允许用户强制设定从推测器接受的草稿 token 数量(即“接受长度”或“接受率”)。然后,针对每种组合(模型、推测器、草稿长度和思考模式),我们在 SPEED-Bench 智能体编程数据集上收集平均接受长度(AL)。该数据集是一个“统一的基准测试,旨在跨多样的语义领域和实际的服务场景评估推测解码(SD)。”
随后在运行时,我们将这些符合实际情况的推测解码接受长度应用于 AgentX。这确保了测试的厂商中立性与公平性。
Source: GitHub
探索智能体工作负载的详细遥测教程
AgentX 不仅仅需要新的基准测试框架和数据集。我们还花了一些时间重构 InferenceX 可视化工具的部分功能,让智能体测试结果更易于探索和理解。单个 AgentX 数据点代表着数千次请求。这些请求涉及不断增长的对话、子智能体、预热阶段、缓存状态以及动态变化的运行中负载。因此,Pareto 曲线上的单个点可能会隐藏许多有用信息。正如我们多次强调的那样——推理服务永远不存在“一刀切”的解决方案。
Source: SemiAnalysis InferenceX
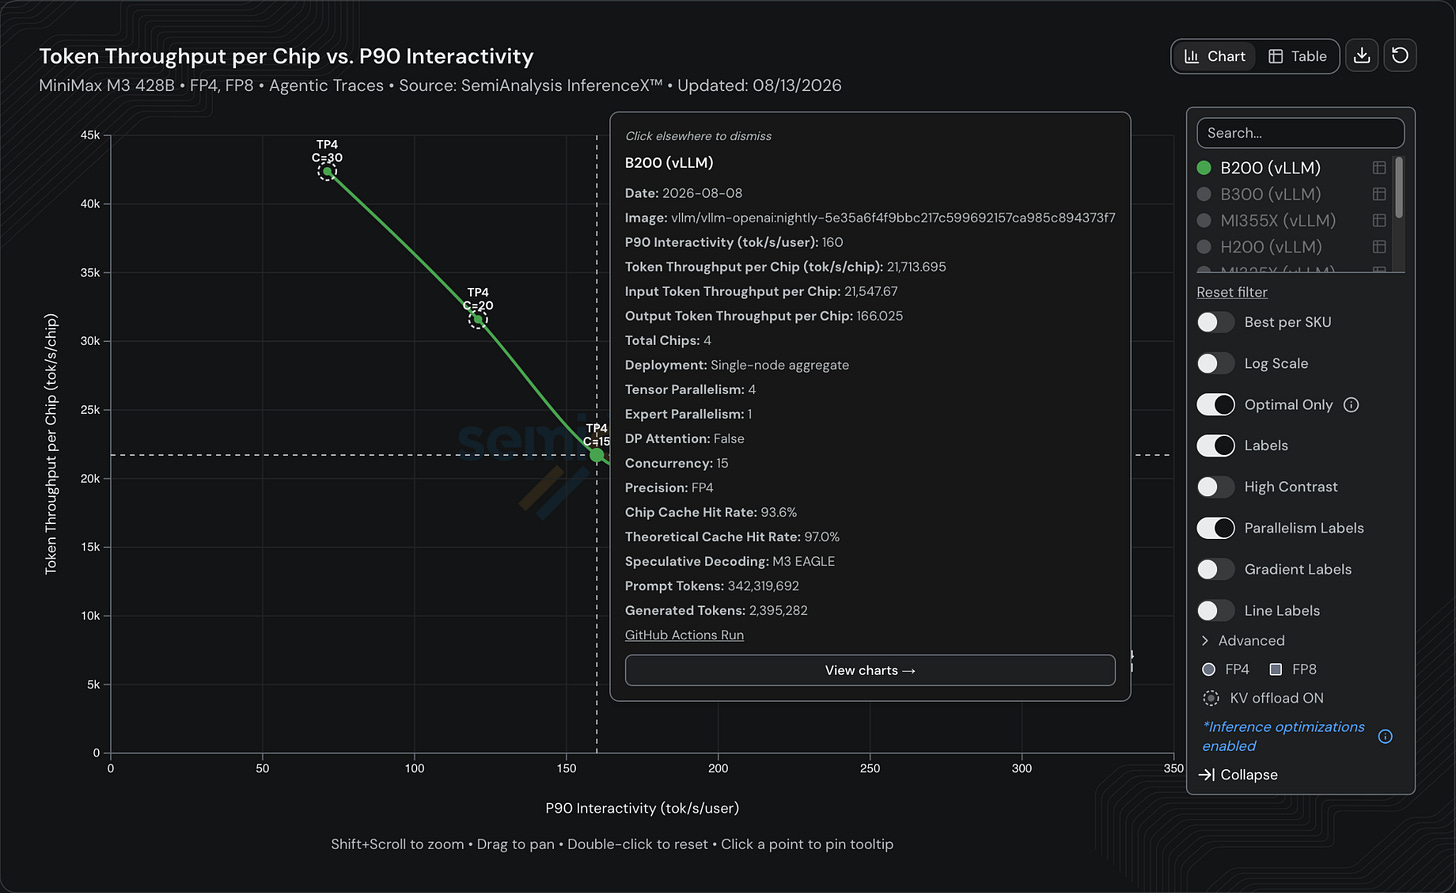
我们的一项重大改变是曲线本身的构建方式。在之前版本的 InferenceX 中,开启和关闭推测解码的配置通常显示为两条独立的曲线。但我们现在放弃了这种做法。前端现在整合了所有允许的推理优化,并为每种模型、SKU 和推理引擎组合显示最佳可用曲线。因此,单条曲线上不同的点可能采用不同的优化技术和配置。这些技术包括推测解码、分离部署或 KV cache offload。
我们的目标是展示每个软硬件栈能够提供的最佳生产性能。而不是为每种可能的优化组合创建单独的曲线。不过,我们仍然会公开每个数据点背后的配置和溯源信息。点击某个数据点会显示一个详细信息的提示框。该提示框明确展示了生成该点的具体配置,以及运行元数据、公开可查的 CI 溯源链接和 AgentX 专属统计数据。在此提示框中,“查看图表”链接会打开完整的数据点详情页面,其中包含 AgentX 专属统计数据。
Source: SemiAnalysis InferenceX
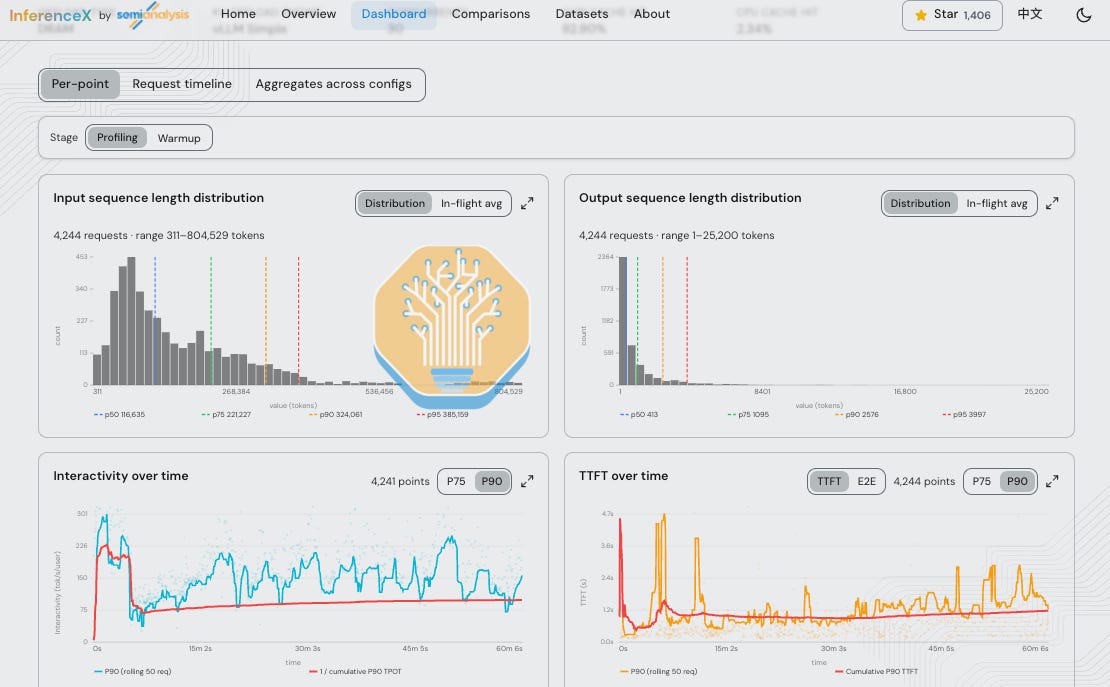
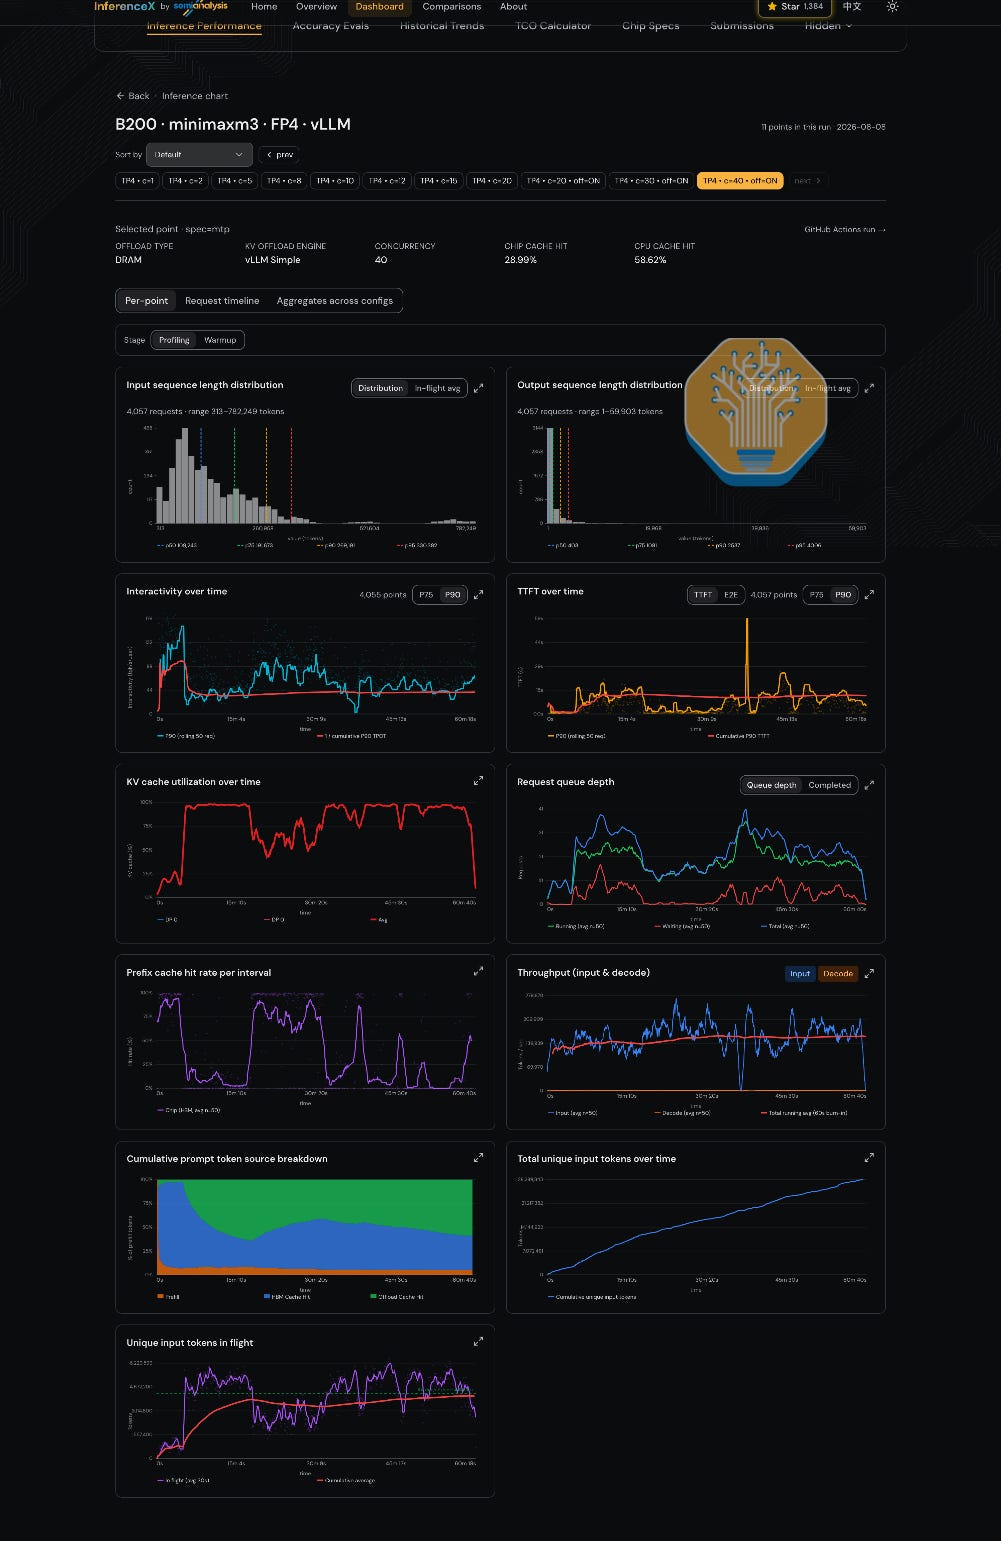
详细的数据点视图可以让我们更深入地了解所选的 AgentX 运行。它包括输入和输出序列长度分布、随时间变化的交互性和 TTFT、KV cache 利用率、请求队列深度、前缀缓存命中率、输入和解码吞吐量、prompt-token 来源明细,以及随时间变化的唯一输入 token 数。有了这些指标,我们就更容易理解为什么在吞吐量总和相近的情况下,两个数据点在整个回放过程中的表现却可能截然不同。
该页面还将预热阶段和分析阶段的数据分离开来。读者可以在两个阶段之间切换,以检查系统在建立缓存状态期间的行为,以及在用于基准测试的分析期间的行为。
Source: SemiAnalysis InferenceX
在主图表上,使用 KV cache offload 的数据点会被一个额外的虚线圆圈包围,以此区分启用了 KV offload 的数据点。选中其中一个数据点时,详情页面会显示 offload 类型、KV offload 引擎、芯片缓存命中率和 CPU 缓存命中率。这样一来,无需为每种 offload 配置单独创建一条曲线,也能直观看出 KV offload 在哪些地方为最优曲线做出了贡献。
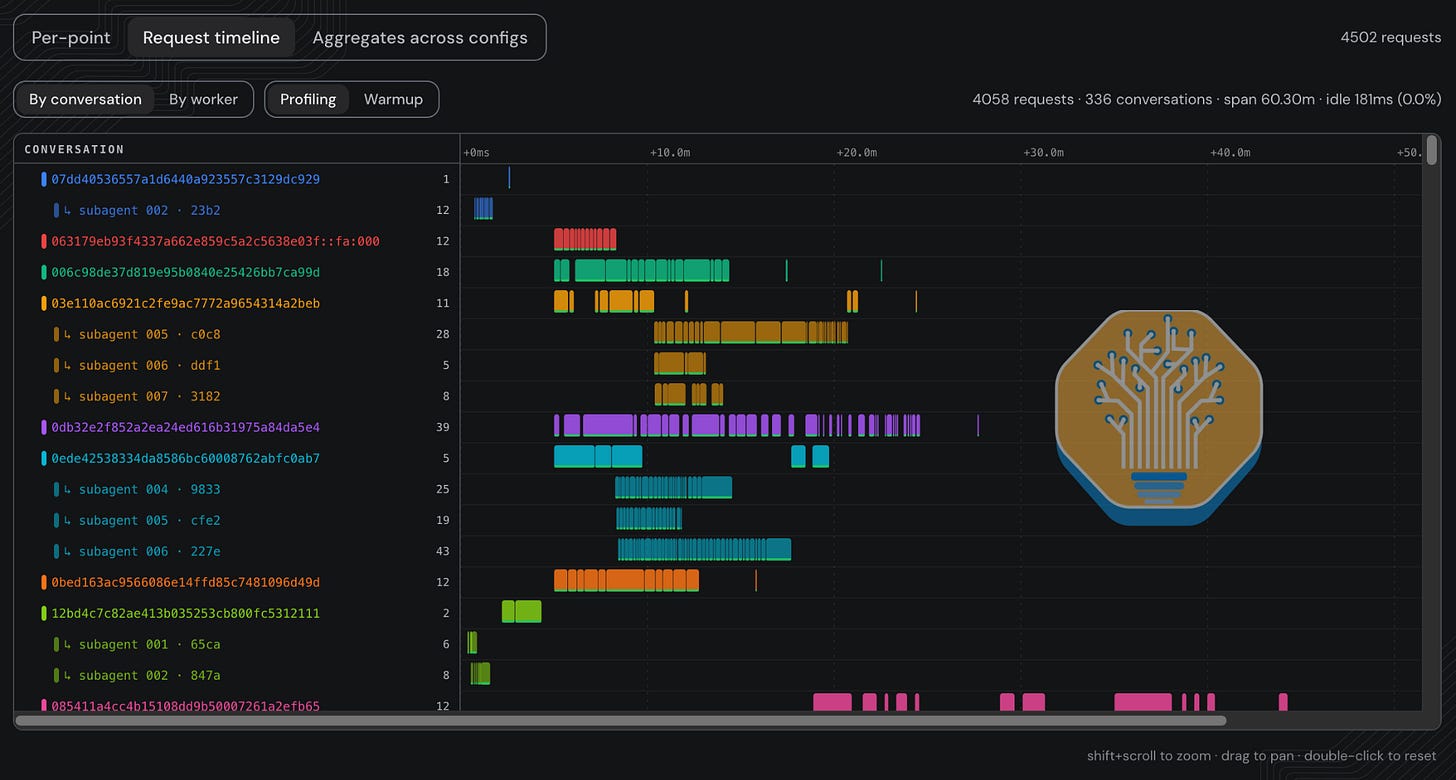
另一个新功能是请求时间线。该视图展示了在所选 AgentX 运行期间回放的各个请求,并且可以按对话或按 worker 进行组织。对话视图将子 agent 归组到其对应的根对话下,便于查看对话与子 agent 何时发生重叠。预热和分析阶段的请求仍然可以分开查看。
Source: SemiAnalysis InferenceX
时间线中的每个请求都是可点击的,并直接链接到 InferenceX 数据集页面上对应的对话和轮次。这让读者能够从 Pareto 曲线上的聚合数据点,直接跳转到所回放的确切匿名请求。
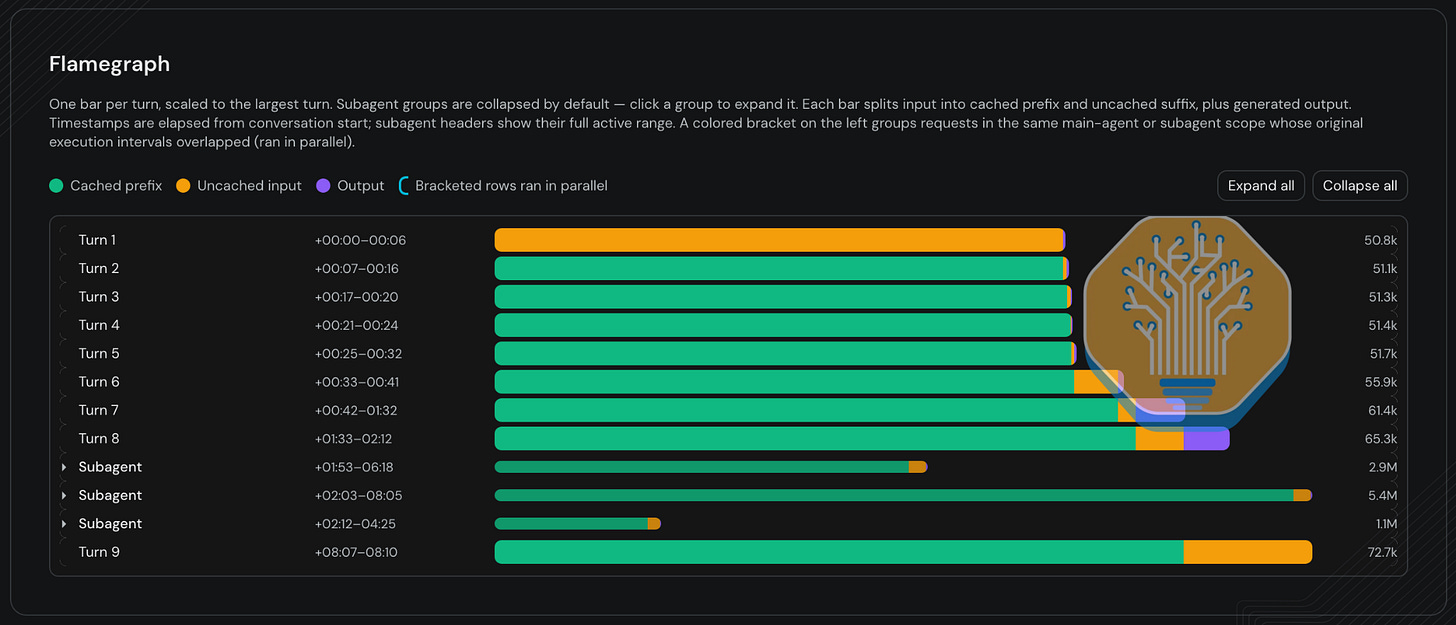
AgentX 页面还包含一个火焰图,用于可视化单个对话的结构。每个条形代表一个轮次,其长度按该对话中最大轮次的比例进行缩放。条形图被划分为缓存的前缀 token、未缓存的输入 token 和生成的输出 token 三部分。这直观地展示了对话过程中上下文是如何增长的,以及每个请求有多少部分可以从 KV cache 中复用。
Source: SemiAnalysis InferenceX
InferenceX/AgentX 未来下一步计划
我们很高兴能继续推进我们的目标,让 AgentX 成为最真实、最具代表性的基准测试。在可预见的未来,我们会继续对当前的 v1.0.x 测试框架进行一些小的 bug 修复,但也计划对 v1.1 测试框架进行更大的改动。每个不同模型的提交将始终运行相同的次版本号,以确保所有结果具有可比性。
作为一项快速跟进工作,我们将添加 SSD/NVMe KV offloading。这将支持比 DRAM 更大的 KV cache 工作集大小,从而实现 Pareto 曲线左侧的高吞吐量。
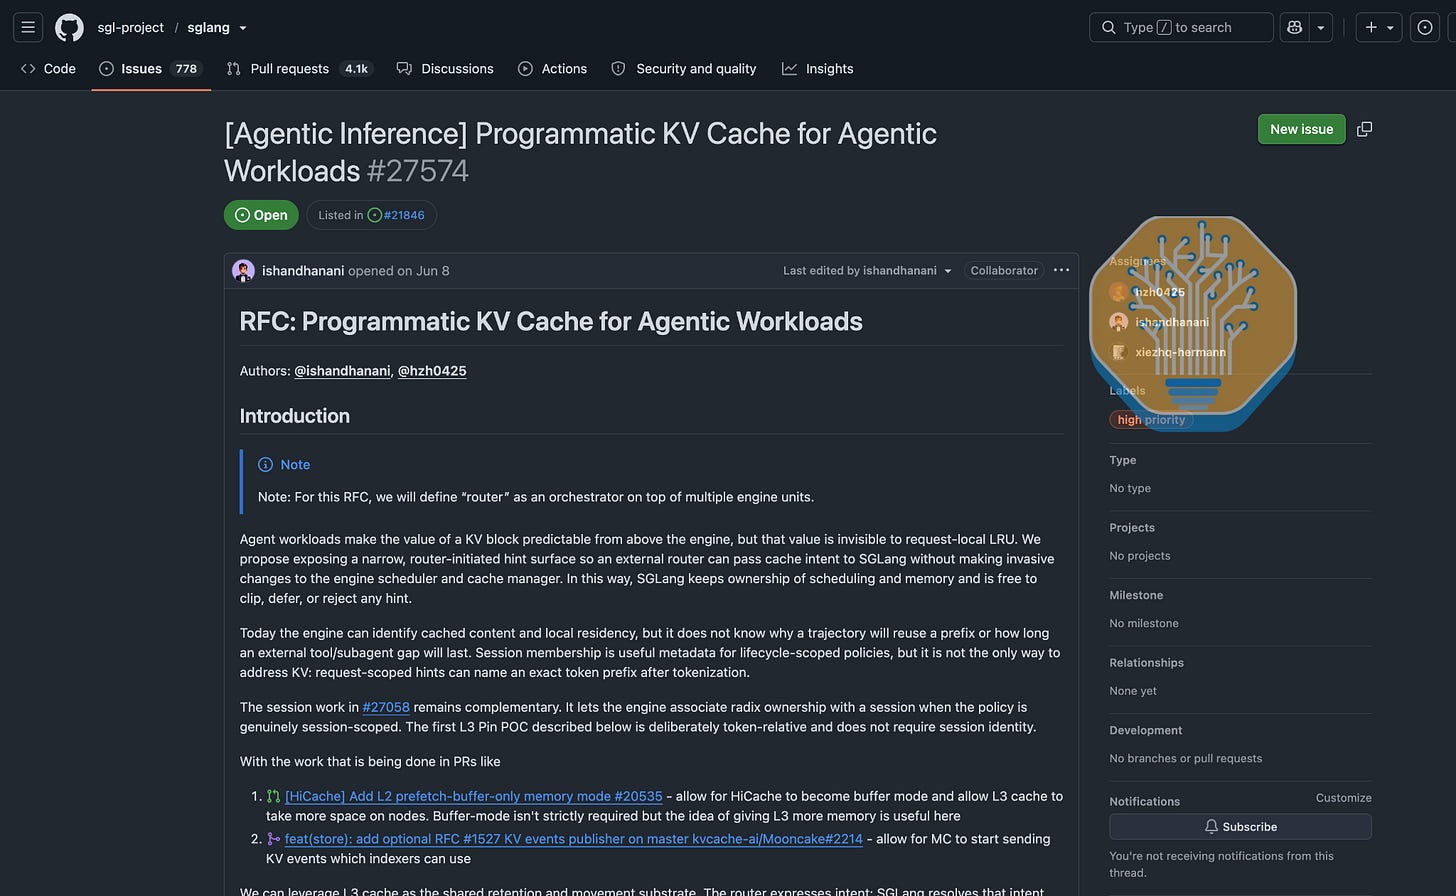
We will also capture a larger, more diverse, and more recent dataset of agentic traces across a wider variety of models and harnesses. Rather than representing each request as one contiguous list of hash IDs, the next dataset will preserve the boundaries between system instructions, user and assistant messages, tool calls, and tool results. This will allow AgentX to evaluate workload-aware serving techniques that use information available to the agent harness but normally hidden from the inference engine. For example, a router could direct low-reuse tool traffic to dedicated prefill workers, retain an agent’s prefix during a long tool call, or prefetch and share prefixes when subagents fork. The current format preserves request sizes and KV-reuse patterns, but it lacks the structure needed to evaluate these optimizations.
The following SGLang RFC by Ishan provides a concrete example of why this richer trace structure matters. It proposes a router-initiated hint interface that uses information such as session lifecycles, shared-prefix boundaries, tool-call duration, and subagent state to tell the engine when KV should be shared, prefetched, demoted, pinned, or retained. Capturing this structure would allow future AgentX versions to evaluate these workload-aware cache policies instead of only replaying flat token prefixes.
Source: GitHub
Lastly, we are capturing fine-grained and coarse grain power telemetry data to have an even more accurate view of the efficiency of the Joules per intelligence of different software and hardware stacks.
We have so much data and so many possible visualizations. Please let us know any visualizations you would like to see, as well as any more general feature requests!
Suggest Frontend Feature!
Performance Throughout the Model Lifecycle
In the following sections, we turn to our historical single turn data (8k1k), which covers each model from launch day through the point we retired it from active testing. There are strong results here from both Nvidia and AMD, including several fixed sequence length configurations where MI355X comes out ahead.
AgentX better represents today’s agentic inference workloads. However, the historical fixed-sequence InferenceX results still remain useful for tracking the performance over time. Workloads such as 8k1k and 1k1k strip away most session-level behavior, including prefix reuse, persistent KV cache state, and routing affinity. This makes them less representative of current production traffic, but still useful for tracking how inference performance improves as software support matures.