← 全部文章
Are Open Models Catching Up?
2026-08-21 · 原文
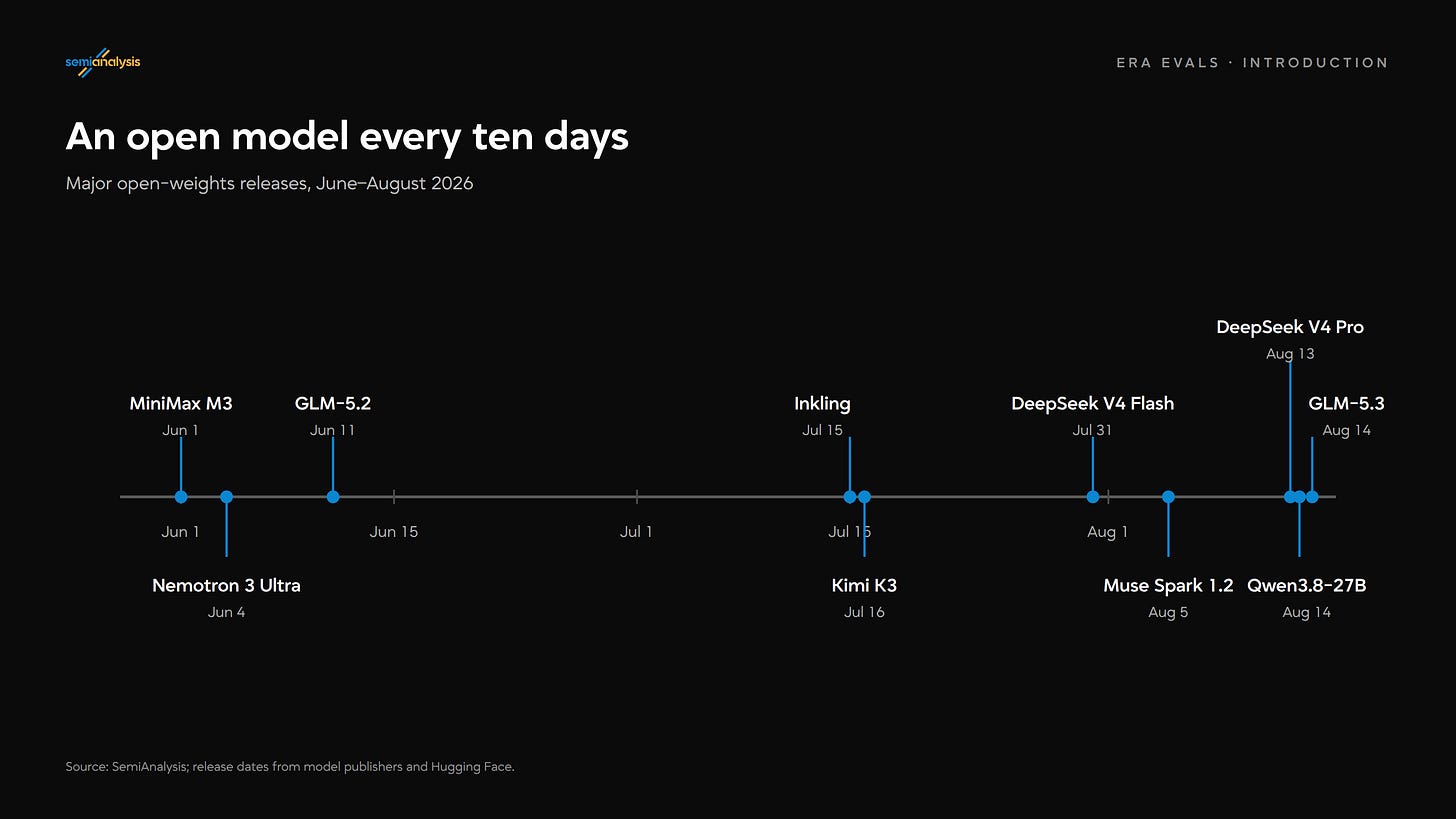
过去两个月是开源 AI 迎来爆发的时期。没错,2025 年 1 月确实出现过“DeepSeek 时刻”,但实际上并没有人使用 R1 来完成任何具有经济价值的工作。相比之下,GLM 5.3 和 Kimi K3 等模型已经真正具备了与 Anthropic 冲上 650 亿美元以上 ARR 相媲美的许多编程和智能体任务能力。与其他虚报 ARR 的人不同,我们的数据更接近真实情况。
Source: SemiAnalysis
对于 token 消费者来说,这是一个激动人心的时期。竞争日益激烈,各平台纷纷重置使用额度,争夺 token 的战役现已超越 OpenAI 和 Anthropic 的双头垄断格局。仅 Fireworks 每天就处理超过 40T 个 token,是 3 月底 OpenAI API 处理量的两倍。
然而,开源模型的成功也引发了严重的 FUD 情绪:如果开源模型以极低的成本,就能保持与闭源前沿模型相当的竞争力,那么模型层会不会变得同质化?这一结果对前沿实验室的利润率来说无疑是灾难性的。关于 Anthropic 和 OpenAI 财务状况的完整详情,请参阅我们的 Tokenomics Model。
为了预测开源与闭源能力差距未来的演变趋势,我们首先需要衡量过去的情况。你可能天真地选择一套基准测试来衡量所有历史模型,但这是一个错误的做法。每套基准测试都是特定时代的产物。当有人创建一套新的基准测试时,他们的目标是辨别当时模型能力的差异。如果成功,模型开发者就会不断刷榜,直到该基准测试达到饱和。一旦出现这种情况,大家就不再关注这套基准测试,接着循环往复。
在 LLM 的发展史上,迄今为止经历了三个时代:早期扩展时代、推理时代和智能体时代。每个时代都代表着模型实用性实现了阶跃式提升。我们认为,与其试图描绘一条单一的连续趋势线,不如按时代分别评估模型和基准测试。
从这个角度来看,开源与闭源之间的差距呈现出周期性变化就变得很明显了。在每个时代伊始,某个前沿实验室会完成一些前景广阔的研究,训练出令人惊艳的模型,并大规模部署给其用户,从而取得领先。随后,其他实验室会识别出关键技术进展,逆向分析前沿实验室的做法,将这些成果复现到自家模型中,从而缩小差距。没有什么能永远保密,尤其是当你把模型蒸馏也考虑在内时。这仅仅是一个需要多长时间的问题。
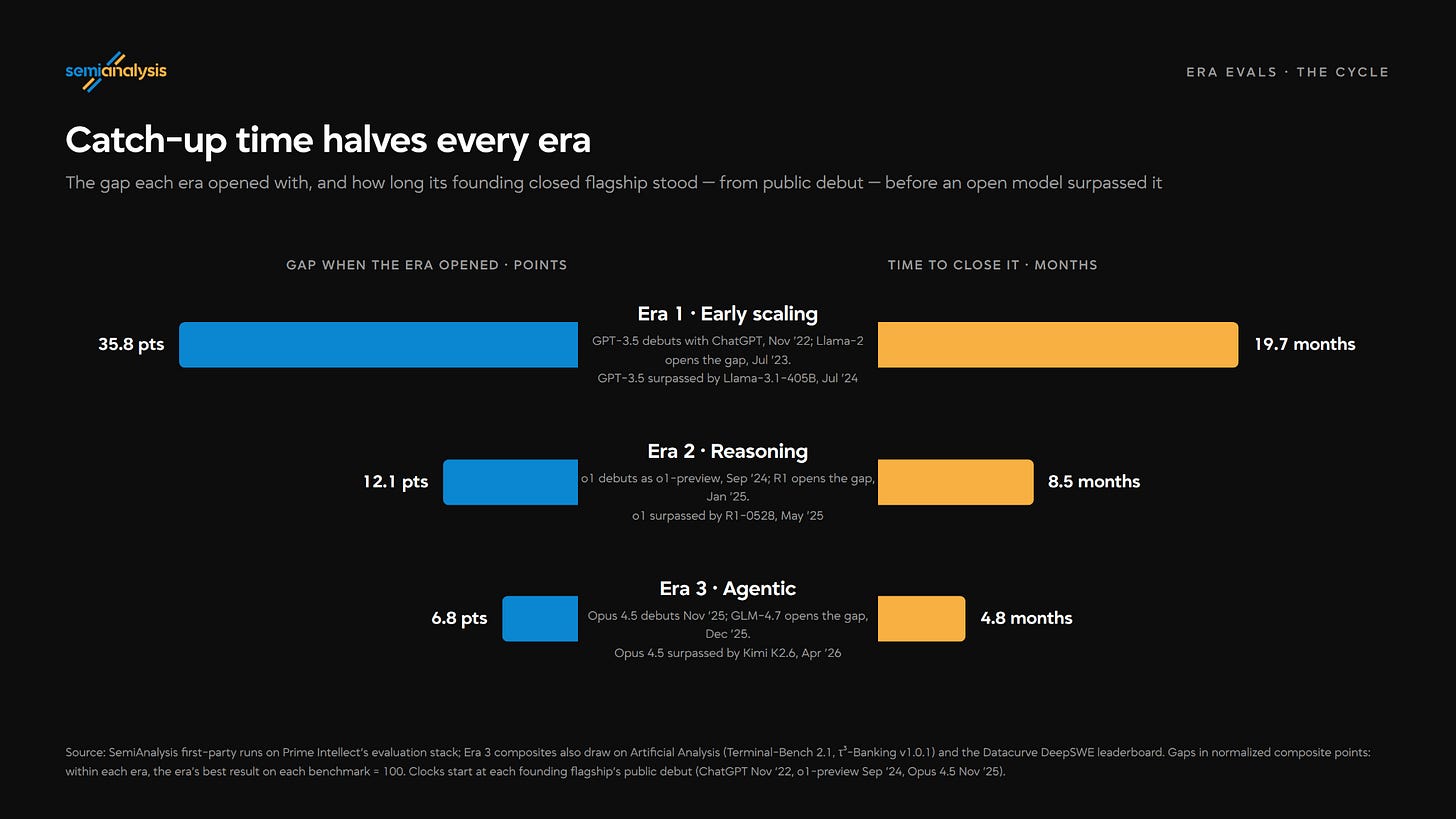
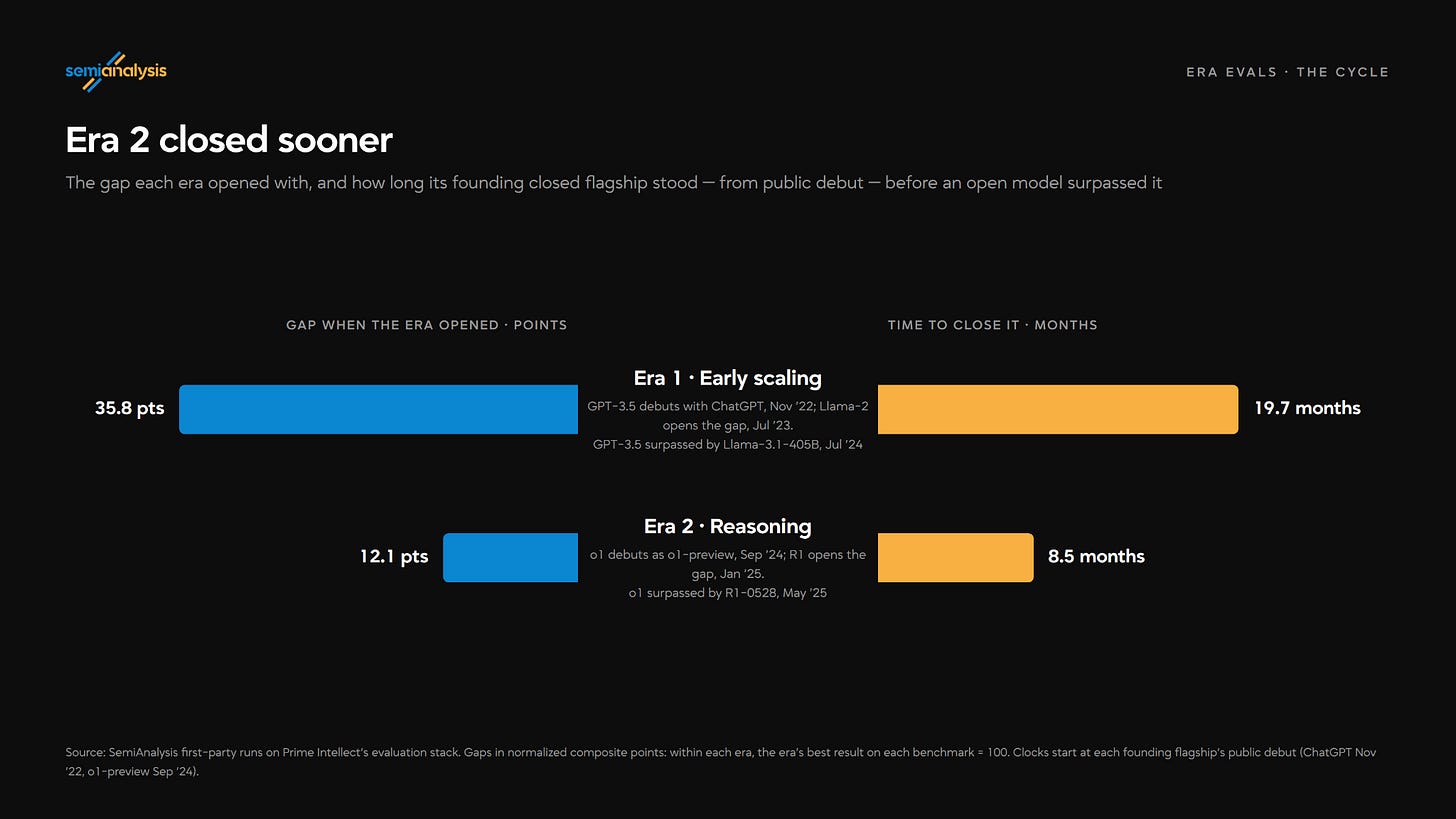
为了回答这个问题,我们选取了每个时代的所有相关模型,并运行了一套精选的基准测试,以得出综合能力评分。结果显示出一个清晰的趋势:随着每一代模型的迭代,开源模型追赶同代首个闭源模型所需的时间缩短了一半。
Source: SemiAnalysis
当然,基准测试并不能说明全部情况,我们将在下文详细说明所有相关的注意事项。最后,我们将把这一分析延伸到未来,并解释为什么前沿模型并没有你最初想象的那样悲观。
我们是如何测量的
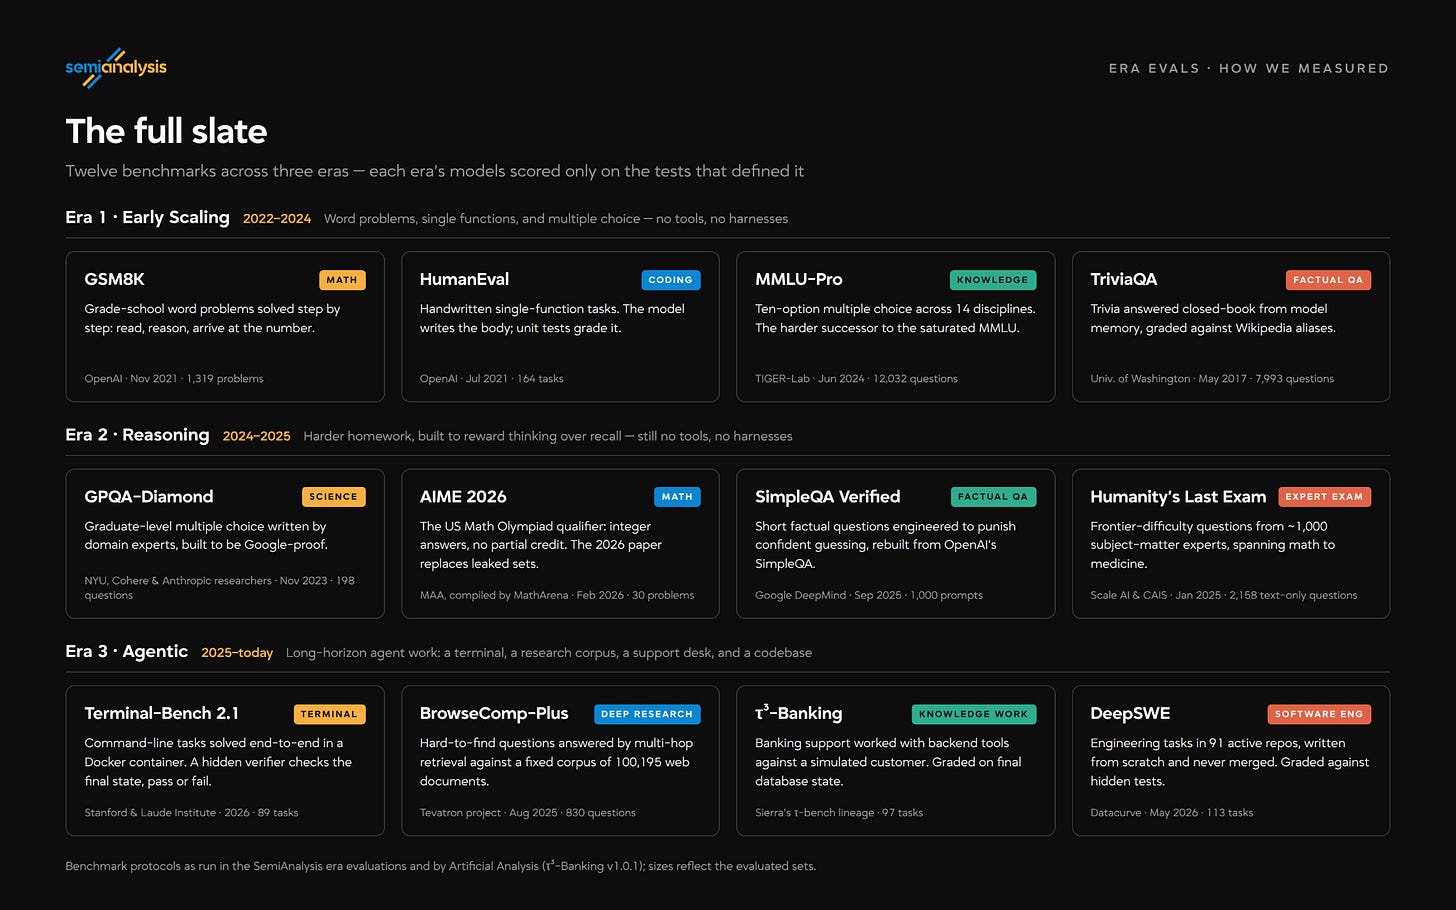
以下是我们为每个时代挑选的模型和基准测试概览:
Source: SemiAnalysis
在特定时间点挑选单一的最先进(SOTA)闭源和开源模型带有一定主观性,但我们的选择反映了 AI 专家的普遍共识。在存在争议的情况下(例如如今的 Fable 5 与 GPT 5.6 之争),我们采取保守策略,对两者均进行了测试。
在基准测试的选择上,我们综合了个人偏好和流行程度。例如,众所周知 Humanities Last Exam (HLE) 存在很多问题,但它确实是定义推理时代的关键基准测试之一,且没有相近的替代品。另一方面,SWE-bench Pro 同样流行且存在问题,但 DeepSWE 可以很好地近似它。
这里的基准测试分数大部分是我们使用 Prime Intellect 的评估框架自行运行得出的。具体来说,我们使用了他们的 environments hub 以及 Prime-RL 中包含的 evals harness。其余分数来自我们的朋友 Artificial Analysis 以及 Datacurve 的 DeepSWE 排行榜的运行结果。开源模型按照其发布时的状态提供服务:使用当时的 vLLM 版本、当时的硬件,以及模型卡中指定的采样设置。对于闭源模型,我们测试了其固定的 API 版本。当我们的数据与第三方数值出现在同一图表时,我们确保了评估规则集的一致性。
我们要特别感谢来自 Prime Intellect 的 Florian Brand (@xeophon),他帮助我们挑选了基准测试和模型,实施了评估,并验证了结果的正确性。
时代 1 | 早期扩展阶段 (2022-2024)
时间是 2023 年 6 月。整个世界正在应对 ChatGPT 带来的冲击,而 Mark Zuckerberg 刚刚同意在 Colosseum 与 Elon Musk 决斗。但当 Zuck 正在训练柔术和做 Murph 训练时,他的公司也在进行自己的“训练”。FAIR 即将挺过 Mistral 团队离职风波和其他戏剧性事件,并成功发布了 Llama-2-70B。这是第一个接近前沿水平的开源模型。
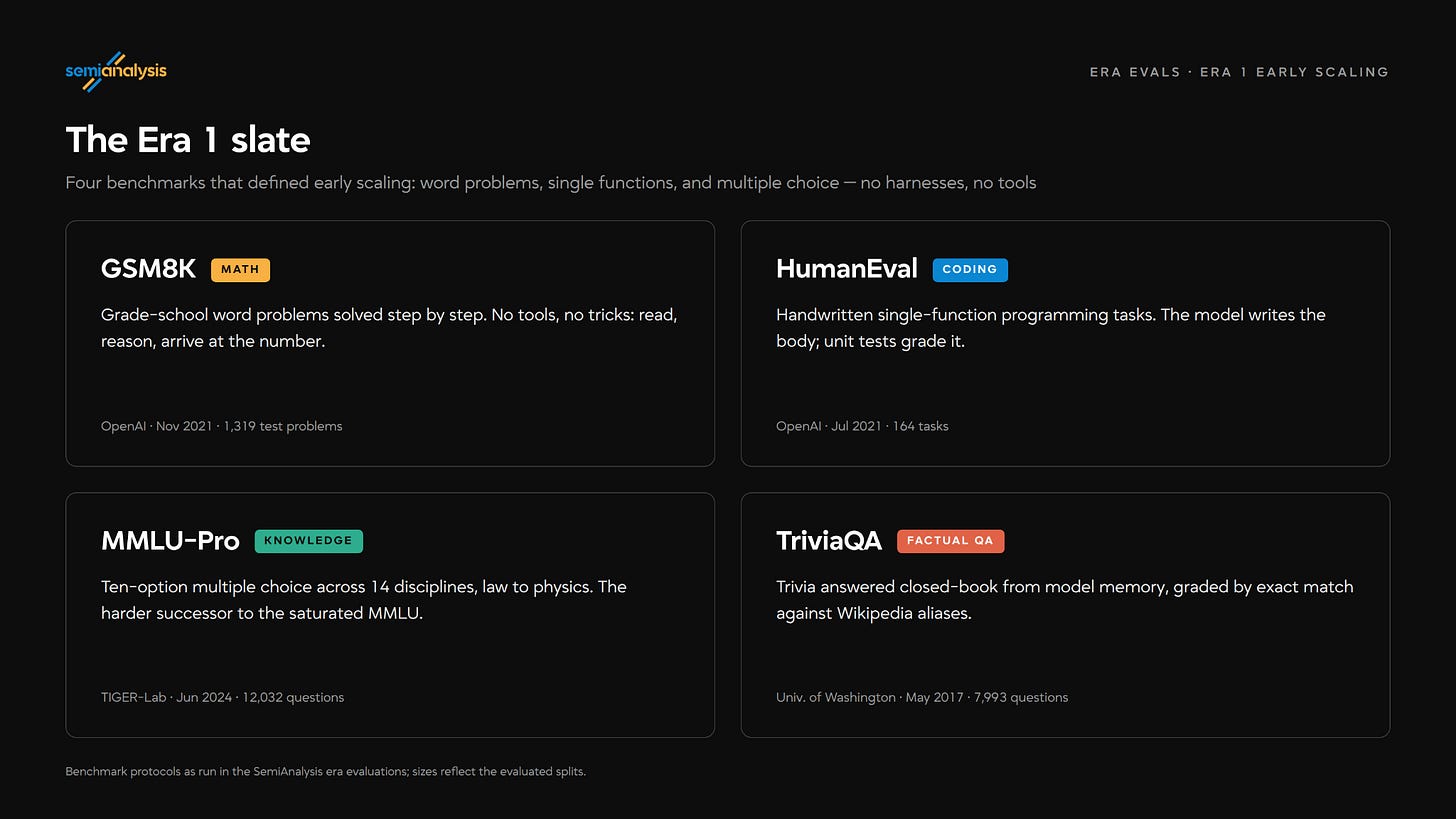
它距离前沿水平还有多远?当时有四个基准测试定义了 SOTA:GSM8K、HumanEval、TriviaQA 和 MMLU-Pro:
Source: SemiAnalysis
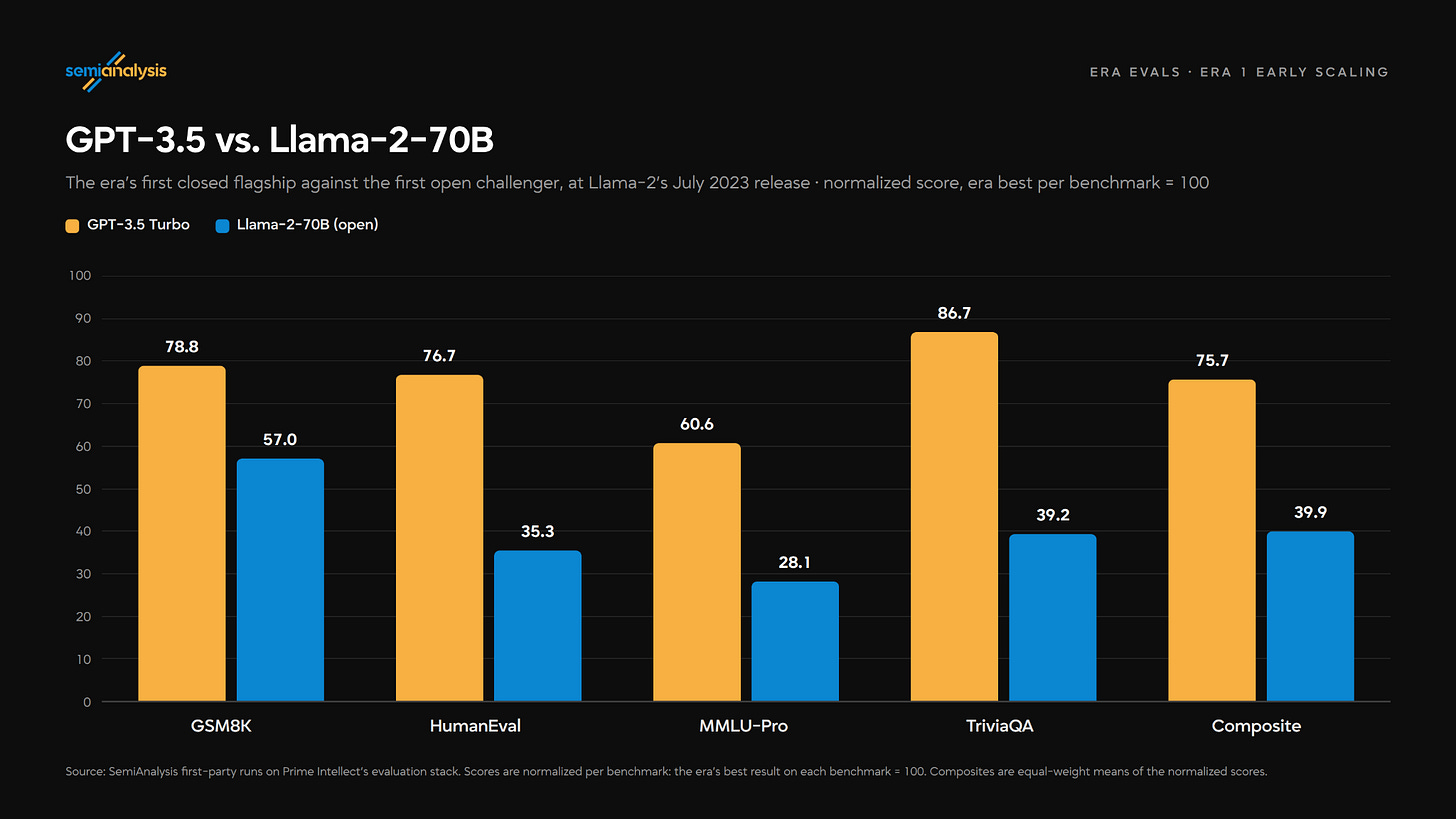
这些基准测试代表了当时前沿模型的能力水平。简单的多项选择题、应用题,以及限定于单函数的编程题。时代真是变了!以下是 Llama-2 在一场属于它们的“对决”中,与 GPT-3.5 Turbo 的较量结果:
Source: SemiAnalysis
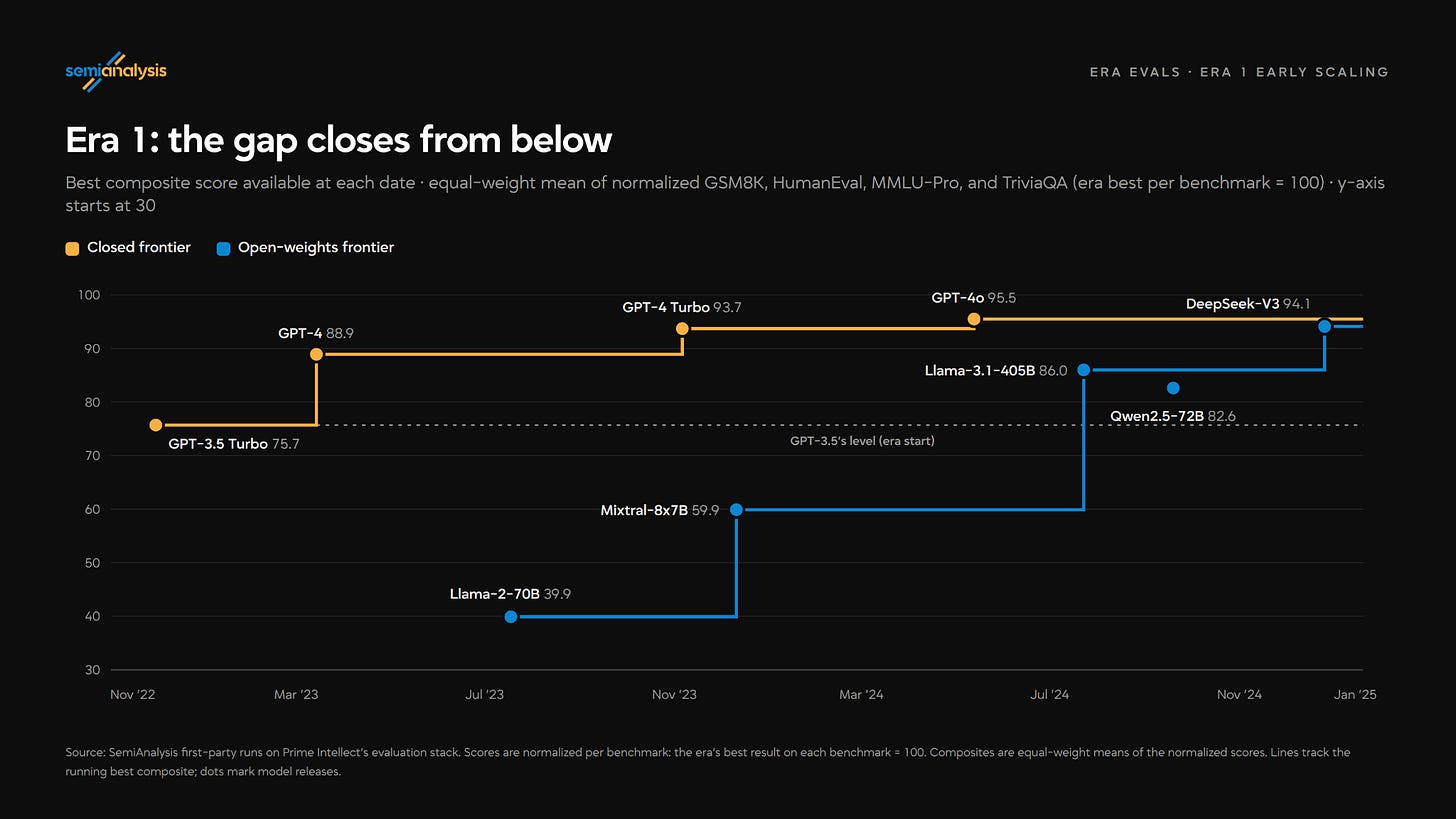
为了消除基准测试难度差异的影响,我们对分数进行了归一化处理。每个时代的最佳成绩设为 100 分,其他模型则据此进行相对评分。综合得分是四项指标的等权平均值:GPT-3.5 Turbo 在前沿水平上得到 75.7 分,而 Llama-2-70B 为 39.9 分。这是一个适度但相当明显的差距。这一初始落后局面构成了该时代后续发展的主线:2023 年 12 月发布的 Mixtral-8x7B 带动了向 GPT-4 能力的追赶势头,但随即被 GPT-4 Turbo 和 GPT-4o 再次大幅拉开差距:
Source: SemiAnalysis
直到 2024 年 7 月 Llama-3.1-405B 发布,开源模型才填补了与 GPT-3.5 Turbo 的差距,其综合得分为 86 分。2024 年 12 月,DeepSeek V3 在能力上追平了上一个前沿模型 GPT-4o,两者的得分分别为 95.5 和 94.1。Qwen2.5-72B 以 405B 六分之一的参数量,达到了足以逼近 GPT-4o 的水平,其预训练数据量为 18T 个 token。
这是差距缩小的首个实例。在整个时代中,我们没有看到前沿水平大幅超越 GPT-4 的能力,但这主要源于战略侧重点的差异:Turbo 和 4o 的目标是让 GPT-4 变得更便宜、更快速,而不是更聪明。
与此同时,OpenAI 一直在研发另一种类型的模型。过程奖励论文的发表以及聘用 Noam Brown 都指向了推理能力。到 2024 年中期,各大主要实验室都在发布测试时计算的研究成果。在 405B 发布七周后,即 2024 年 9 月 12 日,OpenAI 发布了 o1-preview,这款模型开启了一个全新的创新时代。
时代 2 | 推理时代 (2024-2025)
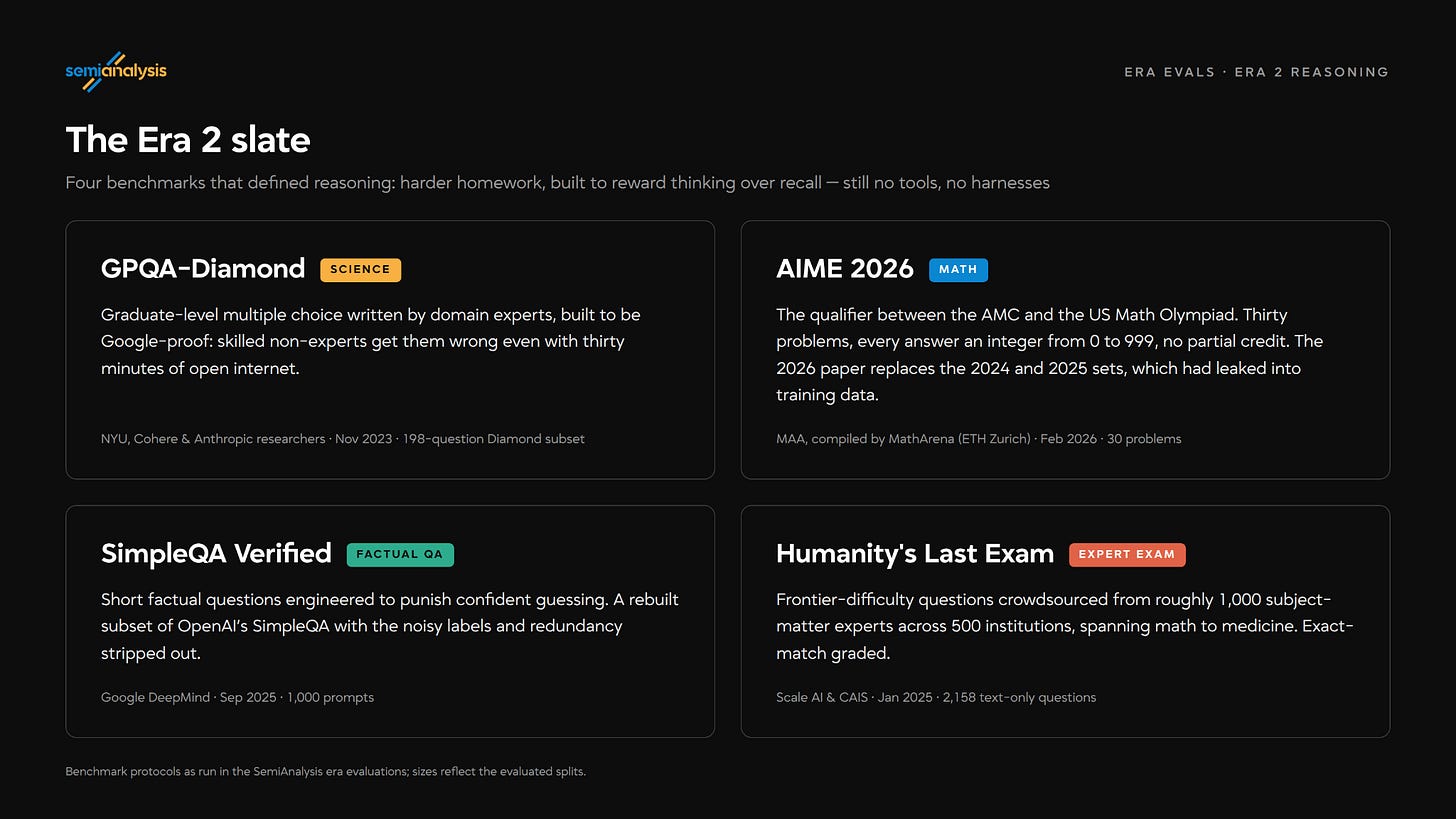
o1 的发布重新确立了基准测试的选择,也改变了差距格局。时代 1 中的基础测试已不足以衡量 o1 的全部能力。小学数学问题被 AIME 取代。Scale AI 收集了世界上一些最冷僻的博士级多项选择题,并极具挑衅性地将其命名为“人类最后的考试”。
Source: SemiAnalysis
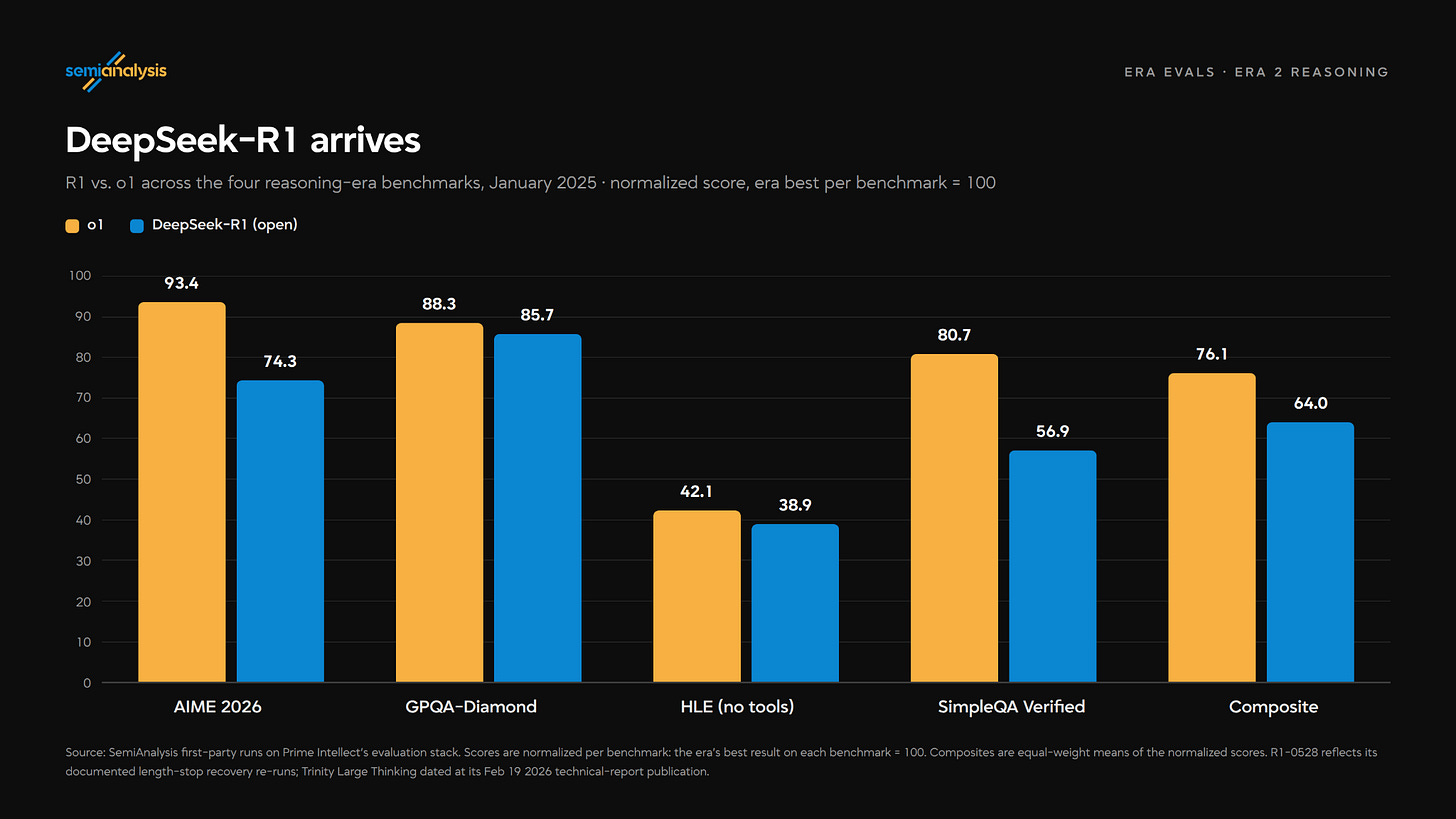
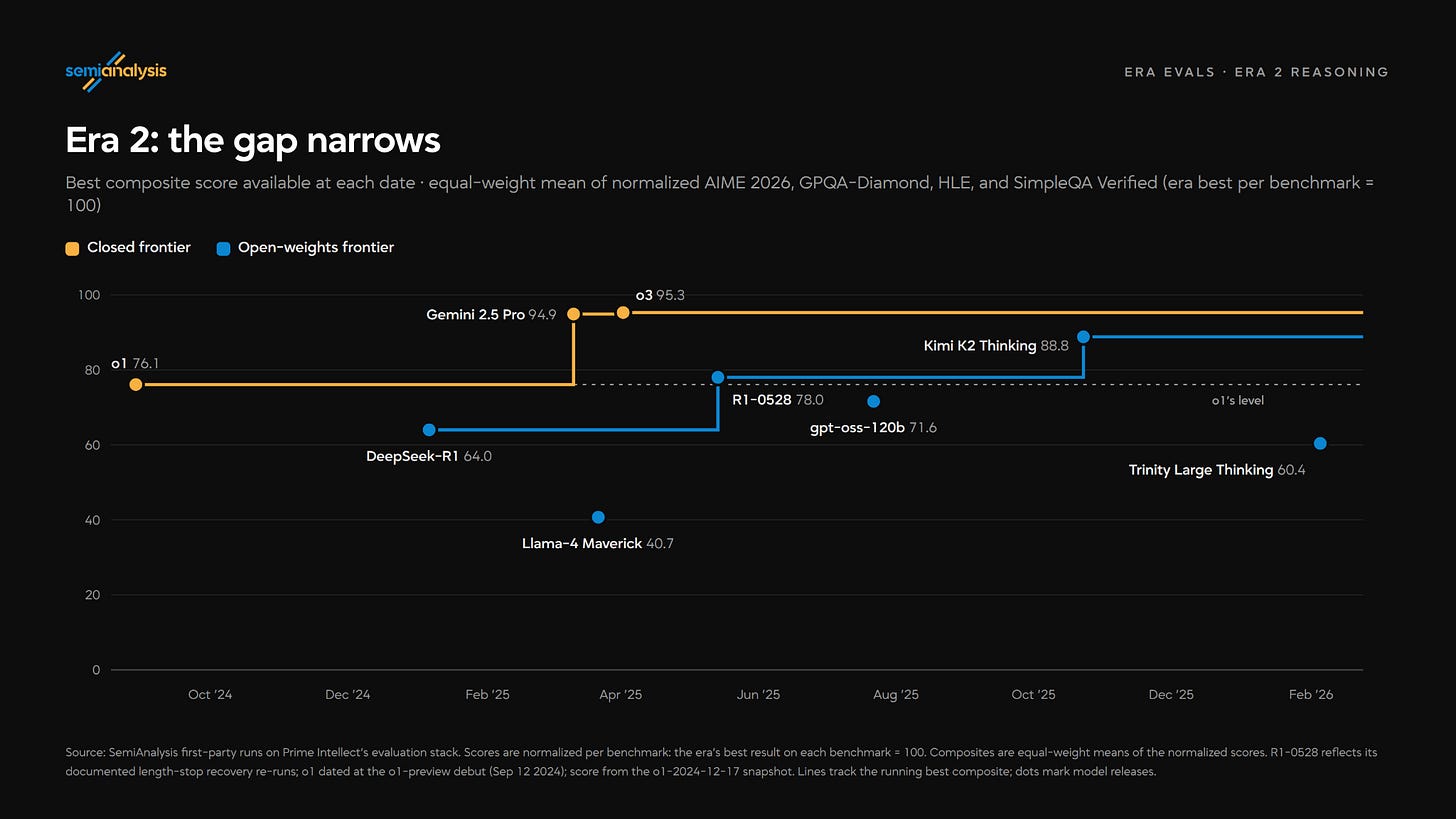
o1 的发布在科技界的重要性怎么说都不为过。许多人认为那一天是“我们确信能实现 AGI”的日子。然而,与时代 1 中 Llama-2-70B 对阵 GPT-4 的情况不同,在时代 2 初期,开源与闭源模型之间的差距要小得多。原因何在?一个名为 DeepSeek R1 的鲜为人知的模型。
Source: SemiAnalysis
这次差距仅为 12.1 分,而上一时代初期的差距为 35.8 分。市场对此做出了剧烈反应。幸运的是,AI 资本支出交易很快复苏,并且由 R1 确立的“我们重回巅峰”的开源模型势头,很快就被 Meta 的 Llama-4 Maverick 所打破。
Source: SemiAnalysis
Gemini 2.5 Pro 和 o3 继续推进推理能力的前沿,而 R1-0528 检查点在 2025 年 5 月以 78 分的得分缩小了初始差距。历时 8.5 个月抹平了 12.1 分的鸿沟:
Source: SemiAnalysis
值得注意的是,Anthropic 在目前的图表中缺席了。与其他公司一样,他们的模型卡片也报告了这些基准测试结果。但在这一时期,他们从未争夺过榜首位置。当 OpenAI 和 Google 轮流坐庄时,Anthropic 正在将 Claude 打造为默认的编程智能体。这为下一个时代定下了基调:如今真正重要的基准测试是在终端中运行的。
第三阶段 | 智能体时代(2025 - 至今)
在 Claude Code 之前,智能体也曾有过高光时刻(例如 Cognition 在 2024 年 3 月发布的 Devin 病毒式传播演示)。但 Anthropic 是首家成功打造“模型+运行框架”产品的公司,这也让他们获益匪浅。自 2025 年 5 月 Claude Code 全面发布以来,Anthropic 的 ARR 增加了超过 650 亿美元。如需深入了解 Anthropic 和 OpenAI 的 ARR 预测,请参阅我们的 Tokenomics 模型。
随着智能体的出现,又诞生了一套新的基准测试。复杂的数学题不再是检验模型能力的最佳方式。相反,人们更想知道模型编写代码、进行网络搜索以及像人类一样使用计算机的能力如何。
Source: SemiAnalysis
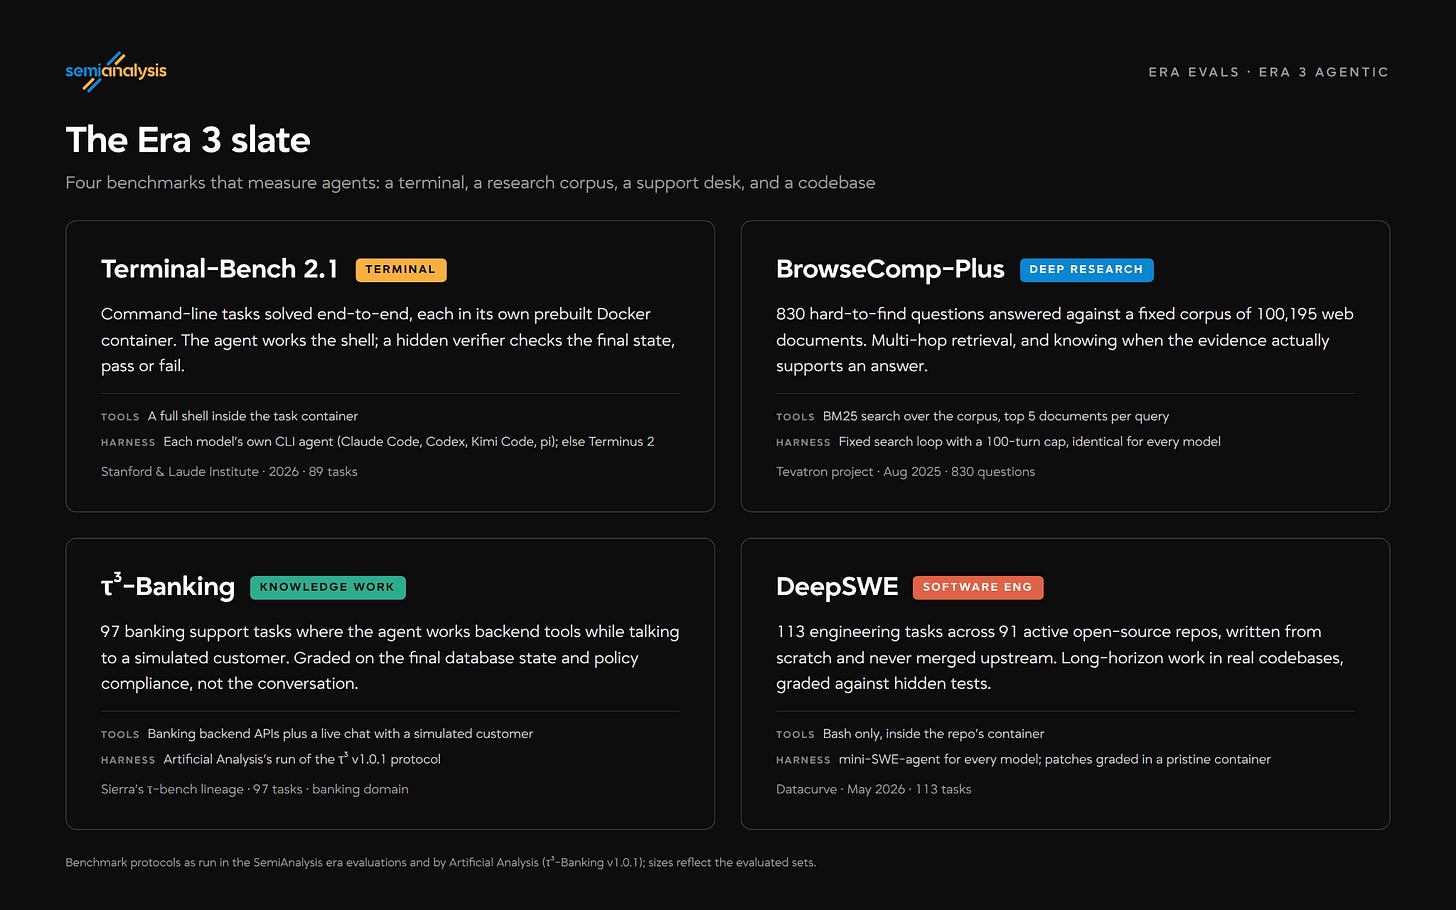
Terminal-Bench 2.1、BrowseComp-Plus、𝜏³-banking 和 DeepSWE 涵盖了当今智能体所承担的长期任务:软件工程、深度研究和知识型工作。我们还特意挑选了设计上更新颖的基准测试,以限制模型对数据的死记硬背。
Source: SemiAnalysis
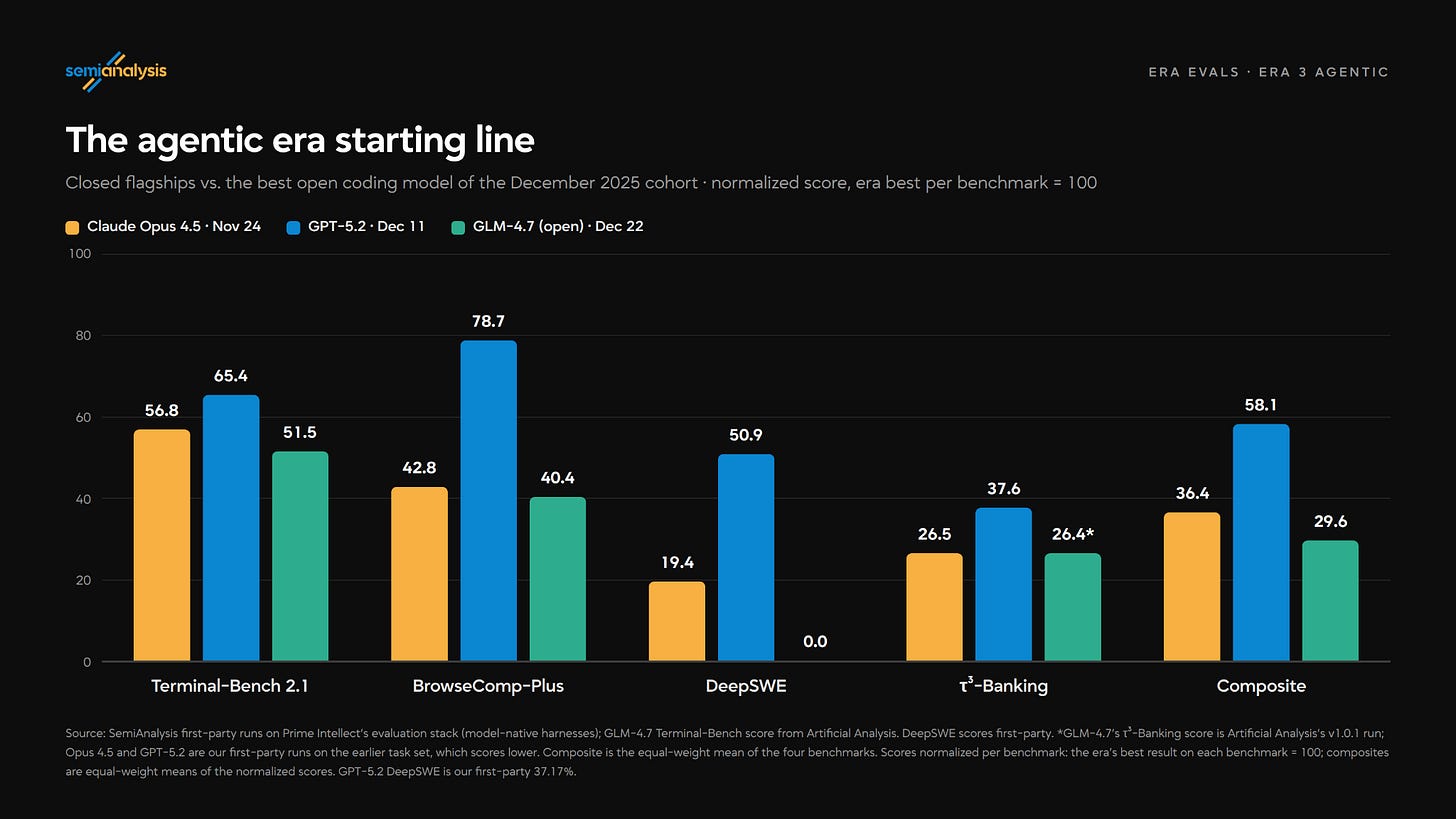
得益于模型的可靠性,大多数 AI 专家将 Opus 4.5 视为智能体时代的正式起点。有趣的是,GPT-5.2(当时的 OpenAI 旗舰模型)在我们的基准测试套件中表现更好,但这并未转化为更好的用户体验。如今真正重要的是完整的智能体产品(模型+运行框架)。而 Anthropic 一直专注迭代,致力于打造一个擅长通用智能体任务的运行框架。相比之下,Codex 显得比较粗糙。与此同时,OpenAI 还在分心 pursue 网页浏览器等支线任务。
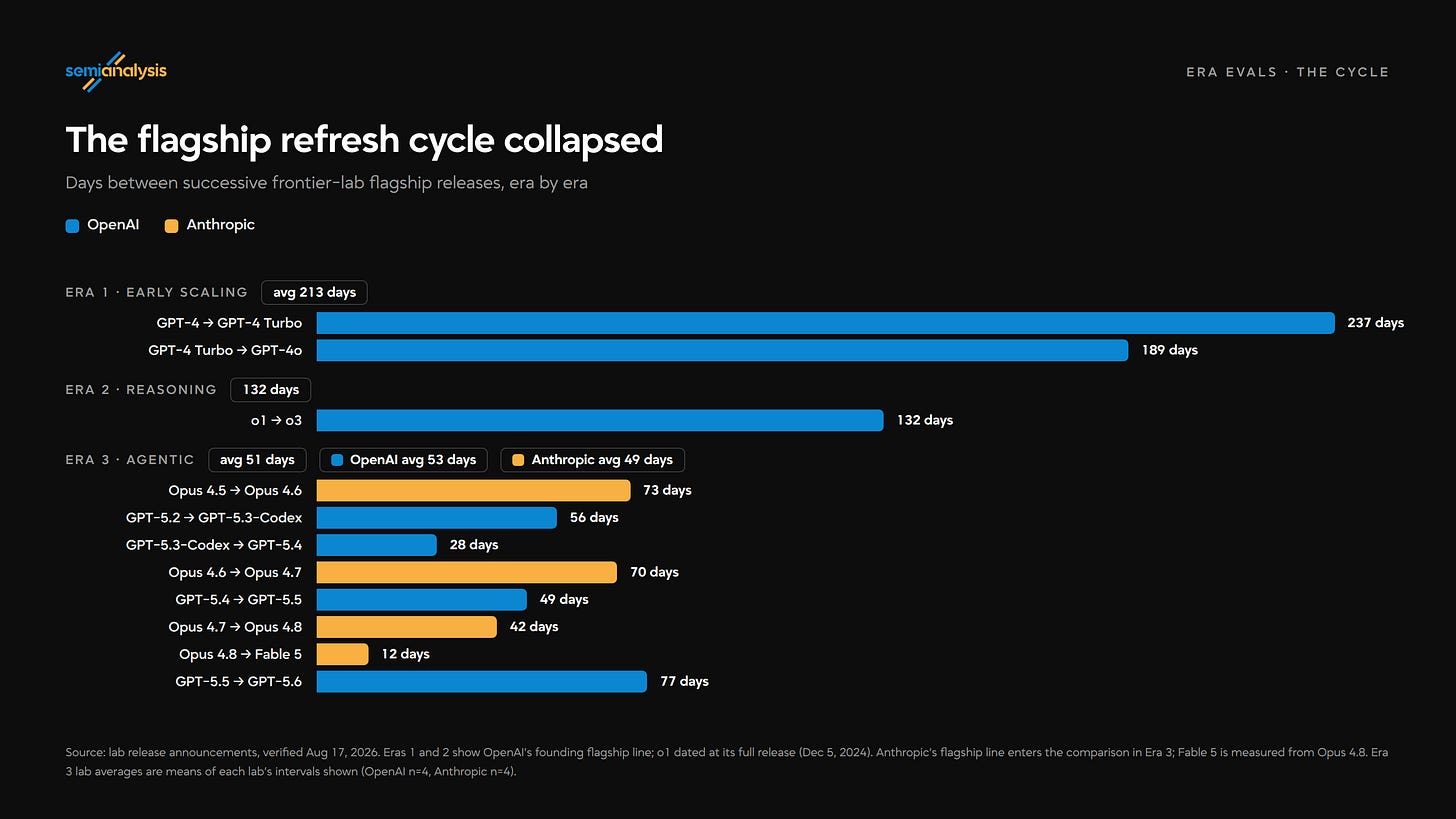
两家前沿实验室之间的模型发布周期也缩短了。在整个第三阶段,OpenAI 和 Anthropic 平均每 51 天就发布一个新模型,从而确立了双寡头格局。相比之下,第一阶段和第二阶段的平均发布周期分别为 213 天和 120 天,如今的发布速度有了大幅提升。
Source: SemiAnalysis
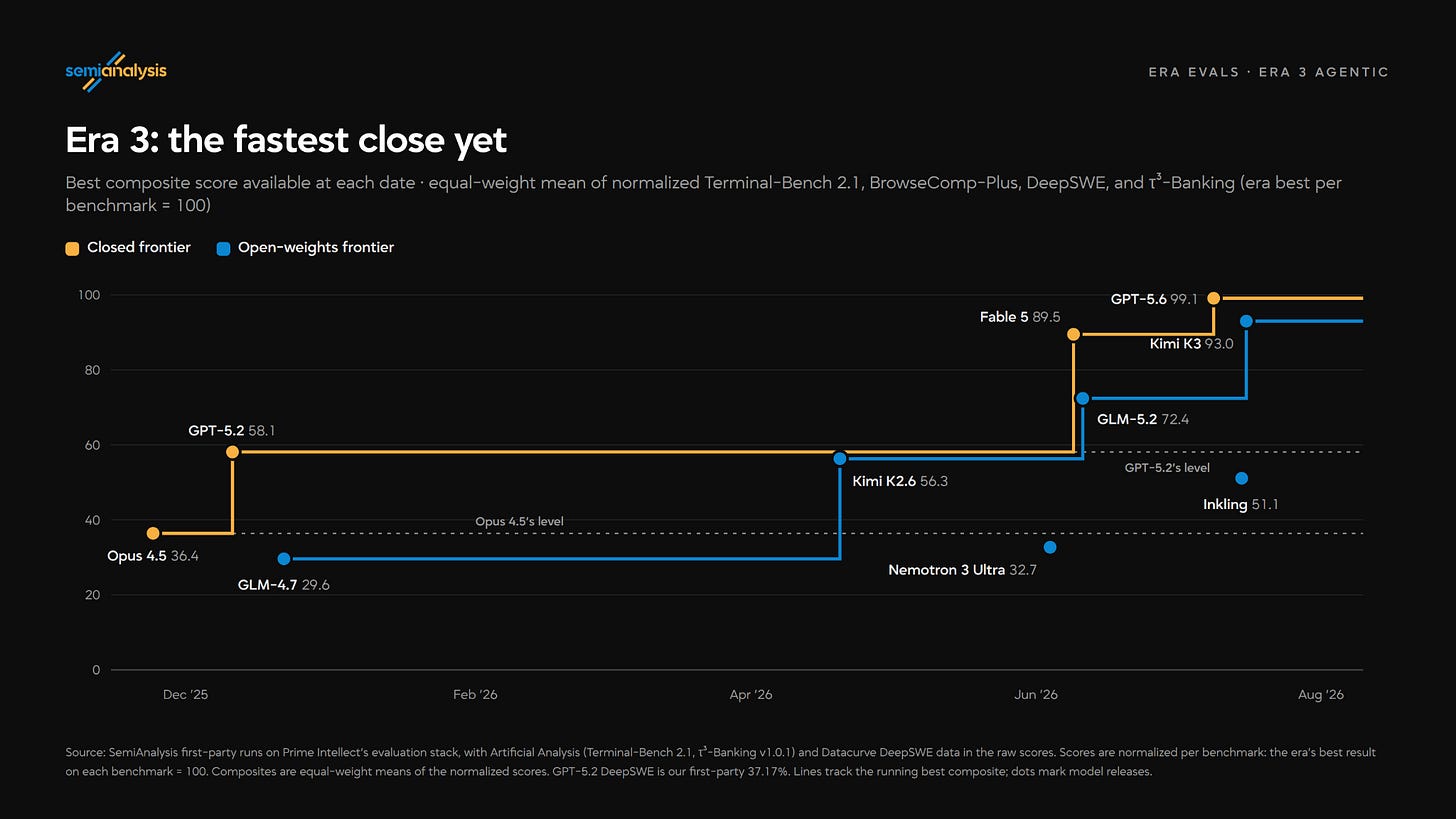
然而,尽管前沿模型创造的经济价值呈现爆炸式增长,但在第三阶段,这种差距的缩小速度却比以往任何一个阶段都要快。Kimi K2.6 仅用 4.8 个月便以 56.3 的得分超越了 Opus 4.5;GLM-5.2 用时 6 个月,便以 72.4 的得分超越了 GPT-5.2。差距缩小时间在每个后续时代减半的趋势,保持着惊人的一致性。
Source: SemiAnalysis
展望未来
那么,这一切对闭源与开源模型的未来意味着什么?
首先,我们要承认,基准测试并非评判一切的终极标准。在我们精心挑选的综合基准测试中,Kimi K3 的得分可能高于 Fable 5,但在 SemiAnalysis 的日常工作中,我们依然更倾向于使用 Fable。这部分是因为 Anthropic 在产品化方面做得更好,他们通过 Claude Code 和 Claude Tag 等工具将模型更好地整合进了实际应用中。但更重要的原因是,基准测试并不能完美代表真实的工作场景。公共基准测试尤其如此,模型开发商只需创建大量与基准任务高度相似的强化学习环境,就能轻松在排行榜上刷分。
其次,你可能会认为 Era 3 的收尾时间被人为缩短了,因为与 Moonshot 和 Zhipu 相比,Anthropic 和 OpenAI 在安全测试上投入了更多时间。但这并不是什么新现象。以 GPT-4 为例,它在发布前 218 天就完成了训练。即使我们假设 Mythos 在 2 月中旬才完成训练,距离 Fable 发布也仅隔了 114 天。
即将到来的时代