← 全部文章
Cerebras's Next Generation CS-4: Fast Just Got Faster
2026-08-19 · 原文
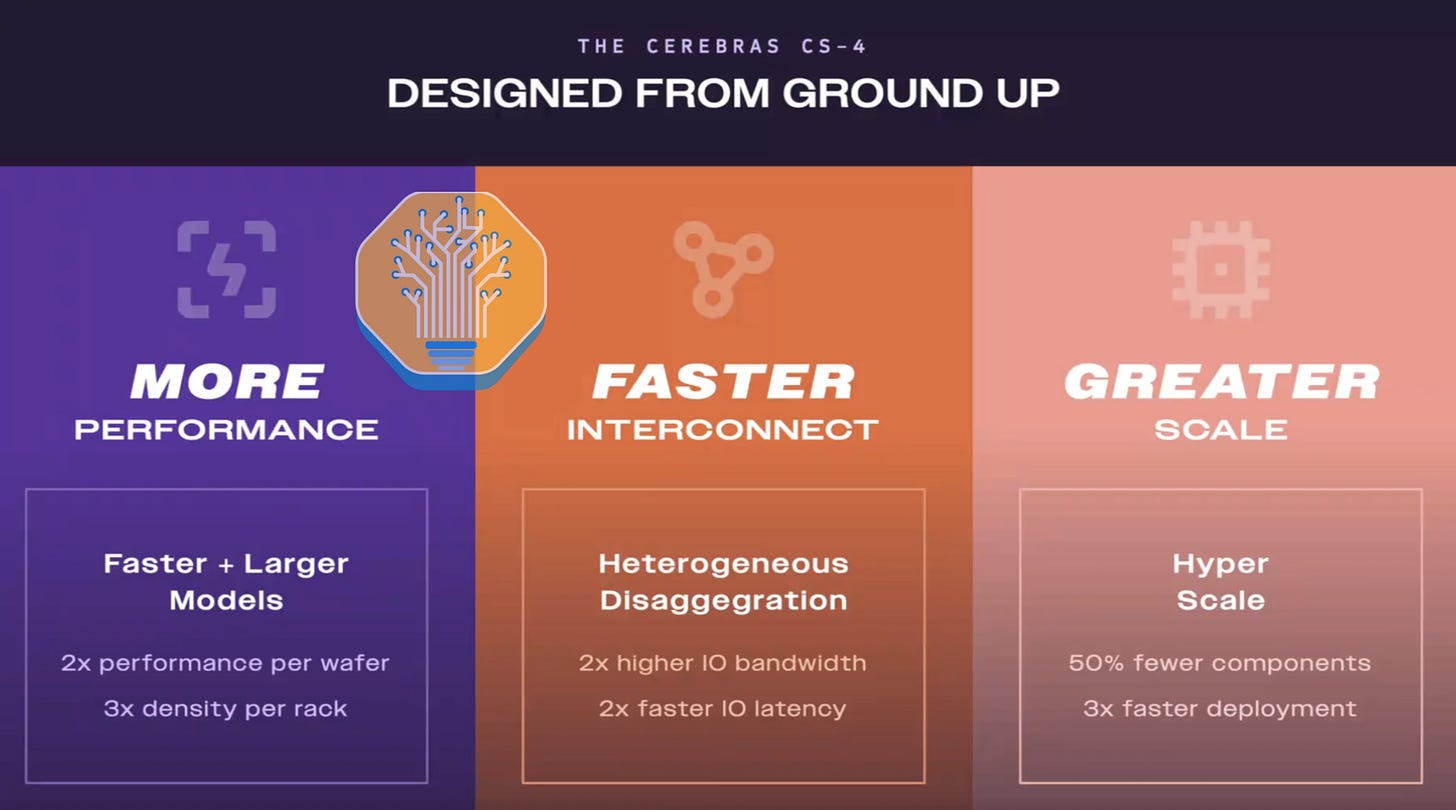
Cerebras 本周发布了 CS-4,更多细节将在 Hot Chips 会议上公布。CS-4 是他们的第四代机架,依然基于相同的第三代 5nm 晶圆级引擎:WSE-3。通过增加每个晶圆的功耗和时钟频率,以及提升机架级密度,CS-4 的性能达到了 CS-3 的两倍。
所有这些意味着 CS-4 能够将每个晶圆每秒每用户生成的 token 数量提升至 CS-3 的两倍,且成本与上一代大致相当。客户可以用同样的硬件支出获得双倍的 token 收益,这无疑是一个明智的选择。不仅 token 生成速度变得更快,上市时间也同样缩短了。机架架构本身经过了重新设计,变得更加模块化,从而改善了可制造性并缩短了部署时间。最后同样重要的是,全新的 I/O 模块将支持未来构建开放、异构且解耦的推理架构。这种解耦的推理设置将大有裨益,通过与基于 HBM 的系统配合使用,有助于克服 CS-4 的内存容量限制。
Source: SemiAnalysis
同款晶圆,双倍时钟频率
Source: SemiAnalysis
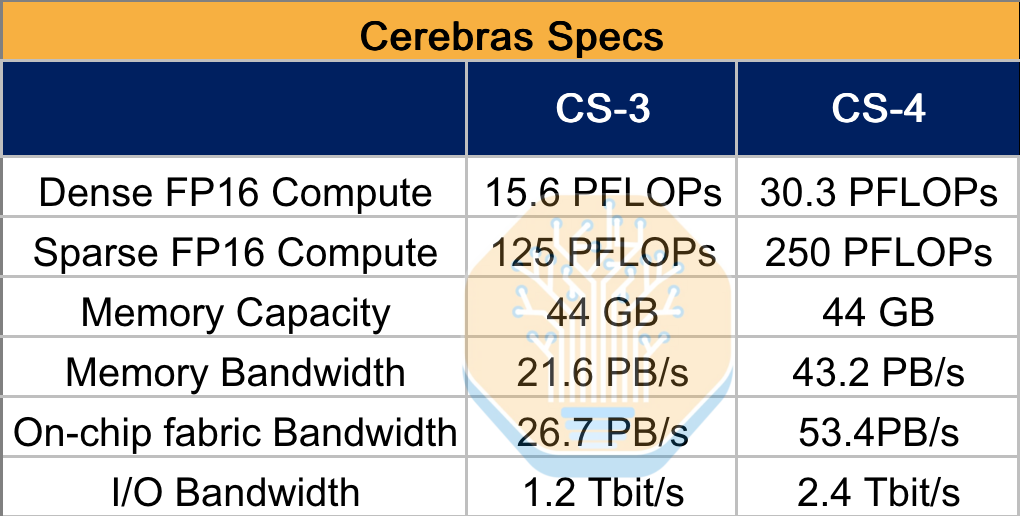
CS-4 采用了与 CS-3 相同的 5nm WSE-3,但 Cerebras 通过将时钟频率翻倍,使其性能提升了一倍。这得益于向晶圆输入大幅增加的功率,并由 CS-4 在供电和散热技术上的改进所支持。虽然继续使用相同的 5nm 制程听起来缺乏惊喜,但 Cerebras 依然能将最关键的指标——内存带宽——翻倍。内存带宽的翻倍应该能转化为每秒每用户 token 数量的近乎翻倍(在其他条件不变的情况下),这正是客户对 Cerebras 的期望。时钟频率翻倍也带来了两倍的理论峰值 FLOPs 以及 WSE 的片外并行 I/O,使 CS-4 的片外 I/O 从 CS-3 的 1.2Tb/s 升级到了 2.4Tb/s。然而保持不变的是每个晶圆 44GB 的 SRAM 容量,因为这是由每个晶圆上可用的 SRAM 单元数量决定的。因此,我们必须等到下一代芯片才能看到这方面的提升。这是沿用 WSE-3 的主要缺点,因为每个晶圆较低的内存容量是 Cerebras 架构固有的关键权衡之一。
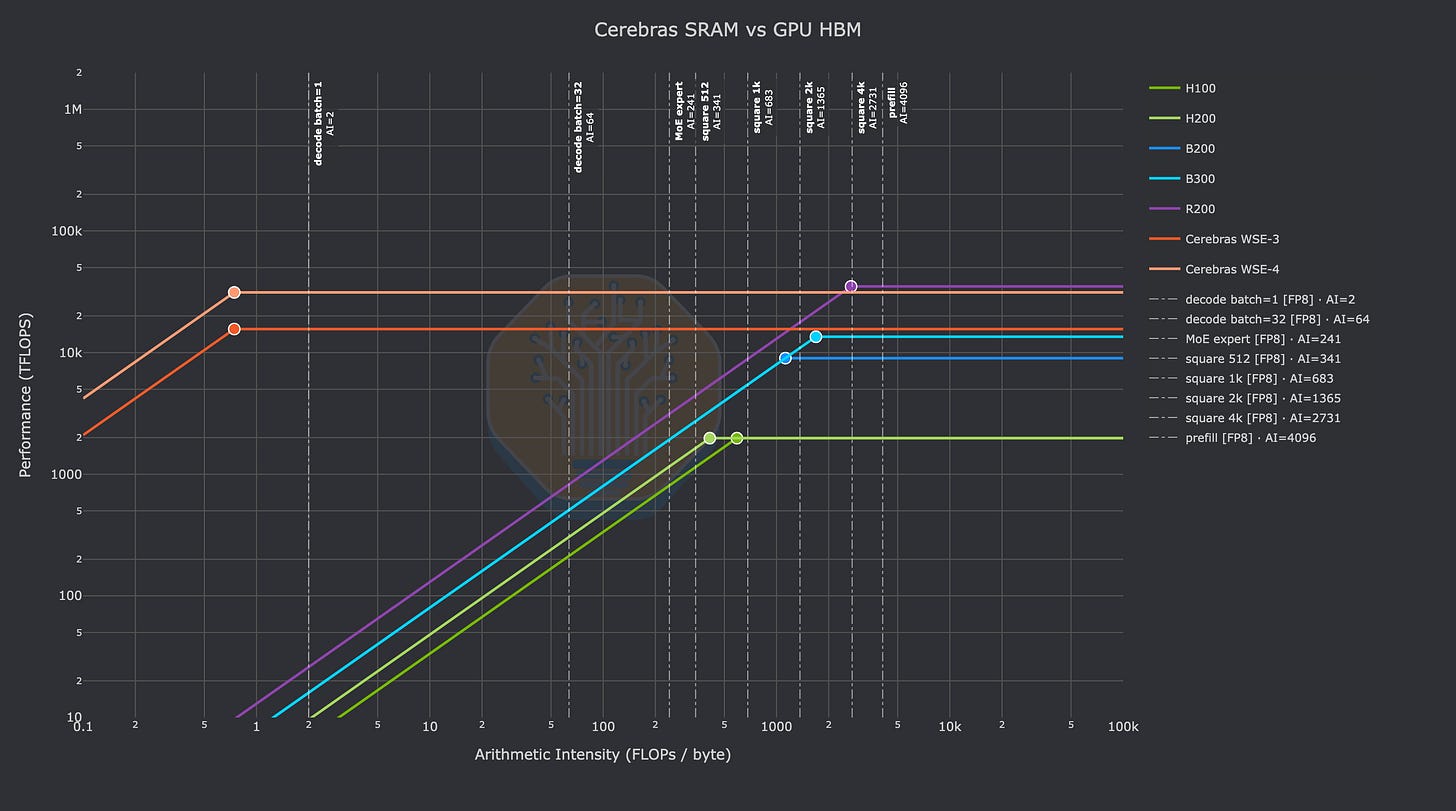
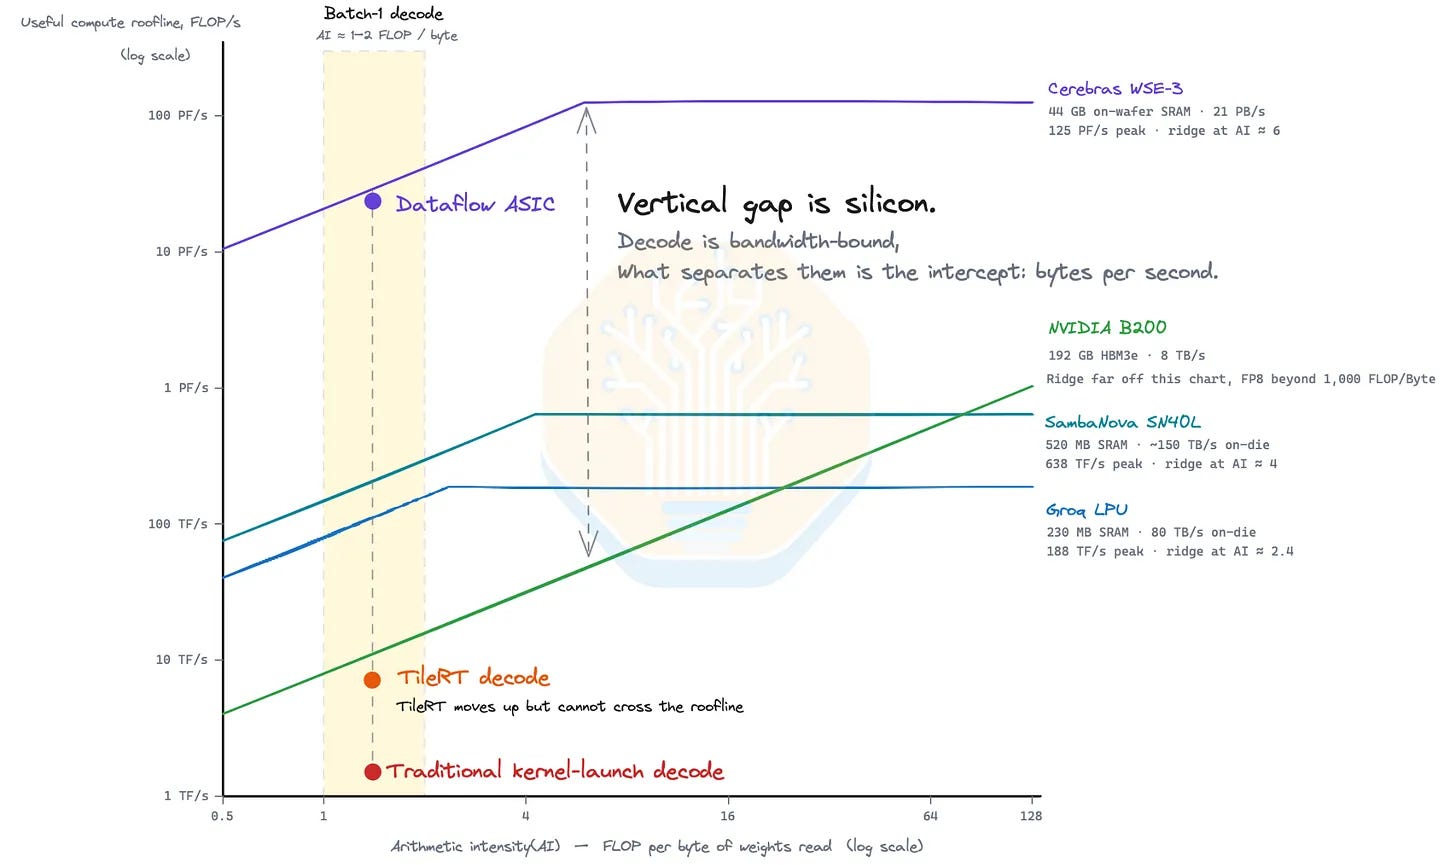
正如我们在之前关于 Cerebras 的文章中所描述的,该晶圆采用了极其独特的架构。这种架构由于使用了 SRAM,非常适合运行算术强度较低的内核,例如小批次解码。
Source: SemiAnalysis
网络改进
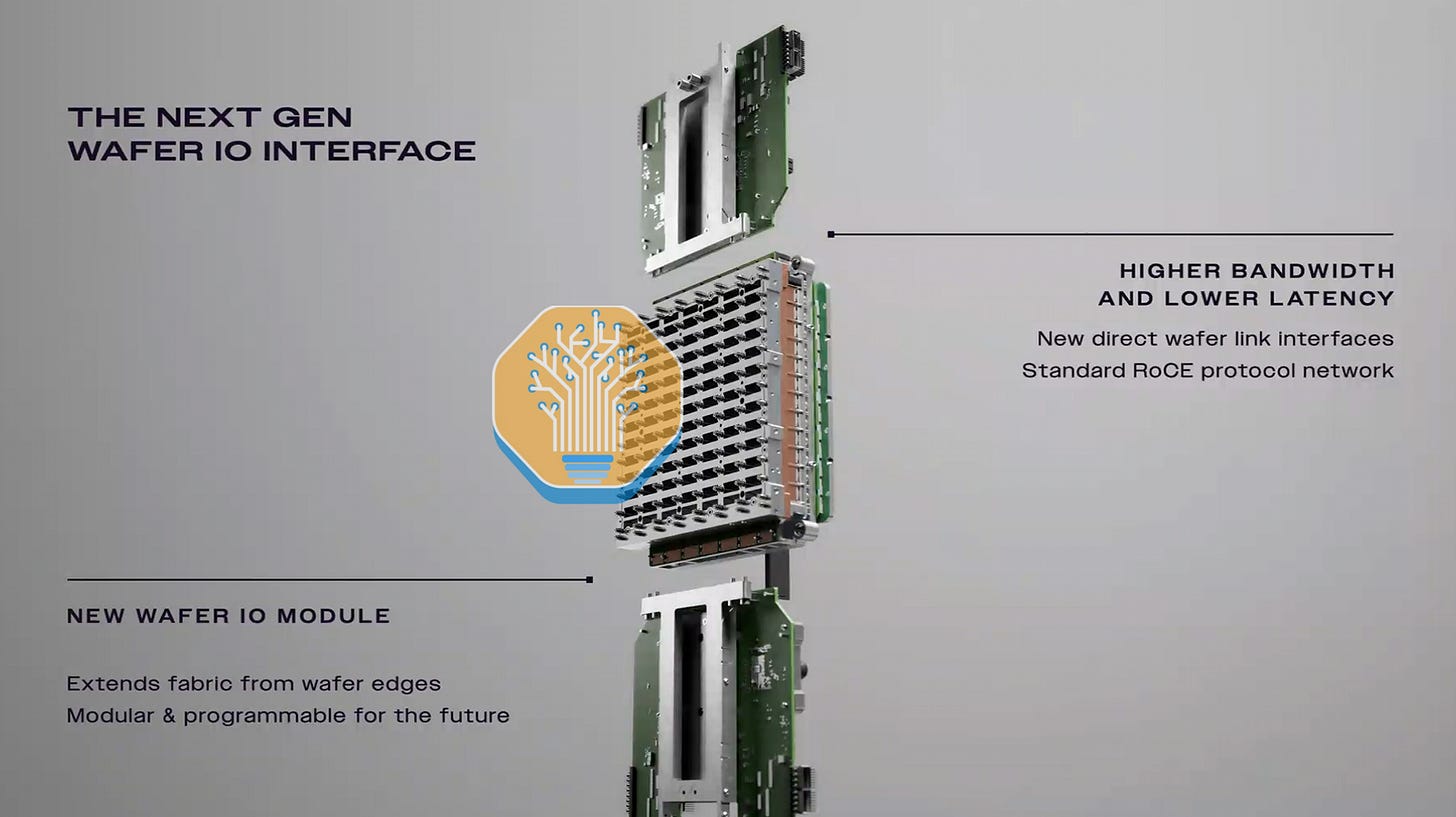
除了片外 I/O 带宽翻倍之外,全新的晶圆 I/O 接口也带来了进一步的片外通信改进。这是一种升级版的 FPGA 卡,用作 NIC 将 Cerebras 的专有 I/O 转换为标准以太网。从下图可以看出,晶圆的南北两侧各有 2 个 I/O 模块。
Source: Cerebras
这个 I/O 模块支持现场升级。因此,Cerebras 可以在不重新设计机箱的情况下升级到新的网络标准。这看似是个小改动,但影响深远。它使 CS-4 更容易与其他系统对接,从而构建解耦的推理集群。将 CS-4 与基于 HBM 的 XPU 配对,组成解耦的注意力与前馈网络架构,是克服 CS-4 内存容量不足的一种方法。这与 Nvidia 定位 Groq LPU 的策略如出一辙。我们将在下文详细探讨。这似乎是专为 AWS 设计的。AWS 希望在 CS-4 上使用自家的 EFA 网卡,以便与 Trainium 服务器对接,实现解耦推理。
此外,通过全新的低延迟数据包处理流水线,两层胖树网络的延迟从 CS-3 的 5 微秒降至 3 微秒。该网络采用 Arista 以太网交换机。现在,晶圆之间还可以直接互联,无需经过交换网络。这进一步将延迟降至 2 微秒。直连晶圆路径也支持配置。这意味着 FPGA 具备交换能力,可以灵活调度数据流经不同的晶圆。
这确实是一项改进。但考虑到许多 Cerebras 的竞争对手如今宣称其交换机的总延迟已达到纳秒级,“超高速”网络只是一个相对概念。我们认为这是一次中规中矩的升级。我们相信,3 微秒的延迟和带宽限制依然是瓶颈。这阻碍了 EP 和 ETP 等并行方案的实现。在这些方案中,专家层需要跨越多个晶圆。从路由器到专家层的 Token 分发与合并对延迟非常敏感。专家负载不均衡问题加上额外的网络跳数,使得流水线并行成为唯一可行的解决方案。
背包式机架
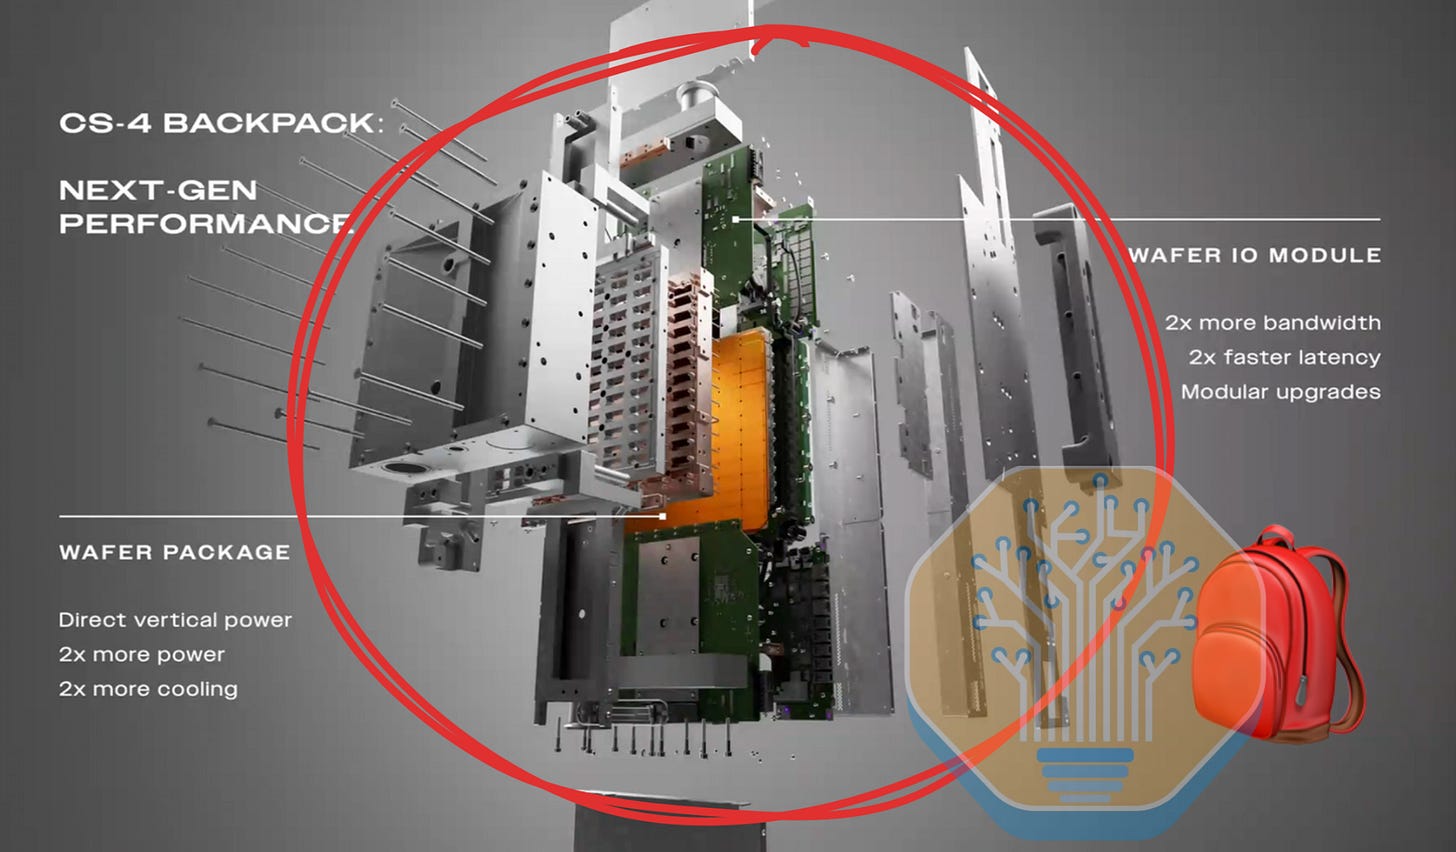
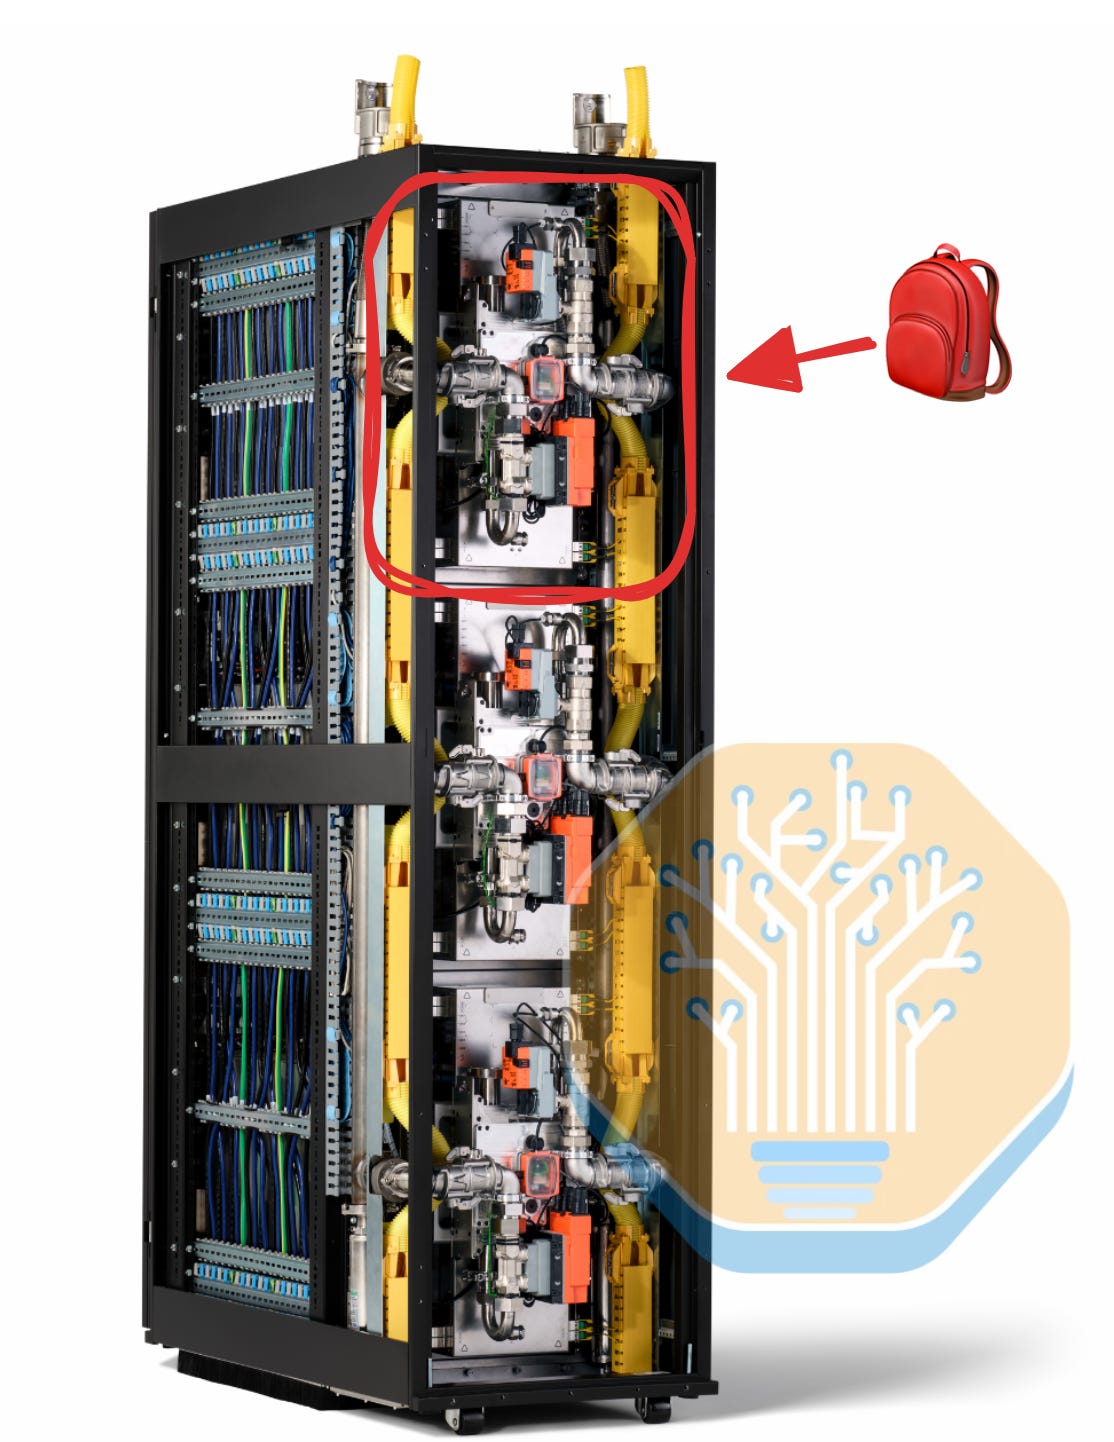
在系统层面,CS-4 最显著的变化体现在物理结构上。Cerebras 将机箱一分为二:前半部分专用于供电,后半部分专用于计算。这些模块被封装成可插拔的“背包”式组件。每个“背包”容纳一块晶圆级引擎。一个 CS-4 机架可容纳三个这样的组件,而 CS-3 每个机架仅能容纳两块晶圆。泵和热交换器等散热基础设施也移出了机架。如今的数据中心已经具备支持全液冷机架的能力。
Source: Cerebras
这种“背包”是一个垂直的机箱。其内部独立划分为供电、散热、I/O 和 WSE-3 四个模块。这使得整个系统的制造难度大大降低,比 CS-3 更具优势。WSE-3 晶圆垂直放置,供电侧朝向机架前方。供电模块将通过晶圆正面供电,这与 CS-3 的设计一致。晶圆的散热则从背面进行。I/O 模块连接在晶圆的上下边缘。它们与晶圆共同构成了一个矩形平面。
背包式设计使部署过程更加顺畅。客户可以事先将电源模块安装到机架上,然后在现场只需将晶圆背包直接插接到机架上即可。由于升级后每个机架包含三个晶圆引擎,且运行频率更高,单个 CS-4 机架的 TDP 达到了 125-135kW。这大约是单个 CS-3 的 23kW 功耗的两倍。总体而言,这意味着 CS-4 的每瓦性能至多比 CS-3 略有改善。
Source: Cerebras
代际之间的最大改进应该是成本。虽然更多的散热和功率需求会增加 BOM 成本,但 CS-4 组件数量的减少和组装的简化应该能大幅抵消这些成本项。我们认为每个晶圆的实际 BOM 可能最终与 CS-3 相当。对客户来说,这意味着在相近的 TCO 下,能获得近两倍的交互能力和 token 收入,这是一个非常有吸引力的方案。
Cerebras 关于 CS-4 最引以为傲的数据是 43 PB/s 的总片上内存带宽,公司将其宣传为比 Nvidia 的 Rubin 高出约 2,000 倍的内存带宽。这个数字将成为此次发布大多数报道的焦点,因为晶圆上 SRAM 带宽会随功率增加而提升。
结果是,尽管内存带宽高出 2,000 倍,Cerebras 声称与 GPU 相比,交互能力的提升更为合理,最高可达 30 倍,并将其定位为全新的“超快”性能层级。我们相信 CS-4 在前沿模型上将接近 4,000 tok/sec/user,而 CS-3 为 2,000 tok/sec/user。与此同时,我们预计 Blackwell GPU 的理论上限将继续维持在 200 tok/sec/user(实际上没人会这样运行),在合理的并发量下更为现实的数据是 100 tok/sec/user。在我们看来,这相当于 20-40 倍的交互能力提升,那么为什么不说“最高”快 40 倍呢?这似乎相当合理。
并行策略
由于 WSE 的晶圆上没有足够的 SRAM 来容纳整个模型的权重,Cerebras 在此系统中继续将重点放在流水线并行推理上。在 CS-4 上,给定模型的每个 MoE 专家都会交错部署在单个晶圆上。默认的流水线并行与 GPU 不同,后者通常采用张量并行和专家并行来将大模型塞进可用的 HBM 中。Cerebras 一直坚持认为,使用 GPU 的 HBM 存储权重比在单个晶圆上完成所有操作更慢、更耗电且更昂贵。
当然,在性能、功耗和成本方面比较 WSE 集群与 GPU 集群时,结果实际上取决于你选择的并行策略。GPU 拥有非常广泛的配置选项(从高吞吐/低交互配置到高交互/低吞吐配置),而晶圆的配置范围则相对有限。此处仅考虑高交互/低吞吐的情况。
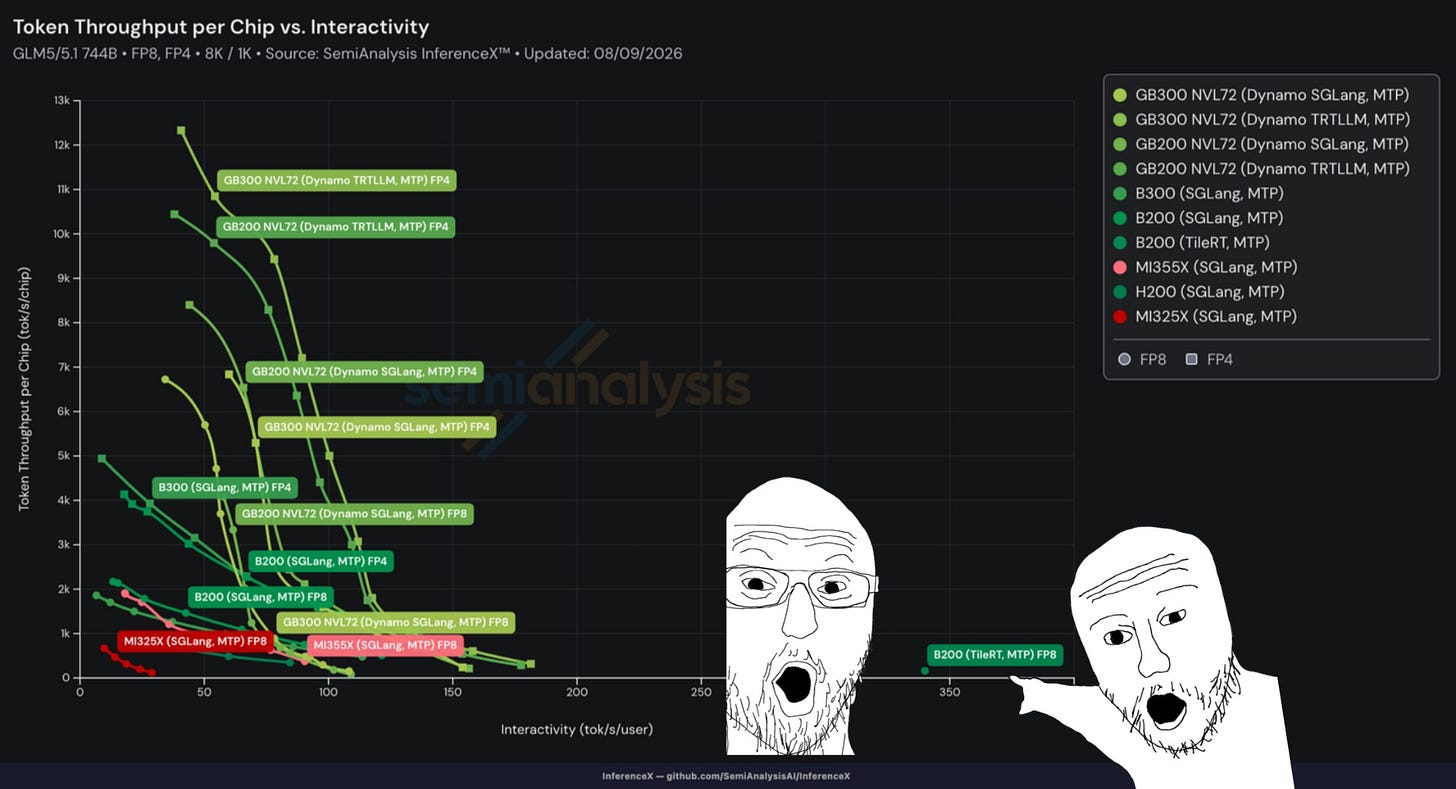
为了将 WSE 与 GPU 进行直接比较,我们对 NVIDIA 发布的 TileRT 特别感兴趣。TileRT 为 GPU 集群带来了高吞吐量、低交互性的配置。我们在上周的 TileRT 文章中对此进行了部分讨论。
Source: InferenceX
Premium-priced “fast modes” are proving that users will pay more for lower latency and faster tokens, potentially yielding higher gross margins. Frontier AI labs such as OpenAI are therefore evaluating purpose-built inference systems, including Cerebras and NVIDIA Groq LPUs
由于晶圆本身具有 44GB 的容量,Cerebras 目前还不需要在多个晶圆之间拆分 MoE 模型中的单个专家,即使是对于他们目前运行的 GPT 5.6 Sol 等前沿模型也是如此。然而,由于长上下文推理的需求,我们预计 OpenAI 等 Cerebras 客户会尝试节省在晶圆上保存长上下文任务 KV Cache 的成本,并在 256k 上下文窗口下运行 5.6 Sol,而不是完整的 1M 上下文。
正如我们在 Cerebras IPO 文章中所述,支持长上下文推理的成本是巨大的。大多数人仍然明白,从模型中获得一次前向传递所需的内存量,与模型的总参数量成正比。然而,保存 KV Cache 所需的内存量,会随着并发用户数量以及这些用户请求的平均/最大规模(由模型的上下文窗口决定)成比例增长,这似乎仍然是一个鲜为人知的秘密。以大上下文窗口运行模型,并支持大量并发用户,需要巨大的内存容量。
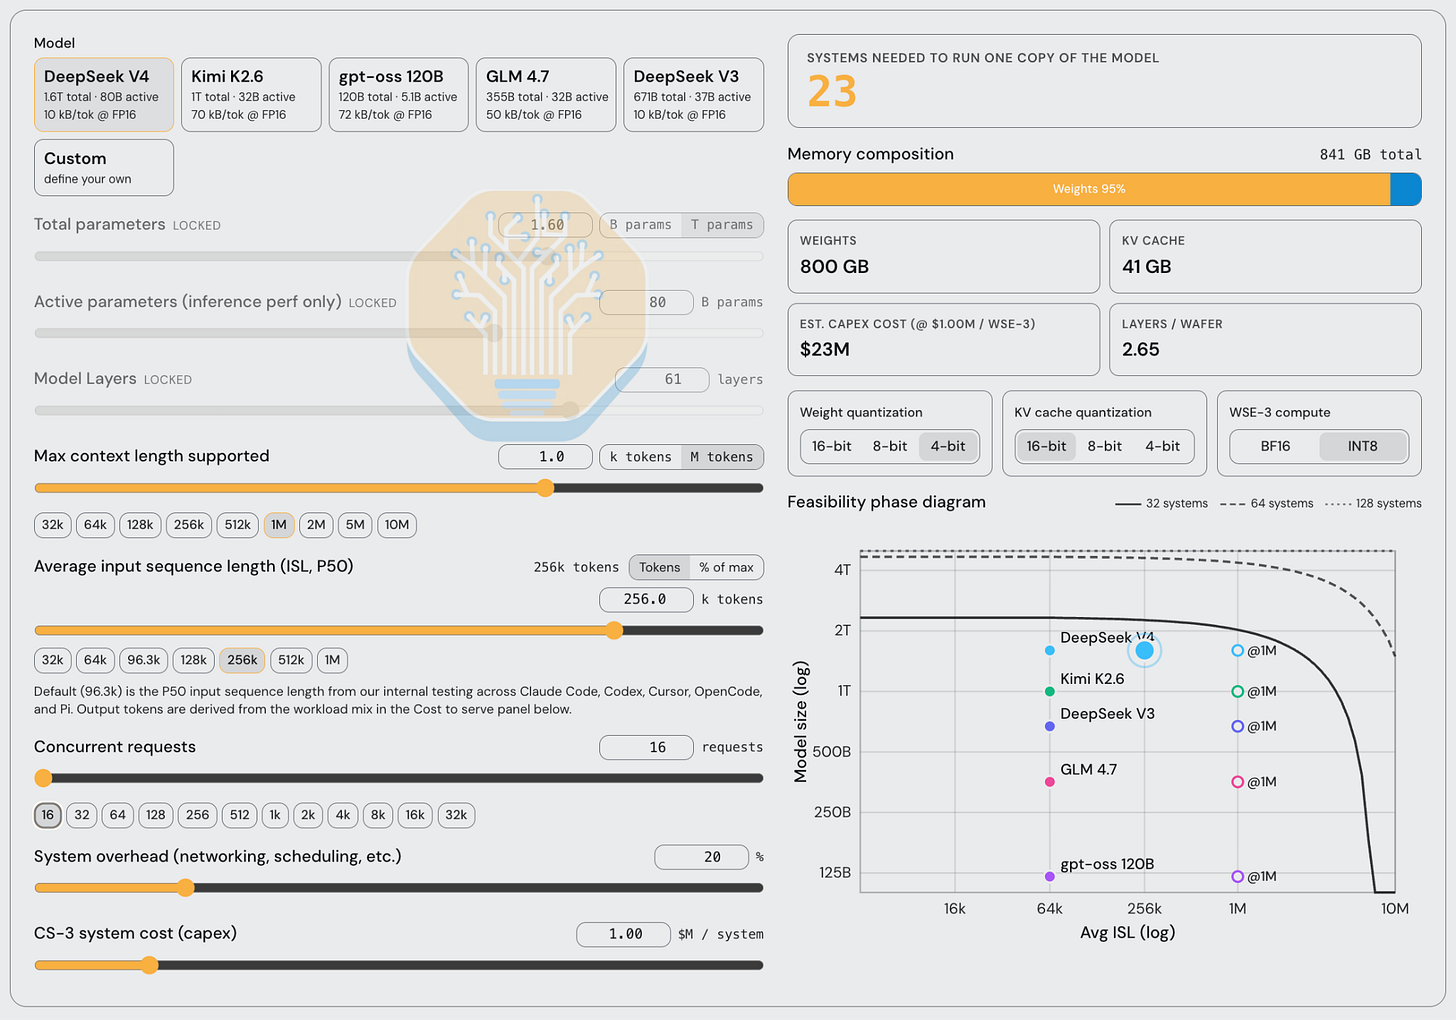
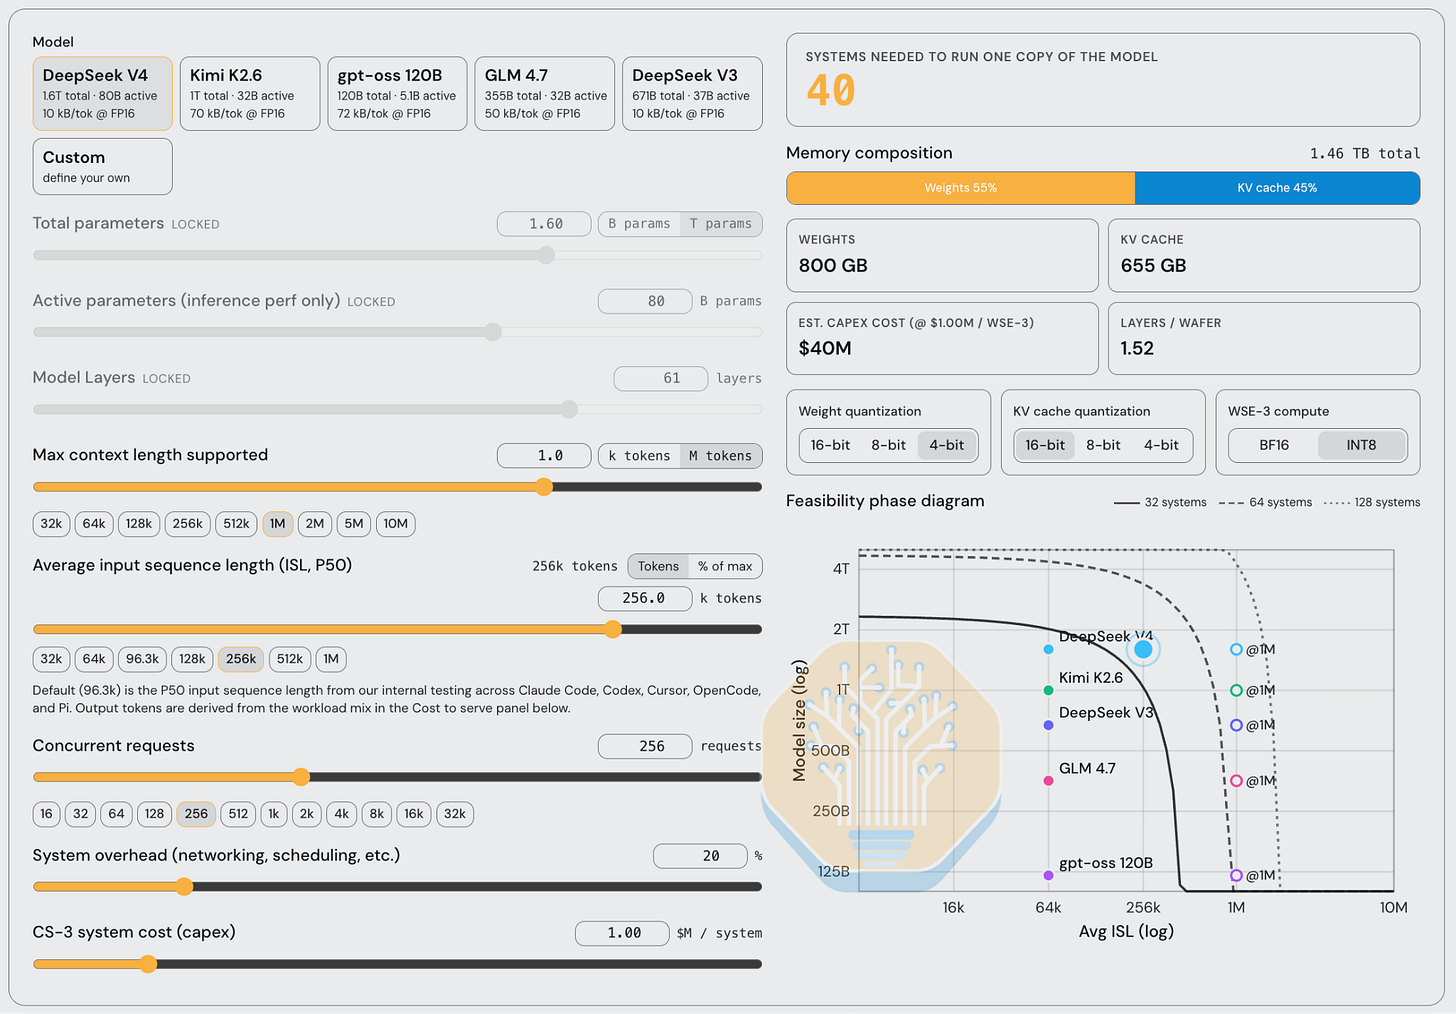
当我们对运行大模型(例如 1.6T 参数的 DeepSeek V4 Pro)所需的条件进行简单分析时,我们发现,要在 1M 上下文下运行该模型,所需的 Cerebras WSE 最少约为 20 个系统;而在 256 个并发请求的合理并发度下,则大约需要 40 个系统。这意味着超过 2000 万美元的 CAPEX 和 1MW 的功耗,而这仅仅是在前沿模型上进行一次前向传递之前的基础投入。
此分析可在我们公开的 tokenomics 网站上查阅:
Source: https://www.tokenomics.info/cerebras
当然,在这笔前期投入之后,随之而来的是相当惊人的总体性能指标。让我们深入分析一下。
押注分离架构
Cerebras 将 CS-4 定位为从底层起就专为开放式、异构、分离式推理而构建的系统。他们目前正与 AMD 和 AWS Trainium 合作,但后续还会有更多合作伙伴。在所有这些配置中,Cerebras 都将充当解码芯片,因为其屋顶线模型并非计算密集型预填充的最优选择。该公司信奉所有的分离式设置,并声称除了传统的预填充-解码分离(PDD)之外,还支持注意力前馈分离(AFD)。
Source: SemiAnalysis
试图在 GPU 上复制数据流执行的软件方案,可以逼近 HBM 带宽上限,但在带宽方面依然无法与纯 SRAM 架构相媲美。然而,所有异构分离式部署都是一把双刃剑。因为当你签署硬件采购订单(PO)的那一天,集群中 Prefill 与 Decode 的资源比例就固定下来了。与此同时,GPU 或 TPU 集群却可以根据用户负载特征随时间的演变,动态调整为不同的资源配比。而在现实世界中,负载确实会随时间变化。我们见证了推理模型随着思考时间变长,导致 Decode 成本上升;随后智能体缓存命中又拉低了 Prefill 成本,而 Decode 成本维持不变。对于这些寿命通常超过 5 年的系统而言,指望用一种 P:D 比例通吃所有场景,很难做到始终最优。
为了更好地理解这些动态变化,以及基础设施团队在设计高性能推理集群时的思考过程,请阅读我们的 TileRT 文章。
路线图:Nexus 与 CS-5
Cerebras 已经完成了下一代晶圆级引擎的协同设计,并同步推出了全新的机架级平台“Nexus”。这意味着 CS-4 机架底盘很可能会延续到未来的芯片世代,无需进行重大的机械结构重新设计。该公司公布的路线图承诺,每年的性能提升约 2 倍,并设定了到 2027 年实现 20 倍吞吐量提升的具体目标。
在可靠性方面,Cerebras 正在着力解决在现场更换晶圆托盘的操作难题,并持续在错误恢复、托盘级冗余,以及芯片内核和通道的良率收集方面加大投入。