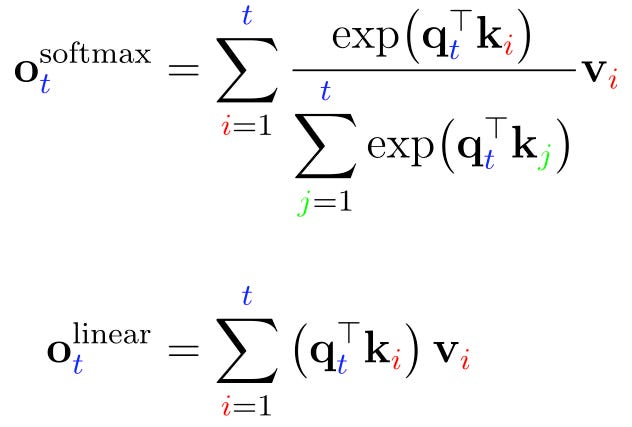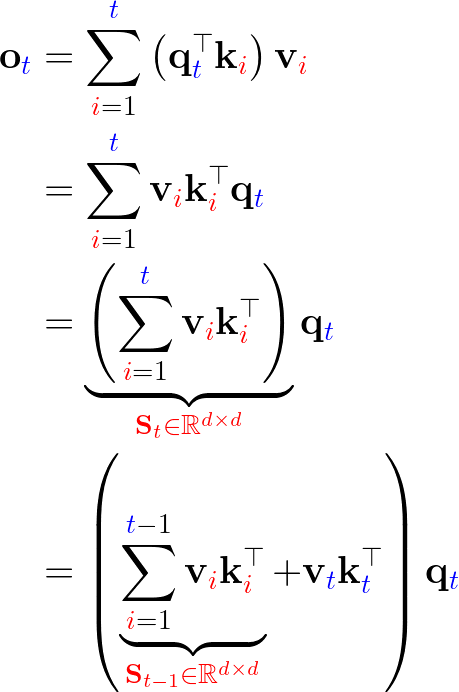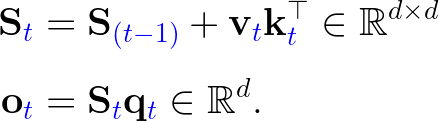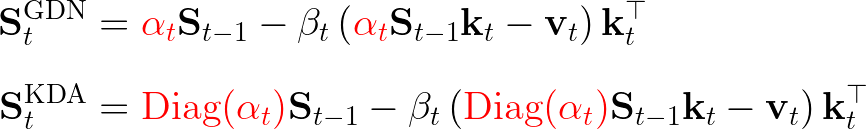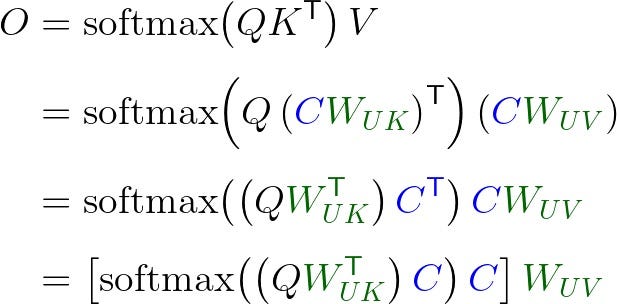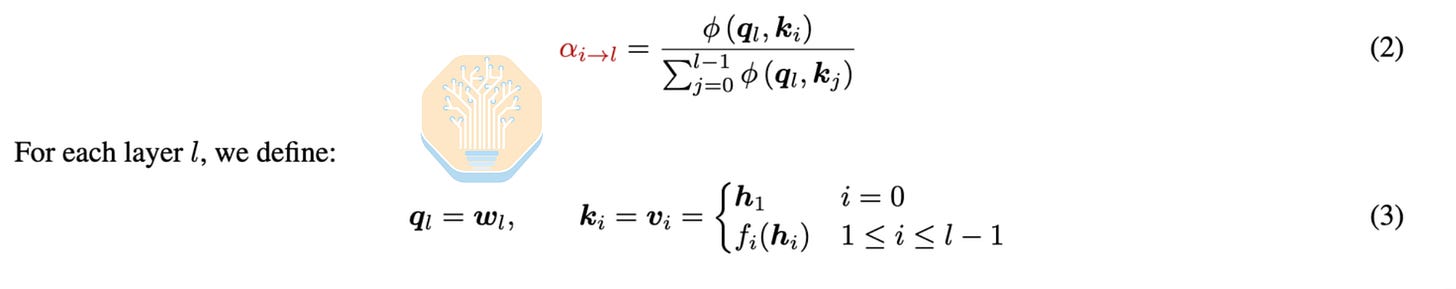← 全部文章
Kimi K3: The Manos, The Mythos, The Legendos
2026-08-03 · 原文
Kimi K3 在发布时席卷全球,横扫各大排行榜,确立了其作为开放前沿模型的地位。虽然社区渴望了解 Kimi K3 的工作原理,但许多人对驱动其性能的非传统技术感到惊讶。本文将作为入门指南,帮助大家理解 Kimi K3 模型架构的核心技术。
Kimi Delta Attention
Kimi Delta Attention(KDA)是 Kimi K3 混合注意力机制中的线性注意力层。我们将追溯 KDA 的起源,从线性注意力、DeltaNet、Gated DeltaNet(GDN),一直介绍到 KDA。
线性注意力
线性注意力的推导源于去除标准 softmax 注意力中的 softmax 操作。下面我们对比迭代推理公式,这些公式展示了在 token 位置 t 处输出向量的计算过程:
Source: DeltaNet Explained (Part I)
通过移除 softmax 操作,我们可以重新排列运算顺序,将注意力的计算复杂度从二次降为线性:
Source: Linear Attention and Beyond (Interactive Tutorial with Songlin Yang)
新的方程如下:
Source: Linear Attention and Beyond (Interactive Tutorial with Songlin Yang)
向量 q、k、v 的维度为 L 乘以 d。两个方程的计算复杂度均为 O(Ld²),从而实现了线性计算。将新方程与 softmax 注意力的方程进行对比,我们可以发现,softmax 注意力需要访问所有过去的键向量和值向量。而线性注意力则将所有过去的键向量和值向量压缩到一个隐藏状态 S 中。
我们可以将新方程重新解释为一个在线学习目标。将矩阵 S 视为存储键向量 k 和值向量 v 之间关联的联想记忆,通过将 S 与 k 相乘来检索 v。接着,我们可以将第一个方程理解为在每个位置持续更新矩阵 S,以完善检索过程。最后,我们可以将 vt @ kt.T 项解释为损失函数 -(S @ kt.T) @ vt 对 S 的梯度。
DeltaNet
从在线学习目标的角度来看,矩阵 S 的值会无限制地增长。随着序列变长,新旧信息在 S 中会变得模糊交织,从而导致学习不稳定。由于缺乏 softmax 对输出进行良好的缩放和约束,线性注意力在长程召回任务上通常落后于 softmax 注意力。
DeltaNet 通过更改损失函数来改进线性注意力,将其设为最小化值检索的 L2 范数。与线性注意力的损失函数不同,DeltaNet 的损失函数对 S 的增长进行了正则化约束。由此产生了一个新的矩阵 S 更新规则,即 Delta 规则,如下所示:
来源:Linear Attention and Beyond(Songlin Yang 的交互式教程)
Delta 规则成为 DeltaNet 注意力方程的基础:
从概念上讲,Sₜ-1 @ kₜ - vₜ 代表与当前键和值无关的关联。DeltaNet 会对这些关联进行定向移除。
Gated DeltaNet
GDN 和 KDA 是 DeltaNet 的变体。Gated DeltaNet 在矩阵 S 上应用了 LSTM 的遗忘门 alpha,使模型能够通过权重衰减来控制记忆生命周期。KDA 进一步将 alpha 扩展为对角矩阵,从而实现了细粒度的逐通道记忆衰减和位置感知。
Source: Kimi Linear
感谢阅读 SemiAnalysis!本文为公开文章,欢迎分享。
分享
FlashKDA 算法
Moonshot 开发了 FlashKDA,这是他们为 KDA 定制的算子,并将其开源。这里我们解释该算法并推导其算术强度。
算法
首先,我们从一个递推公式的替代形式开始:
这里,D_t 是 alpha 遗忘门构成的对角矩阵,u_t 是 delta 规则中的 delta。在解码阶段,算子大致遵循该公式。在预填充阶段,我们将 token 分块展开递推公式以实现并行化,从而在 GPU 上高效执行运算。假设我们将 token i 到 j 展开,且起始状态为 S_i-1,我们得到:
D_j:i 指的是从 token i 到 j 的累积衰减:D_j @ D_j-1 @ D_j-2 @ … @ D_i。在 FlashKDA 的矩阵形式中,公式变为:
向量到矩阵的映射如下:
S_in 指的是一个 chunk 起始位置的状态 S_out 指的是一个 chunk 结束位置的状态 K_restore 是 D_j:t+1 @ k_t 的矩阵形式 Q_decay 是 q_j.T @ D_j:i 的矩阵形式 Q_decay @ K_inv.T 是 q_j.T @ D_j:t+1 @ k_t 的矩阵形式,由 (q_j.T @ D_j:i) @ (D_t:i^-1 @ k_t) 推导而来 M_qk 是因果掩码,因此它是一个下三角矩阵 U 是展开后的 u_t 的矩阵形式。为了计算它,我们应用 UT 变换并计算以下内容:
完整推导请参考 Songlin Yang 的博客文章和 Kimi Linear 论文第 3.1 节。注意,这里的 U 对应于 Kimi Linear 论文中的伪值项。
在实现层面,FlashKDA 启动了两个 kernel:K1 和 K2。K1 并行准备 chunk 级别的张量,包括:
这里 a 是累积衰减,其中每个元素是某个 token 位置处的累积衰减。
K2 执行 chunk 级别的递归计算:
复杂度分析
这里我们分析单个注意力头的复杂度。对于解码阶段,关键路径的计算为:
D_t @ S_t-1:逐元素乘法,D × D S_t-1.T @ k_t:D × D × 1 k_t @ u_t.T:D × 1 × D q_t.T @ S_t:1 × D × D 解码 kernel 大约执行 7*D² FLOPs。
FP32 递归状态的读写主导了访存流量,因此访存流量大约为 8*D² 字节。
对于预填充阶段,K1 的关键路径在于计算 L、INV 和 M_qk。
L:C × D × C INV:Neumann 分解,执行 6 次 C × C × C 矩阵乘法 M_qk:C × D × C 对于 K2,
K_decay @ S: C × D × D Q_decay @ S: C × D × D M_qk @ U: C × C × D INV @ B: C × C × D K_restore.T @ U: D × C × D 综合 K1 和 K2,FlashKDA 执行 12*C^3 + 8*C²*D + 6*C*D² 次浮点运算。由于我们的分析是在块级别进行的(块大小为 C),假设序列长度 T >> C,总体浮点运算量为 T/C * O(C*D²) = O(T*D²)。
对于显存访问量:
K1 读取 Q, K, g:C × D K1 写入且 K2 读取 Q_decay, K_decay, K_restore:C × D K1 写入且 K2 读取 INV, M_qk:C × C K2 读取 V 并写入 O:C × D K2 在每个内核中读写 S 一次:D × D 总体而言,FlashKDA 访问了 3 * 2*C*D + 2 * (3 * 2*C*D + 2 * 2*C*C) + 2 * 2*C*D = 8*C² + 22*C*D 字节。在内核级别,它的访问量为 T/C * (8*C² + 22*C*D) + 8*D² ~ O(TC + TD + D²)。
这具体表明了 KDA 的计算复杂度:
Prefill:计算量和显存访问量与序列长度呈线性关系 Decode:计算量和显存访问量与序列长度无关,保持恒定 Kimi Linear
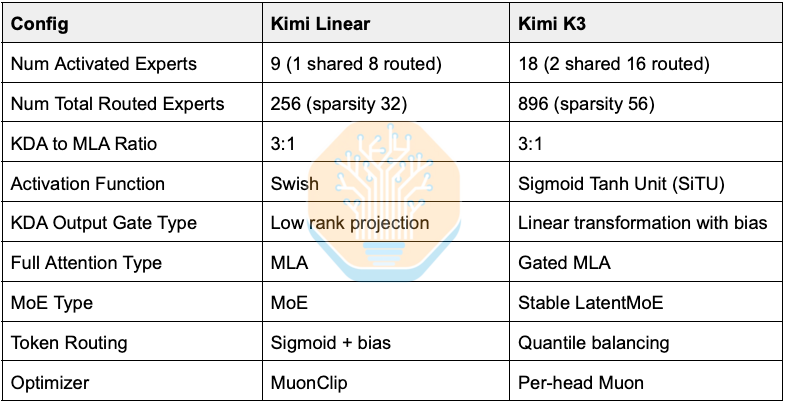
Moonshot 将训练的 Kimi Linear 模型作为其 KDA 设计的概念验证。因此,我们可以从 Kimi Linear 推断出 Kimi K3 的架构设计。对比 K3 发布的技术博客与 Kimi Linear,我们发现 Kimi K3 共享了相同的共享专家数量、混合线性注意力比例以及通用注意力模块设计。
Source: SemiAnalysis
Source: Kimi K3 Tech Blog
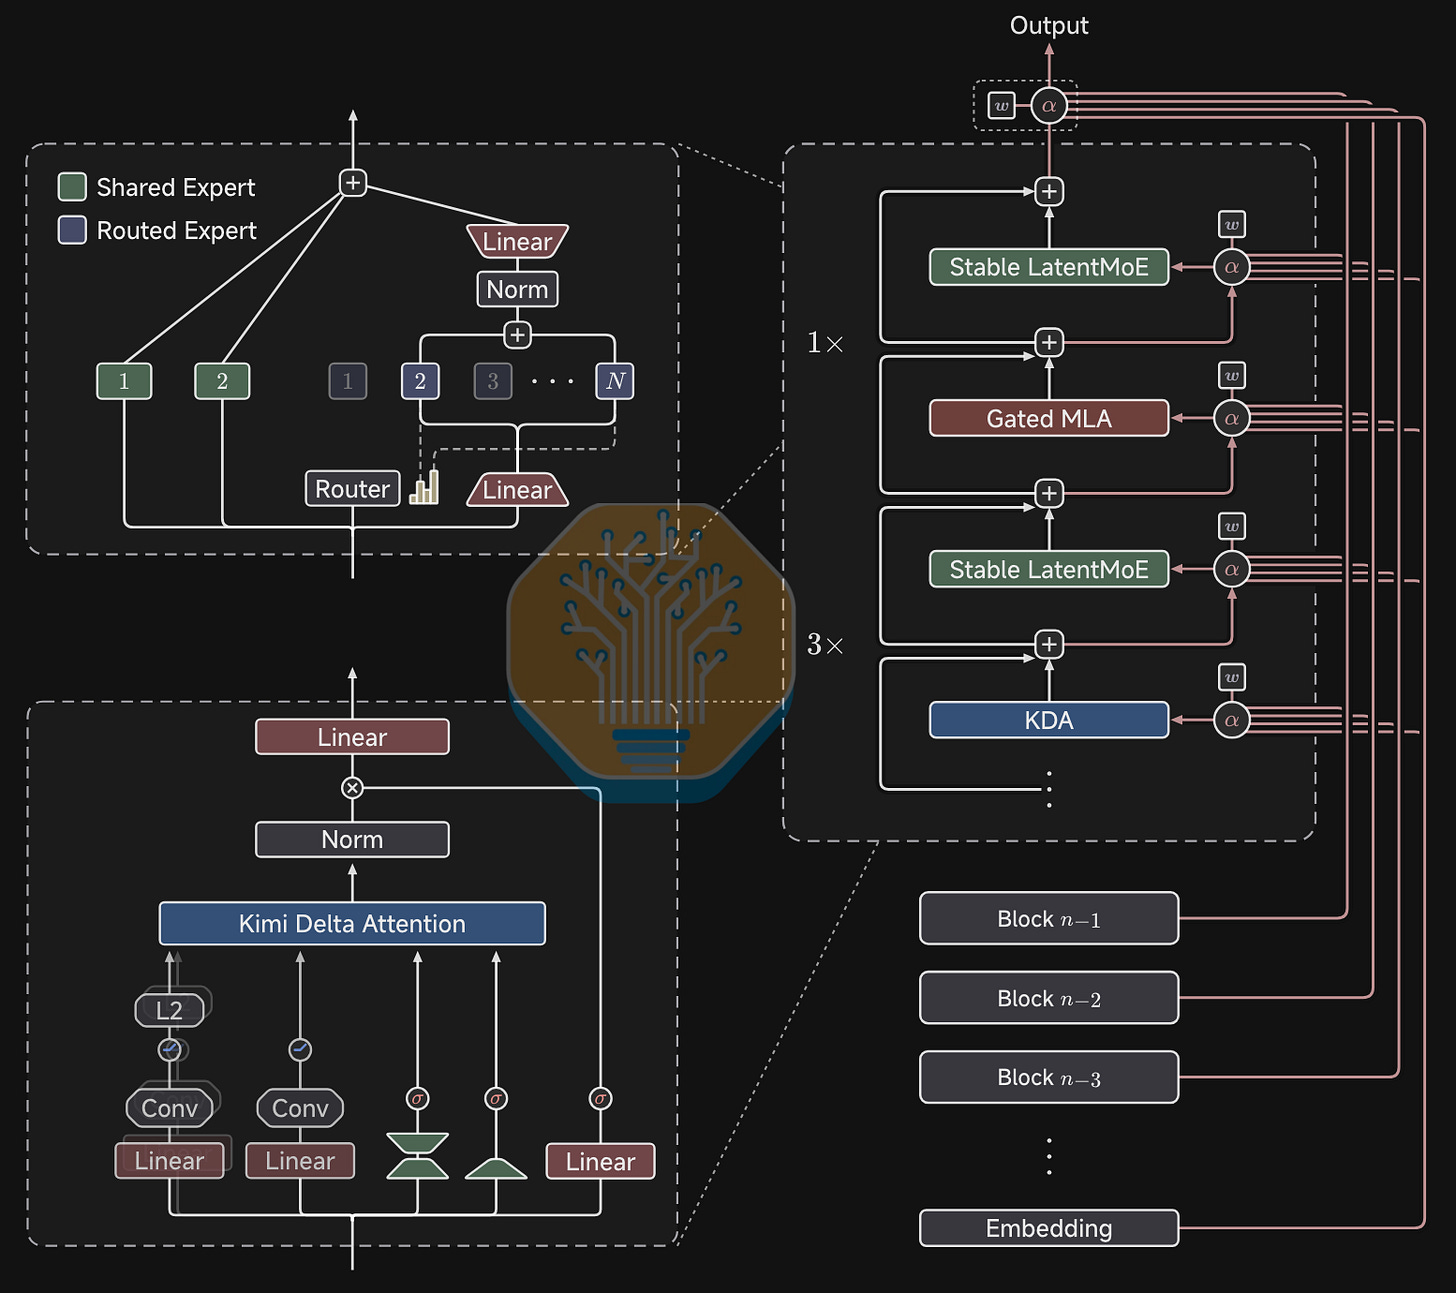
上图展示了对 KDA 输入执行的操作。对于 query、key 和 value,我们应用线性变换和短卷积。应用短卷积能有效捕捉局部 token 的依赖关系,进行左填充卷积可以避免破坏因果性。此外,我们对 query 和 key 额外应用 L2 归一化,以稳定转移矩阵和输出矩阵的特征向量。对于衰减记忆门,alpha 是低秩投影,beta 是降维投影。KDA 的输出按每个头进行归一化,并由一个输出遗忘门控制。该门在 K3 中通过线性变换实现,而在 Kimi Linear 中则采用低秩投影。最后,我们通过一个线性层来融合各头的信息。
Kimi Linear 将 KDA 与全注意力 Multi-head Latent Attention (MLA) 交替使用。Kimi Linear 表明,3:1 是平衡性能与效率的理想 KDA 与 MLA 比例。KDA 还作为一种强大的位置感知算子,替代了 MLA 中的 RoPE。
Moonshot 将 MLA 层保留为全注意力,这与其他曾使用过 MLA 的实验室不同。具体而言,Zhipu 现在采用 DeepSeek Sparse Attention (DSA),DeepSeek 则进一步将 DSA 演进为 Compressed Sparse Attention 和 Heavily Compressed Attention。Moonshot 最著名的研究员之一 Jianlin 给出了两个原因:他们尚未找到更好的注意力设计,且不想一次性应用过多的模型架构改动。MLA 不适合智能体工作负载,下面我们将解释原因。
Multi-Head Latent Attention
MLA 在 prefill 和 decode 阶段执行不同的操作。DeepSeek V3.2 论文定义了两种 MLA 模式:多头注意力(MHA)模式和多查询注意力(MQA)模式。为简单起见,这里我们省略了 RoPE 维度,并以 DeepSeek V3 配置为例。
多头注意力模式
Source: SemiAnalysis
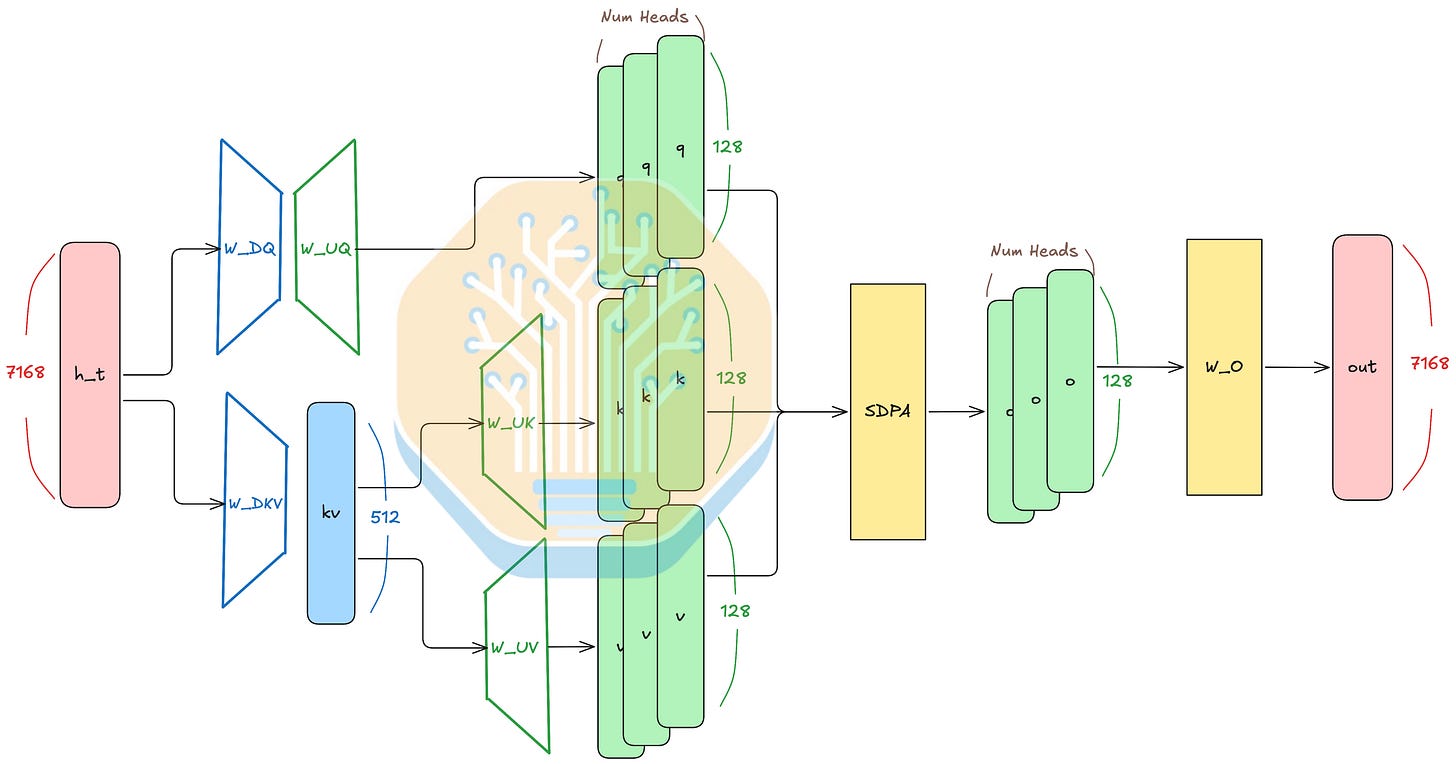
MHA 模式是 MLA 在 prefill 阶段的默认模式。在 MHA 模式下:
对隐藏状态 h_t 进行低秩投影,生成 query q 对 h_t 进行降维投影,生成 kv 条目 kv 对 kv 分别进行升维投影,生成多头 key k 和 value v 经过缩放点积注意力(SDPA)后,将多头输出 o 进行线性投影,得到注意力输出 out MHA 模式与 MQA 模式之间的关键联系在于 KV cache 的内容。我们在 decode 时保存 KV 条目 kv 作为 KV cache,而不是直接保存 key 和 value。通过保存 KV 条目,我们将每个 token 的内存占用减少了 42.67 倍。
多查询注意力模式
Source: SemiAnalysis
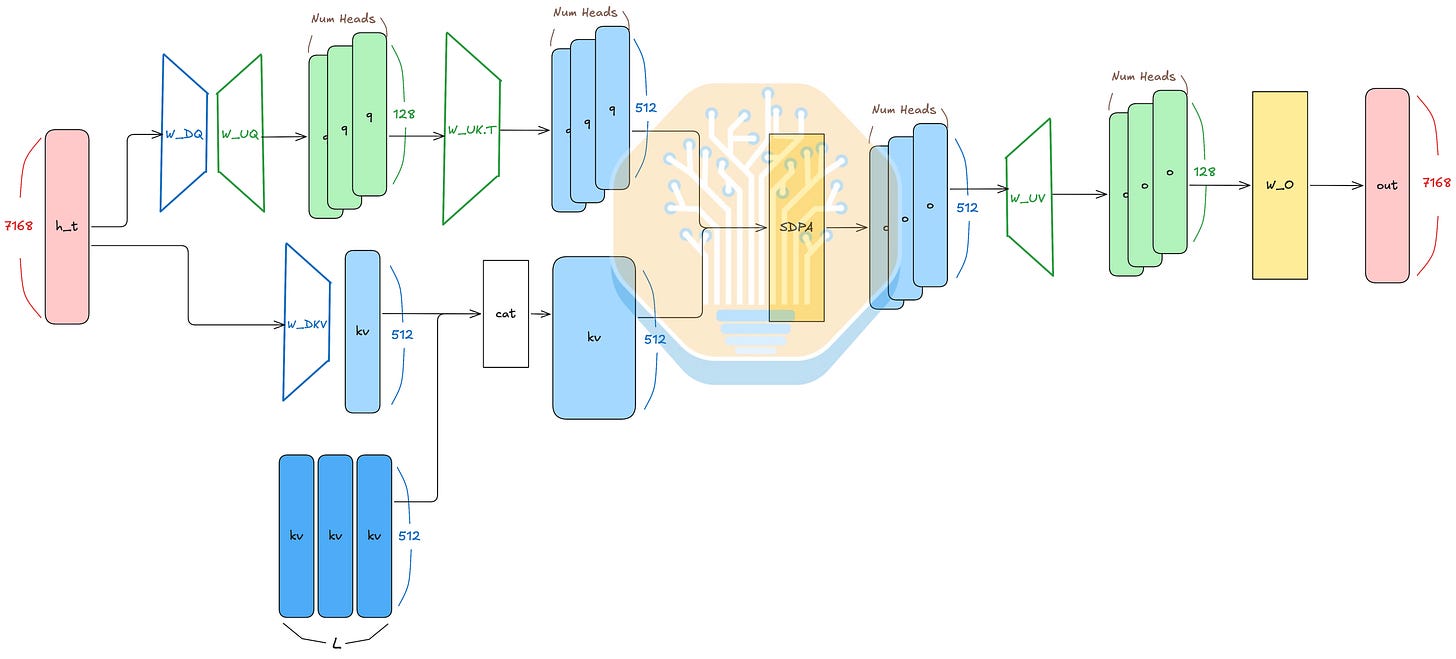
MQA 模式是 MLA 在 decode 阶段的默认模式。为了避免重新物化整个 KV cache,我们重新排列了注意力操作前后的计算顺序,推导如下:
重新排列后,差异如下:
将 query 与 key 的升维投影矩阵 W_UK 的转置相乘 在 SDPA 中将 KV 条目(记为 C)同时用作 key 和 value 在 SDPA 之后再应用 W_UV 如流程图所示,query 是多头的,而 KV 条目是单头的。这实际上就是多查询注意力,因此得名。
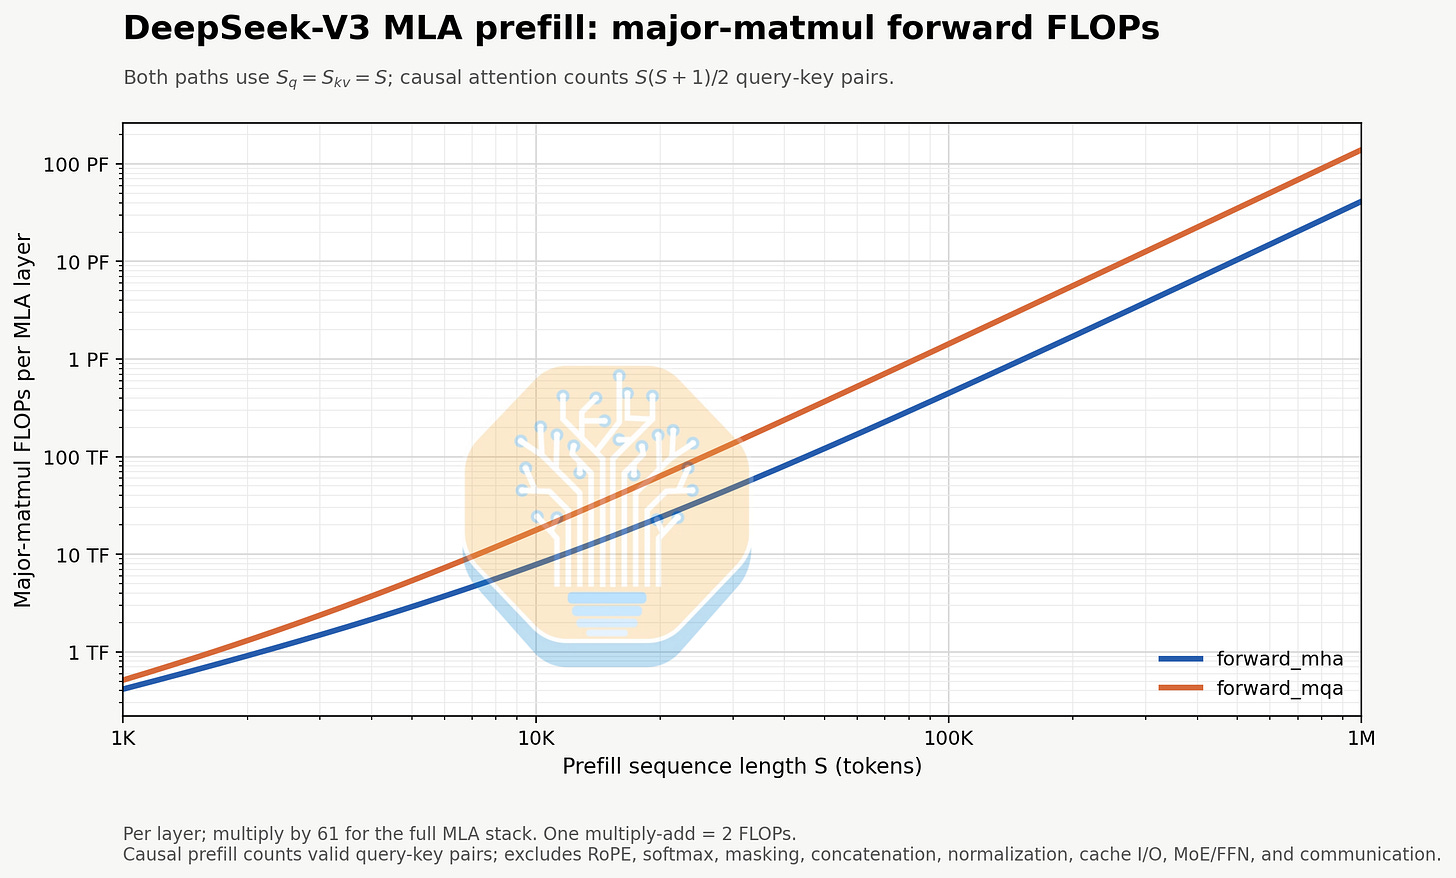
FLOP 对比
比较 MHA 和 MQA 模式的 FLOPs 时,我们可以先消去 query 的低秩投影和输出的线性投影。然后可以观察到,无论升维投影应用在何处,KV 升维投影产生的 FLOPs 大致相等。
接下来就看 SDPA 了。SDPA 执行三次矩阵乘法:(Q @ K.T) @ V。因此 FLOP 数量为 L * d * L + L * L * d = 2*d*L^2。MHA 模式在标准的模型头维度 128 下运行,而 MQA 模式在隐式维度 512 下运行。这意味着 MQA 模式在 SDPA 上的 FLOPs 大约是 4 倍。总体而言,相比 MHA 模式,每个 token 的 FLOPs 开销最多可达 3.4 倍。
Append-Prefill
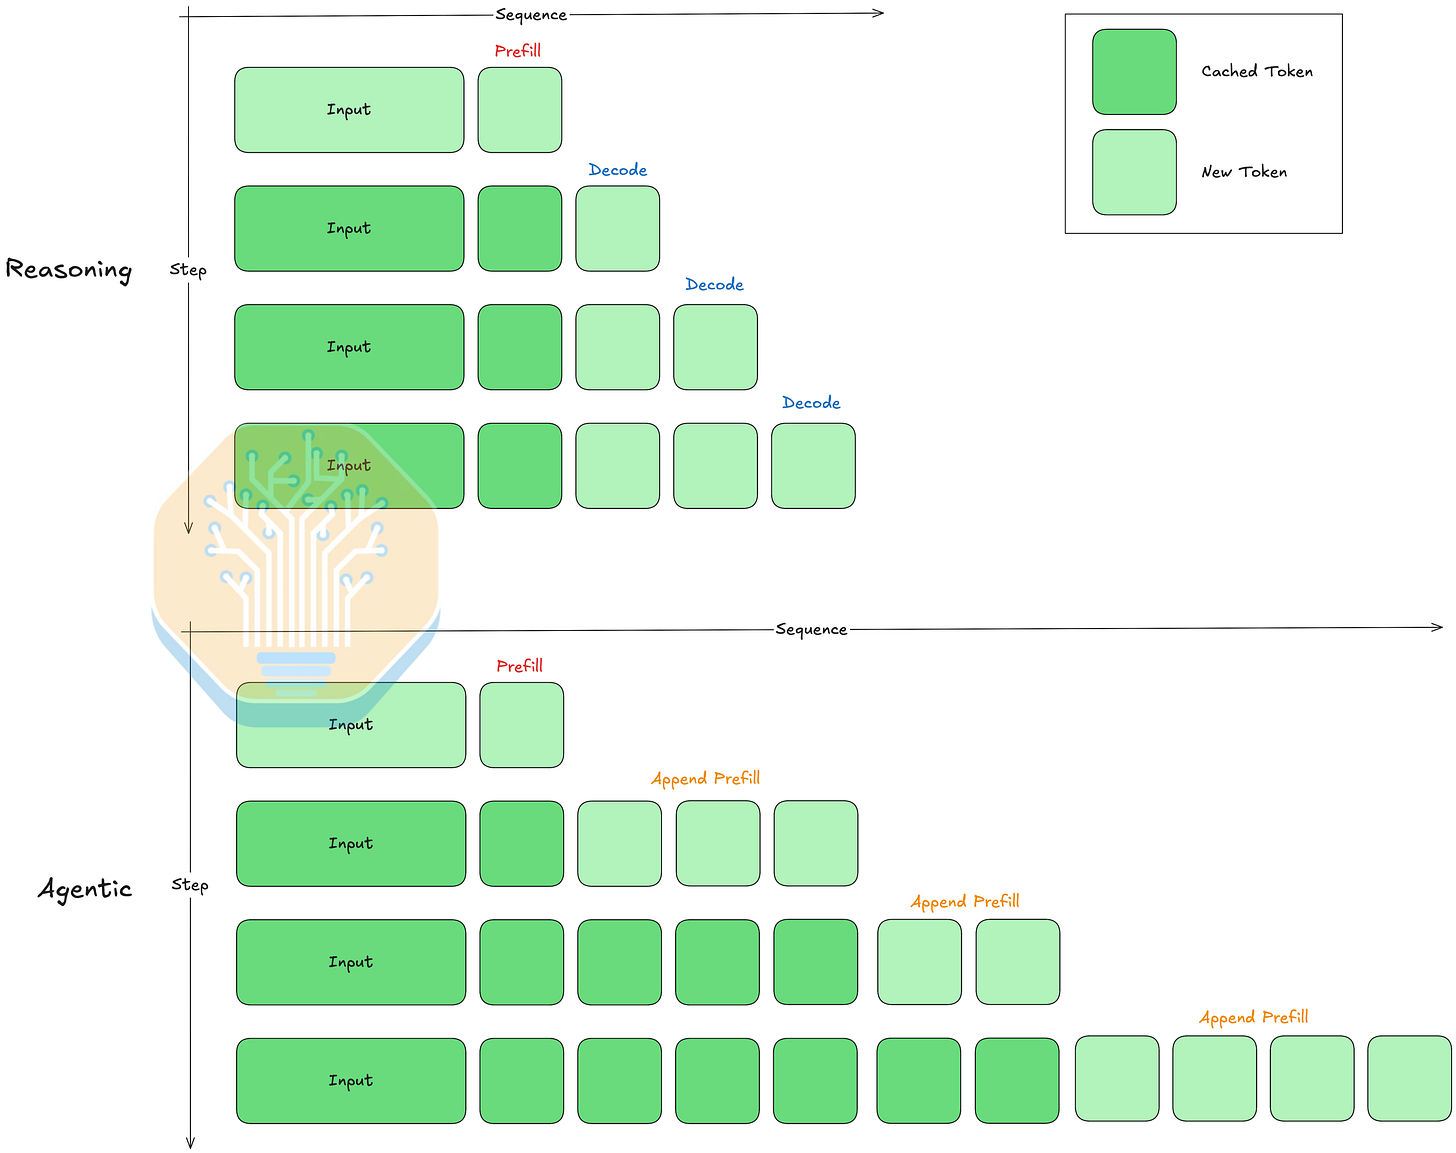
MLA 非常适合推理工作负载。推理通常以相对较短的输入序列开始,随后生成大量输出 token。每个输出 token 对应一个 decode 步骤。MLA 减少了每个 token 的 KV cache 大小,从而降低了内存带宽需求,加速了 decode 过程。
然而,Agentic 工作负载的表现有所不同。这类工作负载涉及工具调用,并会返回较长的工具调用输出。这意味着模型经常处于这种场景中:序列包含一个较长的已缓存输入,随后是一段需要 prefill 的长序列。这种类型的工作负载被称为 append-prefill(也称 extend、append 或 incremental prefill)。
MLA 的两种模式都不适合 append-prefill。MHA 模式并不理想,因为完整实例化 KV cache 的内存开销过大。另一方面,MQA 模式也不合适,因为其 FLOP 开销会增加 3.4 倍。正如这个 Twitter 讨论串中所述,现代推理引擎(vLLM、SGLang)会选择 MHA 模式,但采用分块预填充(chunked prefill)技术,以避免实例化整个上下文的 KV cache。为了解决智能体(agentic)工作负载的问题,DeepSeek 和 Zhipu 选择将 MQA 模式适配到稀疏注意力(sparse attention),以降低 FLOPs 开销。我们推测,Moonshot 未来的模型(例如 Kimi K4)将采用新的注意力机制来替代 MLA。
SemiAnalysis 是一个依靠读者支持的出版物。若要接收新文章并支持我的工作,请考虑成为免费或付费订阅者。
KV Cache 效率
我们认为,不应仅仅根据 KV cache 的空间复杂度来推断其效率。KV cache 大小并非一个孤立的因素,而是模型设计的固有属性:目前没有开源权重模型采用静态 KV cache 压缩技术发布,且模型架构的推理效率会影响 KV cache 效率。KV cache 大小的影响也各不相同,这取决于部署的模型实例的总内存容量。例如,部署采用宽专家并行(expert parallelism)的模型,与采用张量并行(tensor parallelism)的模型相比,其内存占用情况大不相同,这会影响留给 KV cache 的内存容量。因此,我们建议将模型架构的系统效率与 KV cache 大小结合起来考虑,以全面理解 KV cache 效率,并通过 KV 吞吐量对其进行量化。
KV 吞吐量
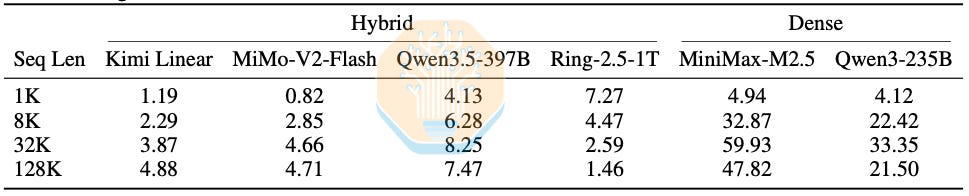
KV 吞吐量定义为:在给定序列长度下,KV cache 大小除以预填充时间(即生成首个 Token 的时间)。KV 吞吐量代表了在 PD 分离(PD disaggregation)架构下可靠提供模型服务所需的最低带宽,同时也是衡量 KV cache 效率的重要参考指标。预填充时间反映了模型架构的效率,并且随着序列长度的增加,我们会观察到内存受限和计算受限两种不同情况。如下表所示,随着序列长度的增加,混合线性注意力(hybrid linear attention)的优势变得更加显著。
Source: Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter
这也是评估 KV cache 卸载到集群中不同内存层级所需带宽要求的好方法。
KV Cache 驻留层
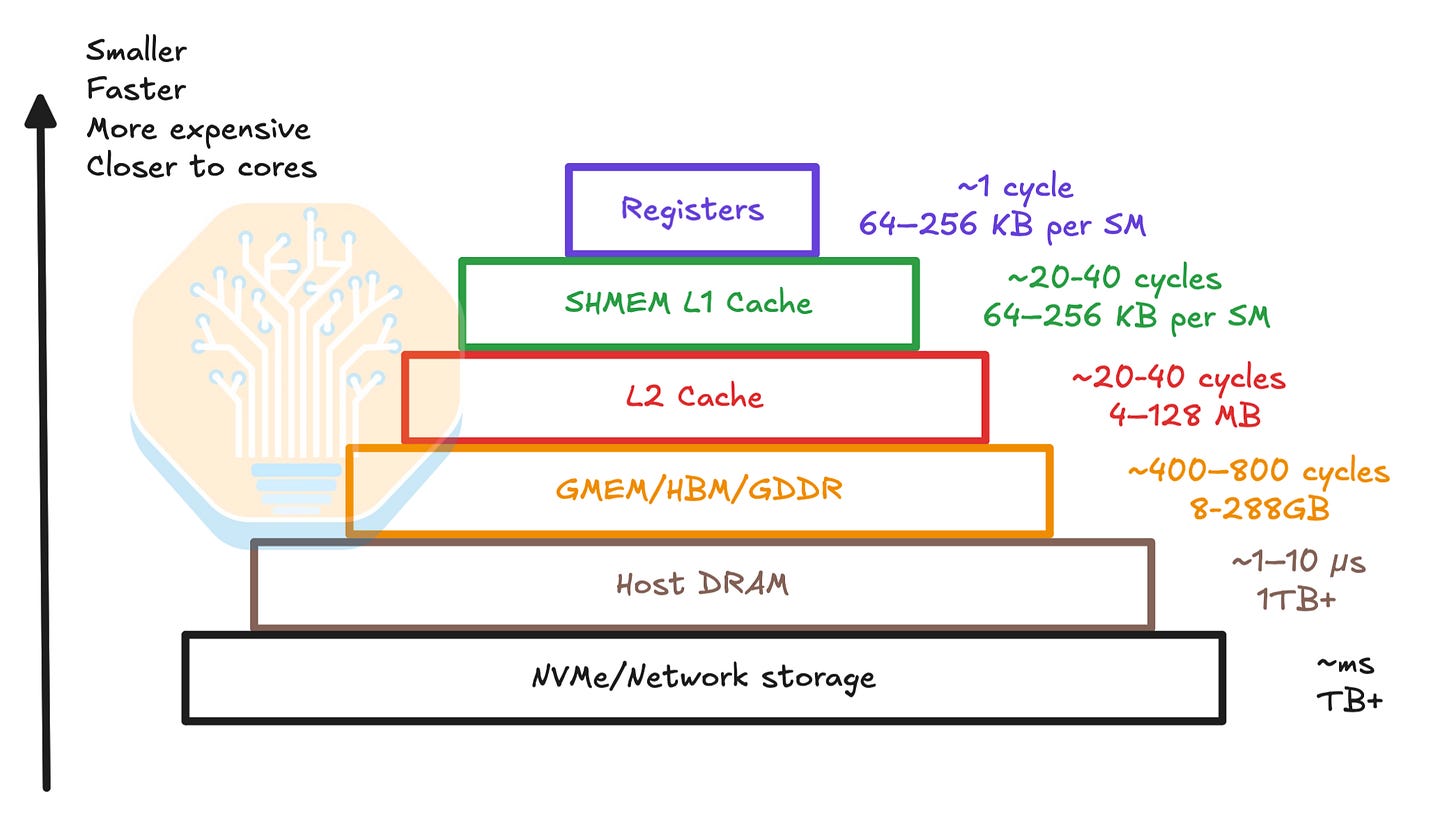
KV cache 的存储位置遵循内存层级结构。首先,KV cache 驻留在 HBM 中。HBM 是 GPU 集群中最快的内存,会消耗掉模型权重和激活值之后剩余的容量。当 KV cache 大小超出 HBM 容量时,它会溢出到服务器 DRAM 中。这是一个容量更大但带宽较低的内存池。最后,当 KV cache 超出 DRAM 容量时,它会溢出到磁盘存储(如 SSD)中。这类似于计算机架构的缓存层级:寄存器、缓存、主存、磁盘存储。
这种类比同样适用于内存一致性。流行的分布式 KV 缓存框架 Mooncake Store 支持 KV 缓存加载的写直通和写回策略。Mooncake Store 的特点是拥有一个分布式 KV 缓存池,使得所有 worker 都能访问所有的 KV 缓存。在 DRAM 和底层分布式 KV 缓存池之间实施写直通策略,在多节点场景下带来了诸多好处。包括跨节点共享前缀缓存、避免张量并行 MLA 中的 KV 缓存重复,以及在节点宕机时提供 KV 缓存冗余。
Source: SemiAnalysis
KDA 前缀缓存管理
在请求的每个 token 位置,Kimi K3 KDA 的循环状态大小固定,而标准注意力 KV 缓存则随序列长度增加而增长。这种 KV 缓存空间的减少是以增加前缀缓存的复杂性为代价的。尤其是当 Kimi K3 成为 KDA 和 MLA 的混合注意力机制时,情况更为明显。
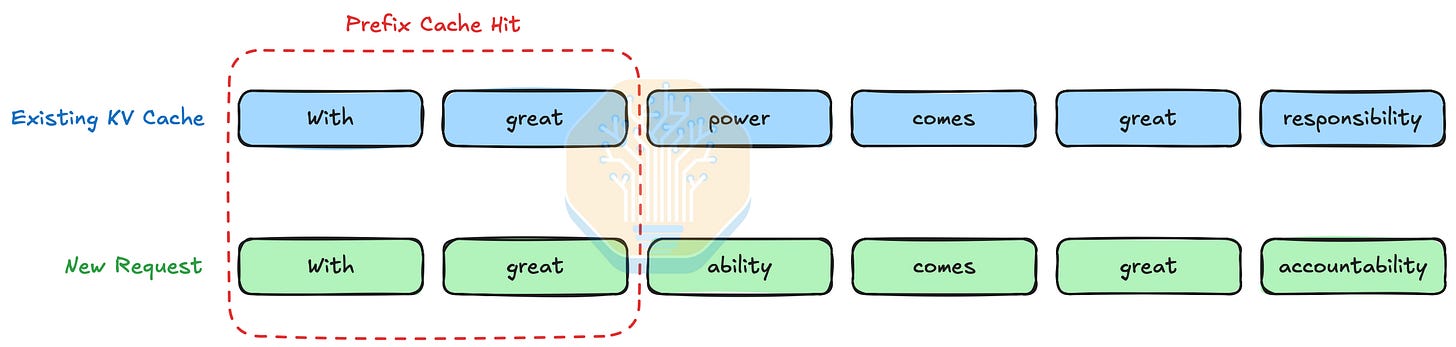
简单来说,现代推理引擎通过匹配现有缓存中最长的 token 前缀,来识别前缀缓存命中。
Source: SemiAnalysis
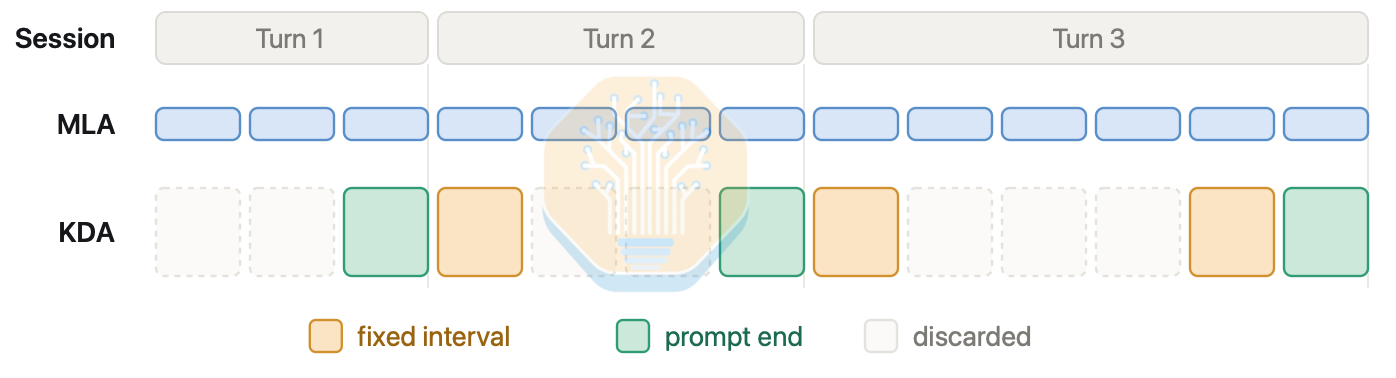
对于像 KDA 这样的线性注意力机制,识别最长前缀成了一个难题。由于事先不知道前缀的边界在哪里,不得不在每一个 token 位置缓存 KDA 的循环状态。这意味着每个 token 都有缓存,KV 缓存的内存使用量又退化为随序列长度而增长,这违背了使用线性注意力的初衷。为解决此问题,Moonshot 以粗粒度保存循环状态,例如 vLLM 每 32K 个 token 进行一次缓存。vLLM 还会在 prompt 边界处额外进行缓存。因为在智能体工作负载中,新一轮对话通常从 prompt 末尾开始。
Source: Kimi K3 Is Here: Efficient Day-0 Support on vLLM
这表明,尽管像 KDA 这样的线性注意力大幅降低了 KV 缓存的内存消耗,但在实际服务过程中,它们消耗的 KV 缓存内存并非固定不变。
注意力残差
残差连接
残差连接是一项关键创新,它让我们能够通过扩大模型深度来构建更庞大的深度神经网络。神经网络越深,表达能力就越强,但直接进行训练却很困难。来自早期层的信号需要一直保留到最后一层,而梯度也需要从输出端无损传导回第一层。
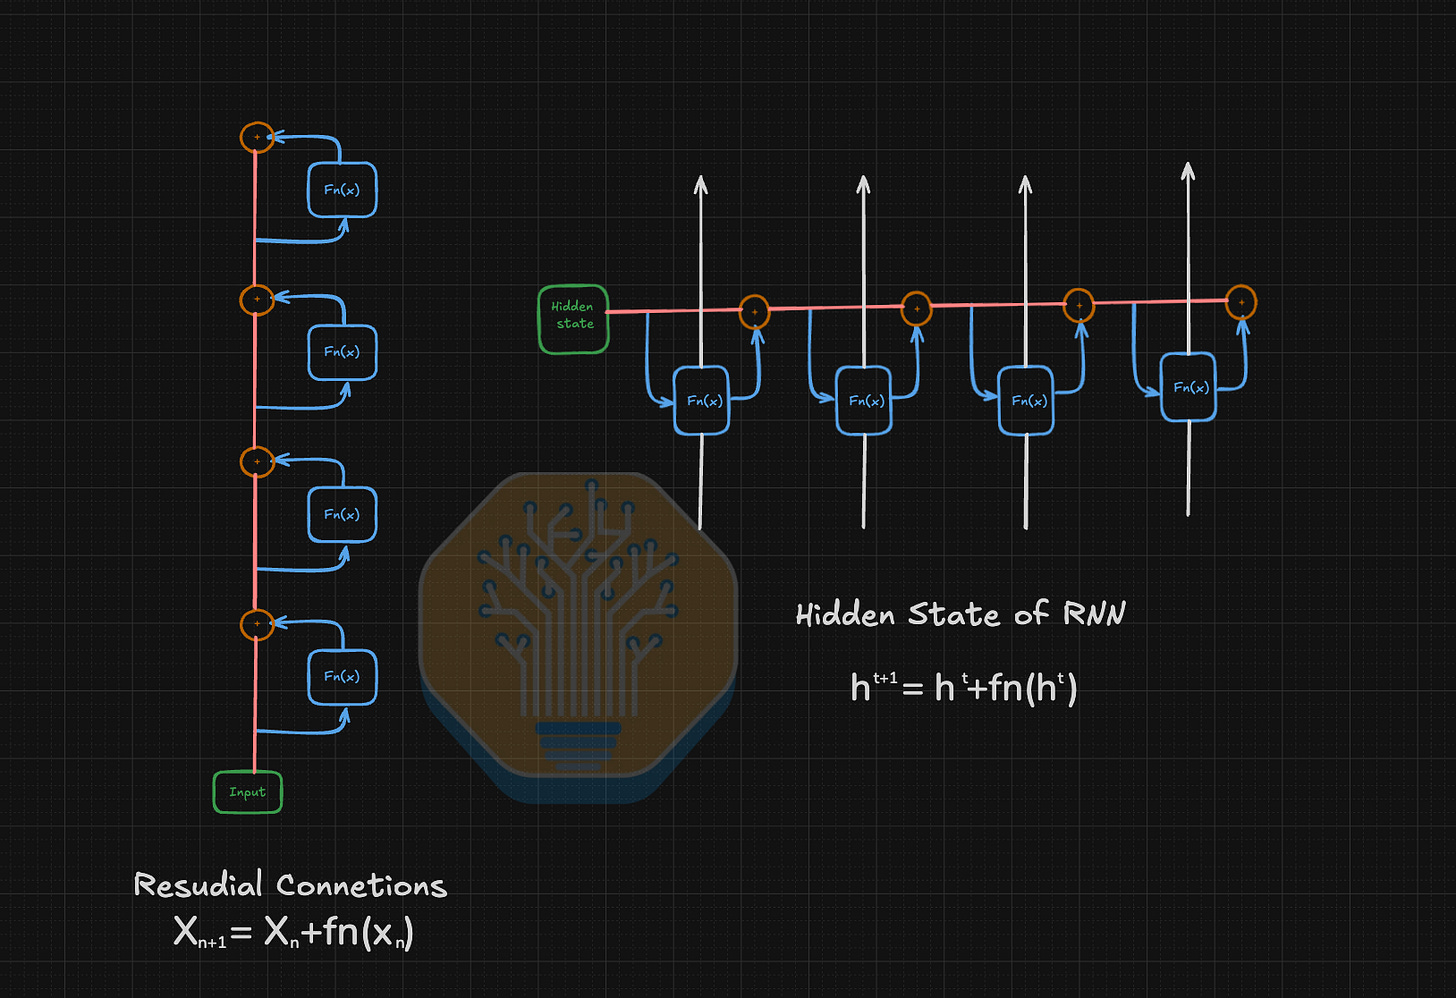
残差网络不再将整个网络建模为单一函数,仅通过非线性变换传递信息。而是通过恒等映射路径将较小的模块连接起来。每个模块 fᵢ 学习对其输入 xᵢ 的改变,由以下递推关系给出:
恒等映射使得特征能够从较浅的单元传递至任意深层单元,并为梯度提供了一条“高速公路”,从而避免梯度消失。
残差连接虽然让我们能够构建更深层的网络,但也带来了挑战。
早期层会深刻影响残差流,进而影响最终输出。因此,随着深度的增加,残差流会出现不可逆的信息损失。后续层会增大输出增益,以作用于这一已被改变的残差流,这可能导致训练失稳。其他变体(如 Highway Networks)虽然允许信息流通过门控机制,但同样面临这一关键问题。各层无法选择性地获取来自早期层的信息。
时间与深度上的循环
由循环神经网络主导的序列建模,采用了相同的循环公式。
在每个时间步中,前一个状态通过恒等映射直接传递信息。然而,这种序列模型面临着同样的挑战:时间轴上的深度会导致信号衰减。
Source: SemiAnalysis
Transformer 引入的注意力机制消除了这一限制。它通过强大但计算成本高昂的注意力机制,能够检索过去的任意 Token。
残差流上的注意力
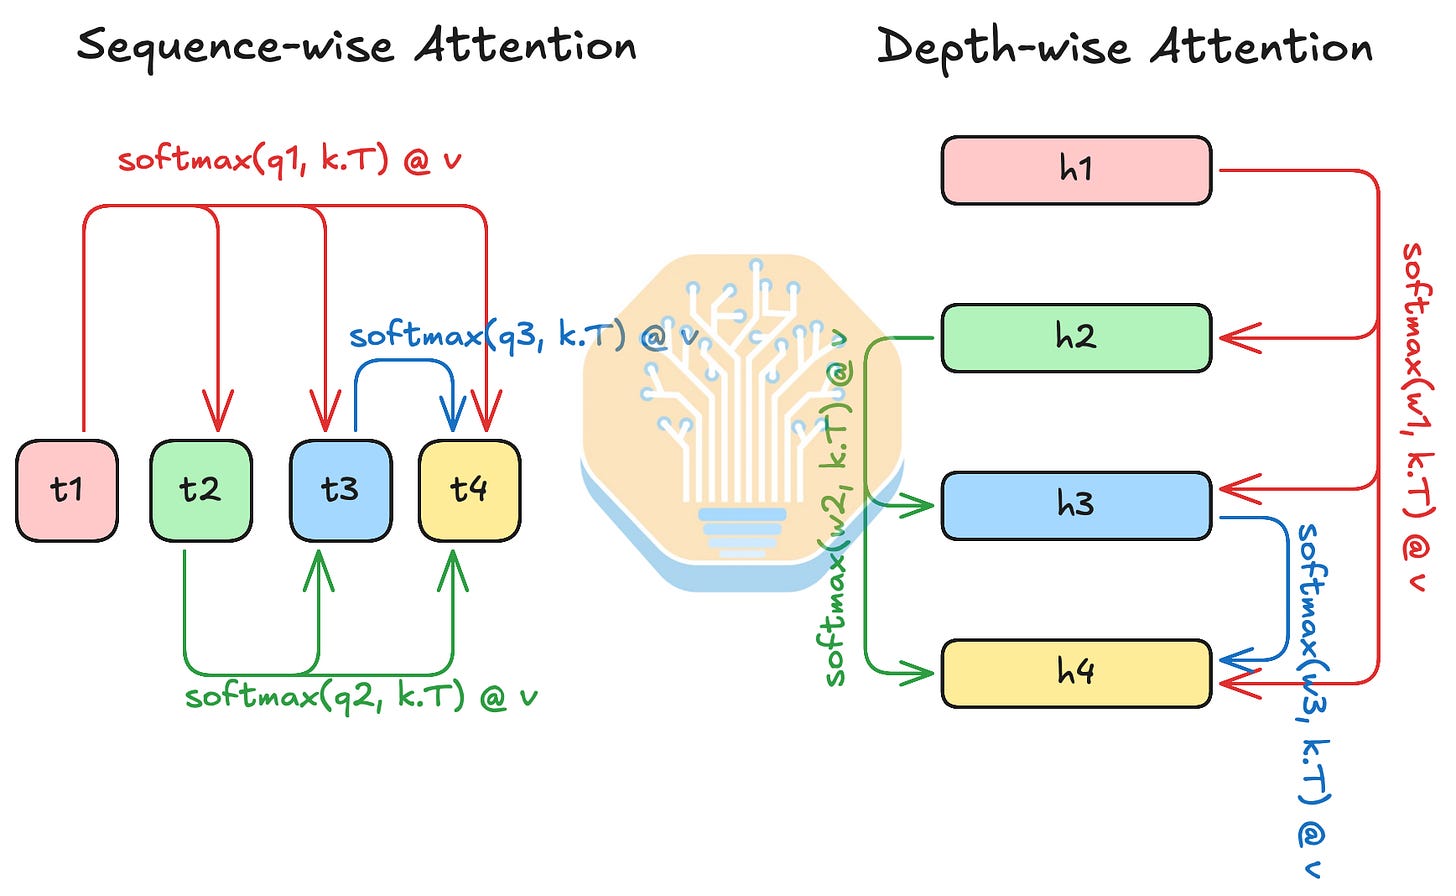
受序列建模中注意力机制的启发,Kimi 提出了注意力残差(Attention Residual)。该机制在深度方向上的多个块之间执行注意力计算。
Source: Attention Residuals
标准因果自注意力将 Token $t$ 的输出,计算为先前 Token 表示的加权和:
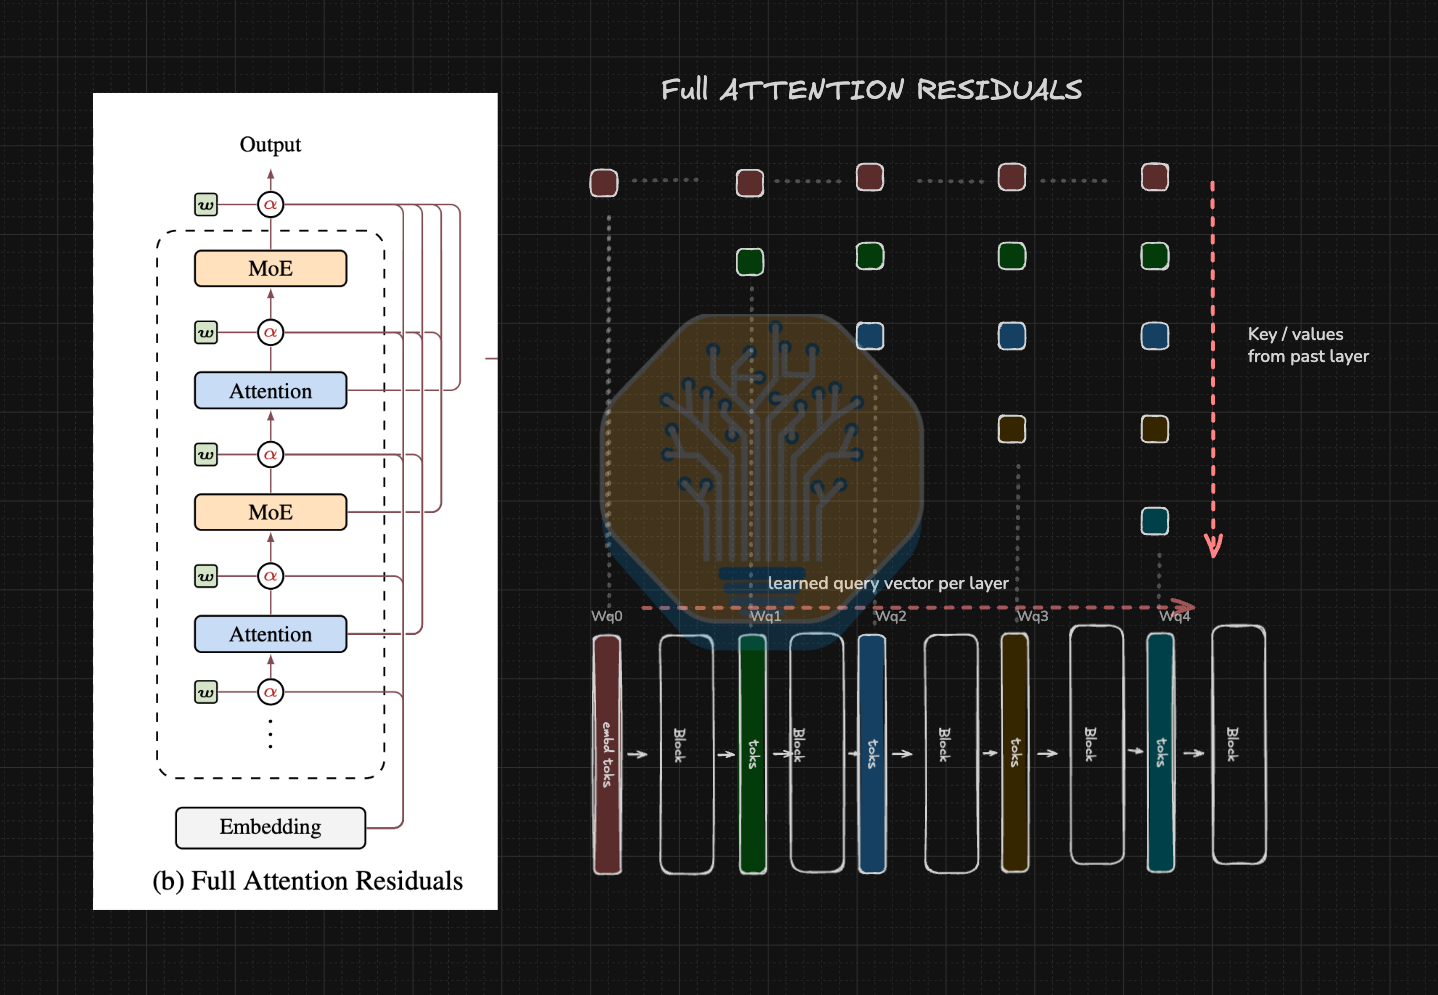
注意力残差采用了相同的注意力机制,但用深度维度替换了序列维度。每个层不再关注先前的 Token,而是关注先前各层生成的表示。
Source: SemiAnalysis
与标准注意力不同,这里的 Query 是每层独立的可学习参数,而不是由当前 Token 生成。
对于每一层 ℓ,我们定义:
每个彩色块代表前一个 Transformer 层的输出 Token 表示。正如标准因果自注意力对序列中的 Token 执行 Softmax 注意力计算一样,注意力残差则对先前各层生成的表示执行 Softmax 注意力计算。
Source: SemiAnalysis
注意力残差使模型能够精细控制从过去层中选择哪些输入,从而提升了模型的表达能力。
块注意力残差
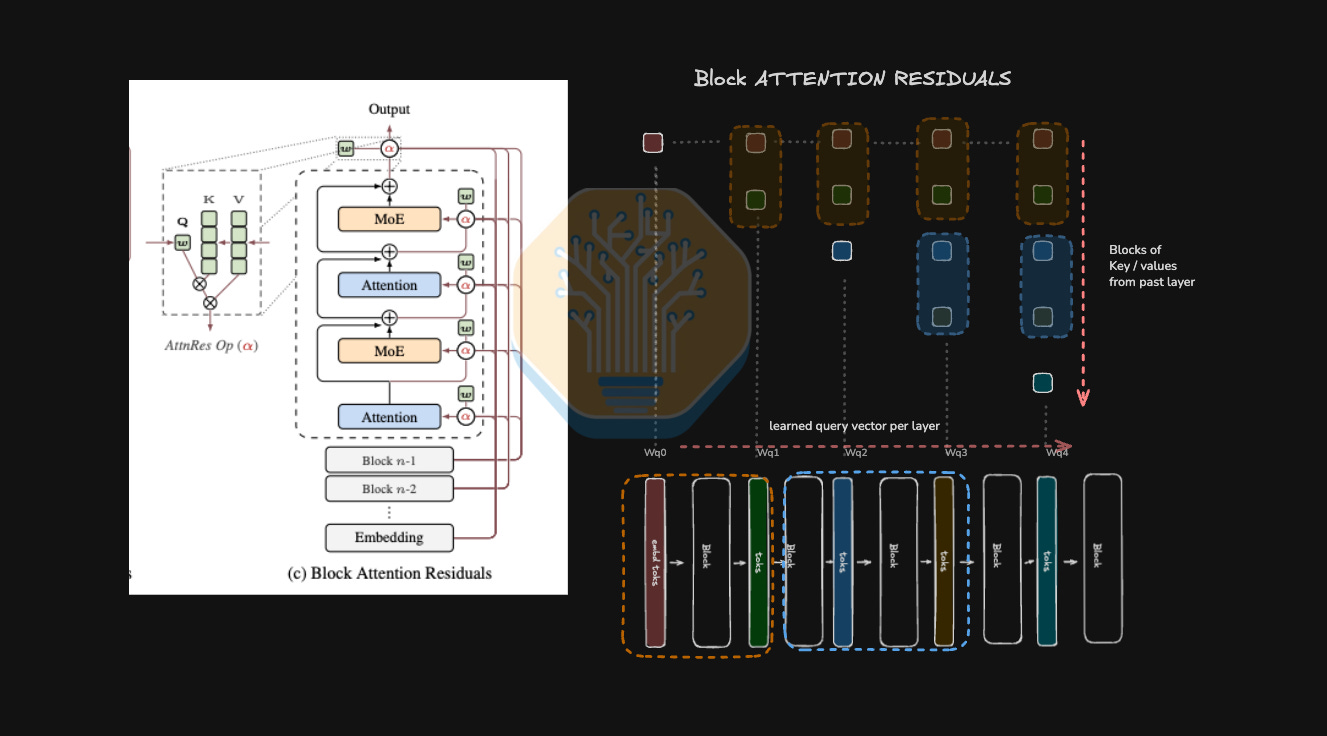
注意力残差需要获取所有过去层的输出来执行注意力计算。对于分布在多张 GPU 上的大型模型而言,这会带来 O(Ld) 的通信开销。为克服这一问题,块注意力残差将 L 个层划分为 N 个块,每个块包含 S 层。Block AttnRes 对已完成的块输出以及当前块正在累加的部分和执行注意力计算。
source: SemiAnalysis
块注意力相比完整的注意力残差仅有极小的性能折损,但将通信开销从 O(Ld) 降低到了 O(Nd)。
令 bₙⁱ 表示第 n 个块中前 i 层的累加和,即
对于第 n 个块中的第 i 层,可用的块表示为
与标准注意力不同,Query 不依赖于输入。每层学习一个 Query 向量:
对可用块表示的注意力权重计算如下:
输出是前层表示的加权和。
Attention Residuals 不再仅仅依赖残差流来保留信息,而是让每一层都能直接、有选择性地访问之前的表示。这种基于块的注意力残差变体在大幅降低通信开销的同时,保持了颇具竞争力的性能。
与标准残差连接相比,块残差展现出更好的扩展性,实现了 1.25 倍的计算效率。其验证损失始终低于基线,且在衰减阶段差距进一步拉大。不同于标准残差网络中输出幅度随深度增加而增大,块注意力的选择性聚合具有有界输出,且梯度幅度保持一致。
训练
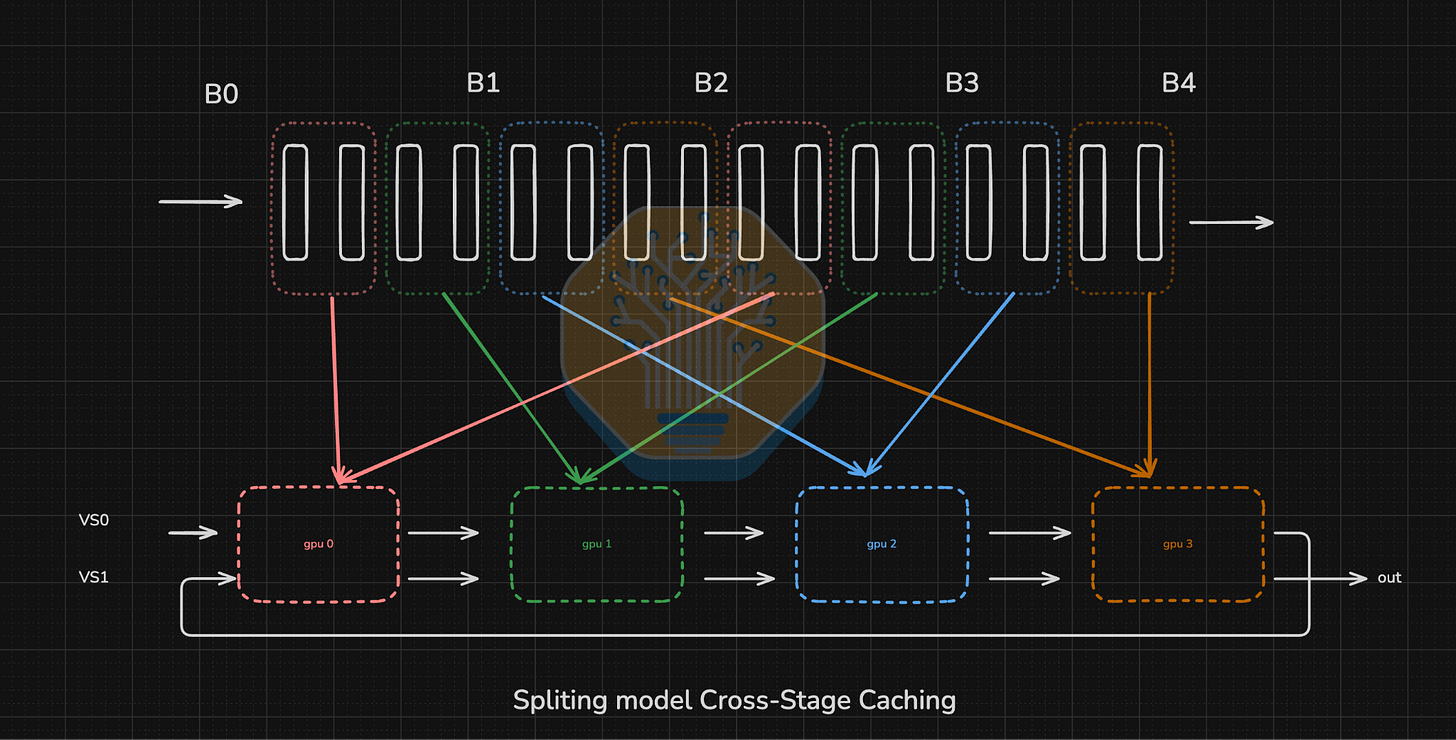
与标准残差网络不同,注意力残差在计算第 N 层时需要前面所有 N-1 个块的输入。这在流水线并行中会带来一个问题:所有 N 个层块的输出都需要跨阶段传输。
通过巧妙的跨阶段缓存和激活检查点技术,Kimi 将流水线并行相比标准架构的开销降至仅 4%。
跨阶段缓存
假设有 P 个物理阶段和 V 个虚拟阶段。每个块 N 对每个数据块需要 C=PV 的通信量。简单直接的做法是,每个阶段都需要传输所有累积的块。这导致通信成本随着物理阶段和虚拟阶段呈二次增长。
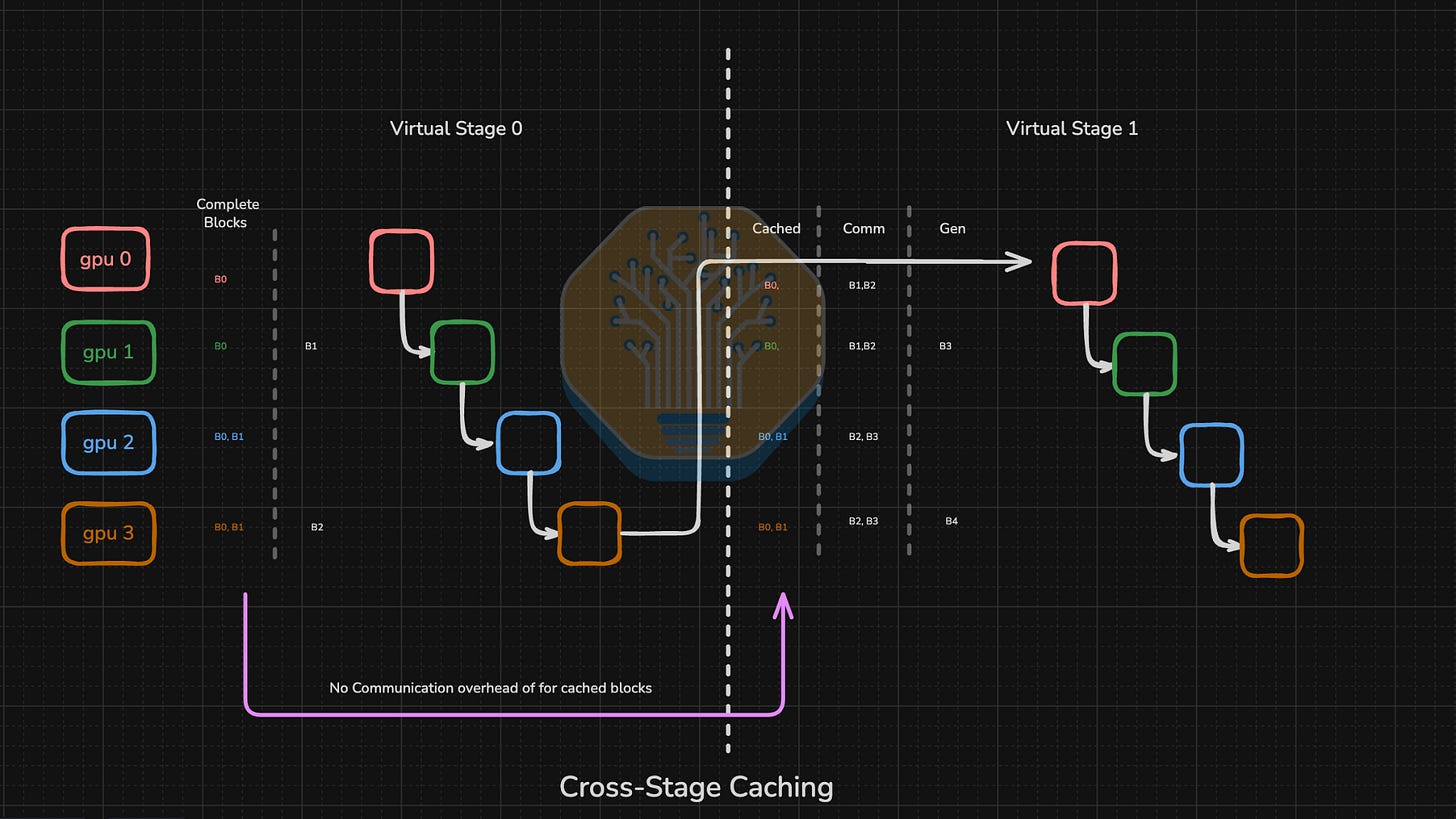
这种高通信量可以通过跨虚拟阶段缓存输入来降低。在较早层计算出的块可以存储在本地内存中。
Source: SemiAnalysis
对于第一个虚拟阶段,所有块嵌入都需要在物理阶段中传输,每个计算完成的块都存储在相应的 rank 上。对于所有后续的虚拟阶段,所有缓存的块都可以被重复用于计算。只有本地 rank 上不存在的块才需要传输,用于注意力到残差的计算。
Source: SemiAnalysis
这将第一个虚拟阶段和后续虚拟阶段的通信成本分离开来。对于第一个虚拟阶段,所有物理层仍然会产生相同的二次方成本。而在后续虚拟阶段中,只需从本地设备获取缓存输入,并仅传输 PNp 个数据块,从而将总通信量从 O(C) 降低到 O(P)。
通信量的减少与虚拟阶段数 V 成正比。因此,在一次完整的前向和反向传播阶段中,所有计算和通信都可以重叠进行。
内存开销
由于采用了跨阶段缓存,所有块在所有 V 个虚拟阶段中只需存储一次。结合激活检查点技术,注意力机制中所有块间数据块的开销被完全消除。每个阶段的激活检查点 Pl 的内存大小与标准架构的 H l 相同,不会产生额外的内存开销。
推理
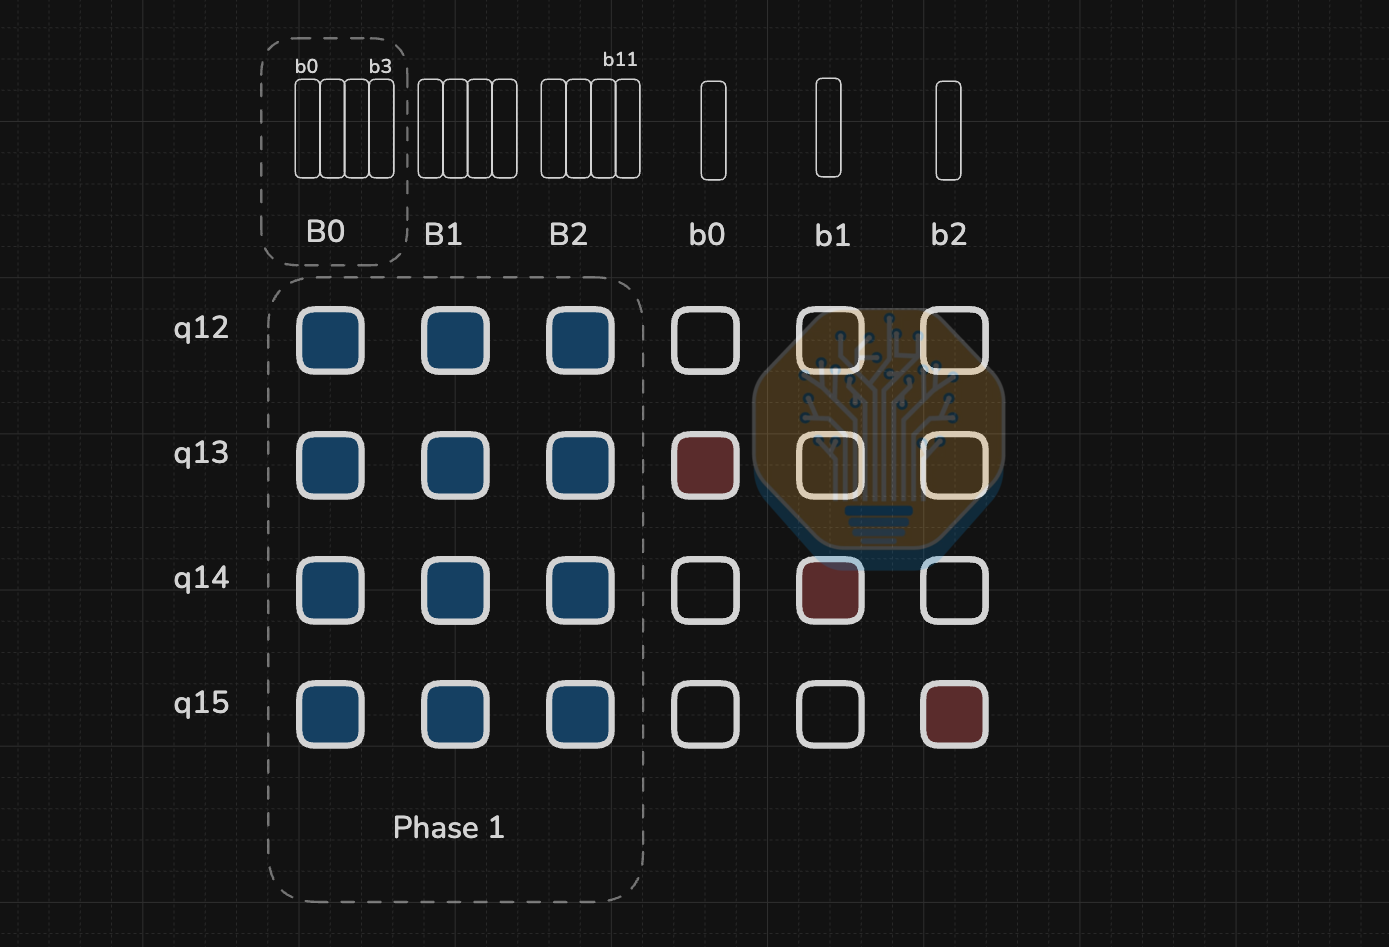
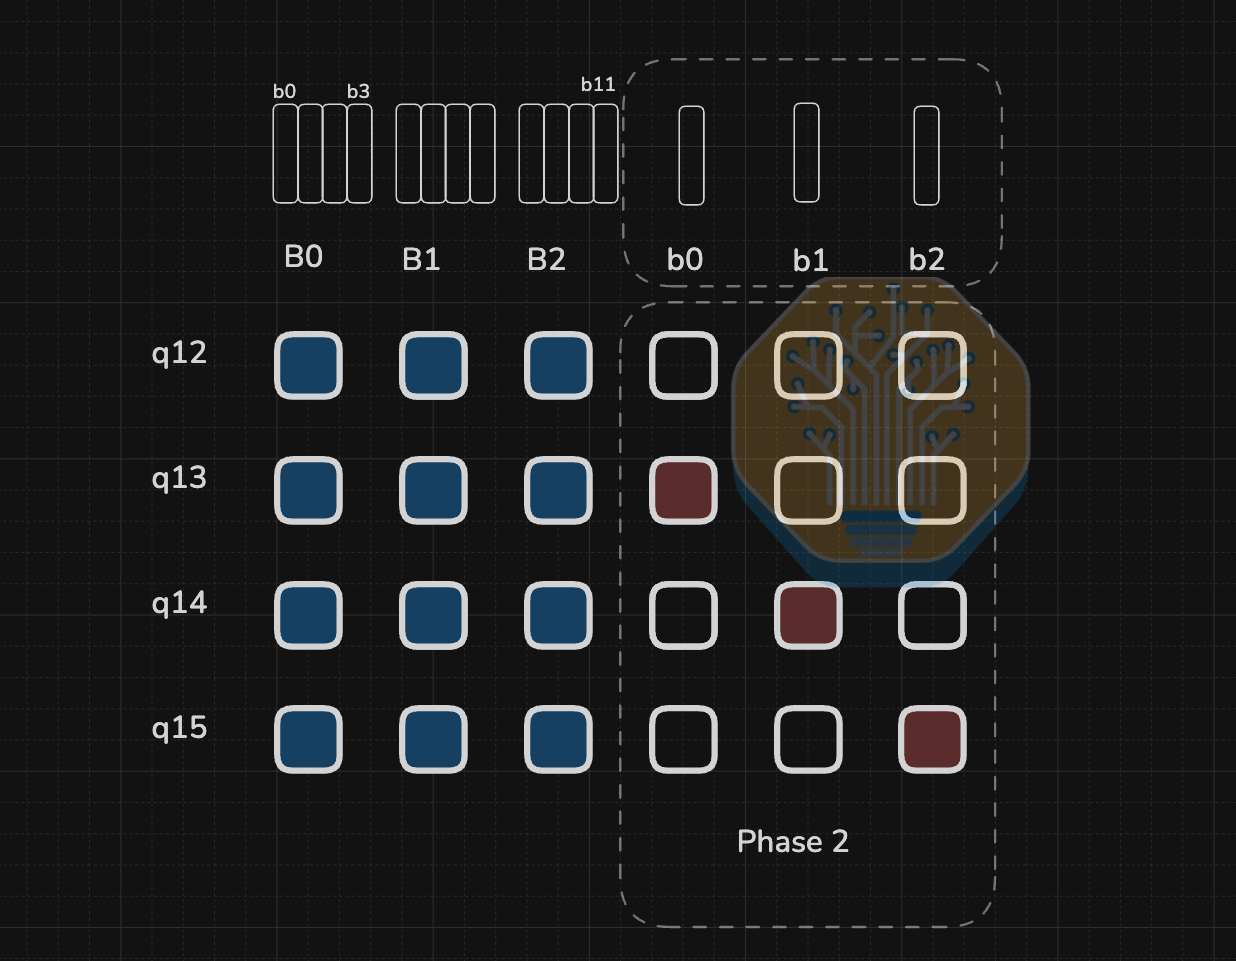
由于 Attention Residuals 需要所有前置块的输出来计算注意力,朴素的实现会带来过多的内存访问。为了降低开销,推理过程被拆分为两个阶段,这类似于自回归注意力中的 prefill 和 decode 阶段。该计算被划分为两部分:针对已完成块的计算采用块间注意力,针对运行中不断变化的注意力则采用块内注意力。
阶段 1:并行块间注意力
Source: SemiAnalysis
在解码过程中,我们需要输出已完成块以及每层学习到的查询向量。所有块间层会同时对已完成块的表示执行批量查询,返回的输出和 softmax 统计信息可被后续计算复用。这一阶段类似于 prefill 阶段的解码过程。
阶段 2:串行块内注意力
Source: SemiAnalysis
此阶段类似于 decode 阶段。与 Flash Attention 类似,可以结合预计算的块间结果,通过在线 softmax 计算块内的动态求和。这有效减少了冗余的内存访问。
采用这种两阶段设计后,IO 开销与标准残差架构相近。仅额外增加了第一阶段中的块间计算,而该开销通过批量处理块内的所有查询被有效均摊。
LatentMoE
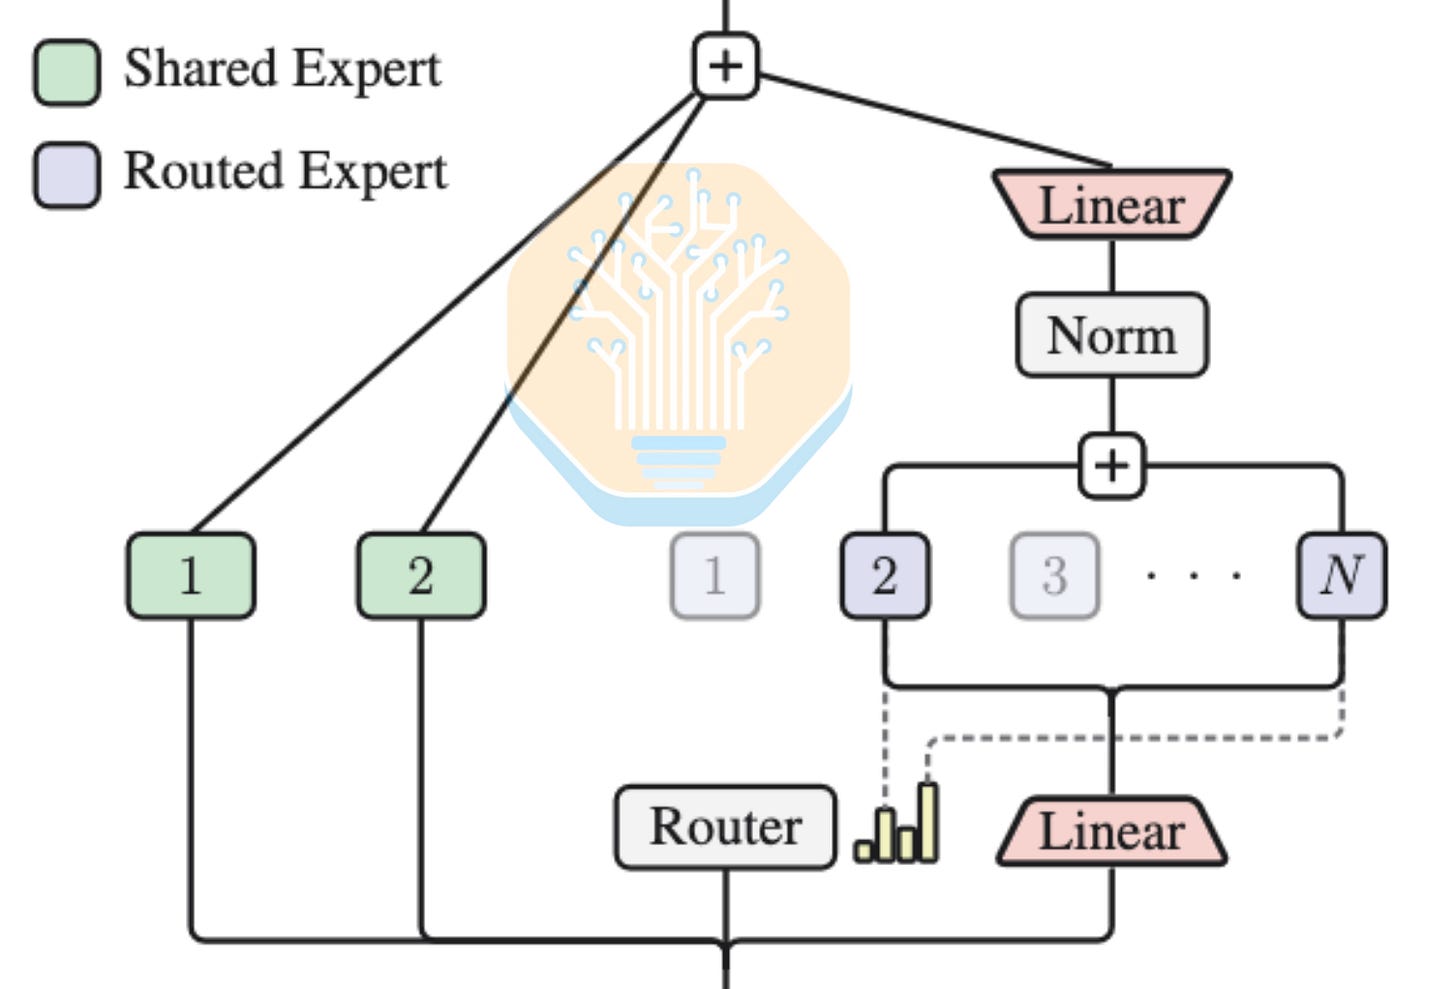
LatentMoE 会在分发操作前压缩路由的 token,并在聚合操作后解压。在 Kimi K3 的 Stable LatentMoE 中,研究者在 up-projection(解压)操作前应用了 RMSNorm。这降低了模型对尺度变化的敏感度,并提升了整体性能。
Source: Kimi K3 Tech Report
这里我们解释 LatentMoE 在 MoE 通信方面的设计原理。LatentMoE 论文指出,通信量与总路由 token 数 t、活跃专家数 K 和专家输入维度 d 成正比,与专家并行度 E 成反比。这可能是 Kimi K3 中 latent MoE 维度大小和活跃专家数量配置背后的原因。Kimi K2 系列配置了 8 个活跃专家,输入维度为 7168。如果 Kimi K3 的 latent 输入维度设为 3584(7168 的一半),就能将活跃专家数翻倍至 16,同时不增加通信量。
然而,在评估系统效率时,通信时间与计算时间的比率可以说更为重要(相关讨论见此处和此处)。该比率反映了在吞吐量受限的场景下,MoE 内核将通信与计算重叠的能力上限,而专家中间层维度大小是唯一影响该比率的模型配置。具体而言,增大专家中间层维度会降低该比率,这意味着理论上可被隐藏的通信比例更高。在此,我们推导出以下公式:
t:专家并行(EP)域内的总输入 token 数 K:每个 token 激活的专家数量 N:专家总数 E:EP 域中的 Rank 数 d:专家输入维度 m:专家中间维度 P:每个激活元素的聚合通信字节开销(分发 + 组合) F:单 GPU 的有效 FFN 专家(建模为 SwiGLU)计算吞吐量,单位为 FLOP/s B:单 GPU 的有效单向网络带宽,单位为 B/s 假设专家路由是均匀的,每个 GPU 会被分配 t * K / E 个 token 假设专家路由是均匀的,平均有 1 / E 的 token 存在于源 GPU 本地,因此每个 GPU 分发 (t*K/E) * (1-1/E) 个 token 每个 token 是一个 d 维向量,因此每个 token 的通信量为 d * P 每个 GPU 的通信量为 (t*K/E) * (1-1/E) * d * P 通信时间 T_comm = (t * K * d * P) / (E * B) * (1-1/E) SwiGLU 计算包含 3 个矩阵乘法:Up(首次)投影:d 到 m;Gate 投影:d 到 m;Down(第二次)投影:m 到 d Up(首次)投影:d 到 m Gate 投影:d 到 m Down(第二次)投影:m 到 d 因此每个 token 的计算量为 2*d*m + 2*d*m + 2*m*d = 6*d*m FLOPs。
每个 GPU 的计算时间为 T_comp = (6*d*m) * (t*K/E) / F 通信与计算时间比为 T_comm / T_comp = ((t * K * d * P) / (E * B) * (1-1/E)) / ((6*d*m) * (t*K/E) / F) = (P*F) / (6*m*B) * (1-1/E) 我们认为,这个公式不仅解释了为何在从 Kimi K2 到 K3 的升级中增加了专家中间维度,也揭示了所有近期开源权重模型(包括 DeepSeek V4 Pro、MiniMax M3、MiMo V2.5 Pro 和 Inkling)同样这么做的原因。随着硬件的改进,以及为了节省内存容量而降低专家权重精度,计算吞吐量不断提升。因此,降低该比值的一种方法就是增大专家中间维度。
分位数负载均衡(QB)
Source: Kimi K3 report
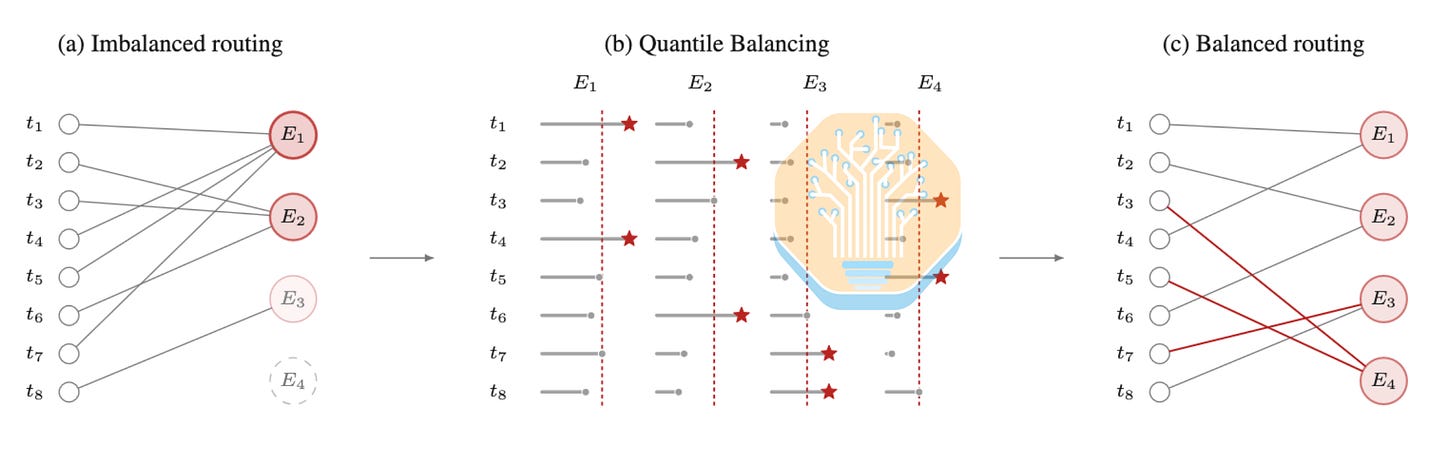
许多现有的负载均衡方法都需要进行细致的超参数调优。分位数均衡(Quantile balancing)是一种免超参数、免辅助损失(aux-loss free)的负载均衡技术,由 Jianlin Su 于 2026 年 2 月的一篇博客文章中提出。
QB 的基本原理与 aux-free 负载均衡相同,都是根据系统负载动态更新路由偏置。但与 aux-free 负载均衡中通过较小的系数来更新偏置不同,QB 直接根据路由分数相对于路由截断阈值的分布来计算下一个偏置。当路由器均匀分配负载时,偏置的更新量会自然变小。
Source: Kimi K3 report
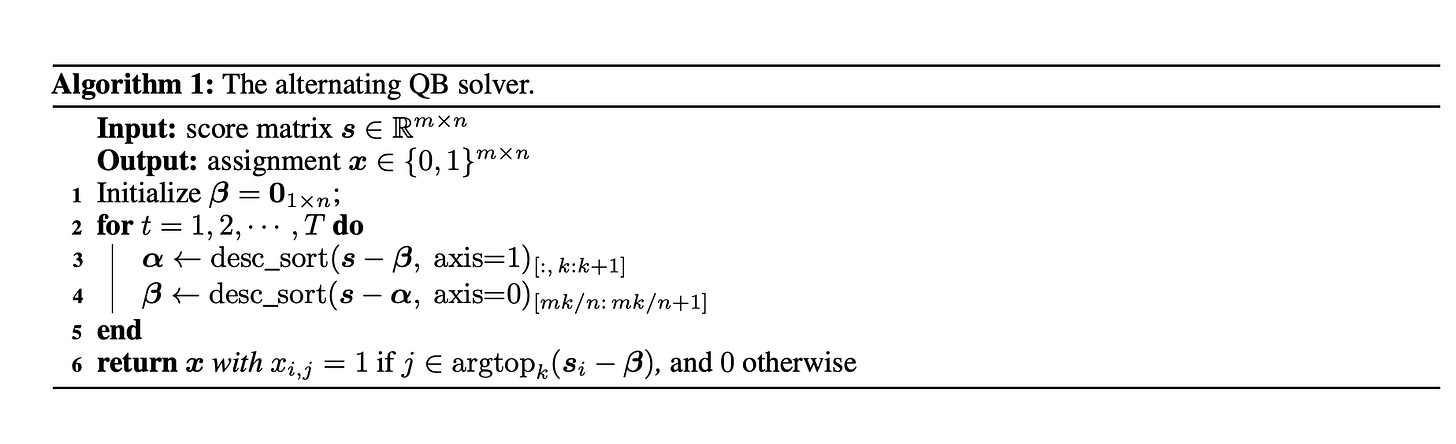
QB 试图找到在当前批次上、当前截断值和路由机制下能够近似实现负载均衡的偏置。它通过求解约束优化问题,并将这些更新应用到下一个批次。第一个约束是,每个 token 恰好被路由到 k 个专家。第二个约束是,一批 m 个 token 每个都选择 k 个专家,总共产生 (mk) 次分配。为了在 n 个专家之间均匀分散负载,每个专家应该处理 q=mk/n 个 token。
每个 token 将 (k+1) 个最高的带偏置路由分作为截断阈值,并利用它来计算平衡每个专家负载所需的偏置更新。对于每个专家,QB 会对路由分与每个 token 截断值之间的间隔进行排序。它将负偏置设为第 q+1 大的间隔,从而在阈值之上恰好保留 q 个间隔。由于 q/m=k/n,这相当于间隔的第 (1-k/n) 分位数,这就是其被称为 Quantile Balancing(分位数平衡)的原因。
SemiAnalysis 是一份依赖读者支持的出版物。如需接收最新文章并支持我的工作,请考虑成为免费或付费订阅者。
推理性能
我们正在 InferenceX 上积极追踪 Kimi K3 的推理性能。
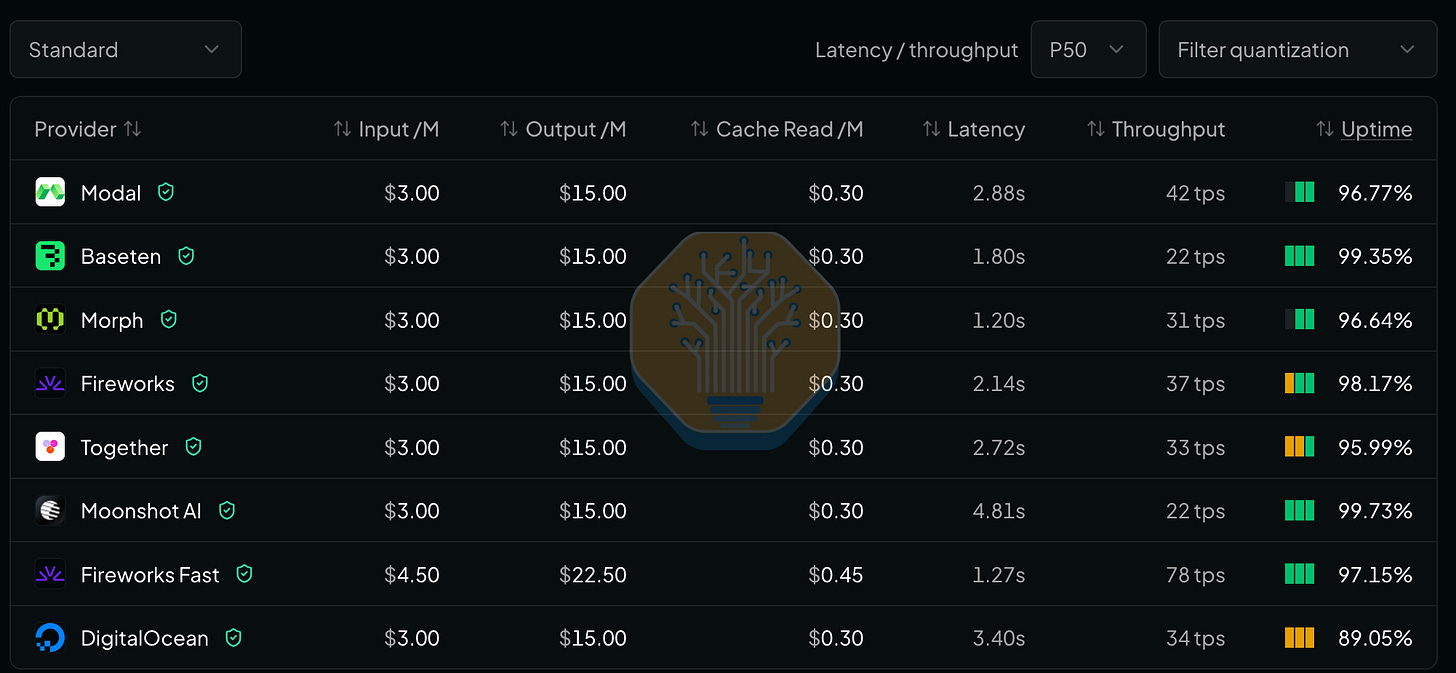
截至 7 月 30 日,OpenRouter 上的所有提供商的定价底线为每百万输入 token 3 美元,每百万输出 token 15 美元。Nvidia 和 AMD 都在 vLLM 上提供了 Day 0 方案,支持 DRAM 卸载和 DSpark 推测解码。
Source: OpenRouter
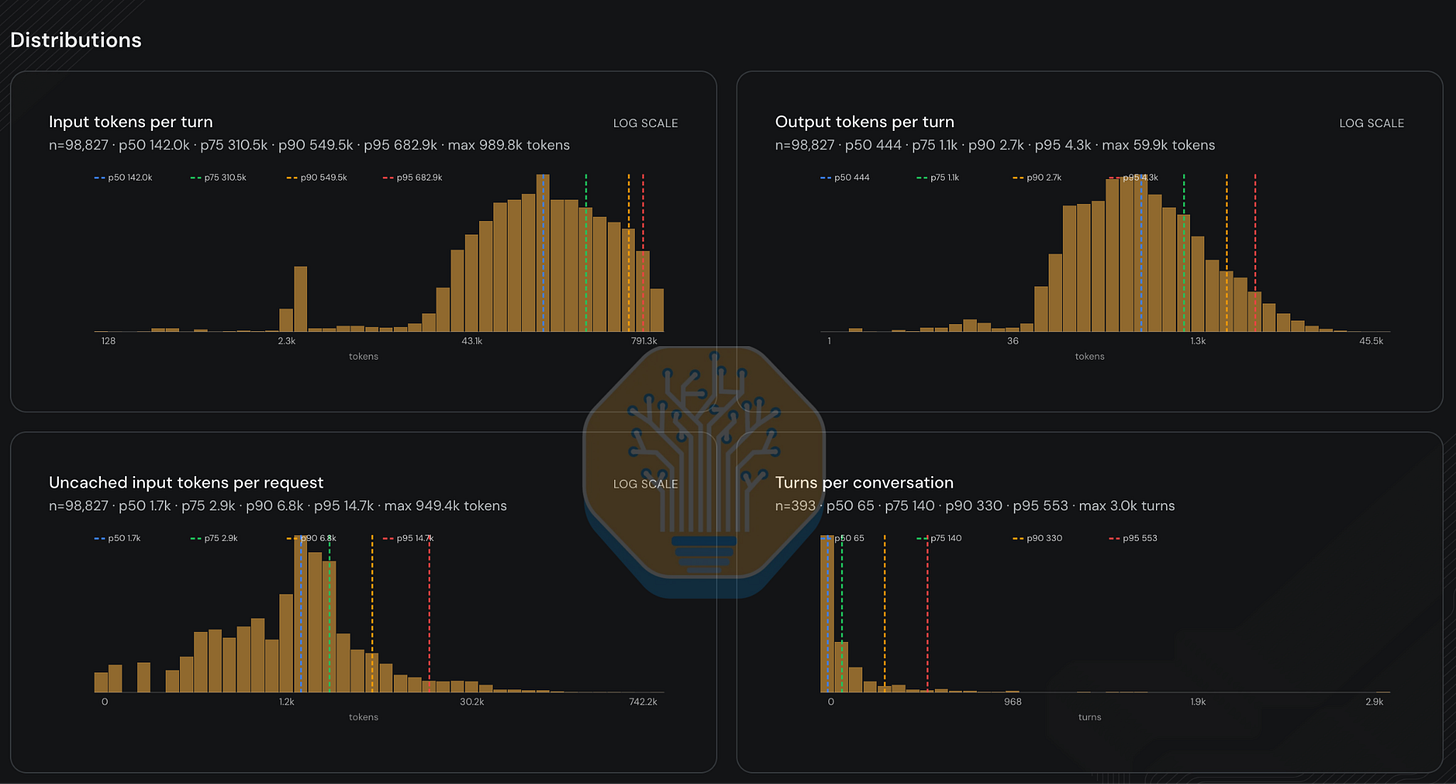
在 InferenceX 上,我们直接基于记录的内部 claude code 轨迹对 Kimi K3 的服务性能进行基准测试。我们重放一个小时的这些轨迹,使其达到稳定状态。每个回合的中位数输入 token 数为 142k,中位数输出 token 数为 444,每个会话的中位回合数为 65。每个回合输出 token 较少是 agentic 框架工作负载的典型特征。在这种框架下,Agent 会频繁调用工具,甚至编辑操作也是通过工具调用完成的。
这项基准测试相比我们之前的 8k1k/1k1k 基准测试有了很大的提升,因为它真正反映了真实世界的 agentic 用例。从系统角度来看,它也非常贴近生产系统,具有很高的现实性。它能够反映 KV 缓存的行为,包括前缀缓存和 KV 卸载到 DRAM 的机制。
Source: InferenceX
对于 Kimi K3,由于其权重发布前的文档和准备工作更加充分,Day 0 启动过程比 DSv4 更容易。在发布权重的同时,也同步发布了相应的镜像和推测解码模型。
The release of DeepSeek v4 marks another step forward for the open model community - unsurprisingly, it is the product of a Chinese lab. The evolution of its performance over time is of paramount importance to the AI Ecosystem. The open-source InferenceX engineering team has pulled multiple all-nighters to measure performance results for this model on Day 0, Day 1, Day 2, and beyond and bring these results to the world.
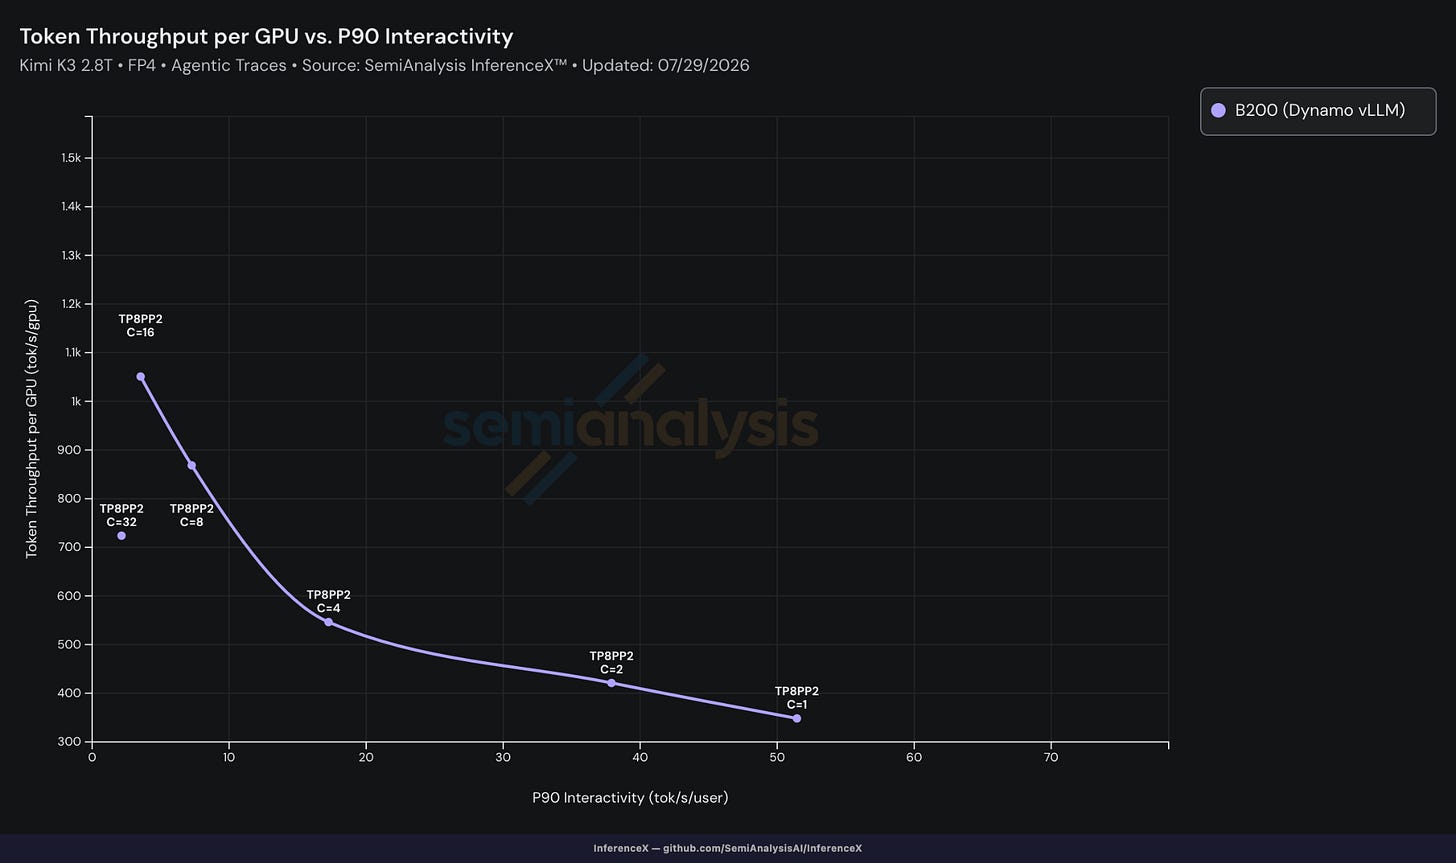
对于 Nvidia,启动过程很简单。但由于模型规模过于庞大,它无法在单个 B200 节点上运行。我们不得不使用 PP 才使其正常工作。此外,DSpark 也不兼容 PP。
Source: InferenceX
对于 B300,该模型可以放进 1 个节点并顺利提供服务。计算权重后,GPU HBM 仅能容纳 3.25M 个 token。在下图中,吞吐量随着批大小的增加而上升,直到并发度超过 8。这与 3.25M 个 token 的 KV 缓存预算大致对应。此后缓存开始抖动,导致在理论命中率为 95% 的情况下,实际命中率却降至 10% 以下。