← 全部文章
Vera Rubin NVL72 vs GB200 NVL72? Inference TCO & Architecture Analysis
2026-07-23 · 原文
Vera Rubin NVL72 是 Nvidia Oberon 机架级架构的第二代产品。它在推理方面的性能提升,源于极致的软硬件协同设计。工程样品的早期测试结果令人振奋。目前,运行 DeepSeek R1 的 Vera Rubin NVL72 与今天的 GB200 NVL72 相比,每兆瓦性能提升 5.4 倍,每美元性能提升 5 倍。如果与 2025 年 GB200 NVL72 早期点亮阶段相比,这一差距甚至更大。Vera Rubin 目前仍处于早期点亮阶段,因此我们预计差距还将继续扩大。随着软件的成熟,Rubin 的推理性能将持续提升。这与我们在 InferenceX 基准测试中展示 Blackwell 时的趋势一致。Rubin 未来还有很长的优化空间。
Nvidia 最近还发布了首个公开版本的 Rubin(SM_107)软件栈,包含 CUDA13.4。同时,Nvidia 已将 Rubin 的 PR 提交至 PyTorch、vLLM 和 OpenAI Triton Compiler 的上游。Blackwell 无法复用 Hopper 的 WGMMA 内核,但 Rubin 能够复用 Blackwell 的内核,这使得软件点亮过程顺畅得多。对于理论极限(SOL)性能,工程师仍需调优和重写内核。但如果重点关注上市时间,则可以直接复用 Blackwell 的内核。此外,我们还将介绍 Rubin 全新的 3 位可编程 LUT Tensor Core。
Nvidia 还在 GitHub 上公布,Feynman 的架构代号为 SM_140。与从 Blackwell 到 Rubin 的过渡不同,从 Rubin 到 Feynman 在内核层面的过渡将复杂得多。
这些在 VR NVL72 上收集的早期指标来自 CoreWeave。我们尚未对这些数据进行独立验证。Nvidia 承诺,将在 2026 年第三季度(Q3 CY2026)前向 InferenceX 提交可验证的测试数据。Google 应该会在未来几个月内提交 TPUv7 的测试结果。AMD 则承诺提交 MI455X UALoE72 的数据。这些结果公布后,整个生态系统将获得跨系统的客观比较。
在本文中,我们将拆解 Nvidia 对 Rubin 的宣传,并与几项基准进行对比。借此展示 Rubin 在哪些方面明显领先 Blackwell,在哪些方面领先优势则相对较小。我们还将基于已有的 Rubin 总体拥有成本(TCO)估算,分析 Rubin 的每 TCO 性能。Rubin 及其他多个系统的 TCO 数据来源于我们的 AI TCO 模型。该模型追踪不同 AI 芯片的总体拥有成本,并综合考量资本支出(capex)、运营支出(opex)及其他各项费用。此外,我们还利用数据中心模型中的综合公用设施供电估算,来评估其每瓦性能。
最后,我们将逐个组件剖析 VR NVL72 的物料清单(BoM)。相关内容将在我们即将推出的 SemiAnalysis 物料清单(BoM)模型中提供。
Rubin Oberon NVL72 相比 Blackwell Oberon NVL72 的另一个优势在于,其量产爬坡期会短得多。这得益于 Rubin 更简单的无缆计算托盘设计。同时也受益于 Nvidia 在部署机架级铜背板方面积累的经验,因为公司此前已投入大量精力解决 Blackwell 铜背板的各类问题。我们的 Accelerator Model 会按季度追踪 Rubin 在封装层级和机架层级的出货量。
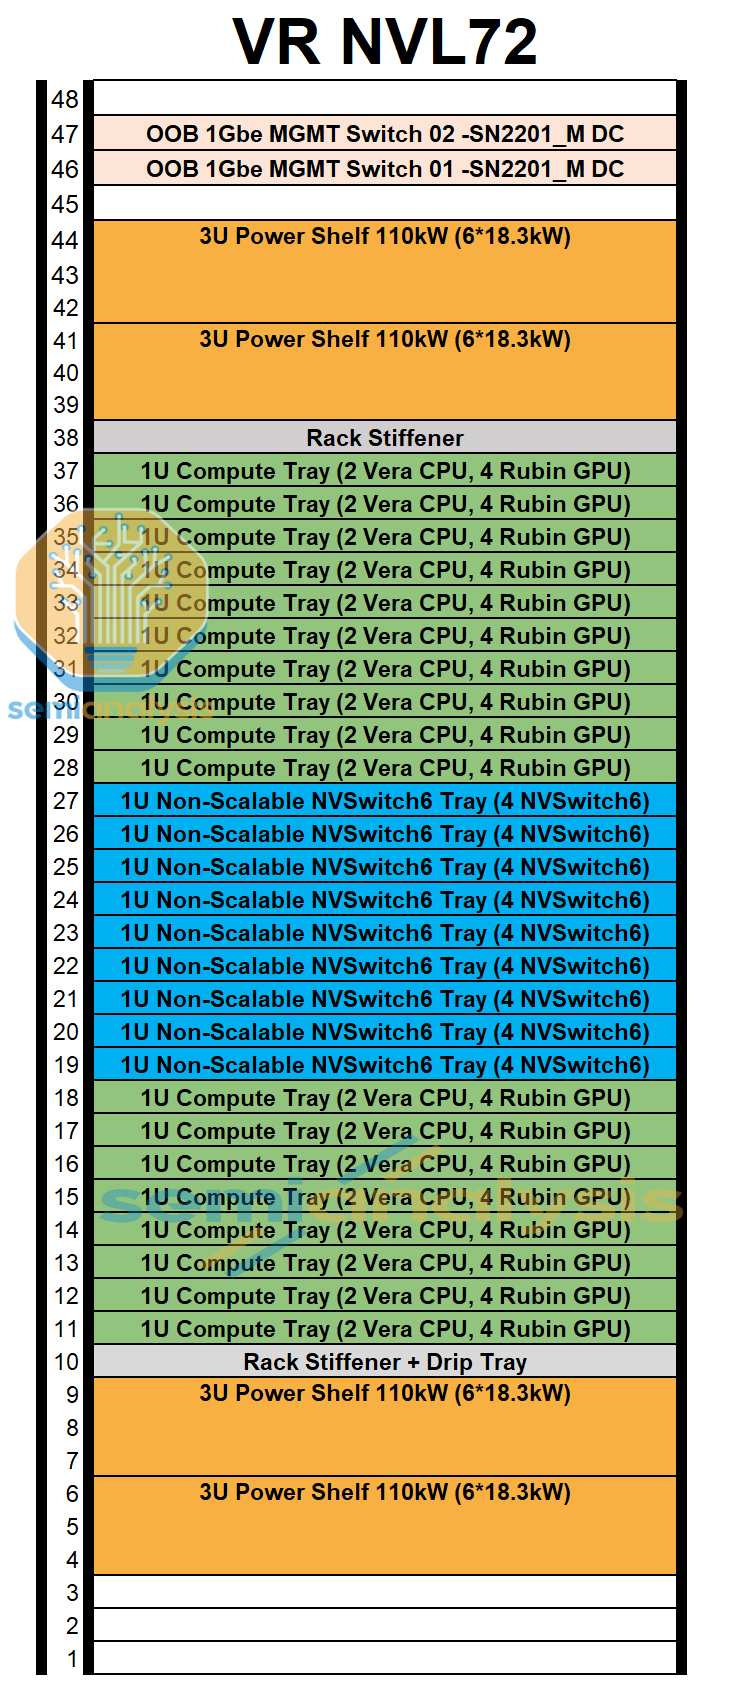
Source: SemiAnalysis VR NVL72 BoM Model
Rubin 芯片级微架构特性简要解析
要全面解析 Rubin 的微架构,我们还需等待获取 Rubin 系统的 SSH 访问权限。届时我们将运行与首次分析 Blackwell 时类似的基准测试。不过,目前仍有一些值得探讨的亮点。
我们预计,Rubin 的上线过程将比从 Hopper 到 Blackwell 的过渡顺畅得多。当初工程师耗费了大量精力,才将计算内核移植到 Blackwell 上。这种顺畅得益于 Rubin 能够在 DeepGEMM、FlashMLA、CUTLASS 等所有重要内核库中,运行 Blackwell 的 SM100 系列内核。而从 Hopper 迁移到 Blackwell 意味着必须从头重写内核。Hopper 的内核根本无法在 Blackwell 上运行。
复用 Blackwell SM100 内核意味着在上市时间上具备明显优势。但为了达到极限性能(SOL),工程师仍需专门针对 Rubin 架构调优和重写内核。不过,内核复用为他们争取了时间,使其能更专注于内核调优工作。
转向架构细节,Rubin 的 SMEM 容量从 Blackwell 的 228 KiB 提升到了 328 KiB。虽然默认 SMEM 容量是 228 KiB,但 Rubin 提供了一种超大共享内存模式,可将容量提升至 328 KiB。此外,TMEM 也从 Blackwell 的 228 KiB 增加到了 256 KiB,这是因为列数从 512 增加到了 576。新增的列可用于存储块缩放因子,同时保证用于累加器的 TMEM 区域与其保持隔离。这极大简化了块缩放内核逻辑:内核编写者无需再小心翼翼地对 MMA 矩阵和块缩放因子的加载进行流水线处理和重叠操作。
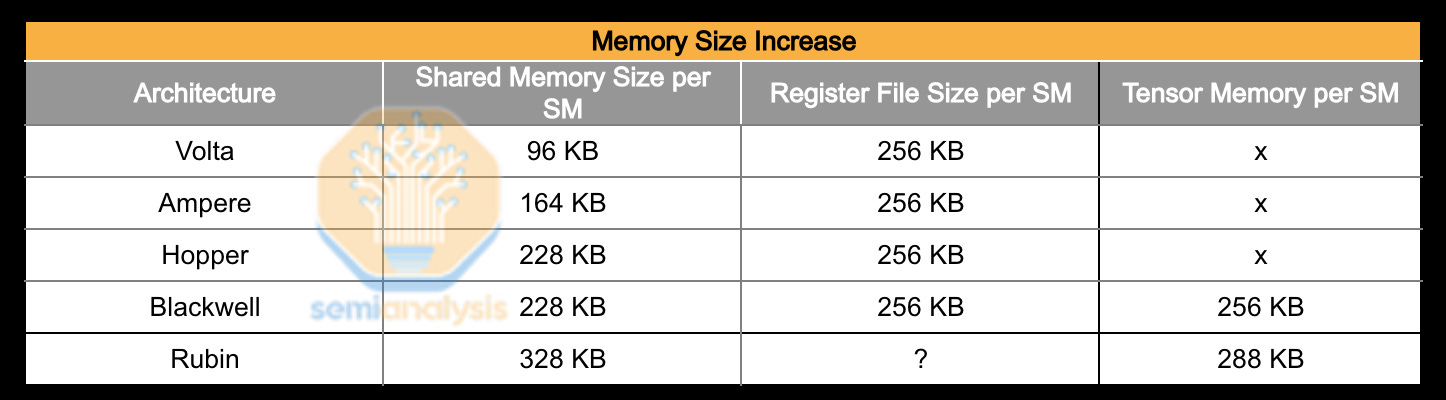
Source: OpenAI
Rubin 的 TMA 现已支持内联描述符更新。这有着众多应用场景。例如,在 MoE 层中,每个专家都是位于 HBM 中各自独立地址上的权重矩阵。因此,每次切换专家时,TMA 描述符都必须指向新地址。在 Blackwell 上,这意味着需要在内存中重写描述符,并在下次加载前进行同步。如今在 Rubin 上,每个专家的偏移量以内联方式传递给 TMA 指令。这样只需一个描述符即可覆盖所有专家,中间无需在内存中重写。这消除了 Token 分发时的开销,并提升了低批次大小下的解码速度。
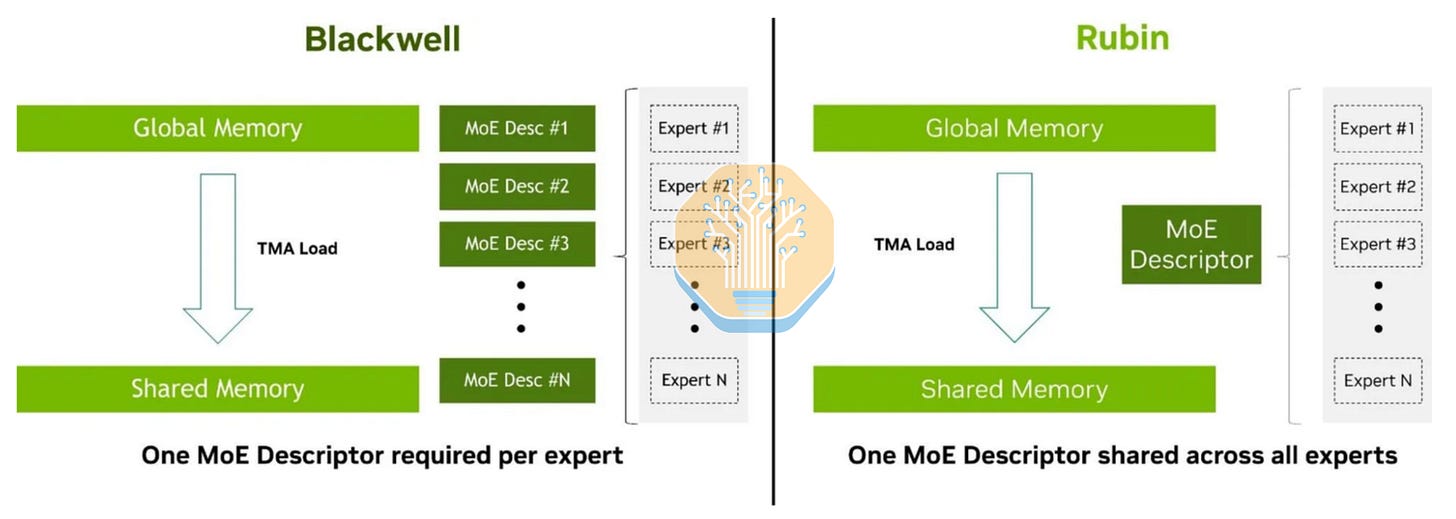
Source: Nvidia
内联 TMA 描述符更新对应于 ISA 特性 .override 限定符。TMA 指令需要一个 tensorMap 对象,用于指定布局和格式等元数据。通过使用 .override 限定符,批量异步拷贝指令可以复用 tensorMap 对象作为模板,同时替换其中的某些元数据字段,例如步长。以 MoE 为例,不同专家的权重具有相同的形状、数据类型和属性。通过覆盖全局地址,kernel 开发者在加载不同专家时,可以避免复制或替换 tensorMap 对象。
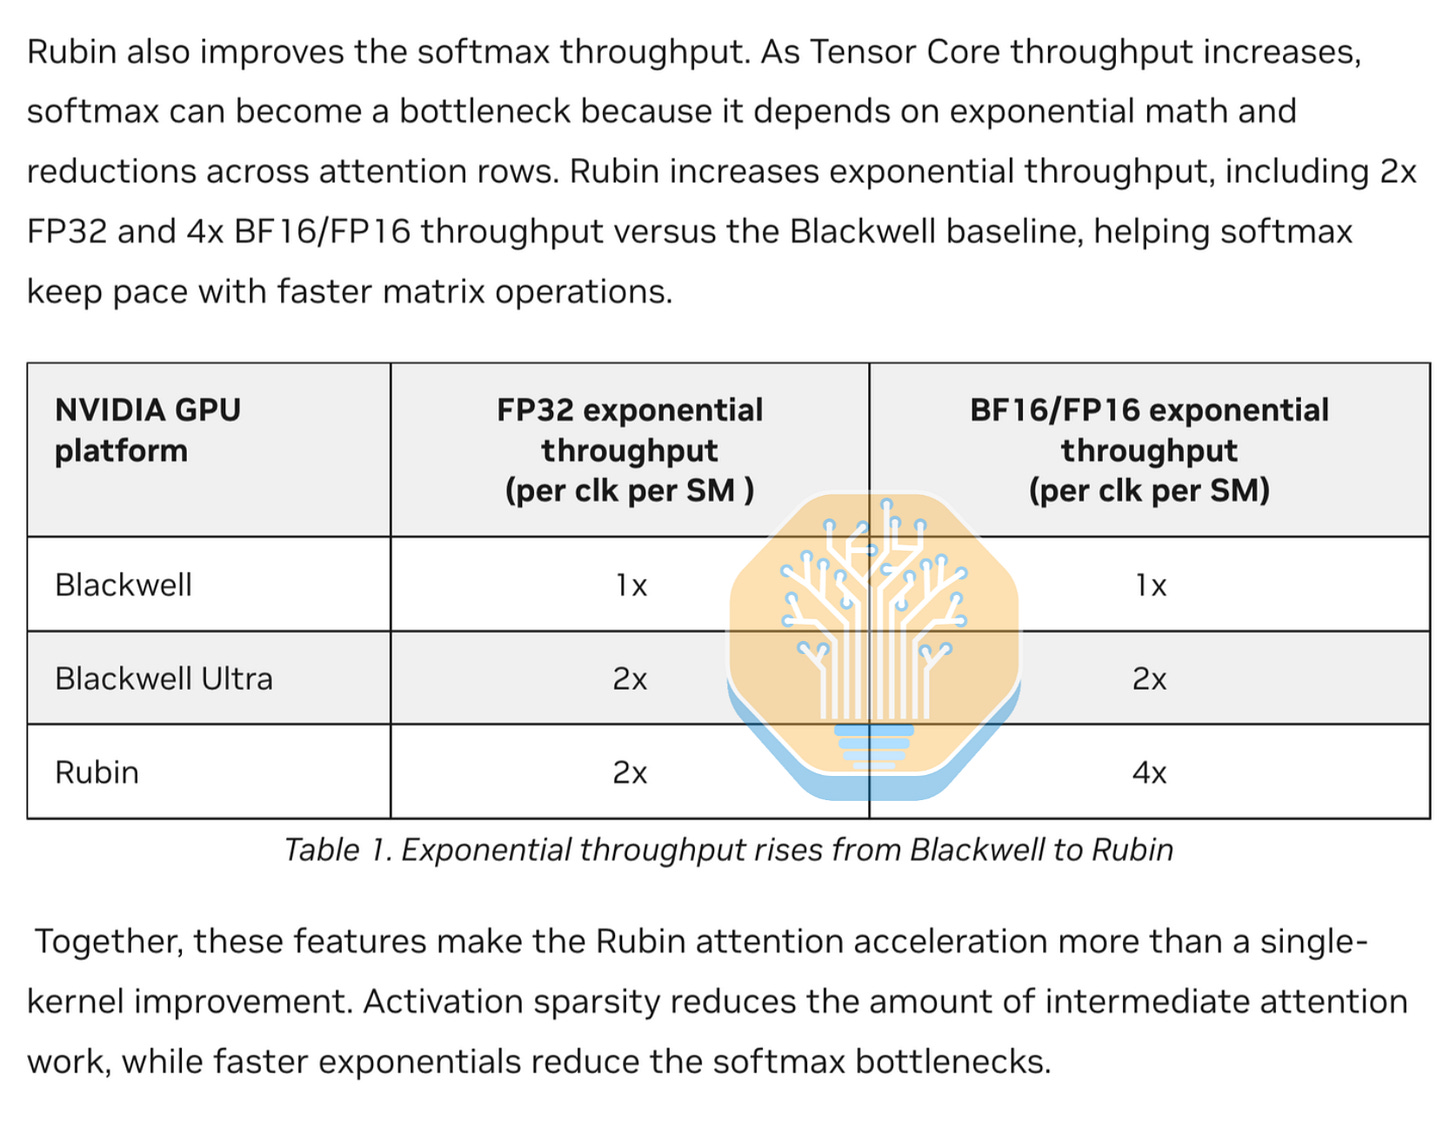
Rubin 再次将每个 SM 每时钟周期的 BF16/FP16 指数运算吞吐量翻倍,这有助于在 attention 计算期间实现 Tensor Core 工作与 softmax 的重叠。FP32 吞吐量与 Blackwell Ultra 相比保持不变。
Source: Nvidia
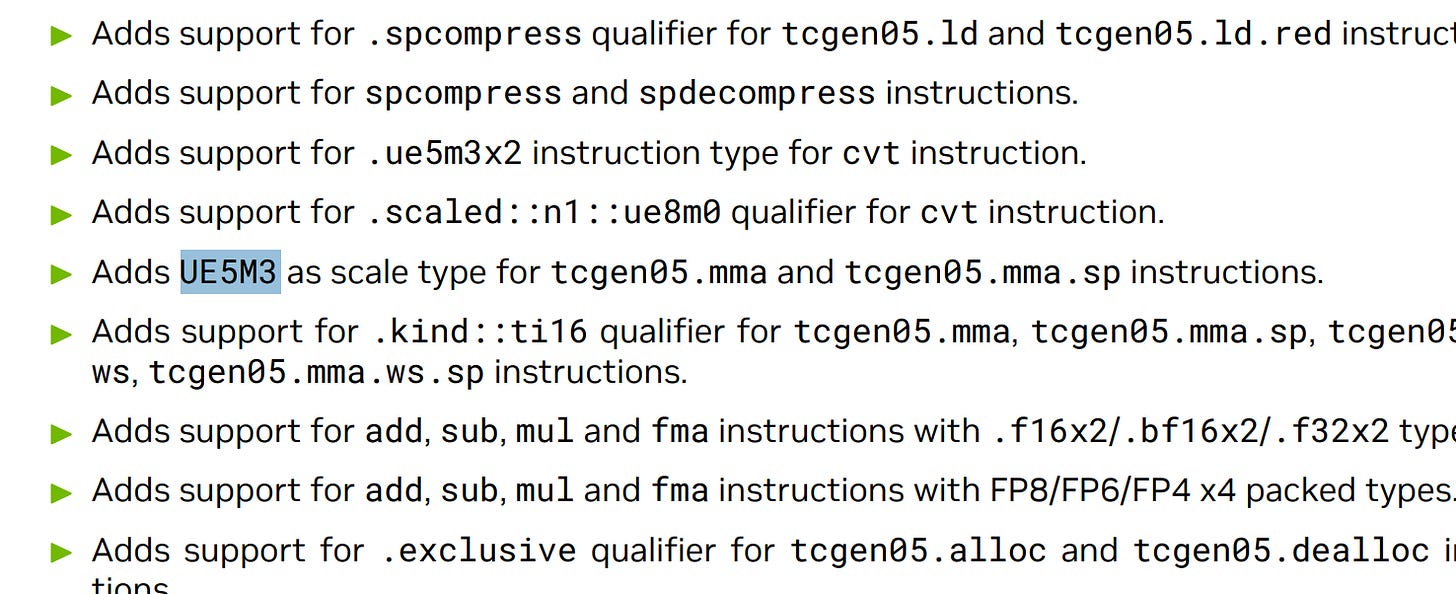
Blackwell 的 NVFP4/MXFP4 Tensor Core 仅支持 UE4M3/UE8M0 块缩放因子格式,而 Rubin 的 Tensor Core 现在也能支持 UE5M3 8 位块缩放因子。这种新增的块缩放格式提供了更高的灵活性,并且由于其具有更宽的数值范围,在某些情况下能够减少量化误差。
Source: NVIDIA PTX
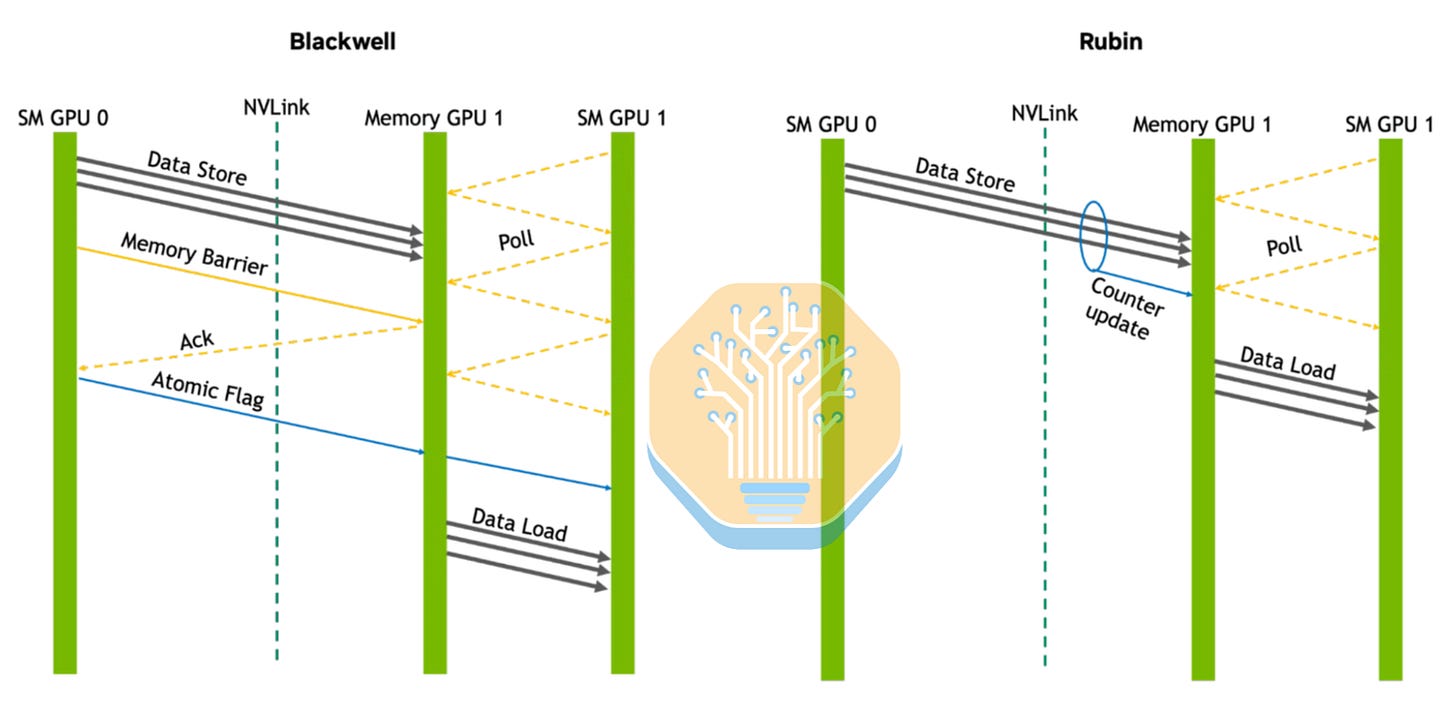
同样值得注意的是,通过使用计数写入,SM 驱动的 NVLink 通信延迟得到了改善。计数写入减少了在铜背板上跨 GPU 传输数据所需的往返消息数量。这一点意义重大,因为 Blackwell 的 NVLink 延迟是 TPU 和 Trainium 的数倍。
Source: Nvidia
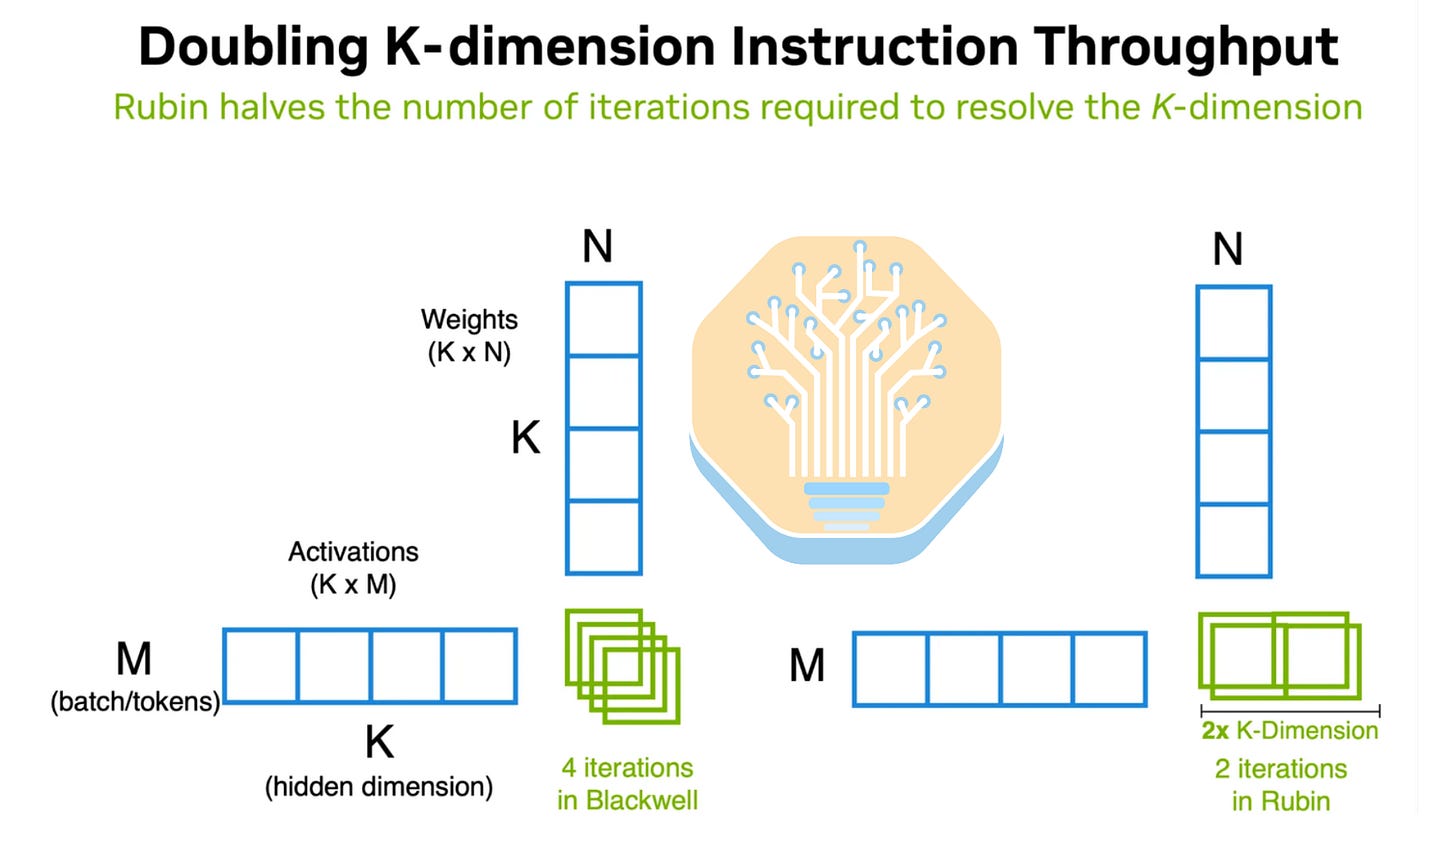
与 Blackwell 相比,Rubin 的 Tensor Core 在 FP8 和 FP4 上的吞吐量翻倍。推动这一性能提升的关键变化是 k 维度翻倍,这意味着从理论上讲,GEMM 执行所需的时钟周期数减半。此外,Blackwell Ultra 中略显别扭的 K=96/3xFP4 指令依然保留,同时还新增了一个 K=128 的变体。
Source: Nvidia
在 Blackwell 中,PDL 允许在网格层级进行重叠,即有依赖关系的网格必须等待上一个 kernel 中的所有线程块执行完毕后才能启动。这种方式能够实现一定程度的重叠,隐藏 kernel 之间执行结束和启动阶段的耗时,但远不及流行的 megakernel 作者们所追求的极致细粒度重叠。而在 Rubin 中,实现了更细粒度的重叠,依赖 kernel 可以在线程块层级与上一个 kernel 进行同步。
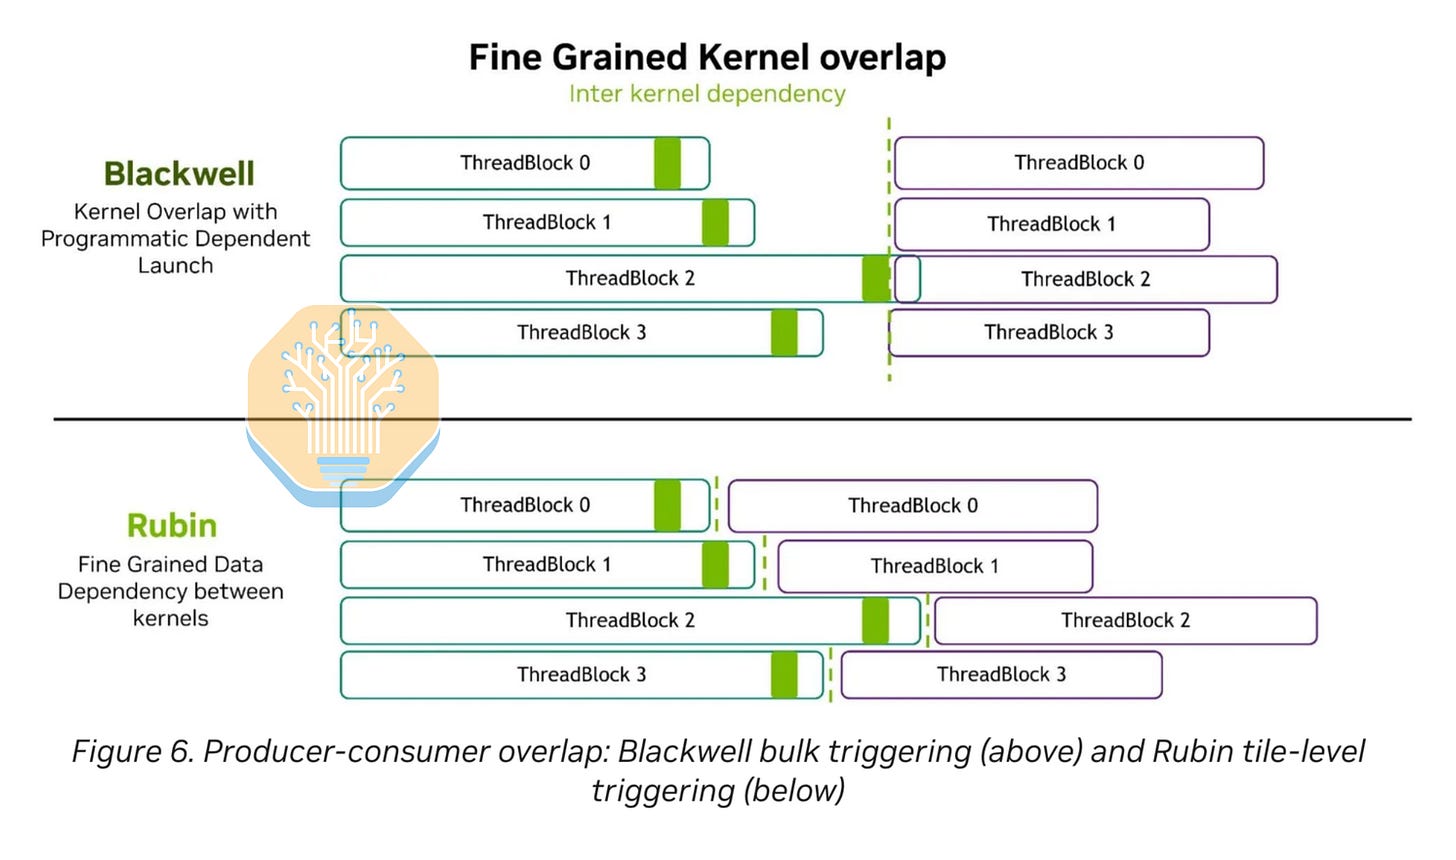
Source: Nvidia
通过采用 3D 堆叠 HBM4 内存,Rubin 的全局内存带宽比 Blackwell Ultra 高出 2.8 倍。Rubin 在内存系统延迟方面不太可能比 Blackwell 有任何改善。我们的 Accelerator & HBM Model 对 Rubin 的内存容量预估和供应商进行了详细的拆解分析。
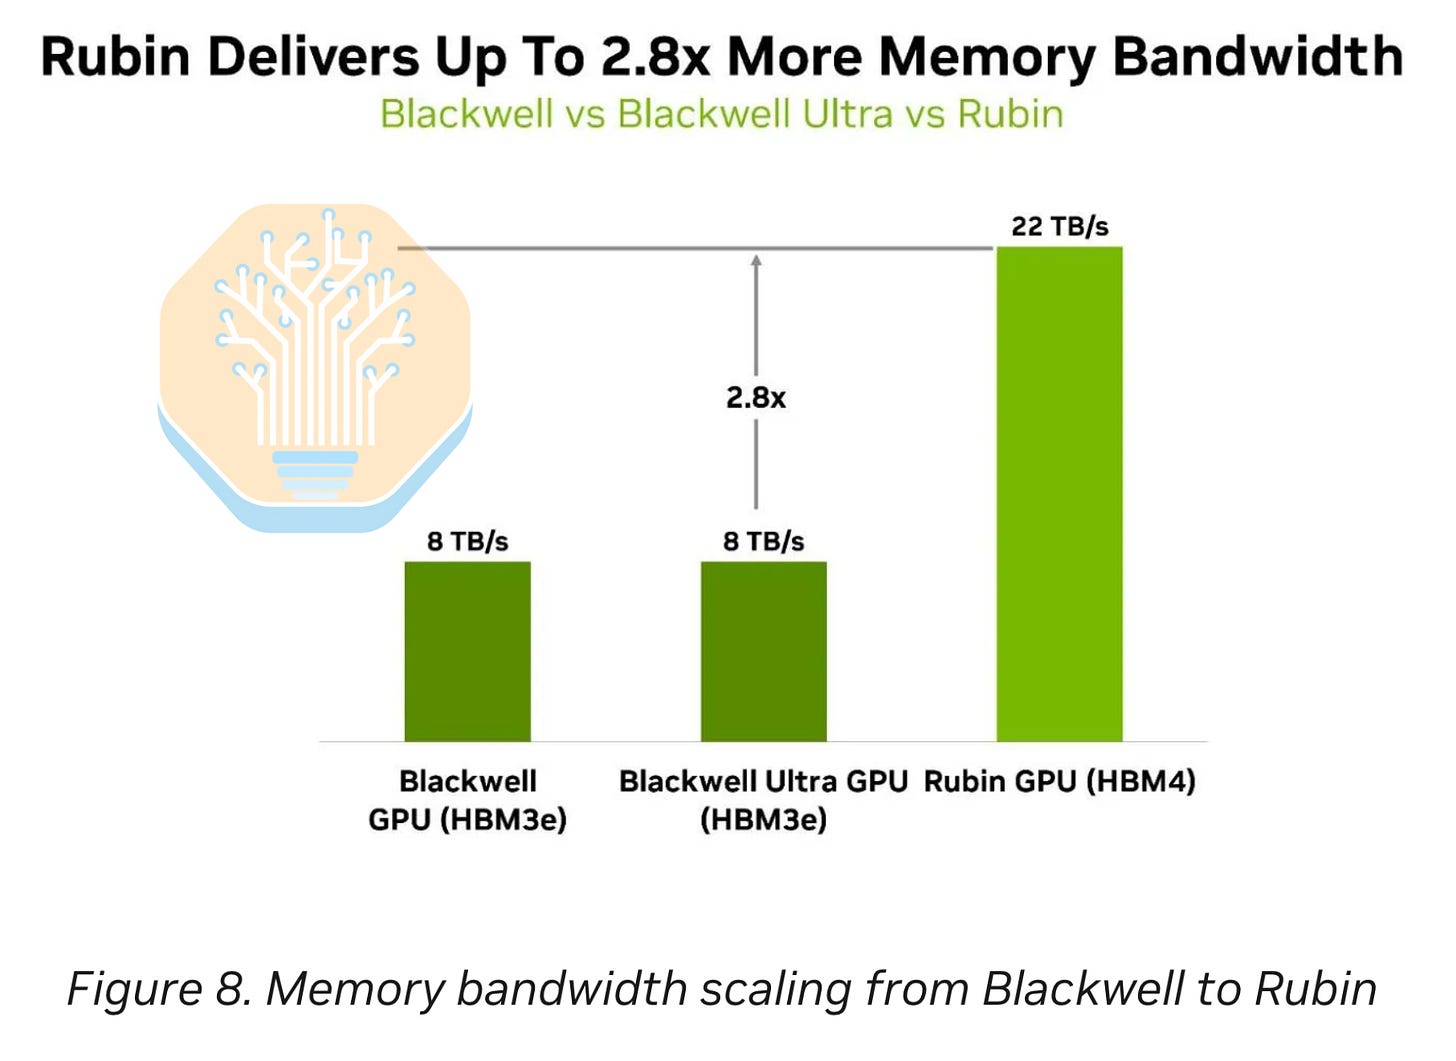
Source: Nvidia
Rubin 为激活值添加了 2:4 稀疏支持。在每四个值组成的一组中,保留两个,置零两个。这种模式是规则化的,因此 Tensor Core 知道哪些值被保留,跳过其余部分,并以两倍速率执行 MMA 运算。一个微小的元数据字段会记录哪些槽位被保留。
Nvidia 早在 Ampere 架构上就推出了针对权重的 2:4 稀疏,但无人问津,因为这意味着需要剪枝模型并重新训练。Rubin 将该机制应用于运行时的激活值,因此无需重新训练。在注意力机制中,QK^T 仍以密集矩阵运算。随后,得分在离开 Tensor Memory 时会被压缩。Softmax 仅处理保留的得分。接下来与 V 的 GEMM 运算则以稀疏方式进行。输出仍保持密集,因此模型的其他部分无需任何改动。该机制同样适用于 MLP 的激活值。
Nvidia 尚未公布精度数据。在 Softmax 之前丢弃一半的注意力得分,其代价显然并非为零。CoreWeave 的 DeepSeek R1 结果似乎也未采用该机制。这使得它成为 Rubin 的又一项功能:目前已有芯片支持,但尚无调优好的计算内核。
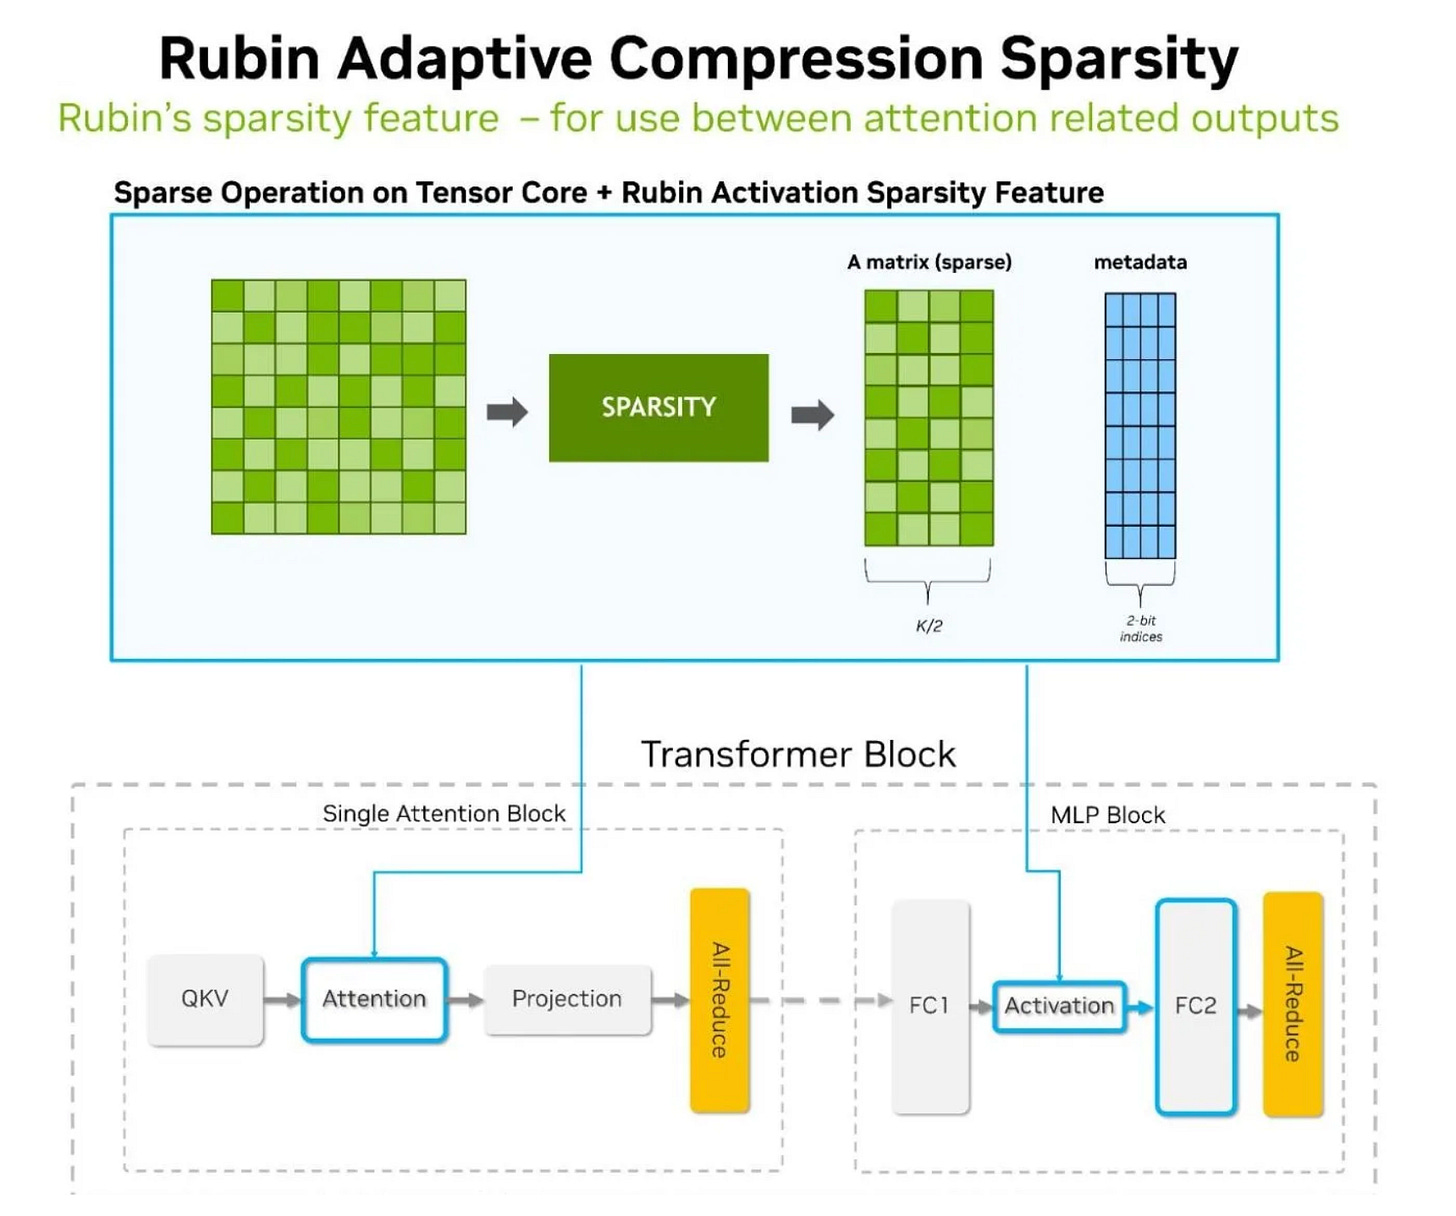
Source: Nvidia
Rubin SM107 Tensor Core 中的查找表权重解压
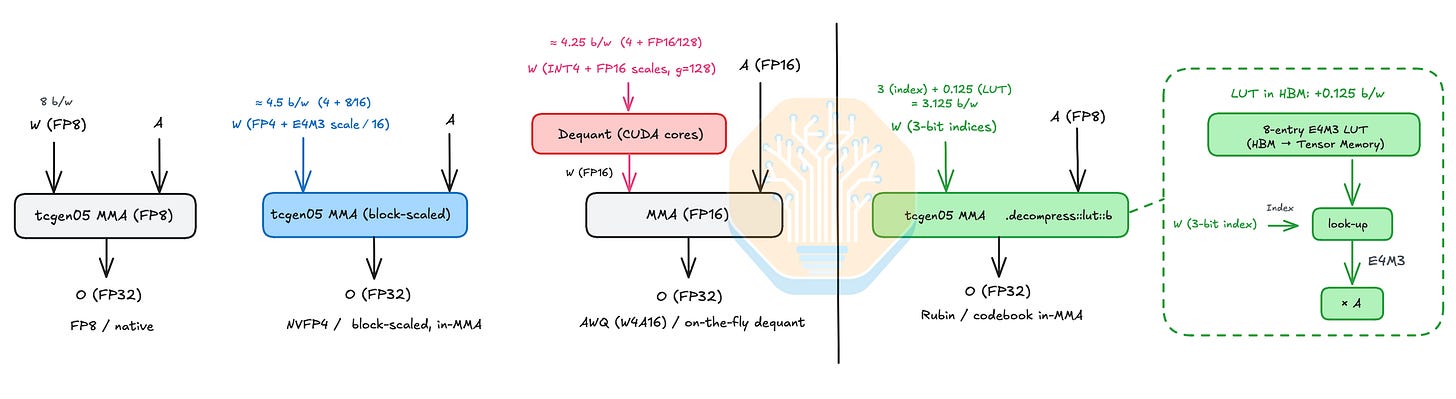
Rubin 新增了 LUT B。这是一种 Tensor Core MMA 模式,可通过查找表解压权重操作数。在该模式下,B 操作数是一个由索引组成的压缩矩阵。在标准的推理 GEMM 中,B 操作数保存的是权重。权重值则存储在 Tensor Memory 的查找表中。Tensor Core 读取每个索引,并在 MMA 内部重建权重值。该过程无需单独的反量化步骤。查找完成后,乘法运算以 FP8 精度执行。
在 LUT B 模式下,每个权重位置存储的是一个 3 位索引,而非完整的数值。该索引会从该权重所在的 8×64 块共享的查找表中,选取 8 个 E4M3 值之一。例如,如果存储的索引为 5,Tensor Core 就会将该块查找表中的第 5 项作为权重使用。查找过程发生在 MMA 内部。因此,内核无需构建单独的解压权重矩阵。
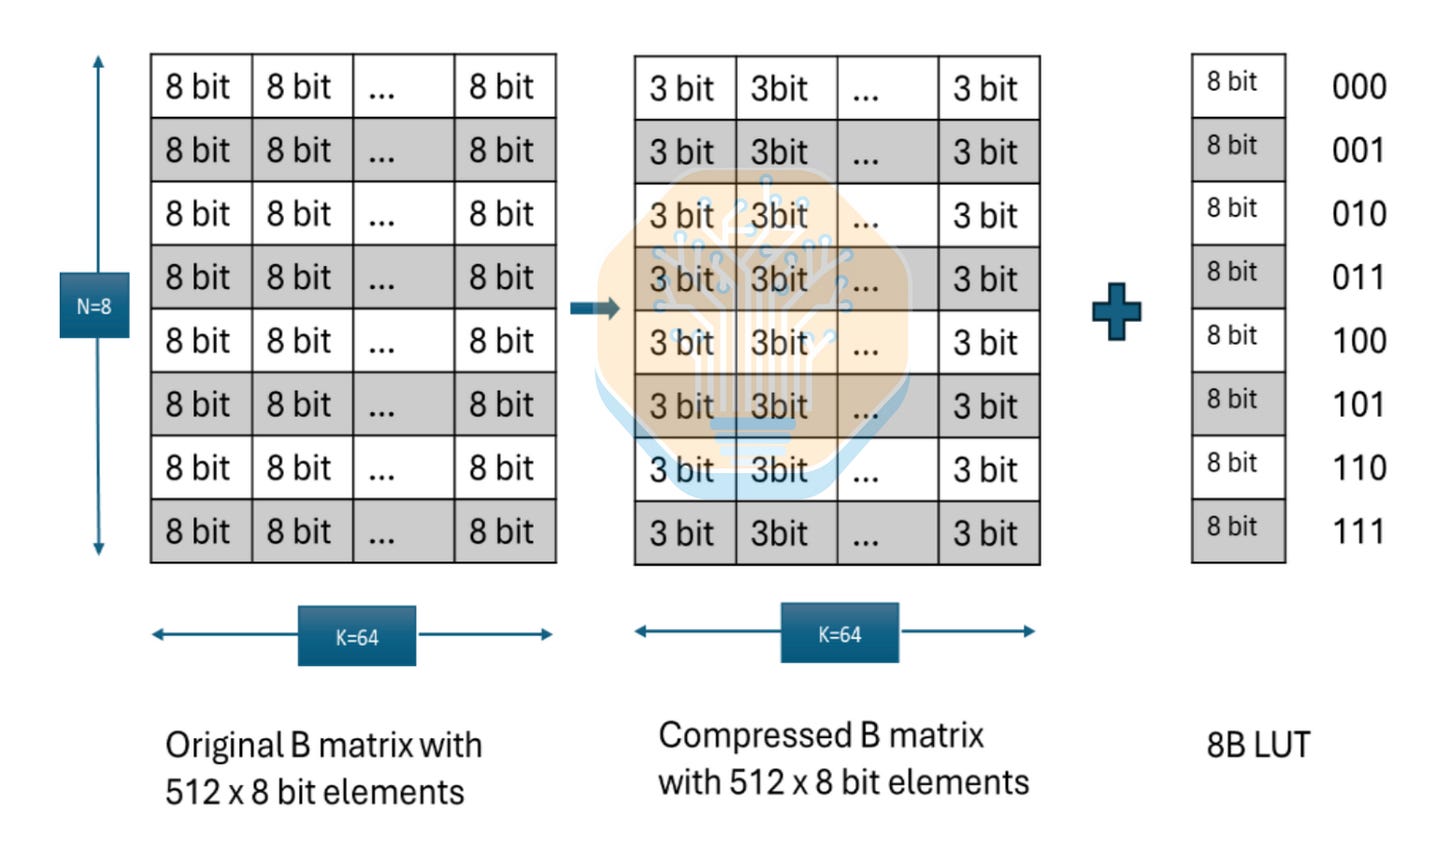
Source: Figure 280, Nvidia
查找表(LUT)无需遵循传统均匀网格或浮点网格的间距。因此,量化算法可以在权重的密集簇附近放置更多值。也可针对长尾分布采用非均匀间距。或者,当正负权重分布不同时,选择非对称码本。
这种灵活性带来了提升每位存储精度的可能。Rubin LUT B 的独立编码数量少于 FP4。但它可以将这些编码放置在特定权重组所需的位置,而不必接受 E2M1 的固定比例。然而,它并不一定比 MXFP4 或 NVFP4 更精确。一个码本由 512 个权重共享。而 NVFP4 则在更小的 16 个权重组上调整其缩放比例。最终结果将取决于码本拟合算法、校准数据、量化感知训练,以及敏感层是否保持更高精度。
每个索引占 3 位。查找表则包含 8 个条目。在参考内核中,每个条目占一字节,即一个 E4M3 8 位浮点数。由此可得,每个权重占 3.125 位:其中 3 位用于索引,另有 64 位的码本开销分摊至 512 个权重上。码本与索引一同存储于 HBM 中。因此,每个权重 3.125 位即为完整的存储占用。
该指令将压缩后的权重加载到收集器缓冲区中。Tensor Core 可以将其保存在那里,并在一组激活块的运行过程中重复使用。这是一种权重驻留模式。该模式也存在局限性,不支持 B 矩阵转置。
块缩放格式 NVFP4 和 MXFP 同样在 MMA 内部进行解压。但它们对每个块应用一个统一的缩放因子,而不是码本。AWQ 等软件方法通过在矩阵乘法之前执行单独的反量化步骤来实现低比特量化。Rubin 是首个在 MMA 内部重构非均匀码本的 NVIDIA Tensor Core 输入格式。
Source: SemiAnalysis
较低的比特率减少了权重所需的 HBM 容量。同时也减少了 GPU 读取每个权重所需的字节数。在低批量大小下,权重带宽限制了解码步骤。因此,每个权重的字节数减少,提升了解码吞吐量。在相同比特数下,非均匀码本也比均匀舍入能更好地保持精度。此特性也会影响功耗效率,因为每次浮点运算中需要通过内存系统传输的比特数更少了。
以 Kimi K3 2.8T 为例,在每权重约 4.5 比特的情况下,MXFP4 存储需要 2.8e12 x 4.25 / 8 = 约 14875 GB(此处 GB = 1e9 字节)。在每权重 3.125 比特的情况下,Rubin 查找表格式存储需要 2.8e12 x 3.125 / 8 = 约 1094 GB(约 1.09 TB)。两者相差约 393.5 GB。这些数据仅涵盖原始权重负载,不包括 KV 缓存、激活值以及任何并行复制开销。以每个 Rubin 封装配备 288 GB HBM4 计算,仅权重部分在 NVFP4 下需要约 6 个封装,而在新的 Rubin 格式下需要约 4 个封装。
Feynman 架构抢先看
从 Blackwell (SM100)/Blackwell Ultra 到 Rubin (SM107),微架构层面的跨度相对较小。因此,Rubin 可以被视为 Blackwell 的小幅升级架构。相比之下,Feynman (sm_140) 是一个全新的架构家族。这意味着从 Rubin 到 Feynman 需要重写大量内核,这与从 Hopper WGMMA 到 Blackwell tcgen05 的情况类似。我们的加速器与 HBM 模型提供了 Feynman 逐季出货量估算的完整分解。
Feynman 的 3D 堆叠技术将与 AMD 自 MI300X 和 CDNA3 以来采用的 3D 堆叠类似。
Feynman 架构的新特性之一是包含感知稀疏性的数据移动操作。这些操作可用于稀疏 GEMM 中,通过避免无意义的加载、存储和 FMA 来提升性能。
CoreWeave VR NVL72 结果的细节解析
昨天,CoreWeave 发布了 Vera Rubin NVL72 的推理基准测试结果,以单位功耗(MW)下的性能(tokens/sec)作为衡量单位。我们将拆解其数据中的细节,并以我们自己的 InferenceX 2026 年 7 月结果作为基准,将其与 Blackwell 的性能进行对比。
Source: CoreWeave
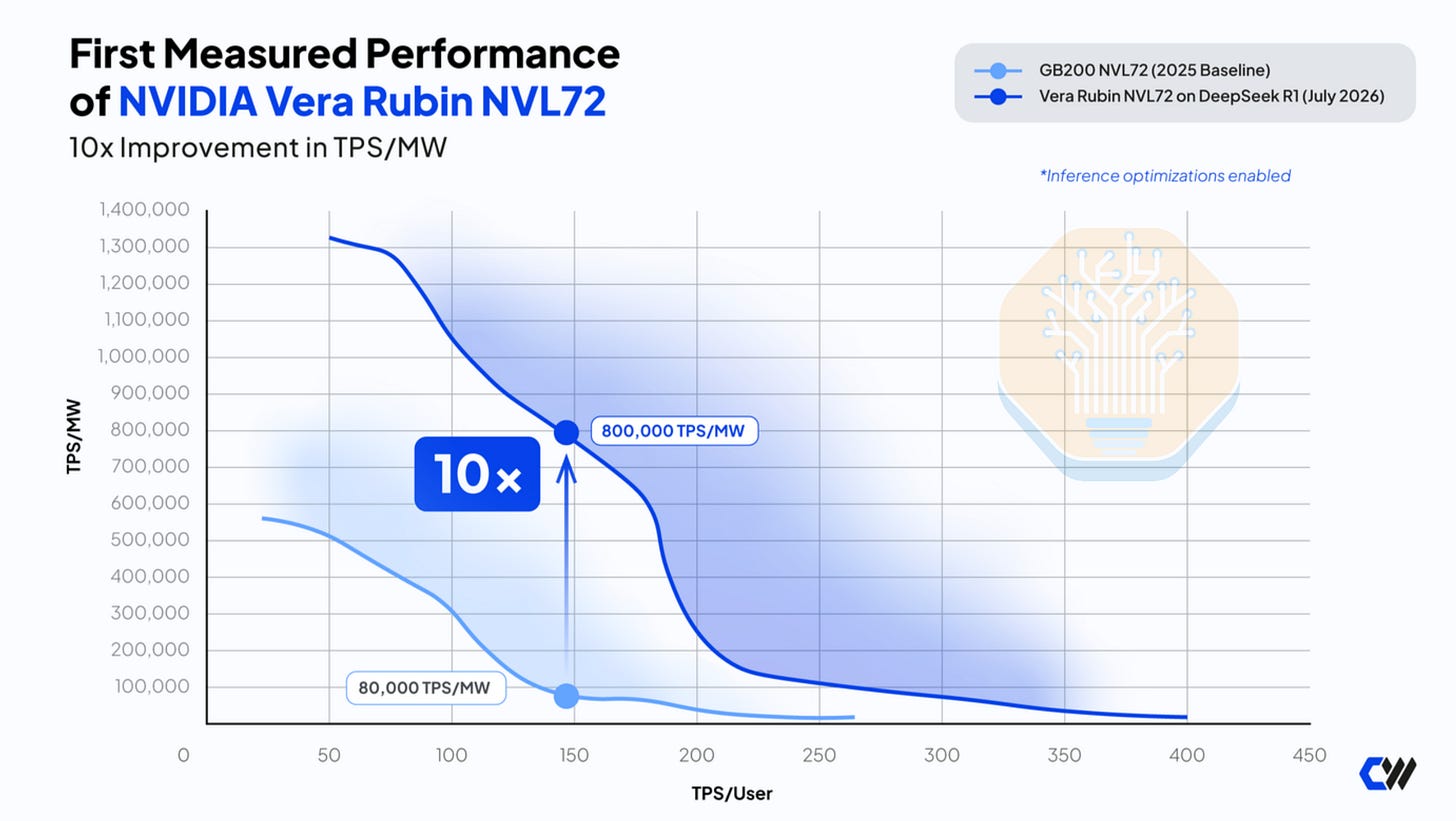
在 CoreWeave 与 Nvidia 发布的图表中,首个引人注目的结论是:在每用户约 150 tok/s 的同等交互体验下,VR NVL72 的每兆瓦 token 吞吐量比 GB200 NVL72 高出 10 倍。这比目前前沿模型的“快速模式”快了约 50%。
关于这张图表,有几点需要说明。该基准测试为单轮测试,输入 8k,输出 1k。纵轴是每兆瓦的输出 token 吞吐量,而不是总吞吐量。此外,他们的功耗数据包含了预填充和解码 GPU 的总功耗,但统计的却只是输出 token。InferenceX 在衡量输出吞吐量时仅计算解码 GPU 的功耗,因此我们重新对数据进行了归一化处理,以便与他们进行对比。
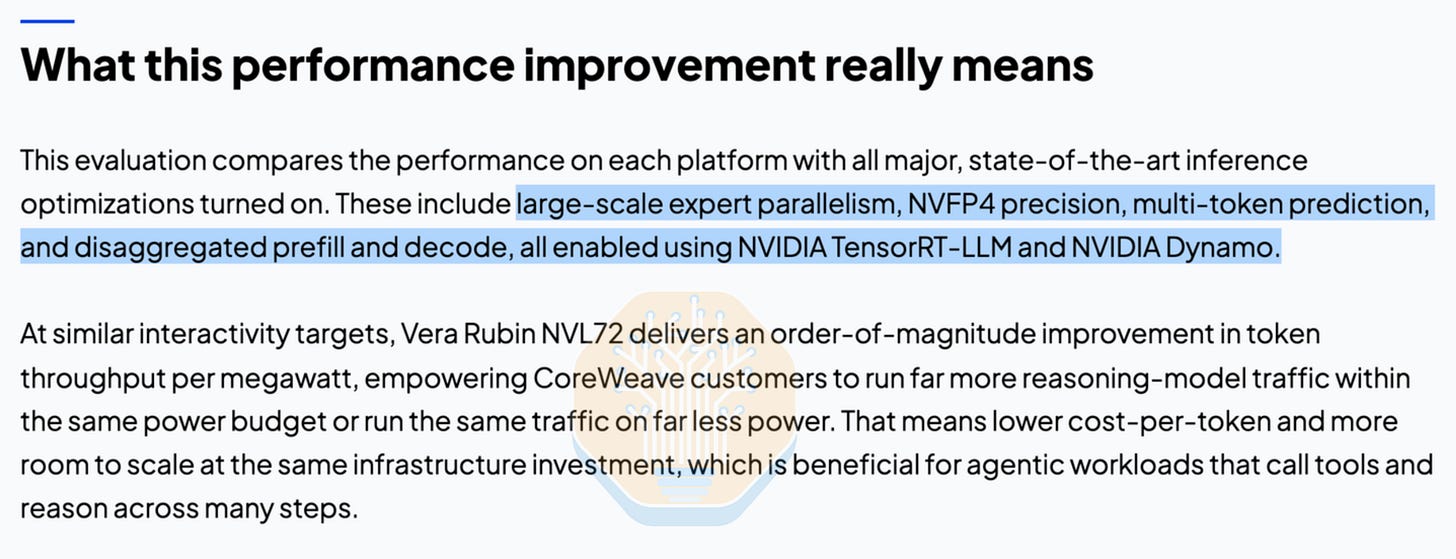
需要特别指出的是,CoreWeave 声称在其 GB200 NVL72 基线和 Rubin NVL72 的性能结果中,均启用了以下所有推理优化措施,包括但不限于:
- NVFP4 精度
- 投机解码(使用 MTP)
- 分离式服务(使用 Dynamo)
- 宽专家并行
- 通过 TensorRT-LLM 实现
Source: CoreWeave
上述结果似乎表明,Rubin 在问世之初就比 Blackwell 实现了显著的性能提升。然而,其中有一些细节值得深入探讨。
首先,细心的读者会注意到,CoreWeave 是将 Rubin 与 2025 年的 GB200 NVL72 基线进行对比。从某种意义上说,将 Rubin 与 GB200 NVL72 生命周期早期的性能进行对比是公平的,因为 Rubin 在自身生命周期早期的性能也有望得到大幅提升。我们的分析同样会采用 2025 年 GB200 NVL72 的早期性能数据,但我们也会对比 GB200 NVL72 到 2026 年时的表现,以及目前最值得对比的 GPU:GB300 NVL72。我们将直接把 2026 年初 GB300 NVL72 的性能与 Rubin 同等生命周期早期的性能进行对比。
Source: CoreWeave
CoreWeave 性能结果的第二个细节是,他们使用的是 DeepSeek R1 671B,这已经是一款不再被广泛使用的模型。人们或许希望 CoreWeave 能使用更现代的模型,比如 GLM5.2、Kimi K2.5、Qwen3.5 或 DeepSeek V4。更好的选择是即将在 InferenceX 上线的 Kimi K3 或 Qwen3.8!至少 CoreWeave 没有像 AMD 那样,在 2026 年夏天为 MI455X UALoE72 性能指标测试时使用 GPTOSS 120B。我们预计,一旦 Nvidia 在 2026 年第三季度通过 InferenceX 使用更现代的模型架构对 Rubin 进行基准测试,这种因测试旧模型而引发的迷雾终将消散。
颇为奇怪的是,CoreWeave 选择使用 DeepSeek R1 671B 在理论上对 Blackwell 基线更有利,而非 Rubin。Rubin 的主要优势在于更高的 HBM 容量、更大的 CPU DRAM 容量以及更高的 HBM 带宽。这意味着 Rubin 针对万亿参数级别的模型进行了更充分的优化,例如 Fable 5、Gemini Pro、Kimi K3 和 Qwen3.8 2.4T。
第三个值得注意的点是,CoreWeave 仅使用了单轮 8k/1k 输入/输出 token。理论上,像 Agentic Coding 这样的多轮长上下文工作负载应该在 Rubin 上表现更好,因为 Rubin 拥有更高的 HBM 容量和带宽,但这在简单的单轮基准测试中无法体现。我们即将推出的 AgentX 基准测试场景是与 Weka、LMCache、vLLM/SGLang 社区、Nvidia、AMD 以及社区中的许多其他参与者共同创建的,将提供一种真实的智能体工作负载来评估推理性能。我们鼓励大家采用这套推理基准测试!
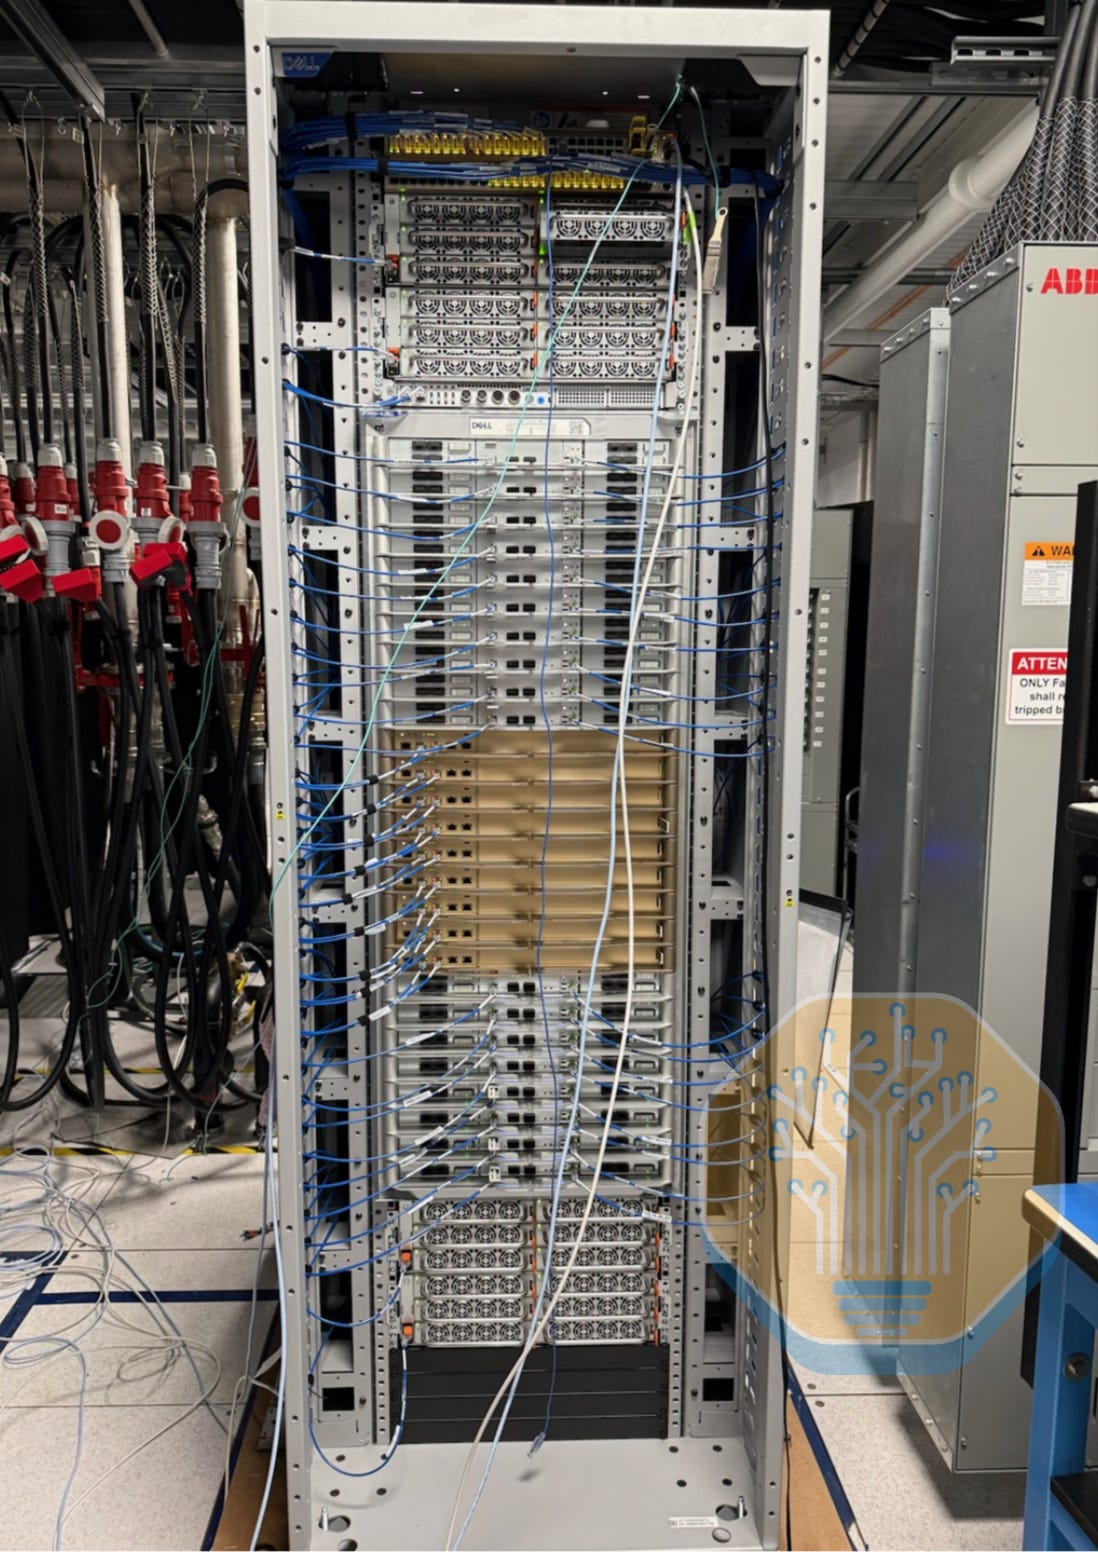
最后,我们注意到 CoreWeave 的测试是在一台没有扩展网络的预生产机架上完成的。具体来说,CoreWeave 使用的是 Dell 工程样机(ES)机架。我们确实认为这些结果很有价值,因为它们使用了宽 EP 和 PD 分离架构,这依赖于 NVL72 纵向扩展背板,并证明了该背板运作良好。正如我们在 Accelerator 模型中提到的,在 GB200 NVL72 Oberon 规模化量产期间,这款背板曾面临许多可靠性挑战。
Source: CoreWeave
Rubin 与 Blackwell 的每兆瓦性能对比
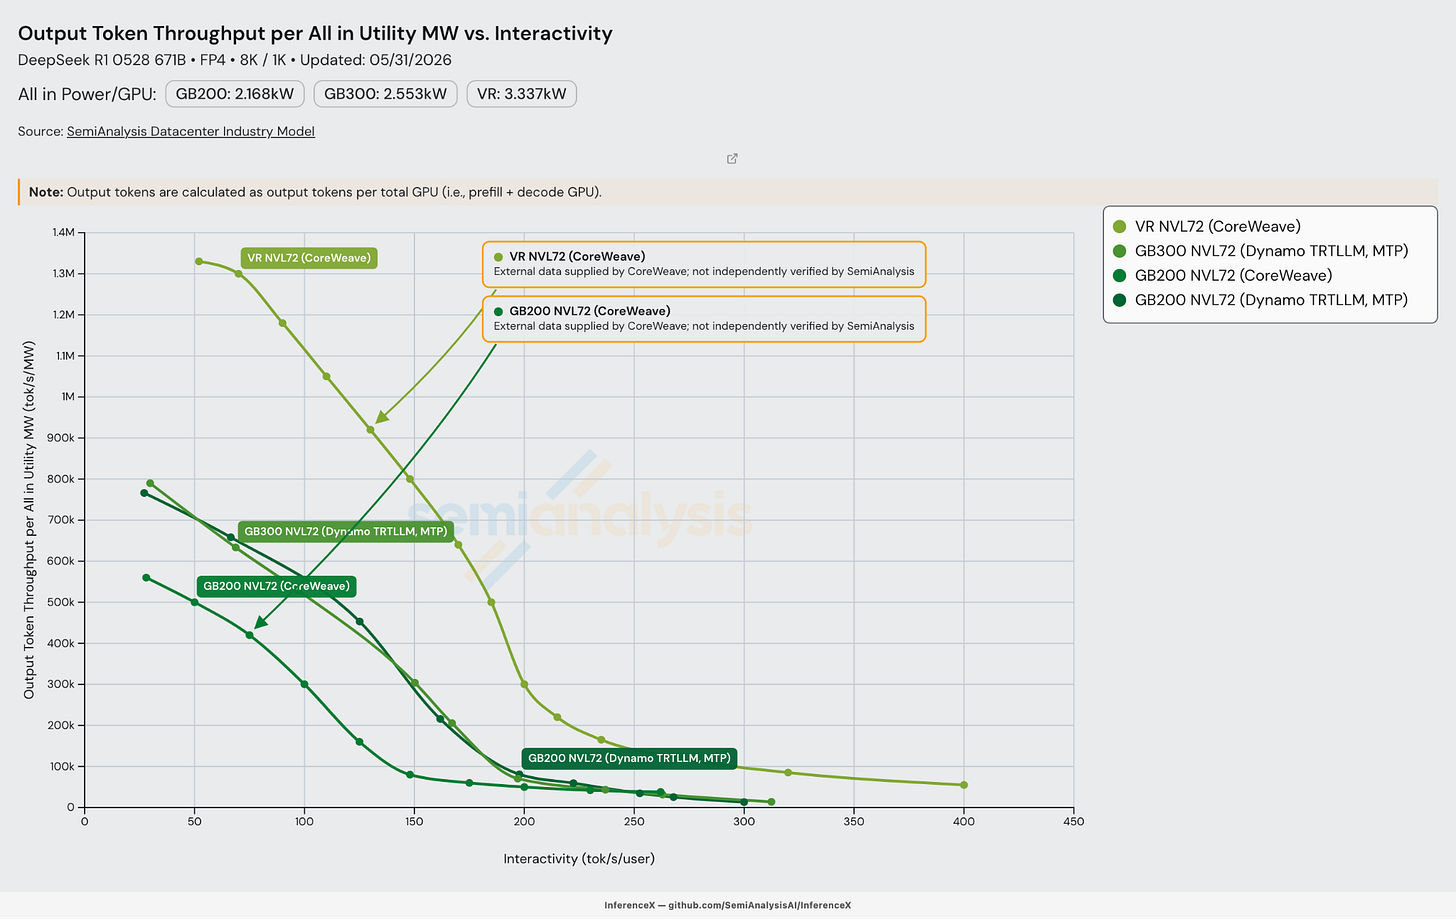
Nvidia 选择主推的指标是“每整体电网兆瓦的每秒输出 token 数”,这里统计了系统中的所有 GPU。为了进行公平对比,我们将自己的 InferenceX 基准测试数据重新换算到了相同的总 GPU 基准上。下文将 VR NVL72 与我们官方的 GB200 和 2026 年 7 月的 GB300 基准测试,以及 CoreWeave 的 2025 年 GB200 基准进行了对比。
Nvidia 图表中那些引人注目的倍数均来自于 2025 年的基准数据。在比较基准测试数据时,我们认为应该使用相同时期的测试结果,因此 2026 年 7 月的 GB200 和 GB300 基准测试是更有参考价值的对比对象。
理论上,Vera Rubin 的数据中心 PUE 可以更低,因为在定制的无冷却器数据中心中,它可以在 45 摄氏度的冷却液温度下运行。然而,在我们的对比中,由于大多数数据中心的设计都需要兼容多种不同的系统,因此我们对采用 DLC 冷却的芯片使用了相同的 PUE。
下面的 Pareto 曲线绘制了每个总 GPU 兆瓦的输出吞吐量与交互性之间的关系。每条线在其对应的配置方案达到性能极限处停止。
Source: SemiAnalysis
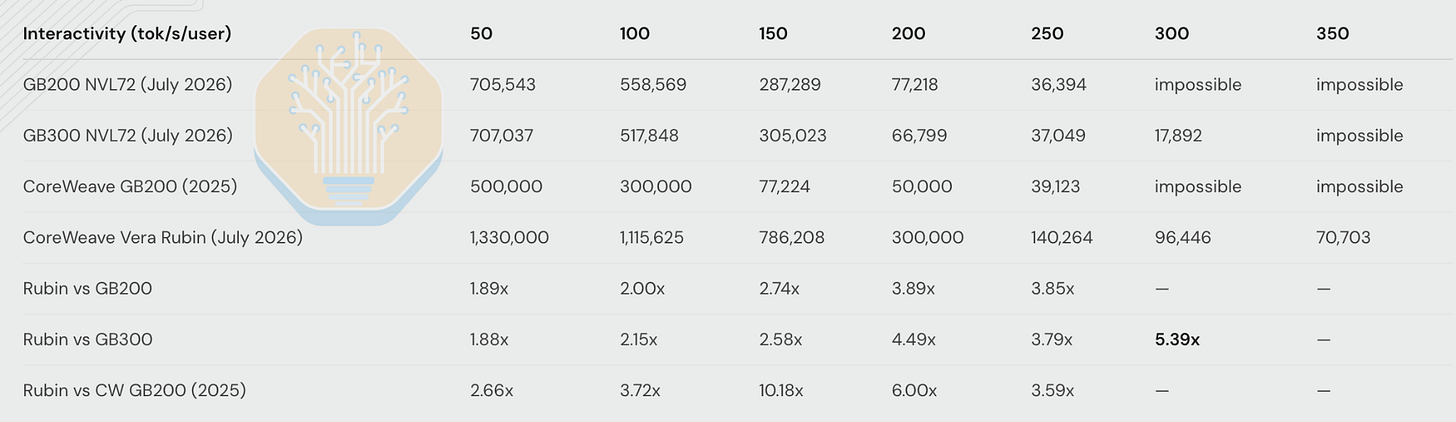
接下来,我们以表格形式提供相同的数据。当某个单元格显示“impossible”时,意思是该交互性已超出了对应方案的性能极限,根本无法在该速度下支撑该工作负载的配置。
Source: SemiAnalysis
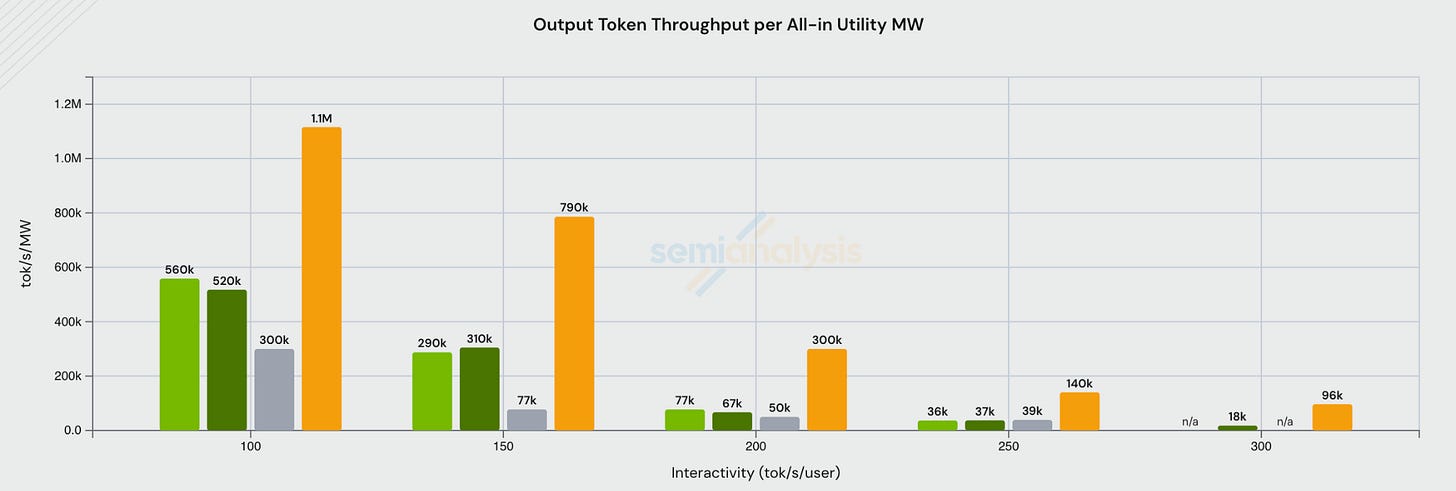
这是以柱状图形式展示的相同性能极限,覆盖了每用户 100 到 300 token/秒的区间。所有四种方案都有达到 250 token/秒的数据,而只有 Rubin 和 GB300 能够达到 300 token/秒。

Source: SemiAnalysis
首先,让我们将 Rubin 与 2026 年 7 月的 GB300 NVL72 基准进行对比。在低交互度下,Rubin 的领先幅度最小。随着交互度曲线向中间推进,其领先优势持续扩大。当每用户吞吐量达到 100 tok/s 之前,Rubin 的吞吐量接近 Blackwell 的 2 倍。在 200 tok/s/user 附近,该差距达到峰值,扩大到约 4 倍。随后,差距再次开始缩小。在 300 tok/s/user 时,Rubin 相比 GB300 取得了 5.4 倍的性能提升。这一标题性数据并非因为 Rubin 进一步拉大了领先优势。相反,这是因为 GB300 运行在其性能极限的最后一个勉强可行的点上,导致比值激增。而 GB200 根本无法达到 300 tok/s/user 的速度。随着高交互度下批处理规模缩小,Blackwell 的单 GPU 吞吐量迅速下降。此时,Rubin 仍处于其性能前沿曲线上较为平缓的区段。
将 Rubin 与 2025 年的 GB200 NVL72 基准进行对比,情况则有所不同,其最大的领先优势出现在曲线中段。在低速度下,差距不到 3 倍。在 150 tok/s/user(Nvidia 在图表中重点标出的点)时,差距扩大到约 10 倍。随后在 200 tok/s/user 附近,差距又回落到 6 倍。该曲线数据是准确的。但正如我们之前提到的,它使用的是一年前的软件栈,而不是你今天会运行的 GB200。
在交互度范围的最顶端,Blackwell 的曲线急剧下挫。到 350 tok/s/user 时,GB200 和 GB300 都完全无法处理这些工作负载。此时仅剩 Rubin 保留着实际的性能曲线。它在 300 tok/s/user 时实现了 96,446 tok/s/MW 的能效,在 350 tok/s/user 时则为 70,703 tok/s/MW。
显然,相比 Blackwell,Rubin 将为我们带来多得多的“快速模式”。
Rubin 与 Blackwell 的单位 TCO 性能对比
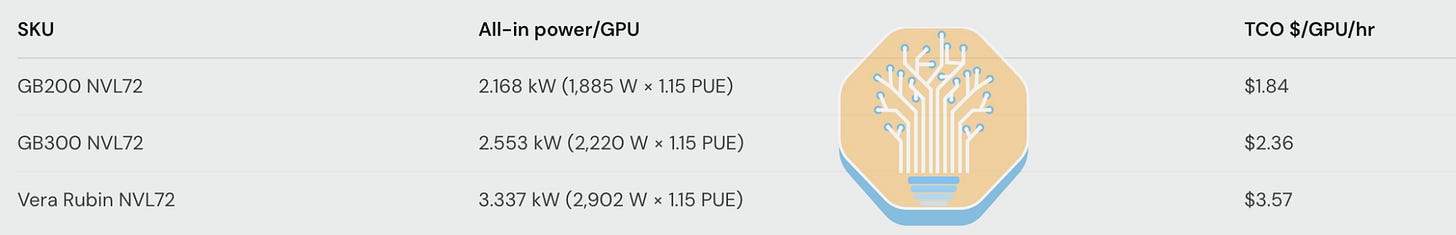
每兆瓦性能仅衡量了性能与功耗的关系。而每百万输出 Token 成本则纳入了硬件的总拥有成本(TCO)。这包括 IT 资本成本,以及电力和数据中心成本。我们的 TCO 模型对此进行了全面拆解,详细提供了各代服务器的资本成本和运营成本。在这里,我们将每个 SKU 的综合 TCO 除以相同的重归一化输出吞吐量,因此数值越低越好。在运营商自持场景(非租赁价格)下,Rubin 的单 GPU TCO 高于 Blackwell。其单 GPU 小时成本为 3.57 美元,而 GB200 为 1.84 美元,GB300 为 2.36 美元。下文的图表和数据表将显示,Rubin 在单位 Token 成本上的领先幅度,会略小于其在每兆瓦性能上的领先幅度。
Source: TCO Model
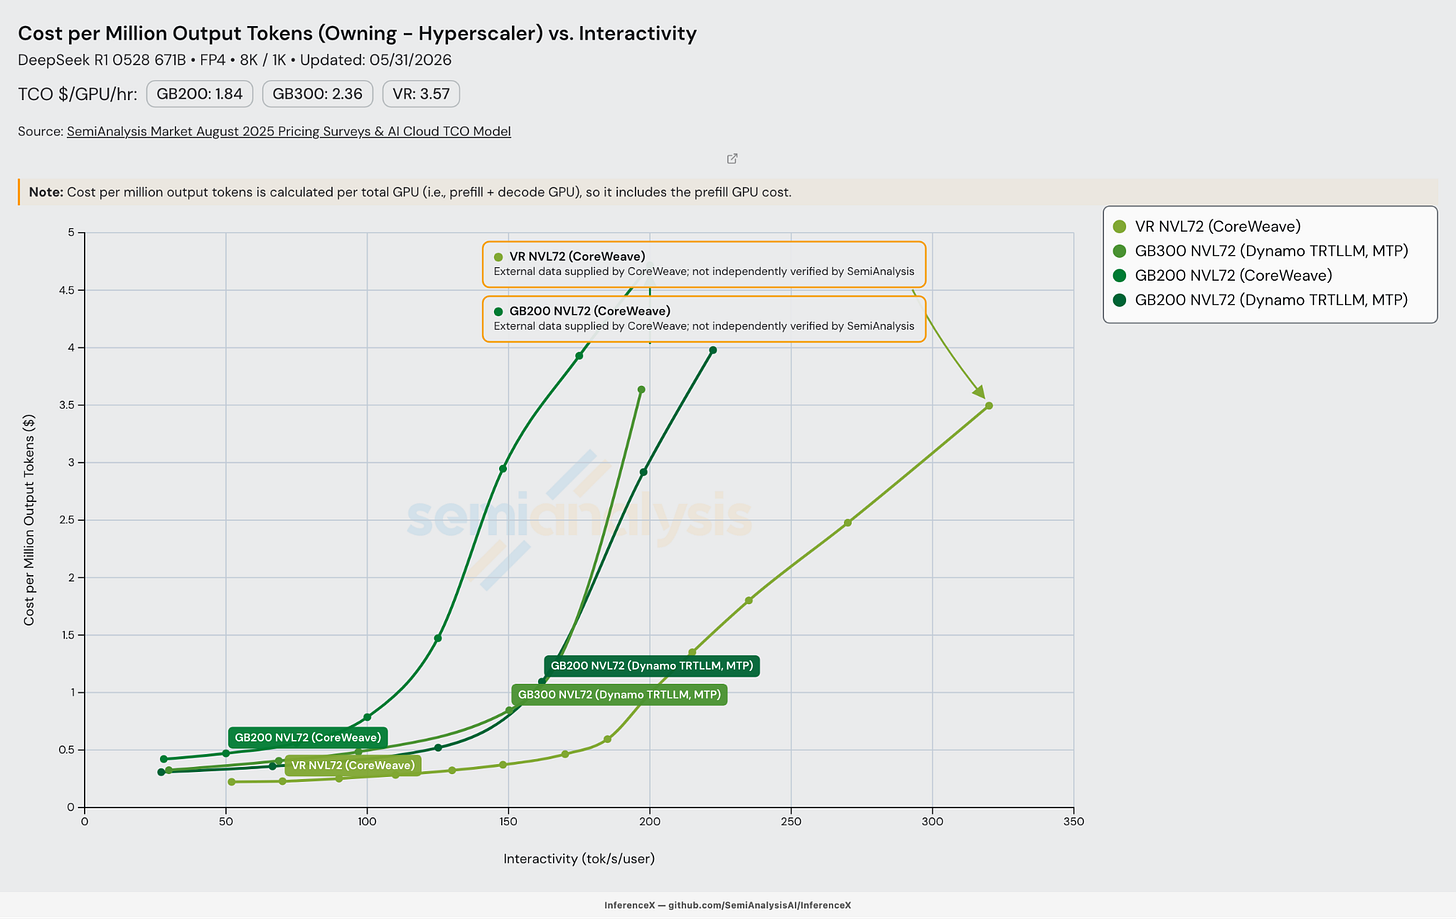
与每兆瓦分析一样,以 2025 年的 GB200 为基准时,Rubin 展现出的性能提升最大。但对于今天正在采购算力的人来说,2026 年 7 月的 GB200 和 GB300 数据才是更具参考价值的对比基准。
下方的 Pareto 曲线绘制了每百万输出 Token 成本与交互度的关系。每条线均终止于其配置方案性能极限的尽头。
Source: SemiAnalysis
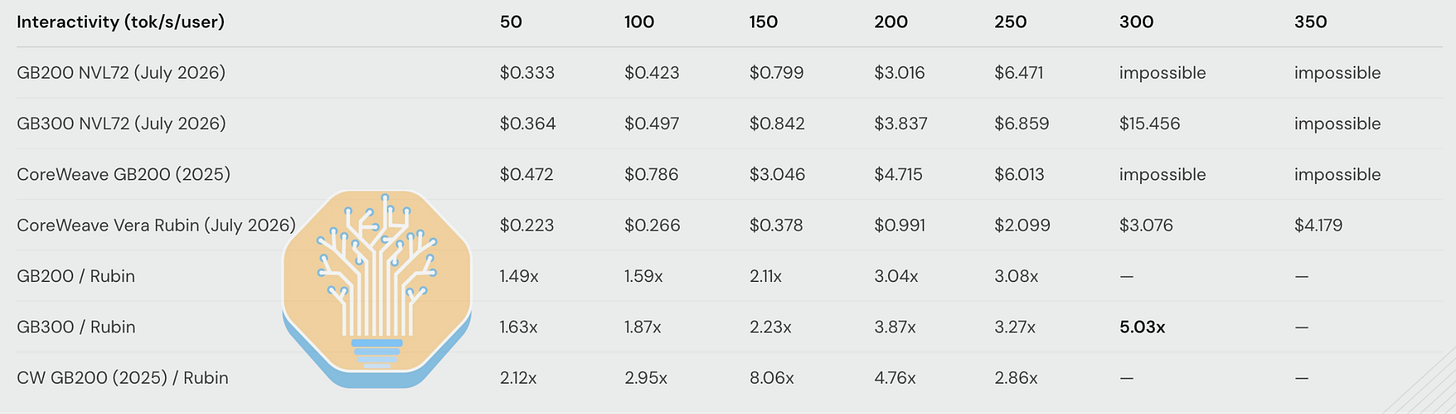
接下来,我们以表格形式提供相同的数据。其中的比值展示了在不同交互度下 Rubin 的成本便宜了多少倍。同样,标记为“impossible”的单元格,表示该配置方案的极限无法达到的速度。
Source: SemiAnalysis, TCO Model
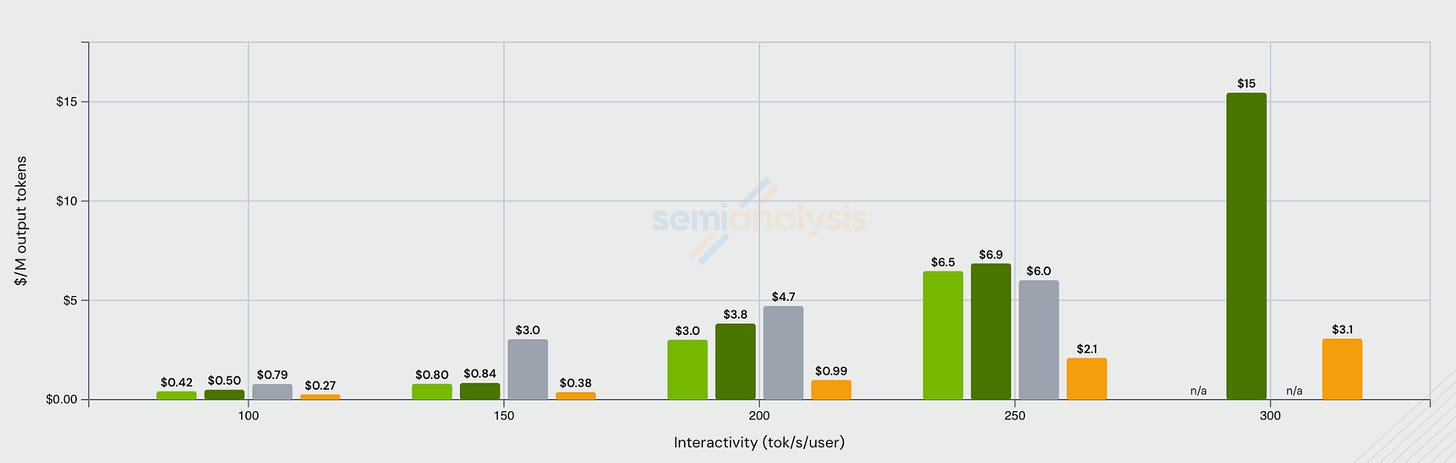
下图以柱状图展示了 100 至 300 tok/s/user 区间的性能边界。所有四种方案的测试数据均覆盖至 250 tok/s/user。仅有 Rubin 和 GB300 能达到 300 tok/s/user。

Source: SemiAnalysis
与 2026 年 7 月的 GB200 和 GB300 相比,Rubin 在各种交互性水平下成本都更低。随着性能要求攀升,这一优势进一步扩大。在 100 tok/s/user 时,Rubin 的成本约为 GB200 的 1/1.5。到了 200 至 250 tok/s/user 区间,该优势提升至 3 倍。在 300 tok/s/user 时,Rubin 相较 GB300 拥有 5 倍的优势,这与每兆瓦(per-MW)视角下的结论一致。在该交互水平下,GB300 几乎无法提供 token 服务,而 GB200 则完全无法运行。
2025 年的 GB200 NVL72 基准表现同样引人注目,在曲线中段达到了峰值。在低速时,Rubin 的成本约低 2 倍以上。在 150 tok/s/user 时,优势达到近 8 倍。随后在 200 tok/s/user 时回落至 5 倍。这与 per-MW 版本的分析结论一致:2025 年的 GB200 基准采用的是一年前的软件栈,并非如今实际运行的 GB200。
在最高性能区间,情况同样如此。GB200 在超过 250 tok/s/user 后已无可用工作点。GB300 在超过 300 tok/s/user 后也无法运行。因此到了 350 tok/s/user 时,仅有 Rubin 能够提供服务。其输出成本为每百万 token 4.18 美元。
在付费墙之后,我们将继续深入分析 Rubin 的性能。并将其与目前已知最佳的 MI355X 公开分布式推理性能进行对比。我们还会简要分析 Triton Compiler、PyTorch、vLLM 和 Dynamo 等软件将在 Rubin 上的运行机制。