在近期关于 Meta 超级智能(Meta Superintelligence)的通讯文章中,我们阐述了看好 Meta AI 的理由。如今,MSL 已经具备了诸多必要条件,有望赶上 Anthropic 和 OpenAI,重返技术前沿。然而,我们也曾简要提及困扰 Meta 基础设施团队的文化问题。本文将深入探讨这些文化问题是如何演变为代价高昂的失误的,无论是像收购 Rivos 这样的举措,还是在硬件架构上的奇特选择。
我们认为,Meta 基础设施部门需要进行一次文化重塑,以更好地服务于 Meta AI 组织,尤其是 MSL 那些世界级的研究人员。鉴于 Meta 开始向外部客户出售计算资源,而不再仅仅服务于内部用户,这一点显得尤为重要。
Meta 基础设施部门已变得机构臃肿。中层管理者将资源投入到过度设计的解决方案中,却忽视了更广泛的组织需求。公司内部似乎存在过多各自为战的团队,他们过度优化某些指标,而非为公司交付实用的技术。中层管理者会千方百计地证明其提案的合理性以保住自己的职位,这使得该组织变得极度政治化。
一个重大问题在于 Meta 的六个月绩效评估周期。每个评估轮次都会淘汰排名靠后的 10% 到 15% 的员工。这导致整个组织的员工只追求短期成果,忽视长期战略。一些管理者热衷于推动见效快、曝光度高的项目,这种做法被称为“粉饰门面”,随后便迅速转向或放弃这些项目。极少有人公开质疑领导层,导致错误决策得不到纠正。整个体系不仅不鼓励长期思考,还催生了规避风险的行为。
在 Meta 基础设施部门内部,供应链团队对工程团队几乎没有话语权。结果就是,技术决策往往受政治动机驱使,而非出于对整个公司利益的软硬件协同设计考量。
频繁的战略转向也十分常见。由于 Meta 一向有砸钱解决问题和高速执行的名声,相比于采取更稳健或保守策略的公司,其路线反转往往代价更高。当已确定的设计中标项目随后被取消时,供应商也会失去信心。这导致新设计在供应链中的优先级降低。由于 Meta 频繁重组,一些供应商更倾向于专注于 Amazon 或 Google 的设计。
Meta 的许多问题源于财务纪律的缺失。为了扩充并证明 AI 等项目获得的巨额预算是合理的,管理者们不断设立新项目并扩大人员规模。这重蹈了 Meta 旗下 Reality Labs 部门的覆辙。该部门曾斥资数十亿美元招聘工程师并投入研发,直到公司因业务重心转向 AI 而引发裁员,才从 2022 年开始大幅削减团队规模及相关项目,这一过程一直持续到今年。
Rivos 收购案
首先,Meta 最近的重大失误之一,是去年斥资超过 25 亿美元收购了芯片初创公司 Rivos。
在 Meta 芯片部门内部,很少有人完全理解公司当初为何要收购 Rivos。那些曾在内部力推这笔交易的人如今也保持沉默。目前普遍的看法是:Meta 资金充裕,定制芯片领域正不断升温,而且公司此前已经在为未来的一款芯片授权使用 Rivos 的 IP。因此,管理层认为,与其让别人染指,不如直接将 Rivos 的技术完全据为己有。
Meta 原本只想要 Rivos 的加速器和 GPU 团队,但这家初创公司的创始人坚持全盘交易,不接受部分收购。Meta 最终买下了整个公司,随后在不需要的业务部门进行了大幅裁员。
Source: SemiAnalysis, Rivos
一些前 Meta 芯片员工表示,这起收购是由 Meta 芯片业务负责人 Yee Jiun Song 主导的。他不顾部分下属的反对推进了这笔交易,但此后便失去了兴趣。结果是,整个组织对这种“移植”产生了排异反应,导致 Rivos 员工陷入孤立无援的境地。现有的 Meta 芯片管理者将这起收购视为免费的人员储备池,纷纷抽调 Rivos 的工程师来扩张各自的势力范围。他们将这家原初创公司向不同方向拆解,最终使其所剩无几。
Meta 依然希望开发一款整合 Rivos 技术的芯片。为此,他们启动了一个名为 Phoebe 的新芯片项目,计划于 2028 年流片。不过,Meta 内部并非所有人都对该项目持乐观态度,部分人认为它最终也可能会被取消。我们一直在为 Accelerator Model 的订阅用户持续更新各种定制芯片架构、平面布局及产能的详细信息。
与此同时,刚加入 Meta 的 Rivos 员工正在快速体验 Meta 的内部文化。与 Apple 等成熟的硬件机构不同,Meta 的硬件路线图和软件路线图一样变化频繁,不断进行战略调整。这意味着你目前正在做的工作,可能在六个月后就变得毫无意义。Meta 芯片部门内的许多人表示,部门缺乏清晰的组织架构,没有明确的决策流程,各个团队之间的职责归属也很模糊。
最后,Rivos 的收购引发了 Meta 原有芯片团队的不满。许多 Rivos 工程师加入时获得了更高的薪酬和头衔,却并未承担与之相称的职责,并且他们被安排在 Meta 原有芯片员工之下。这导致原有团队士气低落,同时也让新加入的 Rivos 员工感到不满,因为他们缺乏决策权。自今年年初以来,已有不少 Meta 芯片工程师离职,转投初创公司或 Arm 和 Nvidia 等成熟企业。
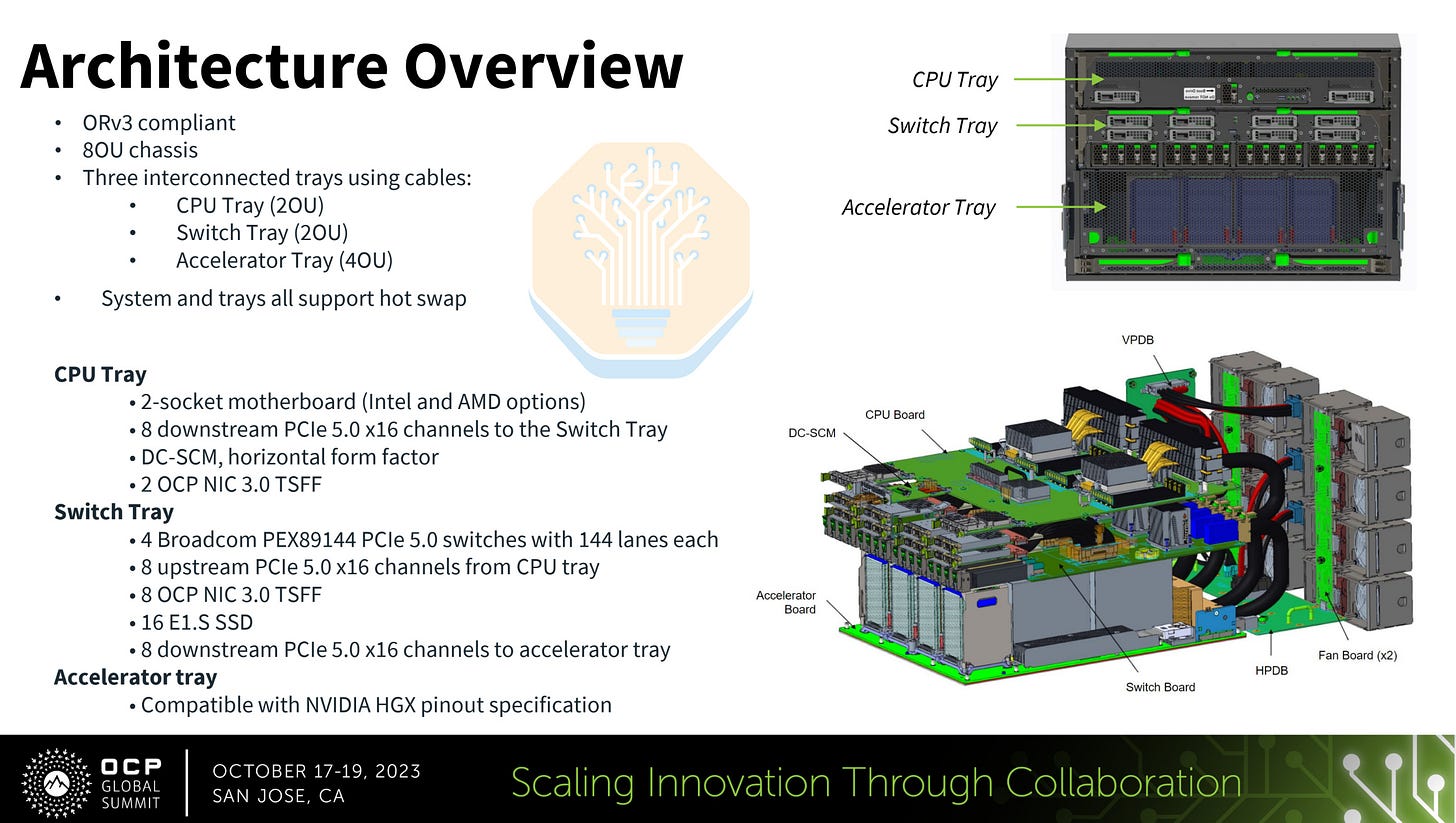
现在我们来谈谈 Meta 的 AI 服务器设计。Meta 的硬件决策在很大程度上取决于 TCO(总拥有成本)分析。该分析会将排序推荐和 GenAI 等一系列工作负载,与 Nvidia、AMD 以及其自研芯片方案提供的性能进行对比。Meta CEO Mark Zuckerberg 下达了一项指令:正在设计的系统必须适用于整个业务。这意味着它们不仅要支持 GenAI 工作负载,还要支持核心的排序与推荐系统。
Meta 为什么需要这么多额外的直连存储呢?基础设施团队当初如此配置,是认为训练过程中的检查点(checkpointing)需要更多存储空间。然而在实际生产中,这些存储的使用率远没有达到模型团队的预期,这也是该设计最终被取消的原因。这个例子说明了硬件与软件缺乏协同设计会导致资源浪费,而此类情况在 Meta 并不少见。
Meta 的其他理由是,该设计更易于维护,并且在使用非 Nvidia NIC 方面提供了灵活性。其工程师希望避免将更多业务交给 Nvidia,尤其是在网络方面,因为他们在 GPU 上已经对 Nvidia 有了很强的依赖。
不过无论如何,Broadcom 的交换机都无法得到有效维护。而且 Meta 的软件栈依然依赖 Nvidia 版本的 RoCE(一种用于 GPU 流量的网络协议)。因此,现实中 Meta 根本不可能更换网卡供应商。最终,Meta 付出了更高的成本,TCO 也变得更差,既没有降低对 Nvidia 网络设备的依赖,反而增加了对 Broadcom 的依赖。
Ariel
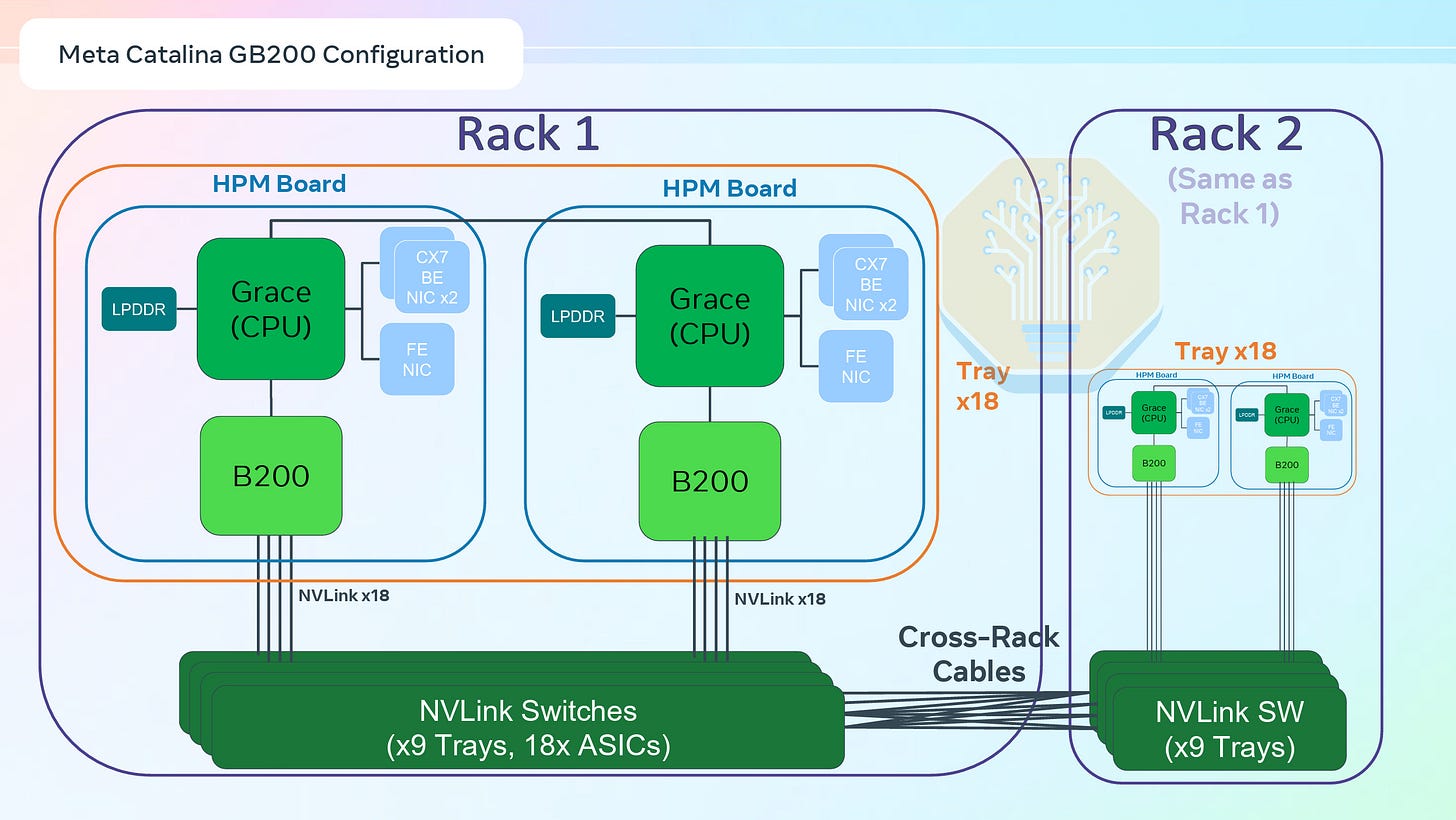
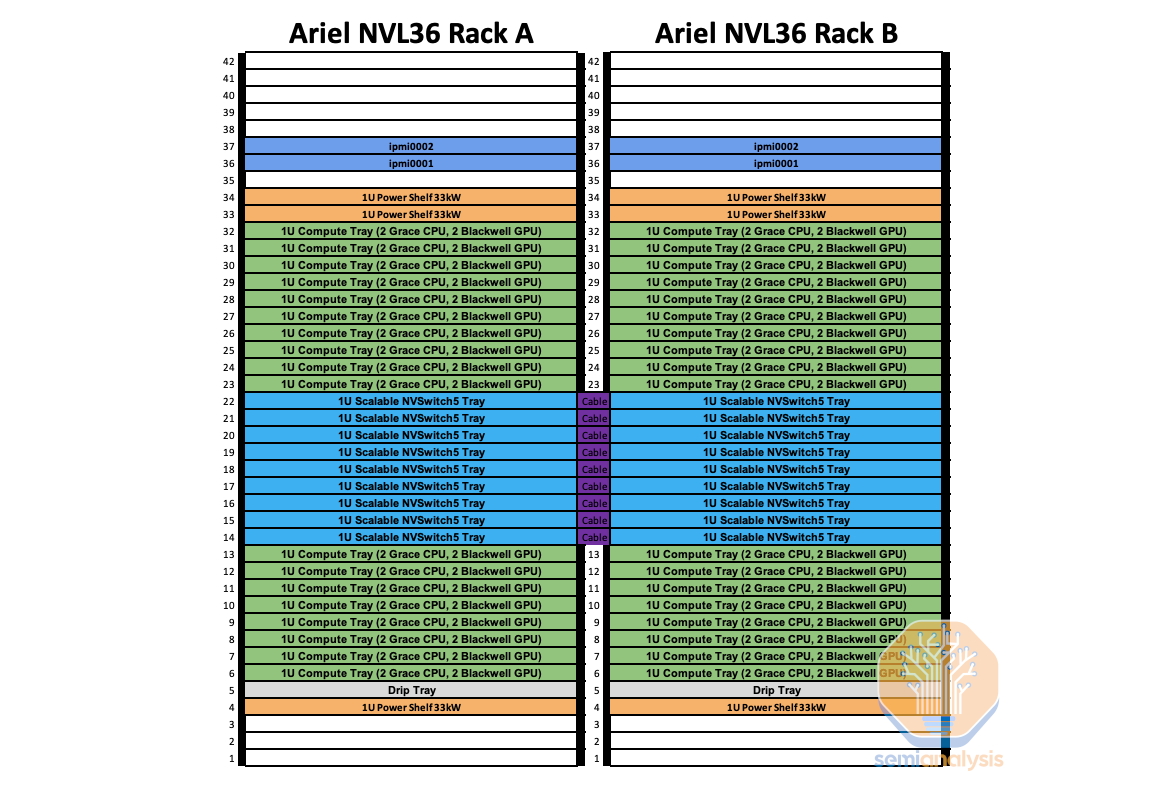
Grand Teton 并不是服务器设计上的一次性失误。这种状况延续到了 Blackwell 时代,体现在 Meta 定制的 GB200 Catalina 机柜(也称为“Ariel”)上。大家通常购买的普通 GB200 SKU 采用的是一块 Grace CPU 搭配两块 B200 GPU。但 Ariel 不同,它采用一块 Grace CPU 搭配一块 Nvidia B200 GPU。其实现方式很简单:Ariel 沿用了 GB200 标准的 Bianca 计算板,只是将每块板子上的其中一块 GPU 空焊移除了。
Source: Meta
Meta 的工程师对单机柜 GB200 NVL72 的稳定性感到担忧。NVL72 系统结构复杂,包含作为所有芯片连接中枢的铜背板、密集的数英里长铜缆,以及芯片与背板之间数以千计的连接点。Meta 基础设施团队起初认为,NVL36x2 配置会比完全通过背板互连的 NVL72 更加稳定。
Meta 是这款 Ariel SKU 的唯一客户。原因在于 Meta 对其推荐系统(简称“RecSys”,用于推荐个性化广告和信息流)有着更高的 CPU-GPU 比例的执念。其逻辑在于,RecSys 会使用大量的嵌入表来存储用户、广告和内容的表征。这需要大量受限于 CPU 的处理能力,而每块 Grace CPU 提供的额外 LPDDR 内存可以用来存储这些嵌入数据。由于这些数据的读取小而分散,因此内存带宽不像运行大语言模型时那么关键。
另一方面,增加 CPU 比例以及 36x2 配置带来的额外 NVLink 网络组件,导致单块 GPU 的服务器资本支出上升。其结果是,相比标准 GB200,它的每 FLOP 成本、每 HBM 容量成本及带宽成本都要高得多。这些都是 LLM 和生成式 AI 工作负载的核心指标,使得 Ariel 在 LLM 训练和推理方面表现糟糕得多。总而言之,我们的计算表明,Ariel NVL36x2 服务器的 TCO 比标准 GB200 NVL72 高出了 14%。如前所述,这笔额外开销用于增加更多的 CPU 和 DRAM 组件,而 LLM 团队根本用不上这些。这项决策让 Meta 损失了数十亿美元。