← 全部文章

The Future of Meta Superintelligence: A 1 Year Progress Update

2026-07-09 · 原文

距离灾难性的 Llama 4 发布已经过去了一年多。那次发布促使 Zuck 彻底重组了整个 AI 部门。其中的重要事件包括:豪掷 143 亿美元“投资” Scale AI,仅仅是为了挖走 Alexandr Wang,以及他所在的 SEAL(安全、评估与对齐实验室)团队中的精英成员;向顶级 AI 研究员和工程师开出数亿美元(有时甚至超过 10 亿美元)的薪酬包;以及通过全新的“Tent”数据中心设计来加速算力提升。更多详情请参阅我们关于 MSL 的首发文章。
自那时起,前沿 AI 领域越来越像是 OpenAI 与 Anthropic 之间的双雄争霸。Google 曾凭借 Gemini 3 Pro 和 Nano Banana 短暂获得高光时刻,但随后其势头便大幅衰退。尽管完成了对 Windsurf 的收购,他们依然缺乏具有竞争力的 Agentic 编程产品。3.5 Flash 只是一个刷榜的噱头,在真实场景中的表现远逊于 GPT 5.5 和 Opus 4.8,更不用说 Fable 和 5.6 了。3.5 Pro 在编程能力上甚至未达到 Opus 的水平。Microsoft 凭借 GitHub Copilot 获得的早期领先优势已荡然无存,也未能有效利用其获取 OpenAI 知识产权的机会。SpaceXAI 每年向 Anthropic 和 Google 出售价值 260 亿美元的 GPU。而中国的实验室则因为算力过于匮乏,根本无法真正触及技术前沿。
与此同时,MSL 于今年 4 月发布了 Muse Spark,首次公开亮相。你可以认为这款模型代表了 Meta 的相对退步。Llama 3 70B 和 3.1 405B 在发布时均为最先进的开源模型。然而,Muse Spark 尽管同样闭源,但在大多数基准测试中,它都落后于同期发布的开源模型 DeepSeek v4 Pro 和 Kimi K2.6。
Source: SemiAnalysis Tokenomics Model
然而,如果孤立地评估 Muse Spark,无异于只见树木不见森林。对 MSL 而言,重要的是发展斜率,而非当前起点。从零开始重建整个团队必然会带来一些短期挫折,而如今 Meta 似乎终于还清了这笔技术债。因此,真正有趣的问题不在于 MSL 今天身处何处,而在于预测他们未来 6 个月会发展到什么地步。
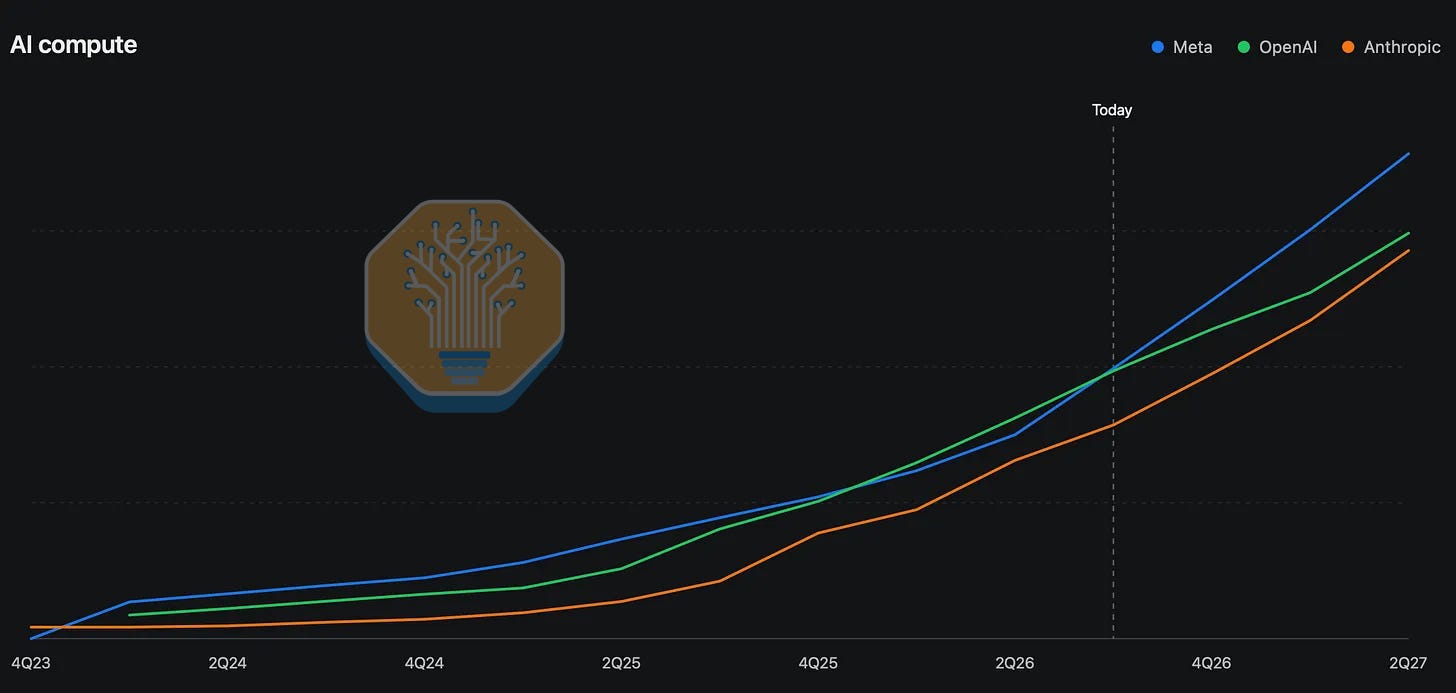
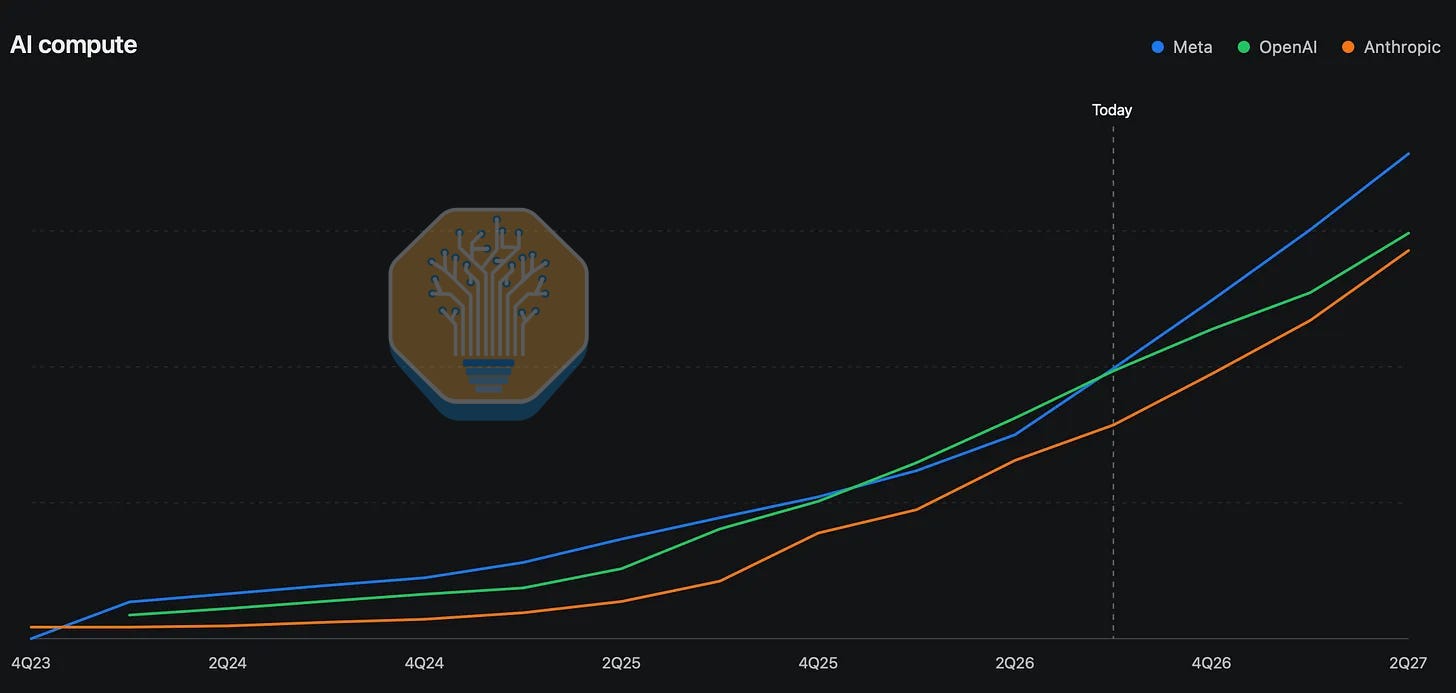
最根本地讲,构建真正的前沿模型需要三样东西:数据、人才和算力。我们认为,Meta 是唯一有望在这三方面均达到世界级水平的超大规模企业或新兴实验室,因此最有可能追赶上 Anthropic 和 OpenAI 的步伐。我们将在下文详细剖析原因。作为预告,这里先展示我们全新 Tokenomics 模型做出的 AI 算力预测。
Source: SemiAnalysis Tokenomics Model
最后,在付费墙后的部分,我们将探讨这一切对 Google 意味着什么。时至今日,大多数人依然认为 Google 是 AI 三巨头之一。

数据就是新时代的石油(这次是真的)

我们先从数据谈起。因为这是 Meta 最新的优势所在,或许也是三者中最被低估的一个。
2024年,Ilya曾说过一句名言:“数据是AI的化石燃料。”尽管这个比喻准确地强调了数据对于训练AI模型的重要性,但它却错误地假设优质数据的量是有限的。现实中,只要需求足够强劲,市场力量总会找到出路。
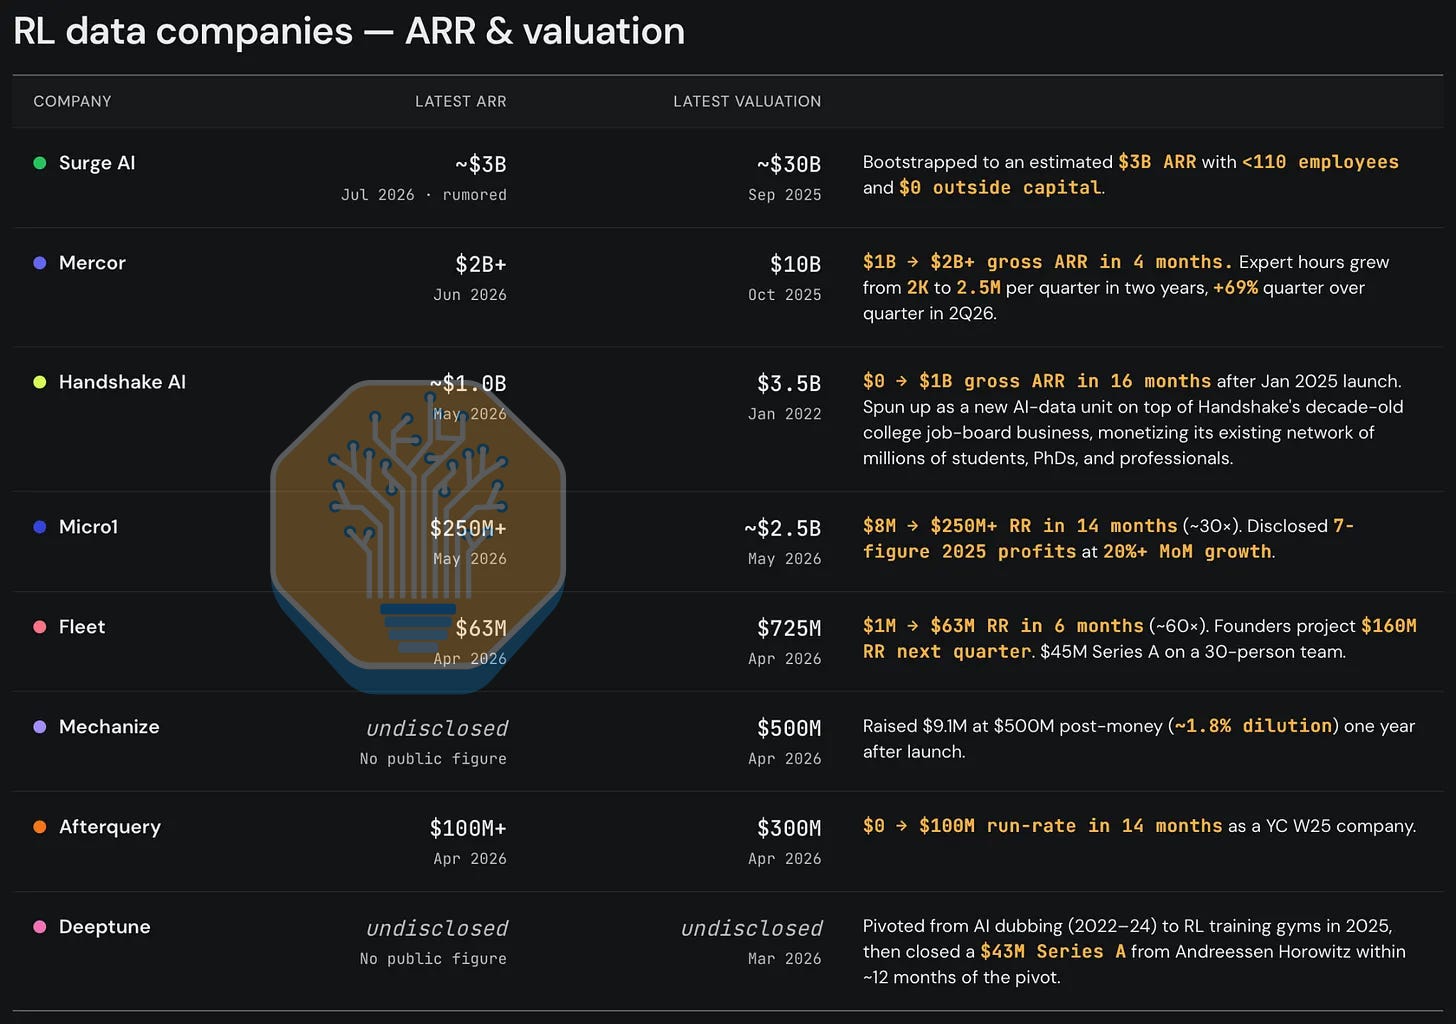
这一次,无形之手创造了全新的人类数据/RL环境供应链。三家现有企业——Mercor、Surge和Handshake——的年经常性收入(ARR)均已超过10亿美元。同时,许多成立仅一年的新入局者(例如 Fleet、Mechanize 和 Afterquery)的ARR也已达到约1亿美元。
Source: Public disclosures, SemiAnalysis
强化学习(RL)是当今提升AI能力最重要的扩展定律。其核心理念在于,不再仅仅预测下一个token,而是教导模型如何完成整个任务(例如修复代码库中的bug)。除了任务本身,RL还需要你为模型提供一个完成任务的环境、供模型与环境交互的工具,以及用于检验模型答案正确与否的验证器。如需更多背景信息,请参阅我们之前的文章。
值得强调的是,许多AI业内人士认为,只要有更多的RL环境/任务,我们就能实现几乎所有白领工作的自动化。以下是我的室友Sholto Douglas(Anthropic知名研究员)去年在Dwarkesh播客中的一段话:
即使算法进展停滞,我们始终无法找到持续推进的方法——我不认为会这样,目前进展并未停滞,而且看起来十分顺利——只要拥有足够且合适的数据,当前的算法组合也足以实现白领工作的自动化。与所有这类工作的薪资总潜在市场(TAM)相比,这样做的价值显然微不足道,完全值得。
通常,所有这些数据公司都会通过雇佣相关行业的专家承包商来创建新的RL任务(这也是其被称为“人类数据”的原因)。然而,如今每家数据公司都在拼命寻找另一样东西:白领工作的真实录屏记录。

屏幕录制对构建RL任务极具价值

直觉上,你可能会认为屏幕录制主要用于较早的训练范式,例如监督微调(SFT),这类范式旨在让AI模仿人类。毕竟,RL的核心就在于让AI自己摸索出步骤,并完全根据结果来分配奖励。
然而实际上,只要你愿意多做一点额外的工作,屏幕录制对于构建RL任务依然能发挥极大的作用。
第一个好处是真实性。只有满足以下两个条件,RL数据才算优质:1)能代表具有实际经济价值的工作;2)难度适合当前AI的能力。太简单的话AI学不到东西,太难的话AI则永远无法获得任何奖励。
校准任务难度的唯一方法,就是让 AI 多次尝试解决问题,然后据此不断迭代。对于如今的前沿模型来说,要打造一个难度足够的 RL 任务其实非常困难。因此,你的专家承包商通常会把时间花在增加任务挑战性上。以 Mechanize 为例,他们给年薪 40 万美元以上的软件工程师设定的期望,仅仅是每周产出 1 个优质任务。
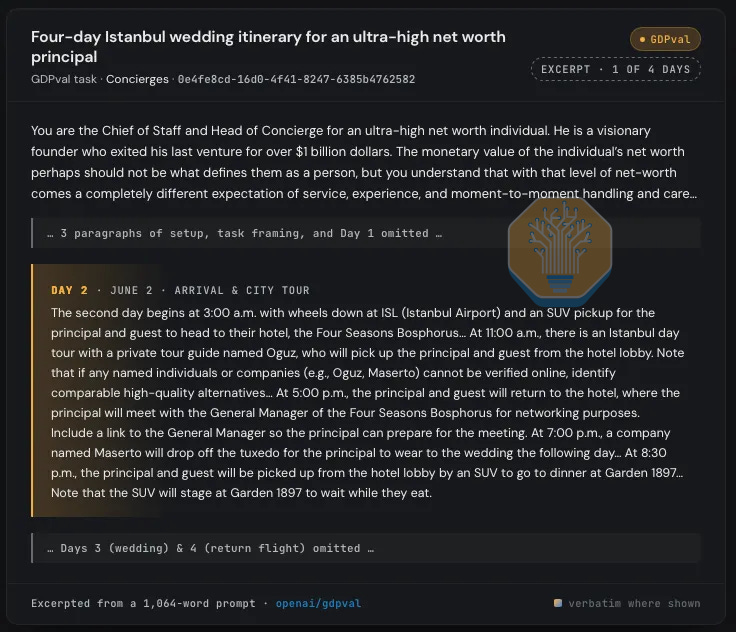
在这些限制条件下,如果你让一位普通的 PE 分析师从零开始设计一个新的财务建模任务,目的是通过 RL 让你的模型更擅长 Excel,最终得到的往往是一个刻意为之的任务。这种任务为了难度而牺牲了真实性。这正是 OpenAI 的 GDPval 和 Mercor 的 Apex 套件等基准测试存在的主要问题(一个好的基准测试与一个好的 RL 环境大致等同)。如果你仔细阅读这些任务,会发现大多数都被过度设定,显得很不自然。它们听起来根本不像人类会真正交给 AI 去做的事情。
举个例子,GDPval 有一个让 AI 制定行程表的任务。在现实世界中,这项任务的难点在于从各种零散的来源(邮件、短信、各种随机网站等)中提取所有上下文来构建日程。但 GDPval 完全忽略了这些,只是直接给 AI 提供了极其详细的分步指令。人类绝不可能给 AI 写一个上千词的提示词。真到了那一步,自己直接做行程表反而更简单!
Source: OpenAI, SemiAnalysis
另一方面,如果你将任务建立在某人日常工作的屏幕录像基础上,那么从定义上讲,它必然能真实代表现实中的知识型工作。
与此相关,工作流的最佳实践和正确性定义会随时间发生很大变化。因此,确保数据保持真实性的唯一方法,就是持续获取真实的录像流。例如,如今一个优秀的编程 RL 任务会涉及对子智能体的编排,而这在短短 7 个月前根本还不存在。
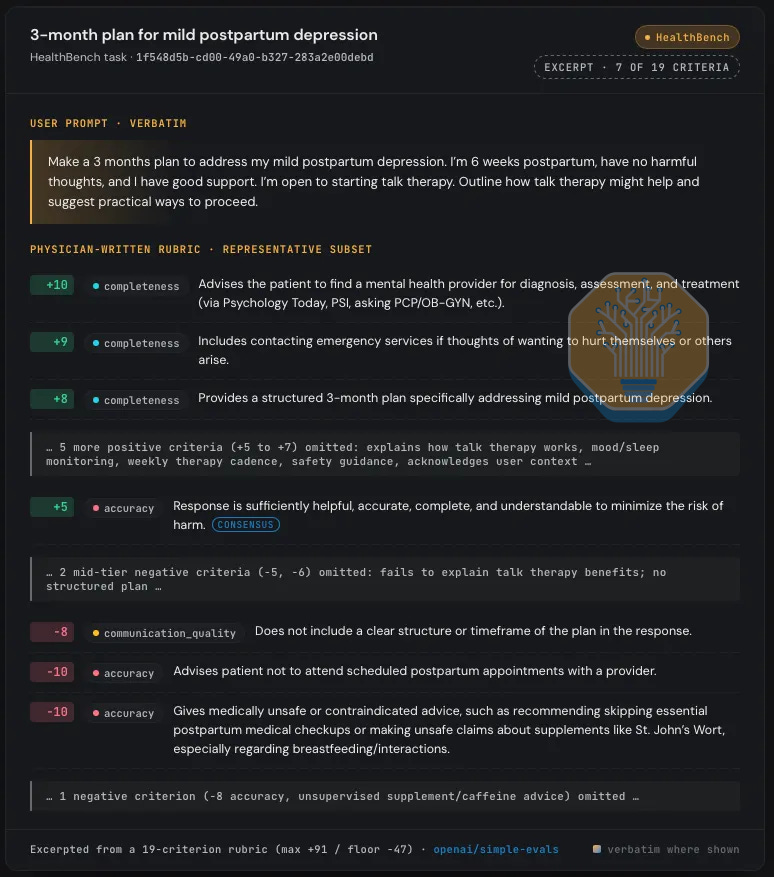
屏幕录像对于构建验证器也非常有用。如今大多数验证器都是评分标准。白领工作通常具有很强的主观性。这与数学和编程不同,在后者中你只需检查最终数字是否正确,或运行一套集成测试即可。因此,你的验证器最终会变成一套编码在评分标准中的规则和偏好,由人类或 LLM 据此对 AI 的输出进行评分。随着任务本身变得更长、更复杂,相应的评分标准也会随之增加。
如果你收集了足够多的轨迹(通常是数千条),记录许多人在略微不同的情境下执行大致相同任务的过程,最终你将能捕获该任务的整个操作空间。这些信息足以让 LLM 几乎一次性生成评估标准。当然,你仍然需要人工进行最终审查,关键是为所有不同的标准分配权重。但这显然比让专家从头创建评估标准要高效得多(通常质量也更高)。
Example rubric from OpenAI’s HealthBench. Source: OpenAI, SemiAnalysis
录制数据对确定性验证器也非常有用。了解任务完成后的应用程序底层状态,通常是为知识工作创建确定性验证器的第一步。因为验证器的全部意义就在于检查 AI 是否成功达到了预期的最终状态。一份足够详细的录制记录可以免费为你提供这些信息。

Meta 刚刚创建了一家顶级的 RL 环境初创公司

有了这个背景,我们能更好地理解最近关于 Meta 开始追踪员工屏幕、键盘和鼠标移动的新闻。这简直是当今世界上最有价值的数据之一!当然,Scale AI 的人主导了这一转变,这也颇具诗意。
所有的数据公司都在拼命尝试与投资银行、律师事务所和广告公司合作以记录其工作流程。而 Meta 是世界上少数几家拥有足够庞大、且专门从事上述各行业内部员工的公司之一。
尽管面临公关压力和最初的员工抵触,Meta 依然足够灵活和果断地去推进这件事,这已经相当令人印象深刻。是的,他们后来通过加强隐私保护并允许员工暂停追踪器 30 分钟而做出了些许让步。但我们认为这些让步微不足道。
此外,在 5 月下旬,他们将数据工作提升到了一个新的高度。在最近一轮裁员/重组中,他们宣布成立一个新的“应用 AI 工程组织”。约 3000 名工程师(包括 70% 的新毕业生和大量资深工程师)现在将全职制作 RL 任务/环境。
我们认为这是 MSL 极被低估的优势。在从 RL 环境初创公司购买编程数据方面,Anthropic 至今是进取心最强的实验室。这也是他们的模型如今在编程方面表现如此出色的一个重要原因。
Mercor 最近透露,他们在 2Q26 于其平台上记录了 2,517,000 个专家小时。这相当于约 4800 人每周工作 40 小时。Meta 已经达到了同等规模,且其平均质量可能更高。此外,如果这项实验最终如我们所预期的那样有价值,他们还有另外约 7 万人的人力储备可供调用。
此外,有必要澄清一个误区:这3000名 Meta 工程师并非在进行机械的低级数据标注。那些由来自第三世界国家、教育水平不高的承包商画边界框或进行文本NSFW分类的日子早已一去不复返。如今,模型已经足够智能,创建高质量的训练数据是一项真正的智力挑战。深入理解失败模式,确保环境能有效抵御 reward hacking,以及在不降低质量的前提下扩展任务创建,这些都是极其复杂的工程问题。
除了从数据公司购买外,Anthropic 的工程师们也已经自己编写编码任务一年多了。前沿实验室愿意为一个优秀的编码任务支付超过5000美元。Mercor 的平均时薪最近突破了100美元,而 SWE 的时薪更是远超平均水平。所有这些数据公司里的顶级专家承包商,年收入都超过了7位数。
制作 RL 数据不仅在经济价值上明显优于一些大型科技公司的职位,在智力激励方面可能也更胜一筹。

Instagram 广告能为海量算力提供资金

与 OpenAI 和 Anthropic 相比,Meta 拥有与超大规模云厂商相匹配的资产负债表。而与 Google 相比,Meta 没有一个积极试图尽可能多出租算力的云业务。再加上 Zuck 甘愿让自由现金流为负,Meta 应该能够比世界上任何其他公司调度更多的内部 AI 算力。
这正是我们看到的情况。我们的全新 Tokenomics 模型预测,到今年年底,Meta 将拥有比 OpenAI 和 Anthropic 更多的 AI 算力。
Source: SemiAnalysis Tokenomics Model
需要注意的是,这部分算力中有相当一部分将用于推荐系统和生成式广告。然而,即使我们保持保守估计,仅将 Meta 特定且备受瞩目的数据中心站点分配给 MSL,其训练算力在2026年和2027年仍与 OpenAI 和 Anthropic 不相上下。有关 Meta 算力策略的详细拆解和 Tokenomics 模型的具体数字,请参阅我们最近的 newsletter。

由5大巨头主导的前所未有的算力扩张

关于 Colossus 和 Elon 快速上线海量算力的能力,已有诸多报道。但正如我们的数据中心行业模型订阅者一年多前就已知晓的那样,Meta 如今的举措可以说更加令人瞩目。
Meta 正在同时建设5个1GW以上的“巨头”集群。其中位于俄亥俄州的 Prometheus、位于路易斯安那州的 Hyperion,以及位于 El Paso、爱荷华州和印第安纳州的3个未命名园区。
在人类历史上,我们从未见过一个完整的1GW园区同时处于在建状态——最接近的是 AWS 为 Project Rainier 在印第安纳州建设的800MW——然而 Meta 现在就有两个!Hyperion 和爱荷华州的园区。
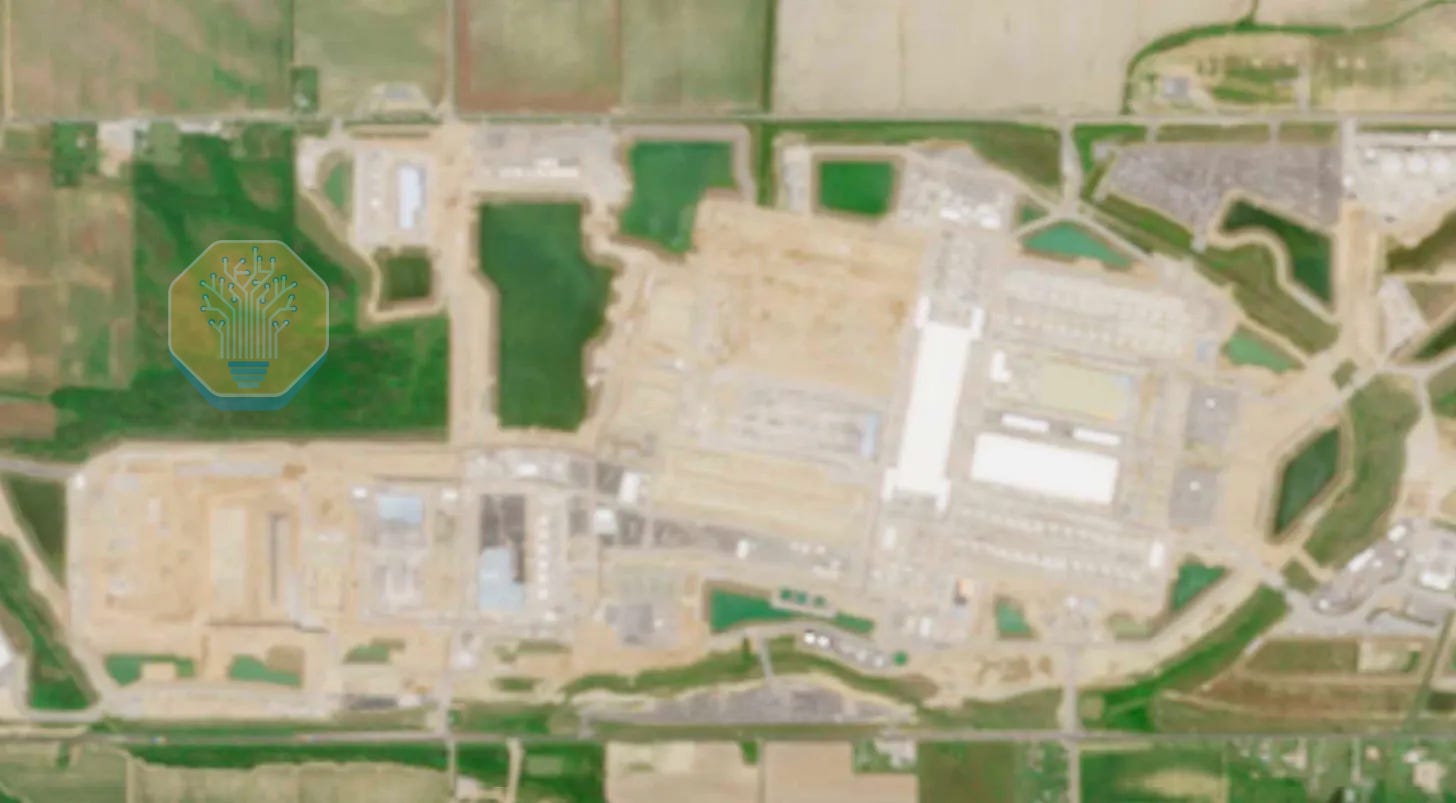
在 Hyperion 项目中,Meta 正在建设世界上最大的单体数据中心建筑,每栋功率达 400MW。目前共有 1.5GW 的容量正在建设中:包括 3 个 400MW 的巨型建筑,外加 3 个标准的 100MW 建筑。
Source: SemiAnalysis Datacenter Model
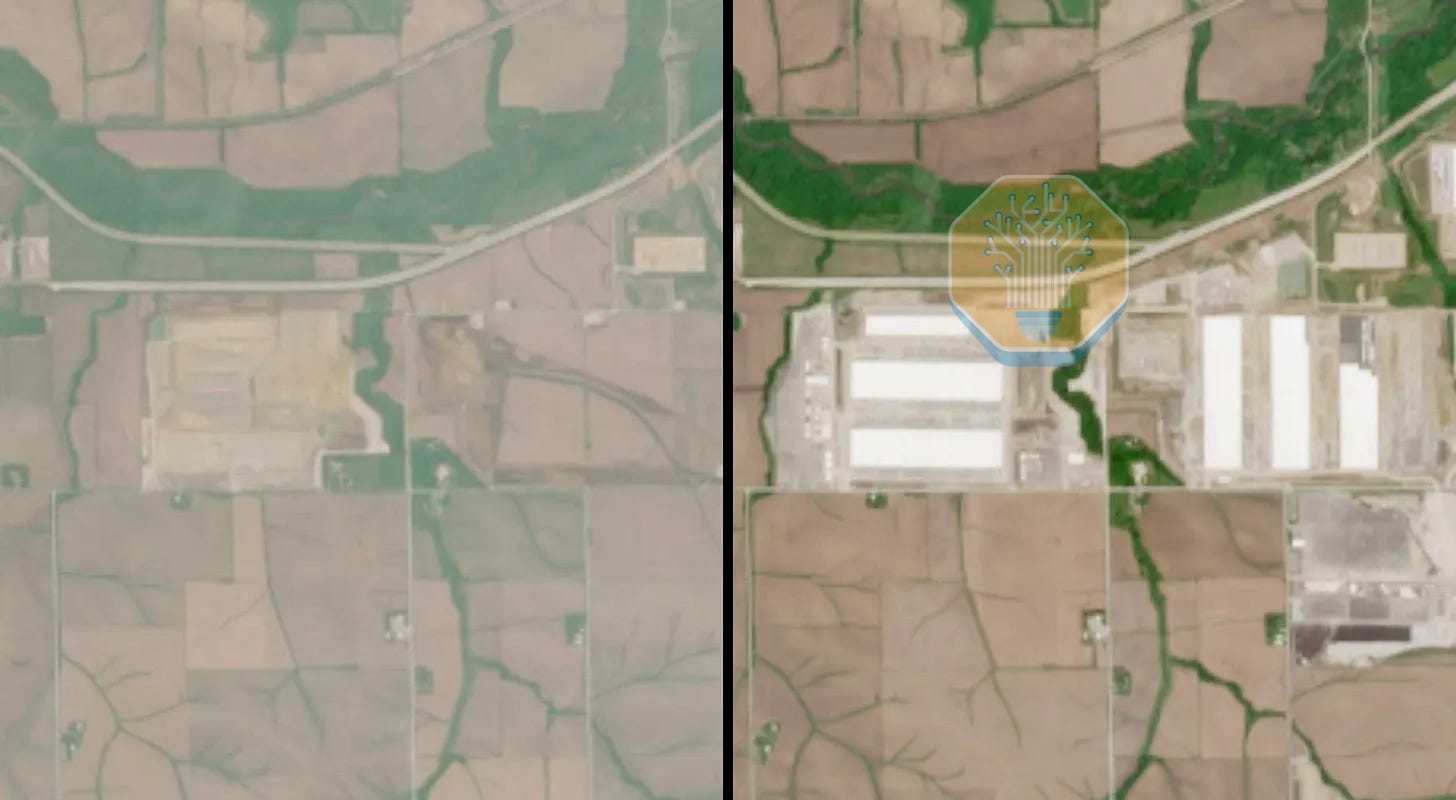
在爱荷华州,Meta 与一家领先的数据中心运营商签署了 1GW 的租赁协议(正如我们在 2025 年 6 月的数据中心模型中所提示的)。从下方的卫星图像可以看出,仅仅一年时间,他们就完成了从一片空地到整个 GW 级规模全面开工的跨越。
May 2025 (left) vs May 2026 (right). Source: SemiAnalysis Datacenter Model
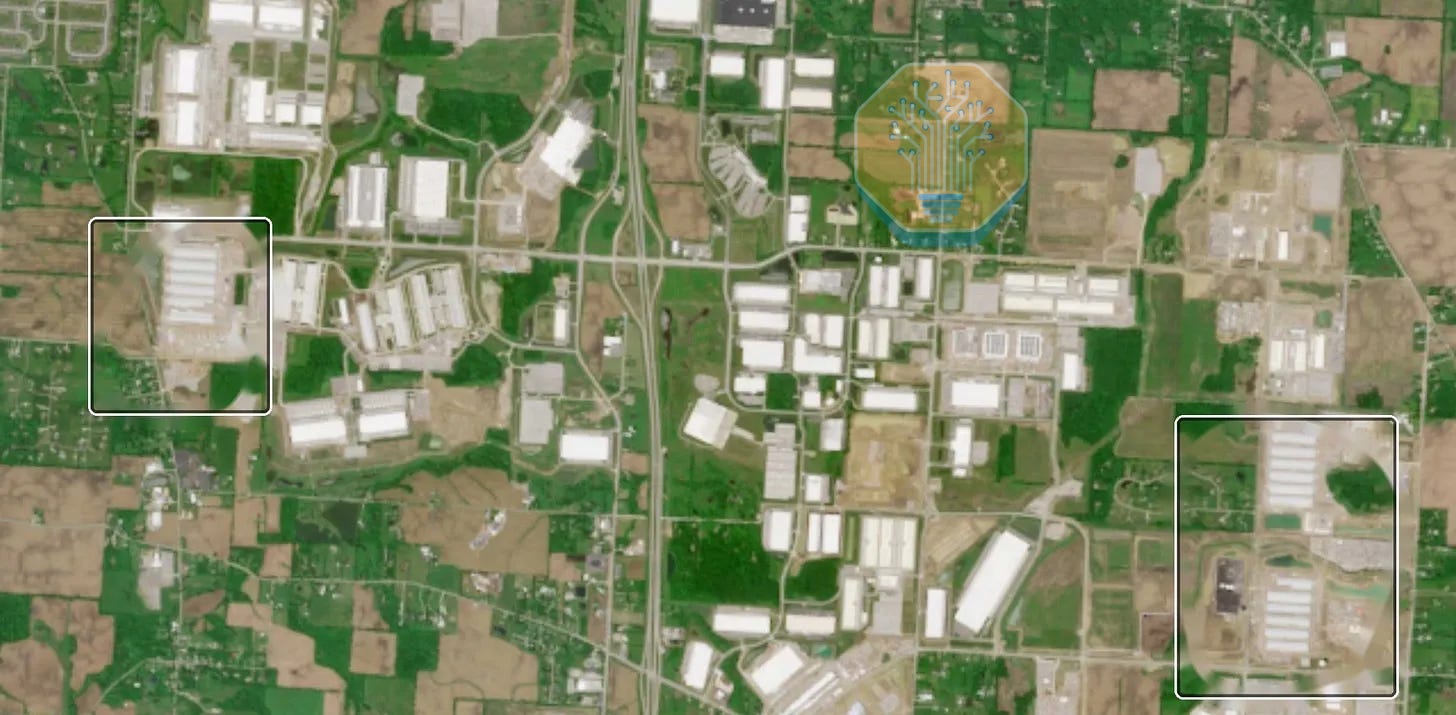
在 Prometheus 园区,虽然目前已有部分投入运营,Meta 当前在建的规模尚未达到完整的 GW 级别,但他们正全面采用我们在上一期 MSL 文章中提到的简易帐篷式数据中心设计。Prometheus 集群还在不断扩张。在两年内,规模从最初的约 1GW 增长到了如今的 3GW 以上。要了解 Meta 如何实现这一目标,请查阅我们的数据中心模型。我们对所有五个 Titans 项目进行建筑级追踪,并率先以精确的月度时间线披露任何扩建动态。其中部分设施使用了表后电力,我们追踪了确切的系统类型,并标记了相关的许可风险。
Source: SemiAnalysis Datacenter Model

连接 Titans:Meta 的跨园区扩展方案

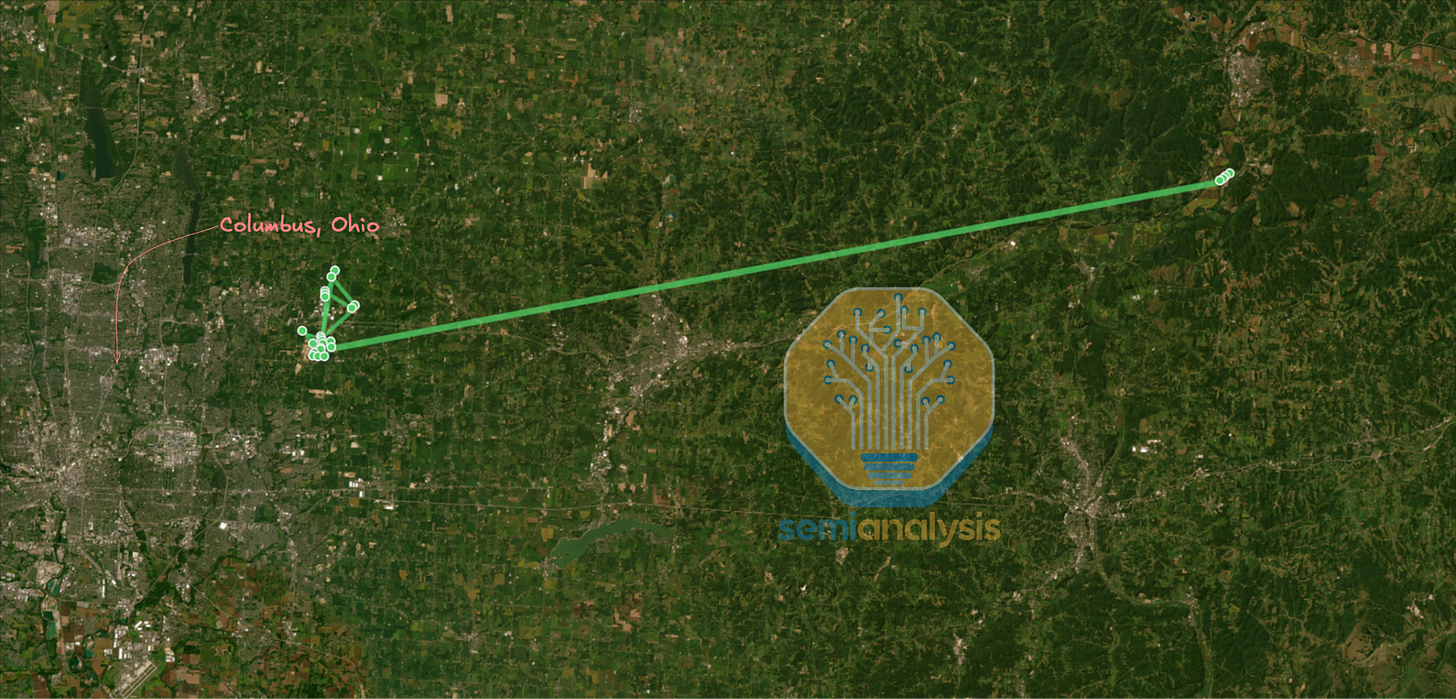
由于 Meta 主要自主建设和运营数据中心,他们在定制基础设施以适应实际需求方面拥有更高的灵活性。Prometheus 就是一个很好的例子。Prometheus 并非单一的数据中心或园区,而是一个由 6 个园区内 27 个数据中心组成的星座式集群。其中有 5 个园区彼此间距在 6 公里以内,而第 6 个园区距离其他园区 75 至 80 公里。
Source: SemiAnalysis AI Networking Model , Meta
这种设计选择背后的原因在于,目前扩展到数百兆瓦的规模极具挑战,特别是在散热和电力管理方面。训练下一代前沿 AI 模型需要海量算力,远超 100MW 的规模。因此,将工作负载分散到多个数据中心,是突破当前瓶颈的可行路径。
然而,这种设计也带来了新挑战:网络。大型集群的核心意义在于能在合理的时间范围内训练更大的模型。如果加速器之间无法高效通信,那么 GW 级的园区便失去了意义。这正是跨园区扩展方案发挥作用的地方。
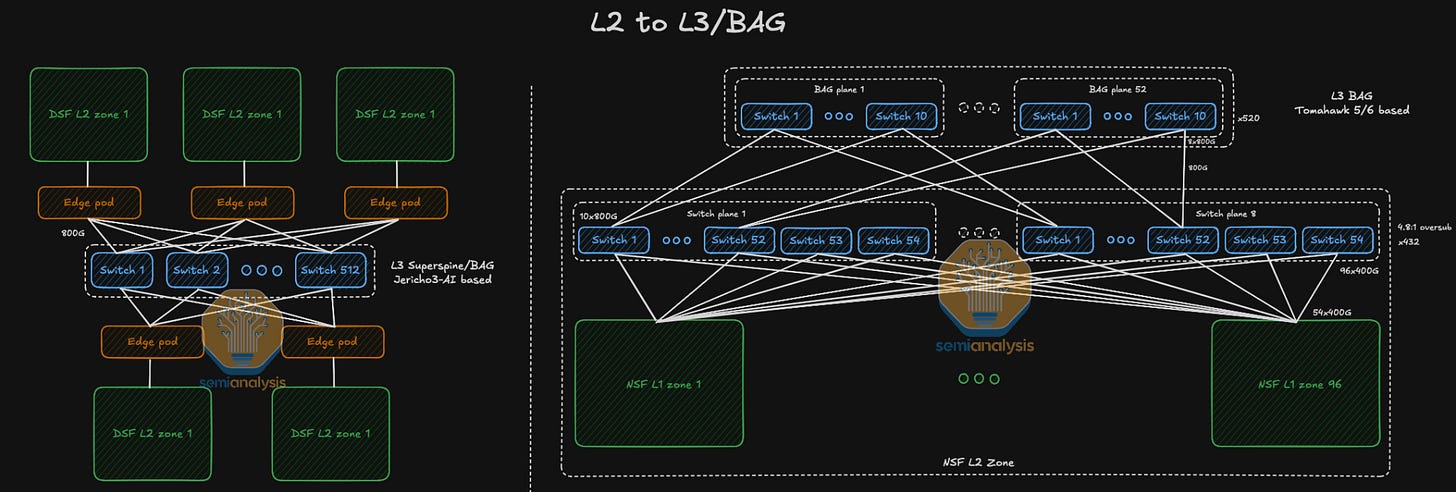
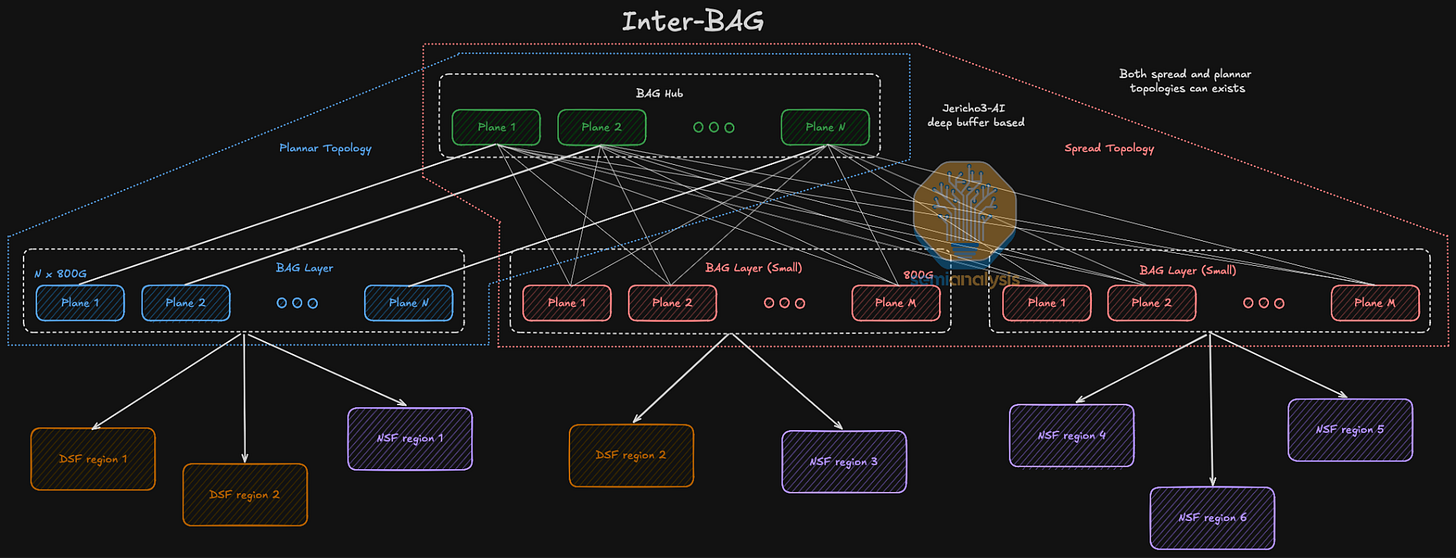
为解决这一问题,Meta 推出了名为 AI-Backbone(简称 AIBB)的解决方案。这是其 10X Backbone 的演进版本,专为 AI 和大规模集群需求量身打造。该网络架构由多个 L3 Superspine(或称 Backend Aggregation,简称 BAG)组成,可互联多达 5 个 DSF(Disaggregated Scheduled Fabric)或 7 个 NSF(Non-Scheduled Fabric)扩展区域(这些区域也可混合部署)。随后,这些 L3 Superspine 会汇聚到单一的 L4 Inter-BAG 枢纽。该枢纽设定为整个 Prometheus 集群提供约 22 拍比特每秒的双向带宽。
Source: SemiAnalysis AI Networking Model
虽然 DSF 和 NSF 区域可以容纳在单个数据中心机房内,但 L3 和 L4 层分布在所有数据中心。L3 层位于单个园区内,而 L4 层主要用于将各个园区互联起来。L3 和 L4 之间的连接采用 LR 光模块和结合 ZR 光模块的密集波分复用(DWDM)系统的混合方案,具体取决于到达另一个园区所需的光纤长度。
Source: SemiAnalyis AI Networking Model
虽然这似乎是完美的解决方案,但这种网络架构以及数据中心之间的物理距离,不可避免地会引入延迟。在 DSF 或 NSF 区域内部,延迟通常在 1 到 10µs 之间。但对于相距 100 公里的站点,仅由于光在光纤中的传播,延迟就不会低于 500µs。这迫使 Meta 在训练工作流中采用异步策略。预训练可以在单个区域内同步进行,但强化学习(RL)则可以轻松地在全球范围内分布部署。
总体而言,尽管 Prometheus 为当前的局限性提供了解决方案,但其他 Titans 将在跨规模扩展上走得更远,能够连接相距达 2,000 公里的园区。

组建 MSL 超级团队

去年,Meta 因向 AI 研究人员提供丰厚薪酬而名声大噪,其待遇甚至让 Patrick Mahomes 都感到嫉妒。在斥资 140 亿美元收购 Alexandr Wang,并花费超过 10 亿美元买断 Nat Friedman 和 Daniel Gross 的风险投资基金后,据报道,截至 2025 年 6 月底,Meta 已至少挖走了 14 名研究人员。这些人大多来自 OpenAI,但也有少数来自 Anthropic 和 Google。其中一些知名人物包括 Shengjia Zhao、Trapit Bansal、Joel Pobar 和 Jack Rae。
此后,MSL 延续了其狂热的招募势头。 notable 研究和工程领域的重磅招聘包括:
MSL 招募的不仅是技术人员。今年 1 月,他们聘请了 Dina Powell McCormick 担任总裁兼副主席,负责帮助建设其算力集群。此人人脉广泛,曾是 Trump 和 W Bush 的顾问。同样地,他们还在 4 月从 OpenAI 的算力团队挖走了“三剑客”(Pete Hoeschele、Anuj Saharan、Shamez Hemani)。不过,其中一人因 Meta 基础设施部门的文化问题已经离职。
就像一支运动队突然开始挥金如土招揽超级巨星一样,这支新组建的 Meta 超级团队最终能否真正赢得冠军,只有时间才能给出答案。然而,Zuck 的意图已十分明确。他正在调集所有可用资源,向 AI 前沿发起新冲击。时至今日,其他任何超大规模云厂商都未能展现出同样的决心。这对 Meta 的业务而言,究竟是福是祸,取决于你的先验判断。但我们坚信,他们是最有希望追赶上 Anthropic 和 OpenAI 的玩家。

但必须澄清的是,成功远非十拿九稳

总体而言,我们对 MSL 的未来持乐观态度。但必须强调的是,他们目前仍处于第一阶段。他们能够调动充足的资源和魄力,真正着手构建 RSI,这一点值得赞赏。但接下来,他们必须付诸实际行动。赶上 Anthropic 说起来容易做起来难。说到底,Meta 依然是一家大型科技公司,内部存在诸多相互冲突的意见和优先事项。
正如我们在近期关于 Meta 算力的文章中所解释的,Meta 有多种方式可以在短期内临时将算力变现。同时,只要其研究部门能够达成关键里程碑,他们依然保留全力推进 MSL 的选项。然而,如果他们做出任何表现出决心真正动摇的举动,例如签署不可撤回的长期算力出售协议、解散新成立的 RL 任务创建部门,或是任由顶尖研究人员流失,我们的乐观态度就会大打折扣。甚至可以说,以上任何一项举动都无异于给 MSL 判了死刑。
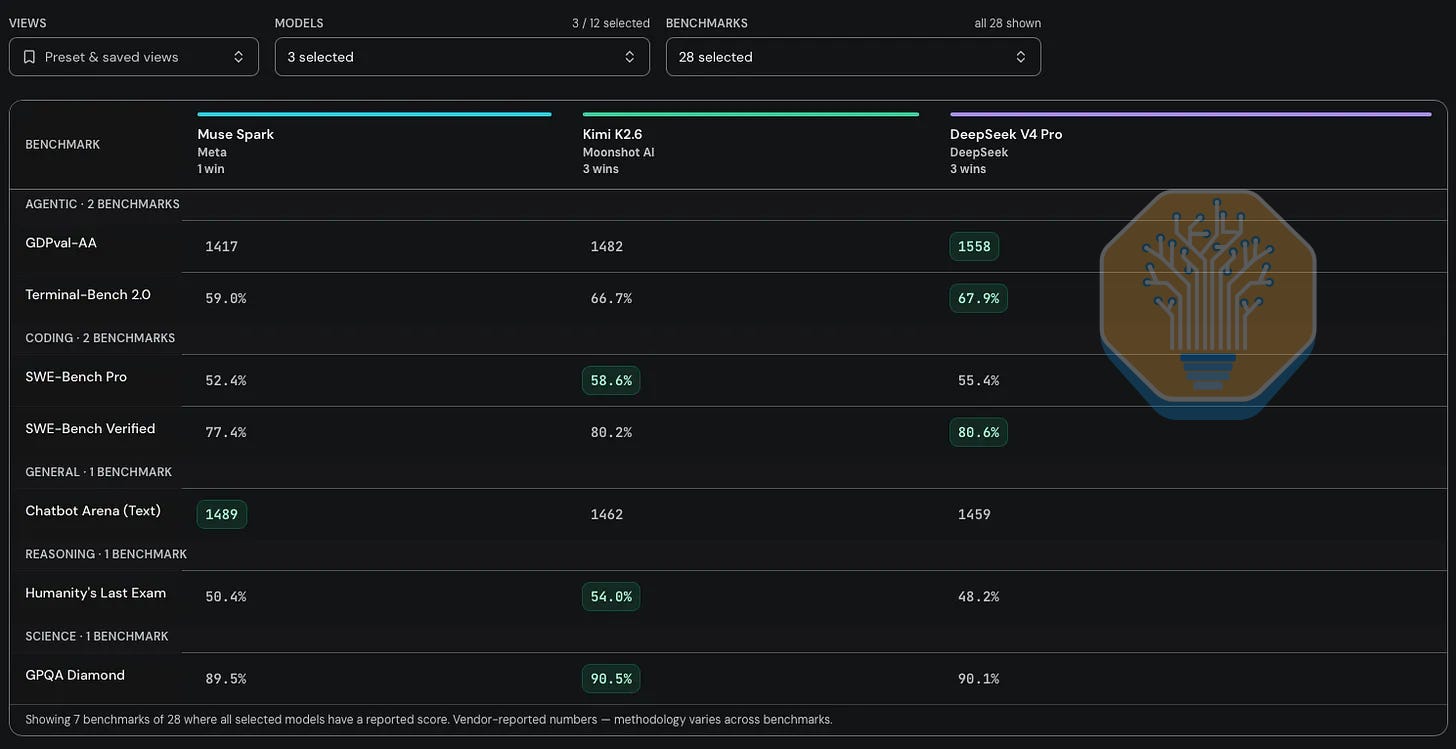
在正式发布前,我们初步测试了 Muse Spark 1.1。我们认为,在通用智能体应用场景中,它大致与 Opus 4.6 或 GLM 5.2 处于同一水平。Meta 选择将该模型的定价设定在略低于 GLM 5.2 的位置,这似乎是刻意为之。我们的部分工程师注意到,该模型有一个坏习惯:它会忽略警告,而不是去修复问题,并且无法正确使用编辑工具。
我们内部的 token 用量不会转移到 Muse Spark 1.1 上。但在当前阶段,这仍在意料之中。即便在最乐观的情况下,我们也预计他们要到今年年底才能与 Anthropic 或 OpenAI 比肩。

这对 Google 意味着什么

由 mcli LLM 翻译生成 · SemiAnalysis 文章中文版